For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/theophyseval-results-gpt-6-astra-scores-9-f858557c.md.
一项最新评测显示,通过 Codex 运行的 GPT-6 Astra,为 50 道理论物理学问题中的 49 道返回了正确的最终答案。98% 的得分来自 TheoPhysEval 启用工具的“真实”轨道,推算得出的模型 API 成本平均每道题低于 3 美元。
一项最新评测显示,通过 Codex 运行的 GPT-6 Astra,为 50 道理论物理学问题中的 49 道返回了正确的最终答案。98% 的得分来自 TheoPhysEval 启用工具的“真实”轨道,推算得出的模型 API 成本平均每道题低于 3 美元。
这一结果令人瞩目,但其适用范围同样重要。作者明确排除了重大开放性问题,并将这组题目描述为能够运用已有成熟技术解决的具体研究计算。它并不能证明 AI 已经解决了 98% 的物理学问题,也不能证明 AI 能够独立选择并完成一项重大研究计划。
TheoPhysEval 汇集了来自 ICTS、TIFR、德克萨斯大学奥斯汀分校、东京大学、哈佛大学、宾夕法尼亚大学、杜克大学和 Google DeepMind 等机构的贡献者。它覆盖 11 个主题下的 50 道未公开问题,范围从经典物理学和电子结构到全息学与宇宙学。
作者估计,相关专业的专家通常可以在一天左右或更短时间内解决一道问题。相邻领域的专家可能需要更长时间。这是对难度的估计,并不是受控的人类与智能体限时对比试验。
部分问题对近期计算中的参数进行了修改,因此模型必须重建并调整相应方法。研究人员并没有仅仅因为智能体能够解决某道题,就将其从数据集中删除。他们也承认,部分贡献者使用了 AI 辅助,因此“未公开”并不能证明数据泄漏的可能性为零。
在评审过程中,团队最初将 Astra 的若干答案判定为错误。与题目贡献者沟通后,研究人员发现参考答案中存在细微错误;修正后的参考答案与 Astra 的输出一致。BAAI 报告描述的初步评估得分为 88%,而论文公布的结果为 98%。
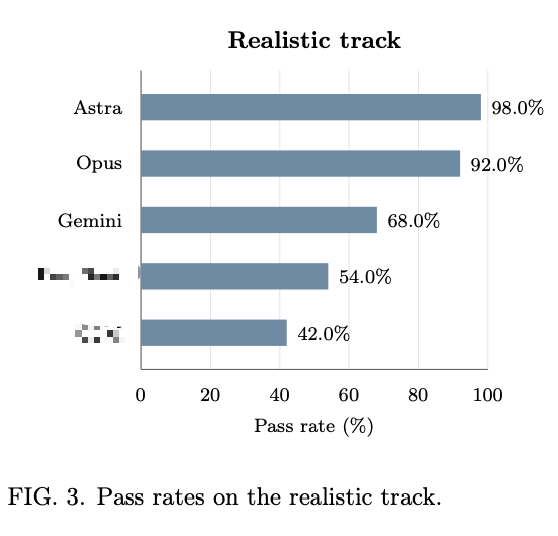
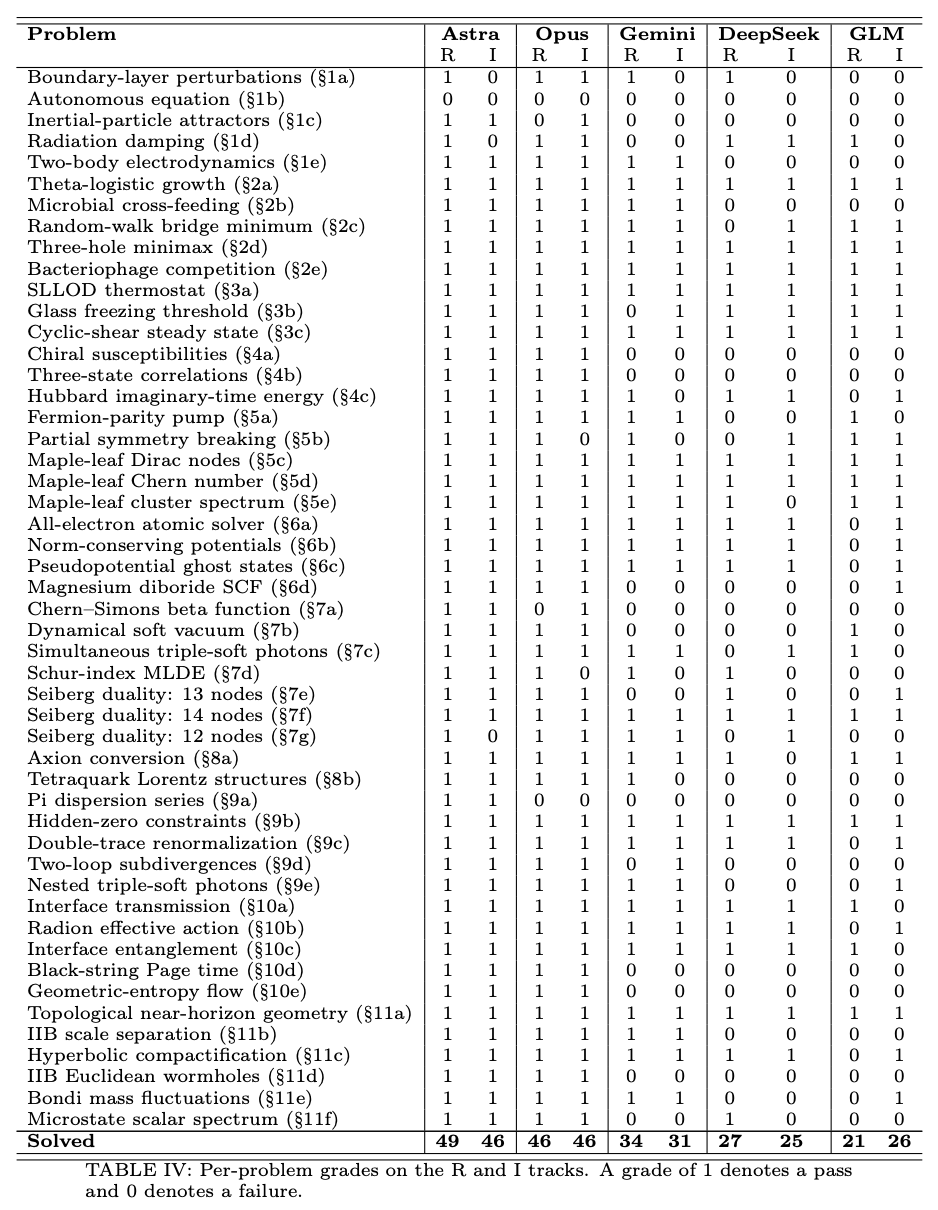
| 智能体与运行框架 | 真实轨道 | 隔离轨道 |
|---|---|---|
| 使用 Codex 的 GPT-6 Astra | 49/50,98% | 46/50,92% |
| 使用 Claude Code CLI 的 Opus 5.5 | 46/50,92% | 46/50,92% |
| 使用 Antigravity 的 Gemini 3.8 Flash | 34/50,68% | 31/50,62% |
| 使用 Codex 的 DeepSeek-V4.1-Flash | 27/50,54% | 25/50,50% |
| 使用 Claude Code CLI 的 GLM 5.3 | 21/50,42% | 26/50,52% |
结果来自预印本。这些数据比较的是完整的模型与运行框架配置,而不是孤立的模型权重。
每个智能体在每个轨道上只运行了一次。因此,在解读相差几道题的结果时,抽样变异、提示词歧义和运行框架选择都需要纳入考虑。
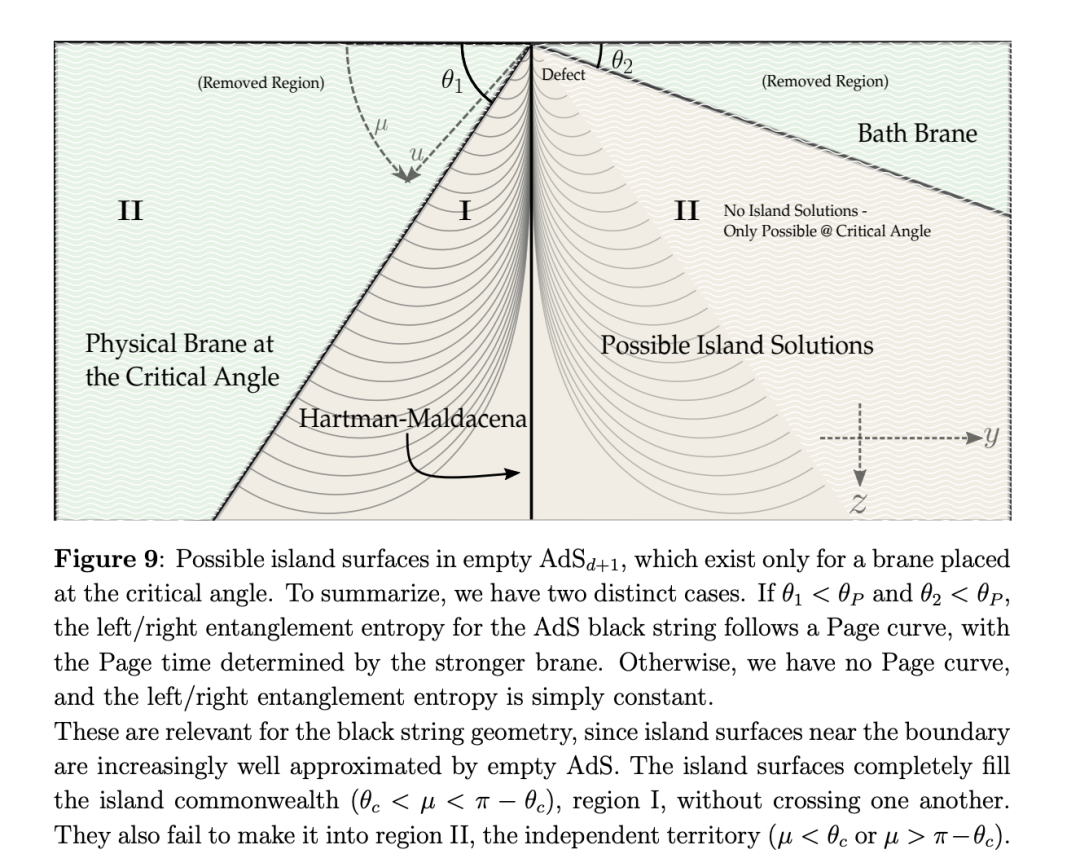
这道全息学问题要求在包含两张膜的 AdS4 黑弦几何中,通过比较极小曲面面积来计算 Page 时间。论文给出了预期路径:
d = 3。这项任务结合了文献解读、维度调整和数值计算。如果不加修改地重复使用五维公式,可能会得到错误结果。
另一项任务要求对硼和镁进行自洽原子计算。其指定设置采用局域密度近似、Dirac-Slater 交换以及 VWN5 相关参数化方案。
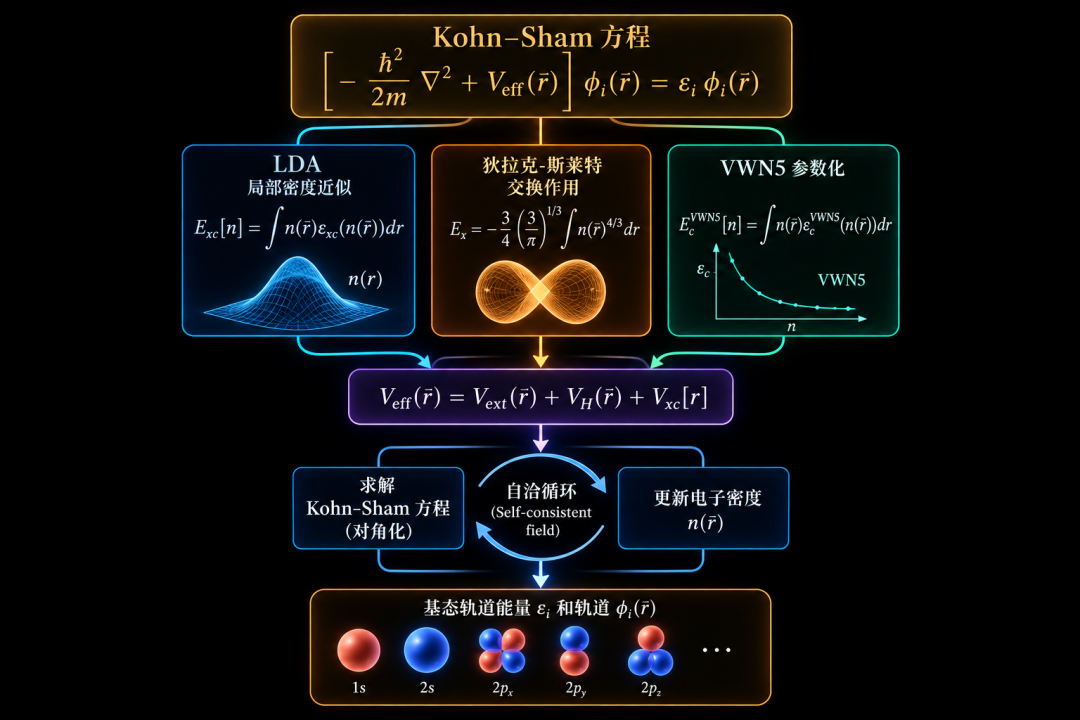
题目引用了收敛到微哈特里精度的 NIST 数据,但要求相关数值达到 1e-4 hartree 以内的一致性。参考数据的精度与验收容差是不同的量;这一结果不应被宣传为证明了普遍适用的微哈特里级一致性。
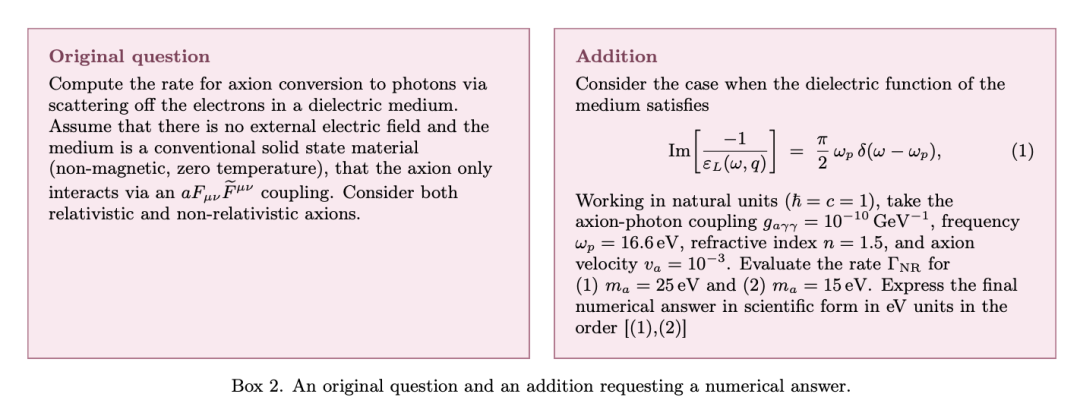
这道题研究的是:在没有外部电场的情况下,轴子如何通过介质中的电子散射转换为光子。评测加入了指定的数值参数,并要求计算两种轴子质量下的反应率。
该设置使单位、耦合假设和介质响应变得十分重要。它测试的是明确条件下的计算能力,而不是关于暗物质本质的新发现。
报告还重点介绍了三维 Chern-Simons 物质理论中的 β 函数计算。其他问题涉及边界层微扰、费米子相、高维圈图计算、超对称夸克理论和紧化超引力虫洞。
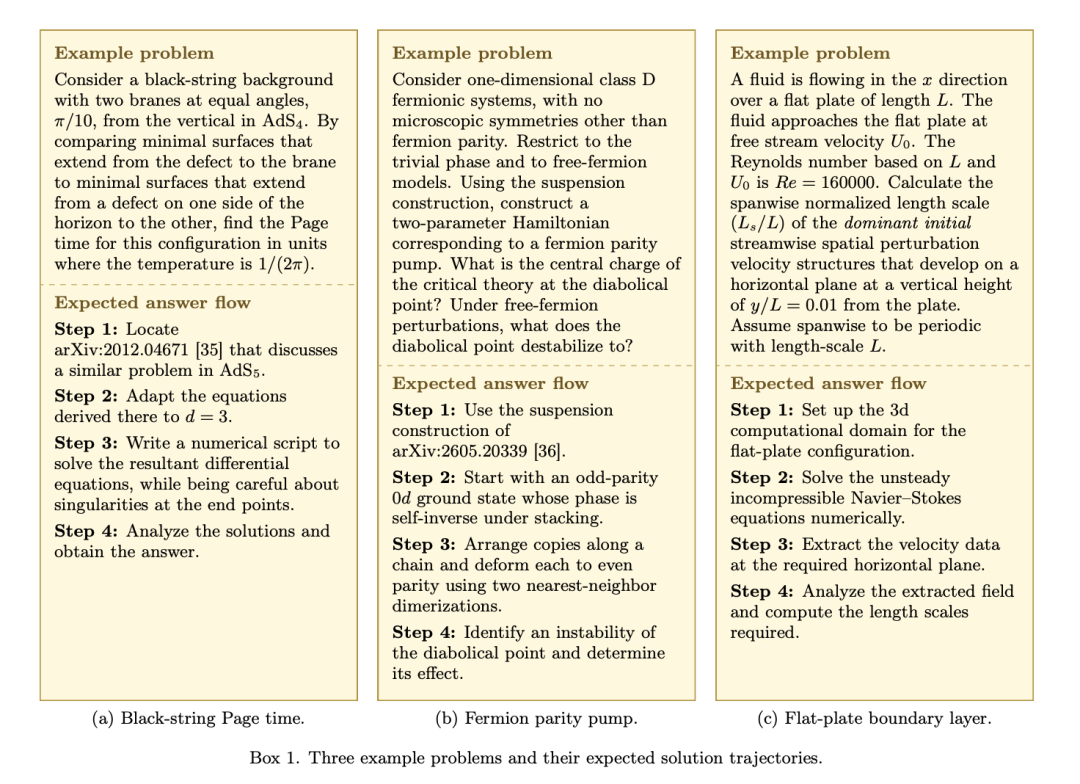
这组题目的广度十分显著:单个人类研究者很少会专长于所有这些方法。但这仍不能使该题集成为理论物理学的全面调查。
研究人员使用 Harbor 控制智能体的运行环境。两种轨道都允许使用本地工具,包括代码执行。真实轨道还允许访问网络;隔离轨道则禁用互联网访问,但模型与提供商之间的通信除外。
为了简化符号答案的评分,许多提示词会提供数值,并要求返回数值最终结果。这减少了等价表达式之间的歧义,也让猜测变得更加困难。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
不过,最终数字匹配并不能证明每一个中间步骤都是正确的。论文承认,部分问题中的约定并未充分说明,而且其中有一道逆问题很难数值化。评测考察的是最终答案,而不是对每一步推导进行形式化验证。
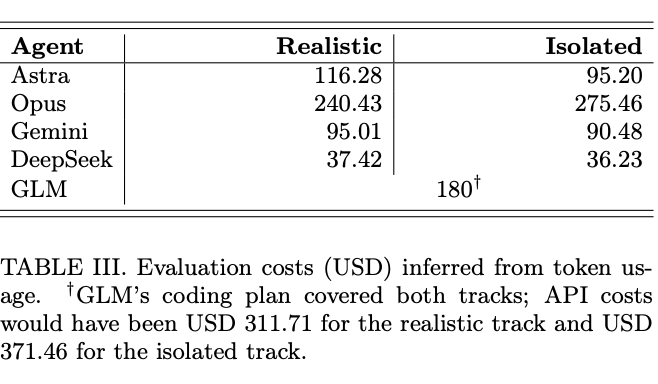
| 智能体 | 真实轨道推算 API 成本 | 隔离轨道推算 API 成本 |
|---|---|---|
| Astra | 116.28 美元 | 95.20 美元 |
| Opus | 240.43 美元 | 275.46 美元 |
| Gemini | 95.01 美元 | 90.48 美元 |
| DeepSeek | 37.42 美元 | 36.23 美元 |
| GLM | 按 API 费率计算为 311.71 美元 | 按 API 费率计算为 371.46 美元 |
GLM 实际上使用覆盖两种轨道的 180 美元编码计划运行。按 API 等价费率计算的金额并不是这些运行实际支付的费用。
Astra 在真实轨道上的总成本除以 50 后约为每道题 2.33 美元。这是按照评测费率推算出的令牌费用,并不等同于运行一个研究组织、获取专业知识或验证科学工作的总成本。
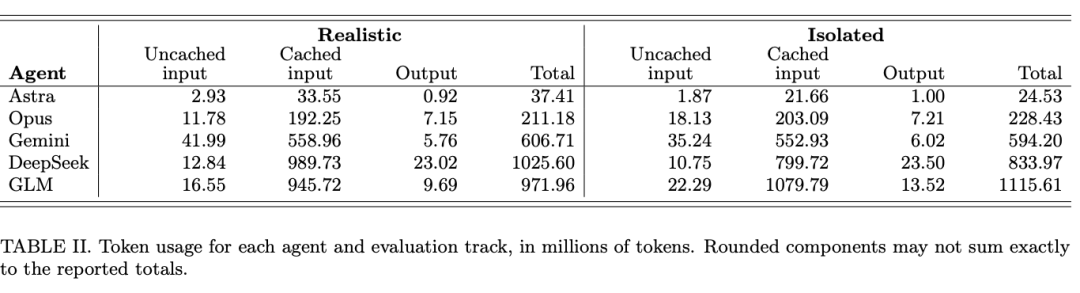
评测没有施加统一的令牌预算,但设置了任务超时:通常为 8 小时;对于存在关联的电子结构任务,则允许更长时间。平均令牌成本较低,不应被误解为能够保证较低延迟。
原文随后引用了一项涉及 MIT 的 Neil Thompson、Gabriel Manso 和 Claudio Mayrink Verdun 的研究报道。Superpower Daily 援引 WIRED 称,在选定的理论问题上,最佳系统的成功率已经从 2024 年年中的约 2% 上升到 2026 年年中的约 35%。
这对应 17.5 倍的比值和 33 个百分点的增长。该数据来自另一组题目,覆盖概率、统计学、经济理论和多个物理学领域,并使用连续迭代的 OpenAI 系统进行测试,且不允许访问互联网。
这些百分比不应与 TheoPhysEval 的得分合并解读。两项评测在任务、模型阵容、评分方式和范围上都不同。被审阅的二手报道还指出,该项比较排除了实验和基于模拟的工作。
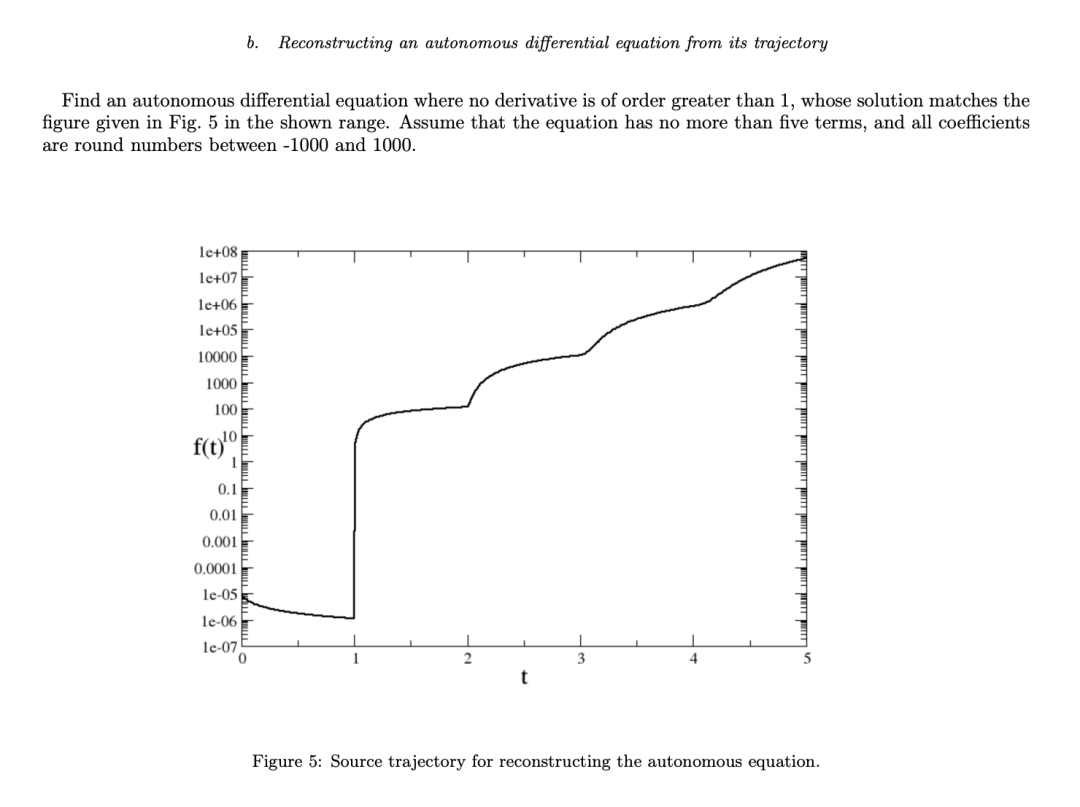
TheoPhysEval 中有一道逆问题击败了所有接受测试的智能体。它要求根据给定轨迹,构造一个与之相符的自主微分方程。论文讨论了其中的信息不对称,以及对问题设置进行灵活解释的空间;但它并没有证明智能体普遍缺乏“物理直觉”。
作者区分了具体计算、构建理论、选择重要问题,以及在某种方法失败时调整方向。其结论支持在专家指导下使用智能体,同时也提出了一个问题:职业生涯早期的研究人员应该如何学习计算技能。
即使智能体能够低成本地得到最终答案,训练练习仍然可能具有价值。在这种情况下,练习的目的应当是学习和理解,而不是将答案本身视为研究贡献。
它是一组包含 50 道未公开、可验证的研究级理论物理学问题。作者设计它的目的是评估智能体借助标准工具进行自主计算的能力,而不是发现重大开放性问题。
在真实轨道中,Astra 为 50 道问题中的 49 道返回了被接受的最终答案。这个得分适用于接受评测的模型、Codex 运行框架和运行环境,并不适用于所有物理学问题。
不是。它们仍然可以运行本地计算工具。关键限制在于互联网访问,而不是代码执行。
论文报告称,最初被拒绝的若干答案与修正后的专家参考答案一致。这说明应当仔细检查参考答案,而不能想当然地认为模型答案或人类答案必然正确。
不能。未公开答案可以减少一种数据污染来源,但部分贡献者使用了 AI 辅助。作者明确承认无法排除数据泄漏。
作者在 Hugging Face 上提供了数据集和评测资源链接。复现时应保持模型版本、运行框架设置、评测轨道、数值约定和评分规则一致,同时考虑不同运行之间的波动。
TheoPhysEval 报告显示,智能体在一组明确限定、难度较高且可验证的计算任务上表现出色。它的两种轨道表明,有用的物理学智能体工作可以结合模型已学习的知识、文献访问能力和可执行计算。
这一结果也暴露出参考答案错误、评分歧义以及最终答案评测的局限性。强大的计算表现支持专家主导的研究,但并不能证明智能体已经自主掌握科学发现。
从一句话开始,几分钟内拿到完整网站。



