「リンクが違う」と言っても原因は大きく異なり、対処法も変わります。まず原因を切り分けなければ、無効な作業に労力を費やすことになります。
学習データの残存。 モデルはコーパスの中で、旧ドメイン、旧ブランド名、改名前のページを見ています。検索を発動せず記憶だけで回答する場合、すでに無効になったアドレスを示します。特徴は安定して再現することで、質問を変えても同じリンクになります。
検索時に二次ページを取得している。 ネット接続を伴う回答は公開コンテンツを取得しますが、取得されるのは業界ディレクトリ、B2Bプラットフォームの店舗、ECモールの旗艦店、プレスリリース転載ページ、採用ページ、さらには模倣サイトであることが少なくありません。これらのページは検索されるためにタイトルへブランド名を詰め込んでおり、意味的には「公式サイトより公式サイトらしく」見えます。
名称が複数の主体を指している。 ブランド名が一般名詞、製品名、他人の商標と高度に重なる場合、同じ名前の下に複数企業が存在し、顧客に返されるのは別会社のサイトである可能性があります。
引用元そのものに問題がある。 公式サイトが長期間更新されず、定義的な表現を欠き、robots.txtでブロックされていると、取得側は引用できる文を手に入れられず、第三者の伝聞を引用するしかありません。伝聞の中のドメインや連絡先が一度でも誤っていると、それが繰り返し使われます。
The Vergeの報道によると、Podqiが独自の質問セットを使って実施したテストでは、ChatGPT、Gemini、Perplexityの一部の回答が、模倣公式サイト、失効したドメイン、偽造品を販売する小売サイトを購入チャネルとしてユーザーに推薦していました(The Verge)。このテストが測っているのは特定の質問に対するAI回答の挙動であり、すべての実ユーザーが危険なリンクに遭遇する確率と直接同一視することはできません。ただし、非常に実務的な事実を示しています。AIが「どのリンクが公式か」を判断する際には、あなたの主観的な宣言ではなく、どのような公開証拠を取得できるかに依存するということです。
二、小規模ブランドが「取り違えられやすい」理由
大規模ブランドが誤認されにくいのは、モデルが偏っているからではなく、公開情報の冗長性が高いからです。同じ会社名、ドメイン、住所、製品名が数十の権威ある情報源で繰り返し現れ、一意の結論に収束しやすくなります。中小企業に欠けているのは、まさにこの冗長性です。
- ブランド名が一般名詞と重なる。 名称に「クラウド」「スマート」「サイト構築」「テクノロジー」といった語が含まれると、検索時に大量の無関係な主体と混ざります。
- 公式サイトの内容が薄い。 ファーストビューのスローガンと数枚の画像しかなく、「私たちは誰か、何をし、誰にサービスを提供し、どこにあるか」といった直接抜き出せる完全な文がありません。
- ドメインまたはブランドを変更した。 旧ドメインに301を設定しておらず、旧ブランド名のページがまだインデックスされ、同じ会社の情報がネット上に2系統同時に存在します。
- 第三者の情報が公式サイトより新しい。 公式サイトは半年動いていないのに、業界ディレクトリでは誰かが紹介文を更新しており、より「新鮮」なほうが採用されやすくなります。
- エンティティ同一性の信号が欠けている。 構造化データがなく、sameAsで外部プロフィールをリンクしていないと、サイトと会社の対応関係を検証できる手がかりが減ります。
三、公式サイトに必ず補うべきブランド情報ブロック
判断基準は簡単です。トップページと会社概要ページの画像を隠し、文字だけを見て、以下の問いに答えられるかどうかです。答えられないなら、判断権を他人に渡していることになります。
| 情報ブロック | なぜ必要か | どこに置くべきか |
|---|---|---|
| ブランド正式名称、英語名、一般的な略称、旧名称 | 同一エンティティに複数名が併存することによる混同を解消する | フッター、会社概要ページの冒頭段落、構造化データのnameとalternateName |
| 一言定義:何をし、誰に提供し、どこにあるか | 直接引用できる回答文を提供する | トップページのファーストビュー直下の本文最初の段落 |
| 公式ドメイン宣言 | 「唯一の公式サイト」を明確にし、ミラーサイトや旧ドメインを排除する | 会社概要ページ、問い合わせページ、フッターの著作権行 |
| 製品・サービス一覧と適用シーン | カテゴリに関する質問でのブランド言及を支える | 製品ページ、料金・プランページ |
| 連絡先(メール、電話、住所) | OrganizationおよびLocalBusinessマークアップを支える | 独立した問い合わせページにプレーンテキストで記載 |
| 会社主体、登記地、設立時期 | 商業登記情報や採用プラットフォームの情報と整合させる | 会社概要ページ |
| コンテンツ更新日と責任主体 | 情報の鮮度を判断する根拠 | 記事ページと重要ページ |
書いた後は一貫性を守る必要があります。公式サイトに「〇〇テクノロジー(深セン)株式会社」と書いたなら、B2B店舗、WeChat公式アカウントの紹介、採用ページで別の主体名を書いてはいけません。プラットフォームをまたいだ表現の不整合は、自ら混同を生み出す行為です。
四、公式ドメイン、製品ページ、連絡先をどう整理するか
ドメインとページ構造はエンティティ信号の骨格であり、改修コストは高くなく、効果は直接的です。
- 唯一の正規ドメインを決める。 主ドメインを1つ選び、サイト全体で自己参照します。その他の変種(www/非www、旧ドメイン、ピンイン表記のドメイン)はすべて主ドメインへ301し、コンテンツのミラーは作りません。
- 主要ページの安定したURLを固定する。 会社概要、製品、料金、問い合わせ、よくある質問には変わらないパスを使います。例:/about、/product、/pricing、/contact、/faq。パスの頻繁な変更は過去の引用を無効にします。
- 各ページのタイトルにブランド正式名称を含める。 「ブランド名 + ページテーマ」を既定の書き方にし、キーワードだけにしない。
- 問い合わせページに機械可読な情報を置く。 組織名、住所、メール、電話をプレーンテキストで記載し、画像だけにしたりフォーム内だけに存在させたりしない。
- 旧ブランド名と旧ドメインをマッピングする。 説明ページまたは301リダイレクトを残し、「旧ドメインは新ドメインへ移行済み」と明記し、旧サイトが公式サイトとして扱われ続けるのを避ける。
- 多言語サイトはhreflangで相互参照する。 各言語版を相互に注記し、同一ブランドの多言語サイトが検索で競合したり、別主体と見なされたりするのを避ける。
五、第三者サイトに正しく引用してもらう方法
第三者からの引用は「お願いして得るもの」ではなく、「与えて育てるもの」です。企業がコントロールできるのは「相手にどの材料を渡すか」と「相手にどこまでクロールを許可するか」です。
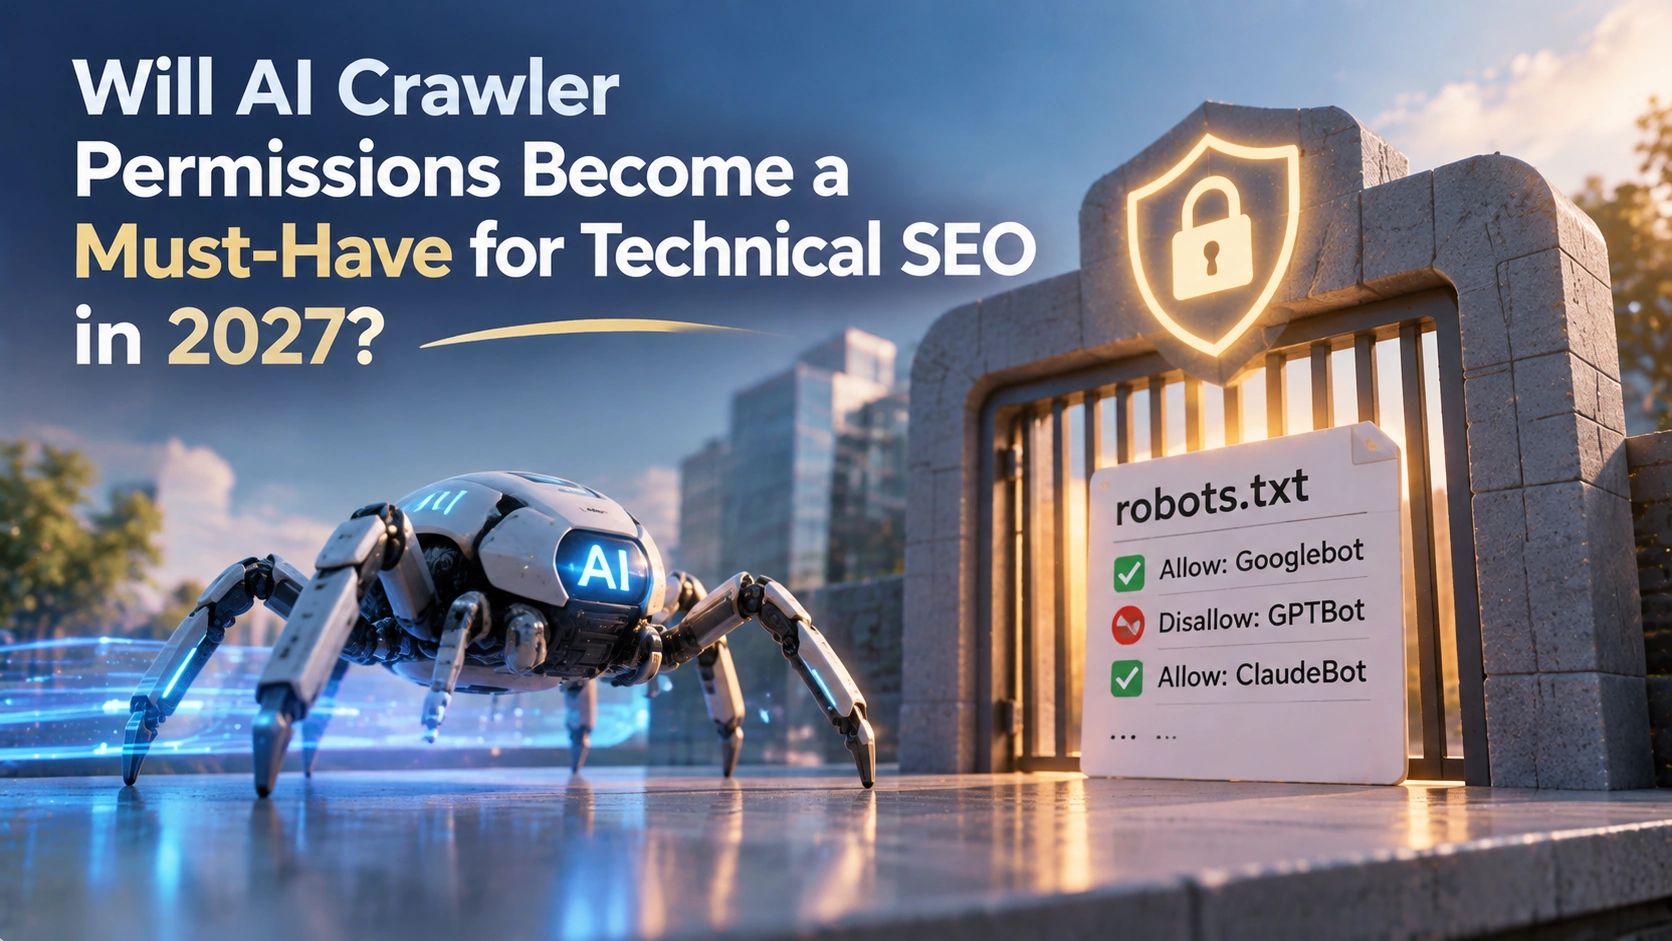
まずクローラーを許可する。 Alibaba CloudはGEOブランド診断のドキュメントで、サイトが厳格なアンチクロールを有効にしているとAIが核心コンテンツを取得・理解できず、診断結果に直接影響すると指摘し、主要AIクローラーを明示的に許可することを推奨しています(Alibaba Cloud ヘルプセンター)。書き方はサイト全体を禁止するのではなく、明示的に宣言します:
User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /
各プラットフォームのクローラー識別子は、対応するサービス提供者の公式ドキュメントに従ってください。追加や名称変更があれば同期して更新し、Disallow: / の一行ですべてのAIクロールを一括で止めないでください。
数分で紹介サイトを作り、リード獲得を伸ばす
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
次に構造化データを配置する。 業界実務では一般に、Organizationマークアップでname、url、logo、sameAs、contactPointなどの属性を担い、FAQPageでQ&Aコンテンツを担い、sameAsで権威あるプロフィールを関連付けてエンティティの信頼性を強めることが推奨されています(Hashmeta)。最小構成の例:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://あなたのドメイン/#organization",
  "name": "ブランド正式名称",
  "alternateName": ["英語名", "一般的な略称"],
  "url": "https://あなたのドメイン/",
  "logo": "https://あなたのドメイン/logo.png",
  "email": "contact@あなたのドメイン",
  "telephone": "+86-xxx-xxxxxxx",
  "sameAs": ["https://www.linkedin.com/company/あなたのブランド"]
}
最後に対外資料パッケージを統一する。 50文字と200文字の2バージョンのブランド概要を用意し、標準ロゴ、公式ドメイン、連絡先とともに公開アクセス可能なメディア資料ページに置きます。メディア、業界ディレクトリ、パートナーはそれを直接利用します。企業はすべての記事をコントロールする必要はなく、すべての記事でブランド名、ドメイン、主体表記が完全に一致していることを保証すれば十分です。The Beijing Newsが転載した業界観察記事は、この能力を「AI引用権」と呼んでいます。これはブランドが大規模モデルに識別・理解され、信頼できる情報として回答に組み込まれる能力であり、権威ある情報源とプラットフォーム横断の一貫性がその基礎だと強調しています(The Beijing News)。
六、AIによる自社の誤った説明をどう監視するか
監視は毎日適当に2、3回質問することではなく、固定した質問セット、固定プラットフォーム、固定フィールドでの再テストです。
- 質問セットを作る。 2種類に分けます。ブランド名を含まない業界質問(例:「国内にはどのようなAIサイト構築ツールがあるか」)では、自社が自発的に言及されるかを見ます。ブランド名を含む質問(例:「〇〇の公式サイトはどれか、信頼できるか」)では、どのリンクを示し、どう評価するかを見ます。Alibaba CloudのGEOブランド診断ドキュメントは、このロジックを「AI可視性」と「AIブランド口コミ」の2種類のテストに分け、ブランドキーワードが略称、英語名、一般的な誤記をカバーすること、さらに3〜5社の同業ブランドを比較対象として設定することを求めています(Alibaba Cloud ヘルプセンター)。
- 記録フィールドを固定する。 各再テストで最低限記録するのは、日付、プラットフォーム、質問原文、ブランドへの言及有無、提示されたリンク、引用元ドメイン、評価の傾向です。
- 「リンクレベル」の誤りを優先する。 顧客が直接損害を受けるのは誤ったリンクをクリックする部分であり、文言や評価は後回しにできます。対応順序は、まず公式サイトに欠けている情報ブロックを修正し、次に誤ったドメインを書いている高権威の第三者へ訂正を依頼し、最後に公式サイトで権威ある「公式チャネル説明」ページを公開して引用可能な根拠とすることです。
- 来源分布を見てから投入内容を決める。 引用が特定のプラットフォームに集中しているなら、自社サイトだけで説明するのではなく、訂正内容と製品ページ情報をそこへ同期します。
七、統一された公式ブランド情報の入口を作る
情報が十数か所に分散していると、訂正作業は長期的なモグラ叩きになります。より省力な方法は、単一の情報源を作ることです。公開され、クロール可能で、更新日時を持つブランドファクトページに、ブランド正式名称と別名、一言ポジショニング、公式ドメイン、製品一覧、連絡先、会社主体、メディア連絡先を含めます。すべての対外資料はこのページからコピーし、別途創作しません。
このページは同時に3種類の読者に役立ちます。顧客は公式サイトの真偽確認に使い、営業とカスタマーサポートは表現の統一に使い、AIはクロール後にエンティティ認識の構築に使います。価値は見た目の美しさではなく、「唯一かつ安定していること」にあります。
we0で公式サイトを構築・維持する場合、情報整理、構造化データ、多言語版、その後のコンテンツ更新を同じ流れで完了できます。ページ生成、CMSコンテンツ管理、ドメイン配置、SEO/GEO設定が1つのワークスペース内にあり(we0.ai)、ブランドファクトページ、製品ページ、FAQを一度変更すればサイト全体に反映され、「公式サイトには旧ドメインが書かれ、第三者はいまだに旧ドメインを引用している」という時間枠を短縮できます。ツールは情報整合の周期を短縮できますが、前提は依然として企業がブランドファクトを明確に定義することです。
八、30日間の実行チェックリスト
- 第1週:棚卸し。 ブランド正式名称、英語名、よくある誤記をそれぞれ使い、ChatGPT、Gemini、Perplexityで「公式サイトはどれか」と質問し、返されたリンクを1件ずつ記録します。失効した旧ドメインと旧ブランドページをすべて確認します。
- 第2週:公式サイトを補完。 第三節の表に従って情報ブロックを補い、ブランドファクトページと問い合わせページのテキスト情報を公開し、OrganizationとFAQPageの構造化データを配置し、バリデーションツールでエラーを確認します。
- 第3週:引用を管理。 robots.txtを調整して主要AIクローラーを許可し、対外ブランド資料パッケージを整理し、誤ったドメインを書いている高権威の第三者ページへ1件ずつ連絡し、旧ドメインをすべて301します。
- 第4週:ベースラインを構築。 質問セットと記録表を固定し、全プラットフォームでの再テストを1回完了してベースラインとします。その後は毎週再テストし、リンク誤りの件数を主要指標にします。
FAQ
AIが示す公式サイトリンクが間違っている場合、プラットフォームに直接申し立てて訂正してもらえますか?
主要なAIアシスタントには、ブランド向けの汎用的な「訂正窓口」はありません。誤ったリンクは通常、AIが取得または記憶した公開コンテンツに由来します。有効な方法は発生源を修正することです。公式サイトの引用可能な情報を補い、クローラーを許可し、第三者の表記を統一します。
公式サイトを修正したら、AIの回答はすぐに変わりますか?
即時に同期されるわけではありません。検索型の回答はクロールとインデックスの周期に依存し、記憶型の回答はモデル更新のリズムに依存します。週単位で再テストし、同じ質問セットにおけるリンク変化の傾向を観察することを推奨します。1回の会話だけに注目しないでください。
小規模企業で知名度が低くても、こうした対策は必要ですか?
ブランドが小さいほど公開情報は少なく、混同される確率は高くなり、誤りのコストはかえって大きくなります。ブランドファクトページ、Organizationマークアップ、問い合わせページのテキスト化という3つから始められます。コストは非常に低いです。
AIクローラーを許可すると、情報漏えいや自然流入に影響しますか?
許可するのは公開ページのクロールであり、顧客データや管理画面の利用を許諾することと同じではありません。サイト全体の開放が心配な場合は、公開ページのみ許可し、管理画面やAPIパスは個別に制限し、従来の検索エンジン向けにsitemap送信を維持できます。
関連ツール
- Google Search Console:公式サイトのインデックス状況と構造化データのエラーを確認し、旧ドメインページがまだインデックスされているかを見ます。
- Bing Webmaster Tools:一部のAI検索とCopilotエコシステムのクロール信号をここで確認できます。
- 構造化データバリデーションツール:Organization、FAQPageマークアップが正しく解析されるか検証します。
- we0.ai:同じワークスペースでページ生成、CMSコンテンツ管理、ドメイン配置、SEO/GEO設定を完了でき、ブランドファクト情報を集中的に維持しやすくなります。
関連リンク
- The Verge:AIチャットボットが偽の小売サイトを推薦しているとの調査結果
- Alibaba Cloud ヘルプセンター:GEOブランド診断
- Hashmeta:2026年のGEO最適化ベストプラクティス
- The Beijing News:トラフィック争いからAI引用争いへ
- we0.ai 公式サイト
まとめ
顧客がChatGPTで見つけた誤った公式サイトリンクは、公開情報の不足と不整合の結果であり、偶発的なミスではありません。AIが「どれが公式か」を判断するには、クロール可能な完全な情報、明確で一意のエンティティ信号、一貫した外部引用が必要です。企業が取れる対策は具体的です。ブランド名、定義、ドメイン、連絡先をサイト本文に書き、構造化データでマークアップする。主要AIクローラーを許可する。第三者向けの対外表現を統一する。長期的に維持できるブランドファクトページを作る。そして固定した質問セットで毎週再テストする。この作業はGEO最適化の基礎であり、顧客がAI検索で最初にたどる先が自社サイトになるか、似た他人のページになるかを直接左右します。