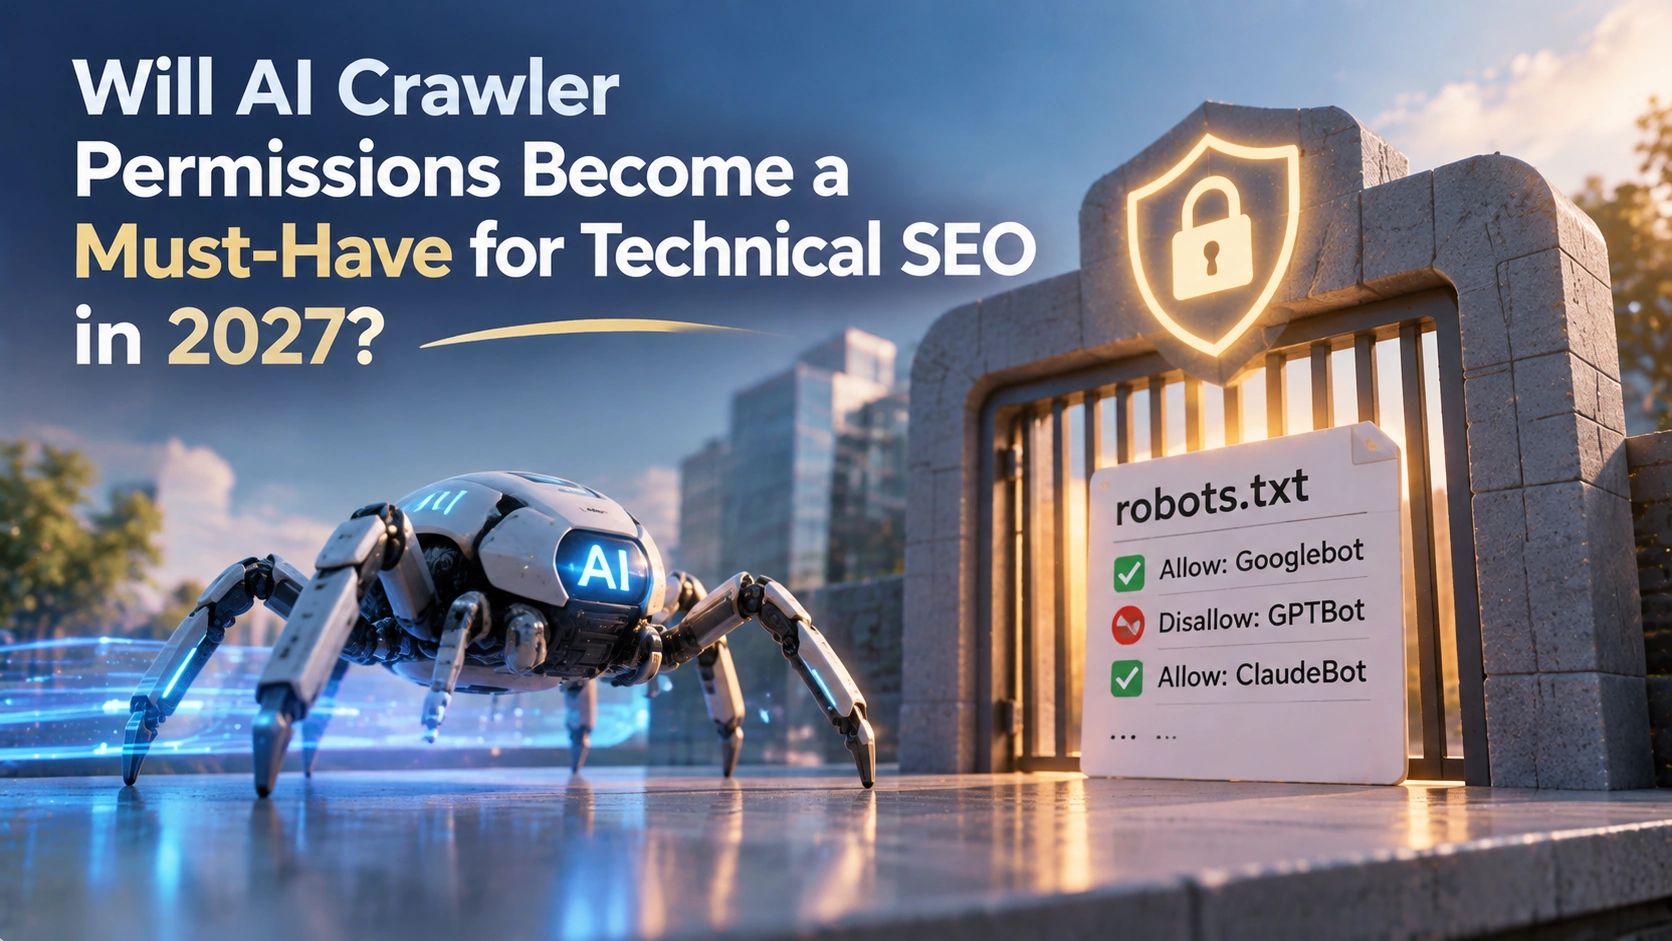
User-agent: Googlebot
Allow: /
User-agent: Google-Extended
Disallow: /
Zukünftiges gemeinsames Trainingspräferenzsignal (Google plant Unterstützung Anfang 2027)
User-agent: __usage_ai-training
Disallow: /
Besonders beachten: Ein `Disallow` für `Google-Extended` führt nicht dazu, dass Webseiten aus den Google-Suchergebnissen verschwinden. Die offizielle Dokumentation stellt klar, dass es weder die Aufnahme einer Website in die Google-Suchergebnisse beeinflusst noch als Rankingfaktor in der Google Suche dient. Umgekehrt wirkt sich ein siteweites Verbot unter `User-agent: *` auch auf Googlebot aus; diese Art des beiläufigen Blockierens ist die häufigste Selbstschädigung im technischen SEO.
## Warum müssen AI Training und AI Grounding getrennt betrachtet werden?
Dies ist die Begriffskombination, die im Jahr 2027 am häufigsten falsch geschrieben werden dürfte.
**AI Training (Training)** bezieht sich darauf, ob Webinhalte für das Training zukünftiger Modellversionen verwendet werden; es beeinflusst die Modellparameter. **AI Grounding (Grundlage)** bezieht sich darauf, ob das Modell bei der Beantwortung von Fragen die abgerufenen Webinhalte in Echtzeit als Faktenbasis verwendet; es beeinflusst, ob Ihre Informationen in einer bestimmten Antwort erscheinen können. Ersteres betrifft die unentgeltliche Nutzung von Inhaltsvermögen, Letzteres betrifft, ob Sie in KI-Antworten erscheinen können – die geschäftlichen Folgen sind völlig unterschiedlich.
Laut der offiziellen Google-Erläuterung zu `Google-Extended` steuert dieses Token, ob von Websites gecrawlte Inhalte für das Training zukünftiger Versionen der Gemini-Modelle verwendet werden dürfen. Diese Modelle unterstützen Gemini in der Gemini-App und Gemini auf Vertex AI und werden auch dafür verwendet, in der Gemini-App Inhalte aus dem Google-Suchindex für das Modell bereitzustellen, um Wahrheitsgehalt und Relevanz zu erhöhen, sowie für Grounding bei der Nutzung von Google Search auf Vertex AI. Das heißt: In dieser Google-Implementierung werden Trainingserlaubnis und Grounding-Erlaubnis durch dasselbe Token abgedeckt. Betreiber, die „Training verbieten, Zitierung beibehalten“ möchten, müssen bei jeder Zielplattform einzeln prüfen, ob eine solche Trennung angeboten wird, und dürfen nicht annehmen, dass alle Plattformen bereits getrennt sind.
## Beeinträchtigt das Blockieren von Training auch die Zitierung in der KI-Suche?

Das muss je nach Szenario beantwortet werden, nicht pauschal.
**Innerhalb der Google Suche: nein.** KI-Funktionen bauen auf dem Suchindex auf; das Blockieren von Training führt nicht dazu, dass Seiten keine Indexierungschance mehr haben. Das ist die direkte Folge der getrennten Gestaltung von `Google-Extended` und `Googlebot`.
**Bei externen KI-Assistenten: häufig ja.** Diese Systeme verwenden eigene Crawler; ob JavaScript ausgeführt wird, ob robots.txt beachtet wird, ob strukturiert klare Seiten bevorzugt gecrawlt werden – die Regeln unterscheiden sich je Plattform. Das Blockieren von Training ist oft gleichbedeutend mit dem Blockieren von Crawling, und wenn Crawling blockiert wird, geht die Möglichkeit der Zitierung verloren. Im Moz-Interview gibt es einen praktischen Hinweis: Bei Inhalten, die von KI gesehen werden sollen, sollten die Kerninformationen direkt im rohen HTML stehen; umgekehrt kann JavaScript-Rendering als Schutzmechanismus dienen, der es erschwert, Assets, die nicht massenhaft extrahiert werden sollen, auszulesen. Das ist eine Abwägung, kein kostenloser Schalter.
**Auf Monitoring-Ebene: man wird leicht blind.** Das eigentliche Risiko besteht darin, nach dem Blockieren keine Wirkung mehr zu sehen. Wenn im Log nicht einmal die entsprechenden Einträge vorhanden sind, lässt sich nicht beurteilen, ob die Wirkung darin besteht, dass niemand crawlt oder dass gecrawlt, aber nicht zitiert wurde.
## Worin unterscheiden sich die Steuerungsregeln von Google und anderen Plattformen?
Nach überprüfbaren öffentlichen Materialien konzentrieren sich die Unterschiede auf drei Punkte: Steuerungsgranularität, Benennung und Umsetzungsrhythmus.
| Dimension | Google | Andere Plattformen (maßgeblich sind die jeweiligen offiziellen Dokumente) |
| --- | --- | --- |
| Ausdrucksort | robots.txt-User-Agent-Token + geplantes gemeinsames Präferenzsignal | Präferenzfelder gemäß jeweiliger Dokumentation, Benennung und Ort nicht einheitlich |
| Trainingssteuerung | separates Produkt-Token `Google-Extended` | meist über eine separate Präferenzdeklaration, Felder unterschiedlich |
| Verhältnis zur Suchindexierung | offiziell kein Einfluss auf Indexierung und Ranking | muss je Anbieter geprüft werden, keine Analogieschlüsse |
| Umsetzungsrhythmus | gemeinsames Trainingssignal soll Anfang 2027 unterstützt werden | befindet sich in schrittweiser Umsetzung |
| Bereits vollständig umgesetzt | gemeinsames Signal wird noch vorangetrieben | darf nicht als abgeschlossen gelten |
Dieselbe robots.txt hat auf verschiedenen Plattformen nicht dieselbe Bedeutung; plattformübergreifende Analogieschlüsse sind der häufigste sachliche Fehler.
## Die Grenzen von fünf Berechtigungssteuerungsmethoden
| Methode | Wirkungsbereich | Wirkung auf Google-Indexierung | Wirkung auf Drittanbieter-KI | Widerrufbarkeit |
| --- | --- | --- | --- | --- |
| `Google-Extended`-Token | Google-Training und Grounding-Zwecke | keine | keine | hoch, Datei ändern genügt |
| `Googlebot`-Token | Google Suche sowie Bilder, Videos, News usw. | direkte Wirkung | keine | hoch |
| `X-Robots-Tag` / Meta-Robots | Crawling- und Indexierungssteuerung auf Seitenebene | direkte Wirkung | plattformabhängig | mittel, erneutes Crawling abwarten |
| Clientseitiges Rendering kritischer Inhalte | Sichtbarkeit der Inhalte | in der Regel renderbar | häufig unsichtbar | mittel, Architekturänderung nötig |
| WAF / IP-Blockierung | Blockierung auf Anfrageebene | kann mitblockieren | wirksam, aber grob | niedrig, hohe Kollateralschadenwahrscheinlichkeit |
Die Entscheidungscheckliste lässt sich auf drei Fragen vereinfachen: Sollen diese Inhalte trainiert werden? Sollen sie zitiert werden? Kann die Änderung bei Problemen innerhalb von zehn Minuten zurückgerollt werden? Wenn eine Frage nicht beantwortet ist, sollte die Konfiguration nicht geändert werden.
## Fünf Umsetzungsschritte für Website-Betreiber
**Schritt 1: erst inventarisieren, dann handeln.** Ermitteln Sie anhand der Logs, welche User-Agents tatsächlich zugreifen. Ein ausreichender Ausgangspunkt ist die Zählung der Anfragen nach UA:
```bash
awk -F'"' '{print $6}' access.log \
| sort | uniq -c | sort -rn | head -30
Schauen Sie zuerst auf die Liste und legen Sie dann die Strategie fest; fügen Sie nicht aus dem Bauch heraus einem UA ein Verbot hinzu.
Schritt 2: Strategieebenen definieren. Unterscheiden Sie mindestens drei Seitentypen: Marketingseiten, die von Suche und KI zitiert werden sollen; sensible Inhalte, die nur für Menschen bestimmt sind; Materialien, die öffentlich sein dürfen, aber nicht für Training verwendet werden sollen. Diese drei Typen sollten nicht dieselbe Regel teilen.
Schritt 3: Konfiguration schreiben und Absicht dokumentieren. Erläutern Sie in der robots.txt per Kommentar den geschäftlichen Grund für jeden Regelblock, damit spätere Übergaben und Audits erleichtert werden.
Schritt 4: Validieren. Prüfen Sie mit dem robots.txt-Testtool der Plattform das Analyseergebnis für den Ziel-UA und lesen Sie anschließend die Logs zurück, um Änderungen beim Crawling zu bestätigen.
Schritt 5: Überprüfungsrhythmus etablieren. Das gemeinsame Trainingspräferenzsignal wird noch vorangetrieben; es empfiehlt sich, einmal pro Quartal zu überprüfen, statt die Konfiguration einmalig festzulegen und dann lange nicht mehr anzufassen.
Häufige Missverständnisse und Einschränkungen
robots.txt als rechtliche Barriere missverstehen. Sie drückt eine Absicht aus, bietet aber keine Durchsetzungskraft; echter Schutz erfordert eine Kombination aus Inhaltsebenen, Zugriffskontrolle und vertraglichen Klauseln.
Annehmen, das Blockieren von Training mache Inhalte unsichtbar. Auf der Google-Suche-Seite stimmt das nicht; bei externen Assistenten stimmt es häufig – die Schlussfolgerungen sind gegensätzlich.
Nur Training behandeln, Grounding ignorieren. Wenn eine Plattform Training und Grounding an dasselbe Token bindet, schwächt das Blockieren von Training gleichzeitig die Zitierungschance.
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Berechtigungsverwaltung als Traffic-Schalter betrachten. Sie entscheidet, wer lesen darf und was nach dem Lesen getan werden darf, und verspricht keine Rankings, keinen Traffic und keine Abschlüsse.
Renderunterschiede ignorieren. Wenn Inhalte nur in JavaScript existieren, ist das gleichbedeutend mit Schweigen gegenüber einer Klasse von Crawlern; solche Probleme gehen über die Berechtigungskonfiguration hinaus und erfordern Änderungen an Frontend und Architektur.
Die tägliche Arbeit im technischen SEO erweitert sich derzeit von „Suchmaschinen sollen es verstehen können“ zu „klar sagen, wer es lesen darf und was nach dem Lesen getan werden darf“. Wenn Seitenstruktur, strukturierte Informationen und Content-Aktualisierung ohnehin chaotisch sind, dokumentiert die Berechtigungskonfiguration nur das Chaos. Website-Aufbau und Content-Betrieb in einem System voranzutreiben, ist meist kostengünstiger als das nachträgliche Ergänzen von Regeln – zum Beispiel bringt We0 beim Generieren einer Website SEO- und GEO-Optimierung, CMS-Backend und Domain-Deployment auf dieselbe Kette; Seitenstruktur, zitierbare Informationsblöcke und Launch-Prozess entstehen gemeinsam, und spätere Berechtigungsstrategien lassen sich leichter auf konkrete Seitentypen anwenden.
FAQ
Muss die Verwaltung von KI-Crawler-Berechtigungen vor 2027 abgeschlossen sein?
Die Konfiguration muss nicht sofort geändert werden, aber es empfiehlt sich, Inventarisierung und Strategie vor 2027 festzulegen. Das gemeinsame Trainingspräferenzsignal wird noch vorangetrieben; Google plant Unterstützung Anfang 2027. Teams, die die Seitenebenen frühzeitig klären, müssen nur wenige Zeilen Konfiguration ändern, wenn die Felder offiziell wirksam werden.
Verschwindet die Website aus der Google Suche, wenn Google-Extended in der robots.txt verboten wird?
Nein. Laut offizieller Google-Dokumentation beeinflusst Google-Extended weder die Aufnahme einer Website in die Google-Suchergebnisse noch dient es als Rankingfaktor. Was die Suchindexierung beeinflusst, sind Regeln zu Googlebot.
Sind AI Training und AI Grounding dasselbe?
Nein. Training entscheidet, ob Inhalte in die Parameter zukünftiger Modelle eingehen; Grounding entscheidet, ob das Modell bei der Beantwortung von Fragen Ihre Inhalte in Echtzeit als Grundlage verwendet. Bei einigen Implementierungen werden beide durch dasselbe Token abgedeckt; das muss je Anbieter geprüft werden.
Welche Auswirkungen hat es auf die Berechtigungskonfiguration, wenn KI-Crawler kein JavaScript ausführen?
Große Auswirkungen. Wenn Kerninformationen nur in clientseitig gerenderten Ergebnissen existieren, kann die Gegenseite die Inhalte selbst bei noch so präziser Berechtigungskonfiguration nicht lesen. Entweder gehören die Kerninformationen ins rohe HTML, oder man akzeptiert, dass diese Crawler sie nicht sehen.
Wie lässt sich feststellen, ob die Konfiguration tatsächlich wirksam ist?
Drei Dinge: mit den offiziellen Testtools das Analyseergebnis für den Ziel-User-Agent validieren, die Zugriffslogs zurücklesen, um zu bestätigen, ob sich das Crawling verändert hat, und eine feste Gruppe realer Fragen regelmäßig prüfen, ob in KI-Antworten noch Markeninformationen und Quellenangaben erscheinen.
Verwandte Tools
- Google Search Console (Diagnose von Indexierung und Crawling)
- robots.txt-Testtool (Validierung des Analyseergebnisses für den Ziel-User-Agent)
- Analyse der Server-Zugriffslogs (Crawl-Verteilung nach UA zählen)
- We0 (AI-Website-Builder und Growth-Workspace, mit SEO- und GEO-Optimierung, CMS-Backend und Domain-Deployment)
Verwandte Links
- Liste der gängigen Google-Crawler (offizielle Dokumentation)
- Gemeinsame KI-Trainingssteuerungsoptionen für Websites (Google Search Central Blog)
- Stop Calling It SEO: 12 Strategies To Dominate AI Search in 2026 (Moz)
- Generative Engine Optimization (GEO) in der Praxis (Tencent Cloud Developer Community)
- We0-Website
Zusammenfassung
Die Verwaltung von KI-Crawler-Berechtigungen wird 2027 wahrscheinlich zur regulären Lieferposition im technischen SEO werden, aber der Kern ist nicht das „Blockieren von KI“, sondern die getrennte Deklaration dreier Verwendungszwecke – Such-Crawling, Modelltraining und Inhaltsgrundlage – und das Hinterlassen überprüfbarer Aufzeichnungen. Die Beurteilung stützt sich auf drei Punkte: Trainingspräferenzen entwickeln sich zu einem gemeinsamen maschinenlesbaren Signal, das Google Anfang 2027 unterstützen will; die Steuerungsobjekte haben sich von einem einzelnen Googlebot auf separate Produkt-Tokens ausgeweitet; KI-Zitierung setzt weiterhin Crawlbarkeit voraus. In der Umsetzung ist es wirksamer, zuerst Logs zu inventarisieren, dann die Strategie nach Seitentypen zu definieren, die Absicht per Kommentar zu dokumentieren, Analyseergebnisse zu validieren und einen vierteljährlichen Überprüfungsrhythmus einzuführen, als einmalig zu sperren. Die Grenzen sind ebenso klar: robots.txt ist eine Vereinbarung und keine Durchsetzung; Google-Extended beeinflusst die Indexierung und das Ranking in der Google Suche nicht; Trainingserlaubnis und Grounding-Erlaubnis sind in einigen Implementierungen noch nicht getrennt. Wenn diese Unterschiede klar beschrieben werden, wird die Berechtigungsverwaltung nicht zu einem irreversiblen Fehlgriff.