Die Logik einer normalen FAQ-Seite lautet „Menschen suchen die Antwort“: Nutzer entscheiden selbst, welchen Eintrag sie öffnen, lesen den ganzen Absatz und gleichen ihn mit ihrer Situation ab. Die Fragen, die Unternehmen tatsächlich erreichen, sind jedoch oft Kombinationsfragen wie „Unterstützt unsere Version Private Deployment, die Daten dürfen das interne Netz nicht verlassen?“ In den FAQ steht nur ein Eintrag „Private Deployment wird unterstützt“, und nach dem Lesen ist der Nutzer immer noch unsicher.
Der Unterschied beim KI-Kundenservice besteht darin, dass die Antwort auf die Frage hin vor Ort zusammengestellt wird. Er nutzt Website-Inhalte, Produktdokumentation und FAQ-Liste gemeinsam als Wissensdatenbank; wenn ein Nutzer eine Frage stellt, werden zuerst relevante Materialien abgerufen, und anschließend formuliert ein großes Sprachmodell daraus einen Absatz, der die Frage direkt beantwortet (Alibaba-Cloud-KI-Kundenservice-Dokumentation). Für häufig wiederkehrende Szenarien wie Vorverkaufsberatung, Funktionsanleitung und Website-Informationsservice entscheidet dieser Unterschied darüber, ob der Nutzer weiterliest oder die Seite schließt und den Wettbewerber fragt.
Deshalb ist das, was geliefert werden muss, kein Chatfenster, sondern ein Wissensbestand, der abrufbar und ausreichend präzise ist. Das Fensterdesign ist der letzte Schritt; die ersten beiden Schritte entscheiden darüber, ob es überhaupt nützlich ist.
Das technische Gerüst, damit der KI-Kundenservice „die eigenen Produkte versteht“: RAG
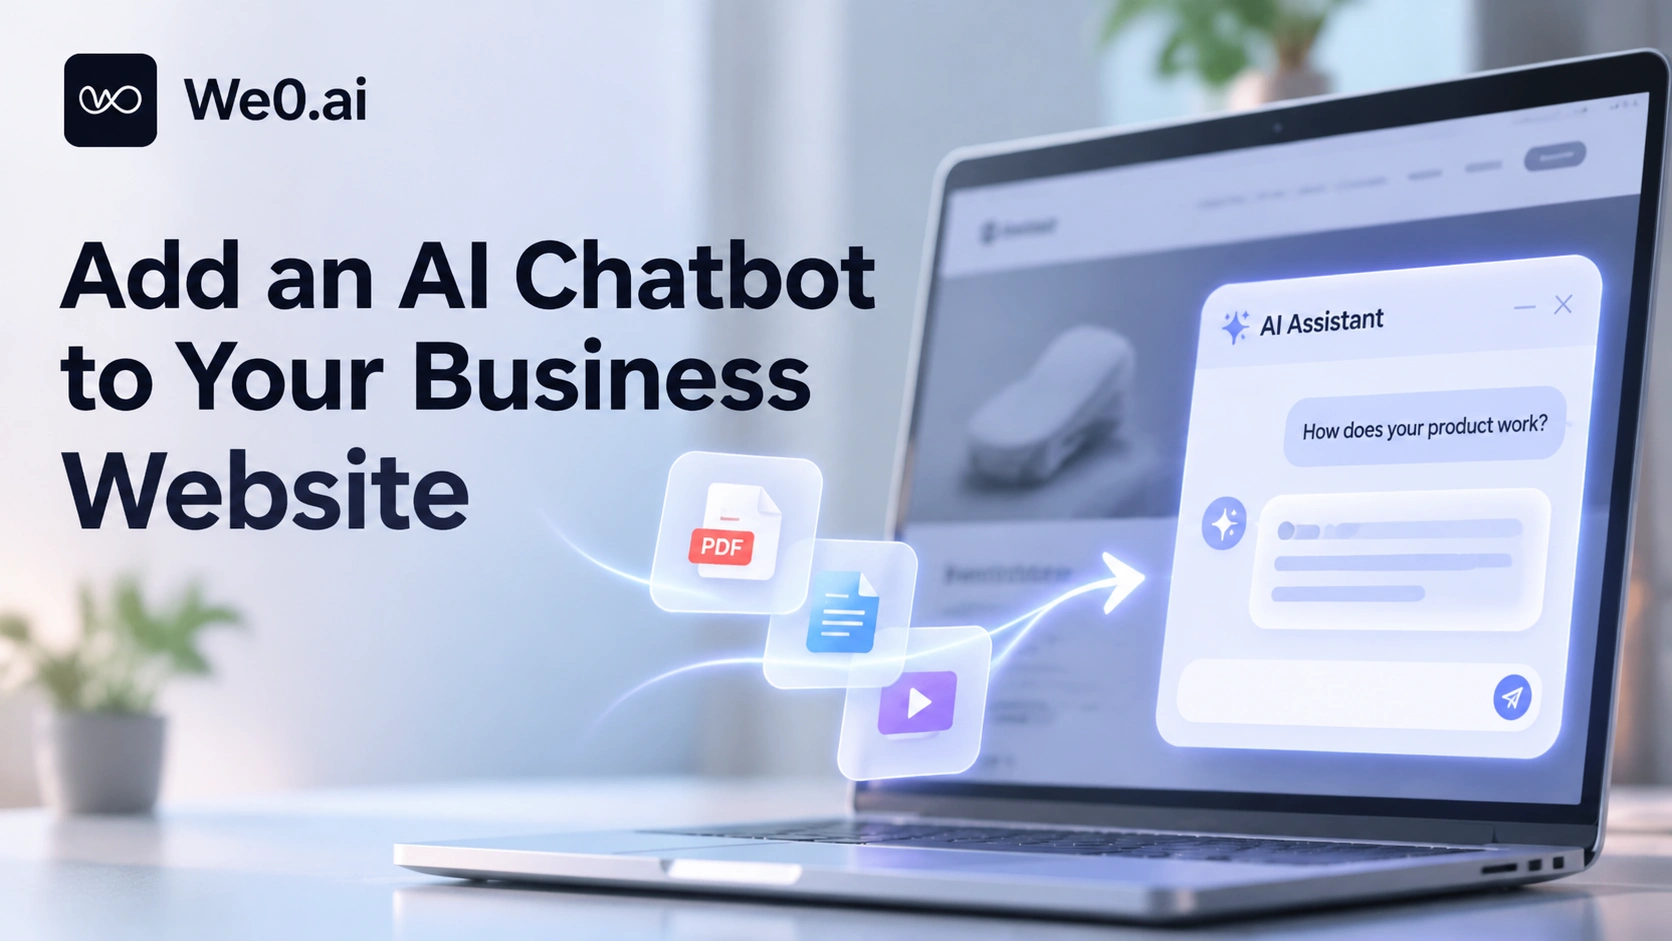
Damit ein Chatbot anhand der eigenen Unternehmensmaterialien antwortet, ist Retrieval-Augmented Generation (RAG) die gängige Methode. Der Kern besteht nicht darin, dass das Modell Ihre Produkte „auswendig lernt“, sondern darin, dass es vor jeder Antwort relevante Passagen aus der Wissensdatenbank sucht und die Antwort auf Basis dieser Passagen schreibt. Die RAG-Studio-Dokumentation von Cloudera beschreibt solche Systeme so: Der Chatbot greift auf eine Wissensdatenbank zu, ruft Inhalte ab, die zur Nutzerfrage passen, und generiert dann eine Antwort, die zu dieser Frage passt (RAG-Studio-Anwendungsbeschreibung).
Eine minimal nutzbare Kette besteht aus fünf Schritten:
- Aufteilen: Handbücher, Klauseln und Produktseiten in abrufbare kleine Blöcke zerlegen;
- Indexieren: für jeden Block einen Vektor- oder Stichwortindex anlegen;
- Abrufen: bei einer Nutzerfrage die relevantesten Blöcke zurückholen;
- Generieren: die abgerufenen Inhalte zusammen mit der Nutzerfrage an das Modell geben, damit es die Antwort formuliert;
- Zitieren: neben der Antwort die Quelle angeben, sodass Nutzer sie aufrufen und prüfen können.
Schritt 5 wird oft übersehen, löst aber gleichzeitig zwei Probleme: Nutzervertrauen und die spätere Nachvollziehbarkeit, aus welchem Dokument „dieser Satz“ stammt. Wenn sich Materialien aktualisieren, muss das Modell nicht neu trainiert werden; es genügt, die Wissensdatenbank zu ändern. Das ist auch der Grund, warum RAG für häufig iterierende Produktinformationen besser geeignet ist als Fine-Tuning.
Schritt 1: Wissensquellen erfassen und trennen, welche Inhalte in die Wissensdatenbank gehören
Vor der Integration sollten die Materialien offen ausgebreitet und kategorisiert werden. Nicht alle Inhalte eignen sich dafür, direkt hineingegeben zu werden, und nicht alle sollten öffentlich gezeigt werden.
| Wissensquelle | Geeignete Inhalte | Worauf bei der Integration zu achten ist |
|---|---|---|
| Website-Seiten | Produktvorstellung, Funktionsseiten, Preisseite, Artikel im Hilfe-Center | Automatisch crawlbar, aber sicherstellen, dass die Online-Seite die neueste Version ist |
| PDF-/Word-Dokumente | Produkthandbücher, Datenblätter, Schnittstellenbeschreibungen, Servicebedingungen | Gescannte Dateien müssen zuerst per Texterkennung verarbeitet werden, sonst sind sie nicht abrufbar |
| FAQ-Standardfragen | Richtlinien, Fristen, Rückgabe, Rechnungen, After-Sales-Prozesse | Höchste Trefferpriorität, am besten kontrollierbare Antworten |
| Interne Materialien | Preisregeln, Vertriebs-SOP, Fehlerbehandlungshandbuch | Betrifft Berechtigungen; dürfen nicht mit öffentlichem Wissen im selben Abrufbereich liegen |
Ein häufiger Fehler besteht darin, alle Materialien ohne Unterschied hochzuladen; infolgedessen ruft das Modell drei Datenblätter aus unterschiedlichen Zeiträumen ab, und die Antworten widersprechen sich. Zuerst Duplikate entfernen und Versionen konsolidieren ist deutlich wirksamer, als an Prompts zu feilen.
Schritt 2: Wissensdatenbank aufbauen und abrufbar machen
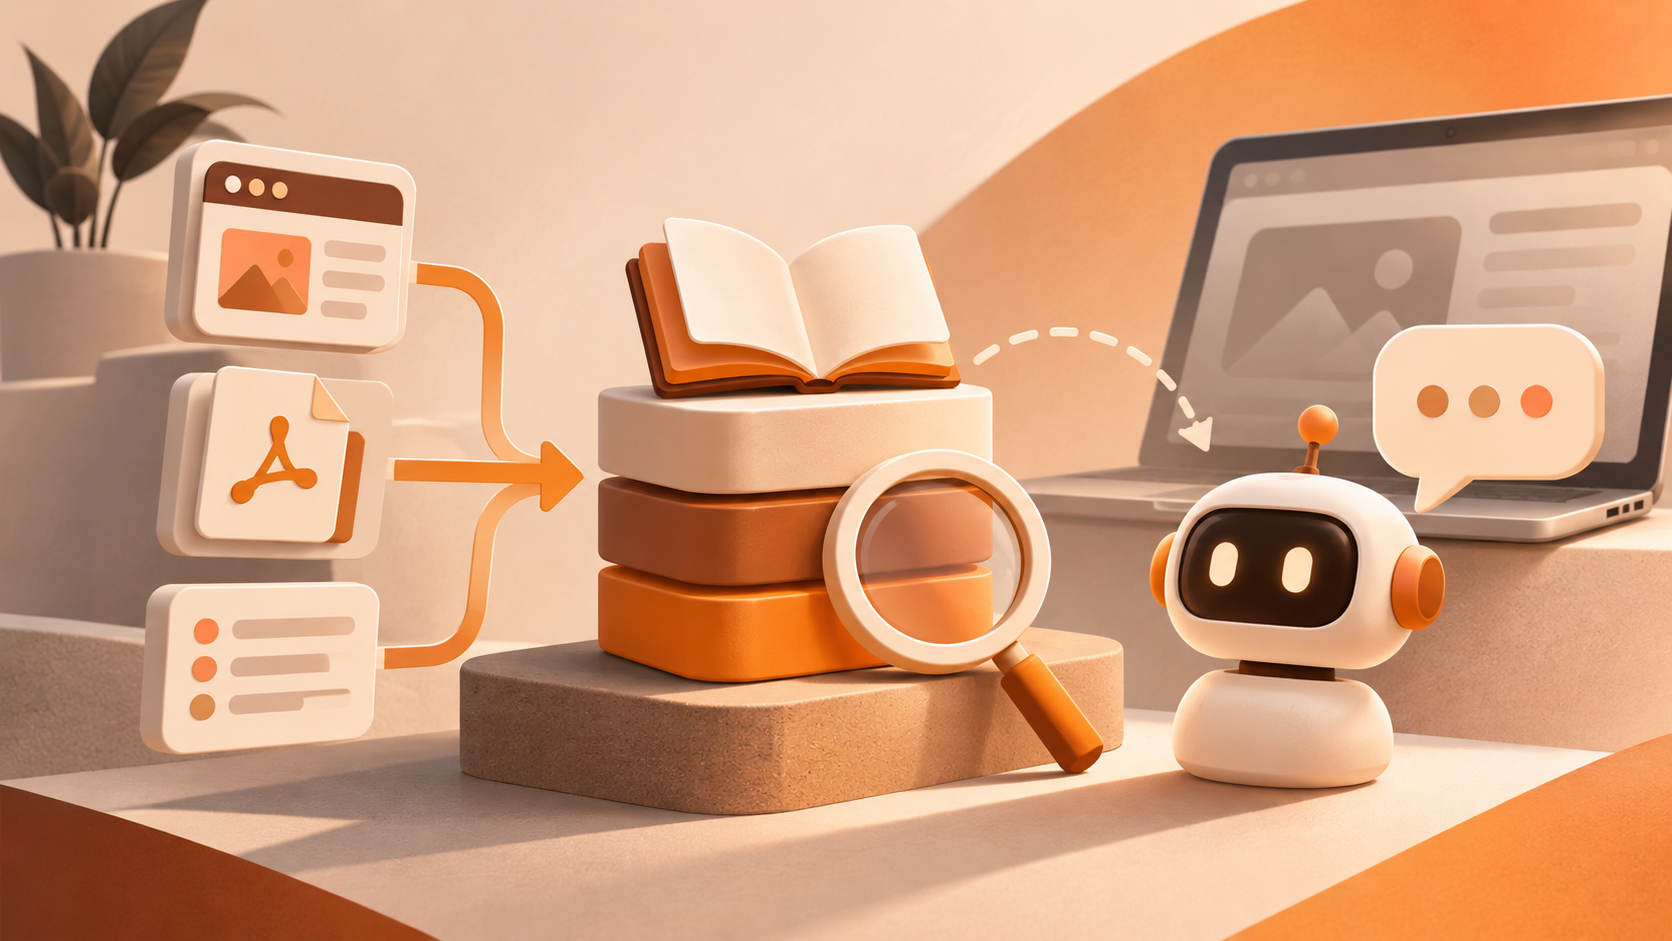
Für den Aufbau einer Wissensdatenbank gibt es meist drei Wege: Website-Import, Datei-Upload und FAQ-Eingabe. Am Beispiel der Implementierung des Alibaba-Cloud-KI-Kundenservice: Nach Aktivierung des Dienstes analysiert das System automatisch öffentliche Website-Inhalte als initiale Wissensdatenbank; die Crawling-Dauer hängt von der Inhaltsmenge der Website ab. Der Datei-Upload unterstützt sechs Formate: pdf, doc, docx, txt, markdown und excel. FAQ dienen der Eingabe von Standardfrage-Antwort-Paaren; wenn eine Nutzerfrage gleichzeitig mehrere Wissensquellen trifft, verwendet das System vorrangig die Standardantwort aus den FAQ (Alibaba-Cloud-KI-Kundenservice-Dokumentation).
Für die operative Umsetzung sollten einige Maßnahmen als feste Prozesse etabliert werden:
- Nach dem Website-Import die Liste der gecrawlten Seiten durchgehen und veraltete Aktionsseiten sowie Entwurfsseiten löschen;
- Bei Inhaltsaktualisierungen manuell erneut crawlen oder eine zeitgesteuerte automatische Synchronisierung aktivieren, damit die Wissensdatenbank nicht drei Monate alt bleibt;
- Die zehn Fragengruppen, bei denen am häufigsten falsch geantwortet wird, als FAQ formulieren und mit Standardantworten den Spielraum des Modells für freie Formulierungen abdecken;
- Für jeden Wissenseintrag einen Verantwortlichen hinterlegen; sonst traut sich nach einem halben Jahr niemand, alte Dokumente zu löschen.
Schritt 3: Das Kundenservice-Fenster in die Website einbinden
Erst wenn die Wissensdatenbank funktioniert, kommt die äußere Konfiguration an die Reihe. Felder wie Fensterfarbe, Servicename, Servicebeschreibung und Eröffnungsfragen wirken wie Dekoration, beeinflussen aber tatsächlich die Qualität des ersten Dialogs: Wenn die Servicebeschreibung die Grenzen der Fähigkeiten klar benennt, fragen Nutzer nicht nach Dingen wie „Schreib mir einen Vertrag“, die außerhalb des Rahmens liegen; Eröffnungsfragen bieten Einstiege zu häufigen Themen und senken die Hemmschwelle für den ersten Satz des Nutzers deutlich (Alibaba-Cloud-KI-Kundenservice-Dokumentation).
Eine weitere leicht übersehene Konfiguration sind Kontaktinformationen. Wenn die KI das Problem des Nutzers nicht lösen kann, muss die Oberfläche Telefon, E-Mail oder andere alternative Kanäle anbieten; sonst verlässt der Nutzer die Seite tatsächlich, nachdem er mit „Ich weiß es nicht“ abgewiesen wurde.
Wenn die Website selbst ein Login-System hat, sollten öffentliches Wissen und Wissen, das erst nach dem Login sichtbar ist, zwei getrennte Wissensbereiche bilden. Um diese Schichtung zu erleichtern, sollte die zugrunde liegende Website am besten Konto-Funktionen besitzen – beispielsweise umfasst der Website-Funktionsumfang von we0 ein Basis-Kontosystem mit E-Mail-Verifizierung sowie Google- und GitHub-Login und ein CMS-Backend von der Nutzerverwaltung bis zur Inhaltswartung (we0 Funktionsübersicht). Eine solche Basis spart den Aufwand, Login und Inhaltswartung selbst zusammenzubauen.
Wie vermeidet man, dass die KI nicht existierende Produktinformationen erfindet?
Das ist das praktischste Risiko bei der Integration: Ein Kunde fragt „Unterstützt ihr SAML-Single-Sign-on?“, und das Modell gibt, um das Gespräch fortzusetzen, sehr wahrscheinlich ein plausibel klingendes „Ja“.
Solche Fehler lassen sich durch Einschränkungen statt durch Hoffen reduzieren. Die verfügbaren Mittel nach Kosten-Nutzen sortiert:
- Antwortbereich begrenzen: Ausdrücklich verlangen, dass das Modell nur auf Basis der abgerufenen Passagen antwortet; wenn der Abruf leer ist, direkt sagen, dass die Wissensdatenbank dazu nichts enthält.
- Fallback-Formulierung vorgeben: Bei keinem Treffer nicht leerlaufen lassen, sondern den Nutzer bitten, die Frage anders zu formulieren, oder an einen Menschen übergeben und einen Bewertungsbutton für negatives Feedback beibehalten.
- FAQ priorisieren: Punkte wie Parameter, Preise und Compliance, bei denen keine Fehler passieren dürfen, als Standardfragen formulieren und sie die freie Formulierung des Modells übersteuern lassen.
- Quellen zwingend angeben: Antworten mit Quellenlinks versehen; Nutzer können prüfen, und Sie können später nachvollziehen.
- Vor dem Launch stichprobenartig prüfen: Aus historischen Fragen in echten Kundenservice-Tickets einen Testdatensatz erstellen und Antworten Zeile für Zeile mit den Dokumenten vergleichen. Nicht mit Fragen wie „Hallo“ oder „Wo ist Ihr Unternehmen?“ abnehmen.
Eine nutzbare Systemanweisung sieht ungefähr so aus:
Du bist der Produktkundenservice dieser Website. Beantworte Fragen ausschließlich anhand der unten abgerufenen Passagen.
Wenn in den Passagen keine Antwort enthalten ist, antworte direkt „In der Wissensdatenbank sind dazu keine Informationen vorhanden“ und weise den Nutzer auf die Kontaktinformationen hin.
Spekuliere nicht über Funktionen, Preise, Versionen oder Zusagen, die nicht in den Passagen vorkommen.
Gib am Ende der Antwort die Titel der Quellseiten als Liste an.
Können Produkte anhand der Nutzerfrage empfohlen werden?
Ja, aber eine Empfehlung muss auf Bedingungen beruhen, die in den Materialien tatsächlich vorhanden sind. Eine praktikable Methode besteht darin, „Empfehlung“ zu „Filterung nach Bedingungen“ herabzustufen: Aus der Nutzerbeschreibung Elemente wie Szenario, Größe und Deployment-Art extrahieren, sie auf ausdrücklich dokumentierte Versionsunterschiede oder Paketaufteilungen abbilden und schließlich auf die entsprechende Produktseite verweisen. So ist jeder Empfehlungssatz nachvollziehbar; umgekehrt bedeutet es, das Modell frei „die am besten zu Ihnen passende Lösung“ formulieren zu lassen, dass es unbestätigte geschäftliche Zusagen für Sie macht.
Auch die Datenseite kann helfen. Bei einigen Kundenservice-Systemen fasst ein Datenpanel Fragen nach Kategorien zusammen; Produktempfehlungen sind eine davon, und gleichzeitig werden Sitzungszahl, Nutzerzahl, Anzahl beantworteter Fragen und Problemlösungsrate (Anzahl beantworteter Fragen ÷ Gesamtzahl der Fragen × 100 %) erfasst (Alibaba-Cloud-KI-Kundenservice-Dokumentation). Wenn die Lösungsrate bei Empfehlungsfragen dauerhaft niedrig ist, liegt es meist nicht am Modell, sondern daran, dass auf den Produktseiten die für die Entscheidung nötigen Informationen fehlen – Vergleichsdimensionen, Preisbereiche, geeignete und ungeeignete Szenarien.
Wie komplexe Fragen an menschliche Mitarbeiter übergeben werden
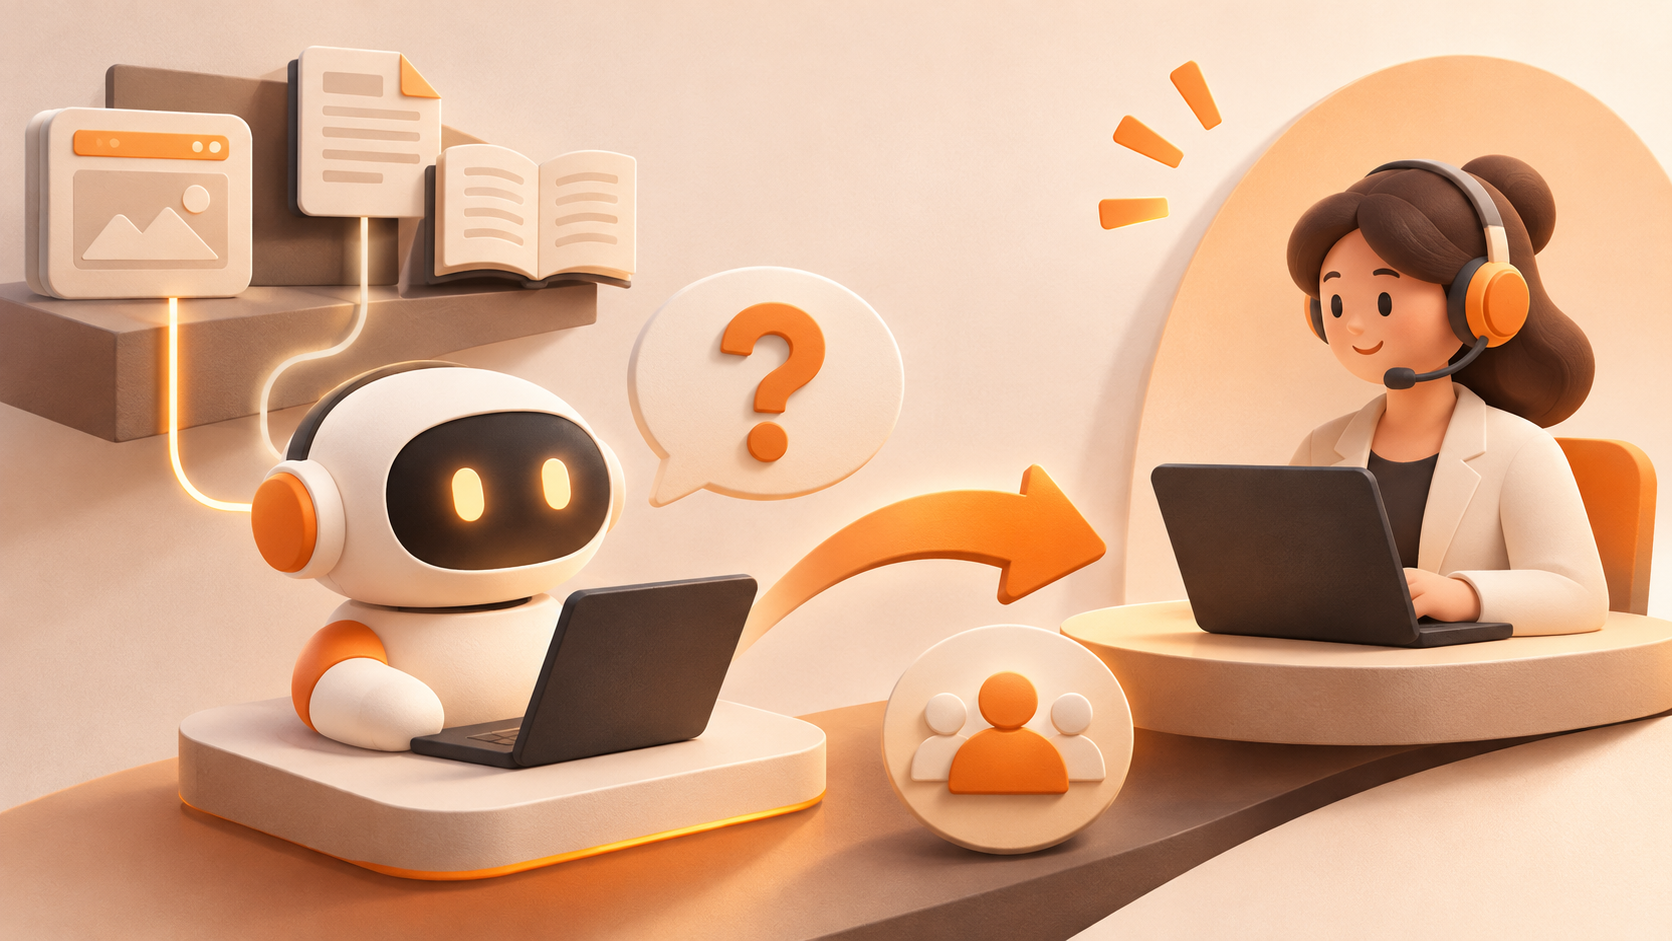
Der Wert eines KI-Kundenservice besteht nicht darin, Menschen abzublocken, sondern einfache Fragen zu absorbieren und komplexe Fragen mit Kontext zu übergeben. Bedingungen für die Übergabe an Menschen sollten als Liste formuliert werden, damit „es kommt darauf an“ vermieden wird:
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
- Das Thema trifft Schlüsselwörter mit hohem Wert oder hohem Risiko: Angebote, Vertragsklauseln, kundenspezifische Entwicklung, Störungen und Datensicherheit, Beschwerden;
- zwei Runden in Folge nicht gelöst oder der Nutzer verlangt ausdrücklich einen Menschen;
- die Stimmung des Nutzers ist deutlich negativ, es gibt klare Unzufriedenheitsäußerungen;
- die Trefferquote der Wissensdatenbank ist leer und die Frage betrifft Angelegenheiten wie Konto oder Bestellung, für die ein Blick ins Backend nötig ist.
Bei der Übergabe sollten Gesprächszusammenfassung, bereits abgerufene Quellen und die Seite, auf der sich der Nutzer befindet, an den Menschen übergeben werden, damit der Kunde nicht von vorne erzählen muss. Dieser Schritt ist technisch nicht schwierig, aber der mit dem größten Erlebnisgefälle – viele Unternehmen bauen einen KI-Kundenservice, machen die Übergabe an Menschen aber zu „Bitte beschreiben Sie Ihr Problem erneut“.
Gespräche protokollieren und als Grundlage für die Aktualisierung der Wissensdatenbank nutzen
Kundenservice-Gespräche sind die günstigste Bedarfsforschung. Systeme behalten in der Regel den Gesprächsverlauf, einschließlich Nutzerfrage, KI-Antwort und der Wissensquelle, auf der die Antwort beruht, und unterstützen Filter nach Status (z. B. beantwortet, teilweise beantwortet) (Alibaba-Cloud-KI-Kundenservice-Dokumentation). Wenn man diesen Datensatz einmal pro Woche zwanzig Minuten durchsieht, erhält man drei Arten von Signalen:
- Fragen, die wiederholt auftauchen, aber schlecht beantwortet werden: In der Wissensdatenbank fehlt ein Eintrag; FAQ ergänzen;
- Fragen, die vage beantwortet werden: Die Dokumentation ist zu abstrakt; konkrete Parameter oder Beispiele ergänzen;
- Fragen, die Kunden aktiv stellen, auf die Sie aber nicht vorbereitet sind: Signal für Vorverkaufsbedarf, das an Produkt und Marketing weitergegeben werden sollte.
Einige Systeme bieten einen Einstieg zur „Fragenoptimierung“, mit dem ungelöste Fragen mit einem Klick in neue FAQ-Einträge umgewandelt werden; es muss nur noch die Standardantwort ergänzt werden. Wenn man das in den Wochenmeeting-Prozess aufnimmt, wächst die Wissensdatenbank von selbst.
Nach dem Launch: Aktualisierungsrhythmus und Verantwortliche für die Wissensdatenbank
Wenn ein KI-Kundenservice drei Monate nach dem Launch anfängt, falsch zu antworten, liegt das fast immer daran, dass sich niemand um die Wissensdatenbank kümmert. Empfohlen wird eine Wartung nach festem Rhythmus:
- Wöchentlich: Liste ungelöster Fragen bereinigen, 3–5 FAQ ergänzen;
- Monatlich: Konsistenz von Preisseite, Paketseite und Dokumentation prüfen, veraltete Aktionsinhalte offline nehmen;
- Bei jedem Release: am Veröffentlichungstag Funktionsdokumentation und Changelog aktualisieren, damit die KI nicht zur Sprecherin der alten Version wird;
- Vierteljährlich: 30 echte Gespräche stichprobenartig prüfen, den Testdatensatz erneut durchlaufen lassen und Veränderungen der Lösungsrate dokumentieren.
Der Verantwortliche muss nicht der Leiter des Kundenservice sein, aber es muss eine Person sein und nicht „das Team“. Mehrere Personen gemeinsam zu verantworten bedeutet niemand verantwortet es.
Beispiel für die vollständige Kette bei einem SaaS-Unternehmen
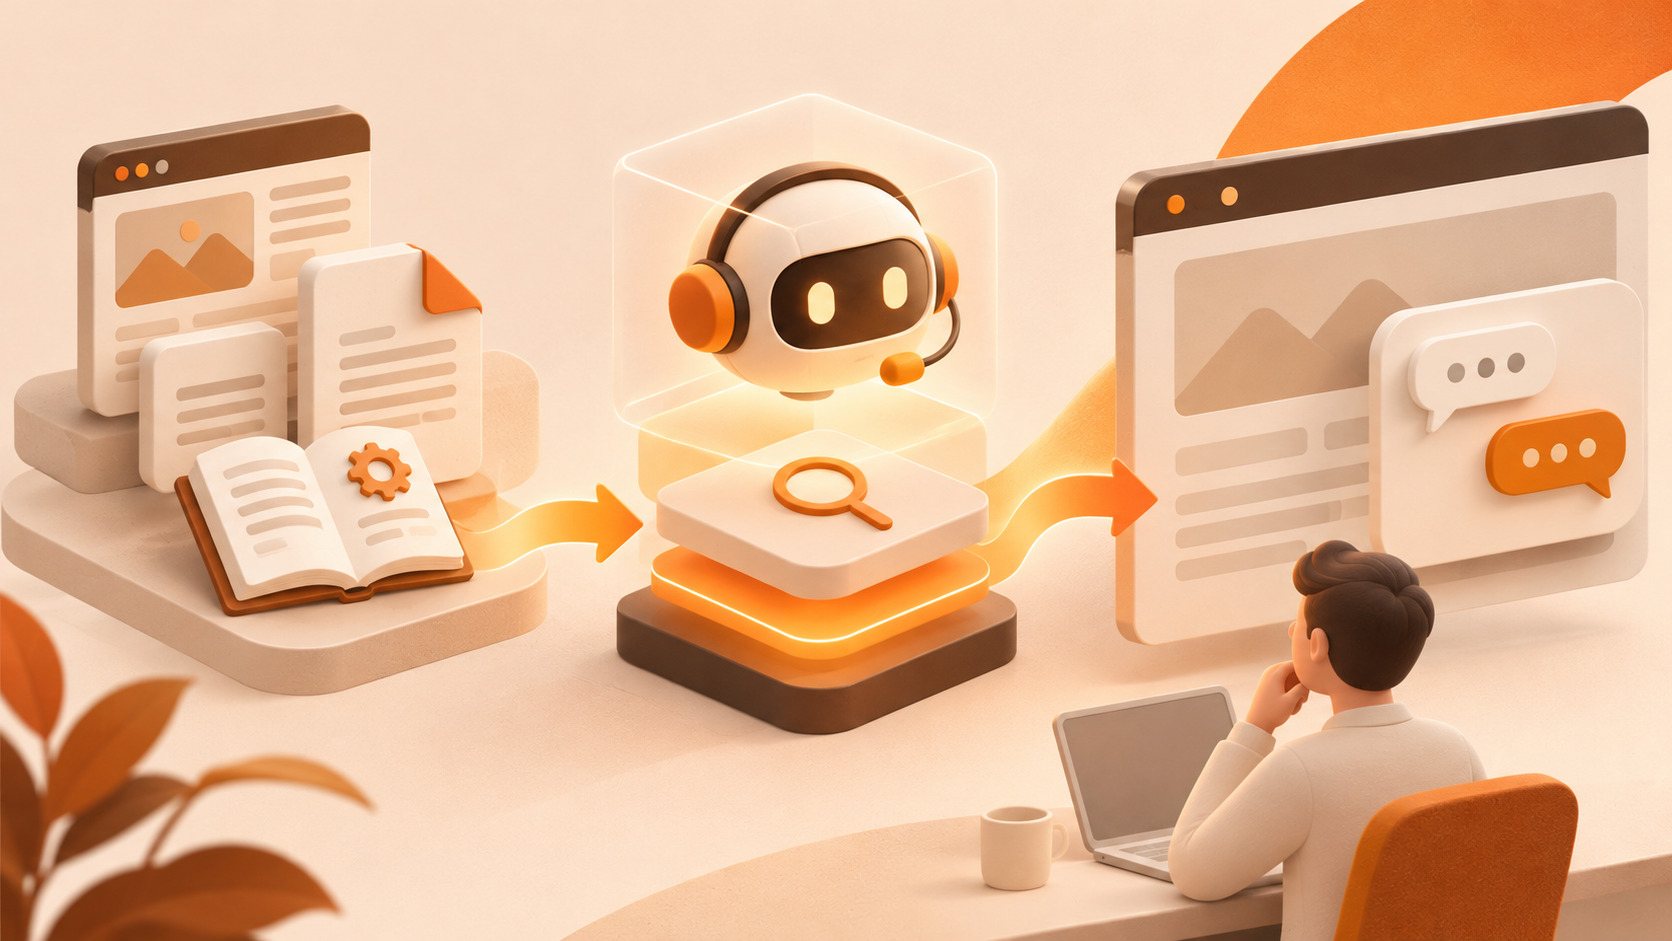
Angenommen, ein SaaS-Unternehmen für Daten-Dashboards hat gerade eine neue Website gelauncht; das Produkt gibt es in drei Formen: kostenlose Version, Team-Version und Private Deployment. Die Dokumentation ist auf Hilfe-Center und PDF-Handbücher verteilt.
- Nutzerfrage: Ein Besucher gibt unten rechts auf der Preisseite in das Fenster ein: „Wir sind ein Analyseteam mit 80 Personen, die Daten dürfen das interne Netz nicht verlassen, wie berechnen Sie das?“
- Abruf: Das System ruft relevante Inhalte im Hilfe-Center, in der Beschreibung für Private Deployment und im PDF-Preishandbuch ab.
- Antwort organisieren: Zuerst beantworten, ob die Deployment-Form „Daten verlassen das interne Netz nicht“ erfüllt, dann die Preisbemessungsdimensionen der Private-Deployment-Lösung erläutern, im Ton zurückhaltend, ohne konkrete Beträge zuzusagen.
- Relevante Seiten bereitstellen: Die Beschreibungsseite für Private Deployment und den Einstieg zur Kontaktaufnahme mit dem Vertrieb anhängen.
- Bei Nichtlösung an Menschen übergeben: Der Nutzer fragt zu Vertragsklauseln und Implementierungsdauer nach; Schlüsselwörter mit hohem Risiko werden getroffen, direkt an einen Menschen übergeben und eine Gesprächszusammenfassung beigefügt.
- Festhalten: Diese Frage landet in der Liste ungelöster Fragen; das Betriebsteam ergänzt eine FAQ „Wie wird Private Deployment bepreist?“.
In der gesamten Kette hat die KI nicht „geraten“; jeder Schritt lässt sich auf ein Dokument zurückführen.
Welche Rolle we0 in dieser Kette übernehmen kann und was selbst gebaut werden muss
Wenn die Unternehmenswebsite selbst noch im Aufbau ist, ist es einfacher, die Kundenservice-Funktionen von Anfang an mitzuplanen. we0 positioniert sich als Sammlung von Website-Funktionen für die formale Auslieferung; die offizielle Funktionsliste umfasst die Integration von KI-Funktionen (Generierungsfunktionen für Text, Bild, Video, Audio usw., geeignet für die Erweiterung zu dialogbasierten Produkten), CMS und Verwaltungsbackend, Authentifizierungssystem, mehrsprachige Organisation sowie Veröffentlichung und Go-live; in den Anwendungsszenarien werden ausdrücklich Anwendungen wie intelligenter Kundenservice und Wissensdatenbanken genannt (we0 Funktionsübersicht).
Die Grenzen müssen klar benannt werden: Dies sind Basis-Funktionen für Website-Erstellung und KI-Integration, nicht gleichbedeutend mit einem sofort einsatzbereiten Unternehmens-Wissensdatenbank-Kundenservice. Dokumentenaufteilung und Indexierung, Retrieval-Strategie, Filterung von Wissen nach Nutzerberechtigungen, Übergabe an menschlichen Kundenservice und Ticket-Verknüpfung müssen in der Regel auf Basis der Full-Stack-Codegenerierungsfähigkeit selbst entwickelt oder in RAG- und Kundenservice-Systeme von Drittanbietern integriert werden. Bei der Bewertung sollte man „eine Website generieren können“ und „einen Wissensdatenbank-Kundenservice betreiben können“ als zwei Dinge behandeln; so vermeidet man, erst nach dem Launch zu merken, dass die halbe Kette fehlt.
Compliance und Inhaltsgrenzen: Welche Materialien nicht gecrawlt werden dürfen
Je breiter die Wissensquellen, desto mehr muss man darauf achten, wie die Inhalte hineinkommen. Nur öffentliche, crawlbare eigene Inhalte und autorisierte Materialien importieren; keine Drittanbieter-Inhalte durch Umgehung von Paywalls, Login-Beschränkungen oder Anti-Crawling-Mechanismen beschaffen. Eine Stellungnahme eines Beraters beim Gerichtshof der Europäischen Union gibt hier einen Anhaltspunkt: Wenn ein Chatbot bei der Antwort in Echtzeit Nachrichteninhalte abruft und wiederverwendet, kann dies die Rechte des Verlegers verletzen, wenn die Inhalte illegal beschafft wurden oder die Formulierung der Antwort nahezu das Original ersetzen kann; eine faktische Zusammenfassung in eigenen Worten mit Link zum Original birgt deutlich geringeres Risiko (Interpretation zum relevanten Fall).
Für den Kundenservice auf einer Unternehmenswebsite übersetzt sich diese Regel einfach: In der Wissensdatenbank liegen eigene Materialien und autorisierte Inhalte; Antworten bestehen überwiegend aus Zusammenfassungen und Quellenangaben und geben fremde Inhalte nicht absatzweise wieder.
Häufig gestellte Fragen
Kann ein KI-Kundenservice PDF und Word direkt lesen?
Ja. Bei gängigen Website- und Kundenservice-Plattformen unterstützt der Datei-Upload Formate wie pdf, doc, docx, txt, markdown und excel; nach dem Upload durchlaufen die Dateien einen Parsing-Prozess, und nach erfolgreichem Parsing können sie am Abruf teilnehmen (Alibaba-Cloud-KI-Kundenservice-Dokumentation). Gescannte PDFs müssen zuerst in abrufbaren Text umgewandelt werden.
Die Preise in der Wissensdatenbank ändern sich häufig – wie stellt man sicher, dass richtig geantwortet wird?
Häufig wechselnde Informationen wie Preise und Pakete sollten separat als FAQ-Standardantworten angelegt und mit einer monatlichen Prüfung versehen werden; Preise nicht über mehrere PDFs verteilen, sonst ruft das Modell unterschiedliche Versionen ab.
Kann ein KI-Kundenservice interne Materialien an Kunden verraten?
Das hängt davon ab, wie der Wissensbereich abgegrenzt ist. Öffentliches Wissen und interne Materialien sollten in unterschiedlichen Wissensbereichen liegen; interne Materialien sind nur für bestimmte Rollen nach dem Login zugänglich, statt sich darauf zu verlassen, dass das Modell per Prompt „nichts davon sagt“.
Sollten Antworten Quellenlinks enthalten?
Ja, empfohlen. Das erhöht die Glaubwürdigkeit und ermöglicht es Ihnen, bei der Nachbereitung zu bestätigen, auf welcher Dokumentversion die Antwort beruht.
Wie lange dauert der Launch?
Der größte Zeitaufwand liegt in der Materialaufbereitung und der stichprobenartigen Prüfung mit dem Testdatensatz, nicht in der technischen Integration. Zuerst eine Version mit 70 % Abdeckung live zu nehmen und wöchentlich FAQ zu ergänzen, ist realistischer, als auf einmal vollständige Abdeckung anzustreben.
Verwandte Tools
- Wissensdatenbank- und Kundenservice-Konsole: Verwaltung von Website-Import, Datei-Upload, FAQ und Fragenoptimierung
- CMS und Content-Backend: Pflege von Hilfe-Center, Produktdokumentation und Preisseite inklusive Versionen
- Website-Analysewerkzeuge: Beobachtung von Klicks und Conversion-Pfaden am Dialogeinstieg
- Ticket-/IM-System: Übernahme von menschlichen Gesprächen und Gesprächszusammenfassungen, die von der KI übergeben werden
- RAG- und Vektorsuchdienste: Nutzung beim Aufbau einer eigenen Retrieval-Schicht
Verwandte Links
- Alibaba-Cloud-KI-Kundenservice-Dokumentation
- Cloudera RAG-Studio-Anwendungsbeschreibung
- we0 Funktionsübersicht
- Interpretation zu KI-Chatbots und Urheberrechtsfällen bei Nachrichten
Zusammenfassung
Beim Einbau eines KI-Kundenservice in eine Unternehmenswebsite liegt die eigentliche Arbeit nicht im Chatfenster, sondern in der Wissensdatenbank: Zuerst werden Produktmaterialien nach den drei Kategorien Webseiten, Dokumente und FAQ erfasst und Versionen konsolidiert; dann wird mit RAG eine Kette aus „Abruf – Generierung – Zitat“ aufgebaut; das Anbringen des Fensters ist nur der letzte Schritt. Nach dem Launch werden Erfindungsrisiken durch begrenzten Antwortbereich, FAQ-Priorität, Pflichtquellen und Stichproben mit Testdatensatz eingedämmt, komplexe Fragen durch eine Übergabeliste an Menschen abgesichert und die Wissensdatenbank durch eine wöchentliche Liste ungelöster Fragen kontinuierlich weiterentwickelt. Wenn diese Dinge zu einem festen Rhythmus mit Verantwortlichen werden, reduziert der KI-Kundenservice tatsächlich wiederkehrende Anfragen, statt falsche Antworten flüssiger zu formulieren.