Das Keyword-Suchvolumen beantwortet die Frage "Wie viele Menschen suchen mit dieser Wortgruppe" – es beantwortet nicht die Frage "Was wird diese Person vor ihrer Entscheidung noch fragen". Die KI-Suche macht Letzteres zur entscheidenden Variable: Wenn Nutzer in ChatGPT, Perplexity, Gemini oder Google AI Mode eine Frage mit einschränkenden Bedingungen stellen, generiert die Engine selbst mehrere Unterabfragen für die Recherche und setzt die gefundenen Absätze zu einer Antwort mit Quellenangaben zusammen. Ob du zitiert wirst, hängt nicht mehr nur davon ab, ob du für ein bestimmtes Wort rankst, sondern davon, ob die Seite Absätze enthält, die einzeln extrahiert werden können und genau eine Unterabfrage beantworten.
Daher ist die genauere Formulierung: Das Suchvolumen bleibt ein nützliches Signal für die Nachfragegröße, aber es ist ein Startindikator, kein Endindikator. Die Keyword-Recherche muss drei Dinge ergänzen – die vollständige Fragenkette hinter dieser Nachfrage, die Rechercheform für jede Frage und ob die Seite extrahierbare Antwortblöcke besitzt.
Warum die ausschließliche Betrachtung des Suchvolumens die tatsächliche Kaufabsicht verfehlt
Der traditionelle Prozess ist "Hauptkeyword → verwandte Wörter → Inhalt", er geht davon aus, dass jede Suche eine unabhängige, wortformfeste Nachfrage ist. Das Nutzerverhalten hat sich jedoch verändert: Eine echte Frage enthält oft gleichzeitig Budget, Szenario, Kompatibilität und Nutzungsweise, zum Beispiel "ein Laptop unter 15.000, mit dem man Videos schneiden kann, gute Akkulaufzeit, praktisch für Dienstreisen". Diese Bedingungen werden in der KI-Suche in verschiedene Zweige aufgeteilt und separat recherchiert.
Nehmen wir B2B-Beschaffung als Beispiel: Hinter "best CRM software" steht normalerweise eine Reihe aufeinanderfolgender Nachfragen: Welches eignet sich für kleine Unternehmen? Unterstützt es E-Mail-Automatisierung? Kann es mit Shopify verbunden werden? Welches hat die niedrigste Monatsgebühr? Der Recherchewert dieser vier Fragen kann höher sein als der des ursprünglichen Keywords, aber das monatliche Suchvolumen liegt oft nahe null – nur wenige tippen den vollständigen Fragesatz in das Suchfeld, aber sie stellen diese Fragen der KI.
Daraus ergeben sich zwei Lücken. Erstens: Niedriges Suchvolumen bedeutet nicht niedrigen kommerziellen Wert. Zweitens: Das Suchvolumen gibt keinerlei Hinweis auf die Antwortform – es sagt dir nicht, dass Vergleichsanforderungen eine Tabelle benötigen, Prozessanforderungen nummerierte Schritte und Definitionsanforderungen eine eigenständig bestehende Erklärung von dreißig bis fünfzig Wörtern. Und genau diese Formen entscheiden darüber, ob der Inhalt gefunden werden kann.
Was ist Query Fan-Out (Abfrage-Fächerung)
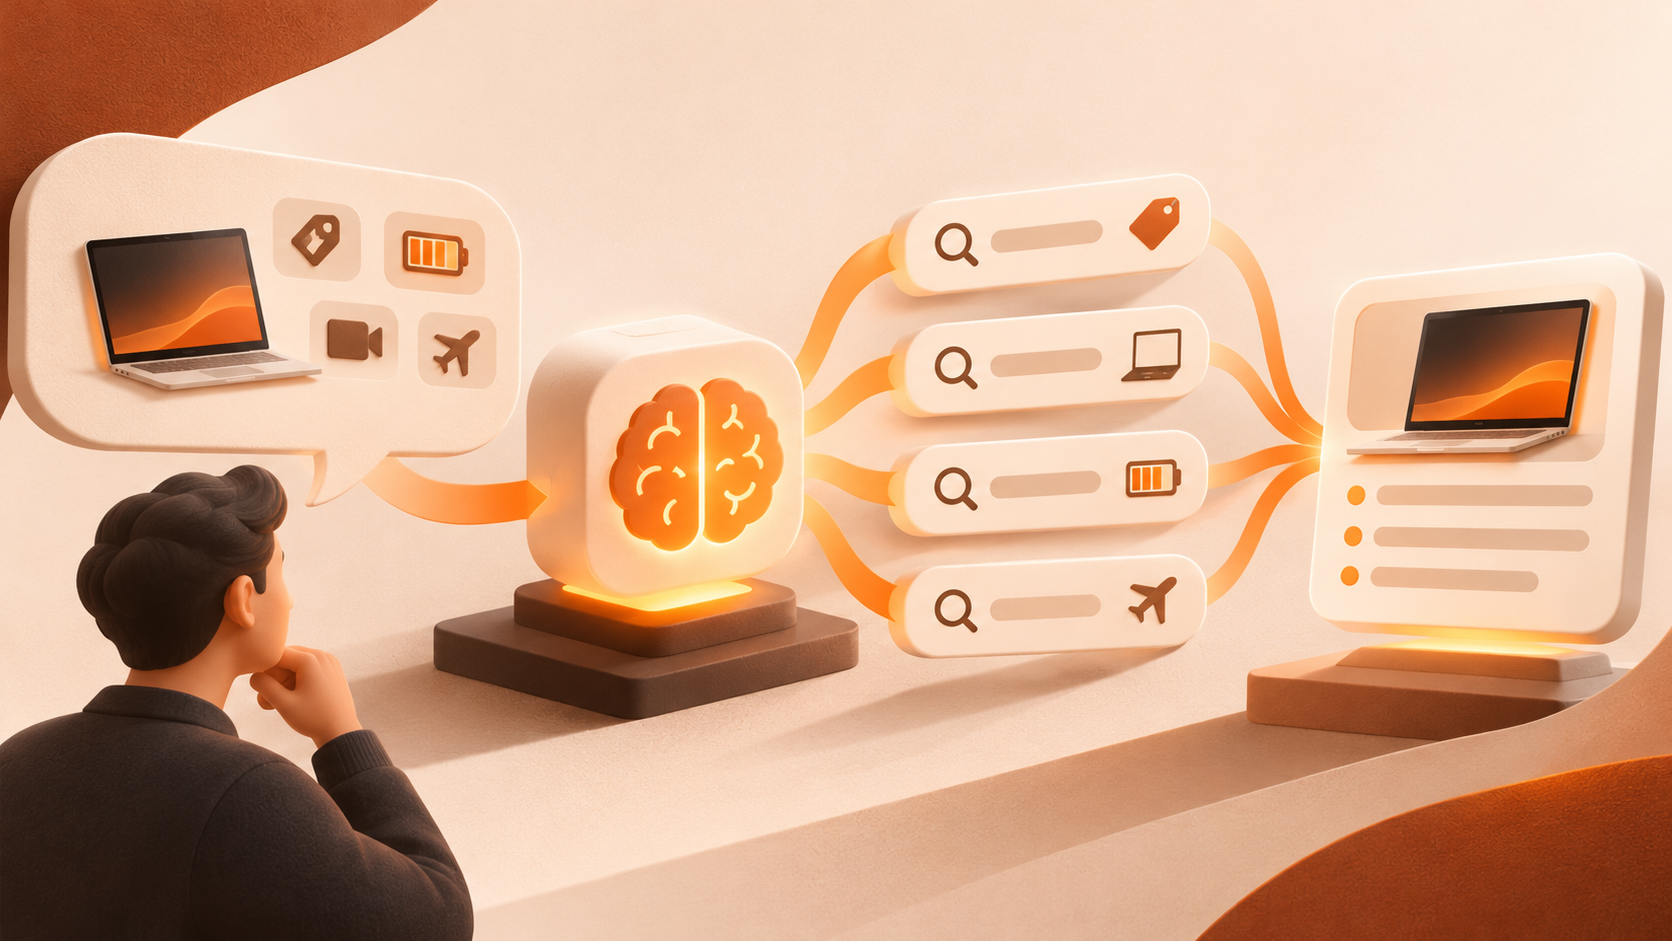
Query Fan-Out bezeichnet, dass KI-Suchmaschinen eine Frage in mehrere vom Modell selbst generierte Unterabfragen aufteilen, parallel recherchieren, die zurückgegebenen Absätze bewerten und dann eine Antwort mit Quellenangaben synthetisieren. Google erklärt in seinen Dokumentationen zu KI-Funktionen, dass Erlebnisse wie AI Mode und AI Overviews diese Technik nutzen können, um "eine breitere und vielfältigere Gruppe nützlicher Links" als bei herkömmlichen Ergebnisseiten anzuzeigen (Google Search Central).
Technisch läuft dies in der Regel in fünf Schritten ab: Absicht und Komplexität erkennen, Unterabfragen generieren, stark duplizierte Unterabfragen filtern, parallel recherchieren, Antwort synthetisieren und mit Quellen versehen. Der dritte Schritt wird am leichtesten übersehen: Das System bevorzugt Abdeckung statt Wiederholung; zwei inhaltlich ähnliche Seiten gelangen normalerweise nicht gleichzeitig in die Recherche.
Was die Größenordnung betrifft, so ergibt die öffentliche Beobachtung ungefähr: AI Mode erzeugt pro Anfrage etwa 8–12 parallele Unterabfragen (in der Praxis häufig 3–8); ChatGPT generiert durchschnittlich 4,7 Unterabfragen pro Websuche; "Hunderte von Suchen" gilt nur für mehrstufige Pipelines wie Deep Search, mit einer Obergrenze von etwa 20 Runden. Entscheidender ist die Form der Unterabfragen – eine reverse Analyse zeigt, dass sie durchschnittlich 70–80 Wörter lang sind, was etwa dem 17- bis 26-fachen der Komplexität traditioneller Keywords mit drei oder vier Wörtern entspricht (MaximusLabs). Die Engine sucht nicht mit deinem Keyword, sondern mit einer vollständigen Beschreibung, die Kontext und Nutzungsszenario enthält.
Fan-Out tritt nicht bedingungslos auf. Relevante Patente binden die Entscheidung, ob Unterabfragen generiert werden, an Eingabelänge, Abfragehäufigkeit, Ergebnisqualität, Token-Anzahl und Serverlast. Kurze navigationsorientierte oder einfache faktische Fragen führen oft nur zu einer Recherche, die der ursprünglichen Frage nahekommt; lange vergleichende oder bewertende Fragen entfalten den größten Zweigbaum. Das Budget sollte daher vorrangig auf komplexe geschäftliche Fragen konzentriert werden.
Die Suchabsicht wandelt sich von "einem Wort" zu "einer Fragenkette"
Die vier Absichtstypen – navigierend, informierend, kommerziell untersuchend, transaktional – bleiben gültig, aber in der KI-Suche erweitert sich eine Hauptabsicht zu mehreren Unterabsichten. Nehmen wir "How do I choose the best SEO tool for my business?" als Beispiel: Die Hauptabsicht ist die Tool-Auswahl, die Unterabsichten umfassen jedoch: Welche Art von Tool brauche ich? Wie hoch ist das Budget? Welche Funktionen sind entscheidend? Brauche ich technische SEO-Fähigkeiten? Was eignet sich für Anfänger bzw. Agenturen?
Hier muss zwischen zwei oft verwechselten Konzepten unterschieden werden: Keyword-Clustering gruppiert ähnliche Wörter nach Absicht, Semantik und SERP-Überschneidung und löst die Frage, wie Inhalte organisiert werden; Query Fan-Out beschreibt, wie sich eine Frage in mehrere Recherchepfade aufspaltet, einschließlich Themen, die der Nutzer nie explizit genannt hat, und löst die Frage, wie die Recherche abläuft (SEO for Today). Ersteres ist eine redaktionelle Methode, Letzteres ein technischer Mechanismus – sie können einander nicht ersetzen.
Tabelle: Acht Arten von Unterabfragen und die benötigten Inhaltsformen
Nach der Kategorisierung der Fan-Out-Zweige erzeugt eine Anfrage in der Regel acht Arten von Unterabfragen, die jeweils unterschiedliche Absatzformen erfordern. Diese Tabelle kann direkt als Selbstprüfungsliste für Inhalte dienen:
| Unterabfragetyp | Beispiel | Benötigte Inhaltsform |
|---|---|---|
| Exakte Übereinstimmung | best CRM software | Antwortblock, der Optionen direkt nennt |
| Semantische Variante | top CRM platforms | Dieselbe Antwort mit einer anderen Formulierung des Käufers wiedergeben |
| Navigierend | Preis-seite eines Anbieters | Crawlbare, klar strukturierte Produkt- oder Preisseite |
| Vergleichend | A vs B for small business | Tabellenzeile mit klaren Attributen |
| Definierend | what is pipeline attribution | Eigenständig bestehende Kurzdefinition von dreißig bis fünfzig Wörtern |
| Prozessual | how to migrate CRM data | Nummerierte Schritte, ein Schritt eine Aktion |
| Listenbasiert | CRM tools for agencies | Gut scannbare Liste mit Filterkriterien |
| Szenariobasiert | CRM for a 3-person team | Einschränkender Satz, der Teamgröße und Nutzungsszenario nennt |
Reine Fließtextseiten decken in der Regel nur zwei bis drei dieser Typen ab: Ohne Tabelle gibt es keinen Inhalt für den Vergleichszweig; ohne nummerierte Schritte bleibt der Prozesszweig leer; wenn nie eine Teamgröße erwähnt wurde, passt der Szenariozweig nicht. Format ist hier keine Layout-Präferenz, sondern Auffindbarkeit selbst.
Von einem Keyword zur vollständigen Fragenkette: Eine Fünf-Schritte-Methode
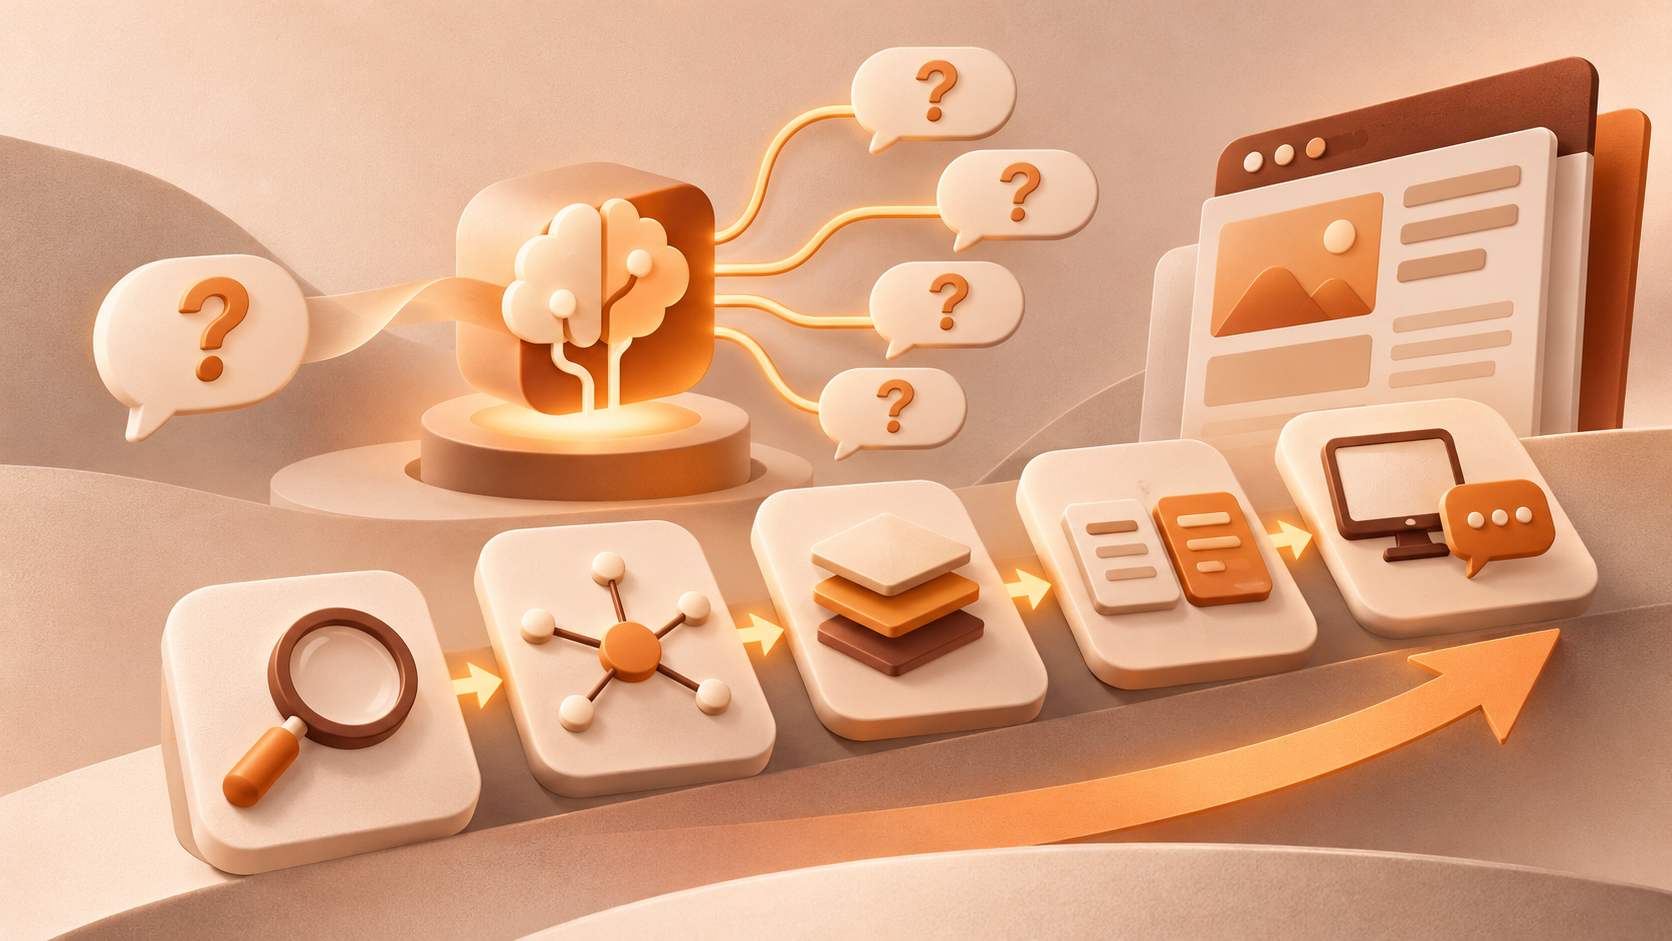
Schritt eins: Seed-Prompts statt Keywords auflisten. Sammle 10–20 Fragen, die idealen Kunden vor der Terminbuchung tatsächlich stellen würden – je umgangssprachlicher, desto besser.
Schritt zwei: Jeden Seed in Perplexity eingeben. Die Oberfläche zeigt die tatsächlich ausgeführten Recherchen an – einer der wenigen Orte, an denen Fan-Out-Verhalten beobachtet werden kann.
Schritt drei: Die 5–8 verwandten Fragen, die es mitbringt, einzeln notieren – im Originalwortlaut, nicht in Keywords umschreiben.
Schritt vier: Dieselben Seeds mit einem Q&A-Tool wie AlsoAsked gegenprüfen, um übersehene Zweige zu ergänzen.
Schritt fünf: Die überlebenden Unterfragen den H2- und H3-Überschriften bestehender Seiten zuordnen. Das Prinzip lautet "ein Frage-Cluster eine Seite", nicht "eine Unterabfrage eine Seite": Für jede Unterabfrage eine eigene dünne Seite zu erstellen, verwässert die Autorität und berührt Googles Richtlinien zu massenhaftem Content-Missbrauch (MaximusLabs).
Es muss klargestellt werden, dass der echte Zweigbaum konversationell und personalisiert ist und von außen nicht vollständig nachgebildet werden kann. Die Fragenkette ist eine rekonstruierte Annäherung, geeignet für die Abdeckungsplanung, nicht als präzise Daten für die externe Berichterstattung.
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Content-Cluster: Die Fragenkette in eine dreischichtige Struktur verwandeln
In der Umsetzung kann man drei Schichten unterscheiden: Die Pillar-Seite beantwortet "den vollständigen Rahmen, wie diese Entscheidung zu treffen ist"; Unterseiten übernehmen Unterfragen mit eigenständigem Suchbedarf, etwa einen Vergleich bestimmter Lösungsansätze oder die Preisstruktur einer Branche; FAQ-Blöcke übernehmen Randfragen wie Kompatibilität, Rückerstattung oder Mindestkonfiguration.
Ob eine Unterfrage eine eigene Seite benötigt, prüft man anhand von drei Kriterien: Wird sie in echten Gesprächen separat gestellt? Kann die Pillar-Seite ihre Beantwortungsaufgabe nicht übernehmen, ohne vom Thema abzuschweifen? Kannst du in einem Satz erklären, worin sie sich von Seiten gleicher Ebene unterscheidet? Erst wenn alle drei zutreffen, wird eine neue Seite erstellt.
Gleichzeitig muss man sich der unterschiedlichen Priorität im unteren Funnel bewusst sein. Bei kaufbezogenen Fragen konzentriert sich der Fan-Out in der Regel auf Preis, Lösung, kostenloses Kontingent, Rückerstattungsrichtlinien und Wettbewerbsvergleiche; Vergleichsseiten und Preisseiten gelangen daher leichter in den Kaufpfad als Definitionsseiten; Definitionsfragen werden von der Engine oft selbst beantwortet, sie zu gewinnen bringt eher nur eine Erwähnung.
Wie sollten FAQ und Produktseiten Aufgaben teilen
Beide übernehmen unterschiedliche Rechercheaufgaben; sie zu vermischen verschlechtert beide. Das Ziel der Produktseite ist es, "ob es zu mir passt" klar zu sagen: Wer es nutzt, welche Fähigkeiten enthalten sind, wo die Grenzen liegen, wie die Preisstruktur aussieht, wie man beginnt. Sie sollte explizit Teamgröße, Nutzungsszenarien, Integrationen und Einschränkungen nennen, denn genau diese einschränkenden Informationen werden von szenariobasierten Unterabfragen zum Abgleich verwendet.
Das Ziel der FAQ ist es, Entscheidungsreibung zu beseitigen und Randfragen zu beantworten, die nicht zum Hauptstrang gehören, aber sicher gestellt werden. Jede Antwort muss unabhängig vom Kontext bestehen können: Pronomen durch Entitätsnamen ersetzen, zuerst die Schlussfolgerung, dann die Bedingungen, Länge auf einige Dutzend Wörter begrenzen.
Auch die strukturelle Reihenfolge innerhalb der Seite ist eine Rechercheentscheidung. In Beobachtungen zum Zitatmodus konzentrieren sich etwa 44 % des Zitatanteils auf den ersten 30 % des Textes, danach nimmt er schrittweise ab (MaximusLabs). Daher sollte die kommerziellste Antwort im ersten Drittel der Seite erscheinen, nicht am Ende.
Können Suchmaschinen und konversationelle Suche gleichzeitig abgedeckt werden?
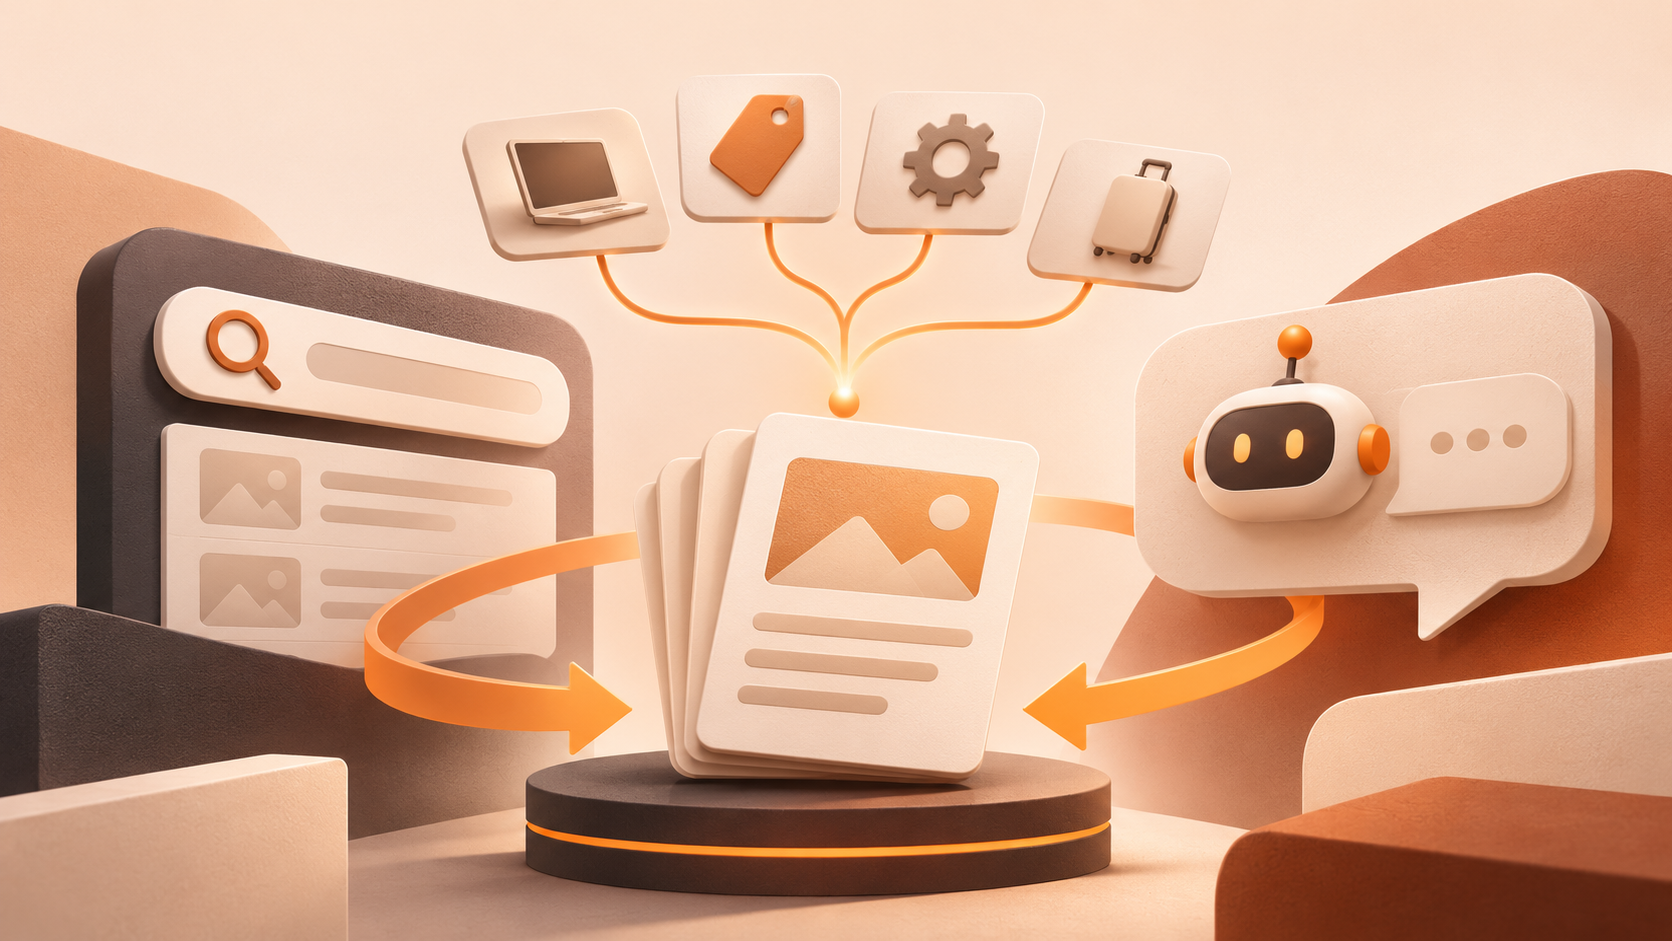
In den meisten Fällen ja, die Überschneidung ist größer als gedacht. Die Präferenzen der wichtigsten Einstiegspunkte widersprechen sich nicht: AI Mode legt Wert auf Unterthemen-Abdeckung und Absatzklarheit; ChatGPT auf eigenständige Q&A-Blöcke und professionelle Signale; Perplexity auf Aktualität und Quellentransparenz; der Forschungsmodus von Claude auf Tiefe und Methodik. Ihre Schnittmenge sind vorangestellte Antworten, sichtbare Quellen, klare Sprache und echte inhaltliche Tiefe.
Eine richtungsweisende Veränderung ist bemerkenswert: In öffentlichen Beobachtungen ist die Abhängigkeit der AI-Overview-Zitate von den Top-10- organischen Ergebnissen von etwa 76 % auf etwa 38 % gesunken; ein beträchtlicher Anteil der Zitate stammt von Positionen außerhalb der Top 100 (MaximusLabs). Das bedeutet nicht "Ranking ist nutzlos", sondern "Ranking ist nicht mehr die einzige Hürde für Zitate" – ob ein Absatz extrahiert werden kann und die Frage direkt beantwortet, gewinnt deutlich an Gewicht.
Die Grundlagen bleiben dennoch wichtig: technische Crawlbarkeit, Inhaltsstruktur, interne Verlinkung und strukturierte Daten sind nach wie vor Voraussetzungen für die Aufnahme in KI-Sucherlebnisse (Google Search Central).
Was Unternehmen jetzt tun sollten: Eine Checkliste mit sechs Punkten
| Priorität | Aktion | Erfüllungskriterium |
|---|---|---|
| 1 | Die Keyword-Liste durch 10–20 echte Kundenfragen ersetzen | Jede ist ein vollständiger umgangssprachlicher Fragesatz |
| 2 | In Perplexity durchlaufen lassen und Folge Fragen notieren | Pro Seed mindestens 5 Zweige notiert |
| 3 | Für die wichtigsten kommerziellen Seiten eine Selbstprüfung zur Abdeckung der acht Unterabfragetypen durchführen | Mindestens sechs der acht Typen abdecken |
| 4 | Unter jeder H2 einen eigenständigen Antwortblock ergänzen | Pronomen durch Entitätsnamen ersetzen, erst Schlussfolgerung, dann Bedingungen |
| 5 | Den kommerziellsten Block in das erste Drittel vorziehen | Innerhalb eines Bildschirms nach dem ersten sichtbaren Bereich erscheinen |
| 6 | Jedem Frage-Cluster genau eine Seite zuweisen | Keine zwei Seiten beantworten dieselbe Frage |
Gleichzeitig sollte ein Teil der Suchvolumen-Bewertung beibehalten werden: Es bleibt ein kostengünstiges Signal zur Schätzung der Nachfragegröße, Priorisierung und Saisonalität. Was wirklich aufgegeben werden sollte, ist die eindimensionale Regel "hohes Suchvolumen = schreiben, niedriges = nicht schreiben".
Wie we0 diese Kette aufgreift
Damit die Fragenkette zum Inhaltsasset wird, muss sie letztlich auf der Website landen: Seitenstruktur, FAQ-Blöcke, Vergleichstabellen, strukturierte Daten, mehrsprachige Versionen und der Rhythmus der laufenden Aktualisierung. we0.ai bietet den Weg, Website-Erstellung und Content-Wachstum in einem Arbeitsbereich zu vereinen: Anforderungen in natürlicher Sprache beschreiben, von mehreren Agenten kollaborativ lauffähige Seiten generieren lassen, auf einer visuellen Leinwand anpassen und auf einer eigenen Domain bereitstellen, dann über ein CMS-Backend die Inhalte kontinuierlich pflegen und auf der Website-Seite SEO- und GEO-relevante Einstellungen verwalten (we0.ai).
Für Teams, die Frage-Cluster schnell validieren müssen, liegt der Wert dieser Integration nicht darin, "wie schnell generiert wird", sondern darin, dass von einer Anforderung bis zur Seitenveröffentlichung und dann zur Überprüfung der Abdeckung entlang der Fragenkette keine Inhalte und Texte zwischen drei oder vier Tools hin- und hergeschoben werden müssen.
FAQ
F: Muss man das Keyword-Suchvolumen noch betrachten?
Ja, aber zur Beurteilung der Nachfragegröße und Priorität, nicht als einzige Grundlage für die Themenauswahl. Das Suchvolumen kann Unterabfrage-Zweige, Antwortformen und Absichtsebenen nicht widerspiegeln; diese drei Punkte müssen durch Fragenketten-Recherche ergänzt werden.
F: Sind Query Fan-Out und Keyword-Clustering dasselbe?
Nein. Keyword-Clustering gruppiert ähnliche Wörter nach Absicht und Semantik zur Inhaltsorganisation; Query Fan-Out ist der Mechanismus, mit dem die Engine eine Anfrage in mehrere Unterabfragen aufteilt und parallel recherchiert, um das Rechercheverhalten zu erklären.
F: Wie kann man beurteilen, ob die eigene Seite zitiert werden kann?
Beginne mit der Extrahierbarkeit: Hat jeder Abschnitt einen eigenständig bestehenden Antwortblock, werden Entitäten und Anwendungsszenarien genannt, gibt es Tabellen oder Schritte, sind Quellen sichtbar. All das lässt sich manuell prüfen, ohne auf Scores von Drittanbietern angewiesen zu sein.
F: Was tun kleine Teams ohne Budget für vollständige Recherche?
Zuerst den minimalen Kreislauf schließen: 10 echte Kundenfragen auswählen, eine konversationelle Suche durchführen und Zweige notieren, die wichtigsten kommerziellen Seiten um Tabellen, Schritte und Antwortblöcke ergänzen, vierteljährlich erneut durchlaufen und das Datum vermerken, um zu unterscheiden, ob Ergebnisänderungen von Inhaltsanpassungen oder Engine-Updates stammen.
Related Tools
- Google Search Central – Dokumentation zu KI-Funktionen: offizielle Aussagen und Grundanforderungen bestätigen.
- Perplexity: Der Rechercheprozess ist in der Oberfläche sichtbar, geeignet zur Beobachtung des Fan-Out-Verhaltens.
- AlsoAsked: Frage-Cluster nach Keywords abrufen und übersehene Zweige ergänzen.
- we0.ai: Integrierter Arbeitsbereich von der Website-Erstellung über Content-Betrieb bis zu SEO/GEO-Einstellungen.
Related Links
- Google Search Central — AI features and your website
- MaximusLabs — What is Query Fan-Out?
- SEO for Today — Query Fan-Out: How AI Search Is Changing Keyword Research
- we0.ai — KI-Website-Erstellung und Wachstums-Workbench
Summary
Das Suchvolumen hat nicht an Bedeutung verloren, es ist lediglich von der "Themenauswahlgrundlage" zur "Referenz für die Nachfragegröße" zurückgestuft worden. Die neue Aufgabe der Keyword-Recherche besteht darin, ein Wort zu einer vollständigen Fragenkette zu erweitern, für jede Frage eine extrahierbare Antwortform vorzubereiten und Seiten nach Frage-Clustern statt nach einzelnen Wörtern zuzuordnen. Dies dient sowohl traditionellen Suchergebnissen als auch der konversationellen Suche, die Abfragen selbst umformuliert. Auch das Bewertungskriterium ändert sich: Nicht wie hoch das Suchvolumen dieses Wortes ist, sondern ob deine Website, wenn der Nutzer bis zur vierten oder fünften Frage weiterfragt, noch die eine zitierte Antwort sein kann.