For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/anthropic-s-2021-roadmap-coding-agents-to-438c8006.md.
Eine kurze Anthropic-Forschungsroadmap vom Juli 2021 beschreibt einen Assistenten, der mit Menschen sprechen und zugleich Software erstellen...
Eine kurze Anthropic-Forschungsroadmap vom Juli 2021 beschreibt einen Assistenten, der mit Menschen sprechen und zugleich Software erstellen, bearbeiten und erklären kann. Aus heutiger Sicht lassen sich darin leicht Fragen erkennen, die Coding Agents weiterhin prägen: Wie erkunden sie ein Repository, nutzen Tools, lernen aus Feedback und handeln sicher in einer realen Umgebung?
Der öffentlich verlinkte Scan ist wegen dieser Zusammenhänge interessant, nicht weil er beweist, dass eine fertige Version von Claude Code bereits fünf Jahre früher existierte. Er dokumentiert Forschungsziele und Meinungsverschiedenheiten. Das ist eine andere Art von Beleg als ein veröffentlichtes Produkt, ein abgeschlossenes Experiment oder eine Aussage über die heutige Modellarchitektur.
Das langfristige Ziel des Dokuments ist sichere, nutzbringende AGI. Als vorgeschlagenen Proof of Concept nennt es einen allgemeinen Assistenten, der über natürliche Sprache gemeinsam mit einem Nutzer an Software arbeiten kann.
Die beschriebenen Aufgaben gehen über das Vervollständigen der nächsten Zeichen im Code hinaus. Sie umfassen das Beantworten von Fragen, das Schreiben von Funktionen, das Auffinden von Fehlern, das Entwerfen von APIs sowie Diskussionen über Stil und Best Practices. Der ambitionierte Zielzustand ist die breite Kompetenz eines Kollegen im Software Engineering.
Die Formulierung erkennt zugleich an, dass das Team nicht erwartete, dieses Ziel sofort zu erreichen. Sie beschreibt eine Forschungsrichtung. Deshalb sollte das Dokument nicht nachträglich als Veröffentlichungsplan für Claude Code im Jahr 2021 dargestellt werden, in dem bereits alle heutigen Funktionen festgelegt waren.
Die aktuelle Claude-Code-Dokumentation ermöglicht den Vergleich zwischen der allgemeinen Zielsetzung und einem realen Produkt. Die thematische Kontinuität ist klar; das Dokument allein belegt jedoch keine lückenlose Implementierungsgeschichte für jede einzelne Funktion.
Die Kommentare zeigen eine praktische Spannung zwischen dem unmittelbaren Bau von etwas Nützlichem und der Demonstration einer allgemeineren Fähigkeit.
Tom Brown schlägt das Durchsuchen von Repositories als wertvollen Einstieg vor. Nelson Elhage nennt ein konkretes Beispiel: das Auffinden von Typdefinitionen in einem Projekt. Das sind gewöhnliche Bedürfnisse von Entwicklern, insbesondere beim Einstieg in eine unbekannte Codebasis.
Andy Jones stellt diesem Ansatz eine Demonstration gegenüber, die printf-Debugging und die Nutzung eines Editors hervorhebt. Die Repository-Suche könnte eine starke erste Funktion für einen Programmierassistenten sein, während die anderen Aktionen überzeugender zeigen könnten, dass ein Modell Tools verwenden kann.
Dario Amodeis Antwort priorisiert kurzfristig die Demonstration der Tool-Nutzung und langfristig den hochkompetenten Programmierer. Dieser Austausch ist aufschlussreich, weil er die Reihenfolge als explizite Entscheidung zeigt. Ein früher Forschungsmeilenstein kann wertvoll sein, auch wenn er noch nicht das nützlichste vollständige Produkt darstellt.
Der Abschnitt zum Pretraining fordert leistungsstarke Sprach- und Code-Modelle, codeorientierte Datensätze und Bewertungen, die Fähigkeiten mit späterem Fine-Tuning verknüpfen. Er behandelt auch die Wissenschaft des Trainings beliebig großer Modelle, einschließlich 1T und größer.
Das ist ein formuliertes Forschungsziel. Es ist keine Offenlegung, dass ein aktuelles Claude-Modell eine Billion Parameter besitzt, und auch kein Beleg dafür, dass das Team 2021 bereits ein solches Modell trainiert hatte.
Derselbe Abschnitt betrachtet sehr große Kontexte oder eine gleichwertige Möglichkeit, umfangreiches Gedächtnis und Erfahrung einzubeziehen. Dadurch bleiben mehrere mögliche Mechanismen offen, statt ein bestimmtes heutiges Design für ein Kontextfenster vorzuschreiben.
| Roadmap-Punkt | Was er unterstützt | Was er nicht belegt |
|---|---|---|
| Ein allgemeiner Software-Assistent | Software-Zusammenarbeit war ein frühes Forschungsziel. | Eine fertige Version von Claude Code im Jahr 2021. |
| Modelle mit 1T Parametern und mehr | Sehr große Skalierung war Teil der Forschungsagenda. | Die Parameterzahl einer aktuellen Claude-Version. |
| Große Kontexte oder gleichwertiges Gedächtnis | Das Team erwog erweiterte Erfahrung und Gedächtnis. | Eine feste Architektur oder das exakte heutige Token-Limit. |
| Tool-Nutzung durch Suche, Debugging und Bearbeitung | Die Agenda umfasste Handlungen in Softwareumgebungen. | Zuverlässigen, uneingeschränkten autonomen Betrieb. |
Der Abschnitt zu menschlichem Feedback und Alignment behandelt die Frage, wie Modellurteile mit menschlichen Urteilen über Verhalten und Qualität von Ausgaben zusammenhängen. Er erwähnt ausdrücklich Selbstbewertung und verknüpft die Frage mit Bias, Fairness und gesellschaftlichen Folgen.
Das ist eine aussagekräftige frühe Formulierung, die die eigenen Bewertungen eines Modells zum Forschungsgegenstand macht. Sie zeigt nicht, dass solche Urteile automatisch vertrauenswürdig sind oder dass ein Modell seine eigene Ausgabe sicher zertifizieren kann.
Das Dokument erwähnt zudem Test-Time Compute in einer Diskussion über GAN- oder Diskriminator-Training und Skalierungsgesetze. Dies zeigt, dass das Team über Rechenleistung jenseits des Pretrainings nachdachte. Es sollte nicht ohne Einschränkung mit jeder späteren Technik für Reasoning-Modelle gleichgesetzt oder als Beweis behandelt werden, dass ein modernes System zur Inferenzzeit-Skalierung bereits spezifiziert war.
Diese Unterscheidung macht den historischen Vergleich stärker. Das Dokument legt verwandte Forschungsfragen offen, ohne dass Leser so tun müssen, als bedeutete ein ähnlicher Wortschatz über fünf Jahre hinweg identische Methoden.
Einer der direkt relevantesten Kommentare fragt, wie nicht sandboxed Tools sicher bereitgestellt werden können. Amodei präzisiert die konkrete Sorge: Tools, die zur Bereitstellungszeit Code ausführen.
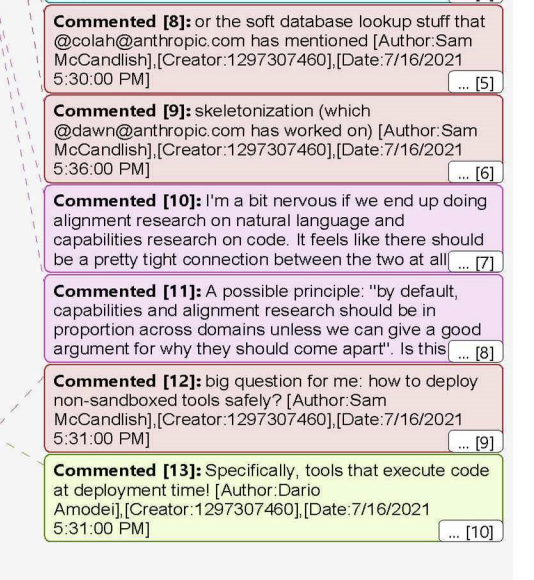
Quelle: der Roadmap-Scan vom Juli 2021, auszugsweise veröffentlicht von QbitAI auf BAAI Hub. Die entsprechenden Kommentare sind im verlinkten PDF einschließlich der erweiterten Kommentarseiten sichtbar.
Diese Sorge bleibt im Kontext von Agents nachvollziehbar. Ein System, das Befehle ausführen oder Dateien bearbeiten kann, kann seine Umgebung verändern. Deshalb lässt sich sicheres Verhalten nicht allein anhand der Höflichkeit oder Plausibilität seiner abschließenden Antwort beurteilen.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die heutige Claude-Code-Sandbox-Dokumentation beschreibt Dateisystem- und Netzwerkbeschränkungen für das sandboxed Bash-Tool sowie die Grenzen des dadurch gebotenen Schutzes. Sie ist eine Referenz für die aktuelle Implementierung, kein Beleg dafür, dass jeder solche Mechanismus bereits in der Roadmap definiert war.
Der historische Kommentar benennt das Problem klar: Der Zugriff auf ein nützliches Tool schafft zugleich eine Grenze, die konzipiert, getestet und gepflegt werden muss.
Amanda Askell äußert in den Kommentaren eine andere Sorge. Wenn Fähigkeiten primär im Bereich Code voranschreiten, während sich Alignment-Experimente weiterhin auf natürliche Sprache konzentrieren, könnten Alignment-Tests für die tatsächlich entwickelten Fähigkeiten weniger nützlich werden.
Sie schlägt vor, Fähigkeits- und Alignment-Forschung domänenübergreifend im Verhältnis zu halten, sofern es keinen guten Grund für eine Trennung gibt. Der Punkt ist operativ: Die Bewertung einer leicht untersuchbaren Interaktion kann eine Lücke hinterlassen, wenn das bereitgestellte System zunehmend in einer anderen Art von Umgebung handelt.
Der Abschnitt der Roadmap zu gesellschaftlichen Auswirkungen umfasst in ähnlicher Weise die Bewertung von Modellen, die Unterstützung Dritter bei der Beurteilung von Systemen und die Erweiterung der Gruppe externer Forschender, die mit ihnen experimentieren können. Dies sind Forschungsziele und keine Garantie dafür, dass spätere Zugangsprogramme oder Bewertungen jedes vorgeschlagene Prinzip erfüllen.
Zusammengenommen macht das Material die Sicherheitsdiskussion konkreter als ein allgemeines Leitbild. Es verknüpft Trainingsfeedback, die Domäne der Bewertung, ausführbare Tools und externe Begutachtung.
Das Dokument stützt eine begrenzte, aber nützliche historische Schlussfolgerung: Mehrere Themen, die mit modernen Coding Agents verbunden werden, waren bereits in Anthropics früher Forschungsplanung miteinander verknüpft. Software-Unterstützung, Tool-Nutzung, Feedback, Skalierung, Gedächtnis und Sicherheit erscheinen in derselben Agenda.
Es beweist nicht, dass die Roadmap jeden späteren Erfolg verursacht hat, dass das spätere Produkt unvermeidlich war oder dass andere Labore keine ähnlichen Ideen hatten. Dafür wären zusätzliche historische Belege und Vergleiche über dieses Dokument hinaus erforderlich.
Für Entwickler bleiben die nützlichsten Fragen konkret. Welche Teile einer Aufgabe kann das Modell ausführen, welche Tools kann es nutzen, wie werden Fehler erkannt und was verhindert, dass eine falsche Aktion die weitere Umgebung beeinträchtigt? Die Roadmap ist auch deshalb wertvoll, weil diese Fragen weiterhin wiedererkennbar sind.
Es handelt sich um den öffentlich verlinkten Scan mit dem Titel Concise Research Roadmap, der Jared Kaplan zugeschrieben wird und als zuletzt aktualisiert im Juli 2021 gekennzeichnet ist. Die sechsseitige Kopie enthält den Forschungstext und erweiterte Kommentare; ihre Herkunft als Gerichtsunterlage wurde hier jedoch nicht unabhängig authentifiziert.
Nein. Sie beschreibt eine Forschungsrichtung für einen allgemeinen Software-Assistenten. Ein Ziel, das einem späteren Produkt ähnelt, ist etwas anderes als ein Beleg dafür, dass das Produkt bereits gebaut oder veröffentlicht worden war.
Nein. Der Verweis auf Modelle mit 1T und mehr ist ein Forschungsziel. Er belegt weder die Architektur noch die Parameterzahl eines aktuellen Claude-Modells.
Die Roadmap schlägt vor, die Beziehung zwischen menschlichen und Modellurteilen über Verhalten und Ausgabequalität zu untersuchen. Sie verbindet das Thema auch mit Bias, Fairness und gesellschaftlichen Folgen, statt anzunehmen, dass Modellurteile allein ausreichen.
Der Ausdruck erscheint im Kontext von Alignment, Diskriminatoren und Skalierungsforschung. Er zeigt Interesse an Rechenleistung zum Bewertungszeitpunkt, spezifiziert jedoch nicht alle Methoden, die von späteren Reasoning-Modellen eingesetzt werden.
Tools zur Codeausführung können Veränderungen in einer tatsächlichen Umgebung vornehmen. Deshalb erfasst eine Bewertung, die nur die abschließende Antwort betrachtet, nicht das gesamte Risiko. Sandboxing, Berechtigungskontrollen und domänengerechte Tests adressieren unterschiedliche Aspekte dieses Problems und erfordern weiterhin eine sorgfältige Implementierung.
Die Roadmap vom Juli 2021 verbindet die Zielsetzung eines Software-Kollegen mit Forschung zu Tools, großen Modellen, Gedächtnis und Feedback. Ihre Kommentare benennen außerdem Sicherheitsprobleme bei ausführbaren Tools sowie Alignment-Tests, die hinter der Entwicklung von Fähigkeiten zurückbleiben.
Sie dokumentiert eine frühe Forschungsagenda mit erkennbaren modernen Themen, nicht ein fertiges Produkt aus dem Jahr 2021 oder eine Spezifikation der heutigen Claude-Modelle.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.
