For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/azure-maia-300-microsoft-s-2027-multi-gig-1e316d9a.md.
Microsoft führt sein Programm für maßgeschneiderte KI-Infrastruktur in eine deutlich größere Bereitstellungsphase über.
Microsoft führt sein Programm für maßgeschneiderte KI-Infrastruktur in eine deutlich größere Bereitstellungsphase über.
Am 12. Oktober 2026 erklärte das Unternehmen, dass es die Azure-Maia-Familie ab 2027 auf Multi-Gigawatt-Bereitstellungen ausweiten will. Maia soll dabei zum primären Inferenzsystem für Microsoft-Produkte und -Dienste werden.
Die Ankündigung verbindet zwei Generationen von Microsoft entwickelter KI-Hardware.
Maia 200 befindet sich bereits in Produktion und verarbeitet Microsoft-Workloads. Maia 300, das nächste System, soll 2027 in die Produktionsbereitstellung gehen und wurde speziell für Long-Context-Reasoning, latenzsensitive Gespräche und dauerhafte mehrstufige Agenten-Workloads entwickelt.
Microsofts Kernargument lautet, dass sich die Inferenzeffizienz nicht länger allein durch die Betrachtung des Chips verbessern lässt.
Das Unternehmen entwickelt folgende Komponenten gemeinsam:
als ein einheitliches System.
Diesen systemweiten Ansatz will Microsoft in den Multi-Gigawatt-Bereich skalieren.
Bevor Microsoft Maia 300 erläutert, beginnt die Ankündigung mit der aktuellen Generation.
Maia 200 ist nicht mehr nur eine Entwicklungsplattform.
Microsoft erklärt, dass das System nun produktive Workloads verarbeitet, darunter Microsoft Copilot, und zugleich das Microsoft-AI-Team bei der Entwicklung von Modellen der nächsten Generation unterstützt.
Laut Unternehmen sollen GitHub Copilot und Microsoft Foundry bis Ende 2026 folgen.
Über diese Workloads hinweg kann Maia 200 folgende Modelle ausführen:
Das ist wichtig, weil Microsoft Maia nicht als Silizium für nur eine proprietäre Modellfamilie positioniert.
Die Architektur soll ein heterogenes Modellportfolio innerhalb von Azure und Microsofts eigenen Diensten unterstützen.
Microsoft betreibt KI-Produkte in enormem Maßstab.
Dadurch erhalten die Infrastrukturteams direkte Einblicke darin, wo bereitgestellte Modelle Zeit, Speicherbandbreite, Netzwerkkapazität und Energie verbrauchen.
Statt zunächst einen allgemeinen Beschleuniger zu entwickeln und erst später zu entscheiden, wie Anwendungen ihn nutzen sollen, arbeiten Microsoft zufolge die Hardware- und Softwareteams bereits Jahre im Voraus zusammen.
Ziel ist es, künftige Modellanforderungen vorauszusehen und sie in Hardwareentscheidungen zu übersetzen, beispielsweise:
Diese Rückkopplungsschleife prägt bereits die nächste Generation.
Microsoft erklärt, dass Maia 200 in folgenden Regionen bereitgestellt wird:
Für integrierte KI-Funktionen in Produkten wie Microsoft Teams, Copilot und Cowork berichtet Microsoft, dass Maia 200 bis zu 1,7-mal mehr Token pro Watt liefern kann als die Infrastruktur, die das Unternehmen als führende GPU-Infrastruktur bezeichnet.
Dabei handelt es sich um einen von Microsoft berichteten Vergleich und nicht um einen unabhängig veröffentlichten Benchmark über standardisierte Drittanbietersysteme hinweg.
Die Formulierung ist wichtig.
Sie belegt Microsofts interne Produktionserfahrung, sollte jedoch nicht als universeller 1,7-facher Vorteil für jedes Modell, jeden Prompt, jede Batch-Größe, jedes Latenzziel oder jede GPU-Bereitstellung interpretiert werden.
Microsoft erklärt, dass die Produktionserfahrung mit Maia 200 das Design von Maia 300 unmittelbar beeinflusst hat.
Das neuere System soll eine breitere Palette an Workloads unterstützen, darunter:
Die gemeinsame Einschränkung dieser Workloads ist die Inferenz.
Die Modelle müssen reaktionsfähig bleiben, während sie längere Kontexte verarbeiten, mehr Zustand vorhalten und mehr Schritte ausführen.
Microsoft beschreibt Maia 300 als dritte Generation seines Azure-Maia-Programms.
Das Design ist inferenzorientiert.
Das bedeutet, dass Microsoft die Workloads optimiert, die aus seiner Sicht in bereitgestellten KI-Systemen dominieren werden, statt sich allein auf Trainingsdurchsatz zu konzentrieren.
Zu diesen Workloads zählen:
Die Zielmetrik sind zunehmend nicht nur rohe FLOPS.
Entscheidend ist vielmehr, wie viele nützliche Token ein Rechenzentrum innerhalb fester Einschränkungen bei folgenden Faktoren liefern kann:
Microsoft erklärt, Maia 300 werde voraussichtlich 40 % mehr Token pro Megawatt als führende GPU-basierte Systeme bereitstellen.
Diese Zahl ist eine Microsoft-Prognose für die Effizienz einer Systembereitstellung und kein öffentlicher, unabhängiger Benchmark mit vollständiger Testmethodik über verschiedene Anbieter hinweg.
In einem vollständigen Rack mit 96 Beschleunigern soll Maia 300 laut Microsoft zudem einen bis zu siebenfachen Token-Durchsatz auf Rack-Ebene gegenüber Maia 200 liefern.
Diese beiden Angaben beziehen sich auf unterschiedliche Vergleiche:
| Aussage | Vergleich |
|---|---|
| 40 % mehr Token pro Megawatt | Maia 300 gegenüber führenden GPU-basierten Systemen |
| Bis zu 7× Token-Durchsatz auf Rack-Ebene | Vollständiges Maia-300-Rack mit 96 Beschleunigern gegenüber Maia 200 |
Sie sollten nicht als austauschbar behandelt werden.
Eine der zentralen Ideen hinter Maia 300 ist, dass die Bewegung von Daten zu einem bedeutenden Engpass geworden ist.
Moderne Inferenzsysteme verschieben wiederholt:
zwischen Recheneinheiten, Speicher und Netzwerkverbindungen.
Jede Bewegung kostet Latenz und Energie.
Microsofts Antwort ist eine Weiterentwicklung der mit Maia 200 eingeführten Software Defined Locally Accessed Dataflow Architecture, kurz SDLA.
Die Software steuert, wo Daten platziert werden und wann sie zwischen folgenden Komponenten bewegt werden:
Maia 300 erweitert dieses Konzept über ein Multi-Chiplet-Design.
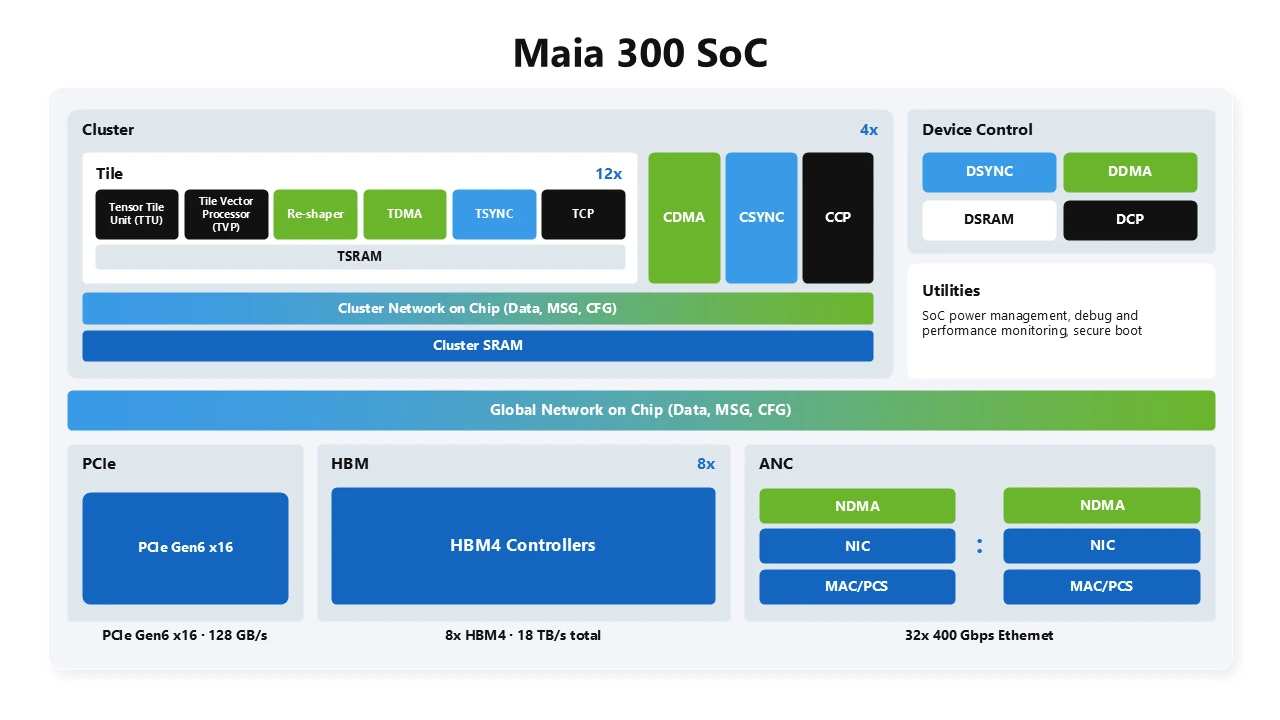
Maia 300 wechselt von einer gleichförmigeren Speicherorganisation zu einer lokalitätsbewussten Non-Uniform-Memory-Architecture über mehrere Chiplets hinweg.
Der Zweck ist einfach:
Daten näher bei der Rechenleistung halten, die sie verwendet
→ weniger Bytes bewegen
→ Latenz und Energieverbrauch senken
→ Auslastung verbessern
Die Architektur überträgt der Software mehr direkte Verantwortung für die Steuerung der Lokalität.
Das ist insbesondere für Long-Context- und Decode-lastige Inferenz wichtig, bei denen die Bewegung von Modellzuständen und KV-Cache den Workload dominieren kann.
Speicher gehört zu den größten Verbesserungen von Maia 300.
Jeder Beschleuniger verwendet acht HBM4-Stacks mit:
Microsoft zufolge ergibt dies ungefähr:
Das System verwendet außerdem On-Die-SRAM als softwareverwalteten Scratchpad-Speicher.
Dadurch kann der Druck auf HBM sinken, weil häufig wiederverwendete Daten näher an der Rechenlogik gehalten werden.
Für die Inferenz ist das relevant, weil viele Workloads durch die Geschwindigkeit begrenzt sind, mit der Zustände an die Rechen-Engines geliefert werden können, und nicht durch deren maximale Rechenleistung.
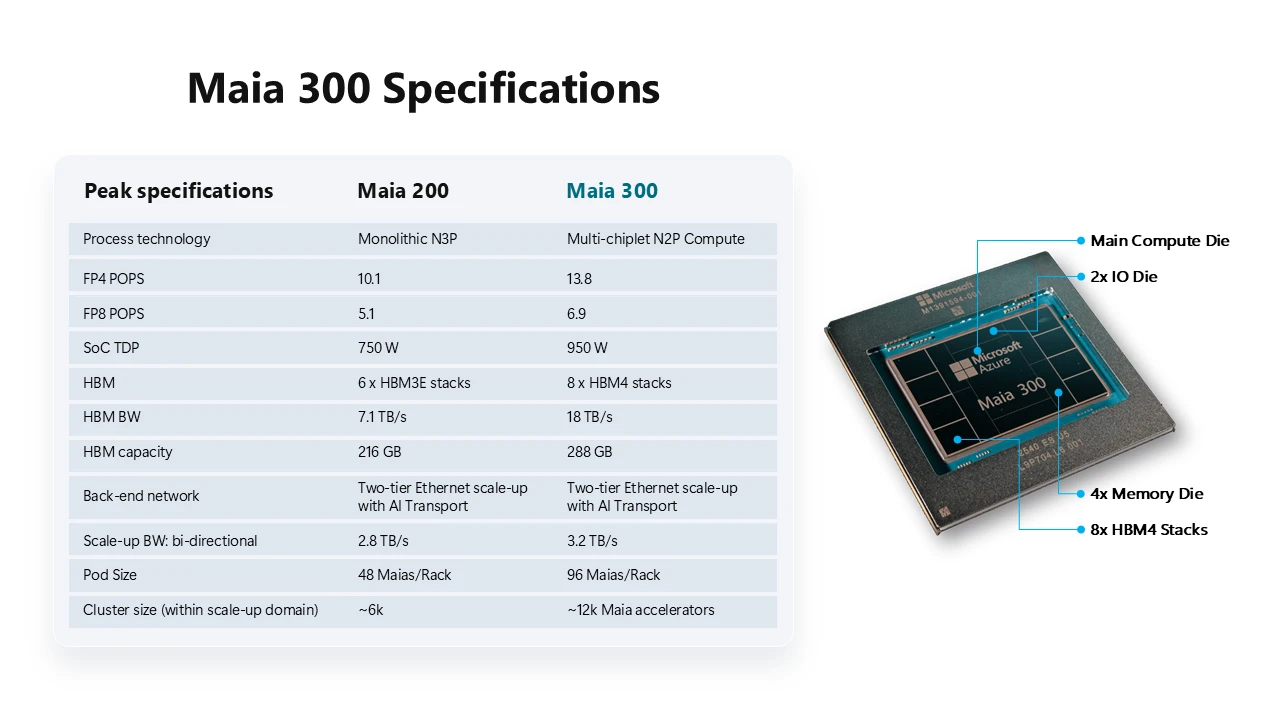
Maia 300 ist nicht im gleichen Sinn wie Maia 200 ein einzelner monolithischer Die.
Microsoft trennt wesentliche Funktionen auf verschiedene Chiplets auf.
Die Architektur enthält getrennte Funktionen für:
Die Compute-Chiplets werden in TSMCs N2P-Prozess gefertigt.
Die Begründung ist sowohl wirtschaftlich als auch technisch.
Die fortschrittlichste Prozesstechnologie kann dort konzentriert eingesetzt werden, wo sie den größten Vorteil bei Leistung pro Watt liefert, während andere Funktionen Designs verwenden können, die für Bandbreite, Konnektivität oder Kosten optimiert sind.
Microsofts technischer Architekturbeitrag erklärt, dass diese Änderung gegenüber Maia 200 zu Folgendem beiträgt:
Maia 300 erweitert auch die Unterstützung für Inferenz mit niedrigerer Präzision.
Microsoft hebt in seinen technischen Architekturmaterialien eine verbesserte Unterstützung für MXFP4 und Speicherformate mit weniger als 3 Bit hervor.
Niedrigere Präzision kann Folgendes reduzieren:
Der Vorteil besteht nicht bloß aus kleineren Zahlen.
Wenn das Modell bei niedrigerer Präzision die erforderliche Qualität beibehalten kann, kann die Infrastruktur Folgendes unterstützen:
Microsoft erklärt außerdem, dass die Vector Engine Optimierungen auf Instruktionsebene für Inferenz-Kernels wie Softmax und die Konvertierung niedrigpräziser Daten ergänzt.
In großem Maßstab sind Beschleuniger nur dann nützlich, wenn sie effizient kommunizieren können.
Maia 300 erweitert sein Dataflow-Modell bis in das Netzwerk selbst.
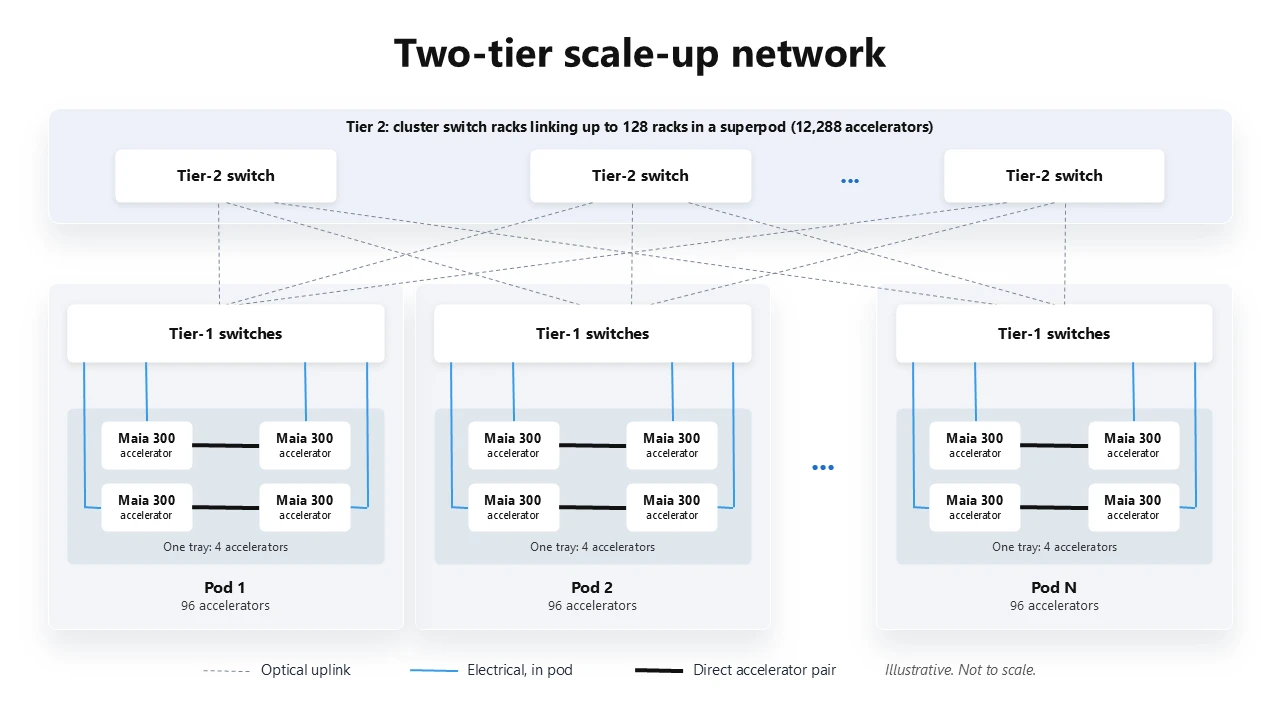
Microsoft verwendet einen benutzerdefinierten KI-Transport über Ethernet-basierte Infrastruktur sowie eine zweistufige Scale-up-Topologie.
Ein einzelnes Maia-300-Rack enthält:
96 Beschleuniger
Mehrere Racks können anschließend zu einem Superpod verbunden werden.
Microsofts technische Architektur beschreibt einen maximalen Superpod mit:
128 Racks
12.288 Maia-300-Beschleunigern
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Innerhalb eines Racks verbinden direkte Links Beschleunigerpaare, während geschaltete elektrische Pfade den vollständigen Pod mit 96 Beschleunigern verbinden.
Microsoft zufolge senkt ein elektrisches Scale-up innerhalb des Racks Energieverbrauch und Kosten.
Eine zweite Netzwerkebene verwendet optische Konnektivität, um Racks zu verbinden.
Dadurch können bis zu 128 Racks an derselben Scale-up-Domäne teilnehmen.
Microsofts erklärtes Ziel ist, nicht für jede physische Grenze separate Kommunikationssemantiken offenlegen zu müssen.
Dasselbe allgemeine Kommunikationsmodell erstreckt sich über:
Dadurch erhalten Scheduler und Software mehr Flexibilität bei der Platzierung von Workloads mit Tensor-, Pipeline- und Expert-Parallelität.
Das Rack von Maia 300 ist ein wesentlicher Teil des Systemdesigns.
Jedes Rack enthält:
Microsofts Architekturvergleich rundet die gesamte HBM-Kapazität in seiner Rack-Grafik auf 27,7 TB.
Der Unterschied entsteht lediglich durch die Rundung von 96 × 288 GB.
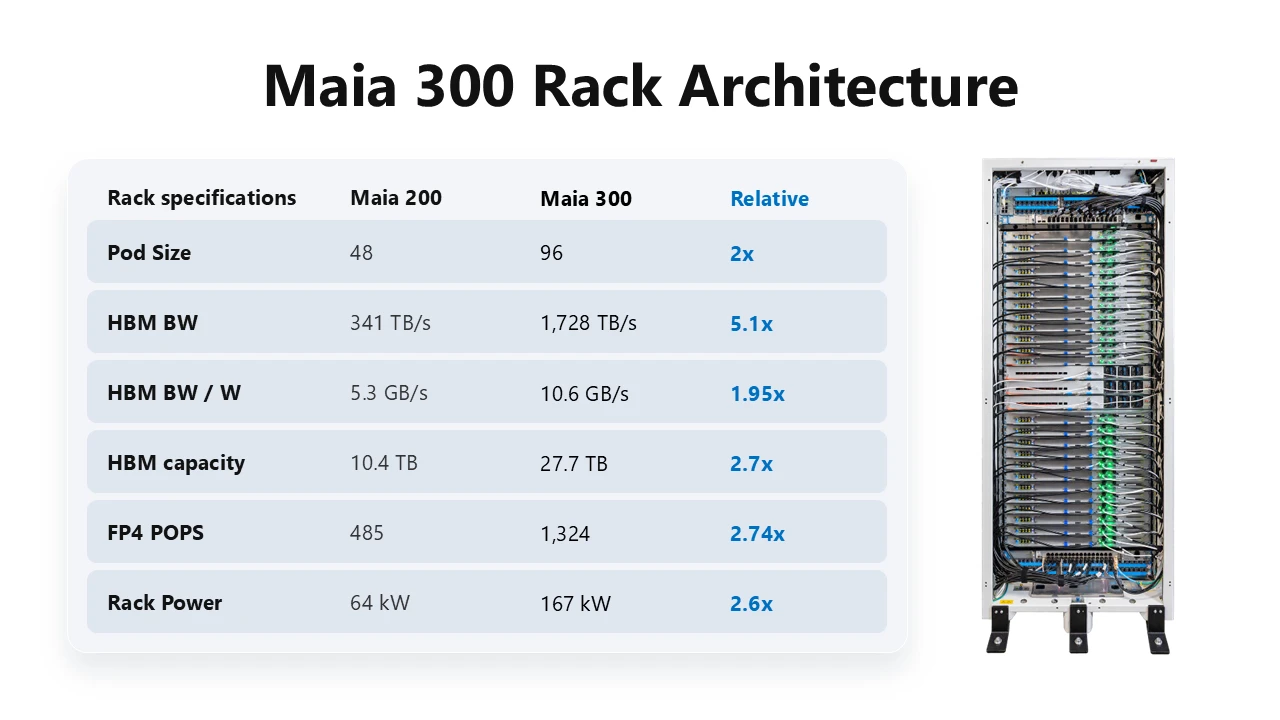
Die Beschleunigerdichte ist doppelt so hoch wie bei Maia 200.
Microsoft integriert Host-Compute, Speicher, Storage, Kühlung und Beschleuniger in jedes Tray, statt separate Host-Trays zu benötigen.
Das schafft Rack-Platz und ermöglicht es, Energie- und Wärmemanagement als ein System zu behandeln.
Ein KI-Rack mit 167 kW stellt eine erhebliche Herausforderung für das Wärmemanagement dar.
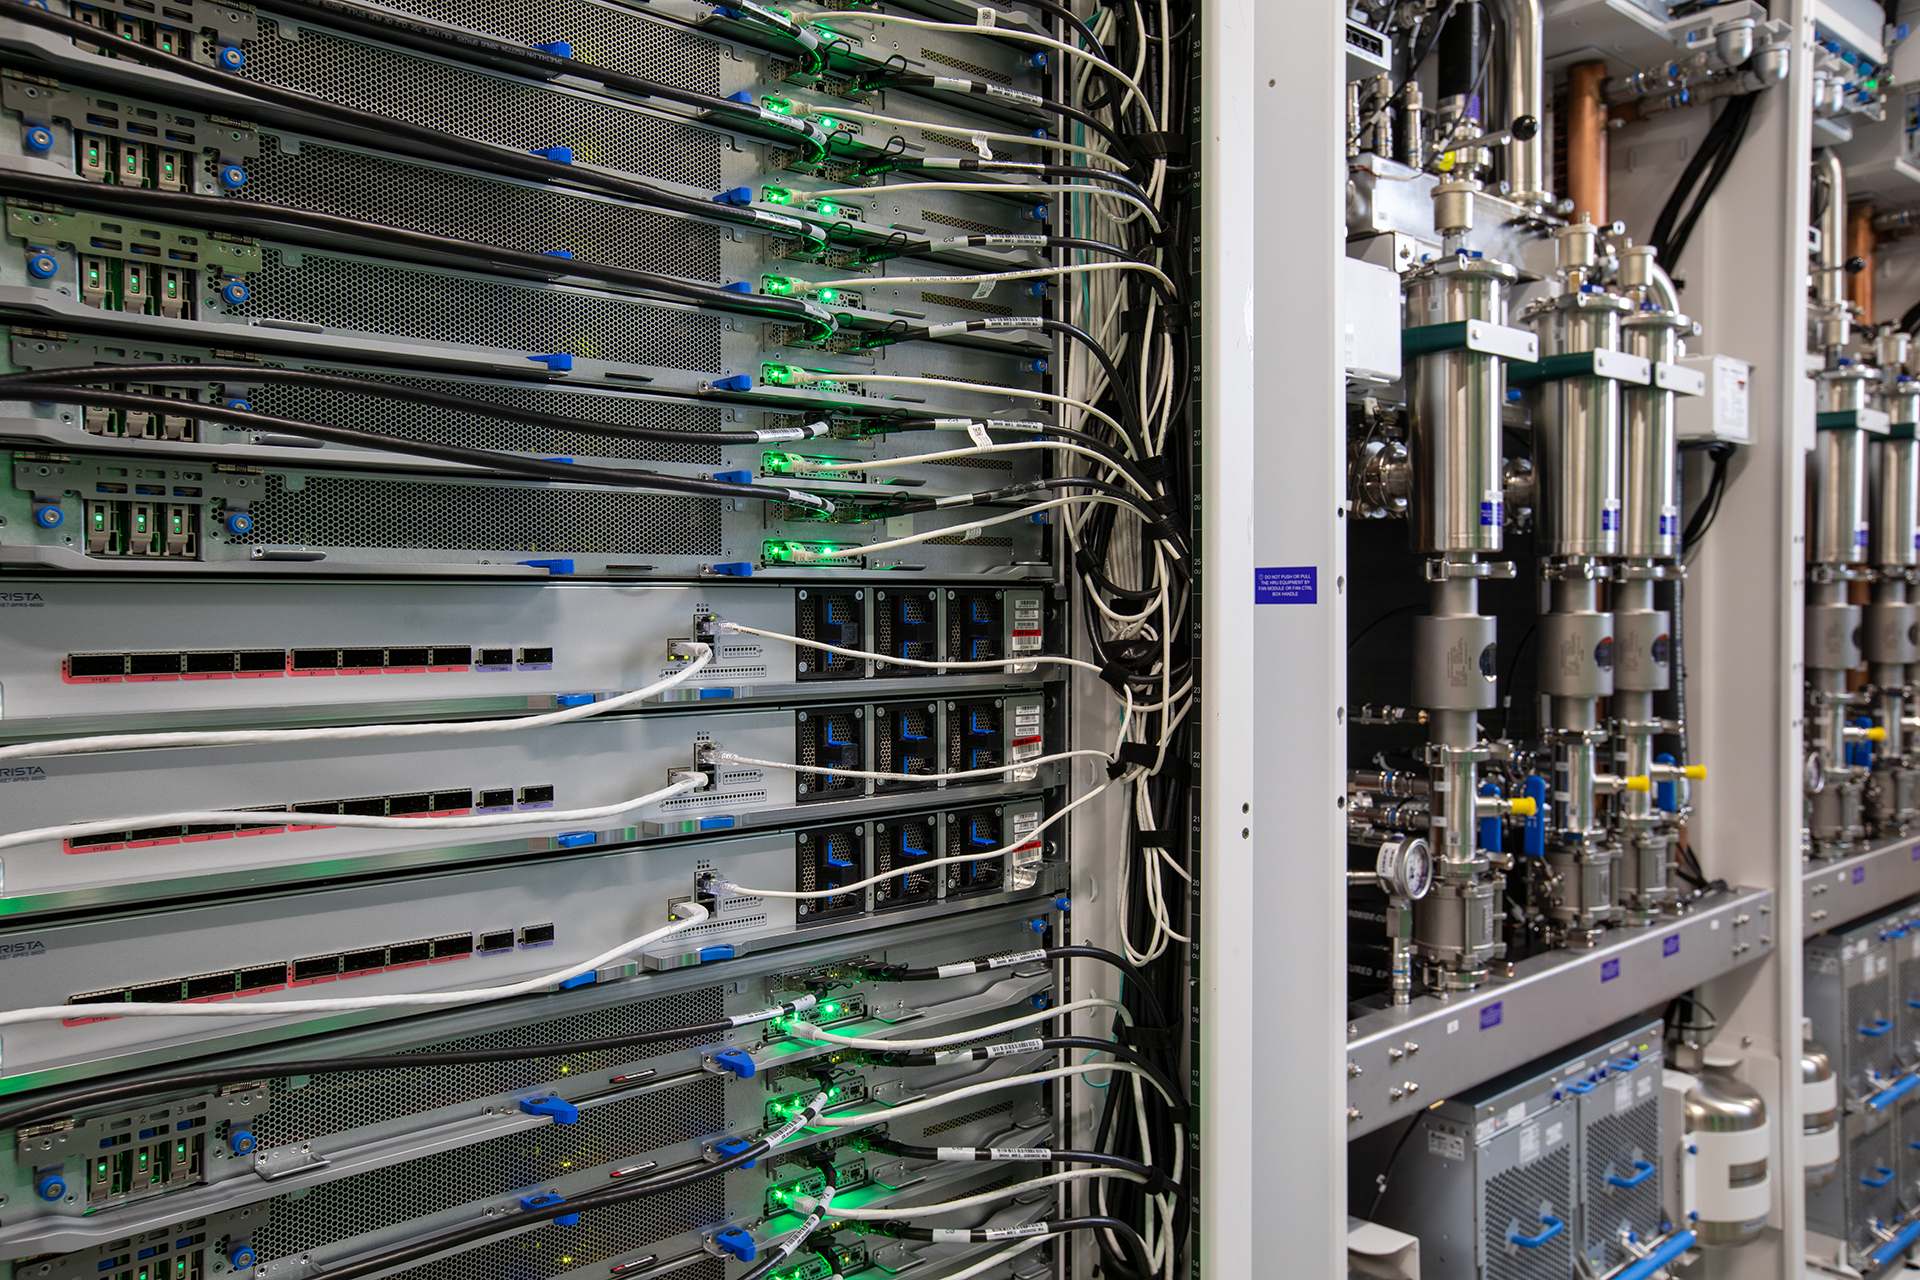
Microsoft erklärt, dass Flüssigkeitskühlung mehr als 80 % der thermischen Last des Racks von Komponenten wie den folgenden abführt:
Luftkühlung bleibt für Komponenten wie Speicher, Storage und andere unterstützende Systeme bestehen.
Das Rack kann sich dort, wo entsprechende Infrastruktur vorhanden ist, direkt mit der Gebäudewasserversorgung verbinden.
In Einrichtungen, die ansonsten luftgekühlt sind, kann es außerdem eine Wärmetauschereinheit verwenden.
Diese Flexibilität ist für die Skalierung der Bereitstellung wichtig.
Microsoft kann Maia nicht nur in Rechenzentren ausbauen, die um exakt eine Kühlungskonfiguration herum aufgebaut sind.
Die folgende Tabelle fasst Microsofts veröffentlichte Maia-300-Spezifikationen und den Vergleich mit Maia 200 zusammen.
| Spezifikation | Maia 200 | Maia 300 |
|---|---|---|
| Prozess-/Package-Ansatz | Monolithisch N3P | Multi-Chiplet, N2P Compute |
| FP4-Spitzenleistung | 10,1 POPS | 13,8 POPS |
| FP8-Spitzenleistung | 5,1 POPS | 6,9 POPS |
| SoC-TDP | 750 W | 950 W |
| HBM | 6 × HBM3E | 8 × HBM4 |
| HBM-Kapazität pro Beschleuniger | 216 GB | 288 GB |
| HBM-Bandbreite pro Beschleuniger | 7,1 TB/s | 18 TB/s |
| Bidirektionale Scale-up-Bandbreite | 2,8 TB/s | 3,2 TB/s |
| Beschleuniger pro Rack | 48 | 96 |
| Ungefähre Rack-HBM-Kapazität | 10,4 TB | 27,7 TB |
| Rack-Leistung | 64 kW | 167 kW |
| Maximal veröffentlichte Scale-up-Domäne | ~6.000 Beschleuniger | ~12.000 Beschleuniger |
Dabei handelt es sich um von Microsoft veröffentlichte Spitzen- und Systemspezifikationen.
Sie sind keine Garantien auf Anwendungsebene.
Der tatsächliche Durchsatz hängt vom Modell, der Präzision, der Batch-Größe, dem Latenzziel, der Parallelisierungsstrategie, dem Software-Stack und der Workload-Mischung ab.
Die zentrale Zahl lautet Microsofts Plan, Azure Maia ab 2027 auf Multi-Gigawatt-Bereitstellungen zu bringen.
Dies ist eine Aussage über die Infrastrukturgröße.
Microsoft hat keine exakte Gigawatt-Gesamtsumme, keinen Bereitstellungsplan pro Standort und keine Beschleunigeranzahl veröffentlicht, die an diese Aussage gebunden wäre.
Sie sollte auch nicht so verstanden werden, dass ein einzelnes Maia-300-Rechenzentrum zwangsläufig mehrere Gigawatt verbrauchen wird.
Ein Programm im Gigawatt-Maßstab kann sich über Folgendes erstrecken:
Die Ankündigung des Unternehmens konzentriert sich bewusst auf die Systemstrategie statt auf einen Ausbauplan für einzelne Anlagen.
KI-Infrastruktur wird zunehmend dadurch eingeschränkt, wie viel nutzbare Rechenleistung in der verfügbaren Energieversorgung untergebracht werden kann.
Ein Rechenzentrum kann nicht unbegrenzt Beschleuniger hinzufügen, wenn es nicht zugleich Folgendes bereitstellen kann:
Deshalb betont Microsoft Token pro Megawatt.
Die Metrik verbindet den Output des Model Serving mit der knappen Ressource, die den Ausbau von Rechenzentren zunehmend bestimmt.
Ein Chip, der schneller ist, aber anteilig mehr Strom verbraucht, löst möglicherweise nicht das eigentliche Bereitstellungsproblem.
Ziel ist es, innerhalb desselben Infrastrukturrahmens mehr nützlichen KI-Output zu generieren.
Microsofts Ankündigung geht über die Aussage hinaus, Maia 300 werde eine weitere Beschleunigeroption sein.
Das Unternehmen erklärt, dass die Maia-Familie mit zunehmender Bereitstellung zu seinem primären Inferenzsystem für Microsoft-Produkte und -Dienste werden soll.
Das macht Maia strategisch wichtig für Microsofts gesamten Stack.
Das Unternehmen nennt oder verweist auf Workloads wie:
Das bedeutet nicht, dass Microsoft GPUs oder andere Beschleuniger aufgibt.
Microsoft beschreibt seine breitere Infrastruktur ausdrücklich als heterogen und modellvielfältig.
Das Maia-Programm bietet Microsoft eine weitere Infrastrukturoption, die sich eng auf die eigenen Dienstmuster optimieren lässt.
Im letzten Abschnitt von Microsofts Ankündigung wird Maia in den Kontext dessen gestellt, was das Unternehmen Frontier Transformation nennt.
Die Idee ist, dass KI-Infrastruktur nicht als isolierte Ebenen optimiert werden sollte.
Microsoft will Folgendes miteinander verbinden:
Silizium
→ Systeme
→ Rechenzentren
→ Model Serving
→ Agenten
→ Anwendungen
Da Microsoft all diese Ebenen betreibt, kann das Unternehmen Produktionsfeedback aus Anwendungen nutzen, um künftige Hardware zu beeinflussen.
Auch die umgekehrte Richtung gilt.
Neue Hardwarefähigkeiten können prägen, was künftige Modelle und Agenten im großen Maßstab wirtschaftlich leisten können.
Das ist der strategische Zweck von Maia.
Das Unternehmen versucht nicht zu beweisen, dass ein einzelner Chip jeden Beschleuniger ersetzen wird.
Es baut eine vertikal gemeinsam entwickelte Inferenzplattform auf, die neben anderer Hardware in Azure eingesetzt werden kann.
Die veröffentlichten Spezifikationen von Maia 300 sind umfangreich, doch der Großteil des entscheidenden Systems befindet sich noch vor der Produktion.
Die Produktionsbereitstellung beginnt 2027.
Mehrere Fragen werden wichtig, sobald das System reale Workloads erreicht.
Microsoft erwartet 40 % mehr Token pro Megawatt als führende GPU-basierte Systeme.
Die relevante Frage wird sein, wie sich dies über verschiedene Modelle und Latenzziele hinweg bewährt.
Maßgeschneidertes Silizium ist nur erfolgreich, wenn Compiler, Kernels, Observability, Bereitstellungstools und Modellunterstützung für Produktionsteams ausreichend ausgereift sind.
Microsoft will, dass Maia OpenAI-, MAI- und Open-Source-Modellfamilien unterstützt.
Die Produktionseffizienz über heterogene Architekturen hinweg wird ein wichtiger Test sein.
Die Scale-up-Domäne mit 12.288 Beschleunigern ist architektonisch bedeutend.
Tatsächliche Auslastung, Fehlerbehebung, Scheduling und rackübergreifende Kommunikation werden bestimmen, wie viel dieser theoretischen Skalierung in nutzbare Kapazität übersetzt wird.
Leistung pro Watt ist nur ein Teil der Gesamtkosten.
Betreiber von Rechenzentren berücksichtigen außerdem:
Microsofts Vorteil wird, sofern die Strategie funktioniert, aus der Optimierung des Gesamtsystems entstehen und nicht aus einer einzelnen Benchmark-Zahl.
Azure Maia 300 ist Microsofts KI-Inferenzsystem der dritten Generation. Es kombiniert einen Multi-Chiplet-Beschleuniger, HBM4-Speicher, softwaredefinierten Dataflow, ein benutzerdefiniertes Ethernet-basiertes Scale-up-Netzwerk und eine Rack-Architektur mit 96 Beschleunigern für Cloud-KI-Inferenz im großen Maßstab.
Microsoft erklärt, dass die Produktionsbereitstellung 2027 beginnen wird. Das Unternehmen plant außerdem, die Maia-Familie 2027 auf Multi-Gigawatt-Bereitstellungen zu skalieren.
Es bedeutet, dass Microsoft Maia-Infrastruktur auf eine aggregierte Leistungsskala von mehreren Gigawatt bringen will. Microsoft hat keine exakte Gesamtsumme, Beschleunigeranzahl oder Aussage veröffentlicht, wonach ein einzelnes Rechenzentrum mehrere Gigawatt verbrauchen wird. Diese Details sollten daher nicht allein aus der Überschrift abgeleitet werden.
Jeder Maia-300-Beschleuniger verfügt über acht HBM4-Stacks mit 288 GB Kapazität und 18 TB/s Spitzen-HBM-Bandbreite. Ein Rack mit 96 Beschleunigern enthält insgesamt ungefähr 27,6 bis 27,7 TB HBM.
Microsoft spezifiziert einen Leistungsrahmen von 167 kW für ein vollständiges Maia-300-Rack mit 96 Beschleunigern. Das Beschleuniger-SoC selbst hat eine TDP von 950 W.
Microsoft erwartet, dass Maia 300 40 % mehr Token pro Megawatt als führende GPU-basierte Systeme liefert, hat für diese Aussage jedoch keine vollständige unabhängige Benchmark-Methodik über verschiedene Anbieter veröffentlicht. Das Ergebnis sollte daher als Microsofts Erwartung zur Systemleistung und nicht als universelle Benchmark-Schlussfolgerung betrachtet werden.
Microsoft erklärt, Maia werde zum primären Inferenzsystem für Microsoft-Produkte und -Dienste. Gleichzeitig beschreibt das Unternehmen Azure als offene, heterogene Plattform mit Wahlmöglichkeiten bei Modellen und Silizium. Maia ist Teil dieses breiteren Infrastrukturmixes und kein Beleg dafür, dass Azure ausschließlich Microsoft-Silizium einsetzen wird.
Microsoft erklärt, dass Maia 200 bereits Microsoft Copilot bedient und die Entwicklung von Modellen der nächsten Generation durch das MAI-Team unterstützt. GitHub Copilot und Microsoft Foundry sollen bis Ende 2026 folgen.
Microsoft entwickelt Azure Maia von einem Programm für maßgeschneiderte Beschleuniger zu einer großskaligen Inferenzplattform weiter. Maia 200 verarbeitet bereits produktive Workloads, während Maia 300 2027 in die Bereitstellung gehen soll und auf Long-Context-, Decode-lastige und agentische Inferenz ausgelegt ist.
Die größten Änderungen betreffen das Systemniveau: 288 GB HBM4 pro Beschleuniger, 18 TB/s Speicherbandbreite, ein Multi-Chiplet-N2P-Design, 96 Beschleuniger pro 167-kW-Rack, ein Scale-up-Fabric mit bis zu 12.288 Beschleunigern sowie Flüssigkeitskühlung, die mehr als 80 % der Rack-Abwärme abführt.
Microsofts Ziel ist es, die Maia-Familie auf Multi-Gigawatt-Bereitstellungen zu skalieren und sie zum primären Inferenzsystem hinter den eigenen Produkten und Diensten zu machen, während Azure heterogen bleibt.
Bei Maia 300 geht es weniger darum, dass ein Chip einen anderen ersetzt, sondern vielmehr darum, dass Microsoft den gesamten Weg von Silizium über Rechenzentren bis zu Agenten auf die Wirtschaftlichkeit der KI-Inferenz ausrichtet.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



