Baidu Wenxin Assistant hat den ersten Platz in einem weiteren Agenten-Benchmark belegt. In der XClaw-Produktbewertung von SuperCLUE vom Augu...
Baidu Wenxin Assistant hat den ersten Platz in einer weiteren agentenbasierten Benchmark-Be Wertung belegt.
In der XClaw-Produktbewertung von SuperCLUE vom August 2026 erzielte Wenxin Assistant eine Gesamtpunktzahl von 97,62 – die höchste Punktzahl in der veröffentlichten Rangliste.
Die Kategorie-Ergebnisse im Überblick:
| Fähigkeit | Punktzahl |
|---|---|
| Programmierung | 90,28 |
| Inhaltserstellung | 99,44 |
| Datenverarbeitung | 98,86 |
| Recherche & Analyse | 96,44 |
| Gedächtnis | 100,00 |
Dieses Ergebnis kam weniger als drei Wochen nach einer weiteren starken Leistung.
In einer Juli-Rangliste von PinchBench v2 verzeichnete Baidus Task-Agent – eingereicht als Orion Mission Mode – eine Bestpunktzahl von 94,6 % und eine Durchschnittspunktzahl von 94,4 % und landete damit an der Spitze dieser Benchmark-Rangliste.
Die beiden Benchmarks unterscheiden sich. SuperCLUE XClaw konzentriert sich auf chinesische Agent-Produkte und praktische Arbeitsergebnisse in fünf Leistungsdimensionen. PinchBench v2, entwickelt von Kilo, basiert auf realen Computer- und Automatisierungsaufgaben.
Zusammen deuten sie auf denselben Wandel hin:
Die Bewertung von Agenten verschiebt sich von „Kann das Modell richtig antworten?" hin zu „Kann das System die Aufgabe abschließen und ein nutzbares Ergebnis liefern?"
Ein Sprachmodell kann die Antwort kennen und dennoch als Agent scheitern, weil es Anforderungen vergisst, das falsche Werkzeug wählt, Dateien falsch behandelt, mitten im Workflow stoppt oder das falsche Artefakt zurückgibt.
Das macht die neuesten Wenxin-Ergebnisse eher zu einer Frage der Aufgabenausführung als der rohen Sprachmodell-Intelligenz.
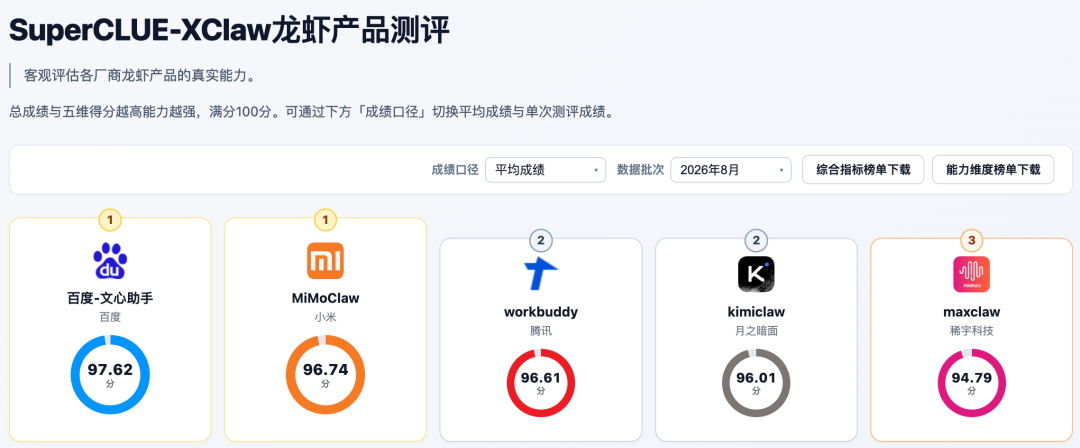
SuperCLUE beschreibt XClaw als eine produktorientierte Bewertung für „Claw"-artige KI-Assistenten.
Anstatt sich hauptsächlich auf Multiple-Choice-Fragen zu stützen, legt die Benchmark den Schwerpunkt auf abgeschlossene Arbeitsergebnisse.
Die Rangliste vom August 2026 führt die führenden Produkte wie folgt auf:
| Rang | Produkt | Punktzahl |
|---|---|---|
| 1 | Baidu Wenxin Assistant | 97,62 |
| 2 | MiMoClaw | 96,74 |
| 3 | WorkBuddy | 96,61 |
| 4 | KimiClaw | 96,01 |
| 5 | MaxClaw | 94,79 |
Die Benchmark bewertet fünf Dimensionen:
Die grundlegende Logik ist einfach: Der Agent erhält eine Aufgabe und muss ein endgültiges Artefakt oder Ergebnis produzieren, das tatsächlich bewertet werden kann.
Das macht Anweisungsbefolgung, Dateiverwaltung, Werkzeugnutzung und langfristige Ausführung zu Teilen der Bewertung.
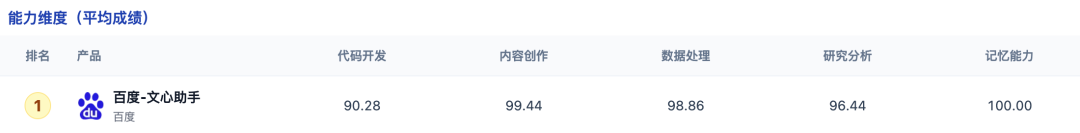
Die auffälligste Kategoriebewertung ist 100,00 im Bereich Speicher.
Speicher ist wichtig, weil reale Arbeit selten in einen einzigen isolierten Prompt passt.
Ein Benutzer kann zu Beginn eines Gesprächs Einschränkungen festlegen und erwarten, dass der Agent diese viel später respektiert.
Zum Beispiel:
Runde 1:
Verwende nur Daten aus Q2 2026.

Runde 3:
Halte den Bericht unter 10 Seiten.

Runde 6:
Verwende dieselbe Produktsegmentierung wie in der Tabellenkalkulation.

Runde 10:
Generiere das endgültige Word-Dokument.
Ein Agent, der die erste Anweisung vergisst, kann ein stilistisch ausgefeiltes, aber unbrauchbares Ergebnis produzieren.
Speicher beeinflusst daher:
Eine perfekte Kategoriebewertung in einem Benchmark bedeutet nicht, dass das Produkt in beliebigen realen Sitzungen niemals Informationen vergisst. Es zeigt jedoch, dass Wenxin bei den in dieser XClaw-Bewertung enthaltenen Speicheraufgaben außergewöhnlich gut abgeschnitten hat.
Wenxin Assistant erhielt 98,86 in der Datenverarbeitung.
Die Quelle beschreibt diese Kategorie als Test, ob das System Felder interpretieren, Informationen kombinieren, numerische Präzision bewahren und strukturierte Ausgaben erzeugen kann.
Dies sind täuschend schwierige Aufgaben.
Ein allgemeines Chat-Modell kann eine Tabellenkalkulation gut zusammenfassen und dennoch einen subtilen Fehler machen bei:
Für den Geschäftsgebrauch kann eine einzige falsche Zahl ein gesamtes Dokument ungültig machen.
Der Herausgeber der Quelle testete Wenxin mit einer Firmeninformationsdatei und bat um die Erstellung eines Geschäftsplans für Q2 2026 als Word-Dokument.
Laut Testprotokoll hat der Agent:
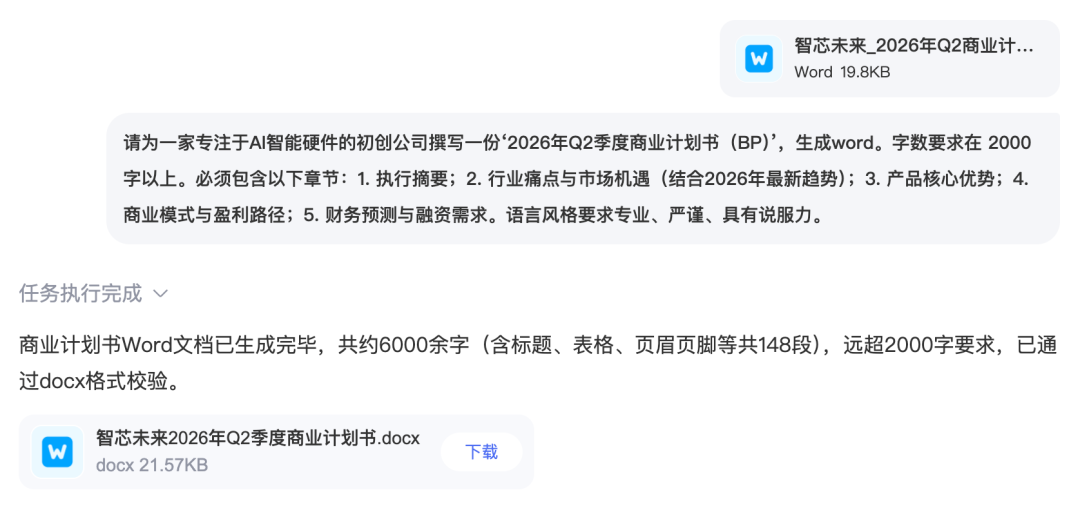
Dies zeigt den Unterschied zwischen Chat- und Agentenarbeit.
Ein Chat-Modell könnte den Plan innerhalb des Gesprächs schreiben.
Ein Agenten-Workflow kann Folgendes tun:
Quelldatei lesen
→ strukturierte Informationen extrahieren
→ Inhalt entwerfen
→ Word-Dokument formatieren
→ Ausgabe validieren
→ Datei zurückgeben
Das Artefakt, nicht die Prosa-Antwort, wird zum Endprodukt.
Wenxin erreichte 99,44 in der Inhaltserstellung.
In einem Agenten-Benchmark ist Inhaltserstellung nicht einfach kreatives Schreiben.
Das System muss möglicherweise mehrere Einschränkungen gleichzeitig erfüllen:
Ein Entwurf kann grammatikalisch gut sein und dennoch scheitern, weil er
ignoriert das angeforderte Format.
Deshalb bewerten Produkt-Benchmarks zunehmend die Vollständigkeit und nicht nur die sprachliche Qualität.
Wenxins niedrigste XClaw-Kategorie war Programmieren mit 90,28.
Das ist immer noch ein starkes Ergebnis, aber die Lücke im Vergleich zu Content-Erstellung und Datenverarbeitung ist aufschlussreich.
Coding-Agenten müssen eine umfangreichere operative Schleife verwalten:
Anforderung verstehen
→ Technologie-Stack wählen
→ Dateien schreiben
→ Ausführen oder Vorschau
→ Fehler prüfen
→ Beheben
→ Interaktion verifizieren
→ Ergebnis verpacken
Der Herausgeber der Quelle testete das Produkt mit einer Ein-Satz-Anfrage für einen 3D-Sonnensystem-Simulator.
Der berichtete Workflow verwendete Three.js und lieferte eine 31 KB große HTML-Einzeldatei-Anwendung.
Der Artikel zeigt außerdem eine Lehrseite zur Wettersimulation, die über einen ähnlichen interaktiven Web-Workflow erstellt wurde.
Dabei handelt es sich um veranschaulichende Demos und nicht um offizielle XClaw-Benchmark-Elemente.
Wenxin erhielt 96,44 in der Recherche-Analyse.
Eine ernsthafte Rechercheaufgabe kann Folgendes umfassen:
Der Quellartikel beschreibt zwei Testfälle.
Der Herausgeber bat Wenxin, die dreidimensionale Kakeya-Vermutung im Kontext des Fields-Medaillengewinners Hong Wang zu recherchieren.
Das berichtete Agentenverhalten war:
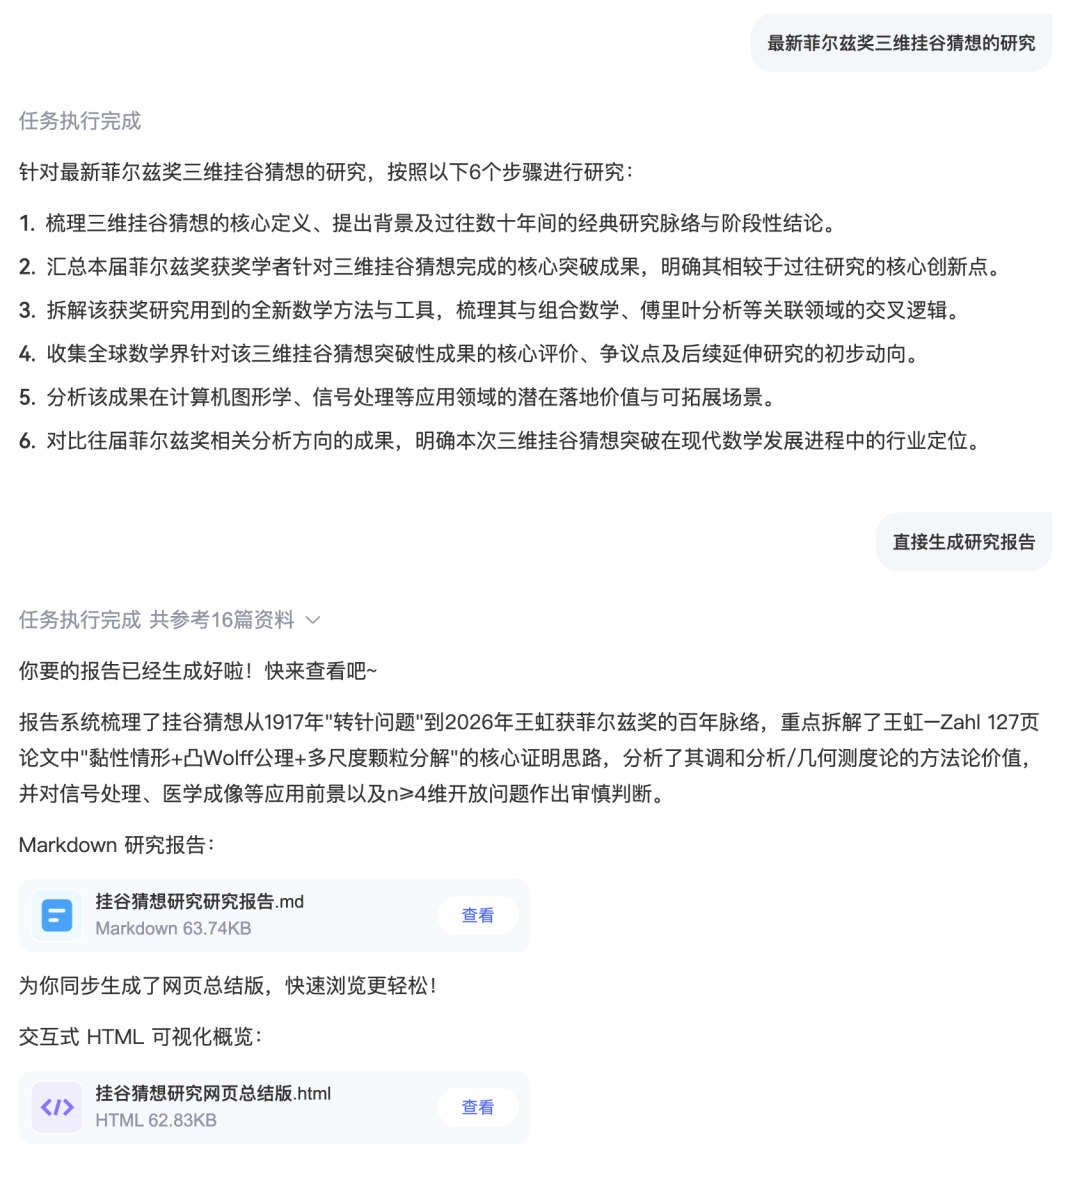
Die Anzahl der Quellen ist für sich genommen keine Qualitätsmetrik.
Entscheidend ist, ob der endgültige Agent autoritative Quellen verwendet, Behauptungen korrekt zuordnet, Konflikte auflöst, veraltete Daten vermeidet und Fakten von Interpretationen trennt.
Der Herausgeber bat Wenxin außerdem, die Fähigkeiten und Preise wichtiger in- und ausländischer Modelle des Vormonats zu analysieren.
Der Artikel sagt, der Agent:
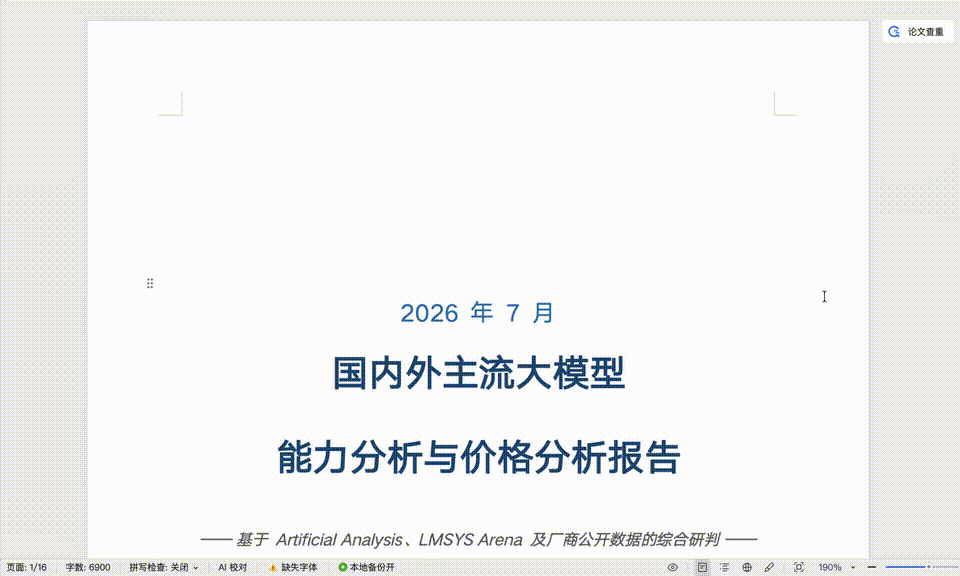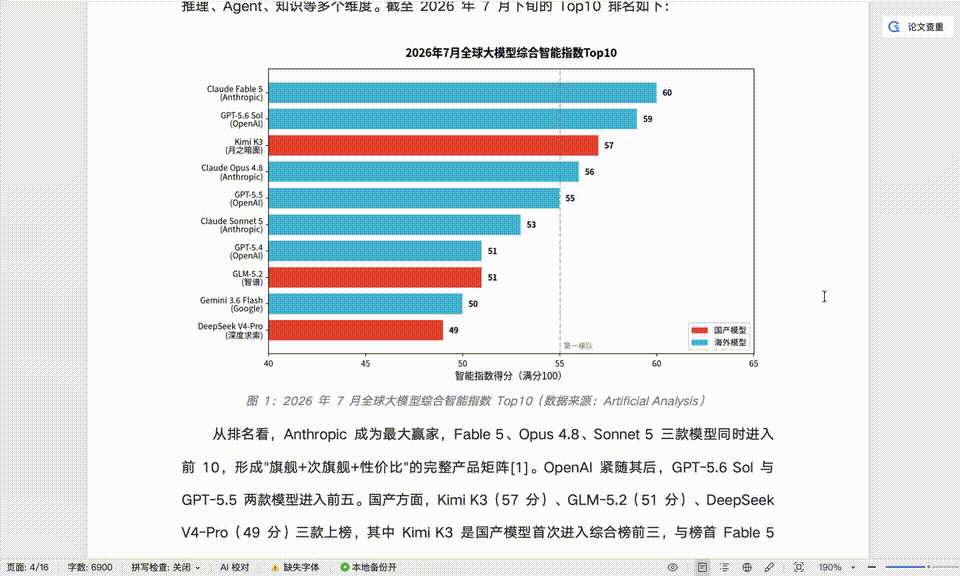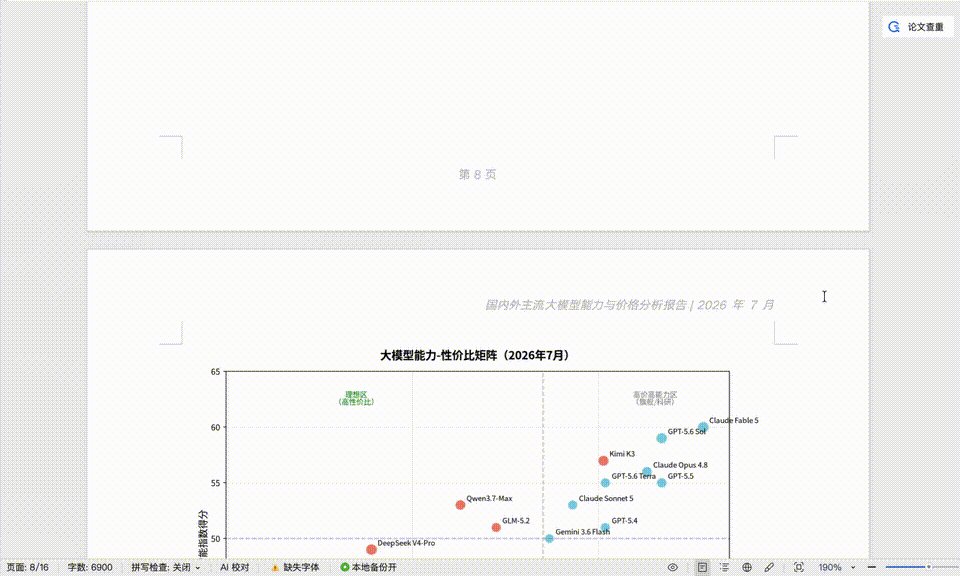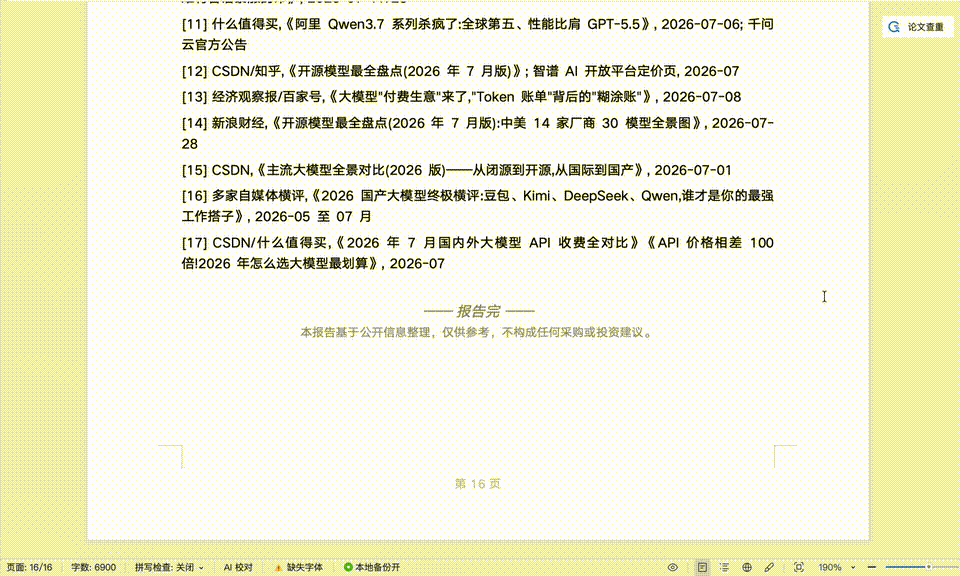
Die nützliche Forschungsschleife lautet:
Suche
→ Unsicherheit identifizieren
→ erneut suchen
→ Quellen vergleichen
→ Diskrepanzen auflösen oder kennzeichnen
→ schreiben
Dieser zusätzliche Verifikationsdurchlauf führt oft zu einer Verbesserung der Forschungsqualität.
Das SuperCLUE-Ergebnis folgte auf einen ersten Platz im Juli bei PinchBench v2.
PinchBench wurde von Kilo entwickelt, um Agenten anhand realer Arbeitsabläufe zu bewerten, anstatt anhand traditioneller Frage-Antwort-Benchmarks.
Die Veröffentlichung von Kilo's PinchBench 2.0 erweiterte den Benchmark auf 148 Aufgaben und fügte strengere Bewertungs- und Leaderboard-Regeln hinzu.
Im Juli-Leaderboard-Schnappschuss, der im Quellartikel wiedergegeben wird, erschien Baidus System als:
Orion-Mission-Mode
mit:
Bestpunktzahl:    94,6%
Durchschnittspunktzahl: 94,4%
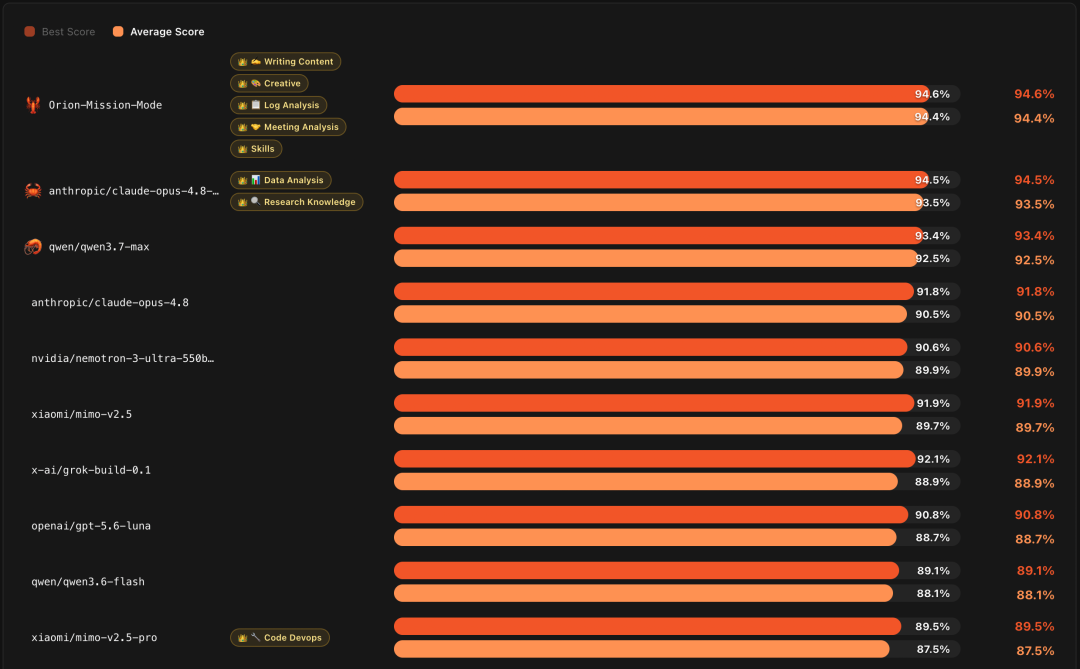
Der Screenshot platziert Orion Mission Mode in diesem speziellen Schnappschuss vor Systemen, die auf Modellen von Anthropic, Alibaba, NVIDIA, Xiaomi, xAI, OpenAI und anderen basieren.
Das entscheidende Wort ist Schnappschuss.
Agenten-Leaderboards ändern sich schnell.
Modelle, Testumgebungen, Prompts, Tool-Richtlinien und Benchmark-Einreichungen können alle aktualisiert werden.
Ein erster Platz im Juli sollte daher mit seinem Datum zitiert werden und nicht als dauerhaftes globales Ranking behandelt werden.
Kilo beschreibt PinchBench 2.0 als Benchmark für reale Agenten-Workflows.
Er enthält Aufgaben, die von einem System verlangen, Tools zu verwenden und Operationen abzuschließen, anstatt einfach eine Antwort auszuwählen.
Der Benchmark deckt Kategorien ab wie:
Der Quellartikel besagt, dass 59 Modell- oder Agenten-Einträge im Leaderboard-Schnappschuss vertreten waren.
Diese Zahl kann sich ändern, wenn Einreichungen hinzugefügt oder aktualisiert werden.
Der Benchmark selbst ist stabiler als die Leaderboard-Bevölkerung.
Die offizielle Veröffentlichung von PinchBench 2.0 beschreibt:
148 Aufgaben
Die Quelle und mehrere Juli-Berichte beschreiben Wenzins Auswertung über 147 abgeschlossene Aufgaben, während sie PinchBench gleichzeitig als einen Benchmark mit 148 Aufgaben beschreiben.
Die sicherste Interpretation ist:
PinchBench v2 enthält 148 Aufgaben; die gemeldete Orion-Mission-Mode-Auswertung könnte in diesem Schnappschuss bewertete Ergebnisse für 147 davon geliefert haben.
Diese Unterscheidung ist wichtig, weil Benchmark-Berichte oft die Größe des Benchmarks mit der Anzahl der erfolgreich
abgeschlossene Läufe.
Die Quelle betont, dass der Orion-Missionsmodus Folgendes aufgezeichnet hat:
94,6 % Bestleistung
94,4 % Durchschnittsleistung
Die Differenz von 0,2 Punkten ist gering.
Das deutet auf eine geringe Schwankung zwischen den gemeldeten Läufen hin.
Es sollte jedoch nicht als universelle Stabilitätsgarantie interpretiert werden.
Die Varianz von Benchmarks kann abhängen von:
Die praktische Lehre ist schlicht, dass der gemeldete PinchBench-Lauf nicht auf einem einzelnen isolierten Glückstreffer beruhte.
Sein Durchschnitt blieb nahe an seiner Bestleistung.
Einer der wichtigsten Punkte im Quellartikel ist, dass der Benchmark ein Produkt oder Agentsystem bewertet, nicht ein nacktes Sprachmodell.
Der Aufgaben-Agent kann kombinieren:
Dies lässt sich wie folgt ausdrücken:
Agentenergebnis
=
Modellfähigkeit
+
Tools
+
Speicher
+
Planung
+
Suche
+
Ausführungsumgebung
+
Verifikation
Deshalb sollte man vorsichtig sein, wenn man sagt:
„Modell X hat Modell Y geschlagen.“
Die Rangliste vergleicht möglicherweise tatsächlich zwei verschiedene Agentenstapel mit unterschiedlichen Tools und Orchestrierung.
Eine präzisere Beschreibung wäre:
„Agentsystem X hat unter dieser Benchmark-Konfiguration besser abgeschnitten als Agentsystem Y.“
Diese Formulierung wird zunehmend wichtiger, da sich KI-Produkte in komplexe Softwaresysteme verwandeln.
Der Quellartikel betrachtet 2026 als das Jahr, in dem sich der Standard für ein nützliches KI-Produkt verschiebt.
Die ältere Interaktion sah so aus:
Benutzer fragt
→ Modell antwortet
→ Benutzer führt die Arbeit aus
Das aufkommende Agentenmuster sieht so aus:
Benutzer gibt Ziel vor
→ Agent plant
→ Agent sammelt Kontext
→ Agent ruft Tools auf
→ Agent erstellt Dateien
→ Agent prüft Ergebnisse
→ Agent liefert Artefakt
Das verändert, was Benutzer wahrnehmen.
Ein Modell kann äußerst sachkundig, aber frustrierend sein, wenn es nicht:
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die neue Erfolgsbedingung liegt näher an:
Wurde die Aufgabe tatsächlich abgeschlossen?
als:
War die Antwort beeindruckend?
Der BAAI-Artikel zeigt die Option „Aufgabe“ direkt in der Wenxin-Oberfläche.
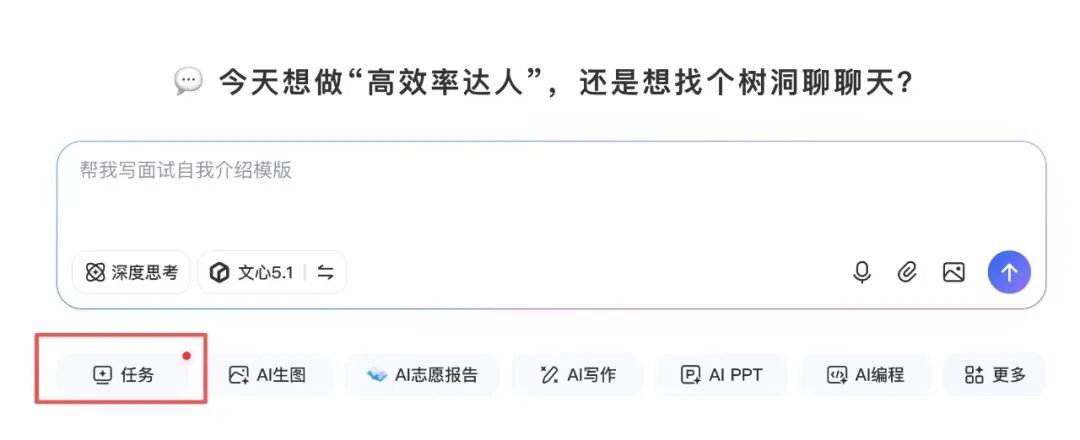
Die offizielle Wenxin-Website von Baidu beschreibt das Produkt als multimodalen KI-Assistenten für:
Geräteübergreifende Nutzung.
Die Baidu-App listet Wenxin Assistant ebenfalls als integrierte KI-Funktion für Deep Research, Suche, Schreiben, Bildgenerierung, Videogenerierung und Konversationsunterstützung.
Dies bestätigt, dass aufgabenorientierte KI in Baidus Mainstream-Verbraucheroberflächen Einzug gehalten hat und nicht länger ein reines Entwicklerexperiment ist.
Der Quellartikel hebt wiederholt einen kommerziellen Punkt hervor:
Wenxin Assistant ist kostenlos und hat keine Bezahlschranke.
Baidus offizielle Wenxin-Seiten bieten derzeit kostenlosen Zugang oder eine kostenlose Testphase.
Das ist leicht zu überprüfen.
Die stärkere Aussage—dauerhaft unbegrenzt für alle Aufgaben-Agent-Funktionen—ist anhand einer stabilen offiziellen Richtlinienseite schwerer zu verifizieren.
KI-Produkte können einführen:
Für die Veröffentlichung ist die sicherere Formulierung:
Wenxin Assistant ist derzeit für einzelne Nutzer mit Optionen für kostenlosen Zugang verfügbar, und die im Quellartikel gezeigte Aufgabenerfahrung erforderte kein kostenpflichtiges Abonnement.
Erstellen Sie keinen langfristigen Kostenvergleich auf Basis von „unbegrenzt für immer“, es sei denn, Baidu veröffentlicht eine spezifische Richtlinie, die dies garantiert.
Der letzte Abschnitt des Quellartikels argumentiert, dass Baidus Suchverlauf ihm einen strukturellen Vorteil beim Agentendesign verschafft.
Es gibt eine echte Analogie.
Eine Suchmaschine verarbeitet etwa Folgendes:
Nutzerabfrage
→ Intent-Verständnis
→ Abfragezerlegung
→ Abruf
→ Ranking
→ Ergebnisaggregation
→ Antwort
Ein Agent verarbeitet:
Nutzerziel
→ Intent-Verständnis
→ Aufgabenzerlegung
→ Tool-Auswahl
→ Ausführung
→ Ergebnisaggregation
→ Bereitstellung
Die beiden Pipelines sind nicht identisch.
Ein Agent hat einen viel größeren Aktionsraum und trägt ein höheres Ausführungsrisiko.
Aber mehrere technische Fähigkeiten übertragen sich natürlich:
Dies ist besonders relevant für Research-Agenten.
Ein System, das bereits über eine starke Suchinfrastruktur verfügt, kann darauf tiefere Workflows aufbauen.
Betrachten Sie eine traditionelle Suchanfrage:
Finde den günstigsten Flug von Peking nach Shanghai.
Ein Suchsystem muss möglicherweise ableiten:
Ein Agent, der gebeten wird:
Finde den günstigsten Flug Peking–Shanghai und erstelle eine Reiseroute.
muss möglicherweise hinzufügen:
Die erste Hälfte des Problems ähnelt der Suche.
Die zweite Hälfte ist Aktionsorchestrierung.
Sucheerfahrung liefert nützliche Komponenten, aber die Agentenqualität hängt weiterhin von der Ausführungsebene ab.
Die Quelle verbindet auch Wenhins Gedächtnisbewertung mit Baidus Erfahrung im Verständnis von Suchsitzungen.
Es gibt
einige konzeptionelle Überschneidungen.
Beide Systeme müssen ableiten, welche Informationen aus früheren Interaktionen weiterhin relevant sind.
Eine Suchsitzung kann Folgendes enthalten:
Anfrage 1: Elektroautos
Anfrage 2: Reichweite über 600 km
Anfrage 3: unter 250.000 RMB
Das System sollte verstehen, dass sich die dritte Anfrage immer noch auf Elektroautos bezieht.
Ein Agenten-Gedächtnissystem hat eine schwierigere Aufgabe.
Es muss sich möglicherweise merken:
Suchsitzungs-Know-how ist nützlich, aber ein persistentes Agenten-Gedächtnis erfordert zusätzliche Mechanismen für Speicherung, Abruf, Datenschutz und Relevanz.
Unter den fünf XClaw-Kategorien ist die Forschungsanalyse der klarste Bereich, in dem Baidus Suchhintergrund direkt übertragbar ist.
Ein Forschungsagent benötigt:
Baidus offizielle Qianfan-KI-Assistent-Dokumentation beschreibt ebenfalls eine Unternehmens-Agentenlösung, die Baidu-Suche, Baidu Baike, Bildersuche, Gesprächsverwaltung, Gedächtnisverwaltung und Dokumentfunktionen integriert.
Das beweist nicht, dass das Verbraucherprodukt Wenxin exakt dieselbe Implementierung verwendet.
Es zeigt jedoch, dass Baidu einen gemeinsamen Agenten-Stack rund um Suche, Gedächtnis, Tools und multimodalen Abruf über sein Produktportfolio hinweg aufbaut.
Hohe Benchmark-Ergebnisse sind nützliche Belege.
Sie sind nicht die vollständige Bewertung.
Ranglisten ändern sich.
Neue Modelle und neue Agenten-Einreichungen können den aktuellen Spitzenreiter überholen.
XClaw aggregiert ausgewählte Aufgaben und Kategorien.
Der reale Arbeitsablauf eines Benutzers kann ganz anders aussehen.
Die Punktzahl gehört zum vollständigen Assistenten- oder Agenten-Stack.
Ein Agent, der Aufgaben effizient erledigen kann, könnte dennoch unsichere Tool-Aufrufe tätigen oder in einer anderen Umgebung vertrauliche Informationen offenlegen.
Forschungsagenten können schwache Quellen zitieren oder sich ändernde Daten falsch interpretieren.
Produktpreise und Kontingente sind kommerzielle Richtlinien, keine Benchmark-Eigenschaften.
Ein sinnvoller persönlicher Test sollte Ihrer realen Arbeit ähneln.
Stellen Sie nicht nur Wissensfragen.
Geben Sie dem Agenten eine vollständige Aufgabe.
Geben Sie zu Beginn eines langen Gesprächs fünf Einschränkungen vor.
Stellen Sie nach mehreren unzusammenhängenden Gesprächsrunden eine abschließende Ausgabe an und prüfen Sie, ob alle fünf erhalten bleiben.
Laden Sie hoch:
Bitten Sie den Agenten, diese zu einem Bericht zu kombinieren.
Überprüfen Sie jeden numerischen Wert unabhängig.
Wählen Sie ein Thema mit sich ändernden Informationen.
Verlangen Sie:
Erstellung
Bitten Sie um ein Word-, PowerPoint-, Tabellenkalkulations- oder HTML-Artefakt.
Bewertung:
Bitten Sie um eine kleine interaktive Anwendung.
Prüfen Sie:
Geben Sie eine Aufgabe, die mehrere Werkzeuge erfordert.
Beobachten Sie, ob das System:
Beim Vergleich von Wenxin mit anderen Agenten verwenden Sie eine Tabelle, die breiter ist als eine „Benchmark-Punktzahl“.
| Dimension | Was gemessen wird |
|---|---|
| Aufgaben-Erfolg | Wurde die angeforderte Arbeit abgeschlossen? |
| Speicher | Wurden frühere Einschränkungen beibehalten? |
| Genauigkeit | Sind Zahlen und Aussagen korrekt? |
| Recherche-Qualität | Sind Quellen autoritativ und aktuell? |
| Werkzeug-Zuverlässigkeit | Gelingen Werkzeugaufrufe durchgängig? |
| Artefakt-Qualität | Sind Dateien ohne manuelle Reparatur nutzbar? |
| Erholung | Kann der Agent fehlgeschlagene Schritte beheben? |
| Latenz | Wie lange dauert eine vollständige Aufgabe? |
| Kosten | Was kostet ein akzeptiertes Ergebnis? |
| Datenschutz | Wie werden hochgeladene Dateien und Speicher behandelt? |
| Verfügbarkeit | Sind Kernfunktionen kostenlos, kontingentbegrenzt oder kostenpflichtig? |
Dies ergibt ein realistischeres Bild als ein einzelner Ranglistenplatz.
Der stärkste Punkt des Quellartikels geht über Baidu hinaus.
Der Agenten-Wettbewerb verändert die Definition von KI-Qualität.
Für die erste Generation von Chatbots konzentrierten sich die Nutzer auf die Antwortqualität.
Für aktuelle Aufgaben-Agenten werden die Schlüsselfragen zunehmend:
Deshalb erregen Benchmarks wie XClaw und PinchBench Aufmerksamkeit.
Sie bringen die Bewertung näher an die Produktionsarbeit.
Zwischen einem Benchmark und einer Unternehmensbereitstellung liegt noch eine lange Strecke.
Aber die Richtung ist nützlich:
Wissens-Benchmark
→ Denk-Benchmark
→ Werkzeugnutzungs-Benchmark
→ End-to-End-Aufgaben-Benchmark
→ Echtes Produktionsergebnis
Der letzte Schritt ist letztendlich der, der zählt.
Die SuperCLUE-XClaw-Momentaufnahme vom August 2026 gibt Wenxin Assistant eine Gesamtpunktzahl von 97,62 und platziert es damit auf dem ersten Platz der gezeigten Produkte. Die Kategoriewerte betrugen 90,28 für Programmierung, 99,44 für Inhaltserstellung, 98,86 für Datenverarbeitung, 96,44 für Recherche-Analyse und 100 für Speicher.
Es bedeutet, dass Wenxin bei den in dieser XClaw-Bewertung enthaltenen Speicheraufgaben die volle Punktzahl erhalten hat. Es bedeutet nicht, dass der Assistent in jedem möglichen realen Gespräch niemals den Kontext vergessen kann.
PinchBench v2 ist ein Agenten-Benchmark von Kilo, der Systeme an realen Computer- und Arbeitsablaufaufgaben bewertet. Version 2.0 enthält 148 Aufgaben und ist darauf ausgelegt, zu messen
End-to-End-Ausführung statt einfacher Beantwortung von Fragen.
In einer Leaderboard-Aufnahme vom Juli 2026 erschien Baidus Task-Agent als Orion Mission Mode mit einer Bestwertung von 94,6 % und einer Durchschnittswertung von 94,4 %. Leaderboards ändern sich im Laufe der Zeit, daher sollte bei der Zitierung des Ergebnisses das Datum der Aufnahme angegeben werden.
Die offiziellen Baidu-Wenxin-Seiten bieten derzeit Optionen für kostenlosen Zugang oder kostenlose Testversionen an, und der Quellartikel besagt, dass die demonstrierten Aufgabenfunktionen ohne kostenpflichtiges Abonnement verfügbar waren. Eine dauerhafte offizielle Garantie für unbegrenzte Nutzung aller Funktionen wurde nicht gefunden, daher sollten aktuelle Kontingente direkt im Produkt geprüft werden.
Der Quellartikel zeigt Testsitzungen, in denen Wenxin ein formatiertes Word-Geschäftsplandokument und interaktive HTML-Seiten erstellte. Diese Beispiele demonstrieren den Aufgaben-Workflow des Produkts, sind jedoch keine Garantie dafür, dass jede Eingabeaufforderung oder Umgebung dasselbe Ergebnis liefert.
Suche und Agenten teilen Fähigkeiten wie Absichtsverständnis, Abfragezerlegung, Abruf, Ranking, Quellenaggregation und Sitzungskontext. Agenten fügen eine breitere Ausführungsebene hinzu, einschließlich Tool-Aufrufen, Dateierstellung, Speicher, Planung und Aktionen.
Nicht im engeren Sinne. Sie bewerten Produkt- oder Agentensysteme, die Modelle mit Tools, Speicher, Suche, Eingabeaufforderungen, Orchestrierung und Ausführungsumgebungen kombinieren können. Ihre Ergebnisse sollten daher der vollständigen Agentenkonfiguration zugeschrieben werden.
Evaluation](https://superclueai.com/xclawpage?category=openclaw&name=SuperCLUE-XClaw%E9%BE%99%E8%99%BE%E4%BA%A7%E5%93%81%E6%B5%8B%E8%AF%84&folder=XClaw&date_if_exists=2026%E5%B9%B48%E6%9C%88): Die Benchmark-Seite, auf die der ursprüngliche Artikel verweist.
Der Baidu Wenxin-Assistent belegte im August-2026-XClaw-Schnappschuss von SuperCLUE den ersten Platz mit 97,62 Punkten, darunter perfekte 100 Punkte im Speicher und Werte über 96 bei Datenverarbeitung, Inhaltserstellung und Recherche-Analyse.
Dieses Ergebnis folgt auf einen PinchBench-v2-Leaderboard-Schnappschuss vom Juli, bei dem Baidus Orion-Missionsmodus einen Bestwert von 94,6 % und einen Durchschnittswert von 94,4 % erzielte. Die Benchmarks verwenden unterschiedliche Aufgaben, aber beide legen den Schwerpunkt auf die tatsächliche Aufgabenerfüllung statt auf einfache Fragenbeantwortung.
Die wichtigste Erkenntnis ist nicht, dass ein Assistent das Agenten-Rennen dauerhaft „gewonnen“ hat. Agenten-Rankings ändern sich schnell, und die gemessenen Systeme umfassen Modelle, Tools, Suche, Speicher, Eingabeaufforderungen und Orchestrierung.
Was die beiden Ergebnisse zeigen, ist, dass die KI-Bewertung zu einem praxisorientierteren Standard übergeht: nicht ob das Modell intelligent klingt, sondern ob der Agent die Arbeit erledigen und ein brauchbares Ergebnis zurückliefern kann.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



