Name: Deployment – Produktionsumgebung Beschreibung: Verifizieren und Bereitstellen der Anwendung in der Produktionsumgebung. --- 1. Lesen S...
checklist.md.scripts/verify-release.sh aus.
Der entscheidende Mechanismus ist die **schrittweise Offenlegung**.

Claude sieht eine kurze Beschreibung, die ihm hilft zu entscheiden, ob eine Fähigkeit relevant ist. Der vollständige Text der Fähigkeit und unterstützende Dateien werden nur geladen, wenn der Prozess benötigt wird.

Mukta vergleicht dies mit einem Bücherregal.

Eine Person muss sich nicht jedes Buch merken, bevor sie ein Gespräch beginnt. Sie muss nur wissen, welches Buch relevante Informationen enthalten könnte, und es im passenden Moment herausnehmen.

Fähigkeiten helfen, das Problem der „ständig wachsenden Kontextdatei“ zu lösen:

- Stabile, hochrangige Fakten können in `CLAUDE.md` verbleiben.
- Detaillierte Prozesse können in Fähigkeiten verschoben werden.
- Unterstützende Materialien können bis zur Notwendigkeit außerhalb des aktiven Kontexts bleiben.

Die offizielle Dokumentation zu Fähigkeiten von Anthropic empfiehlt, Fähigkeiten zu erstellen, wenn Teams wiederholt dieselben Anweisungen, Checklisten oder mehrstufigen Prozesse in Gespräche einfügen oder wenn ein Abschnitt von `CLAUDE.md` sich von einer prägnanten Tatsache zu einem Prozess entwickelt hat.

### Fähigkeiten erfordern weiterhin menschliche Verwaltung

Fähigkeiten sind wiederverwendbar, aber es muss weiterhin jemand entscheiden:

- Welche Arbeitsabläufe eine Fähigkeit verdienen
- Wie der Prozess strukturiert sein sollte
- Welche Dateien enthalten sein sollten
- Wann eine Fähigkeit veraltet ist
- Wer die Berechtigung hat, sie zu bearbeiten

Agenten können beim Schreiben und Pflegen von Fähigkeiten helfen, aber das System bleibt teilweise von menschlicher Verwaltung abhängig.

Dies führt zur vierten Methode.

## Vierte Generation: Das Dateisystem als Gedächtnis betrachten

Mukta beschreibt das dateisystembasierte Gedächtnis als das Muster, das Anthropic derzeit in vielen Agent-Gedächtnissystemen bevorzugt.

Die Begründung ist äußerst pragmatisch.

Agenten sind bereits gut darin:

- Dateien aufzulisten
- Dateinamen zu durchsuchen
- `grep` auszuführen
- Markdown zu lesen
- Verzeichnisse zu durchsuchen
- Text zu bearbeiten
- Versionen zu vergleichen

Anstatt eine hochspezialisierte Gedächtnisschnittstelle zu erfinden, können Teams das Gedächtnis als Dateien organisieren und dem Agenten gewöhnliche Dateisystemwerkzeuge bereitstellen.

Eine mögliche Struktur sieht wie folgt aus:

```Plaintext
memory/
├── organization/
│   ├── principles.md
│   ├── terminology.md
│   └── security-policy.md
├── teams/
│   ├── engineering/
│   │   ├── architecture.md
│   │   └── release-process.md
│   └── support/
│       ├── escalation-rules.md
│       └── response-style.md
├── projects/
│   └── billing-redesign/
│       ├── decisions.md
│       ├── known-issues.md
│       └── current-status.md
└── agents/
    └── agent-104/
        └── scratchpad.md
Diese Struktur unterstützt verschiedene Ebenen des Gedächtnisses:
Sie verkörpert auch die schrittweise Offenlegung.
Der Agent kann Verzeichnisse durchsuchen und nur die Dateien laden, die für die aktuelle Aufgabe relevant sind.
Die dateisystemartige Schnittstelle erfordert nicht, dass jedes Unternehmensgedächtnis als unverwaltete Dateien auf einem Laptop existiert.
Die zugrunde liegende Implementierung kann weiterhin verwenden:
Der entscheidende Punkt ist, dass der Agent eine einfache, navigierbare Abstraktion erhält.
In der Fragerunde fragte ein Zuhörer, ob dies einer Neuerfindung der Datenbank gleichkomme.
Mukta erkannte an, dass diese Architektur zu vertrauten Prinzipien der Softwareentwicklung zurückkehrt. Sobald Teams verstehen, welche Verhaltensweisen deterministisch sein sollten, können sie diese in ein Kontrollframework verschieben, anstatt das Modell jedes Mal improvisieren zu lassen.
Ein Ordner voller Markdown-Dateien kann für einen einzelnen Benutzer funktionieren.
Aber wenn Tausende von Agenten ein gemeinsames organisatorisches Gedächtnis aktualisieren können, wird dies gefährlich.
Mukta betont vier Produktionsprinzipien:
Jede Aktualisierung des Gedächtnisses sollte eine Historie haben.
Nützliche Metadaten umfassen:
Gedächtniseinträge ohne Herkunftsnachweis sind schwer vertrauenswürdig.
Angenommen, ein Agent fügt hinzu:
- Produktionsbereitstellungen am Freitag benötigen keine Genehmigung.
Ohne Herkunft, Prüfer und Revisionshistorie könnte ein anderer Agent diese Aussage als maßgeblich betrachten.
Versionskontrolle unterstützt:
Ein versioniertes Gedächtnissystem sollte leicht beantworten können:
Welche Interaktion hat zu dieser Regel geführt?
Zwei Agenten könnten um 10:00 Uhr denselben Gedächtniseintrag gelesen haben.
Agent A schreibt um 10:02 Uhr eine Aktualisierung.
Agent B, der diese Änderung nicht kennt, schreibt um 10:03 Uhr seine eigene Version und löscht versehentlich die Aktualisierung von Agent A.
Mukta beschreibt ein hashbasiertes Nebenläufigkeitsmuster:
Agent liest Gedächtnis und notiert Hash A
        ↓
Agent entwirft Aktualisierung
        ↓
Agent liest Gedächtnis erneut und notiert Hash B
        ↓
Wenn Hash A == Hash B:
    Aktualisierung übernehmen
Andernfalls:
    Neu laden, neu basieren und erneut versuchen
Dies ist optimistische Nebenläufigkeitskontrolle.
Das Modell kann entscheiden, welche Änderung vorgeschlagen wird, aber das Kontrollframework sollte deterministisch verhindern, dass veraltete Schreibvorgänge neuere Versionen ersetzen.
Nicht jeder Agent sollte berechtigt sein, jeden Gedächtniseintrag zu bearbeiten.
Ein sinnvolles Berechtigungsmodell könnte wie folgt aussehen:
| Gedächtnisbereich | Typischer Zugriff |
|---|---|
| Organisationsprinzipien | Für die meisten Agenten nur lesbar; Schreiben nur über Überprüfungsprozess |
| Sicherheitsrichtlinien | Für relevante Agenten nur lesbar; eingeschränktes, menschlich kontrolliertes Schreiben |
| Teamprozesse | Für Teams nur lesbar; Schreiben durch benannte Verwalter |
| Projektentscheidungen | Für Projekt-Agenten nur lesbar; vorgeschlagene Bearbeitungen benötigen Genehmigung |
| Entwurfsbereich des Agenten | Lesen und Schreiben durch einzelnen Agenten |
| Benutzerpräferenzen | Zugriff durch benutzerbezogene Agenten |
| Sensibler Kundenkontext | Strenge rollenbasierte Zugriffskontrolle |
Ein Agent sollte nicht in der Lage sein, eine unsichere Beobachtung in eine organisationsweite Regel umzuwandeln.
Berechtigungsgrenzen müssen auch auf Dreaming angewendet werden. Konsolidierungsaufgaben dürfen nur Gesprächsaufzeichnungen und Gedächtnisinhalte empfangen, auf die ihre Identität autorisiert ist.
Das Gedächtnis könnte eines der wertvollsten KI-Vermögenswerte einer Organisation werden.
Es enthält:
Mukta ist der Ansicht, dass Teams vermeiden sollten, dieses Vermögen so zu gestalten, dass es nur innerhalb eines einzelnen Produkts funktioniert.
Ein portables Gedächtnissystem sollte Folgendes aufweisen:
Portabilität ermöglicht es, dass derselbe sorgfältig kuratierte Kontext unterstützt:
Selbst gut gestaltete Gedächtniswerkzeuge weisen zwei strukturelle Einschränkungen auf.
Der Agent muss gleichzeitig Aufgaben erledigen und das Gedächtnis pflegen.
Das Schreiben in das Gedächtnis verbraucht Ressourcen, die für das aktuelle Ziel verwendet werden könnten.
Agenten könnten:
Einschränkung Zwei: Ein Agent sieht nur eine Sitzung
Ein Agent könnte bemerken, dass ein bestimmter Befehl einmal fehlgeschlagen ist.
Er kann nicht sehen, dass derselbe Befehl in 300 anderen Sitzungen ebenfalls fehlgeschlagen ist.
Ein Support-Agent könnte sehen, dass ein Kunde über eine bestimmte Richtlinie verwirrt ist.
Er kann nicht sehen, dass dieselbe Verwirrung im gesamten Gebiet immer wieder auftritt.
Ein systemweiter Lernmechanismus benötigt einen Prozess mit größerer Sichtbarkeit.
Dieser Prozess ist das, was Anthropic als "Träumen" (Dreaming) bezeichnet.
Träumen ist ein asynchroner Prozess, der nach Abschluss der normalen Arbeit einen Rückblick auf die Agentenhistorie durchführt.
In den aktuellen API-Versionshinweisen von Anthropic wird die "Dreaming"-Funktion für gehostete Claude-Agenten als Forschungsvorschau beschrieben.
Ein "Traum" liest:
Anschließend erstellt es einen reorganisierten Ausgabespeicher, in dem:
Dies ist kein Modell-Retraining.
Die Gewichte des zugrunde liegenden Modells bleiben unverändert.
Die Verbesserung entsteht durch die Änderung des persistenten Kontexts, sodass zukünftige Sitzungen diese Inhalte abrufen können.
Mukta verwendet eine Schule, um den Unterschied zwischen normalem Gedächtnis und dem "Träumen" zu erklären.
Stellen Sie sich vor:
Ein Lehrer kann einem Schüler helfen, einen Fehler zu korrigieren.
Der Schulleiter kann jedoch feststellen, dass jeder Geographie-Schüler bei demselben Wissenspunkt einen Fehler macht, weil dieses Thema gar nicht im Lehrplan enthalten ist.
Die Korrektur auf Systemebene besteht nicht darin, jede Arbeit einzeln zu korrigieren.
Sondern darin, den Lehrplan zu aktualisieren.
Agenten-Terminologie:
Dies ermöglicht es dem System, aus Mustern zu lernen, die einzelne Agenten nicht erkennen können.
Eine vereinfachte Pipeline der Traum-Verarbeitung sieht folgendermaßen aus:
Flussdiagramm TD
    A[Bestehender Speicherbestand] --> D[Traum-Orchestrator]
    B[Sitzungsaufzeichnungen] --> D
    C[Werkzeugaufrufe und Metadaten] --> D
    D --> E1[Bewertungsagent 1]
    D --> E2[Bewertungsagent 2]
    D --> E3[Bewertungsagent 3]
    E1 --> F[Muster-Aggregator]
    E2 --> F
    E3 --> F
    F --> G[Vorgeschlagene Speicheränderungen]
    G --> H{Menschliche Genehmigung}
    H -->|Werden angenommen| I[Aktualisierter Speicherbestand]
    H -->|Abgelehnt| J[Bestehender Speicher bleibt erhalten]
Der Bewertungsprozess kann Inhalte prüfen, die über Benutzer- und Assistentennachrichten hinausgehen.
Nützliche Beweise umfassen:
Traum-Agenten suchen anschließend nach Mustern wie:
Mukta erwähnte, dass das Design von Anthropic Beispiele relevanter Sitzungsaufzeichnungen sowie Statistiken zur Häufigkeit der Muster umfassen kann.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Diese Beweise helfen Menschen zu beurteilen, ob die vorgeschlagenen Speicheränderungen sinnvoll sind.
Der Traum-Verarbeitungsprozess hat umfangreichen Zugriff und kann das zukünftige Verhalten eines gesamten Agenten-Clusters beeinflussen.
Dies macht automatische und ungeprüfte Aktualisierungen riskant.
Ein sichererer Arbeitsablauf ist:
Zum Beispiel:
## Vorgeschlagene Speicheraktualisierung

**Ziel:** `teams/engineering/test-process.md`

**Beobachtetes Problem:**
Agenten verwendeten in 18 von 63 relevanten Sitzungen den Unit-Test-Befehl, um Integrationstests auszuführen.

**Beweise:**
Sitzungen `s-102`, `s-111`, `s-118`, `s-124`, ...

**Vorgeschlagene Ergänzung:**
- Verwenden Sie `npm run test:integration` für alle Tests, die Datenbankcontainer benötigen.
- Verwenden Sie `npm test` nicht für Dateien unter `tests/integration/`.

**Konfidenz:** Hoch

**Menschliche Entscheidung:** Ausstehend
Dies erhält die menschliche Aufsicht und ermöglicht es dem Agenten-Cluster gleichzeitig, den Großteil der Analysearbeit zu erledigen.
Traum-Verarbeitung erfordert zusätzliche Modellaufrufe.
Auf den ersten Blick scheint dies unnötiger Overhead zu sein.
Mukta argumentiert, dass ein saubererer Speicherbestand die Gesamtkosten senkt, weil zukünftige Agenten mit höherer Wahrscheinlichkeit beim ersten Versuch Aufgaben korrekt erledigen.
Beim ersten Versuch.
Ein nützlicher wirtschaftlicher Vergleich ist:
Kosten des Träumens
gegenüber
Kosten von wiederholtem Scheitern, Wiederholungsversuchen, Nacharbeit und überlangen Kontexten
Potenzielle Einsparungen können entstehen durch:
Anthropic hat noch keinen allgemeinen Benchmark veröffentlicht, der zeigt, wie viel jede Organisation sparen kann. Der konkrete Wert hängt ab von:
Wenn viele Agenten ähnliche Aufgaben ausführen und wiederholt auf dieselben Muster stoßen, zahlt sich "Träumen" am wahrscheinlichsten aus.
Ein Team muss nicht auf eine vollständige Plattformintegration warten, um dieses Konzept zu testen.
Eine manuelle Version kann einmal pro Woche ausgeführt werden.
Sammeln Sie nur die Gesprächsaufzeichnungen, die der Prüfer einsehen darf.
Strukturieren Sie sie nach:
Enthalten:
CLAUDE.mdDie Eingabeaufforderung könnte so aussehen:
Überprüfen Sie diese autorisierten Sitzungsaufzeichnungen und die aktuellen Speicherdateien.

Identifizieren Sie wiederkehrende Fehler, wiederholte Nutzerkorrekturen, veraltete Anweisungen,
fehlende Prozesse und doppelte Einträge.

Für jede vorgeschlagene Änderung:
1. Geben Sie die Zieldatei an.
2. Nennen Sie die unterstützenden Sitzungs-IDs.
3.

Erklären Sie die Häufigkeit, mit der dieses Muster auftritt.
4. Entwerfen Sie die minimal wirksame Änderung.
5. Bearbeiten Sie die Datei nicht direkt.
Lehnen Sie die folgenden Änderungen ab:
Verwenden Sie Versionskontrolle und fügen Sie Quellennachweise in den Commit- oder Audit-Datensatz ein.
Verfolgen Sie, ob derselbe Fehler in nachfolgenden Sitzungen seltener auftritt.
Ohne Messung wird „Träumen" zu einer Dokumentationsaufgabe und nicht zu einem lernenden System.
Das Gedächtnis beantwortet:
Was sollte der Agent aus früherer Arbeit behalten?
Die Graphenstruktur-Technik beantwortet eine andere Frage:
Welche Teile der aktuellen Aufgabe hängen tatsächlich voneinander ab?
Der BAAI-Quellartikel verbindet das Thema Gedächtnis mit einem Leitfaden zur Graphenstruktur-Technik, der in der KI-Entwicklungsgemeinschaft kursiert.
Der Kernpunkt dieses Leitfadens ist, dass viele „Workflows" im Wesentlichen bereits Graphen sind – nur schlecht gestaltet.
Als Listen geschriebene Workflows werden oft künstlich in serielle Abläufe gezwungen:
Recherche
    ↓
Zusammenfassung
    ↓
Vergleich
    ↓
Faktenprüfung
    ↓
Schreiben
Einige dieser Schritte hängen tatsächlich von den vorherigen Ausgaben ab.
Andere warten möglicherweise unnötig.
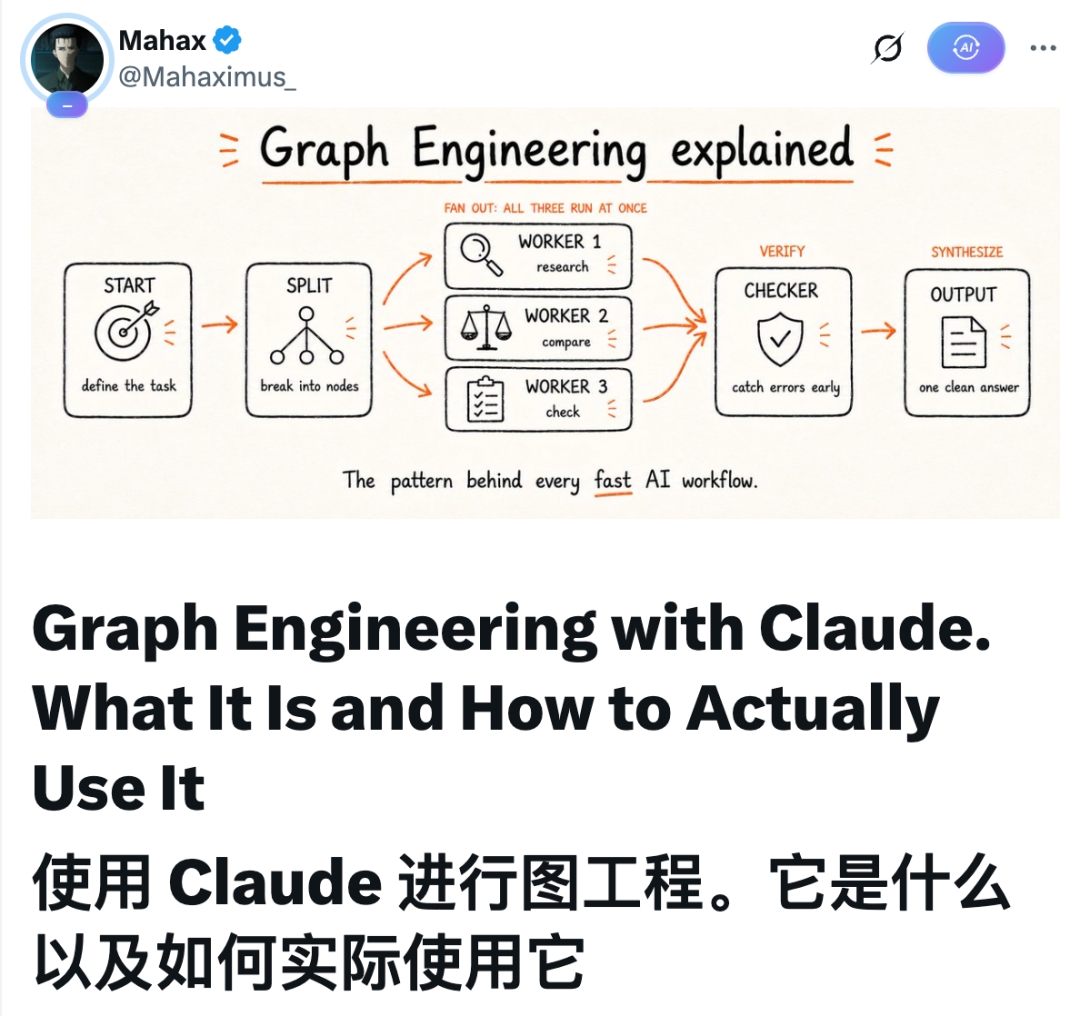
Im Workflow-Graphen:
Zum Beispiel:
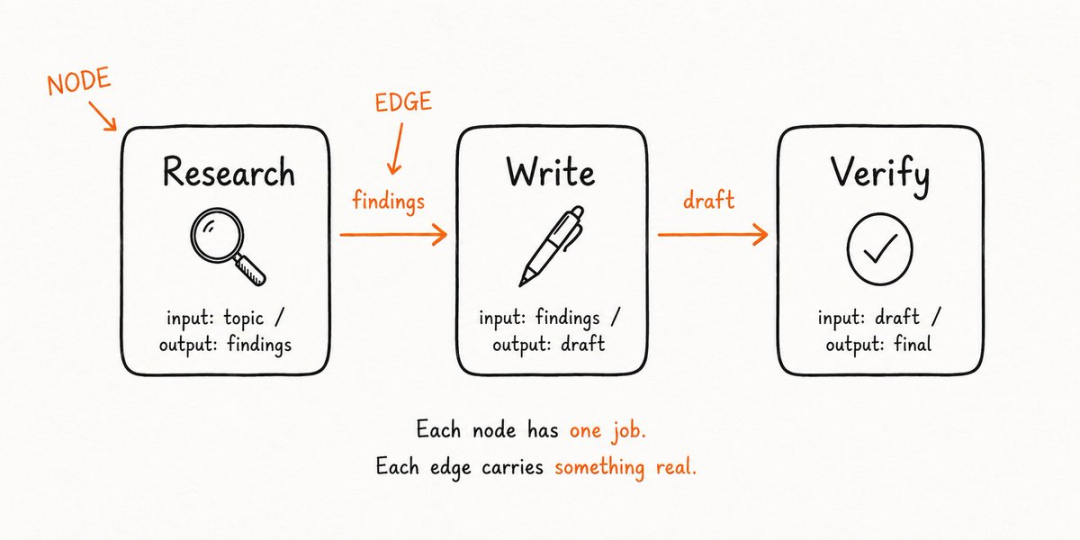
Der Recherche-Knoten erzeugt Forschungsergebnisse.
Der Schreib-Knoten konsumiert diese Ergebnisse und erzeugt einen Entwurf.
Der Prüf-Knoten konsumiert den Entwurf und erzeugt ein überprüftes Ergebnis.
Diese Pfeile sind sinnvoll, weil jeder nachgelagerte Knoten die Ausgabe des vorgelagerten Knotens benötigt.
Der Community-Graphen-Leitfaden schlägt einen einfachen Test für jede Kante vor:
Benötigt die nächste Aufgabe wirklich die Ausgabe der vorherigen Aufgabe?
Wenn die Antwort nein ist, handelt es sich um eine Pseudo-Abhängigkeit.
Betrachten Sie den folgenden Workflow:
Wettbewerber A recherchieren
    ↓
Wettbewerber B recherchieren
    ↓
Wettbewerber C recherchieren
    ↓
Vergleichsbericht schreiben
Die Recherche zu Wettbewerber B benötigt normalerweise nicht die Ausgabe der Recherche zu Wettbewerber A.
Die Recherche zu Wettbewerber C benötigt normalerweise nicht die Ausgabe der Recherche zu Wettbewerber B.
Diese Aufgaben können parallel ausgeführt werden:
flowchart TD
    A[Vergleichskriterien definieren] --> B1[Wettbewerber A recherchieren]
    A --> B2[Wettbewerber B recherchieren]
    A --> B3[Wettbewerber C recherchieren]
    B1 --> C[Vergleichsbericht schreiben]
    B2 --> C
    B3 --> C
Das Entfernen von Pseudo-Kanten reduziert Wartezeiten.
Wenn die drei Recherche-Aufgaben jeweils 10, 12 und 15 Minuten dauern:
Ein Graph macht keinen einzelnen Agenten schneller.
Er ändert die Art der Planung.
Nach dem Entfernen von Pseudo-Kanten entsteht eine häufige Form:
Dies wird oft als Raute bezeichnet.
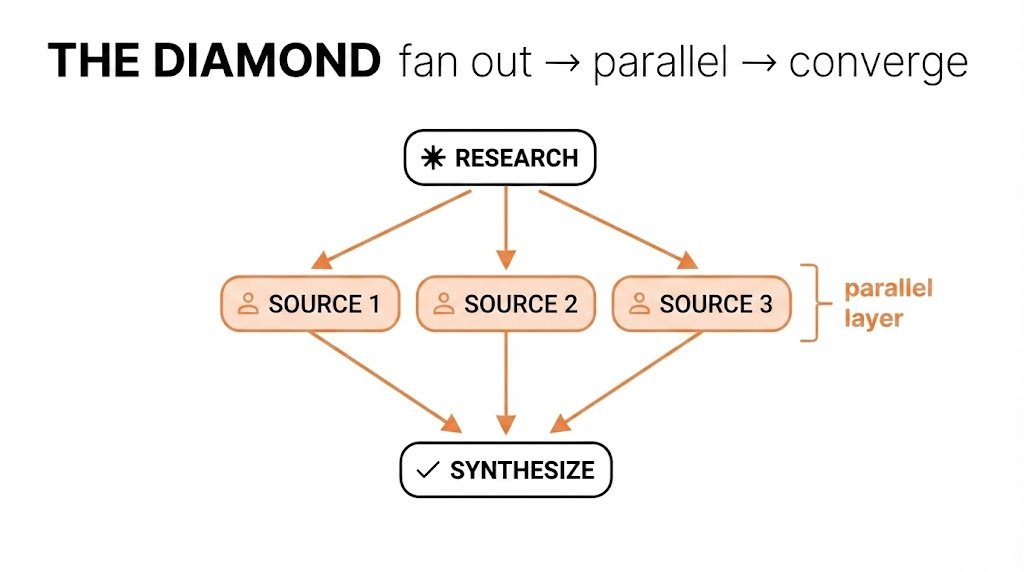
Ein Forschungsbeispiel könnte wie folgt aussehen:
flowchart TD
    A[Forschungsfrage] --> B1[Marktdaten]
    A --> B2[Kundenbelege]
    A --> B3[Wettbewerbsanalyse]
    B1 --> C[Prüfer]
    B2 --> C
    B3 --> C
    C --> D[Endgültige Synthese]
Die Gesamtdauer wird hauptsächlich vom langsamsten Zweig bestimmt, nicht von der Summe aller Zweige.
Parallelität führt ein neues
Risiko ein.
Ein Arbeitsthread könnte schwache, veraltete oder ungestützte Ergebnisse erzeugen.
Wenn das System alles ohne Validierung zusammenführt, kann ein einziger schlechter Zweig die endgültige Antwort verunreinigen.
Daher platziert der Graphen-Leitfaden vor der Synthese einen Prüfer.
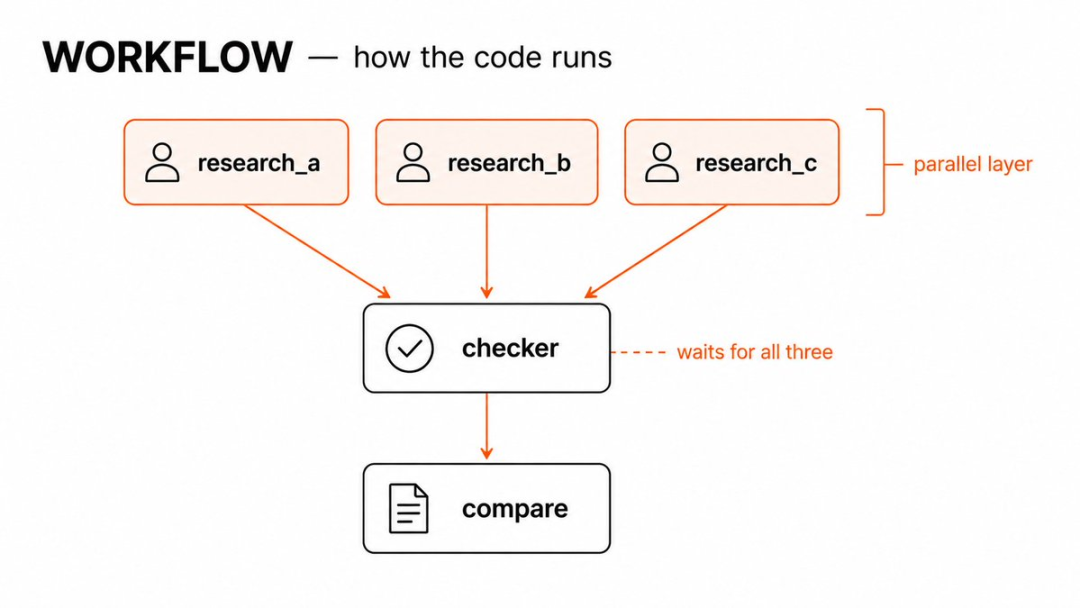
Ein Prüfer kann fragen:
Entspricht die Ausgabe dem geforderten Format?
Ein nützlicher Prüfer sollte klare Abnahmekriterien haben.
Zum Beispiel:
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



