For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/claude-code-feels-worse-model-vs.md.
Auch wenn sich das zugrunde liegende Modell nicht geändert hat, kann Claude Code manchmal den Eindruck erwecken, weniger leistungsfähig zu s...
Wenn Claude Code schwächere Ergebnisse liefert, wechseln viele Entwickler sofort zu einem größeren, teureren Modell.
Diese Reaktion ist verständlich, zielt aber oft auf die falsche Einstellung ab.
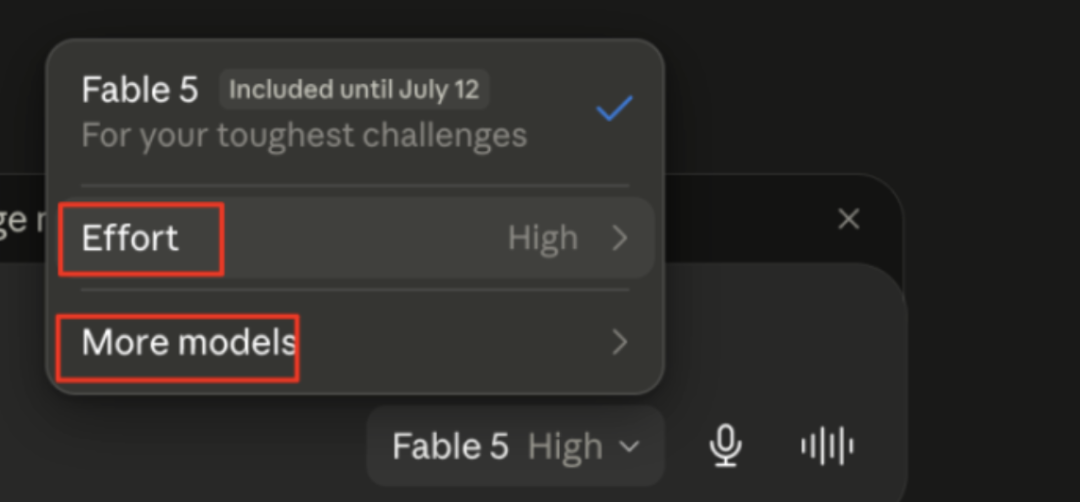
Claude Code bietet zwei Steuerungsmöglichkeiten zur Verbesserung der Ausgabe: Modell und Aufwandsniveau. Beide sind miteinander verbunden, haben aber unterschiedliche Aufgaben. Die Modellauswahl ändert die zugrunde liegenden Fähigkeiten des Systems, während das Aufwandsniveau reguliert, wie viel Arbeit Claude bereit ist, in die aktuelle Aufgabe zu investieren.
Diese Unterscheidung erklärt, warum Claude plötzlich weniger gründlich wirkt, obwohl sich das Modell selbst nicht geändert hat. Sie erklärt auch, warum ein kleineres Modell bei hohem Aufwandsniveau manchmal bessere Ergebnisse liefern kann als ein großes Modell bei niedrigem Aufwandsniveau.
Diese Verwirrung wird besonders deutlich, wenn Entwickler feststellen, dass sich das Verhalten von Claude Code ändert.
Nutzer berichten, dass Claude Dateien überspringt, die es lesen sollte, das Ausführen von Tests vermeidet, mitten in mehrstufigen Aufgaben abbricht oder sich stattdessen mit weiteren Fragen an den Nutzer wendet, anstatt selbstständig zu recherchieren.
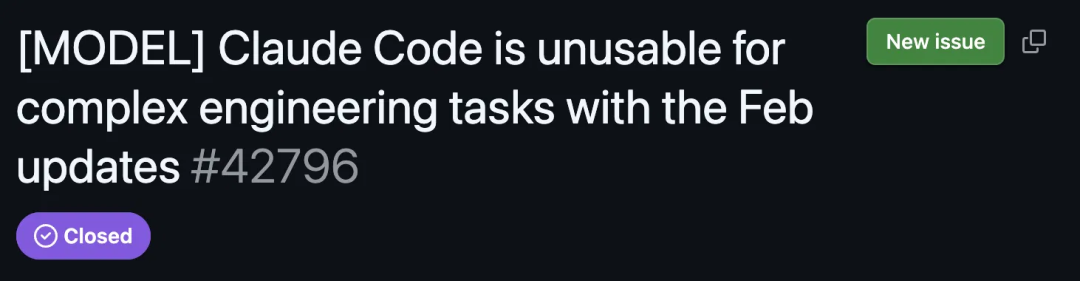
Ein viel diskutiertes GitHub-Issue beschreibt Claude Code als "für komplexe Ingenieuraufgaben unzuverlässig". Die im ursprünglichen Artikel zitierte Analyse untersuchte Tausende von Sitzungen und berichtete einen drastischen Rückgang der Denk- oder Arbeitsleistung.
Viele Nutzer dachten zunächst, ihre Eingabeaufforderungen, Repository-Anweisungen oder lokalen Konfigurationen seien fehlerhaft. Der ursprüngliche Quellartikel wies darauf hin, dass die direktere Ursache eine Änderung der Standardeinstellung des Aufwandsniveaus war.
Um die Latenz zu reduzieren, hatte Anthropic vorübergehend das Standardaufwandsniveau für einige Claude-Code-Nutzer von high auf medium gesenkt. Die Modellgewichte wurden nicht schwächer, aber Claude wurde ermutigt, für jede Aufgabe weniger Zeit, weniger Token und weniger Tool-Aufrufe aufzuwenden.
Die sichtbaren Effekte können leicht falsch interpretiert werden:
Anthropic stellte später die höheren Standardeinstellungen für die betroffenen Nutzer wieder her. Aber zu diesem Zeitpunkt hatte der Vorfall bereits einen wichtigen Punkt deutlich gemacht: Auch wenn sich das Modell selbst nicht ändert, fühlt es sich "dümmer" an, wenn sich die Aufwandsstrategie ändert.
Die Erklärung von Anthropic lässt sich auf einen praktischen Satz reduzieren:
Das Modell ändert das Gehirn. Das Aufwandsniveau bestimmt, wie gründlich dieses Gehirn an der aktuellen Aufgabe arbeitet.
Ein Modell wird durch einen festen Satz trainierter Gewichte definiert.
Nach Abschluss des Trainings bestimmen diese Gewichte das Allgemeinwissen des Modells, die erlernten Muster, die Denkfähigkeit, die Programmiererfahrung und die Fähigkeitsspanne. Eingabeaufforderungen, Repository-Dateien, CLAUDE.md und Dokumente im Kontext können das Modell lenken, aber diese Gewichte nicht überschreiben.
Das bedeutet, die Modellauswahl beantwortet hauptsächlich folgende Frage:
Kann dieses Modell diese Art von Problem lösen?
Wenn eine Bibliothek nach dem Stichtag der Trainingsdaten des Modells veröffentlicht wurde, kannst du in der aktuellen Sitzung Dokumentation bereitstellen, die das Modell verwenden kann. Das lehrt das Modell diese Bibliothek jedoch nicht dauerhaft. Das relevante Wissen existiert nur innerhalb des aktuellen Kontexts.
Die gleiche Einschränkung erklärt auch, warum ein Modell selbstbewusst eine nicht existierende API erfinden kann. Es generiert den wahrscheinlichsten nächsten Inhalt auf der Grundlage erlernter Muster, anstatt eine interne Datenbank abzufragen, die die Gültigkeit von Funktionen garantiert.
Bevor Claude Code oder Text verarbeitet, wird die Eingabe in Token aufgeteilt.
Zum Beispiel diese Codezeile:
const x = await fetch(...)
wird aus dem Vokabular des Modells in Token-IDs umgewandelt. Das Modell verarbeitet diese numerischen Darstellungen, anstatt Zeichen wie ein Mensch zu lesen.
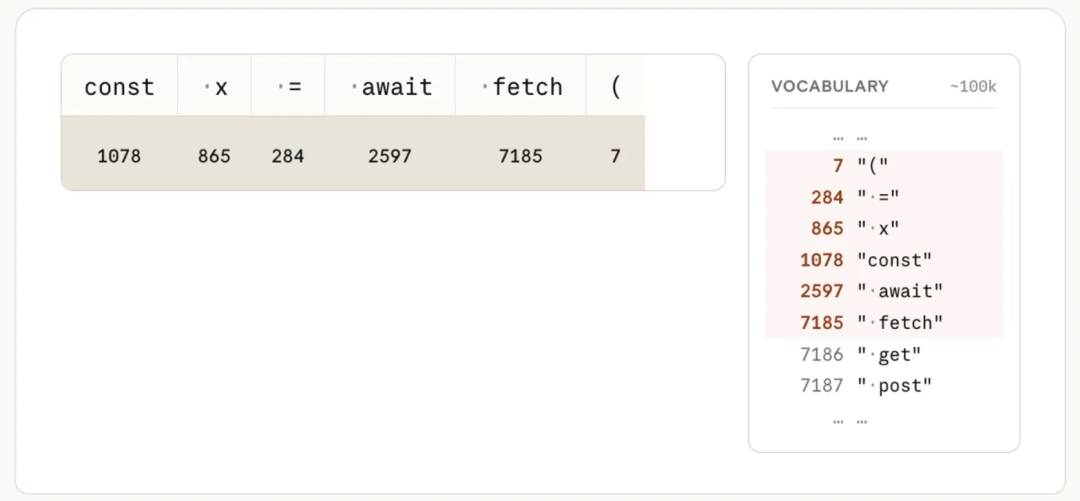
Das Modell sagt dann einen Token nach dem anderen vorher. Nach der Erzeugung jedes Tokens wird die Sequenz erneut verarbeitet, um den nächsten vorherzusagen.
Dieser wiederholte Generierungsprozess ist eine der Hauptquellen für Latenz und Kosten. Leistungsfähigere Modelle können bessere Vorhersagen treffen, aber das bedeutet nicht, dass das Modell automatisch jede Datei prüft, jeden Test ausführt oder jede Phase jeder langen Aufgabe durchgängig abschließt.
Genau diese Art von Verhalten ist der Bereich, in dem der Aufwand eine Rolle spielt.
Viele Nutzer verstehen eine höhere Anstrengungsstufe so, dass sie das Modell „ein paar Sekunden länger nachdenken lässt“.
Diese Auffassung ist unvollständig.
Der Anstrengungsparameter von Anthropic beeinflusst, ob das Modell insgesamt bereit ist, Tokens und Arbeit zu investieren. Er kann sich darauf auswirken:
Bei niedriger Anstrengung optimiert Claude für Geschwindigkeit und Token-Effizienz. Er liest möglicherweise nur die offensichtlichsten Dateien, führt eine schmale Änderung durch und gibt schnell eine Antwort zurück.
Bei hoher Anstrengung prüft Claude eher umgebenden Code, liest Konfigurationen, führt Tests aus, validiert Ergebnisse und arbeitet so lange, bis die Aufgabe vollständiger erledigt ist.
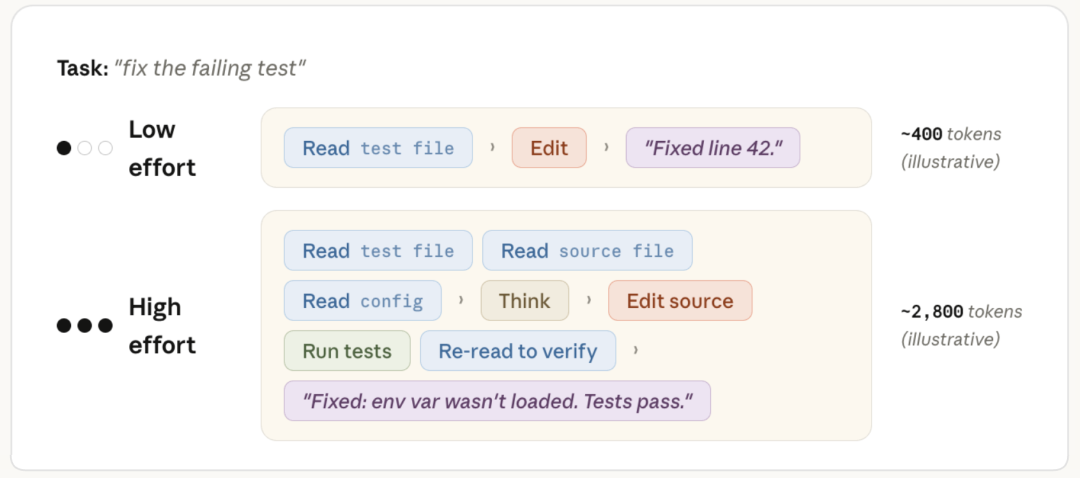
Die Grafik im Anthropic-Leitfaden verwendet ein illustratives Beispiel:
Ein bestimmter Faktor ist keine feste Regel. Aufwand ist ein Verhaltenssignal, kein strenges Token-Budget. Unterschiedliche Aufgaben können unterschiedliche Verbrauchsmuster erzeugen.
Der wesentliche Punkt ist, dass zusätzliche Tokens nicht nur für versteckte Schlussfolgerungen verwendet werden. Sie können auch zum Lesen von Dateien, Generieren von Tool-Parametern, Durchführen von Validierungsschritten und Verfassen vollständigerer Antworten genutzt werden.
Das führt zu einem auf den ersten Blick kontraintuitiven Ergebnis:
Ein kleineres Modell mit ausreichend Kontext und hohem Aufwand kann bessere Leistungen erbringen als ein größeres Modell, das nur eine oberflächliche Verarbeitung zulässt.
Stellen Sie sich zwei Entwickler vor:
Der Experte mag bessere Intuition haben, aber der Allrounder hat mehr Gelegenheit, Beweise zu sammeln.
Dies ähnelt dem Unterschied zwischen Modellfähigkeit und Aufwand.
Größere Modelle setzen eine höhere Qualitätsobergrenze. Höherer Aufwand bestimmt, wie weit das Modell bereit ist, sich in der aktuellen Aufgabe in Richtung dieser Obergrenze zu bewegen.
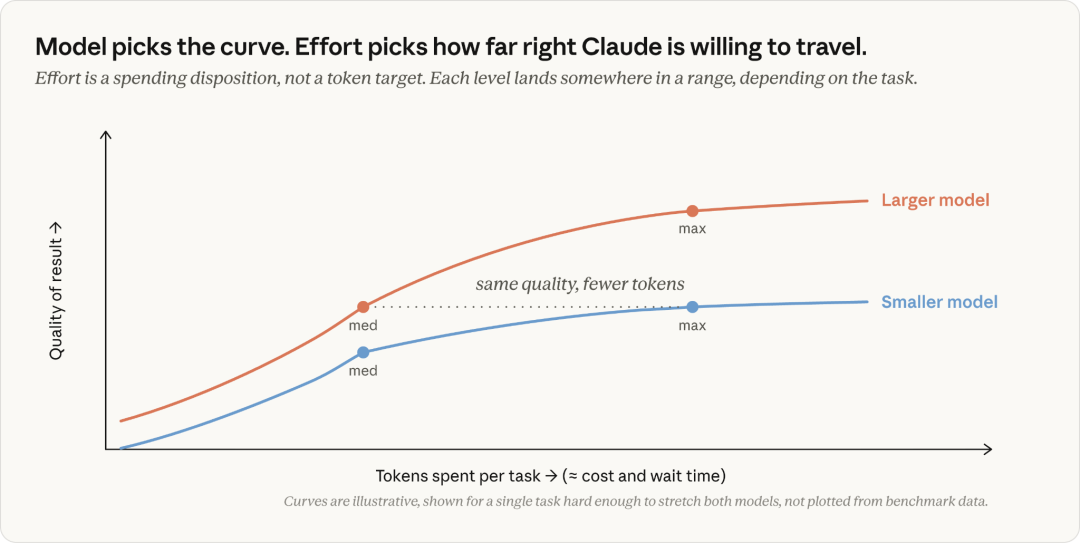
Das bedeutet nicht, dass die Modellgröße unwichtig ist. Manche Aufgaben liegen dennoch außerhalb der Fähigkeiten eines kleinen Modells, unabhängig vom Aufwand. Ein Modell kann fehlende Fähigkeiten nicht einfach durch das Ausgeben von mehr Tokens ausgleichen.
Es bedeutet jedoch, dass ein größeres Modell nicht immer die erste Wahl oder die günstigste Lösung ist.
Der nützlichste Ratschlag von Anthropic ist ein Diagnose-Framework.
Wenn Claude schlechte Ergebnisse liefert, wechseln Sie nicht sofort das Modell. Bestimmen Sie zunächst die Art des Scheiterns.

Bevor Sie Einstellungen ändern, überprüfen Sie die Aufgabe selbst.
Fragen Sie:
CLAUDE.md korrekt?Viele Probleme, die wie Modellprobleme aussehen, sind in Wirklichkeit Kontextprobleme.
Wenn das Modell unvollständige Anforderungen, veraltete Anweisungen oder falsche Dateien erhält, kann weder höherer Aufwand noch ein größeres Modell zuverlässig Abhilfe schaffen.
Wenn Claude Folgendes zeigt, ist das Problem wahrscheinlich zu wenig Aufwand:
In diesen Fällen erhöhen Sie die Anstrengungsstufe.
Das Modell hat möglicherweise bereits ausreichende Fähigkeiten.
Es fehlt nur ein stärkeres Signal, dass die Aufgabe gründlicher erledigt werden muss.
Wenn Folgendes auftritt, liegt das Problem eher am Modell selbst:
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Wechseln Sie in diesen Fällen zu einem leistungsstärkeren Modell.
Höherer Aufwand gibt denselben Gewichten mehr Raum zum Wirken, ersetzt sie aber nicht durch einen stärkeren Fähigkeitssatz.
Die genaue Modellzusammenstellung und Standardeinstellungen ändern sich im Laufe der Zeit; sehen Sie daher immer in der aktuellen Anthropic-Dokumentation nach. Die praktische Auswahllogik hält länger als jeder spezifische Modellname.
Für folgende Aufgaben reichen in der Regel schnellere Modelle wie Sonnet aus:
Wenn die Aufgabe mehrere Dateien umfasst oder Validierung erfordert, erhöhen Sie zunächst die Anstrengungsstufe, bevor Sie zu einem teureren Modell wechseln.
Wenn folgende Situationen eintreten, ist ein stärkeres Modell wie Opus angemessener:
Der Vorteil liegt nicht nur in mehr Tokens. Größere Modelle haben möglicherweise bereits stärkere Muster gelernt und haben eine höhere Fähigkeitsobergrenze.
Der Quellartikel beschreibt Fable als Expertenmodell, das man aufruft, wenn andere Modelle noch stecken bleiben.
Solche Modelle sind am wertvollsten für:
Da das leistungsfähigste Modell auch die höchsten Token-Kosten verursacht, sollte es nur eingesetzt werden, wenn seine zusätzlichen Fähigkeiten das Ergebnis verändern können.
| Aufgabentyp | Strategie für Startmodell | Empfohlene Anstrengungsstufe |
|---|---|---|
| Umbenennungen, Formatierungen, kleine Textbearbeitungen | Schnelles oder ausgewogenes Modell | Niedrig oder mittel |
| Kleiner Bug mit klaren Tests | Ausgewogenes Modell | Mittel |
| Mehrere Dateien umfassende Bugbehebung | Ausgewogenes Modell | Mittel |
| Aufwandsstufe | Modellpriorität | Anwendungsszenario |
|---|---|---|
| Hoch | Ausgewogenes oder stärkeres Modell | Große, klar definierte Refactorings |
| Hoch | Stärkeres Modell | Unklare Architekturfehler |
| Sehr hoch oder Maximal | Starkes Modell | Lange autonome Codierungs-Workflows |
| Ausreichend hoch für Validierung | Wechsel zu leistungsstärkerem Modell | Wiederholtes Scheitern trotz gründlicher Untersuchung |
Dies ist ein Ausgangspunkt, keine feste Regel.
Die optimale Einstellung hängt ab von:
Ein ständiges Ändern des Aufwandslevels für jeden Prompt macht Kosten und Latenz unberechenbar.
Anthropic empfiehlt, mit dem Standard-Aufwandslevel des gewählten Modells zu beginnen und es dann als breiteres Arbeitspräferenz anzupassen.
Beispiele:
Niedriger Aufwand für schnelle Fragen und viele Subtasks.
Mittlerer Aufwand für die reguläre Entwicklung.
Hoher Aufwand für schwierige Codierungs- und Agenten-Workflows.
Nur bei besonderer Gründlichkeit xhigh oder max verwenden.
Für API-Nutzer gilt der effort-Parameter für sichtbaren Text, Tool-Aufrufe, Tool-Parameter und erweitertes Denken. Er ist nicht auf ein einzelnes verstecktes Reasoning-Budget beschränkt.
Dies macht effort zu einer direkten operativen Steuerung, wie viel Arbeit das Modell investieren soll.
Der Quellartikel erwähnt auch den ultracode-Modus von Claude Code.
Ein wichtiger Gedanke ist, dass bestimmte lange Aufgaben von mehreren Agenten-Threads profitieren können. Anstatt dass eine Claude-Instanz jeden Teil einer großen Aufgabe sequenziell prüft, delegiert ein Koordinator unabhängige Arbeit an spezialisierte Agenten.
Beispiele umfassen:
Die Managed Agents Dokumentation von Anthropic beschreibt Multi-Agenten-Sitzungen, in denen Agenten parallel mit unabhängigen Gesprächsverläufen arbeiten können. Dies kann die Abdeckung verbessern und die Fertigstellungszeit reduzieren, wenn Aufgaben gut zerlegt sind.
Multi-Agenten-Ausführung ist nicht automatisch besser.
Sie kann erhöhen:
Nur bei Aufgaben mit unabhängigen Arbeitsabläufen verwenden, nicht nur weil verfügbar.
Die breitere Erkenntnis ist, dass KI-gestütztes Codieren über reine Modell-Rankings hinausgeht.
Früher war der Workflow einfach:
Modernes agentisches Codieren erfordert eine proaktivere Planung.
Ein Team könnte einsetzen:
Dies ähnelt mehr der Führung eines technischen Teams als der Nutzung einer Suchleiste.
Wer dieses System bedient, muss verstehen:
Das Ziel ist nicht, die meisten Tokens zu verbrauchen, sondern Tokens dort auszugeben, wo die Wahrscheinlichkeit der Ergebnisakzeptanz steigt.
Wenn Claude Code schwache Ergebnisse liefert, in dieser Reihenfolge vorgehen:
Die Modellauswahl ändert die zugrundeliegenden Trainingsgewichte und damit den gesamten Fähigkeitsbereich. Der Aufwand steuert, wie viel Arbeit Claude bei der aktuellen Aufgabe zu investieren ermutigt wird, einschließlich Reasoning, Dateilesen, Tool-Aufrufen, Testen und Validieren.
Bei manchen Aufgaben ja. Ein kleineres Modell mit ausreichend Kontext und hohem Aufwand kann gründlicher recherchieren als ein größeres mit niedrigem Aufwand. Aufwand kann jedoch keine echten Fähigkeitsgrenzen überwinden.
Claude läuft möglicherweise mit niedrigerem Aufwand, der Aufgabenbereich ist nicht klar definiert, oder es fehlen benötigte Tools und Kontext. Zuerst Prompt und Repo-Anweisungen prüfen, dann Aufwand erhöhen, wenn Claude vor Abschluss verfügbarer Validierungen stoppt.
Wenn Claude den richtigen Kontext hat, die Aufgabe klar recherchiert, relevante Checks durchführt und dennoch zur falschen Schlussfolgerung gelangt. Wenn es nur Arbeit ausgelassen hat, ist Aufwanderhöhung meist der bessere erste Schritt.
Nein. Anthropic beschreibt Aufwand als ein Verhaltenssignal, nicht als striktes Token-Limit. Es beeinflusst, wie bereitwillig Claude Tokens in Antworten, Tool-Aufrufen, Funktionsparametern und erweitertem Denken investiert.
Standard oder mittlerer Aufwand für alltägliche Aufgaben, hoher Aufwand für schwierige Codierungs- und Agenten-Aufgaben, externer oder maximaler Aufwand für lang laufende oder besonders anspruchsvolle Workflows. Kosten und Latenz je nach eigener Aufgabe neu bewerten.
Der Quellartikel beschreibt Ultracode als Hochintensitäts-Modus von Claude Code, der sehr hohen Aufwand mit der Möglichkeit zur Koordination mehrerer Agenten bei Bedarf kombiniert. Da sich das Produktverhalten ändern kann, vor der Abhängigkeit von einer spezifischen Implementierung die aktuelle Claude Code Dokumentation konsultieren.
Nein. Der Aufwand ändert nur das Verhalten der Anfrage oder Sitzung. Er aktualisiert keine Modellgewichte und lehrt Claude nichts Dauerhaftes.
Modell und Anstrengungsniveau: Offizielle Erläuterung von Anthropic zur Modellauswahl und zum Anstrengungsniveau in Claude Code.
Dokumentation zum Anstrengungsniveau von Claude: Offizielle Dokumentation zum Anstrengungsniveau, unterstützten Modellen und API-Verhalten.
So wählen Sie das richtige Claude-Modell: Leitfaden von Anthropic zur Modellauswahl basierend auf Fähigkeiten, Kosten und Aufgabentyp.
Claude Code Changelog: Offizielle Versionshistorie der Änderungen und Standardeinstellungen von Claude Code.
Multi-Agent-Sitzung in Claude Managed Agents: Offizielle Dokumentation zur Koordination mehrerer Claude-Agenten.
Orchestrierungsmuster erstellen: Anleitung von Anthropic zur Kombination von hohem Einsatz mit Multi-Agent-Orchestrierung.
Claude Code GitHub Repository: Offizielles Quellcode-Repository, Issue-Tracker und Changelog von Claude Code.
Auch wenn das zugrunde liegende Modell unverändert bleibt, kann Claude Code schwächer wirken. Ursachen können ein niedriges Anstrengungsniveau, unvollständiger Kontext, fehlende Tools oder ein unklarer Aufgabenbereich sein.
Die Modellwahl bestimmt die obere Leistungsgrenze. Das Anstrengungsniveau bestimmt, inwieweit Claude diese Fähigkeit durch Lesen von Dateien, Aufrufen von Tools, Ausführen von Tests und Überprüfen der Arbeit ausschöpft.
Beginnen Sie mit der Korrektur der Eingabe. Erhöhen Sie das Anstrengungsniveau, wenn Claude verfügbare Arbeit überspringt. Wechseln Sie das Modell, wenn es die Aufgabe trotz ausreichender Untersuchung nicht lösen kann.
Die beste Claude Code-Konfiguration ist nicht immer das größte Modell – sondern das richtige Modell mit ausreichendem Anstrengungsniveau, Kontext, Tools und Aufgabenüberprüfung.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



