For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/claude-code-language-migration-workflow-anthropic.md.
Die Änderung der Hauptsprache einer ausgereiften Produktionscodebasis war ein Projekttyp, den Teams oft jahrelang aufschoben. Diese Arbeit i...
Die Änderung der Hauptsprache einer etablierten Produktionscodebasis war bisher eine Projektart, die Teams oft Jahre hinauszögerten. Die Arbeit ist kostspielig, risikoreich und schwer abschätzbar. Eine Migration kann mehrere Engineering-Quartale beanspruchen, während die beiden Implementierungen auseinanderdriften und am Ende nur eine unvollständige Verhaltenskonsistenz erreicht wird.
Ein aktuelles internes Projekt von Anthropic zeigt, dass sich dies zu ändern beginnt.
Im Juli 2026 veröffentlichte Anthropic einen Praxisbericht, der detailliert beschreibt, wie seine Entwickler mit Claude Code, Claude Fable 5, Claude Opus 4.8 und dynamischen Multi-Agent-Workflows innerhalb von etwa einem Monat zehn Codepakete migrierten. Diese Pakete umfassten Codeumfänge von Zehntausenden bis Hunderttausenden von Zeilen.
Zwei Fälle stechen besonders hervor:
Die wichtige Erkenntnis ist nicht, dass KI-Modelle Dateien schnell übersetzen können, sondern dass ein gut konzipiertes Migrationssystem mit geringem manuellen Eingriff wiederholt Code generieren, prüfen, testen, ablehnen und neu generieren kann.
Anthropic fasst seine Philosophie so zusammen: Die Hauptaufgabe des Entwicklers besteht nicht darin, jeden erzeugten Fehler manuell zu beheben, sondern den Prozess zu verbessern, der diese Fehler ständig produziert.
Bun ist ein All-in-One-Toolkit für JavaScript und TypeScript, das Laufzeit, Paketmanager, Bundler, Testrunner und andere Entwicklungstools umfasst. Die ursprüngliche Implementierung stützte sich stark auf Zig und war mit umfangreichem C- und C++-Code integriert.
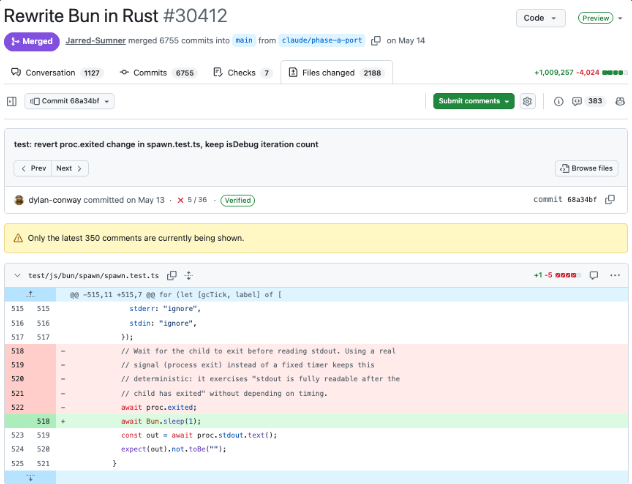
Jarred Sumner nutzte innerhalb von 11 Tagen etwa 50 dynamische Claude-Code-Workflows für die Rust-Migration. Der zusammengeführte Pull-Request enthielt über eine Million neue Codezeilen und Tausende von Commits.
Vor dem Merge bestand der bestehende CI-Testsuite von Bun auf allen unterstützten Plattformen. Anthropic berichtete später von 19 Regressionen nach dem Merge, die inzwischen behoben wurden.
Diese Migration war kein Neuanfang von Grund auf. Ziel war es, die bestehende Architektur und das Verhalten von Bun beizubehalten, während die Implementierungssprache ersetzt wurde. Dies reduzierte die gleichzeitig variablen Faktoren: Das Projekt konnte sich auf Sprachsemantik, Eigentumsverhältnisse, Speichersicherheit und Kompatibilität konzentrieren, anstatt das Produkt von Grund auf neu zu bauen.
Der offizielle Bericht von Bun erklärt, warum Rust attraktiv war. Viele wiederkehrende Stabilitätsprobleme betrafen Lifecycle-Management, vergessene Bereinigungspfade, Use-after-Free-Bedingungen und Double-Free-Risiken. In sicherem Rust werden viele dieser Probleme zu Compiler-Fehlern, anstatt erst durch Produktionsabstürze, Fuzzing oder manuelle Reviews entdeckt zu werden.
Mike Kriegers Projekt ging einen anderen Weg. Diese Migration versuchte nicht, die ursprüngliche Dateistruktur so weit wie möglich zu erhalten, sondern beinhaltete mehr architektonische Neugestaltung.
Das Ergebnis waren etwa 165.000 Zeilen TypeScript-Code, die an einem Wochenende generiert wurden. Berichten zufolge wurden dabei verwendet:
Der geschäftliche Grund war klar. Dieses interne Python-Tool wurde als einzelne Binärdatei ausgeliefert, deren Erstellung pro Plattform etwa acht Minuten dauerte, die gesamte Release-Matrix benötigte etwa 30 Minuten.
Nach der Migration dauerte die Kompilierung etwa zwei Sekunden, die Startgeschwindigkeit verbesserte sich um das Sechsfache, und das Team konnte eine separate Deployment-Pipeline einsparen.
Sprachmigrationen erfordern weiterhin einen echten technischen oder geschäftlichen Grund. Schnellere Codegenerierung bedeutet nicht, dass jede Neuschreibung gerechtfertigt ist.
Wenn sich die Umgebung seit der Erstellung des Systems verändert hat, erwägen Teams in der Regel eine Neubewertung der Sprachwahl. Typische Auslöser sind:
Die ursprüngliche Wahl von Zig für Bun ergab Sinn: Für einen Gründer, der vor dem Aufkommen moderner Coding-Agenten allein eine sehr breite Laufzeit aufbaute, bot die Sprache Low-Level-Kontrolle, die Jarred Sumner half, schnell voranzukommen.
Einige Jahre später ist Bun ein weit verbreitetes Produktionstool mit einer viel größeren Wartungslast. Die Kosten wiederkehrender speicherbezogener Fehler stiegen, und Claude Code machte die mechanische Portierung machbar genug, um sie zu testen.
Die Entscheidung war also nicht „Zig ist schlecht und Rust ist gut“, sondern die aktuelle Größe, die betrieblichen Anforderungen und die verfügbaren Tools haben die Abwägungen verändert.
KI-unterstützte Sprachmigrationen können immer noch teuer sein.
Anthropic berichtete, dass das Bun-Projekt etwa Folgendes verbrauchte:
| Nutzungskategorie | Berichtete Anzahl |
|---|---|
| Nicht gecachte Input-Tokens | 5,9 Milliarden |
| Output-Tokens | 690 Millionen |
| Geschätzter API-Preisäquivalent | ca. 165.000 USD |
Der Hauptteil von Mike Kriegers Python-zu-TypeScript-Migration verwendete etwa 27 Millionen Tokens.
Diese Zahlen liegen weit unter den Engineering-Kosten traditioneller mehrjähriger Migrationen, sind aber nicht unbedeutend. Teams müssen auch Folgendes berücksichtigen:
Kostensenkungen machen mehr Projekte finanziell machbar, aber dies beseitigt nicht die Notwendigkeit eines Business Cases.
Große Sprachmigrationen weisen mehrere Eigenschaften auf, die sie besonders geeignet für den Einsatz mit kollaborativen Coding-Agenten machen.
Migrationen umfassen oft Hunderte oder Tausende von Dateien, Modulen, Paketen oder Bibliotheken, die unabhängig voneinander bearbeitet werden können, sofern ihre Abhängigkeiten verstanden sind.
Agenten können unabhängige Einheiten parallel übersetzen, anstatt auf einen einzigen zentralen Implementierungsfluss zu warten. Die Herausforderung verschiebt sich von der Tippgeschwindigkeit hin zu Orchestrierung, Konsistenz und Validierung.
Viele Softwareaufgaben beginnen mit unvollständigen Anforderungen. Sprachmigrationen haben einen viel stärkeren Ausgangspunkt: die ursprüngliche Implementierung.
Der vorhandene Quellcode definiert Kontrollfluss, Datenstrukturen, Randfälle, Fehlerverhalten, öffentliche APIs und plattformspezifische Verarbeitung. Wenn Migrationsregeln unklar sind, können Agenten jederzeit darauf zurückgreifen.
Agenten arbeiten am besten, wenn Erfolg und Misserfolg mechanisch überprüfbar sind.
Compiler, Testsuiten, Konsistenzskripte, Benchmarks oder deterministische Ausgabevergleiche bieten dem Workflow eine einzige Quelle der Wahrheit. Das System muss nicht fragen, ob die neue Implementierung „richtig aussieht“, sondern vergleicht wiederholt das Verhalten mit der ursprünglichen Implementierung.
Compilerfehler, Abstürze, Testfehlschläge und Ausgabeunterschiede beschreiben auf natürliche Weise die verbleibende Arbeit.
Das Migrationssystem muss keine manuellen Aufgabenlisten erstellen. Es identifiziert selbstständig, was noch zu tun ist, und priorisiert die Behebung. Die
Jeder fehlgeschlagene Prüfpunkt kann kategorisiert und einem Reparatur-Agenten zugewiesen werden.
Wenn dasselbe Problem in mehreren Dateien auftritt, ist es nicht die richtige Vorgehensweise, diese einzeln manuell zu korrigieren.
Eine bessere Lösung besteht darin, die Migrationsregel zu aktualisieren, die den Fehler verursacht, und dann nur die betroffenen Einheiten neu zu generieren. Dies wandelt einen entdeckten Fehler in eine dauerhafte Verbesserung des Prozesses um.
Bevor man Produktionscode übersetzt, muss man ein Verifikationssystem erstellen, das in der Lage ist, die alte und die neue Implementierung unter denselben Bedingungen zu bewerten.
Ohne einen zuverlässigen Schiedsrichter gibt es keine glaubwürdige Definition von „Fertig“ für das Projekt.
Eine in der Quellsprache geschriebene Testsuite kann auf private Funktionen, interne Klassen oder Implementierungsdetails angewiesen sein, die in der Zielsprache nicht existieren. Diese Tests können nicht immer direkt migriert werden.
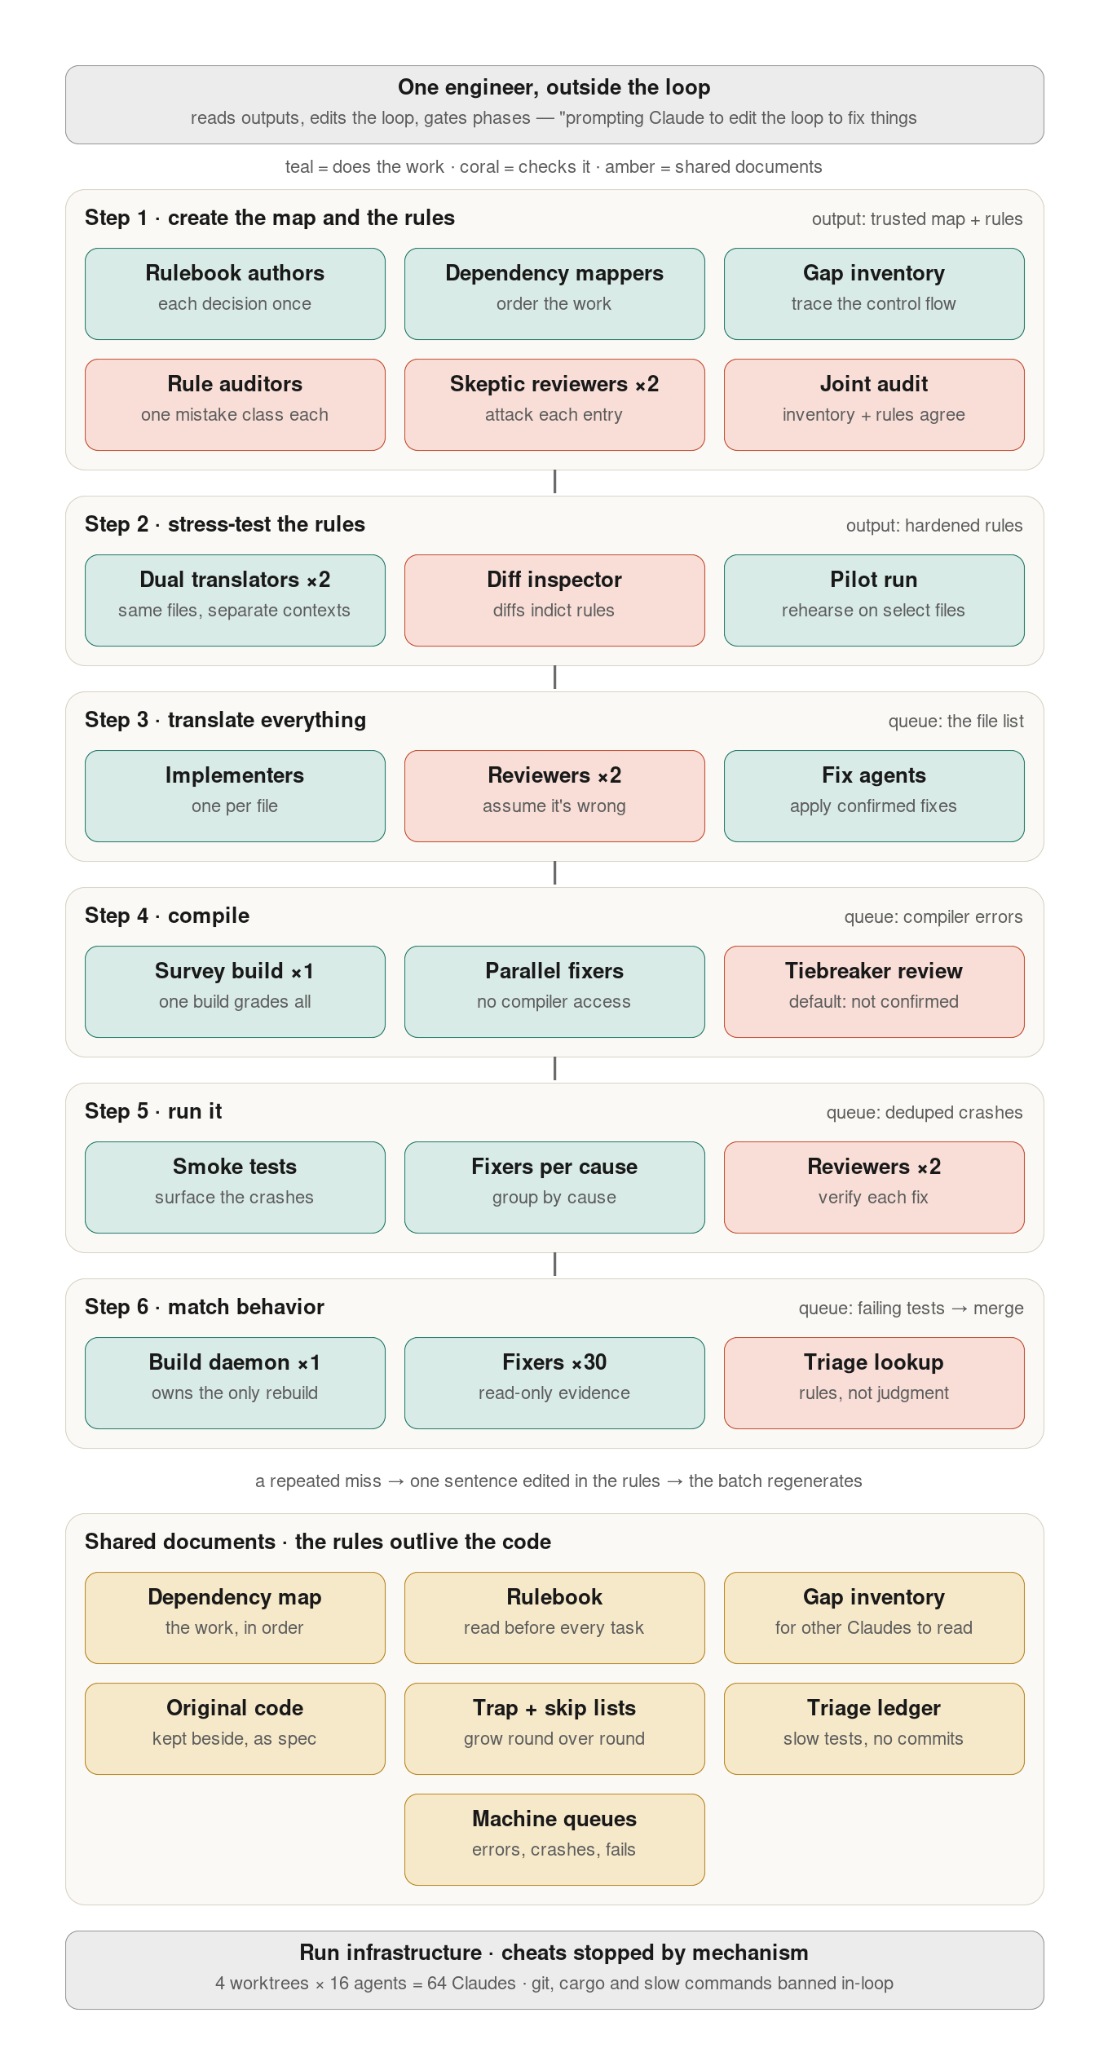
Anthropic empfiehlt, das Schiedsrichtersystem in drei Phasen vorzubereiten.
Man unterscheidet Tests, die externes Verhalten ausdrücken, von denen, die von internen Implementierungsdetails abhängen.
Externe Tests betreffen typischerweise Kommandozeilenverhalten, öffentliche APIs, Dateien, Netzwerk, beobachtbare Ausgaben oder vollständige Anwendungsszenarien. Diese sind zwischen verschiedenen Sprachen besser portierbar.
Verhaltensorientierte Tests werden in Behauptungen umgewandelt, die in beiden Versionen ausgeführt werden können.
Man setzt unabhängige, kontradiktorische Prüfer ein, um sicherzustellen, dass die umgeschriebenen Tests nicht schwächer sind als die Originalversionen. Leichter zu bestehende Tests können Kompatibilitätsprobleme verbergen.
Man führt das Bewertungssystem auf der ursprünglichen Implementierung aus und bestätigt, dass es bestanden wird.
Dann beschädigt man das Programm absichtlich und bestätigt, dass das Bewertungssystem fehlschlägt. Wenn ein Verifikationssystem einen bekannten Fehler nicht erkennen kann, ist es nicht bereit, die Migration zu überwachen.
Mike Krieger hat nicht von Grund auf eine vollständig portable Testsuite aufgebaut. Sein Team erstellte ein Konsistenz-Test-Framework, das sieben reale Szenarien abdeckte, und behandelte jede Abweichung zwischen Python und TypeScript als Fehler.
Der erste Schritt legt die Grundlage, die alle nachfolgenden Agenten verwenden werden.
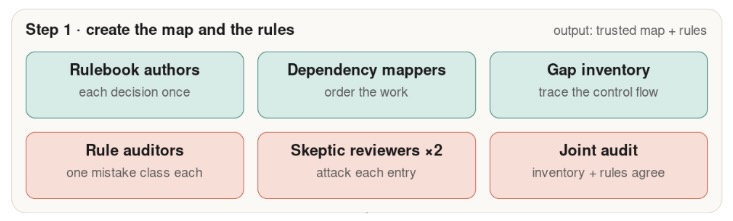
Das Regelbuch beschreibt, wie die Quellsprache auf die Zielsprache abgebildet werden soll.
Seine Form hängt von der Migrationsstrategie ab.
Für strukturerhaltende Migrationen kann das Regelbuch Folgendes enthalten:
Bei Neugestaltungen ähnelt das Regelbuch eher einem Architekturdokument. Es definiert die neuen Komponentengrenzen, Schnittstellen, Datenverträge und Designentscheidungen, die die Implementierungsagenten befolgen müssen.
Die Reihenfolge ist wichtig. Das Regelbuch sollte vor dem Lückeninventar erstellt werden, da das Lückeninventar all das festhält, was die Standardregeln nicht sicher verarbeiten können.
Parallele Arbeit ist nur sicher, wenn der Workflow versteht, welche Einheiten voneinander abhängen.
Ein Abhängigkeitsgraph hilft zu bestimmen:
Einige Sprachen machen Abhängigkeitsinformationen über Paketmanifeste oder Modulmetadaten zugänglich. Ältere C-, C++- und Python-Systeme benötigen möglicherweise deterministische Analyseskipte, um den Abhängigkeitsgraphen zu entdecken.
Claude Code kann beim Erstellen und Ausführen dieses Skripts helfen, aber der generierte Graph sollte maschinell erzeugt werden und nicht nur auf Modellausgaben basieren.
Das Lückeninventar erfasst Unterschiede, die nicht durch direkte Übersetzung behandelbar sind.
Für eine Migration von Zig nach Rust sind wichtige Lücken Eigentum und Speicherlebenszyklen. Zig erlaubt es, einige Aufräumverantwortlichkeiten durch Konvention oder Kommentare zu kommunizieren, während Rust verlangt, dass Eigentumsbeschränkungen im Typsystem ausgedrückt werden.
Für eine Migration von Python nach TypeScript ist die Schnittstellendefinition eine große Lücke. Python akzeptiert Objekte typischerweise basierend auf ihrem Laufzeitverhalten, während TypeScript explizite Verträge erfordert, bevor der Code sicher kompiliert werden kann.
Das Inventar sollte als ein dynamisch aktualisiertes Artefakt betrachtet werden. Während der Übersetzung, Kompilierung und Konsistenztests treten ständig neue Lücken auf.
Wenden Sie das neue Regelbuch nicht sofort auf tausende von Dateien an.
Führen Sie zuerst eine kleine Migration durch und verwerfen Sie dann die Ergebnisse absichtlich.
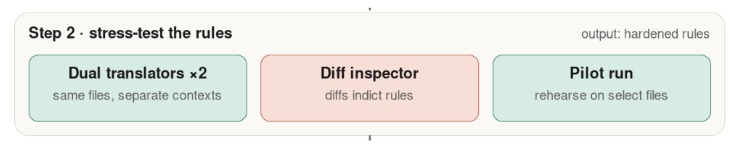
Für Bun umfassten die Tests eine kleine Anzahl von Dateien:
Bevor es tatsächlich auf alle 1.448 Zig-Dateien angewendet wurde, deckte diese Arbeit zwei schwerwiegende Probleme auf.
Strukturerhaltende Migrationen machen diesen Vergleich relativ einfach, da zwei Implementierungen derselben Datei nebeneinander geprüft werden können.
Bei Neugestaltungen sollte der Stresstest gegen das Architekturdokument durchgeführt werden. Kontradiktorische Agenten können dessen Annahmen angreifen, gefolgt von einem einmaligen End-to-End-Lauf, um fehlende Schnittstellen und unrealistische Reihenfolgen aufzudecken.
Das Ziel ist die Verbesserung des Regelbuchs, nicht die Anhäufung von Produktionscode. Sobald Schwächen erfasst sind, werden die generierten Dateien verworfen.
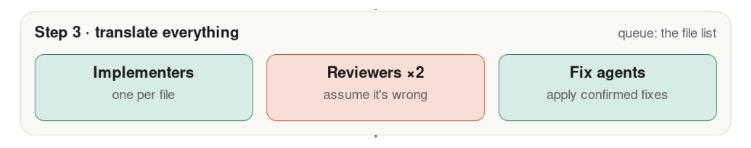
Nachdem die Regeln den Stresstest bestanden haben, kann die Übersetzung auf das gesamte Repository ausgeweitet werden.

Anthropic beschreibt einen wiederholten Zyklus mit drei Rollen:
Die Umsetzung kann oft mit kleineren, günstigeren Modellen durchgeführt werden. Die stärksten Modelle sollten für Prüfer, Regelersteller, Architekturentscheidungen und Streitfälle, die ein breiteres Urteilsvermögen erfordern, reserviert bleiben.
Batch-Skripte sollten durch Überprüfung des Dateisystems oder anderer deterministischer Zustände entscheiden, was abgeschlossen ist.
Zum Beispiel kann eine Quelldatei als übersetzt betrachtet werden, wenn die entsprechende Zieldatei im erwarteten Verzeichnis existiert und die erforderliche Prüfschwelle bestanden hat.
Die Neuerstellung der Warteschlange vom Datenträger aus macht den Prozess wiederherstellbar. Wenn ein Agent anhält, die Maschine neu startet oder ein Batch fehlschlägt, kann der Orchestrator die verbleibende Arbeit neu aufbauen, ohne auf flüchtige Gesprächserinnerungen angewiesen zu sein.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Wenn der Umsetzungsagent eine Übersetzung nicht zuversichtlich abschließen kann, sollte er einen durchsuchbaren Marker hinterlassen, z.B.:
TODO(port): Erklären, warum dieser Abschnitt manuelle Bearbeitung oder Nachbearbeitung erfordert
Die genaue Form des Markers kann variieren, muss aber den Grund enthalten. Dies schafft eine strukturierte Warteschlange für die Kompilierungs- und Reparaturphase.
Der Umsetzungsagent sollte nicht nur von sich selbst überprüft werden.
Anthropic und Bun nutzten adversarielle Prüfung in separaten Kontextfenstern. Der Prüfer erhält den geänderten Code und wird angewiesen anzunehmen, dass der Code Fehler enthält.
Zwei Prüfer können denselben Batch unabhängig prüfen. Bei widersprüchlichen Ergebnissen kann ein dritter Agent entscheiden.
Diese Trennung reduziert die Tendenz des Schreibagenten, seine eigenen Entscheidungen zu verteidigen, und macht den langen autonomen Betrieb zuverlässiger.
Wenn ein Prüfer wiederholt denselben Fehler findet, sollte das Regelhandbuch aktualisiert und die betroffenen Batches neu generiert werden.
Das manuelle Patchen von Hunderten von generierten Dateien führt zu Inkonsistenzen und erhält die ursprüngliche Fehlerquelle. Die Reparatur der Generierungsregel verhindert, dass das Problem in späteren Batches erneut auftritt.
Die letzten drei Phasen teilen sich denselben grundlegenden Zyklus: objektive Fehler erzeugen, klassifizieren, Reparierer zuweisen, Reparatur prüfen und wiederholen.
Die Kompilierung wandelt sprachbezogene Fehler in eine deterministische Warteschlange um.
Ob die Kompilierung Teil jedes Übersetzungszyklus ist, hängt von den Kosten ab.
Mike Kriegers TypeScript-Compiler kann eine Einheit in Sekunden überprüfen, daher wird er während der Umsetzung häufig ausgeführt. Buns Rust-Build dauerte länger, daher hielt Jarred Sumner Cargo außerhalb des dateibezogenen Übersetzungszyklus und kompilierte größere Batches separat.
Für teure Builds verwenden Sie einen einzelnen Orchestrator oder Build-Daemon. Reparaturagenten schreiben Patches, und nur der Daemon darf neu bauen. Dies verhindert, dass Dutzende von Agenten gleichzeitig dieselbe teure Operation starten.
Systemweite Compiler-Fehler verdienen besondere Aufmerksamkeit. Tausende ähnlicher Fehler könnten auf eine fehlende Abhängigkeitsregel, eine falsche Modul-Grenzstrategie oder eine problematische Sprachzuordnung hindeuten, nicht auf Tausende von unabhängigen Fehlern.
Nach der Kompilierung des Codes führen Sie minimale Tests durch, die Abstürze und schwerwiegende Laufzeitfehler aufdecken.
Die Ergebnisse des Rauchtests liefern eine weitere mechanische Wahrheitsquelle. Gruppieren Sie Fehler nach Grundursache, anstatt jedem Fehler einen Agenten zur Analyse zuzuweisen.
Nützliche Kategorien könnten sein:
Ein adversarieller Prüfer sollte die vorgeschlagenen Ursachenbehebungen überprüfen, insbesondere wenn eine einzelne Änderung mehrere Dateien betrifft.
Die letzte Phase vergleicht das neue Programm mit dem Original.
Führen Sie tragbare Test-Suites oder Äquivalenzprüfungs-Frameworks auf beiden Implementierungen aus. Jede unerklärliche Abweichung sollte als Migrationsfehler betrachtet werden, es sei denn, das Team hat sie bewusst als Produktänderung akzeptiert.
Der Reparaturagent kann überprüfen:
Für zeitintensive Neubauprozesse können Build-Daemons Patches stapeln, einmal kompilieren, nur die betroffenen Tests erneut ausführen und die Ergebnisse an die Warteschlange zurückgeben.
Wenn dasselbe Fehlermuster in mehreren Tests auftritt, sollten Korrekturmaßnahmen vorgezogen werden. Aktualisieren Sie das Regelhandbuch und regenerieren Sie die Dateien unter der fehlerhaften Regel.
Das Fehlen einer Test-Suite bedeutet nicht, dass eine Migration unmöglich ist.
Sie können die ursprüngliche Anwendung als Referenzimplementierung verwenden und ein Verhaltens-Äquivalenzprüfungs-Framework um reale Benutzerszenarien herum aufbauen.
Mike Kriegers Workflow führte sieben Szenarien sowohl für die Python- als auch für die TypeScript-Version aus, verglich die Ergebnisse und wies jeden Fehler einem dedizierten Reparaturzyklus zu. Anschließend entwarf Claude zusätzliche End-to-End-Tests, die vier Nächte lang ununterbrochen liefen.
Selbst wenn das Team eine neue Prüfinstanz um den ursprünglichen Code herum aufbauen muss, bleibt der ursprüngliche Code der einzige Maßstab.
Anthropic warnt davor, ihren Prozess als universelle Vorlage zu betrachten. Jede Codebasis hat andere Build-Kosten, Sprachsemantik, Testqualität, Plattformbeschränkungen und akzeptable Kompromisse.
Die folgenden Praktiken sind jedoch in mehreren Projekten konsistent.
Einzelne Fehler gehören in den Reparaturzyklus.
Menschliche Aufmerksamkeit sollte sich auf wiederkehrende Fehler, fehlende Regeln, schlecht definierte Aufgaben, schwache Überprüfungsmechanismen und Engpässe im Orchestrierungssystem konzentrieren.
Prüfer sollten aktiv versuchen zu beweisen, dass der Code Fehler enthält.
Dies bedeutet nicht vage oder pessimistische Urteile. Das Prüfergebnis sollte auf spezifische Fehler, verletzte Regeln, nicht zutreffende Annahmen oder Verhaltensabweichungen hinweisen.
Compiler, Testfälle, deterministische Skripte, Benchmarks und Ausgabedifferenzen sollten die Kriterien für die Annahme von Ergebnissen sein.
Modellmeinungen sind für Recherche und Prüfung wertvoll, sollten aber die objektive Validierung nicht ersetzen – sofern diese möglich ist.
Groß angelegte Übersetzungsarbeit ist oft repetitiv und kann von kleineren Modellen übernommen werden.
Die stärksten Modelle sollten verwendet werden für:
Dies senkt die Token-Kosten, ohne die starke Argumentationsfähigkeit aus den risikoreichsten Entscheidungen zu entfernen.
Regelhandbücher, Abhängigkeitsgraphen, Validierungsstrategien und Stresstests erfordern die sorgfältigste menschliche Beteiligung.
Sobald diese Grundlagen solide sind, wird der Großteil der verbleibenden Arbeit zu einem Warteschlangenverarbeitungsprozess. Schwache Grundlagen machen jede nachfolgende Phase teurer.
Der Migrationsprozess sollte nach einer Unterbrechung wiederhergestellt werden können, ohne den Zustand über Chat-Verläufe neu aufbauen zu müssen.
Speichern Sie den Fortschritt in Dateien, Commits, Manifests, Datenbanken oder anderen deterministischen Artefakten. "Abgeschlossen" sollte eine maschinenlesbare Bedeutung haben.
Kompilierung, Integrationstests, Paketerstellung und vollständige Benchmarks können Engpässe darstellen.
Führen Sie diese Operationen über einen kontrollierten Dienst oder Daemon aus, damit parallele Agenten keine Ressourcen verschwenden oder den gemeinsamen Zustand beeinträchtigen.
Buns Rust-Version ist in der Produktion, obwohl es noch technische Kompromisse gibt.
Anthropic berichtet, dass etwa 4 % des Rust-Codes in unsafe-Blöcken verbleiben, hauptsächlich kurze Zeigeroperationen an den Grenzen zu C und C++. Rust eliminiert nicht alle Probleme der unteren Ebene, beschränkt sie aber mehr auf explizite Bereiche.
Die berichteten Verbesserungen umfassen:
| Messwert | Ergebnis |
|---|
| Speichernutzung bei 2000 Wiederholungs-Builds | Von 6745 MB auf 609 MB gesunken |
| Binärdateigröße unter Linux und Windows | 19 % kleiner |
| Leistung ausgewählter realer Workloads | 2 %–5 % Verbesserung |
| Erkennbare Speicherlecks | Behoben |
| Nach Merge gemeldete Regressionen (Anthropic) | 19, später behoben |
Diese Ergebnisse sind wichtiger als die bloße Anzahl von Codezeilen. Der Erfolg einer Migration bemisst sich nicht an der Geschwindigkeit, mit der ein Agent Code generiert, sondern an Kompatibilität, Wartbarkeit, Laufzeitverbesserungen und der Fähigkeit, das Produkt danach kontinuierlich weiterzuentwickeln.
Beantworten Sie die folgenden Fragen, bevor Sie eine KI-gestützte Migration im großen Maßstab beginnen.
Wenn sich das Originalsystem schnell ändert, wird die Konsistenz schwer messbar. Erwägen Sie, ausgewählte Schnittstellen einzufrieren oder stabile Module zuerst zu migrieren.
Legen Sie Compiler-Prüfungen, Tests, Szenarien, Benchmarks und Ausgabevergleiche fest, die definieren, wann etwas fertig ist.
Vage Ziele wie „das Verhalten konsistent machen“ sind nicht ausreichend.
Eine direkte Portierung ist einfacher zu vergleichen und zu parallelisieren. Ein Neudesign kann eine bessere Architektur hervorbringen, erfordert aber mehr Entscheidungen und strengere Design-Reviews.
Bewerten Sie die folgenden Kosten:
Entwerfen Sie den Orchestrator um die teuerste gemeinsam genutzte Ressource.
Definieren Sie die folgenden Grenzen:
Im Bun-Workflow kam es vor, dass Agenten sich gegenseitig durch Befehle wie git stash und git reset beeinträchtigten. Die Orchestrierungsregeln wurden aktualisiert, um unsichere gemeinsam genutzte Repository-Operationen zu verbieten und die Agenten auf kontrollierte dateibezogene Commits zu beschränken.
Migrationen sollten verwerfbar bleiben, bis ausreichende Belege für einen Merge vorliegen.
Verwenden Sie isolierte Branches, reproduzierbare Builds, Checkpoints und klare Prozesse, um bei Regelverstößen Arbeiten zu verwerfen oder neu zu generieren.
KI-gestützte Code-Migration verwendet Coding-Agenten, um in einem kontrollierten Workflow die Übersetzung, Prüfung, Kompilierung, das Testen und die Fehlerbehebung von Codebasen durchzuführen. Das Modell ersetzt nicht die Validierung; Compiler, Tests, Konsistenzprüfungen und manuell definierte Regeln bleiben die maßgeblichen Instanzen.
Jarred Sumner führte mit dem dynamischen Workflow von Claude Code die Rust-Portierung durch; der entsprechende GitHub-Pull-Request wurde im Mai 2026 gemerged. Laut dem offiziellen Bun-Account dauerte diese Arbeit etwa 11 Tage und stützte sich auf parallele Implementierung, adversarielle Prüfung und die bereits vorhandenen sprachunabhängigen Testsuiten des Projekts.
Der gemergte Pull-Request zeigte über eine Million neu hinzugefügte Codezeilen, begleitet von gelöschten und geänderten Zeilen. Die reine Zeilenzahl kann keine Qualität messen; daher sind die wichtigeren Prüfmetriken Kompilierungsergebnisse, plattformübergreifende Tests, Verhalten, Speicherverbrauch, Binärgröße und der Umgang mit Regressionen nach dem Merge.
Basierend auf 5,9 Milliarden ungecachten Eingabe-Token und 690 Millionen Ausgabe-Token schätzt Anthropic die API-Kosten auf etwa 165.000 USD. Die tatsächlichen Organisationskosten können je nach Preisvereinbarungen, interner Infrastruktur, Personalaufwand, CI-Nutzung und Nachbesserungen nach dem Merge variieren.
Ein Migrations-Regelwerk ist eine maschinen- oder agentenlesbare Sammlung von Richtlinien, die beschreibt, wie Quellsprachmuster auf die Zielimplementierung abgebildet werden. Es umfasst Typen, Eigentumsverhältnisse, Fehler, Schnittstellen, Benennung, nicht unterstützte Fälle, Architekturentscheidungen und andere Regeln, die Implementierungsagenten konsistent befolgen müssen.
Implementierungsagenten besitzen Kontext und Trägheit, die sie dazu neigen lassen können, ihre eigenen Lösungen zu akzeptieren. Ein adversarieller Prüfer arbeitet in einem unabhängigen Kontext und wird angewiesen, Fehler, Regelverstöße und Verhaltensunterschiede zu suchen, anstatt beim Zusammenführen von Code zu helfen.
Möglicherweise, aber das Team muss eine andere objektive Instanz schaffen. Eine Konsistenz-Testplattform kann reale Szenarien auf beiden Implementierungen ausführen und die Ausgaben vergleichen, während neue End-to-End-Tests Fehler aufdecken können, die statische Übersetzungsprüfungen übersehen.
Nein. Migrationen benötigen weiterhin messbare Vorteile, eine stabile Referenzimplementierung, objektive Validierung, ausreichendes Budget und einen akzeptablen Rollback-Plan. Systeme mit schwacher Testabdeckung, undokumentiertem Verhalten, schnellen Anforderungsänderungen oder kritischen Sicherheitsbeschränkungen erfordern möglicherweise umfangreiche Vorbereitungen oder sind mit den derzeitigen KI-Fähigkeiten nicht machbar.
Vorbereitungen, die notwendig sind, bevor die Agenten verantwortungsvoll helfen können.
Die jüngsten Migrationspraktiken von Anthropic zeigen, dass Sprachportierungsprojekte um Agenten-Workflows herum neu organisiert werden können, anstatt sich auf eine einzige langwierige manuelle Neuschreibung zu verlassen. Die Migration von Bun von Zig zu Rust und die Projekte von Anthropic von Python zu TypeScript setzen alle auf parallele Implementierung, adversarische Prüfung, deterministische Verifikation und wiederholte Neugenerierung.
Was wiederverwendbar ist, ist der Ablauf: einen Bewerter aufbauen, Regeln definieren, Abhängigkeiten abbilden, Methoden unter Druck setzen, in fortsetzbaren Chargen übersetzen, kompilieren, ausführen und das Verhalten vergleichen. Wenn derselbe Fehler wiederholt auftritt, wird die Regel oder der Workflow, die den Fehler verursacht hat, korrigiert, anstatt jede Ausgabe manuell zu reparieren.
Diese Methode erfordert immer noch ein beträchtliches Budget, robuste Tests, kontrollierte Berechtigungen und architektonische Entscheidungen auf menschlicher Ebene. Sie senkt die Migrationskosten, eliminiert jedoch nicht die Ingenieursarbeit.
Verantwortung.
Der Kernpunkt ist einfach: Zuverlässige KI-Migration entsteht aus überprüfbaren Produktionszyklen, nicht aus einem einzigen Prompt, der das gesamte Codebase umschreibt.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



