For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/claude-code-loop-engineering-four-ways.md.
Der Artikel erklärt vier Claude-Code-Schleifen: rundenbasiert, zielbasiert, geplant und proaktiv. Behandelt werden Auslöser, Validierung, Be...
Erklären Sie UI-Änderungen nicht allein aufgrund einer erfolgreichen Bearbeitung für abgeschlossen.
Wenn eine dieser Prüfungen fehlschlägt, beheben Sie das Problem und beginnen Sie erneut bei Schritt 1.
Der Kerngedanke liegt nicht in der Formulierung, sondern darin, dass Claude auf dieselben Beweise zugreift wie ein menschlicher Prüfer.
Besonders wirkungsvoll sind quantitative Prüfungen:
Je quantifizierbarer der Validierungsprozess ist, desto seltener ist ein menschlicher Eingriff erforderlich.
Wenn ein einzelner Durchlauf möglicherweise nicht ausreicht, der Endzustand aber klar beschreibbar ist, sind zielbasierte Schleifen besonders nützlich.
Claude Code überlässt es nicht dem Aktionsagenten, selbst zu entscheiden, ob ein Ergebnis "gut genug" ist, sondern verwendet nach jedem Durchlauf einen unabhängigen Evaluator.
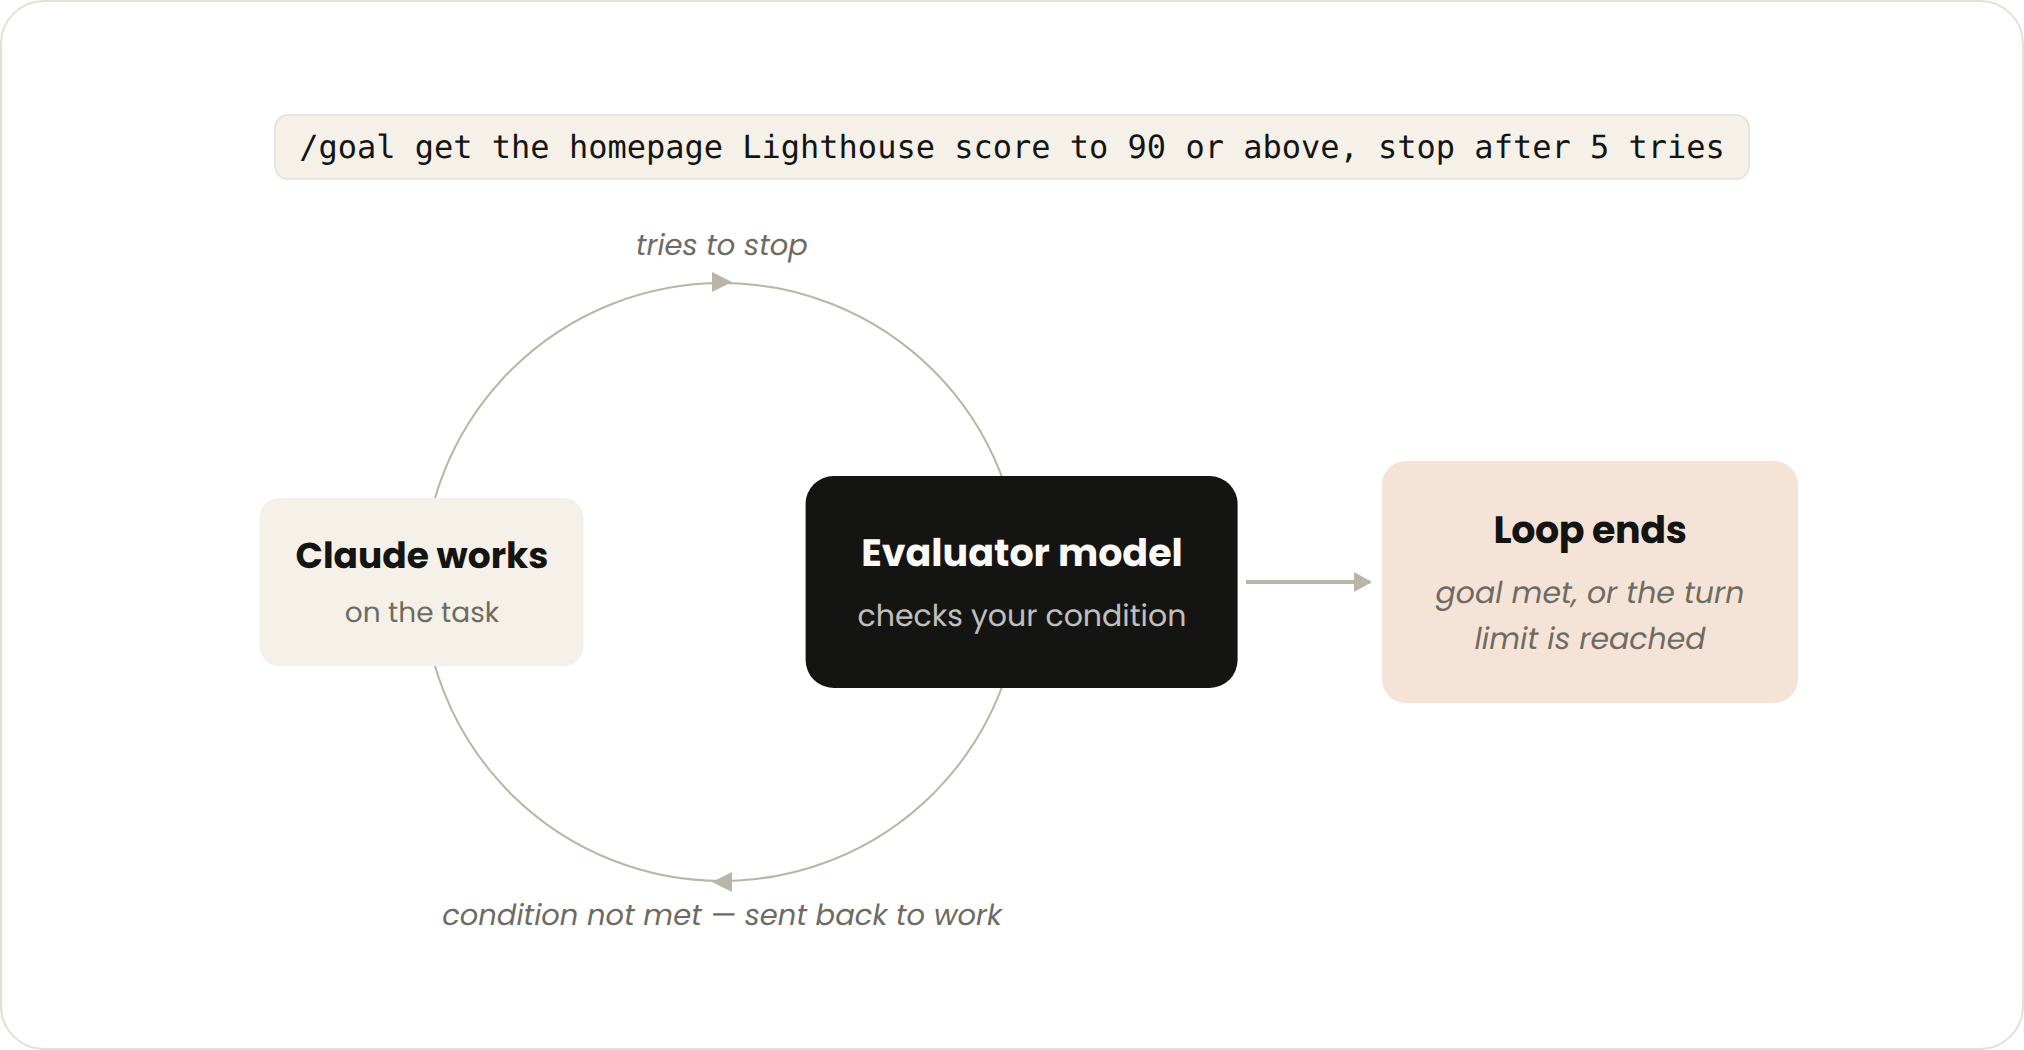
Der Benutzer startet in der aktuellen Sitzung ein Ziel.
Der Zyklus endet, wenn:
Zielbasierte Schleifen eignen sich für Aufgaben mit überprüfbaren Endpunkten, wie zum Beispiel:
Das offizielle Beispiel von Anthropic lautet:
/goal Erreiche einen Lighthouse-Score von 90 oder höher für die Startseite, stoppe nach 5 Versuchen.
Ein weiteres praktisches Beispiel:
/goal Alle Tests im Verzeichnis test/auth bestehen und der lint-Schritt liefert keine Fehler
Laut der aktuellen Claude-Code-Dokumentation erfordert der /goal-Befehl Claude Code Version 2.1.139 oder höher.
Nach Abschluss eines Durchlaufs von Claude prüft ein leichtgewichtiges, schnelles Evaluatormodell, ob die Bedingungen erfüllt sind.
Sind die Bedingungen nicht erfüllt, beginnt automatisch ein neuer Durchlauf; sind sie erfüllt, wird das aktuelle Ziel gelöscht und die Kontrolle über die Sitzung an den Benutzer zurückgegeben.
Diese Trennung ist wichtig, weil das Arbeitsmodell nicht der alleinige Beurteiler seiner eigenen Ausgaben sein sollte.
Eine wirksame Abschlussbedingung sollte folgende Eigenschaften haben:
Schwaches Ziel:
/goal Verbessere die Startseite
Der Begriff "verbessern" definiert keinen messbaren Endpunkt.
Starkes Ziel:
/goal Erhöhe den mobilen Lighthouse-Leistungswert auf mindestens 90 Punkte,
behalte die Barrierefreiheit bei 95 Punkten oder höher und stoppe nach 5 Versuchen.
Schwaches Ziel:
/goal Repariere die Tests
Starkes Ziel:
/goal Alle Tests im Verzeichnis test/payments bestehen, keine übersprungenen Tests,
und der Befehl npm run lint hat einen Exit-Code von 0
Das Modell sollte nicht raten müssen, was Erfolg bedeutet.
/goal ändert keine BerechtigungenEin Ziel erstreckt sich über mehrere Runden, aber es genehmigt nicht automatisch alle Tool-Aufrufe.
Im Standard-Berechtigungsmodus kann Claude bei Befehlen, die noch nicht erlaubt wurden, immer noch eine Bestätigung anfordern.
Für unbeaufsichtigte Ziele empfiehlt Anthropic, /goal im automatischen Modus zu verwenden, wenn verfügbar und angemessen. Dies sollte nach einer Überprüfung der erlaubten Tools, der Repository-Grenzen und möglicher Nebenwirkungen erfolgen.
/loop und /scheduleManche Arbeiten werden nicht durch den Abschluss der vorherigen Runde ausgelöst, sondern durch die Zeit.
Die Aufgaben bleiben ähnlich, aber die Eingaben ändern sich:
Jeder Durchlauf wird durch ein konfiguriertes Zeitintervall oder einen Zeitplan gestartet.
Lokale Schleifen stoppen, wenn Sie sie abbrechen, die Umgebung schließen oder die Überwachungsarbeit abgeschlossen ist.
Cloud-Routinen laufen gemäß ihrer Konfiguration weiter, bis sie pausiert oder deaktiviert werden.
Zeitbasierte Schleifen eignen sich für:
Das offizielle Beispiel verwendet /loop:
/loop 5m Überprüfe meine Pull-Requests, bearbeite Überprüfungskommentare und repariere fehlgeschlagene CI
Diese Aufforderung wird im konfigurierten Intervall erneut ausgeführt.
Lokale Schleifen sind an die aktuelle Maschine und Sitzung gebunden. Wenn der Computer heruntergefahren wird oder der Prozess gestoppt wird, stoppt auch die Schleife.
Für Arbeiten, die auch nach dem Schließen des Laptops weiterlaufen sollen, kann Claude Code mit /schedule Cloud-Routinen erstellen.
Eine aktive Routine könnte wie folgt beginnen:
/schedule Stündlich: Überprüfe #project-feedback auf neue Fehlerberichte
Claude-Code-Routinen laufen auf der von Anthropic verwalteten Cloud-Infrastruktur und können ausgelöst werden durch:
Zum Zeitpunkt der Erstellung dieses Textes befinden sich Routinen in der Research-Preview-Phase, daher können sich Verhalten, Einschränkungen und die API-Oberfläche ändern. Die Verfügbarkeit hängt auch vom jeweiligen Claude-Plan, den Organisationsrichtlinien und davon ab, ob Claude Code für das Web aktiviert ist.
Ein häufiger Fehler ist es, Schleifen viel häufiger auszuführen, als das externe System seine Änderungen vornimmt.
Wenn neue Probleme nur wenige Male am Tag auftauchen, hilft es nicht, die Problemwarteschlange jede Minute zu überprüfen. Es erhöht nur die Token-Nutzung, die Anzahl der Tool-Aufrufe und ...
... Lärm, ohne das Ergebnis zu beeinflussen.
Passen Sie das Abfrageintervall an die erwartete Änderungshäufigkeit an:
| Externes Änderungsmuster | Sinnvolles anfängliches Abfrageintervall |
|---|---|
| CI-Status nach aktivem Push | Alle 5–10 Minuten |
| Team-Feedbackkanal | Alle 30–60 Minuten |
| Tägliche Slack-Zusammenfassung | Einmal täglich morgens |
| Abhängigkeitsaktualisierungen | Täglich oder wöchentlich |
| Dokumentationsabweichung | Nächtlich oder wöchentlich |
Dies sind Ausgangsempfehlungen, keine allgemeingültigen Regeln. Wenn es das externe System unterstützt, ist Ereignisauslösung in der Regel dem Polling vorzuziehen.
Proaktive Schleifen sind eine Kombination der vorherigen Grundelemente.
Sie laufen unbeaufsichtigt, reagieren auf geplante oder eingehende Arbeiten und durchlaufen jedes Aufgabenelement in einem definierten Prozess.
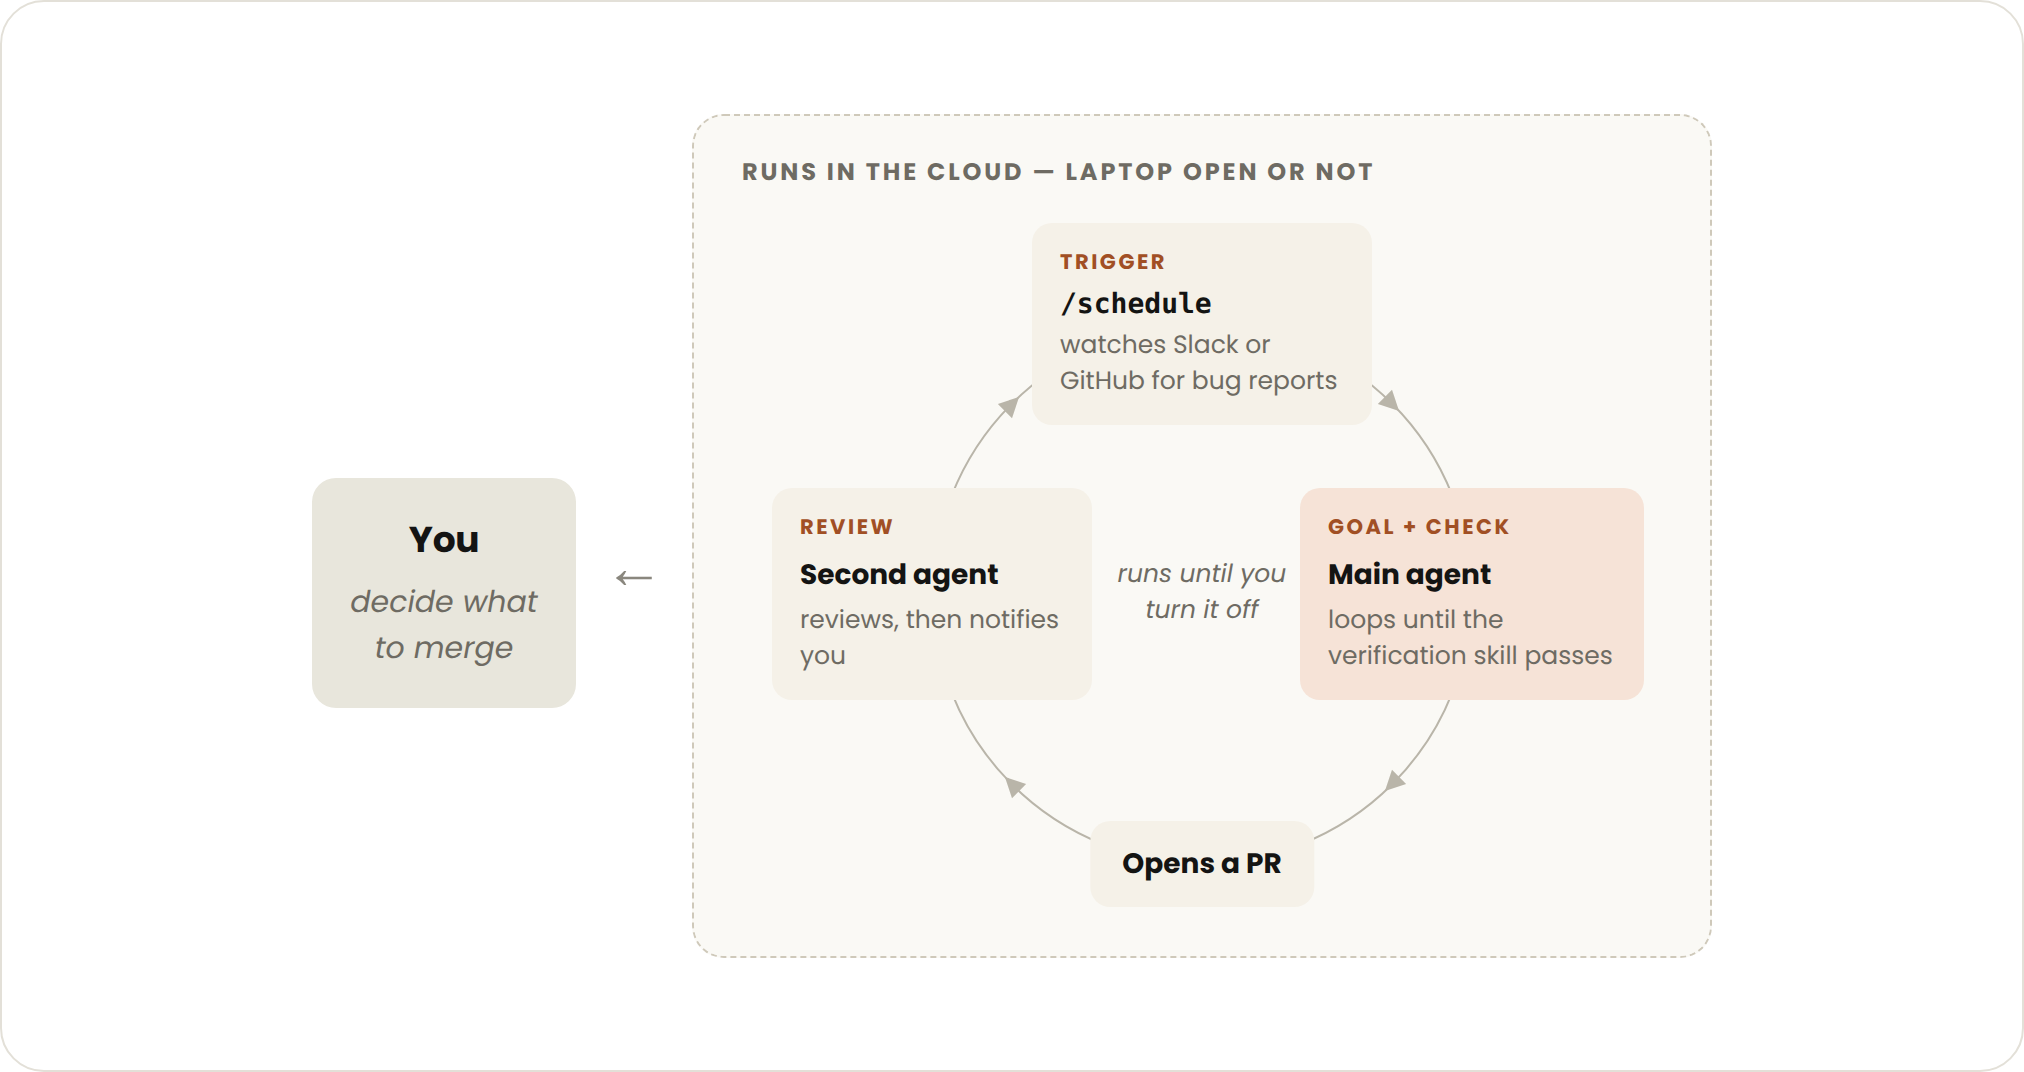
Ein geplanter Task, eine API-Anfrage, ein GitHub-Ereignis, eine Nachricht, ein Problem oder ein anderes externes Signal startet die Arbeit.
Jeder einzelne Task beendet sich, sobald sein Ziel erreicht ist.
Die umgebenden Routinen nehmen weiterhin zukünftige Arbeiten an, bis jemand sie deaktiviert.
Aktive Schleifen eignen sich für klar definierte, sich wiederholende Arbeitsabläufe:
Das Beispiel von Anthropic kombiniert mehrere Funktionen von Claude Code:
/schedule prüft auf neue Berichte./goal definiert, was in einem Durchlauf abgeschlossen werden muss.Eine kombinierte Anweisung könnte wie folgt aussehen:
/schedule einmal pro Stunde: Überprüfe Bugberichte in #project-feedback.

/goal: Stoppe nicht für jeden in diesem Durchlauf gefundenen Bericht,
bevor er triagiert, bearbeitet und beantwortet wurde.

Verwende bei der Fehlerbehebung den Workflow, um in einem parallelen Arbeitsbaum
drei Lösungen zu erkunden, die von einem unabhängigen Prüfer überprüft werden.
Das ist nicht mehr nur eine sich wiederholende Eingabeaufforderung. Es ist ein kleines Betriebssystem für einen eng gefassten Workflow.
Dynamische Workflows sind Skripte zur großflächigen Koordination von Unteragenten.
Claude schreibt ein JavaScript-Orchestrierungsskript, und die Laufzeitumgebung führt es im Hintergrund aus. Zwischenergebnisse können in Skriptvariablen gehalten werden, ohne den Hauptkontext der Unterhaltung zu füllen.
Anthropic positioniert Workflows für Aufgaben wie:
Die aktuelle Dokumentation gibt an, dass dynamische Workflows Claude Code Version 2.1.154 oder höher erfordern. Sie können dutzende oder hunderte von Agenten koordinieren. Daher sollten sie vor der Ausführung großer Produktionsaufgaben in kleinem Maßstab pilotiert werden.
Geplante Tasks, Orchestrierung, Rückkopplungsschleifen und Arbeitswarteschlangen sind keine neuen Engineering-Konzepte.
Der eigentliche Wandel besteht darin, dass Codierungsagenten jetzt umfassender an der Schleife teilnehmen können:
Die Eingabeaufforderung ist nicht verschwunden. Sie ist ein Bestandteil eines größeren Kontrollsystems geworden.
Die wichtigeren Designfragen sind heute:
Eine sorgfältig formulierte Eingabeaufforderung kann fehlende Stoppbedingungen nicht ersetzen.
Anthropic betont wiederholt die Validierung: Claude in die Lage zu versetzen, seine eigene Ausgabe zu überprüfen und zu messen.
Wenn ein menschlicher Ingenieur aufgefordert würde, eine Seite zu erstellen, ohne Zugriff auf einen Browser zu haben, würde er blind arbeiten. Bei Agenten verhält es sich ähnlich.
Nützliche Validierungswerkzeuge sind:
Ein Skript, das den Exit-Code 0 oder 1 zurückgibt, ist in der Regel günstiger und zuverlässiger, als ein Modell zu bitten, von Grund auf zu überlegen, ob eine Anforderung erfüllt ist.
Zum Beispiel:
npm test
npm run lint
npm run typecheck
Ein kombiniertes Validierungsskript könnte sein:
#!/usr/bin/env bash
set -euo pipefail

npm run typecheck
npm run lint
npm test
Claude kann dieses Skript nach jeder Änderung ausführen. Die Schleife muss nicht jedes Mal den gesamten Abnahmeprozess neu interpretieren.
Anthropic empfiehlt auch die Verwendung eines Prüfers mit einem neuen Kontext.
Der ausführende Agent hat bereits seinen eigenen Denkprozess gesehen und könnte dieselben Annahmen wiederholen. Ein unabhängiger Prüfer ist weniger an diesen Pfad gebunden und kann das Ergebnis aus einem anderen Blickwinkel überprüfen.
Für Änderungen mit hohem Wert kann das System Folgendes verwenden:
Mehr Agenten sind nicht immer besser. Fügen Sie sie nur hinzu, wenn der Wert der Überprüfung die zusätzlichen Kosten rechtfertigt.
Schleifen, die unbegrenzt weiterlaufen können, sind sowohl mächtig als auch gefährlich.
Es gibt drei Hauptfehlermodi.
Jede Schleifenrunde kann Input-Token, Output-Token, Tool-Aufrufe und die Nutzung kostenpflichtiger Modelle verbrauchen.
Ohne eine Begrenzung der Runden- oder Budget-Obergrenze kann eine offene Schleife weiter Kosten verbrauchen, während sie nur sehr wenig zusätzlichen Wert generiert.
Das Claude Agent SDK unterstützt beides:
max_turns / maxTurnsmax_budget_usd / maxBudgetUsdDie offizielle SDK-Dokumentation gibt an:
Standardmäßig ist keine der beiden Beschränkungen gesetzt.
Für Agenten in der Produktion sind klare Grenzen eine sinnvolle Grundlage.
Ein Agent könnte immer wieder dieselben Dateien bearbeiten, ohne einen neuen, bestandenen Test oder eine messbare Verbesserung zu erzeugen.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die Protokollierung kann trotzdem aktiv erscheinen, auch wenn das System verschiedene Varianten derselben fehlgeschlagenen Lösung durch die Schleife schickt.
Nützliche Signale für fehlenden Fortschritt sind:
Eine robuste Schleife sollte gestoppt oder eskalieren, wenn der Fortschritt stagniert.
Iteration kann eine fehlerhafte Lösung komplexer machen, anstatt sie korrekt zu machen.
Ein Agent könnte Schichten um eine falsche Annahme herum aufbauen, was zu Code führt, der immer vollständiger aussieht, sich aber immer weiter vom erwarteten Verhalten entfernt.
Unabhängige Prüfungen, deterministische Tests und klare Rollback-Pfade helfen, diese Art von Fehlschlag zu verhindern.
Eine praktische Schleife sollte mindestens drei Arten von Barrieren umfassen.
Der abgeschlossene Zustand sollte durch Tests, Skripte, Evaluatoren oder externe Statusbeobachtung überprüfbar sein.
Beispiele:
Setzen Sie mindestens eine harte Obergrenze:
Eine Grenze verwandelt unbegrenztes Scheitern in begrenztes Scheitern.
Stoppen Sie den Lauf, wenn sich das System nicht mehr auf das Ziel zubewegt.
Zum Beispiel:
Wenn drei aufeinanderfolgende Versuche keinen neuen, bestandenen Test hervorbringen
und dieselben Dateien geändert werden, stoppe den Lauf und melde die Blockade.
Implementierungen auf Produktionsniveau können dies über Skripte oder Workflow-Status verfolgen und nicht nur über Anweisungen.
Schleifen sollten so gestaltet sein, dass sie Rechenressourcen auf die wertvollsten Schritte konzentrieren.
Anthropic empfiehlt die folgenden Kostenkontrollmaßnahmen.
Kleine Aufgaben benötigen keinen Mehr-Agenten-Workflow.
Beginnen Sie mit folgenden Ansätzen:
/goal, wenn mehrere Durchläufe erforderlich sind./loop oder /schedule, wenn die Arbeit zeitgesteuert erfolgen soll.Schnelle, kostengünstige Modelle eignen sich für:
Heben Sie sich die stärksten Modelle auf für:
Dynamische Workflows können eine große Anzahl von Agents erzeugen.
Führen Sie zunächst kleinere Tests durch:
Den gesamten Rückstand.
Pilotprojekte zeigen Tokenverbrauch, Tool-Engpässe, häufige Fehler und fehlende Kontrollmechanismen auf.
Wenn der Ablauf deterministisch ist, schreiben Sie den Code einmal und lassen Sie Claude ihn ausführen.
Zum Beispiel:
Zeitbasierte Schleifen sollten der Änderungsgeschwindigkeit des zugrunde liegenden Systems entsprechen.
Zu kurze Intervalle erhöhen die Kosten, ohne bessere Ergebnisse zu liefern.
Anthropic bietet mehrere Befehle zur Überprüfung des Verbrauchs:
/usage
Dieser Befehl zeigt die aktuelle Nutzung in Bereichen wie Skills, Sub-Agents und MCP-Integrationen an.
Ohne Argumente ausgeführt, zeigt /goal die Durchläufe und den Tokenverbrauch des aktuellen Ziels, während /workflows die Nutzung von Workflow-Agents und Steuerungsmöglichkeiten zum Stoppen von Agents anzeigt.
Die Verfügbarkeit kann je nach Claude Code-Version und aktivierten Funktionen variieren.
Automatisierung sollte nicht mit uneingeschränktem Zugriff gleichgesetzt werden.
Claude Code unterstützt Berechtigungsmodi, die steuern, welche Tools und Befehle ausgeführt werden können.
Für autonome Arbeit auf Entwicklungsrechnern empfiehlt Anthropic, klare Genehmigungsregeln beizubehalten oder einen Modus zu verwenden, der begrenzte, häufige Operationen automatisch genehmigt, während risikoreiche Befehle weiterhin kontrolliert werden.
Modi, die Berechtigungen umgehen, sollten nur in isolierten Umgebungen eingesetzt werden, wie zum Beispiel:
Ein aktiver Loop, der Dateien bearbeiten, Shell-Befehle ausführen, auf externe Systeme zugreifen und Pull-Requests erstellen kann, sollte ebenfalls Folgendes aufweisen:
Ziel ist es nicht, alle menschlichen Entscheidungen zu eliminieren, sondern menschliches Urteilsvermögen dort einzusetzen, wo es wirklich benötigt wird.
Beachten Sie den folgenden Entscheidungsprozess.
Anthropic empfiehlt, mit einer Aufgabe zu beginnen, bei der Sie derzeit der Engpass sind.
Stellen Sie drei Fragen.
Beispiele:
Ein nützliches Ziel beschreibt einen Zustand, nicht nur eine Aktivität.
Besser:
Alle Zahlungstests bestehen und es gibt keine TypeScript-Fehler mehr.
Schwächer:
Das Zahlungsmodul weiter verbessern.
Wenn die Aufgabe stündlich, täglich, wöchentlich oder nach bekannten Ereignissen auftritt, eignet sie sich möglicherweise für einen Loop oder eine Routine.
Wenn eine Antwort „Ja“ ist, haben Sie einen Kandidaten für Ihren ersten Loop.
Stellen Sie sich ein Team vor, das wiederholt fehlgeschlagene Pull-Request-Checks repariert.
Überprüfe aktuelle PRs, repariere fehlgeschlagene CI-Tests und erkläre die Änderungen.
Der Entwickler führt diesen Vorgang manuell bei jeder CI-Änderung erneut aus.
Erstellen Sie einen Skill, der:
/goal Alle erforderlichen CI-Checks bestehen, stoppe nach 4 Versuchen.
Die Sitzung kann mehrere Reparaturversuche durchführen.
/loop 10m Überprüfe PRs, bearbeite neue Review-Kommentare und repariere fehlgeschlagene erforderliche Checks.
Der Agent überprüft externe Änderungen.
Erstellen Sie eine Cloud-Routine, die durch Pull-Request-Ereignisse oder einen Zeitplan ausgelöst wird.
Begrenzen Sie sie auf:
Die Entwicklung erfolgt schrittweise. Jede Phase fügt Automatisierung erst hinzu, nachdem die vorherige Phase über zuverlässige Checks verfügte.
„Codebasis verbessern“ könnte ewig weiterlaufen.
Brechen Sie es in beobachtbare Ergebnisse herunter.
Verwenden Sie Tests, Skripte oder unabhängige Evaluatoren.
Ein einzelner Agent plus ein starker Validierer kann besser sein als ein schlecht koordinierter großer Workflow.
Minütliches Polling ist nicht von Natur aus reaktionsschneller.
Schleifen ohne Obergrenze können zu teuren Fehlern führen.
Verwenden Sie Berechtigungen, Hooks, Sandboxen und isolierte Umgebungen für deterministische Ausführung.
Wenn derselbe Fehler wiederholt auftritt, verbessern Sie den Skill, die Regel, den Validierer oder den Workflow, der ihn erzeugt.
Loop Engineering ist das Design von sich wiederholenden Agent-Workflows, die bis zu einem Stoppkriterium laufen. Es konzentriert sich auf Auslöser, Überprüfung, Grenzen, Berechtigungen und Eskalation, nicht nur auf den Inhalt eines Prompts.
Anthropic unterteilt Loops in durchlaufbasierte, zielbasierte, zeitbasierte und aktive Loops.
Ihre Hauptunterschiede liegen im Mechanismus, der eine neue Runde auslöst, sowie in der Frage, wer oder was bestimmt, wann die Arbeit beendet wird.
/goal in Claude Code?/goal legt eine Abschlussbedingung für die aktuelle Sitzung fest. Nach jeder Runde prüft ein unabhängiger Evaluator, ob die Bedingung erfüllt ist; falls nicht, wird die nächste Runde gestartet, bis das Ziel oder die konfigurierte Grenze erreicht ist.
/loop und /schedule?/loop wiederholt einen Prompt in festgelegten Intervallen auf dem lokalen Rechner. Wenn die Maschine oder die Sitzung endet, stoppt auch die Schleife. /schedule erstellt eine cloudbasierte Routineaufgabe, die auf der von Anthropic verwalteten Infrastruktur weiterläuft – selbst wenn der Laptop ausgeschaltet ist.
Wenn der Arbeitsablauf keine klaren Grenzen hat, kann die Schleife länger laufen als erwartet. Bevor eine unbeaufsichtigte Ausführung zugelassen wird, sollten eine messbare Abschlussbedingung, eine feste Obergrenze für Runden oder Kosten sowie eine Stoppregel bei fehlendem Fortschritt definiert werden.
Nein. Eine normale Claude-Code-Sitzung mit wiederverwendbaren Validierungsfähigkeiten kann bereits ausreichen. Dynamische Workflows und mehrere Agenten sind dann sinnvoll, wenn Aufgaben eine massive Parallelverarbeitung oder unabhängige Überprüfungen erfordern.
Indem Sie den einfachsten Schleifentyp verwenden, für Routineaufgaben kleinere Modelle einsetzen, zunächst mit kleineren Arbeitslasten pilotieren, Skripte anstelle deterministischer Inferenz nutzen, unnötige Abfragen vermeiden und klare Grenzen für Runden oder Budget setzen.
Sie können verantwortungsvoll betrieben werden, solange ihre Berechtigungen, Repositorys, Anmeldedaten, Budgets, Stoppregeln und Eskalationspfade streng kontrolliert werden. Verwenden Sie keine Modi, die Berechtigungen umgehen, auf Maschinen mit sensiblen oder wertvollen Daten.
SKILL.md abgelegt sind./goal-Syntax, Evaluierungsverhalten, Statuskontrolle und Anforderungen.Claude-Code-Schleifen sind keine einfachen Wiederholungen von Prompts, sondern ein kontrolliertes System, das durch Auslöser, Werkzeuge, Validierung, Berechtigungen, Budget und Stoppbedingungen zusammenwirkt.
Rundenbasierte Schleifen geben dem Menschen die Kontrolle über jeden nachfolgenden Schritt; zielorientierte Schleifen delegieren die Abschlussbedingung an den Evaluator; zeitgesteuerte Schleifen delegieren den Auslöser. Proaktive Schleifen kombinieren diese Grundelemente zu wiederholbaren, unbeaufsichtigten Arbeitsabläufen.
Die wichtigste Verbesserung besteht in der Regel nicht darin, mehr Agenten hinzuzufügen, sondern den bestehenden Agenten zuverlässige Selbstprüfmechanismen zu geben, klare Abschlusskriterien zu definieren und das System bei Erschöpfung des Fortschritts oder Budgets rechtzeitig zu stoppen.
Nützliche Schleifen laufen nicht ewig – sie können beweisen, wann sie gestoppt werden sollten.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



