For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/claude-code-review-ai-checks-human-approv-629ae884.md.
Anthropic zufolge schreibt Claude etwa 90 % des eigenen Codes von Claude Code. Der Engineering-Bericht stellt die nächste Frage: Wie sollte ...
Anthropic zufolge schreibt Claude etwa 90 % des eigenen Codes von Claude Code. Der Engineering-Bericht stellt die nächste Frage: Wie sollte ein Team Änderungen prüfen, wenn Agenten sie schneller erzeugen können, als Menschen sie lesen können?
Die Antwort ist ein mehrstufiger Prozess, der routinemäßige Prüfungen frühzeitig durchführt, Agenten zur Untersuchung von Fehlern einsetzt und menschliche Aufmerksamkeit für Entscheidungen mit höherem Risiko reserviert. Anthropic berichtet, dass sich die Zahl der zusammengeführten Pull Requests von Juni bis September mehr als verdoppelt hat, während der Anteil der Pull Requests, die eine Rücknahme erforderten, um über 40 % gesunken ist.
Diese Beobachtungen beschreiben den Prozess eines einzelnen Teams. Die Angabe von 90 % bezieht sich auf die Urheberschaft am Code, nicht auf den Anteil der Änderungen, die ohne menschliche Beteiligung freigegeben werden dürfen. Eine erforderliche menschliche Freigabe kann nicht von einem Agenten bereitgestellt werden.
Das Team betrachtet das zeilenweise Lesen durch Menschen als eine Möglichkeit, Probleme zu erkennen, nicht als das eigentliche Ziel eines Reviews. Die bessere Frage lautet: Welche Fehlerarten führt eine Änderung ein, und welche Prüfungen können sie erkennen?
Dadurch wird das Review von einem einzelnen Kontrollpunkt nach einem Pull Request zu einer kontinuierlichen Aktivität. Tests, Builds und Agenten-Reviews in einem frischen Kontext können Probleme erkennen, bevor ein weiterer Entwickler unterbrochen werden muss.
Die Kostenberechnung berücksichtigt sowohl die Review-Zeit als auch die Zeit, die für die Behebung von Vorfällen aufgewendet wird. Weniger Freigaben sind keine erfolgreiche Optimierung, wenn Fehler lediglich weiter nachgelagert auftreten. Rücknahmen und Vorfallraten dienen daher neben Kennzahlen zu menschlichen Kommentaren, Freigaben und Wartezeiten als Leitplanken.
Das separate Monorepo von Anthropic wuchs von etwa 2.500 täglich zusammengeführten Änderungen im Mai auf mehr als 30.000 im September. Claude Code verfügt über ein eigenes Repository; diese Zahlen zum Monorepo dürfen nicht direkt seiner Codebasis zugerechnet werden.
Der zugrunde liegende Bericht hebt drei Stufen eines siebenstufigen Prozesses hervor. Der offizielle Beitrag beschreibt die vollständige Abfolge:
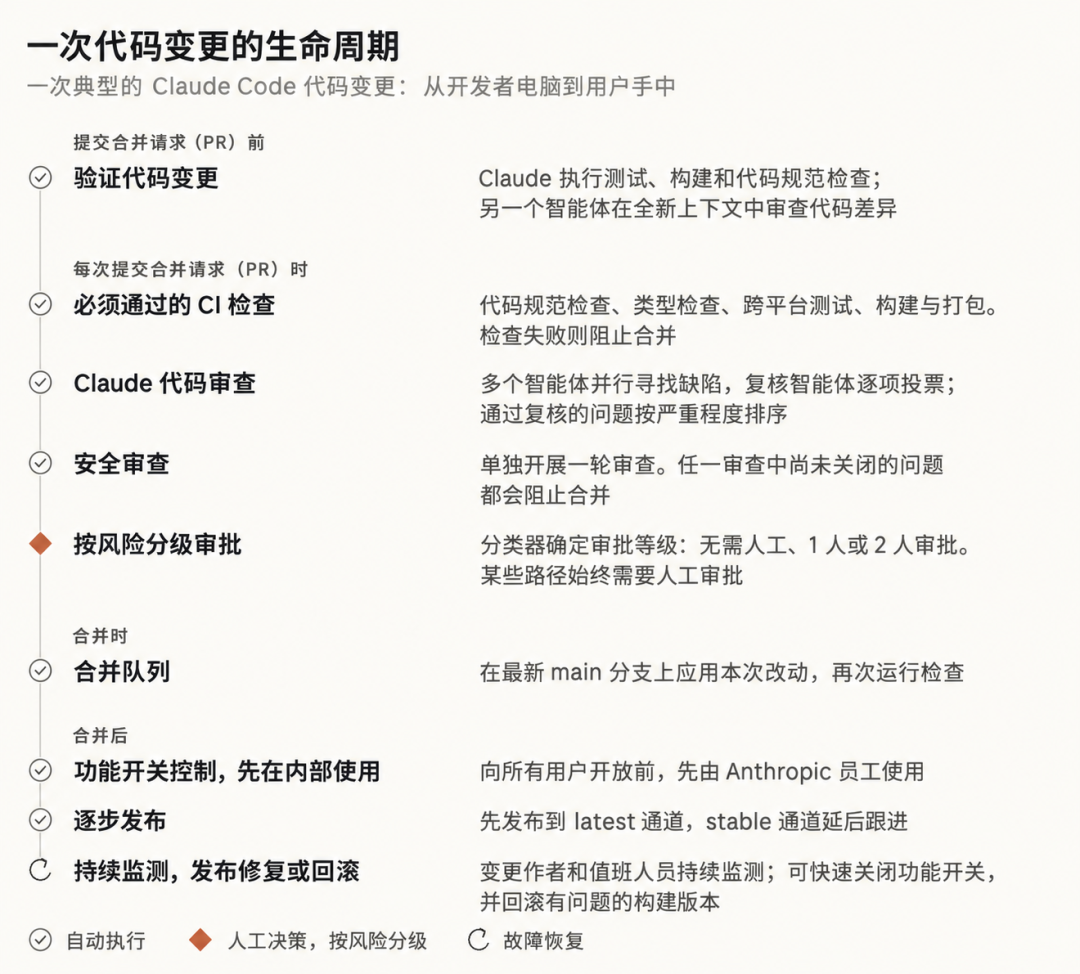
Übersetzte Darstellung des Workflows aus dem bereitgestellten Bericht; der offizielle Artikel enthält das englische Original.
Vor einem Pull Request sind Nachweise wichtiger als die Aussage eines Agenten, dass die Aufgabe abgeschlossen sei. Ein Testbefehl mit seiner Ausgabe oder ein anhand eines Designs geprüfter Screenshot gibt Reviewern etwas Überprüfbares an die Hand. Wiederkehrende Probleme können anschließend in Linting-Regeln, Fähigkeiten oder präzise Projektanweisungen in CLAUDE.md und REVIEW.md überführt werden.
Der KI-Reviewer konzentriert sich auf wesentliche Fehler statt auf uneingeschränkte Stilhinweise. Anthropic berichtet, dass der Anteil interner Pull Requests mit substanziellen Kommentaren während der Forschungs-Vorschau von 16 % auf 54 % gestiegen ist. Kommentare können bereits bestehende Probleme separat kennzeichnen und so vermeiden, dass der Eindruck entsteht, jeder Befund sei durch die neue Änderung verursacht worden.
| Risikostufe | Vom Team beschriebene interne Freigaberichtlinie |
|---|---|
| Niedrig | Keine menschliche Freigabe erforderlich, sobald die zutreffenden automatisierten Prüfungen bestanden sind; Vertrauens- und Pfadregeln gelten weiterhin. |
| Mittel | Eine menschliche Freigabe. |
| Hoch | Zwei menschliche Freigaben. |
Für sensible Pfade und CI-Workflow-Dateien gelten zusätzliche Anforderungen. Nur vertrauenswürdige Autoren kommen für vereinfachte Wege infrage; andere Mitwirkende benötigen die Freigabe einer weiteren Person. Klassifikatoren bewerten die Änderung, statt lediglich der Identität des Einreichers zu vertrauen.
Bei von Agenten geschriebenen Arbeiten gilt die Person, die den Agenten anleitet, als verantwortlicher Reviewer. Die Freigabe eines Agenten ersetzt niemals einen erforderlichen menschlichen Freigabeplatz. Freigaben müssen möglicherweise erneut eingeholt werden, wenn nachfolgende Commits den geprüften Inhalt verändern.
Der interne Weg ohne menschliche Beteiligung unterscheidet sich außerdem vom öffentlichen Review-Produkt. Das Produkt veröffentlicht Befunde; es stellt nicht eigenständig die menschliche Freigabe bereit, die durch die Regeln eines Repositorys vorgeschrieben ist.
Ein CLI-Pull-Request durchlief über Nacht mehr als 50 Review- und Fehlerbehebungsrunden, bevor sein Verantwortlicher ihn stoppte. Ein Agent als Autor behob einen geringfügigen Kommentar, erzeugte einen neuen Commit und löste damit einen Reviewer aus, der ein weiteres Problem fand.
Die nachträgliche Untersuchung des Teams ergab, dass etwa 59 % des wiederholt beanstandeten Codes bereits bei der ersten Prüfung vorhanden waren. Spätere Durchläufe entdeckten häufig weitere alte Probleme, statt Fehler, die durch jede einzelne Reparatur neu eingeführt worden waren.
Der überarbeitete Prozess begrenzt gewöhnliche Review-Schleifen auf drei Runden, bevor der Autor aufgefordert wird, den Ansatz zu überdenken. Spätere Durchläufe werden außerdem auf das neue Diff eingegrenzt, wiederholte Befunde unterdrückt und Autoren dazu aufgefordert, eine Fehlerklasse statt nur eines einzelnen Vorkommnisses zu beheben.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
| Interne Kennzahl | Vorher | Nach den Änderungen zur Konvergenz |
|---|---|---|
| Bestehen nach einer Review- und Behebungsrunde | 65 % | 78 % |
| Mindestens fünf Runden erforderlich | 8,9 % | 1,5 % |
| Durchschnittliche Zahl der Reviews bis zum Bestehen | 2,08 | 1,32 |
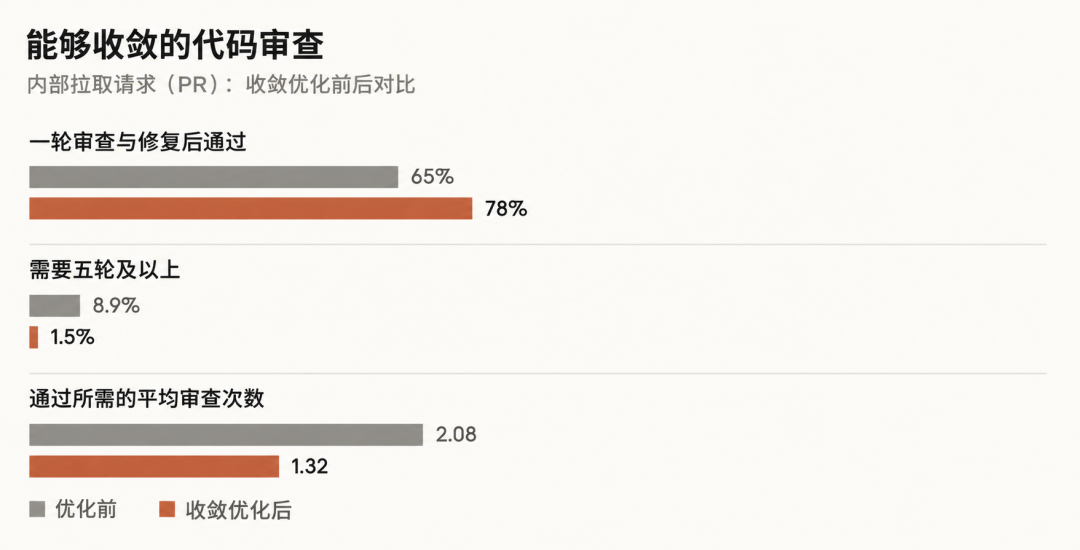
Interne Messwerte von Anthropic, reproduziert im Quellbericht.
Mehr Kommentare zu finden bedeutet nicht automatisch, dass ein Review besser wird. Anthropic testet Reviewer anhand von durch Experten bestätigten Vorfallfällen und bekanntermaßen fehlerfreien Änderungen und erfasst sowohl übersehene Fehler als auch schädliche Fehlalarme.
Menschen bleiben dafür verantwortlich zu entscheiden, ob eine Funktion in das Produkt gehört, folgenreiche Architekturentscheidungen zu prüfen und riskante Bereiche wie Abrechnung, CI und den Updater zu untersuchen. Sie müssen außerdem verstehen, was automatisierte Prüfungen übersehen können.
Der Autor und der für Bereitschaftsdienste zuständige Entwickler beobachten das Ergebnis nach dem Zusammenführen. Feature-Flags, interne Nutzung und stufenweise Kanäle erleichtern die Wiederherstellung, beseitigen Vorfälle jedoch nicht. Der offizielle Beitrag erklärt, dass automatische Schutzschalter, die bei einer Verschlechterung der Kennzahlen die Freigabeanforderungen verschärfen, weiterhin eine gewünschte Verbesserung sind.
Die dauerhafte Verantwortung liegt bei der Übernahme der Verantwortung für die ausgelieferte Änderung. Eine schnellere Implementierung erleichtert es, einen unnötigen Pull Request zu verwerfen, überträgt die Entscheidung darüber, was ausgeliefert werden sollte, jedoch nicht an eine ungeprüfte Review-Schleife.
Nein. Urheberschaft und Freigabe sind unterschiedliche Messgrößen. Der interne Prozess skaliert die menschliche Prüfung nach Risiko und behält für bestimmte Änderungen und Pfade verpflichtende Freigaben bei.
Der offizielle Beitrag erklärt ausdrücklich, dass dies nicht möglich ist. Automatisierte Reviews können geeignete Arbeiten mit geringem Risiko freigeben, aber keinen für eine Person vorgesehenen Freigabeplatz besetzen.
Agenten untersuchen unterschiedliche potenzielle Fehler, und separate Verifizierer bewerten ihre Befunde. Dadurch findet eine zusätzliche Prüfung statt, bevor ein Kommentar den Autor erreicht. Eine Übereinstimmung ist jedoch kein Beweis dafür, dass jeder Befund korrekt ist.
Unbegrenzte Schleifen zwischen Autor und Reviewer können Zeit verbrauchen und dabei wiederholt alte Probleme aufdecken. Das Limit fordert dazu auf, den Ansatz zu überdenken, statt automatisch denselben Zyklus fortzusetzen.
Sie bezeichnet den relativen Rückgang des Anteils zusammengeführter Claude-Code-Pull-Requests, die zwischen Juni und September eine Rücknahme erforderten. Es handelt sich nicht um die Aussage, dass alle Softwarefehler um 40 % zurückgegangen seien.
Beginnen Sie mit überprüfbaren Prüfungen, eindeutigen Risikoregeln und einer zuverlässigen Rücknahme. Messen Sie den Review-Aufwand gemeinsam mit Vorfällen und Rücknahmen, bevor Sie den Umfang der erforderlichen menschlichen Beteiligung reduzieren.
Das Team hinter Claude Code kombiniert frühe Verifizierung, Multi-Agenten-Reviews, Sicherheitsprüfungen, eindeutige Freigaberegeln und schnelle Wiederherstellung. Außerdem begrenzt es Review-Schleifen, damit Agenten sich nicht gegenseitig beschäftigen, ohne die Änderung zu verbessern.
Automatisierung verändert, wer das Diff liest; Menschen bleiben für die Entscheidung und das Ergebnis verantwortlich.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.