For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/claude-cowork-mobile-web-agent-harness.md.
Die mobile und Web-Unterstützung von Claude Cowork ist mehr als nur eine Aktualisierung der Produktschnittstelle. Sie zeigt, dass die Arbeit...
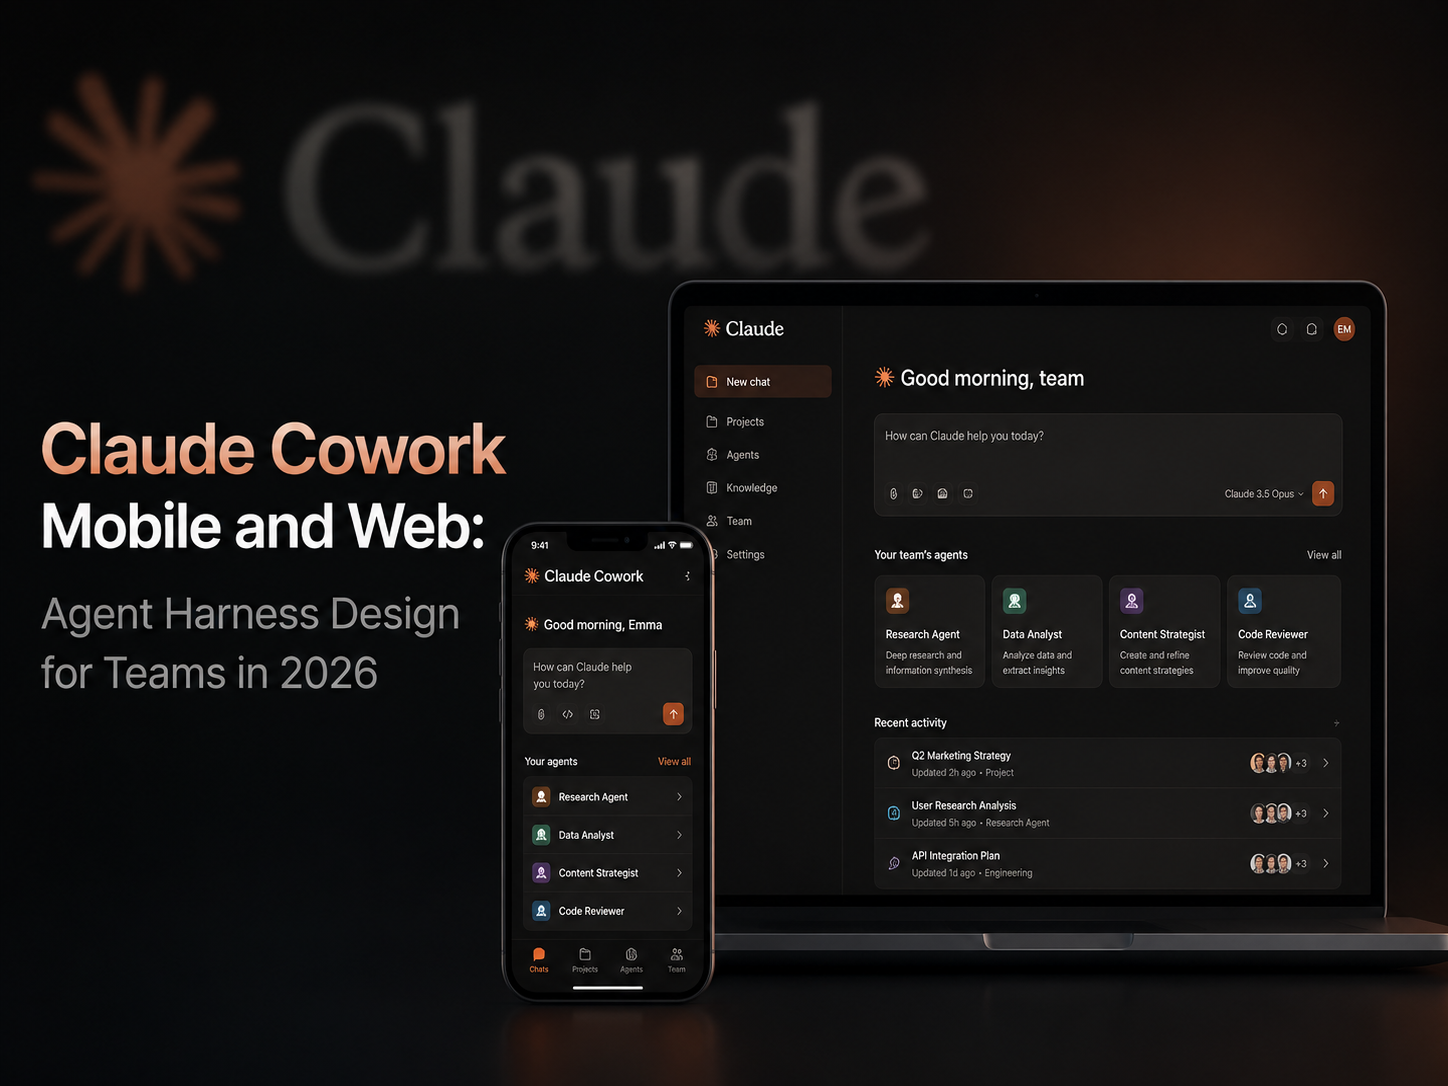
Anthropics Claude Cowork-Update wirkt auf den ersten Blick simpel: Cowork verlässt den Desktop und wird auch im Web und auf Mobilgeräten verfügbar. Aber das eigentliche Signal ist größer als eine neue Oberfläche.
Sobald ein Agent weiterarbeiten kann, nachdem der Benutzer den Schreibtisch verlassen hat, ist das Produkt nicht mehr nur ein Chatfenster. Es wird zu einem persistenten Aufgabenfaden. Der Benutzer kann die Arbeit am Desktop beginnen, den Fortschritt auf dem Telefon prüfen, eine Klärungsfrage von einem anderen Gerät beantworten und später zurückkehren, um ein Artefakt zu überprüfen.
Diese Veränderung ist für Teams relevant, die Claude Cowork, Claude Code, Codex, Cursor, GitHub Copilot, NxCode oder interne Agenten nutzen. Die Frage ist nicht mehr nur: „Kann das Modell die Aufgabe lösen?“ Die bessere Frage lautet: Kann das System um das Modell herum Kontext, Werkzeuge, Zustand, Berechtigungen, Protokolle, Validierung und menschliche Überprüfung kontrollieren?
Claude Cowork erweitert sich von einem desktop-zentrierten Workflow zu einer Web- und mobilen Erfahrung. Der Benutzer kann eine Aufgabe am Computer starten, Claude im Hintergrund weiterarbeiten lassen, den Status vom Telefon aus prüfen und später zurückkehren, um die Ausgabe zu überprüfen.
Das verändert das mentale Modell.
Ein Chatbot wartet auf die nächste Nachricht. Ein Code-Vervollständigungswerkzeug schlägt die nächste Zeile vor. Ein Hintergrund-Agent arbeitet weiter, nachdem der Benutzer weggegangen ist. Das bedeutet, dass Teams nicht die gesamte Governance in eine Desktop-Sitzung oder ein sichtbares Terminal-Fenster packen können.
Anthropics Cowork-Produktseite betont auch die Kontrolle. Benutzer wählen Ordner und Werkzeuge aus, und Unternehmensadministratoren können Zugriff und Berechtigungen konfigurieren. Das ist wichtig, weil geräteübergreifende Arbeit nur dann nützlich ist, wenn sie nicht versehentlich jede Telefonberührung in eine weitreichende Berechtigungserteilung verwandelt.
Für Ingenieursteams ist die Lektion nicht „Verlagern Sie jede Aufgabe auf Mobilgeräte“. Die Lektion ist, dass delegierte Arbeit dauerhaft wird. Aufgaben werden über Tabs, Geräte, Meetings, Benachrichtigungen und menschliche Kontextwechsel hinweg fortgesetzt. Das Betriebsmodell muss davon ausgehen, dass die Arbeit nach der ersten Eingabeaufforderung weitergehen kann.
Ein Agenten-Geschirr ist das System um das Modell herum, das eine Anfrage in kontrollierte Arbeit verwandelt.
Es umfasst:
Ein starkes Modell in einem schwachen Geschirr kann dennoch schwer scheitern. Es könnte die falschen Dateien lesen, das falsche Werkzeug verwenden, eine große
unsichere Änderung oder ein Ergebnis, das poliert aussieht, aber nicht überprüfbar ist.
Die mobile und Web-Erweiterung von Claude Cowork macht das "Harness" sichtbarer. Die Aufgabe kann auf dem Desktop beginnen, in der Cloud weitergeführt werden, eine Genehmigung auf dem Mobilgerät anfordern und mit Dateien oder Nachrichten enden, die zur Überprüfung bereit sind. Dieser Ablauf benötigt Zustand und Berechtigungen, die mit der Aufgabe reisen, nicht nur mit dem Gerät.
AWS treibt eine verwandte Idee von der Cloud-Seite aus mit Amazon Bedrock AgentCore voran. Dessen Harness-Modell konzentriert sich auf Orchestrierung, Tool-Ausführung, Kontextmanagement, Zustandspersistenz, Fehlerbehebung und isolierte Sitzungen. Lilian Wengs Schriften über Harness-Engineering weisen aus Forschungsperspektive in die gleiche Richtung: Besseres Agentenverhalten resultiert nicht nur aus stärkeren Modellgewichten, sondern auch aus besseren Umgebungen, Feedbackschleifen, Evaluierung, Werkzeugen und Gerüsten.
In der Praxis ist das Harness der Ort, an dem Teams definieren, was "gute Agentenarbeit" bedeutet.
Geräteübergreifende Agenten haben einen offensichtlichen Wert.
Ein Produktmanager kann vor dem Einsteigen in den Zug eine Kundenrecherche-Zusammenfassung anfordern. Ein Entwickler kann eine Log-Untersuchung starten, den Laptop schließen und eine gezielte Folgemaßnahme vom Telefon aus genehmigen. Ein Gründer kann ein Investoren-Update delegieren und den Entwurf später prüfen.
Aber das Risiko ist ebenso klar. Eine Aufgabe, die im Hintergrund weiterläuft, kann weiterhin Werkzeuge, Dateien, verbundene Apps und Kontext nutzen, nachdem der Mensch aufgehört hat, auf den Bildschirm zu schauen.
Teams sollten fünf Arten von Befugnissen trennen.
| Befugnisart | Beispiel | Standardregel |
|---|---|---|
| Lokalen Kontext lesen | Repository-Dateien, Dokumente, Notizen | Nur eingeschränkte Ordner erlauben |
| Verbundene Apps lesen | Slack, E-Mail, Kalender, CRM | Genehmigung pro Connector verwenden |
| Lokale Artefakte schreiben | Entwürfe, Branches, Tabellen | Nur mit überprüfbaren Diffs erlauben |
| Externe Kommunikation | E-Mail senden, Slack posten, Tickets anlegen | Menschliche Bestätigung erforderlich |
| Destruktive oder Produktionsaktion | Dateien löschen, Secrets rotieren, Deployen | Explizite Genehmigung und Protokolle erforderlich |
Mobiler Zugriff sollte die Überprüfung schneller, nicht schwächer machen. Ein Telefon ist nützlich, um den Aufgabenstatus zu prüfen, eine Klärungsfrage zu beantworten oder einen gezielten nächsten Schritt zu genehmigen. Es ist nicht der richtige Ort, um einen großen Code-Diff zu überprüfen, eine Produktionsmigration zu autorisieren, Abrechnungsänderungen zu genehmigen oder weitreichenden Zugriff auf Kundendaten zu gewähren.
Eine einfache Betriebsregel funktioniert gut:
Mobilgeräte können lenken, aber ernsthafte Genehmigungen sollten dort erfolgen, wo die Beweise sichtbar sind.
Jede delegierte Aufgabe benötigt eine schriftliche Abgrenzung.
Ein guter Umfang sollte Folgendes enthalten:
Ohne diese Grenzen ist ein Hintergrundagent nur ein langlaufender Prompt mit angehängten Werkzeugen. Das ist kein sicheres Betriebsmodell.
Ein Prüfer sollte nicht raten müssen, was der Agent getan hat.
Für Codeaufgaben sollte der Abschlussbericht Folgendes enthalten:
relevant
Bei Forschungsaufgaben sollte der Abschlussbericht Folgendes enthalten:
Ziel ist es, die Arbeit des Agents nachvollziehbar zu machen. Eine polierte Antwort reicht nicht aus.
Nicht jede Aufgabe benötigt dasselbe Modell, denselben Kontextrahmen oder dasselbe Budget.
Für risikoarme Zusammenfassungen, Problem-Triage, Formatierung und deterministische Transformationen können oft günstigere Modelle verwendet werden. Schwieriges Debugging, Architekturplanung, Migrationen und sicherheitskritische Arbeiten rechtfertigen möglicherweise stärkere Modelle und strengere Überprüfungen.
Eine praktische Routing-Richtlinie könnte wie folgt aussehen:
| Aufgabentyp | Vorgeschlagene Modellstrategie | Überprüfungsniveau |
|---|---|---|
| Formatierung oder Bereinigung | Kostengünstigeres Modell | Leichte Überprüfung |
| Zusammenfassung oder Triage | Kostengünstigeres Modell | Stichprobenprüfung |
| Kleiner Code-Fix | Mittel/hohes Modell je nach Risiko | Diff + Test-Überprüfung |
| Architekturänderung | Stärkeres Modell | Menschliche Überprüfung erforderlich |
| Sicherheits- oder Produktionsaufgabe | Stärkeres Modell + strenge Umgebung | Menschliche Genehmigung erforderlich |
| Externe Kundenkommunikation | Stärkeres Modell oder menschengeführt | Genehmigung vor dem Versand |
Es geht nicht darum, immer das günstigste Modell zu verwenden. Es geht darum, das richtige Modell für das Risikoniveau zu wählen.
Persistente Agents verleiten dazu, alles zu speichern. Das ist riskant.
Teams sollten stabile, wiederverwendbare Informationen speichern, wie zum Beispiel:
Teams sollten vermeiden, Folgendes zu speichern:
Guter Speicher verbessert die Zuverlässigkeit des Workflows. Schlechter Speicher verwandelt die gestrige Vermutung in die versteckte Anweisung von morgen.
Bewerten Sie Agents nicht nur durch Demos oder Social-Media-Clips.
Wählen Sie reale Aufgaben aus dem letzten Monat. Beziehen Sie Fehler, Refaktorisierungen, Dokumentationsbearbeitungen, Datenbereinigungen, Support-Untersuchungen und Release-Überprüfungen ein. Lassen Sie jeden Agent mit dem gleichen Zeitbudget laufen und vergleichen Sie die Ergebnisse.
Messen Sie:
Ein lokaler Benchmark eines Teams ist wertvoller als eine allgemeine Bestenliste, weil er die Arbeit widerspiegelt, die das Team tatsächlich leistet.
Ein nützlicher Harness muss nicht als großes Plattformprojekt beginnen. Eine minimale Version kann mit einer Repository-Anweisungsdatei, einer Aufgaben-Vorlage, einer Validierungs-Checkliste und einer Überprüfungsregel erstellt werden.
Verwenden Sie eine Aufgaben-Vorlage wie diese:
Ziel:
Erlaubter Kontext:
Erlaubte Werkzeuge:
Nicht erlaubte Aktionen:
Validierungsbefehl:
Erwartetes Artefakt:
Menschliche Genehmigung erforderlich für:
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Stopp, wenn:
Ordnen Sie dann Aufgabentypen Workflows zu.
Diese Vorlage ist einfach, aber sie zwingt das Team, Autorisierung und Validierung sichtbar zu machen.
Für We0 AI-artige Workflows sollte der Harness Teams helfen, Anweisungen zu definieren, wiederholbare Prüfungen durchzuführen, Agent-Ausgaben zu vergleichen und ausreichend Kontext für die Überprüfung zu bewahren. Das Ziel ist nicht, zu verlangsamen.
Einführung. Ziel ist es, Delegation ausreichend vorhersagbar zu machen, um Vertrauen zu ermöglichen.
Vergleichen Sie Claude Cowork, Claude Code, Codex, GitHub Copilot, Cursor oder interne Agents nicht nach dem "Bauchgefühl".
Nutzen Sie echte Aufgaben und stellen Sie fünf Fragen:
Führen Sie jede Aufgabe mehr als einmal aus. Agents sind stochastisch. Ein einzelner beeindruckender Durchlauf beweist keine Zuverlässigkeit, und ein einzelner schlechter Durchlauf beweist nicht, dass das System nutzlos ist.
Messen Sie auch den Überprüfungsaufwand. Wenn ein Agent ein großes Artefakt erstellt, dessen Überprüfung länger dauert als die manuelle Durchführung der Aufgabe, hilft er nicht. Ein nützlicher Agent senkt die Kosten für das Erreichen einer fundierten Entscheidung. Er generiert nicht nur mehr Output.
Claude Cowork Mobile und Web ist Teil einer breiteren Verschiebung.
AWS verwandelt Agent-Harnesses in verwaltete Cloud-Infrastruktur. Der GitHub Copilot Cloud Agent unterstützt Hintergrund-Codierung und Pull-Request-Workflows. Claude Code, Codex, Cursor und interne Agents drängen Teams alle in Richtung asynchroner, werkzeugnutzender Arbeit. Forschungsdiskussionen über das Harness-Engineering deuten ebenfalls darauf hin, dass bessere Agent-Systeme von stärkeren Umgebungen, Werkzeugen, Feedbackschleifen und Evaluierungen abhängen werden.
Dies sind verschiedene Produktgeschichten, die jedoch auf dieselbe betriebliche Realität hindeuten: KI-Produkte werden zu Systemen.
Sie benötigen:
Das Zeitalter von "Prompt einfügen, Antwort erhalten" ist nicht vorbei. Aber für ernsthafte Teams ist es nicht länger die Grenze.
Hier ist ein praktischer 30-Tage-Einführungsplan.
Listen Sie jedes Agent-Werkzeug auf, das Ihr Team verwendet.
Erfassen Sie für jedes Werkzeug:
Dies gibt dem Team eine klare Ausgangsbasis.
Teilen Sie Aufgaben in niedriges, mittleres und hohes Risiko ein.
Diese Richtlinie sollte schriftlich festgehalten werden. Wenn eine Aufgabenkategorie unklar ist, behandeln Sie sie als mittleres oder hohes Risiko, bis das Team anders entscheidet.
Wählen Sie etwa 20 reale Aufgaben aus dem Vormonat aus.
Beinhalten Sie:
Führen Sie aktuelle Workflows und mindestens eine alternative Agent-Einrichtung durch. Verfolgen Sie Abschluss, Überprüfungszeit, Kosten, Fehler und Überraschungen.
Fügen Sie hinzu oder verbessern Sie:
nicht verifiziert werden kann, sollte es nicht ohne einen eindeutigen menschlichen Eigentümer delegiert werden.
Der mobile Zugriff sollte auf enge Kontrolle ausgelegt sein, nicht auf weitreichende Berechtigungen.
Ein sicherer mobiler Workflow kann es Benutzern ermöglichen:
Er sollte es Benutzern nicht beiläufig erlauben:
Dies bedeutet nicht, dass mobile Steuerung schlecht ist. Es bedeutet, dass mobile Steuerung auf die Arten von Entscheidungen beschränkt sein sollte, die verantwortungsvoll von einem kleinen Bildschirm aus getroffen werden können.
Die Unterstützung von Claude Cowork für Mobilgeräte und das Web ist wichtig, weil sie zeigt, wohin sich Agentenprodukte entwickeln. KI-Arbeit wird persistent, geräteübergreifend, asynchron und werkzeugnutzend sein.
Teams, die Agenten nur als intelligentere Autovervollständigung behandeln, werden den Wandel verpassen. Teams, die Agenten als voll vertrauenswürdige Mitarbeiter behandeln, schaffen vermeidbare Risiken.
Der sicherere Weg ist kontrollierte Delegation: enge Aufgabenbereiche, explizite Berechtigungen, persistente Protokolle, deterministische Validierung, Modell-Routing und menschliche Überprüfung zu den richtigen Zeitpunkten.
Claude Cowork ist Anthropics agentisches Arbeitsprodukt, das Claude ermöglicht, Aufgaben über Dateien, Tools und Workflows hinweg zu bearbeiten, während der Benutzer das Endergebnis überprüft. Die Unterstützung für Web und Mobilgeräte macht den Workflow persistenter und geräteübergreifend.
Der mobile Zugriff ist wichtig, weil er die Art und Weise verändert, wie Benutzer mit Agenten interagieren. Anstatt in einer einzigen Desktop-Sitzung zu bleiben, kann eine Aufgabe im Hintergrund fortgesetzt werden, während der Benutzer den Fortschritt überprüft, Fragen beantwortet oder den Status von einem anderen Gerät aus einsehen kann.
Ein Agent-Harness ist das System um das Modell herum, das Kontext, Tools, Zustand, Berechtigungen, Validierung, Protokolle und menschliche Überprüfung verwaltet. Es ist das, was eine Modellantwort in kontrollierte Arbeit umwandelt.
Die mobile Genehmigung kann für enge, risikoarme Entscheidungen sicher sein, wie zum Beispiel die Klärung einer Anforderung oder die Überprüfung des Fortschritts. Sie sollte nicht die vollständige Überprüfung bei großen Codeänderungen, Produktionsaktionen, Kundendaten, externen Nachrichten oder destruktiven Operationen ersetzen.
Verwenden Sie reale interne Aufgaben anstelle von Demos. Vergleichen Sie die Abschlussrate, den Überprüfungsaufwand, die Kosten, die Sicherheit, die Komplexität des Zurücksetzens, die Quellnachweise und ob der Agent zu den richtigen Zeitpunkten gestoppt oder umgeleitet werden kann.
Eine gute Vorlage sollte das Ziel, den erlaubten Kontext, die erlaubten Tools, die nicht erlaubten Aktionen, das Validierungskommando, das erwartete Artefakt, die erforderlichen Genehmigungspunkte und die Stopp-Bedingungen enthalten.
Verschiedene Aufgaben haben unterschiedliche Risiko- und Komplexitätsgrade. Einfache Zusammenfassungen benötigen möglicherweise nicht das teuerste Modell, während Architekturänderungen, Fehlersuche, Migrationen und sicherheitssensitive
Aufgaben erfordern möglicherweise leistungsstärkere Modelle und strengere Überprüfungen.
Das Hauptrisiko besteht darin, dass der Agent weiterhin Tools, Kontext oder Berechtigungen nutzt, nachdem der Nutzer aufgehört hat, genau aufzupassen. Deshalb sind eingeschränkter Zugriff, Protokolle, überprüfbare Artefakte und Genehmigungsschwellen unerlässlich.
Die mobile und Web-Unterstützung von Claude Cowork ist mehr als nur eine Aktualisierung der Produktoberfläche. Sie zeigt, dass Agentenarbeit zunehmend persistent, geräteübergreifend, asynchron und werkzeugnutzend wird.
Diese Verschiebung macht das Agenten-Dienstprogramm noch wichtiger. Teams benötigen klarere Aufgabengrenzen, strengere Berechtigungen, dauerhafte Protokolle, Modell-Routing, deterministische Validierung und menschliche Genehmigung an den richtigen Stellen.
Ein guter nächster Schritt ist nicht, jeder neuen Agentenfunktion hinterherzujagen. Es geht darum, einen kleinen internen Benchmark aufzubauen, Risikostufen zu definieren und delegierte Arbeit überprüfbar zu machen.
Der stärkste Agenten-Workflow ist nicht der mit der größten Autonomie. Es ist der mit den klarsten Grenzen, den besten Nachweisen und dem sichersten Überprüfungspfad.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



