For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/claude-distillation-defenses-and-preserve-b64c5fd8.md.
Anthropic erklärt, dass neue Schutzmaßnahmen die Menge an Claude-Reasoning, die von Destillierern auf der eigenen Plattform abgeschöpft wird...
Anthropic erklärt, dass neue Schutzmaßnahmen die Menge an Claude-Reasoning, die von Destillierern auf der eigenen Plattform abgeschöpft wird, um etwa 90–99 % reduziert haben. Das Update vom 12. Oktober beschreibt drei Schutzebenen: Einschränkungen bei der Wiederverwendung geschützten Reasonings, stärkere Klassifikatoren zur Extraktionserkennung und Kontokontrollen, die wiederholte Versuche kostspieliger machen.
Auch für gewöhnliche Entwickler hat dies praktische Folgen. Manche Integrationen müssen die Wiedergabe des Konversationsverlaufs ändern, und einige Anfragen, die blockiert werden, bevor Claude antwortet, sind nun kostenpflichtig. Um diese Kosten zu verstehen, muss zwischen den Ergebnissen des Unternehmens zur Missbrauchsbekämpfung und den API-Regeln unterschieden werden, denen Anwendungen tatsächlich begegnen.
Bei der Destillation wird ein Modell mit den Ausgaben eines anderen Modells trainiert. Sie ist auch eine legitime Technik: Entwickler können ihre eigenen Modelle destillieren oder Daten verwenden, für deren Nutzung sie eine Berechtigung haben. Der Bericht von Anthropic konzentriert sich auf unbefugte Extraktionskampagnen, an denen häufig betrügerische Konten beteiligt sind, statt jede Form der Destillation als Missbrauch einzustufen.
In diesem Kontext sind Endantworten nützliche Trainingsdaten, detailliertes Reasoning kann jedoch noch wertvoller sein. Ein Reasoning-Transkript legt Zwischenschritte, ausprobierte Ansätze und Korrekturen offen, die ein Schülermodell andernfalls selbst ableiten müsste.
Anthropic veranschaulicht den Unterschied mit einem Experiment, bei dem ein vortrainiertes Claude-Modell mit Transkripten von Claude Opus 4.8 trainiert wurde. Die resultierenden SWE-bench-Verified-Werte waren:
| Trainingsmaterial | Berichteter SWE-bench-Verified-Wert |
|---|---|
| Transkripte mit vollständigem Reasoning | 80,4 % |
| Transkripte mit zusammengefasstem Reasoning | 71,8 % |
Das entspricht in diesem Experiment einem Unterschied von 8,6 Prozentpunkten. Es belegt den Wert von Reasoning-Transkripten für dieses Trainingssetup; es begründet keinen universellen Vorteil derselben Größenordnung über Modelle oder Aufgaben hinweg.
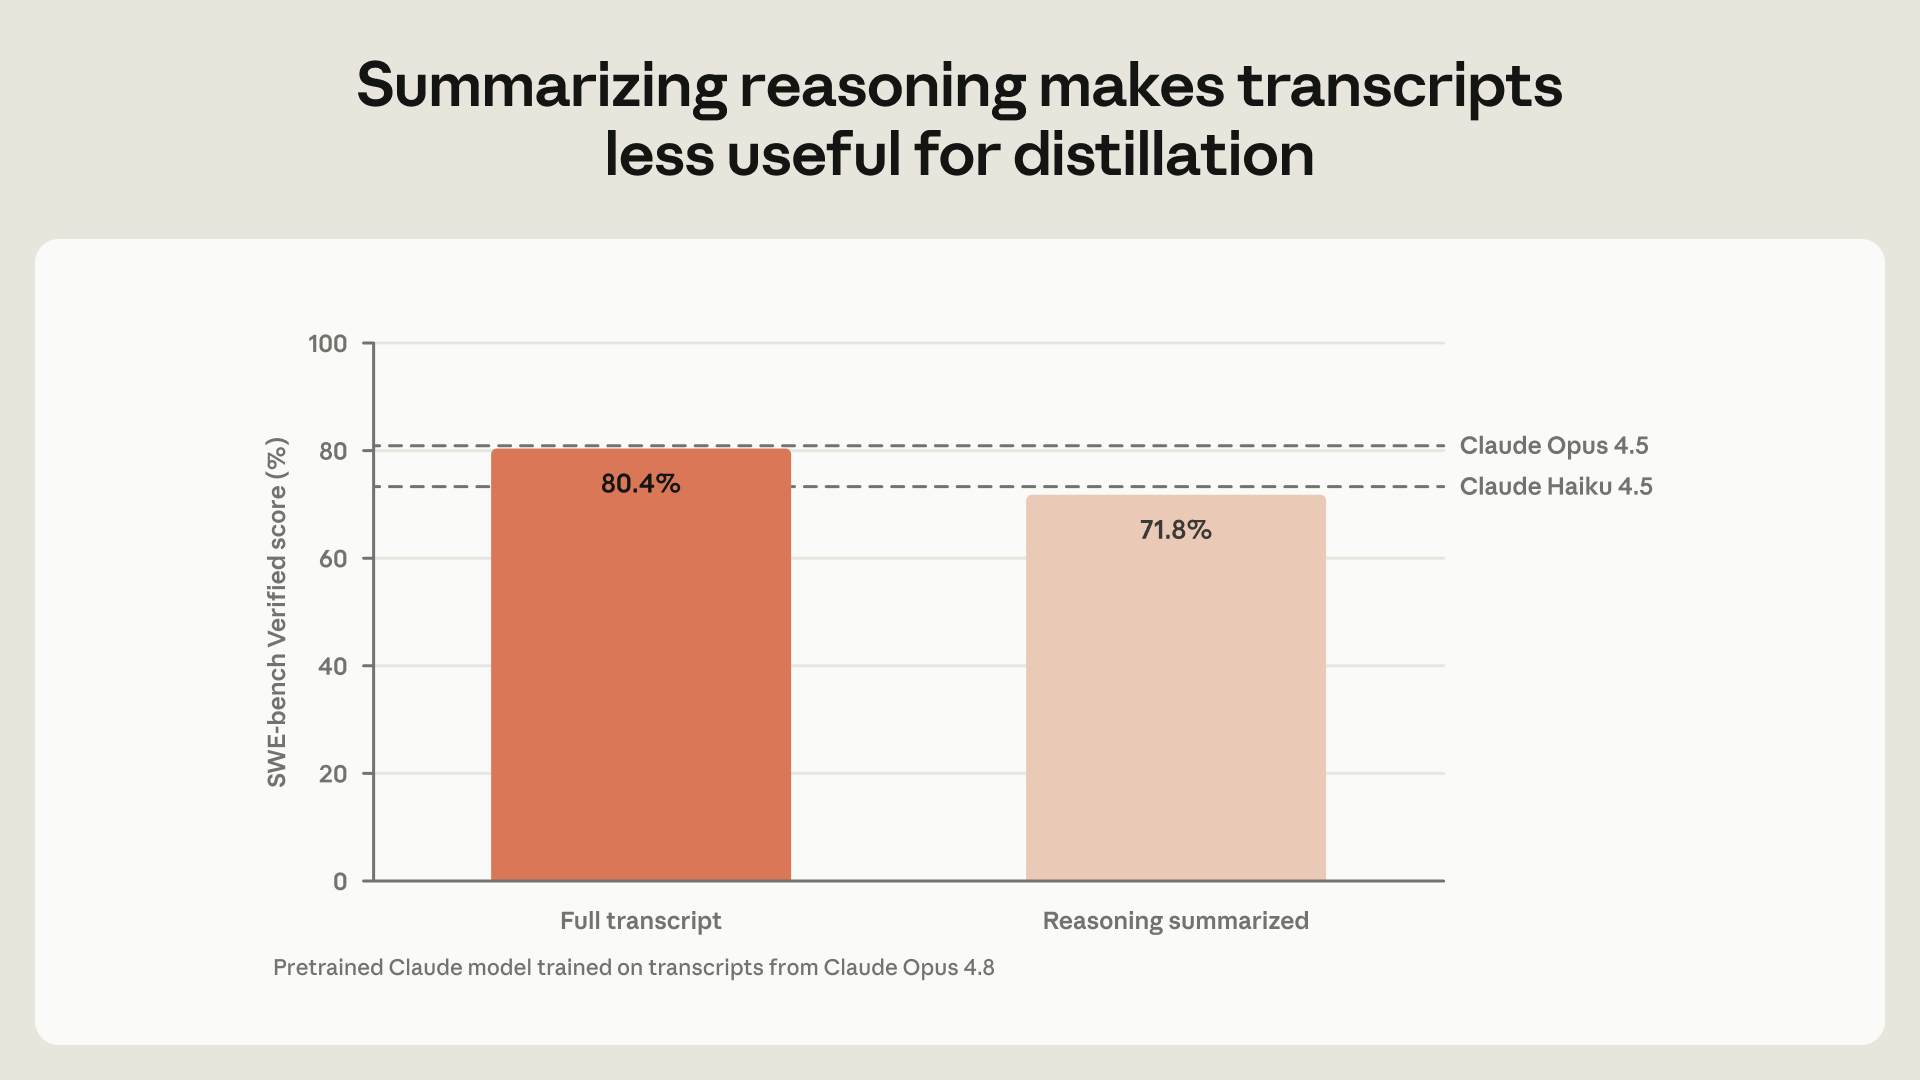
Quelle: Anthropic. Die Balken beschreiben das mit Opus-4.8-Transkripten trainierte Schülermodell, nicht einen direkten Benchmark-Vergleich zwischen den als Referenzlinien dargestellten Produktionsmodellen.
Das Anzeigen von Zusammenfassungen reduziert passive Sammlung, schafft jedoch einen Anreiz, das verborgene Reasoning durch Folgeanfragen hervorzurufen. Anthropic zufolge testete ein Labor 12.000 verschiedene Extraktionsanfragen. Das Unternehmen beschreibt außerdem Proxy-Netzwerke, die Aktivitäten auf eine große Anzahl von Konten verteilen, darunter ein bereits zuvor gemeldetes Netzwerk, das gleichzeitig mehr als 20.000 betrügerische Konten verwaltete.
Bei langen Aufgaben muss ein Modell möglicherweise an Reasoning anknüpfen, das in einem früheren Turn erzeugt wurde. Die API kann geschützte Thinking-Blöcke zu diesem Zweck erhalten, ohne das zugrunde liegende Reasoning als normalen, für Nutzer lesbaren Text offenzulegen.
Dadurch entsteht ein Zugriffssteuerungsproblem. Anthropic zufolge haben Angreifer versucht, Reasoning zwischen Konversationen, Modellen oder Konten zu verschieben, um einen Kontext zu finden, in dem es offengelegt werden kann. Der Schutz des Blocks erfordert daher nicht nur die Kontrolle seiner Anzeige, sondern auch seiner Wiederverwendung.
Anthropic führte erhaltenes Thinking mit Claude Fable 5.1 und Claude Opus 5.5 ein. Die aktuelle Dokumentation beschreibt zwei zentrale Prüfungen:
Die Präfixprüfung wird standardmäßig für Konten durchgesetzt, die am oder nach dem 31. August 2026 um 00:00 UTC erstellt wurden. Ältere Konten können die Durchsetzung über dokumentierte Einstellungen aktivieren. Die Prüfung der Modellkompatibilität gilt für jedes Konto.
Die Forschungsankündigung beschreibt außerdem Organisationsbeschränkungen für Sonnet-5.5-Reasoning. Die aktuelle API-Dokumentation nennt die spezifischere Regel: Thinking-Blöcke von Sonnet 5.5 und Haiku 5.5 funktionieren nur in dem Konto, das sie erzeugt hat, oder in einem verknüpften Konto, sofern die dokumentierte Durchsetzung greift. Entwickler sollten diese Kompatibilitätsdokumentation verwenden, wenn sie Routing- oder Kontoänderungen implementieren.
Übliches Anwendungsverhalten kann ein geschütztes Präfix verändern: das erneute Erstellen eines System-Prompts mit einem neuen Zeitstempel, das Bearbeiten alter Tool-Ausgaben, das Ändern von Tool-Beschreibungen oder das Zusammenfassen früherer Turns bei gleichzeitiger Beibehaltung späterer Thinking-Blöcke.
Standardmäßig kann ein ungültiges Präfix zu einem 400 invalid_request_error führen. Die dokumentierten Beta-Einstellungen erlauben außerdem, thinking.block_binding.prefix_mismatch_behavior auf drop_block zu setzen. Dann werden ungültige Thinking-Blöcke und nachfolgende Thinking-Blöcke für diese Anfrage verworfen. Die Anfrage wird dadurch weiter ausgeführt, aber die Veränderung des Verlaufs wird nicht repariert.
Halten Sie erneut wiedergegebene Verläufe stabil und fügen Sie neue Informationen über unterstützte Muster an. Es ist keine sichere Annahme mehr, den sichtbaren Text einer Konversation zu ändern und gleichzeitig weiterhin sämtliches altes geschütztes Reasoning wiederzuverwenden.
Die zweite Schutzebene von Anthropic nutzt ein zweistufiges Klassifikatorsystem, das von der Forschung zu Constitutional Classifiers informiert ist. Das Unternehmen testet Extraktionsversuche mit internen und externen Red Teams und aktualisiert die Schutzmaßnahmen, wenn eine Technik erfolgreich ist.
Das Unternehmen erklärt, die daraus resultierenden Schutzmaßnahmen gegen Destillation hätten in seiner Bewertung eine Falschpositivrate von unter 0,1 %. Es vergleicht ihre Robustheit mit seinen Schutzmaßnahmen gegen Unterstützung bei biologischen Waffen. Dies ist eine Unternehmensbewertung unter den eigenen Testbedingungen und keine Garantie, dass die legitime Anfrage eines bestimmten Nutzers niemals abgelehnt wird.
Das System verändert sich zudem im Laufe der Zeit. Anthropic beschreibt, wie Techniken gepatcht wurden, die geschütztes Reasoning durch Übersetzung oder speziell formatierte Ausgaben offenlegen sollten. Die veröffentlichte Aussage lautet, dass der Klassifikator die in seinem Septemberbericht beschriebenen Extraktionstechniken bei den vom System abgedeckten Modellen erkennt.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die dritte Ebene greift bei wiederholtem Verhalten. Konten, die fortgesetzt Extraktion versuchen, können strengere Nutzungslimits erhalten, und verknüpfte Konten können gesperrt werden. Anthropic berichtet, Zehntausende Konten gesperrt zu haben, teils innerhalb von zwei Stunden nach Beginn einer Kampagne.
Ab dem 24. September nahm Anthropic außerdem die Abrechnung für Anfragen wieder auf, die vor einer Modellantwort in ausgewählten Schutzkategorien mit berichteten Falschpositivraten unter 0,1 % blockiert wurden, einschließlich Destillation. Die Quelle nennt außerdem die Kategorien biologischer Missbrauch und Entwicklung von Frontier-Modellen. Diese Richtlinie sollte nicht auf jede abgelehnte Anfrage oder jede Art von Sicherheitsfilter verallgemeinert werden.
Anthropic schätzt, dass die extrahierten Reasoning-Tokens auf der eigenen Plattform nach Einführung des Klassifikators zusammen mit den Änderungen an erhaltenem Thinking um den Faktor 10–100 zurückgingen. An manchen Tagen gab es zu wenige extrahierte Tokens, damit das Unternehmen messen konnte.
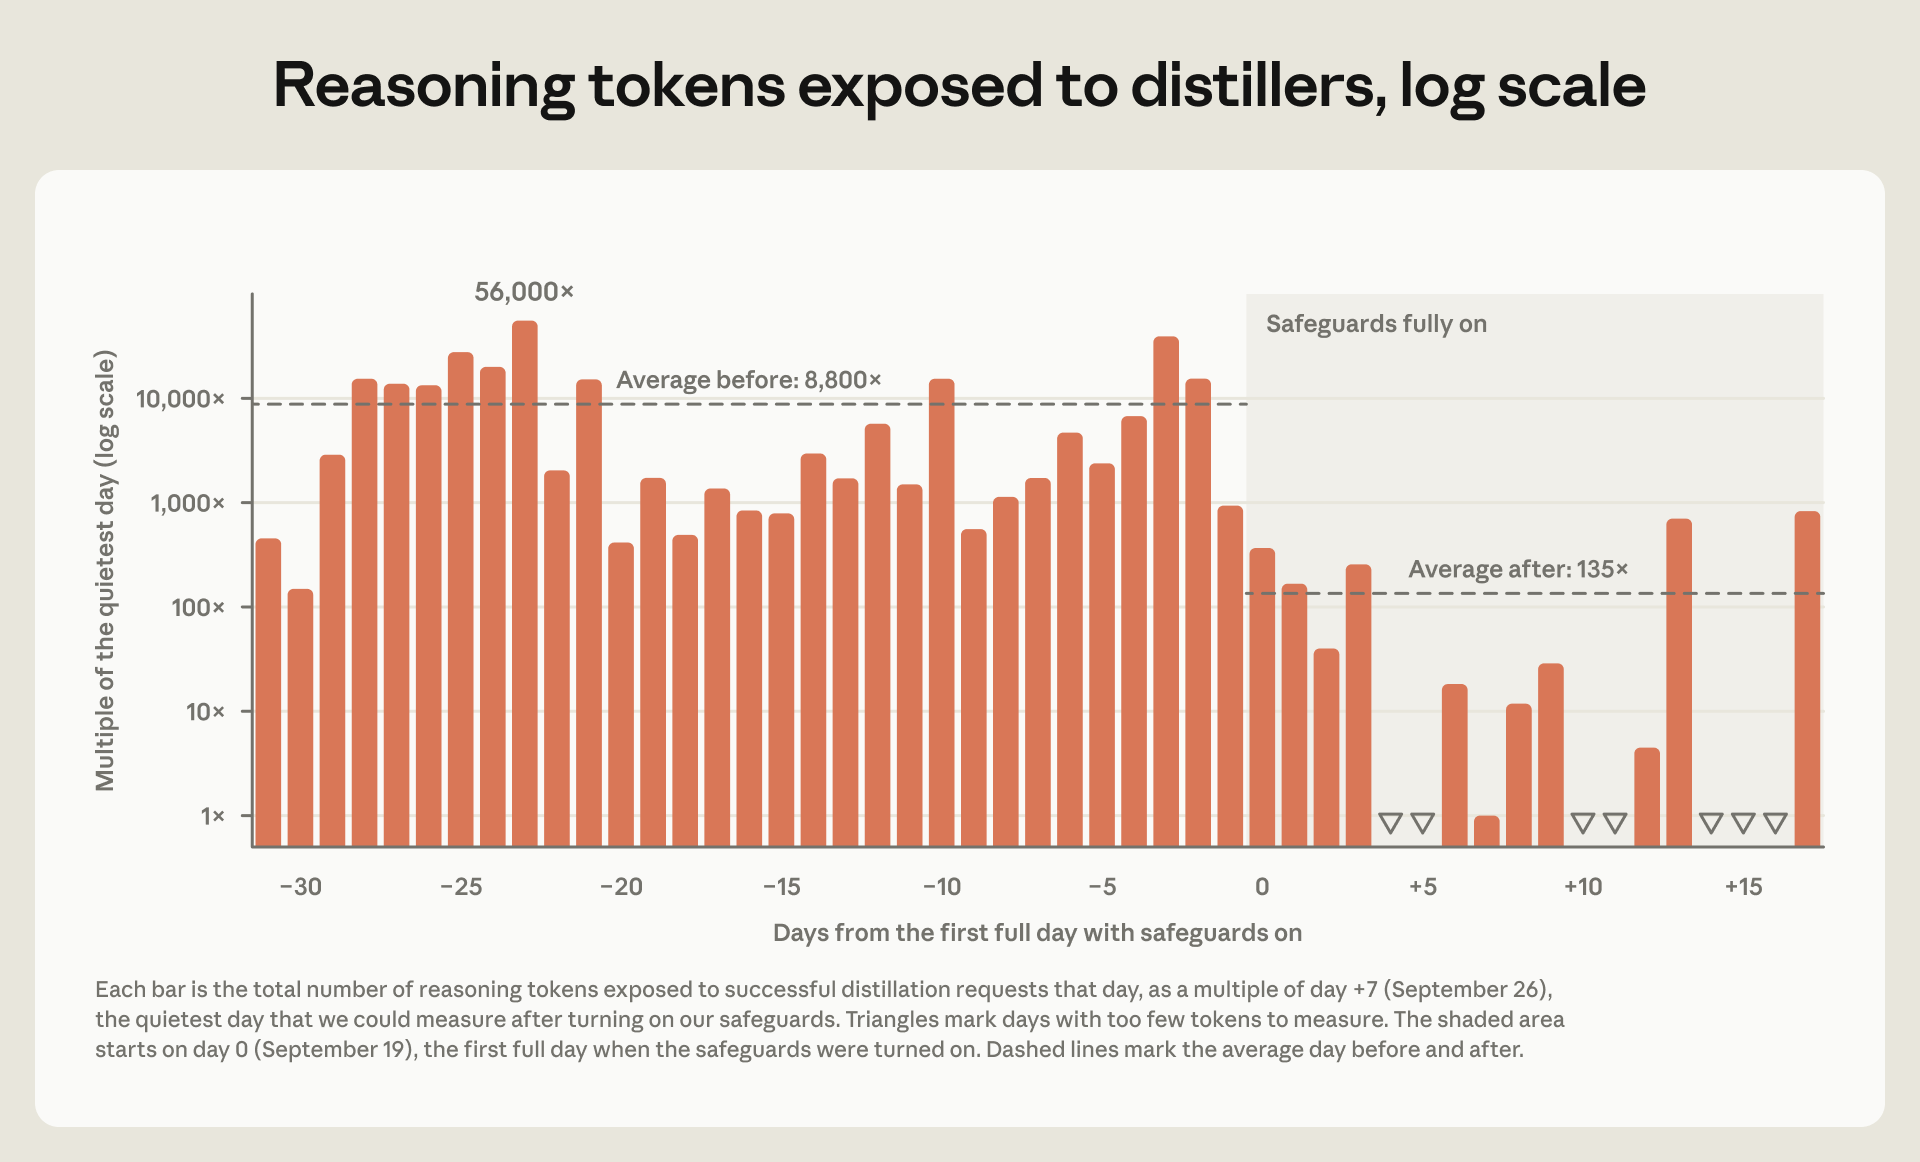
Quelle: Anthropic. Die vertikale Achse ist logarithmisch und auf einen Tag mit geringer Extraktion normiert, nicht auf eine absolute Tokenanzahl. Nach unten gerichtete Dreiecke kennzeichnen Tage mit zu wenigen Tokens für eine Messung.
Der Umfang ist wichtig. Diese Zahlen beschreiben die Schätzung von Anthropic für die eigene Plattform; sie sind keine Messung sämtlicher Destillationsaktivitäten über externe Inference-Anbieter hinweg. Das Unternehmen erklärt außerdem, es habe noch keinen hochentwickelten, anhaltenden Versuch beobachtet, die vollständig implementierten Schutzmaßnahmen zu überwinden, und wisse nicht, wie lange die Gewinne anhalten werden.
Anthropic räumt ein, dass die Änderungen für gewöhnliche Nutzer nicht vollständig transparent waren. Integrationen müssen möglicherweise aktualisiert werden, gutartige Anfragen können falsch klassifiziert werden, und diese irrtümlichen Blockierungen können nun in den betroffenen Kategorien Kosten verursachen.
Der Verlust wiederverwendbaren Thinkings hat noch weitere Kosten: Das Modell muss möglicherweise Arbeit rekonstruieren. In einem in der API-Dokumentation beschriebenen Multi-Turn-Coding-Benchmark erhöhte das einmalige Verwerfen von Thinking pro Sitzung die Ausgabe-Tokens bei maximalem Aufwand um 20,1 %. Dies ist eine auf einen bestimmten Workload bezogene Schätzung mit breiten Fehlerspannen, kein Standardaufschlag und keine Vorhersage für jede Anwendung.
Für Entwickler ist die Unterscheidung zwischen einem nicht lesbaren oder verworfenen Eingabeblock und neu erzeugter Ausgabe hilfreich. Der verworfene Block selbst wird nicht abgerechnet, während die Rekonstruktion des Reasonings zusätzliche Ausgabe-Tokens erzeugen kann. Das Überwachen von Präfixabweichungen und das Testen der eigenen Anwendungs-Workloads ist aussagekräftiger als anzunehmen, dass ein erfolgreicher Wiederholungsversuch kostenfrei bleibt.
Nach der Definition von Anthropic handelt es sich um eine unbefugte Kampagne zur Sammlung von Claude-Ausgaben oder geschütztem Reasoning, um ein anderes Modell zu trainieren. Destillation selbst ist eine übliche Technik des maschinellen Lernens und kann legitim sein, wenn der Entwickler über die erforderlichen Rechte und Berechtigungen verfügt.
Nein. Anthropic berichtet nach Bereitstellung der Schutzmaßnahmen von einer geschätzten Reduzierung des abgeschöpften Reasonings auf der eigenen Plattform um 90–99 %. Diese Zahl deckt nicht jeden Anbieter, jeden Angriff oder jede künftige Extraktionsmethode ab.
Nein, sofern die Anwendung die dokumentierten Regeln für das Wiedergeben von Thinking und das Erhalten des Konversationspräfixes befolgt. Probleme entstehen, wenn sich der frühere Kontext ändert, während die Anwendung weiterhin Thinking-Blöcke sendet, die an den ursprünglichen Kontext gebunden sind.
Nur wenn die dokumentierten Regeln zur Modellkompatibilität dies erlauben. Ein Modell, das einen Block nicht lesen kann, läuft ohne diesen Block. Ein Wechsel zu einem günstigeren Modell erhält daher nicht zwangsläufig das Reasoning des vorherigen Modells.
Ja. Anthropic erklärt, dass ausgewählte Schutzkategorien am 24. September wieder kostenpflichtig wurden, selbst wenn die Anfrage blockiert wird, bevor Claude antwortet. Der Bericht räumt ausdrücklich ein, dass ein Falschpositiv in diesen Kategorien einen legitimen Kunden betreffen kann.
Nein. Dies war die berichtete Erhöhung für das einmalige Verwerfen von Thinking pro Sitzung bei maximalem Aufwand in einem bestimmten Multi-Turn-Coding-Test. Die Auswirkung hängt vom Aufwand, dem Konversationsverlauf, der Aufgabe und davon ab, wie häufig die Integration Blöcke verwirft.
Die neuen Schutzmaßnahmen von Anthropic kombinieren Einschränkungen für geschütztes Reasoning, Extraktionsklassifikatoren und Durchsetzungsmaßnahmen gegen wiederholten Missbrauch. Das Unternehmen berichtet über einen deutlichen Rückgang des abgeschöpften Reasonings auf der eigenen Plattform, räumt jedoch ein, dass Angreifer ihre Methoden anpassen könnten.
Für Claude-API-Entwickler besteht die unmittelbare Aufgabe darin, einen gültigen Konversationsverlauf beizubehalten und die Kosten blockierter Anfragen oder verworfenen Thinkings zu verstehen. Die berichteten Sicherheitsgewinne sind erheblich, doch stabile Integrationen und Workload-spezifische Tests bleiben wichtig.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



