For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/claude-model-routing-rumors-and-code-gene-14c8ef5f.md.
Eine Sammlung aufwendiger Coding-Demos hat Spekulationen ausgelöst, dass einige Claude-Nutzer auf ein neueres Modell zugreifen könnten als d...
Eine Sammlung aufwendiger Coding-Demos hat Spekulationen ausgelöst, dass einige Claude-Nutzer auf ein neueres Modell zugreifen könnten als das in ihrer Oberfläche angezeigte. Zu den Beispielen gehören animierte Szenen, synchronisierter Ton und eine musikalische Präsentation rund um Hamilton.
Die Ergebnisse sind interessant, doch zwei Fragen müssen getrennt beantwortet werden: Was haben die Ersteller tatsächlich gebaut, und welches Modell hat es erzeugt? Die berichteten Projekte liefern Beispiele für kreative Software-Workflows. Sie belegen jedoch für sich genommen nicht, dass Anthropic das Modell, das diese Anfragen verarbeitet, stillschweigend geändert hat.
Laut QbitAI glaubten einige Nutzer, dass Anfragen, die bei hohem Aufwand als Opus 5.5 gekennzeichnet waren, an ein unveröffentlichtes Fable 5.5 oder Opus 5.6 weitergeleitet würden. Ihre Belege bestanden vor allem aus einer wahrgenommenen Verbesserung kreativer Ergebnisse sowie aus informellen Prompts, die das antwortende Modell identifizieren sollten.
Keine der beiden Methoden ist schlüssig. Ein Modell kann bei einer bestimmten Aufgabe außergewöhnlich starke Ergebnisse liefern, und eine Selbstbeschreibung ist generierter Text statt eines authentifizierten Nachweises der Routing-Entscheidung des Servers. Eine Identitätsfrage ohne Browsing oder Konversationsspeicher zu stellen, macht die Antwort nicht zu einer zuverlässigen Kennung des verwendeten Checkpoints.
Die geprüfte offizielle Ankündigung bestätigt Opus 5.5 als veröffentlichtes Produkt. Sie bestätigt jedoch nicht die im Bericht beschriebene konkrete Behauptung über verborgenes Routing. Damit bleibt die Erklärung eines Modell-Upgrades eine Hypothese und keine Tatsache, die aus einer hochwertigen Animation abgeleitet werden kann.
Das musikalische Beispiel lässt sich besonders leicht missverstehen, als hätte ein einzelnes Modell ein vollständiges audiovisuelles Werk in einem Durchgang generiert. Die von QbitAI zitierte Beschreibung des Erstellers nennt jedoch eine konkretere Kombination: Suno für Musik, ElevenLabs für Stimmen und ein synchronisiertes Three.js-Musikvideo.
Diese Nennungen sind wichtig. Three.js ist eine JavaScript-3D-Bibliothek; sie kann eine Szene rendern, deren Bewegung, Beleuchtung und Kameraverhalten im Code beschrieben sind. Suno und ElevenLabs liefern unterschiedliche Audiofunktionen. Ein fertiges Video kann diese Ergebnisse zusammenführen, ohne dass das Coding-Modell jedes zugrunde liegende Asset selbst erzeugt.
Die Quelle spekuliert über die Nutzung von Tools, belegt jedoch nicht die genaue Abfolge von Aufrufen, Bearbeitungsschritten oder Integrationen. Sie veröffentlicht auch keinen vollständigen Prompt-Verlauf, keine Generierungszeit und keine Kostenaufstellung für das musikalische Projekt. Folglich sollte die Demo nicht als verifizierte Claude-Produktion mit einem Prompt und geringen Kosten beschrieben werden.
Dennoch wird eine nützliche Fähigkeit sichtbar: Code kann Szenenwechsel, Bewegungen und Audio-Timing zu einer fertigen Präsentation koordinieren. Die Bewertung dieses Workflows erfordert das Projekt und seine Abhängigkeiten, nicht nur den exportierten Clip.
Der Bericht beschreibt außerdem ein Papierboot mit unterschiedlicher Beleuchtung und verschiedenen Kameraabständen sowie Sonnenuntergangs-, Ozean- und Weltraumszenen. Der Ersteller schrieb diese Visualisierungen und ihr Animations- und Audioverhalten JavaScript zu; in den Beispielen seien keine externen Web-Assets verwendet worden.
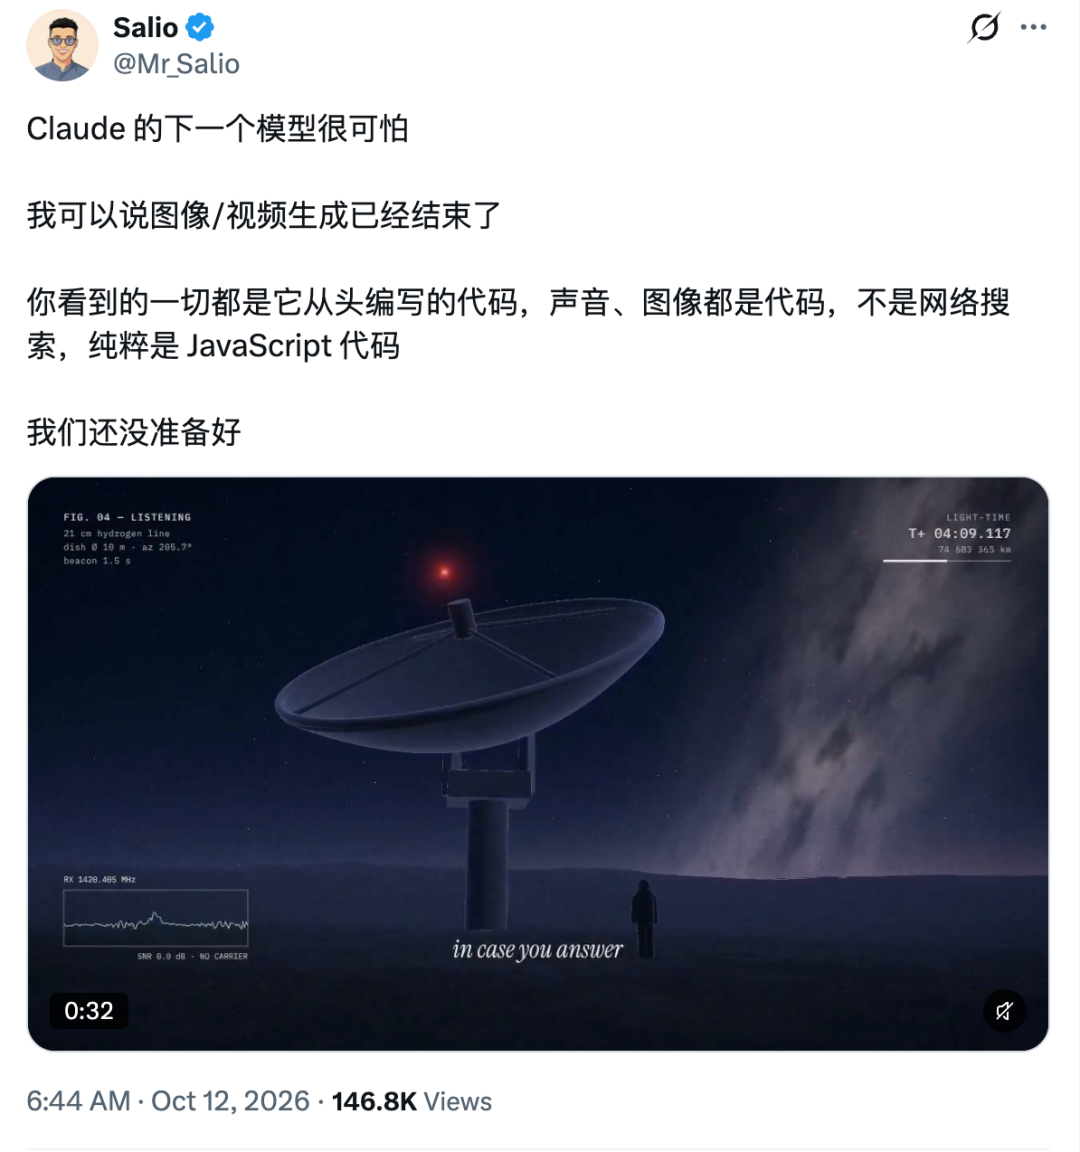
Quelle: Screenshot des Erstellers, von QbitAI auf BAAI Hub reproduziert. Die Modellbehauptung des Beitrags ist keine offizielle Bestätigung.
Hier beschreibt „codegeneriert“, wie die Präsentation konstruiert wird. Ein Renderer führt Anweisungen für Geometrie, Materialien, Beleuchtung und Bewegung aus; die resultierenden Frames können als Video aufgezeichnet werden. Audio kann je nach Projekt programmatisch synthetisiert oder als Asset eingebunden werden.
Das ist ein anderer Produktionsweg als ein Videomodell direkt um die Synthese einer Sequenz zu bitten. Er kann Kamerapfade und wiederholte Bewegungen leichter steuerbar machen, reproduziert jedoch nicht automatisch jeden visuellen Effekt oder jede Szene, die ein Videomodell erzeugen kann. Die verfügbaren Beispiele belegen nicht, dass einer der beiden Ansätze den anderen ersetzt.
Die Quelle enthält keinen Code, mit dem die berichteten assetfreien Implementierungen geprüft werden könnten. Die Behauptung bleibt daher die Darstellung des Erstellers zu diesen konkreten Demos und kein allgemeines Versprechen darüber, was jede Claude-Animation verwendet.
Ein weiteres Beispiel im Bericht ist eine etwa 30-sekündige Animation über das Leben. Ihr Ersteller beschrieb Berichten zufolge zwei kurze Prompts, etwa zwei Stunden Arbeit und 27 Millionen Tokens bei maximalem Aufwand.
Diese Angaben wurden nicht unabhängig anhand von Logs verifiziert. Selbst wenn man sie als berichtete Werte akzeptiert, zeigen sie, warum eine geringe Zahl an Nutzer-Prompts nicht mit einem geringen Rechenaufwand verwechselt werden sollte. Ein Coding-Workflow kann zwischen zwei kurzen Nutzernachrichten umfangreiche Generierung und Überarbeitung ausführen.
| Berichtetes Detail | Was sich vernünftigerweise daraus schließen lässt |
|---|---|
| Zwei kurze Prompts | Der Ersteller beschreibt wenig Nutzereingabe; dies legt nicht die gesamte Zwischenarbeit offen. |
| Etwa zwei Stunden | Die berichtete verstrichene Zeit ist erheblich und kein unmittelbares Ergebnis. |
| 27 Millionen Tokens | Eine vom Ersteller berichtete Nutzungssumme ohne verifizierte Aufschlüsselung nach Eingabe, Ausgabe oder Caching. |
| Maximaler Aufwand | Eine berichtete Einstellung, kein Nachweis einer anderen Modellidentität. |
Eine Dollar-Schätzung würde weitere Informationen erfordern: Modellidentität, Abrechnungsweg, Token-Kategorien, Cache-Behandlung und ob die genannte Summe mehrere Versuche einschließt. Einen einzelnen Token-Preis auf die gesamte Zahl anzuwenden, würde eine irreführende Kostenzahl erzeugen.
Für die musikalische Demo und mehrere andere Beispiele sind diese Details schlicht nicht offengelegt. Die nützliche Schlussfolgerung lautet, dass das Ergebnis eine Prüfung verdient, während seine Effizienz eine offene Frage bleibt.
QbitAI erörtert außerdem einen Lumina-Vergleich zwischen gewöhnlichen Opus-Ergebnissen und Ergebnissen, die der mutmaßlichen Routing-Änderung zugeschrieben werden. Laut Bericht wurden mehrere Durchläufe durchgeführt und ausgewählte Ergebnisse verglichen, wobei Letztere als geringfügig besser wahrgenommen wurden.
Die Auswahl eines besten Ergebnisses verändert die gemessene Fragestellung. Sie kann zeigen, was ein Workflow gelegentlich erzeugt, aber weder seine durchschnittliche Zuverlässigkeit noch das verantwortliche Modell belegen. Unterschiedliche Prompts, Kontexte, Tools, Aufwandseinstellungen und Auswahlkriterien können das Ergebnis beeinflussen.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Ein nützlicherer Vergleich würde dieselbe Aufgabe, Umgebung und dieselben Bewertungsregeln beibehalten, jeden Versuch berichten und dokumentieren, welche Artefakte menschliche Korrekturen erforderten. Falls verfügbar, sind offizielle Metadaten von API-Antworten und Dokumentationen des Anbieters stärkere Belege für das angeforderte Modell als die Antwort eines Modells auf eine Identitätsfrage. Selbst dann benötigen Behauptungen über internes Routing Belege des Anbieters.
Anthropics Ankündigung zu Opus 5.5 vom 22. September beschreibt Verbesserungen beim Coding und bei anderen Aufgaben. Sie enthält auch ein Spielebeispiel, das den visuellen Feinschliff aus einem einzelnen Prompt veranschaulichen soll. Kreatives Coding ist somit bereits Teil der öffentlichen Positionierung des veröffentlichten Modells.
Die Ankündigung enthält ein separates internes Beispiel einer C-zu-Rust-Überarbeitung von HAProxy. Anthropic berichtet, dass Opus 5.5 dafür 9,5 Stunden benötigte, gegenüber 12 Stunden für Fable 5.1, bei 51 % geringeren Kosten; beide hätten nahezu alle ursprünglichen Regressionstests bestanden.
Dabei handelt es sich um dem Unternehmen zugeschriebene Ergebnisse für eine konkrete Aufgabe. Sie belegen nicht, dass jeder kreative Workflow günstiger, schneller oder zuverlässiger sein wird. Ebenso authentifizieren sie nicht das Modell hinter einer Animation in sozialen Medien.
Die Unterscheidung ist praktisch: Offizielle Veröffentlichungsbelege stützen Aussagen über ein angekündigtes Modell, während die Demo eines Erstellers Aussagen über das demonstrierte Artefakt stützt. Um beides zu verknüpfen, reicht der Eindruck, dass ein Ergebnis ungewöhnlich gut aussieht, nicht aus.
Für ein Projekt, das wiederverwendet werden soll, sind die aussagekräftigsten Belege oft unkompliziert:
Dadurch wird die Arbeit überprüfbar, selbst wenn eine Frage zum internen Modell-Routing unbeantwortet bleibt. Ein zuverlässiges Projekt, das eine andere Person ausführen kann, ist unabhängig davon nützlich, ob ein verborgenes Upgrade stattgefunden hat.
Die geprüften offiziellen Materialien bestätigen nicht die von QbitAI beschriebene konkrete Routing-Behauptung zu Fable 5.5 oder Opus 5.6. Starke Ergebnisse und die Selbstbeschreibung eines Modells reichen nicht aus, um festzustellen, welcher interne Checkpoint eine Anfrage verarbeitet hat.
Die von QbitAI berichtete Beschreibung des Erstellers nennt Suno für Musik, ElevenLabs für Stimmen und Three.js für das synchronisierte Video. Der vollständige Workflow und Prompt-Verlauf wurden nicht offengelegt; die Demo sollte daher nicht als verifizierte audiovisuelle Generierung durch ein einzelnes Modell dargestellt werden.
Codegenerierte Animation verwendet ein Programm zur Steuerung eines Renderers, von Szenenobjekten, Beleuchtung und Bewegung. Ein Videogenerierungsmodell synthetisiert Frames über seinen erlernten Generierungsprozess; ein fertiges Projekt kann auch beide Ansätze kombinieren.
Eine generierte Antwort ist kein authentifizierter Nachweis der Infrastruktur des Anbieters. Nutzen Sie offizielle Modelldokumentationen und verfügbare Antwortmetadaten für das angeforderte Modell, und behandeln Sie Behauptungen über nicht offengelegtes Routing ohne Belege des Anbieters als unbestätigt.
Diese Zahl stammt aus der im Bericht zitierten Darstellung eines Erstellers und wurde hier nicht unabhängig verifiziert. Ohne Token-Kategorien, Modell- und Abrechnungsdetails kann sie keine verlässliche Dollar-Kostenberechnung stützen.
Bitten Sie um den Quellcode, Abhängigkeiten, die Asset-Liste und vollständige Prompts einschließlich Überarbeitungen. Das ausgewählte Modell und die Aufwandseinstellung, Ausführungszeit, Anzahl der Versuche und Nutzungsaufschlüsselung helfen zu beurteilen, ob sich das Ergebnis praktisch wiederholen lässt.
Die berichteten Demos zeigen kreative Coding-Projekte, die Szenen-Rendering, Bewegung und Audio kombinieren. Das musikalische Beispiel umfasst ausdrücklich mehrere Tools, während bei den anderen Beispielen wichtige Details zu Reproduzierbarkeit und Kosten nicht offengelegt werden.
Eine überzeugende Demo belegt ein Ergebnis; die Bestätigung eines verborgenen Modell-Upgrades erfordert separate Belege.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.
