Ein neues Claude-Opus-5-Prompt-Muster verbreitet sich rasant in der KI-Programmier-Community, mit dem Entwickler aus kurzen Beschreibungen ü...
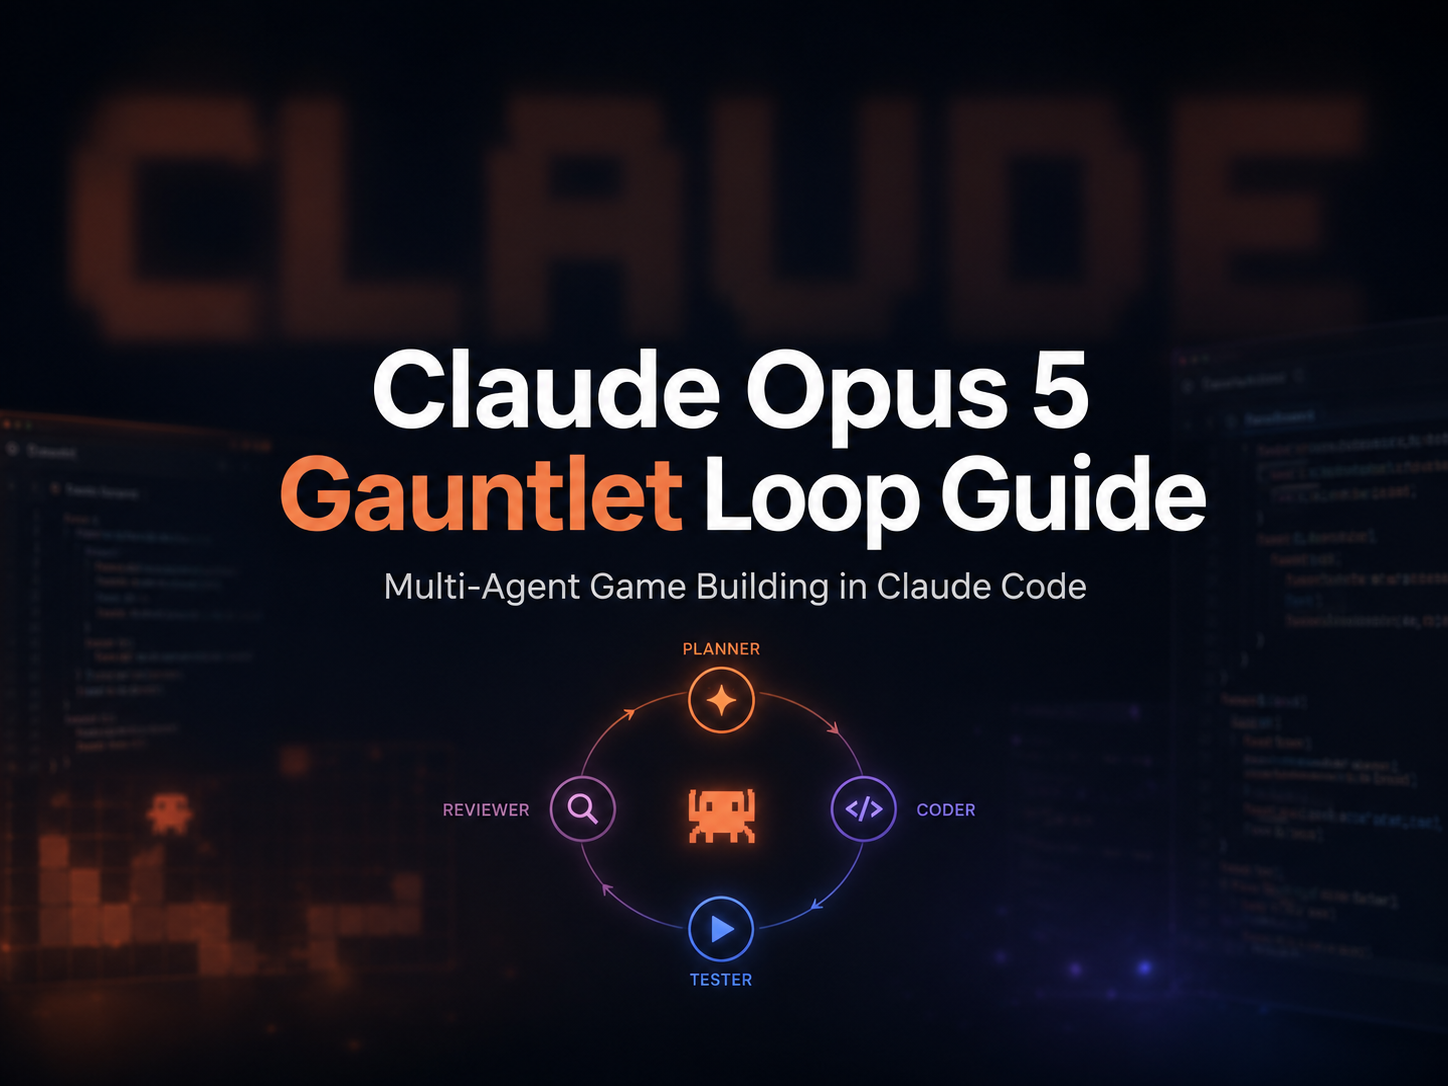
Ein neues Prompt-Muster für Claude Opus 5 verbreitet sich rasant in der KI-Programmiergemeinschaft, da Entwickler damit überraschend hochwertige Browser-Spielprototypen aus kurzen anfänglichen Anweisungen erschaffen.
Diese Methode wird inzwischen als „Gauntlet Loop“ (Überlebensschleife) bezeichnet.
Die Kernidee ist einfach: Lasse nicht denselben Agenten einmal bauen, seine eigene Arbeit bewerten und dann aufhören. Gib dem Leitagenten ein übergeordnetes Ziel, lasse ihn das Projekt in kleinere Teile zerlegen, weise spezialisierte Builder zu und verwende unabhängige Review-Agenten, die die tatsächliche Ausgabe mit konkreten Qualitätsmaßstäben vergleichen.
Wenn das erzeugte Ergebnis den Vergleich nicht besteht, geht es in eine weitere Iterationsrunde.
Matt Shumer popularisierte diese Methode, nachdem er mit Claude Code und Opus 5 einen von modernen Call-of-Duty-Spielen inspirierten Browser-Ego-Shooter erstellt hatte. Anschließend veröffentlichte er den Prompt, den Quellcode sowie eine Beschreibung des Workflows.
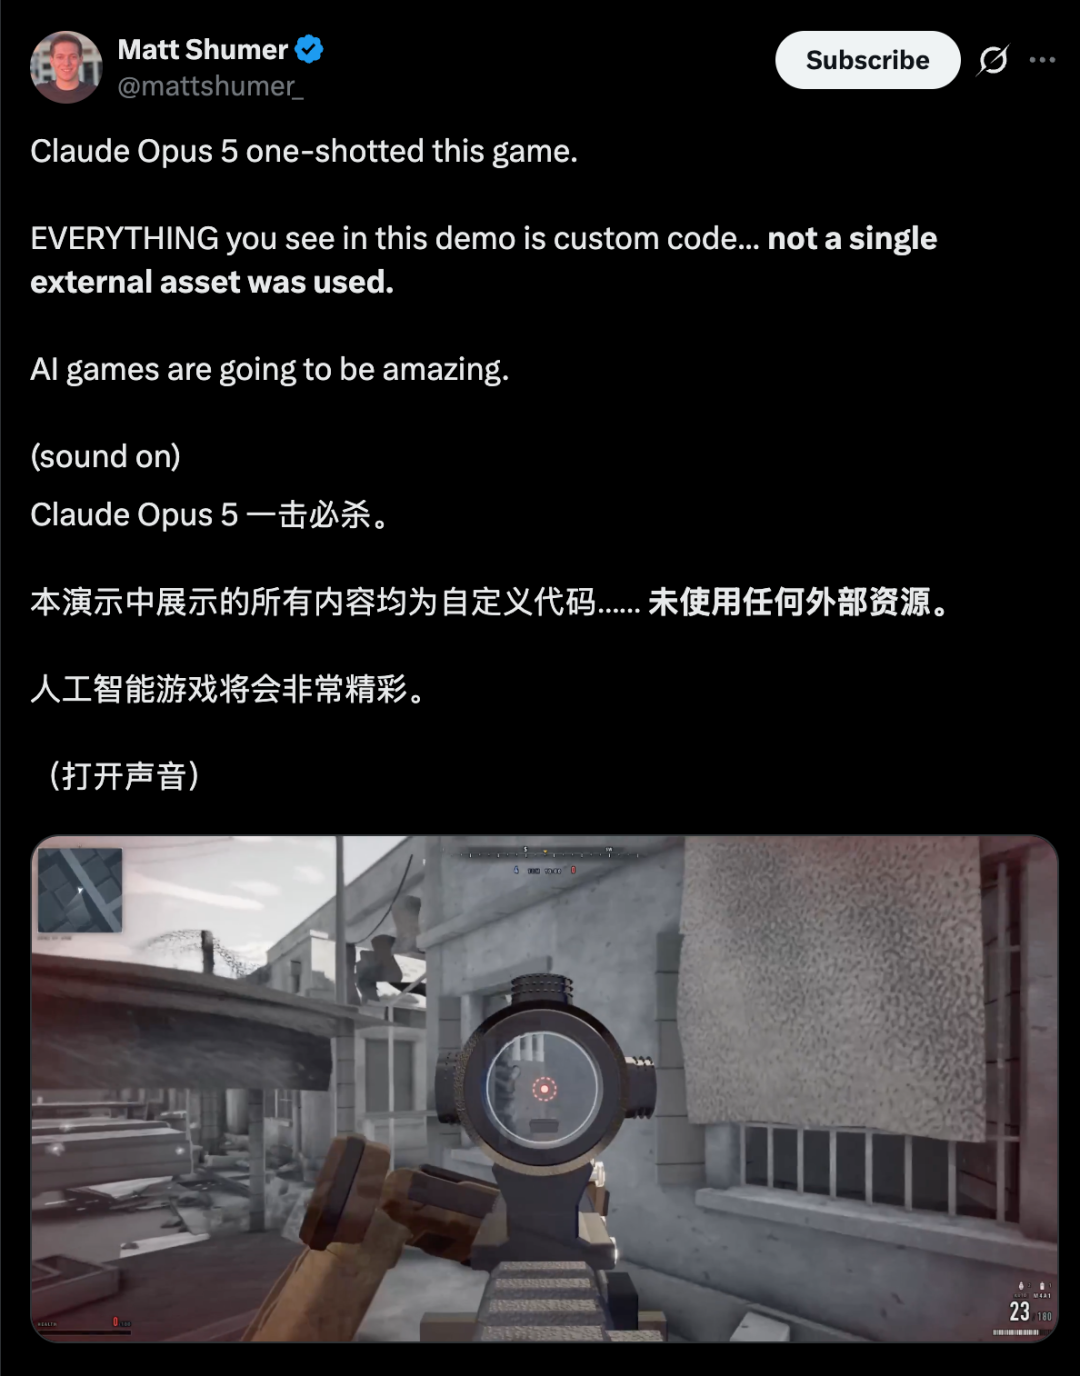
Ein anderer Entwickler, Anshu Chimala, verwendete einen ähnlichen Workflow, um „The Long Silence“ zu entwickeln – ein prozedurales Weltraum-Erkundungsspiel, das im Browser läuft.
Diese Projekte sollten präzise beschrieben werden. Sie zeigen nicht, dass ein einziger Prompt sofort ein kommerzielles AAA-Spiel produzieren kann. Sie zeigen, dass ein leistungsfähiges Coding-Agenten-System, ausgestattet mit Werkzeugen, Sub-Agenten, langer Ausführungszeit, messbaren Qualitätsschwellen und wiederholter Verifikation, Prototypen weit über das hinausbringen kann, was herkömmliche Einmal-Prompts erreichen.
Shumers ursprüngliche Aufgabe setzte ein bewusst extremes Ziel: einen Ego-Shooter zu bauen, dessen visuelle Ambitionen mit modernen AAA-Titeln vergleichbar sind.
Der entscheidende Teil lag nicht im Spielgenre, sondern in der Bewertungsstruktur.
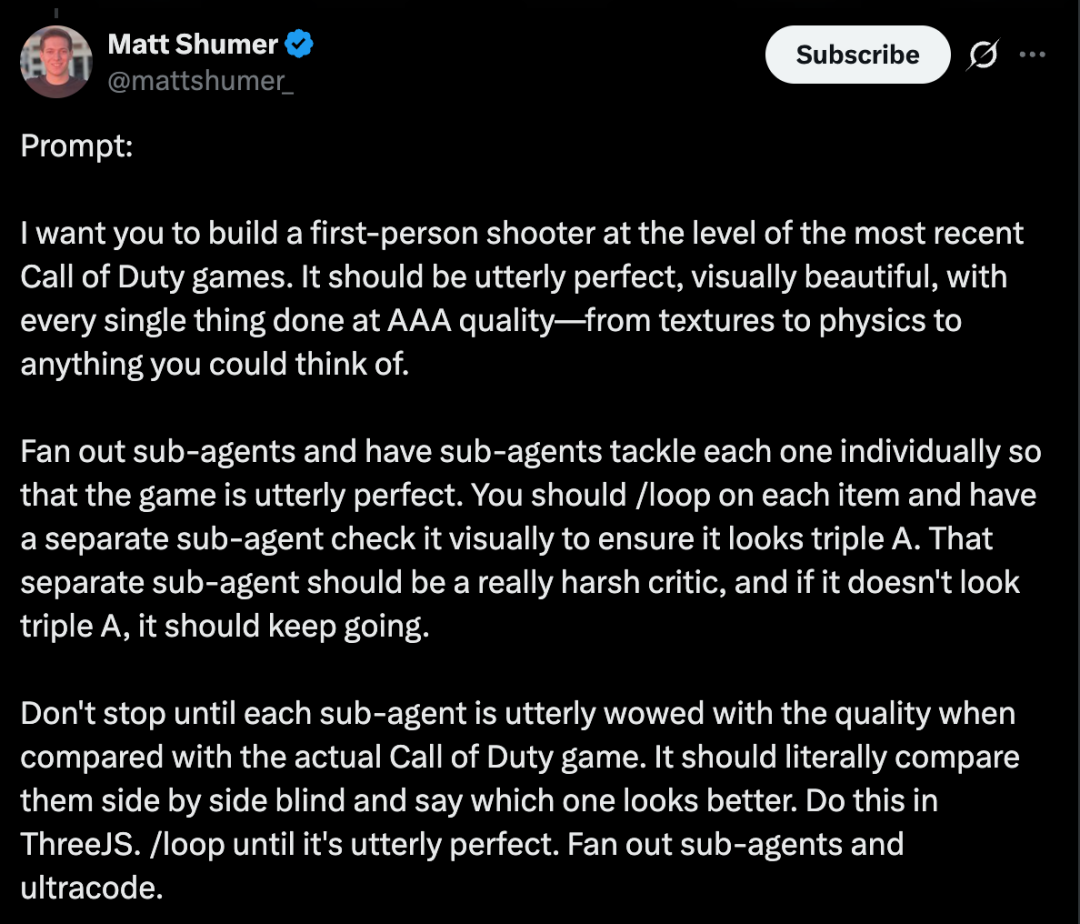
Der Workflow wies den Agenten an:
Shumer formalisierte diese Methode später als „Gauntlet Loop“ .
Die vereinfachte Version sieht wie folgt aus:
Ziel
  ↓
Leitagent
  ↓
Aufgabenzerlegung
  ↓
Build-Agenten
  ↓
Tatsächliche Ausgabe
  ↓
Unabhängige Bewertung
  ↓
Vergleich mit Referenz
  ↓
Bestanden? ── Ja → Integration
  │
  Nein
  ↓
Größte Lücke erklären
  ↓
Builder verbessert
  ↓
Wiederholen
„Mach es besser“ ist schwaches Feedback, weil das Modell selbst definieren muss, was „besser“ bedeutet.
Der Gauntlet-Loop gibt dem Bewerter dagegen einen externen Bezugspunkt.
Für Spiele können das Screenshots aus etablierten kommerziellen Werken sein.
Für Websites könnten es mehrere führende Seiten derselben Kategorie sein.
Für Backend-Engineering könnten es sein:
Das Ziel muss nicht unbedingt vollständig erreichbar sein. Seine Funktion besteht darin, zu verhindern, dass der Agent zu früh Erfolg erklärt.
Die zweite entscheidende Regel ist Unabhängigkeit.
Der Builder kennt die Gründe für jede seiner Entscheidungen und verteidigt seine Ergebnisse leicht. Ein völlig neuer Bewerter erhält dagegen das tatsächliche Artefakt und kennt die Implementierungshintergründe nicht.
Für visuelle Arbeit kann der Bewerter die gerenderten Pixel prüfen.
Für Software kann der Bewerter Tests und Laufzeitverhalten prüfen.
Für Performance-Arbeit kann der Bewerter echte Messdaten prüfen.
Das allgemeinere Prinzip lautet: Generierung und Bewertung sollten zwei getrennte Dinge sein.
Shumers ursprüngliche Demo wurde öffentlich als Claude of Duty veröffentlicht.
Das GitHub-Repository beschreibt einen auf Three.js und WebGL2 basierenden Ego-Shooter mit etwa 55.000 Codezeilen in rund 11 Subsystemen.
Das Repository erklärt, dass das Spiel keinerlei externe Kunstressourcen verwendet. Texturen, Meshes, Animationen und Sounds werden vollständig prozedural per Code generiert.
Die Systeme umfassen:
Das Projekt als „in einem Durchgang erstellt“ zu bezeichnen, bedeutet nicht, dass alles in einer einzigen Antwort erschien. Laut Shumer startete ein übergeordneter Prompt eine langlebige Claude-Code-Sitzung, die anschließend Sub-Agenten ableitete, Dateien schrieb, Werkzeuge ausführte, das Spiel rendern ließ, Ausgaben prüfte und kontinuierlich modifizierte.
Das Repository enthält folgende Werkzeuge:
Die README ist außerdem vorsichtiger als einige virale Beiträge: Sie stellt klar, dass das finale Projekt nicht dem Niveau moderner Call-of-Duty-Spiele entspricht.
Das macht das Experiment umso wertvoller. Das wahre Ergebnis ist nicht „KI hat AAA-Studios ersetzt“, sondern: Ein bewusst hoch angesetzter Referenzrahmen bringt Agenten dazu, lange dort weiterzuarbeiten, wo normale Prompts längst aufgehört hätten.
Anschließend wandte Anshu Chimala einen ähnlichen Workflow auf The Long Silence an – ein prozedurales Browser-Weltraum-Erkundungsspiel, das mit Claude Opus 5 gebaut wurde.
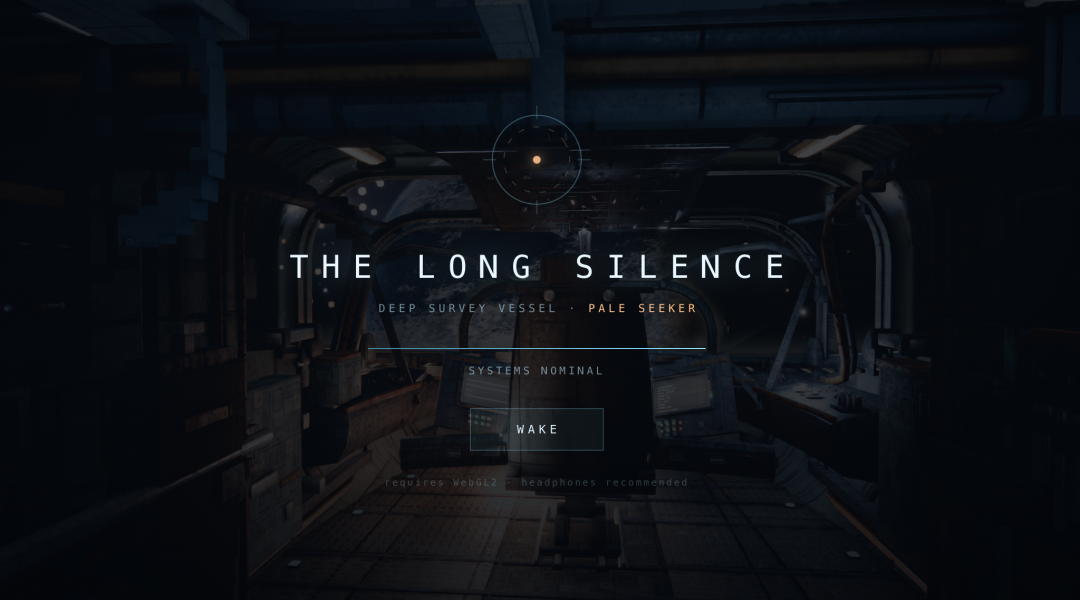
Das öffentliche Repository beschreibt, dass das Spiel WebGL2, Three.js-artige Browser-Rendering und benutzerdefiniertes GLSL verwendet.
Zudem wird eine seed-basierte prozedurale Inhaltsgenerierung verwendet, anstatt traditionelle Kunstressourcenbibliotheken herunterzuladen.
Der Quellartikel beschreibt einen etwa 24-stündigen Entwicklungsprozess, der hauptsächlich in drei Phasen unterteilt ist.
Die erste Anfrage war die Erstellung eines Weltraumerkundungsspiels mit Three.js.
Die Anforderungen wurden bewusst auf hoher Ebene gehalten:
Der Großteil der Weltkonstruktion und technischen Architektur blieb dem Agenten zur eigenen Entscheidung überlassen.
Dies folgt dem Kernprinzip des Ansatzes:
Definiere das Ziel, nicht den Weg.
Der Quellartikel erwähnt außerdem, dass Claude Code während des Prozesses mit Blender-bezogenen Werkzeugen verbunden war. Das öffentliche Repository enthält ein Claude-Skills-Verzeichnis für Blender Hard-Surface-Modellierung, was bestätigt, dass wiederverwendbare Blender-Anweisungen Teil des Projekts wurden.
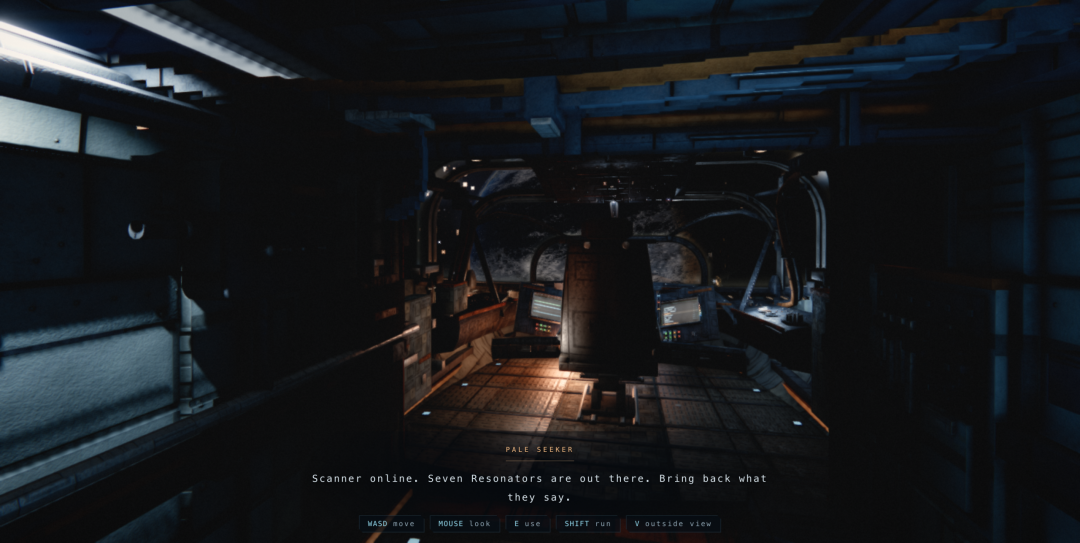
Nachdem die erste spielbare Version fertiggestellt war, trat das Projekt in eine lange Phase der visuellen Verfeinerung ein.
Mehrere Unteragenten bearbeiteten verschiedene Bereiche, während ein Bewertungsagent Screenshots mit hochwertigen Referenzbildern von Weltraumspielen verglich.
Der Fokus lag nicht darauf, Opus 5 einfach zu sagen „Mach das Spiel hübscher“. Der Bewertungsagent musste sichtbare Lücken identifizieren und schwache Bereiche zur erneuten Iteration zurückschicken.
Der Quellartikel erwähnt, dass Werke wie Starfield als Qualitätsmaßstab dienten.
Der lange Zyklus benötigte auch eine Abbruchbedingung. Nützliche Stopppunkte umfassten:
Der Zyklus ist eine Druckmechanik, keine Garantie dafür, dass das Endergebnis „perfekt“ wird.
Der Prozess lief nicht vollständig ohne menschliches Eingreifen.
Laut Quellartikel überprüfte Chimala den Fortschritt aus der Ferne und griff ein, wenn der Agent zu viel Aufwand in einen Bereich steckte.
Nach Abschluss des langen Laufs wurden zusätzliche Claude-Sitzungen verwendet, um:
Anschließend wurde das Modell gebeten, die wiederverwendbaren Erfahrungen als Skill zusammenzufassen.
Das öffentliche Repository enthält:
.claude/skills/blender-hardsurface
Dies ist ein nützliches Muster für langlaufende Agentenarbeit. Ein Projekt kann nicht nur Artefakte hervorbringen, sondern auch wiederverwendbares Handlungswissen verankern: welche Werkzeuge funktionieren, welche Tests wichtig sind, was fehlgeschlagen ist und wie zukünftige Aufgaben strukturiert sein sollten.
Eines der markantesten Elemente im öffentlichen Repository ist das
Validierungswerkzeug-Set.
Im README sind die folgenden Befehle dokumentiert:
node tools/play.mjs
node tools/survey.mjs
node tools/probe.mjs "" --shot out.png
node tools/sheet.mjs a.png b.png --out s.png
node tools/levels.mjs shots/*.png
node tools/judgeset.mjs
Die dokumentierten Zwecke dieser Befehle umfassen:
play.mjs: 17 Interaktions-Assertions zu Fliegen, Scannen, Falten und Springensurvey.mjs: Screenshots der Hauptszenen und Leistungsberichteprobe.mjs: Einzelne Browser-Ausdrucksausführung mit einem einzelnen Screenshotsheet.mjs: Kontaktbogen mit Miniaturansichten für visuelle Vergleichelevels.mjs: Farbton- und Belichtungsstatistikenjudgeset.mjs: Wiederaufbau des visuellen Bewertungssets
Der entscheidende Punkt ist, dass der Agent nicht nur das Spiel selbst erschaffen hat, sondern auch die Mechanismen zur Bewertung des Spiels.
Das ist einer der Gründe, warum ein langlaufender Agent zuverlässiger Verbesserungen erzielen kann als ein einfacher „Generieren und Stoppen“-Workflow.
Das README dokumentiert mehrere tatsächliche Grafikentscheidungen:
Das Repository zeigt außerdem, dass die Browser-Validierung auf echten Chromium-Instanzen mit aktivierter GPU-Rasterisierung durchgeführt wurde.
Diese Details sind wichtig, weil sie zeigen, wie das Modell mit vertrauten technischen Einschränkungen umgeht: Leistung, Präzision, Reproduzierbarkeit, Browser-Verhalten und visuelle Qualität.
„The Long Silence“ ist öffentlich im Browser spielbar.
Das Repository bietet Standard-Entwicklungsbefehle:
npm install
npm run dev
npm run build
Das Spiel umfasst Raumflug, Scannen, prozedurale Umgebungen, Navigation, Erkundungsziele sowie mehrere Schnittstellensysteme.
Das macht es zu mehr als einem statischen Modell.
Es ist jedoch nicht gleichzusetzen mit einem kommerziellen AAA-Spiel, das große Studios über Jahre entwickelt haben.
AAA-Produktionen erfordern in der Regel große Teams für:
Die tragfähigere Schlussfolgerung ist: Ein einzelner Entwickler kann heute hochmoderne Codieragenten orchestrieren und spielbare Prototypen schaffen, die visuell ambitioniert und technisch nicht trivial sind – weit schneller, als es bisher praktisch möglich war.
Gemeinschaftsentwickler begannen, dieses Muster zu übernehmen
Nachdem Shumer Prompt und Code veröffentlicht hatte, verbreitete sich dieser Workflow schnell.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Ryan Campbell verwendete ein ähnliches Muster
Er trieb ein Browser-basiertes Go-Kart-Rennspielprojekt iterativ voran und verbesserte kontinuierlich Rendering, Steuerung, Kameraführung sowie mobile Leistung.
Das von Shumer öffentlich zugänglich gemachte Gauntlet-Loop-Verzeichnis zeigte später ein mit dieser Methode erstelltes, im Browser spielbares Rennspiel-Experiment.
Der Designer Yogi Suria teilte ein Cyberpunk-inspiriertes Three.js-Projekt, das vom selben Prompt-Muster inspiriert war.
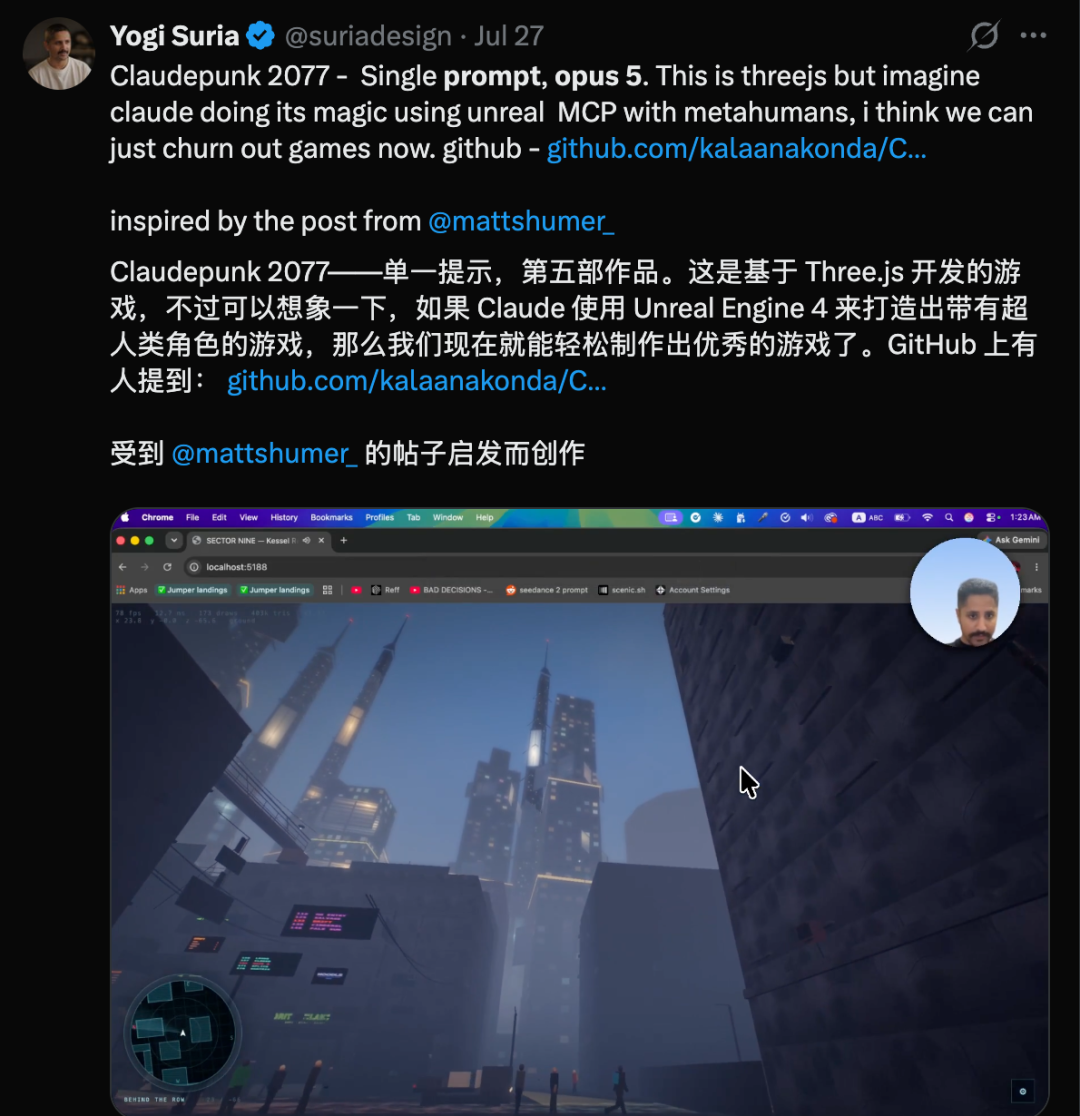
Dieses Beispiel zeigt, dass die Methode nicht auf ein einzelnes Spielgenre beschränkt ist. Referenzziele, künstlerische Ausrichtung und Toolchain können variieren, während die Struktur aus „Bauen – Kritisieren – Wiederholen“ konstant bleibt.
Die Quelle zeigte außerdem, wie ein Entwickler über Codex mit GPT-5.6 Sol ähnliche Prompts ausprobierte.
Der Entwickler berichtete von einer Bauzeit von etwa zwei Stunden und beschrieb das Ergebnis als ordentlich, aber nicht so ausgefeilt wie Shumers Demonstration.
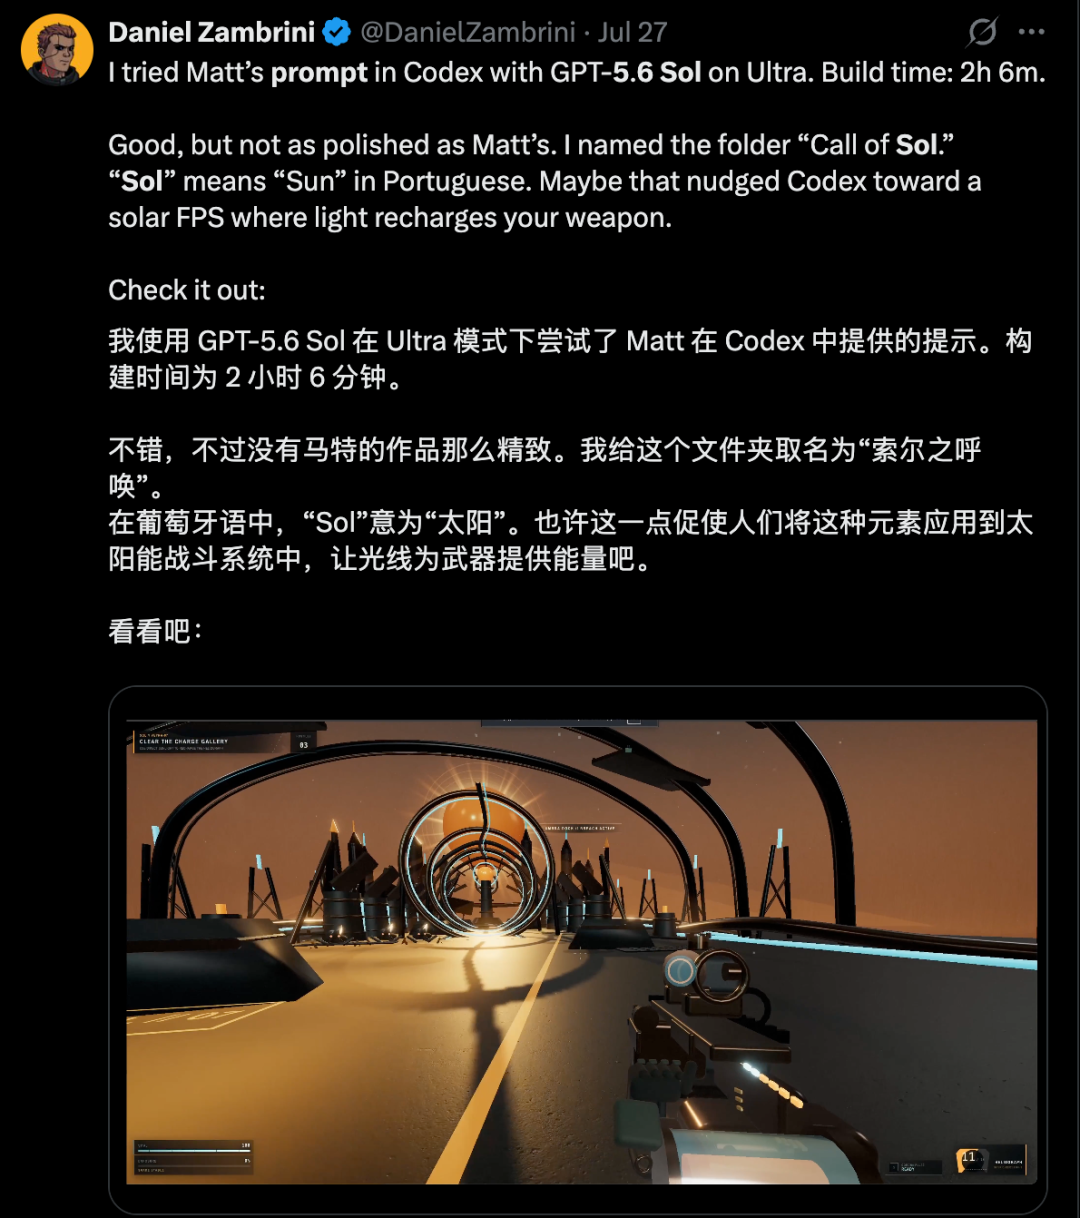
Dies zeigt, dass der Gauntlet Loop im Kern nicht exklusiv für Claude ist.
Das Muster hängt von einer Agentenumgebung ab, die folgende Fähigkeiten besitzt:
Verschiedene Modelle können sich in der Schleife unterschiedlich verhalten, aber die Architektur ist übertragbar.
Traditionelle Generierungsabläufe sehen meist so aus:
Benutzer → Modell → Ausgabe → Benutzer
Der Gauntlet Loop fügt eine Bewertungsebene hinzu:
Benutzer
  ↓
Hauptagent
  ↓
Builder
  ↓
Artefakt
  ↓
Unabhängiger Kritiker
  ↓
Lücke messen
  ↓
Builder überarbeitet
  ↓
Neues Artefakt
Dies schafft mehr Gelegenheiten, minderwertige Ergebnisse zu entdecken, bevor sie ausgeliefert werden.
Zu sagen „Die Seite sollte jetzt responsiv sein“ ist weniger aussagekräftig, als die Seite tatsächlich mit mobiler Breite zu öffnen und zu prüfen.
„Das Spiel sollte schneller sein“ ist weniger aussagekräftig als die Messung der Frame-Zeiten.
„Das Rendering sieht besser aus“ ist weniger aussagekräftig als der Vergleich von Screenshots.
Die besten Feedbacksignale sind in echten Artefakten verwurzelt.
Der Builder erinnert sich an jeden Kompromiss, den er eingegangen ist.
Das kann die Bewertung verzerren.
Ein unabhängiger Kritiker kann eine einfachere Frage stellen: Erreicht das Ergebnis wirklich den Standard?
Dies spiegelt menschliche Arbeitsabläufe wider. Entwickler nutzen Tests und Code-Reviews. Designer nutzen visuelle Reviews und Nutzertests. Autoren nutzen Lektorat.
KI-Agenten können diese Trennung mit höherer Frequenz replizieren.
Anthropic veröffentlichte Claude Opus 5 am 24. Juli 2026.
Das offizielle Veröffentlichungsmaterial betont stärkere Leistung bei Codierung, langen mehrstufigen Aufgaben, Validierung und Iteration.
Anthropic hob besonders hervor, dass Opus 5 besser abschneidet bei:
Diese Verhaltensweisen passen hervorragend zum Gauntlet Loop.
Der Prompt verleiht dem Modell keine neuen Fähigkeiten. Er schafft eine Struktur, die das Modell wiederholt dazu zwingt, bereits vorhandene Fähigkeiten zu nutzen.
Anthropic gab außerdem an, dass Opus 5 effizienter ist als Opus 4.8 zum gleichen Basispreis: 5 US-Dollar pro Million Input-Tokens und 25 US-Dollar pro Million Output-Tokens.
Langlaufende Agenten können weiterhin mit folgenden Problemen konfrontiert sein:
Daher bleiben menschliche Kontrollpunkte nützlich.
Der stärkste Workflow ist nicht „den Agenten nie wieder ansehen“, sondern „den Agenten länger zwischen zwei hochwertigen menschlichen Eingriffen arbeiten lassen“.
Die Methode lässt sich über Spiele hinaus verallgemeinern.
Beschreiben Sie das gewünschte Ergebnis, statt jedes Implementierungsdetail vorzuschreiben.
Baue ein raffiniertes Browser-Weltraum Explorationsspiel mit flüssiger Steuerung,
starker visueller Atmosphäre und stabiler Leistung.
Verwenden Sie Inhalte, die ein Rezensent prüfen kann.
Für visuelle Arbeit:
Vergleiche Beleuchtung, Tiefe, Komposition und UI-Verfeinerung mit einer kuratierten Auswahl hochwertiger kommerzieller Spiel-Screenshots.
Für Software verwenden Sie Tests, Benchmarks oder Referenzimplementierungen.
Der Agent kann Komponenten aufschlüsseln, zum Beispiel:
Für wichtige Komponenten verwenden Sie:
Der Kritiker sollte die größte umsetzbare Abweichung benennen, statt eine lange Liste vager Beschwerden zu liefern.
Iterieren Sie kontinuierlich, bis Qualität, Budget oder Zeit einen Stopppunkt erreichen.
Parallele Agenten können lokal gute, aber global inkonsistente Arbeit produzieren.
Ein finaler Integrationsagent kann prüfen:
Speichern Sie nützliche Teile des Prozesses als:
Nachfolgende Läufe sollten von früheren Lektionen ausgehen.
Der Gauntlet Loop ist am effektivsten, wenn Qualität wiederholt messbar ist.
Geeignete Kandidaten umfassen:
Aber wenn dem Kritiker verlässliche Signale fehlen, ist das Muster schwächer.
Ein Kritiker ohne Screenshots, Tests, Benchmarks, Referenzmaterial oder echtes Nutzerfeedback könnte lediglich eine weitere „Meinung“ des Modells erzeugen.
Langlaufende Multi-Agenten-Workflows können erhebliche Rechenressourcen verbrauchen.
Jede Überprüfungsrunde kann Folgendes erfordern:
Praktische Budgetkontrollen umfassen:
Ein strenger Kritiker kann die Qualität verbessern, aber er kann das System auch sehr lange weiterlaufen lassen, wenn weitere Verbesserungen bereits unrentabel sind.
Die Gauntlet Loop ist eine von Matt Shumer populär gemachte Multi-Agenten-Prompt-Methode. Ein führender Agent zerlegt das Ziel in kleinere Aufgaben, ein Builder-Agent erstellt die Ergebnisse, und ein unabhängiger Kritiker-Agent vergleicht die tatsächliche Ausgabe mit konkreten Referenzen. Ergebnisse, die die Anforderungen nicht erfüllen, werden zur Überarbeitung zurückgeschickt.
Laut Shumer begann das Projekt mit einem hochrangigen Prompt, wurde aber nicht in einer einzigen Modellantwort generiert. Claude Code arbeitete anschließend über mehrere Stunden, leitete Unteragenten ab, schrieb etwa 55.000 Zeilen Code, nutzte Werkzeuge, überprüfte Ausgaben und iterierte.
Nein. Diese Demos sind technisch beeindruckende Browser-Spiele und Prototypen, aber sie entsprechen nicht kommerziellen 3A-Produktionen. Das Code-Repository von Claude of Duty selbst stellt fest, dass das Endergebnis nicht mit modernen Call-of-Duty-Titeln vergleichbar ist, die als Qualitätsreferenz dienten.
The Long Silence ist ein browserbasiertes prozedurales Weltraumspiel von Anshu Chimala. Das öffentliche Repository zeigt, dass es mit Claude Opus 5 gebaut wurde und benutzerdefiniertes Rendering, prozedurale Inhaltsgenerierung sowie browserbasierte Verifikationswerkzeuge umfasst.
Ein neuer Kritiker ist weniger geneigt, die Implementierungsentscheidungen des Builders selbst zu verteidigen. Er kann das tatsächliche Artefakt prüfen und es mit Tests, Screenshots, Benchmarks oder Referenzbeispielen vergleichen, bevor er eine weitere Überarbeitung anfordert.
Nein. Diese Architektur lässt sich auf andere Coding-Agenten anwenden, die Werkzeuge, Dateibearbeitung, Codeausführung, visuelle Inspektion und wiederholte Arbeit unterstützen. Der Quelltext enthält ein Beispiel mit GPT-5.6 Sol und Codex.
Der vollständige Workflow erfordert eine Agenten-Laufzeitumgebung und nicht nur eine normale Chat-Oberfläche. Claude Code ist eine Option, da es Dateien verarbeiten, Befehle ausführen, Werkzeuge anbinden und langlaufende Codierungsaufgaben koordinieren kann.
Wenn Qualitätsstandards vage oder nicht messbar sind, können langlaufende Schleifen Zeit und Rechenressourcen verschwenden. Der menschliche Eigentümer sollte weiterhin Budgets festlegen, Fortschritte prüfen, bei Bedarf Prioritäten neu setzen und entscheiden, wann weitere Iterationen keinen Wert mehr bieten.
Umfasst die Fähigkeiten von Opus 5 in Bezug auf Codierung, Validierung, Iteration und langzyklische Aufgaben.
Die viralen Opus-5-Spielexperimente sollten eher als Demonstration eines Workflows verstanden werden denn als magische „Einmal-Generierung“. Die Gauntlet Loop kombiniert Aufgabenzerlegung, spezialisierte Builder, unabhängige Kritiker, konkrete Qualitätsstandards und wiederholte Iteration.
The Long Silence zeigt, wie weit dieses Muster in einem etwa eintägigen Agentenprojekt reichen kann. Das öffentliche Repository enthält nicht nur das spielbare Spiel, sondern auch Validierungsskripte, Screenshot-Werkzeuge, Interaktions-Assertions und wiederverwendbare Agenten-Anweisungen.
Die Methode bleibt weiterhin auf menschliches Urteil, Rechenbudgets, gute Referenzmaterialien und eine Agenten-Werkbank angewiesen. Sie bedeutet nicht, dass Browser-Prototypen mit 3A-Spielen aus Studios mithalten können.
Der eigentliche Wandel besteht darin, dass ein hochrangiges Ziel nun einen langlaufenden Build-Mess-Kritik-Verbesserungs-Zyklus anstoßen kann, der weit mehr Arbeit erledigt, bevor ein Mensch eingreifen muss.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



