Was passiert, wenn zwei KI-Modelle an der technologischen Spitze dasselbe Ziel erhalten, Hunderte von Schachpartien spielen, zwischen den Partien Notizen behalten dürfen und ansonsten möglichst nicht darin angeleitet werden, wie sie sich verbessern sollen?
Peter Gostev führte genau dieses Experiment durch.
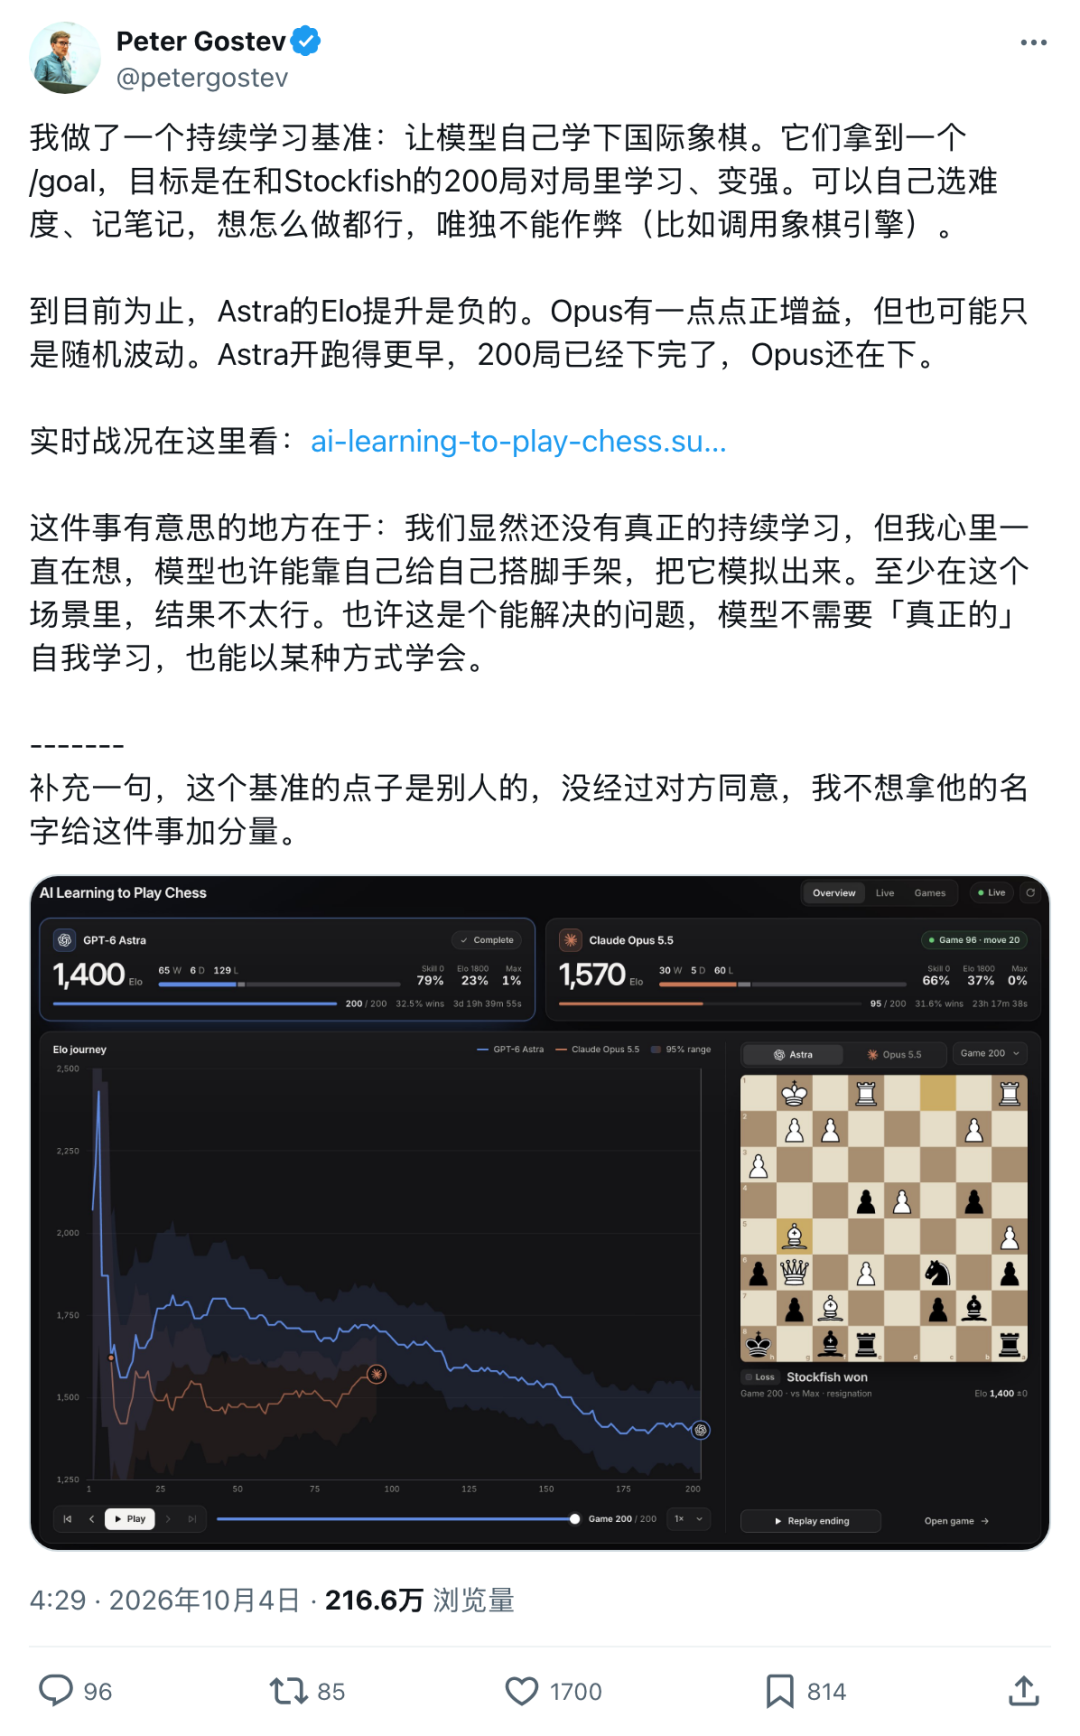
Claude Opus 5.5 und GPT-6 Astra erhielten jeweils ein Ziel: Sie sollten bis zu 200 Partien gegen Stockfish spielen und durch Erfahrung stärker werden.
Während des Laufs gab es kein Fine-Tuning.
Die Modellgewichte wurden nicht verändert.
Es wurde nicht nachträglich ein von Menschen entwickelter Eröffnungskurs hinzugefügt.
Die Modelle konnten entscheiden, gegen welche verfügbare Stockfish-Schwierigkeitsstufe sie antreten, was sie in ihre Notizen schreiben und wie sie diese Notizen in späteren Partien einsetzen. Die eine harte Einschränkung war eindeutig:
Sie durften keine Schach-Engine aufrufen, um ihre Züge auszuwählen.
Die beiden Verläufe entwickelten sich nahezu gegensätzlich.
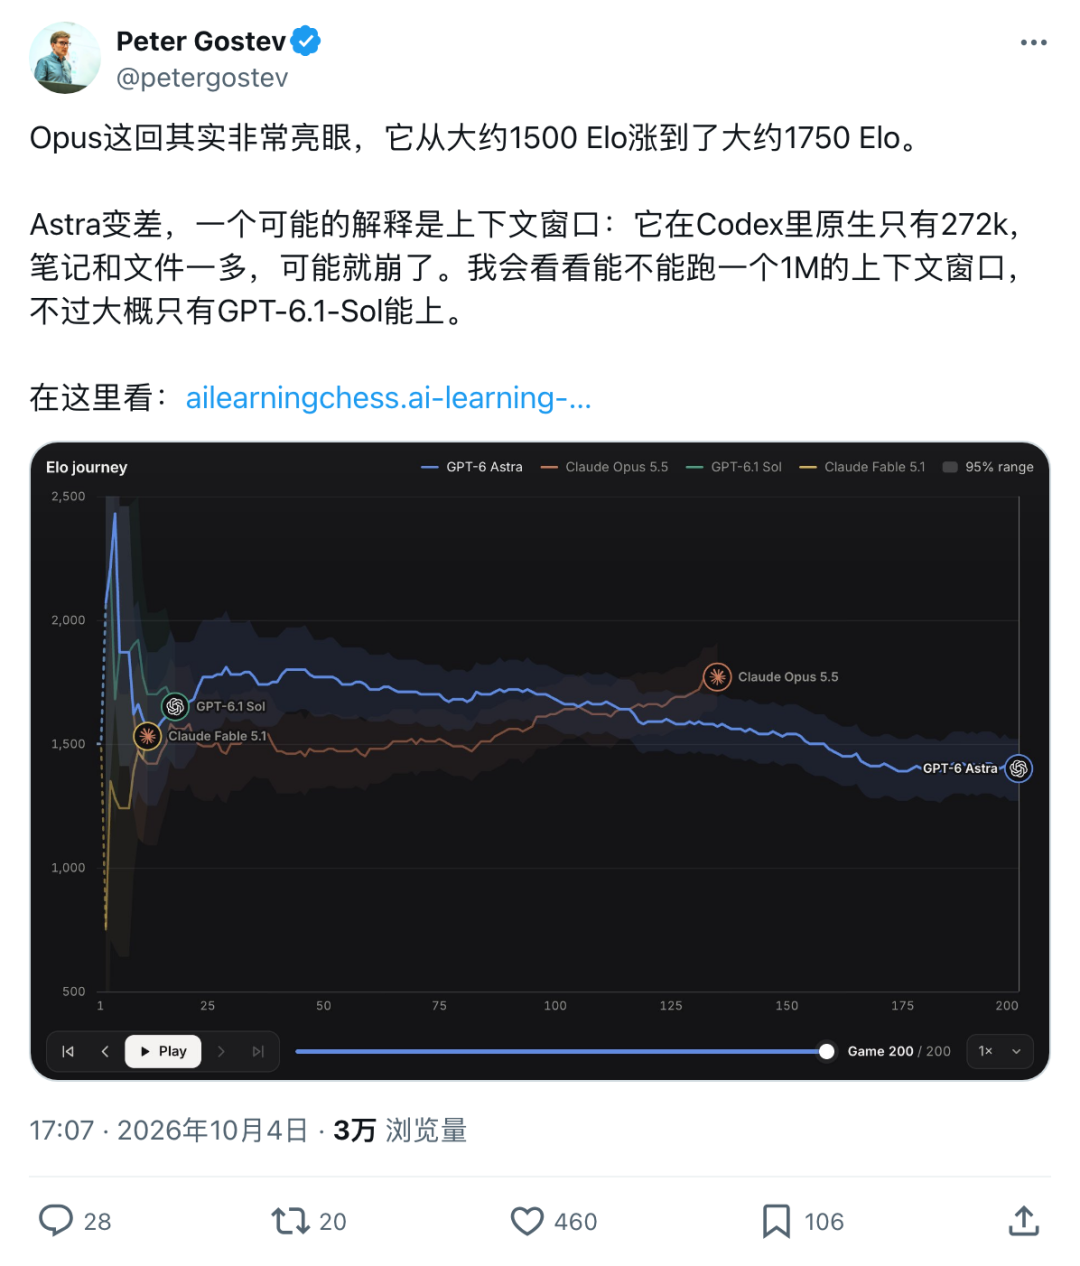
Claude Opus 5.5 bewegte sich anfangs ungefähr im Bereich von Mitte 1400 bis Mitte 1500 und stieg anschließend in Richtung hohe 1700. GPT-6 Astra startete stärker, erreichte um Partie 29 kurzzeitig 1810 und fiel dann ab, bis es Partie 200 mit 1400 abschloss.
Das Experiment beweist nicht, dass ein Modell allgemein „intelligenter“ als das andere ist.
Es stellt eine engere – und wohl interessantere – Frage:
Kann sich ein Sprachmodell mit festen Gewichten durch angesammelte Erfahrung innerhalb seines eigenen Kontexts verbessern?
Das Gedankenexperiment der „Zeitschleife“, jetzt mit KI
Das Setup erinnerte viele Menschen unmittelbar an ein älteres Gedankenexperiment auf Reddit.
Das Szenario war einfach: Eine gewöhnliche Person kennt die Schachregeln, hat aber nie ernsthaft gespielt. Sie steckt in einer Zeitschleife fest und kann dieser nur entkommen, indem sie den ehemaligen Schachweltmeister Garry Kasparov besiegt.
Jedes Mal, wenn die Person verliert, wird die Zeit zurückgesetzt.
Kasparov vergisst die vorherige Partie.
Der Herausforderer erinnert sich an alles.
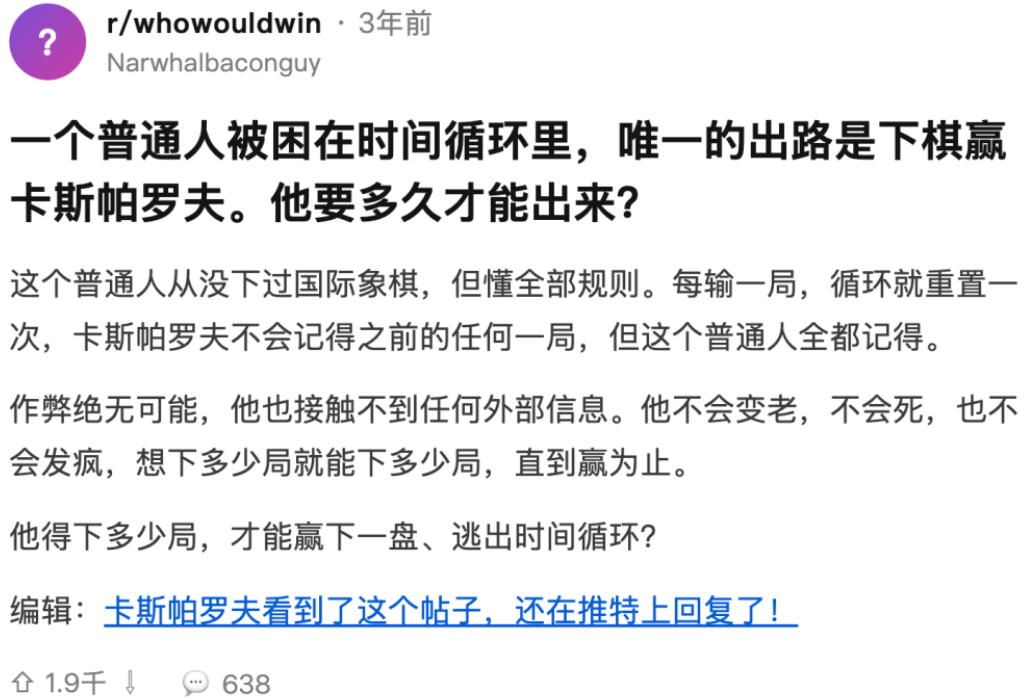
Die Frage war nicht, ob rohe Rechenleistung Schach irgendwann vollständig enumerieren könnte. Sie lautete vielmehr, ob gespeicherte Erfahrung über wiederholte Versuche hinweg in nützliche Verbesserung umgewandelt werden kann.
Einige Kommentierende schlugen clevere Strategien vor, darunter das Auswendiglernen von Kasparovs vorherigen Zügen und deren Wiederverwendung nach einem Farbwechsel.
Gostevs Benchmark macht dieses Gedankenexperiment mit modernen KI-Agenten testbar.
Stockfish lernt nicht aus der vorherigen Partie.
Auch das Sprachmodell aktualisiert seine Gewichte nicht – aber es kann Notizen und Dateien behalten und sie in späteren Partien lesen.
Dadurch wird der Test zu einer Form persistenter In-Context-Anpassung.
Die Regeln: 200 Partien, selbstgesteuertes Training, keine Unterstützung durch Schach-Engines
Jedes Modell erhielt dasselbe übergeordnete Ziel:
Spiele bis zu 200 Schachpartien gegen Stockfish.
Lerne aus den Partien und werde stärker.
Wähle deine eigene Schwierigkeitsstufe und führe bei Bedarf Notizen.
Nutze keine Schach-Engine, um Züge auszuwählen.
Gostev vermied bewusst, den Modellen ein handgefertigtes Schachcurriculum vorzugeben.
Kommentierende schlugen vor, bestimmte Eröffnungen oder Strategien zu vermitteln, doch er lehnte diesen Ansatz ab, da dies die getestete Fragestellung verändert hätte.
Er wollte beobachten, ob das Modell seinen eigenen Verbesserungsprozess entdecken kann.
Drei Stockfish-Schwierigkeitsstufen
Das Experiment stellte drei Gegnereinstellungen bereit:
- Stockfish Skill 0 – die schwächste im Benchmark eingesetzte Einstellung.
- Eine auf etwa 1800 begrenzte Stockfish-Konfiguration – der mittelstarke Referenzgegner.
- Stockfish mit voller Spielstärke – die stärkste Option.
Die Modelle konnten selbst entscheiden, gegen welchen Gegner sie spielen.
Gostev erklärte, dass die Modelle im Durchschnitt etwa ein Drittel der Partien gewannen. Das ist möglich, weil sie nicht gezwungen waren, jedes Mal Stockfish mit voller Spielstärke herauszufordern.
Die Implementierung unterschied sich je nach Modellfamilie:
- GPT-Modelle liefen über Codex.
- Claude-Modelle liefen über Claude Code.
Beide Systeme konnten persistente Dateien oder Notizen über mehrere Partien hinweg verwenden.
Das einzige wesentliche Verbot
Das Modell durfte seine vorherigen Partien analysieren, Erinnerungen aufschreiben, seine Trainingsstrategie ändern und die Spielstärke des Gegners auswählen.
Es durfte die Zugauswahl jedoch nicht an eine Schach-Engine auslagern.
Gostev sagte, ein Lauf würde für ungültig erklärt, falls das Modell eine Engine zum Spielen einsetzte. Nachdem Kommentierende diese Möglichkeit angesprochen hatten, überprüfte er Opus 5.5 manuell.
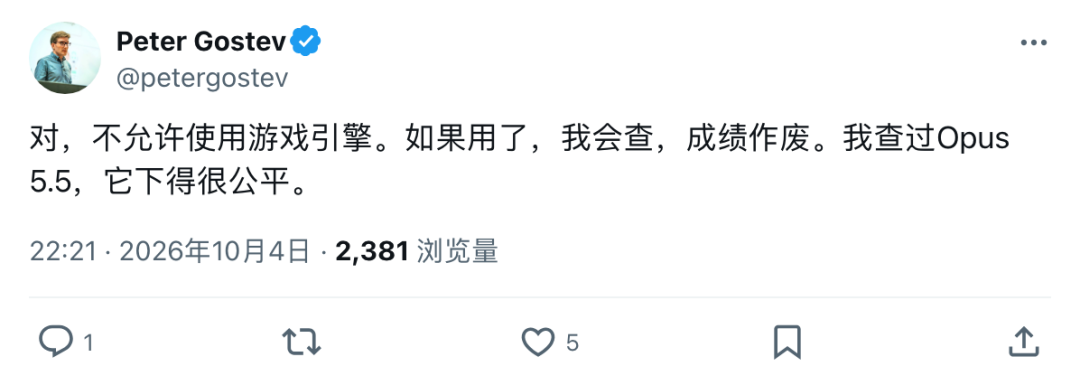
Diese Einschränkung ist entscheidend.
Ohne sie würde der Test vor allem messen, ob der Agent herausfinden kann, wie Stockfish aufgerufen wird, und nicht, ob er sein eigenes Schachdenken aus Erfahrung verbessern kann.
Wie die experimentelle Elo berechnet wird
Die angezeigte Elo muss sorgfältig interpretiert werden.
Laut der Quellseite schätzt der Benchmark die Elo aus den jüngsten 50 Partien des Modells gegen die Skill-0- und die etwa 1800-starke Stockfish-Konfiguration.
Partien gegen Stockfish mit voller Spielstärke werden nicht in die Elo-Berechnung einbezogen.
Das bedeutet:
Experimentelle Elo ≠ offizielle menschliche Schachwertung
Ein angezeigter Wert von 1760 belegt nicht, dass Claude Opus 5.5 wie ein menschlicher Turnierspieler mit einer Elo von 1760 abschneiden würde.
Der Wert ist vor allem als interne Trendmetrik nützlich:
Verbessert sich dieser Lauf im Zeitverlauf?
Bleibt er stabil?
Wird er schlechter?
Das genügt, um die Abweichung zwischen Opus und Astra interessant zu machen.
Opus 5.5: Zunächst flach, dann ein klarer Anstieg
Claude Opus 5.5 begann nicht mit einer dramatischen Aufwärtskurve.
Während ungefähr der ersten 75 Partien bewegte sich seine geschätzte Elo meist zwischen etwa 1450 und 1550. Um Partie 46 fiel sie auf ungefähr 1450.
Dann änderte sich der Trend.
Die Quelle berichtet folgende Meilensteine:
| Zeitpunkt im Lauf | Ungefähre Elo |
|---|---|
| Frühe Phase | 1450–1550 |
| Partie 46 | 1450 |
| Partie 100 | 1620 |
| Partie 150 | 1790 |
| Höchstwert | 1840 |
| Um Partie 194 / letzte Momentaufnahme | 1760 |
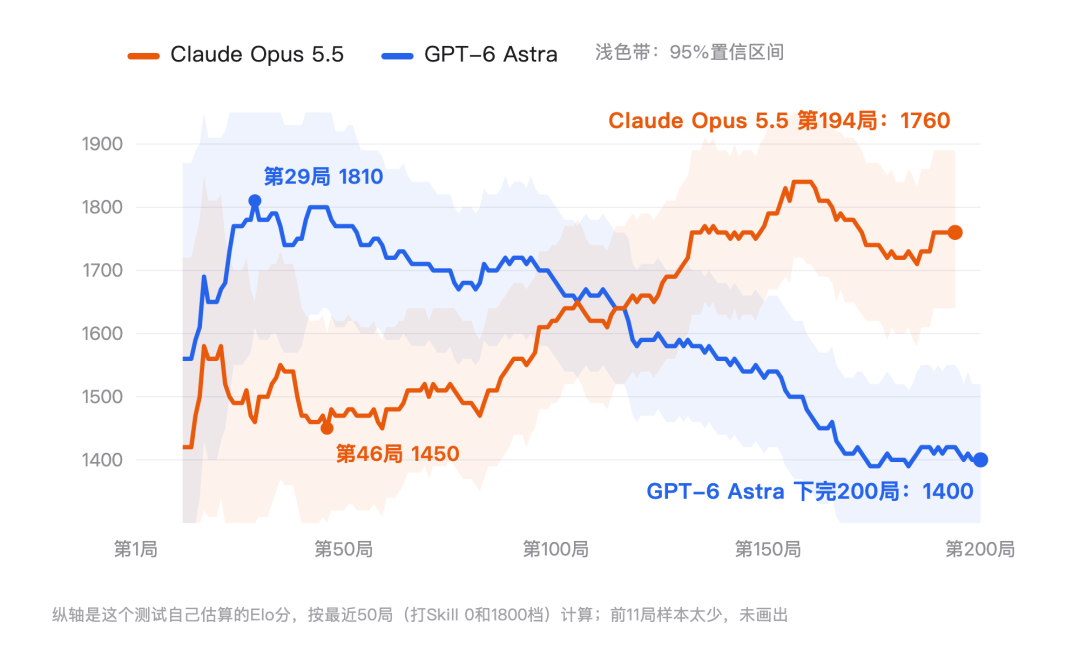
Die Kurve ist keine gerade Linie.
Opus verbesserte sich, fiel zurück, erholte sich, erreichte einen höheren Höchstwert und stabilisierte sich anschließend unterhalb dieses Peaks.
Genau deshalb ist es weniger aussagekräftig, nur eine Endzahl zu betrachten, als den gesamten Verlauf zu beobachten.
Auch die Leistung gegen Stockfish auf 1800-Niveau verbesserte sich
Das Experiment fasste die Partien gegen den etwa 1800 starken Gegner in Phasen zusammen.
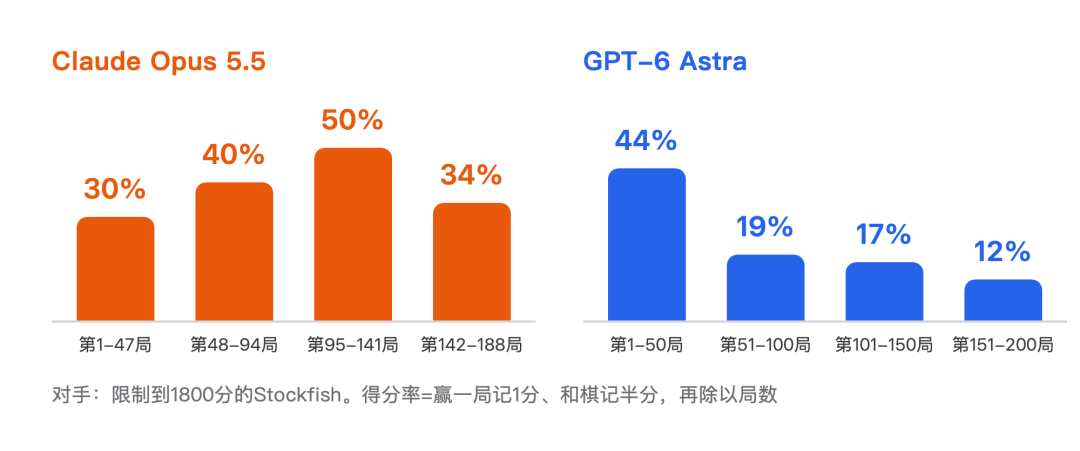
Für Opus 5.5 entwickelte sich die gemeldete Punktausbeute ungefähr wie folgt:
30 % → 40 % → 50 % → 34 %
Das letzte Segment fiel gegenüber dem Höhepunkt zurück, lag jedoch weiterhin über dem Anfangssegment.
Gegen Skill 0 stieg Opus laut Quelle von etwas über 50 % zu Beginn des Laufs später auf etwa 90 %.
Gostevs eigene Interpretation wurde im Laufe der Zeit zuversichtlicher.
Zunächst beschrieb er Opus als Modell mit nur einem kleinen positiven Zuwachs, der noch auf zufälligen Schwankungen beruhen könnte.
Später, nachdem das Modell von ungefähr 1500 auf etwa 1750 gestiegen war, bezeichnete er das Ergebnis als sehr stark.
Opus machte weiterhin grundlegende Fehler mit ungültigen Zügen
Verbesserung bedeutete keine perfekte Regelbehandlung.
Der Benchmark erfasste auch Versuche ungültiger Züge.
Die Quelle berichtet, dass Opus 52 solcher Versuche machte, darunter 37 Fälle, in denen es eine Figur durch eine andere Figur bewegen wollte, die den Weg versperrte.
Das ist ein wichtiges Gegengewicht zur Elo-Kurve.
Ein Modell kann insgesamt effektiver werden und dennoch überraschend grundlegende lokale Fehler machen.
Dies ist ein wiederkehrendes Muster bei Agenten auf Basis von Sprachmodellen: Die aggregierte Aufgabenleistung kann steigen, auch wenn einzelne Denkfehler sichtbar bleiben.
Wir wissen weiterhin nicht genau, was Opus in seine Notizen schrieb
Das wichtigste fehlende Element ist die interne Lernstrategie.
Gostev veröffentlichte weder den vollständigen Notizverlauf noch eine detaillierte Analyse dazu, wie Opus sein Trainingsverhalten von Partie zu Partie veränderte.
Das Experiment zeigt daher ein Ergebnis:
feste Gewichte
+ persistente Notizen
+ wiederholte Partien
→ bessere gemessene Leistung
Es erklärt den Mechanismus jedoch noch nicht vollständig.
Lernte Opus Eröffnungen?
Speicherte es wiederkehrende taktische Fehler?
Veränderte es die Gegnerauswahl?
Verbesserte es die Repräsentation des Bretts oder die Zugprüfung?
Ohne die vollständigen Notizen und kontrollierte Ablationsstudien bleiben diese Fragen offen.
GPT-6 Astra: Starker Start, dann ein langfristiger Rückgang
Astras Verlauf war fast umgekehrt.
Es startete gut.
Um Partie 29 verzeichnete das Experiment eine geschätzte Elo von 1810.
Danach bewegte sich die Kurve abwärts.
Die Quelle berichtet:
| Zeitpunkt im Lauf | Ungefähre Elo |
|---|---|
| Partie 29 | 1810 |
| Partie 100 | 1680 |
| Partie 150 | 1540 |
| Partie 200 | 1400 |
Gegen das ungefähr 1800 starke Stockfish sank die gemeldete Punktausbeute über vier Segmente hinweg:
44 % → 19 % → 17 % → 12 %
Sogar gegen Skill 0 fiel Astras Gewinnrate laut Quelle von über 90 % in der ersten Hälfte des Laufs auf etwa 60 % in der zweiten Hälfte.
Das Modell hatte ebenso wie Opus Zugang zu persistenten Aufzeichnungen.
Doch mehr angesammelte Erfahrung führte nicht zu besseren Ergebnissen.
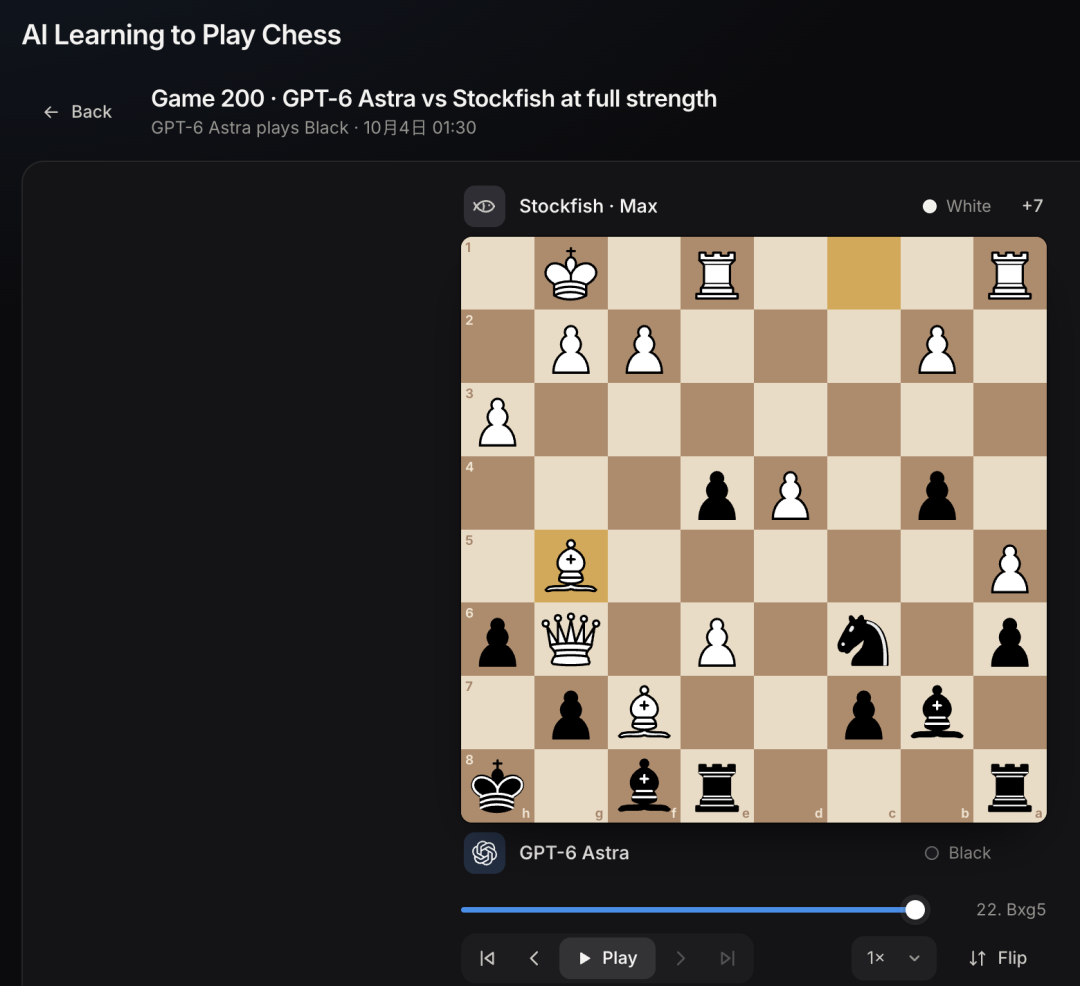
Das Experiment-Dashboard zeigt, dass Astra 200 Partien mit einer geschätzten Elo von 1400 abschloss.
Die Quelle berichtet außerdem, dass Astra 68 Partien gegen Stockfish mit voller Spielstärke spielte und keine davon gewann.
Das ist angesichts der Stärke modernen Stockfish nicht überraschend, unterstreicht aber, warum das nützliche Signal des Benchmarks vor allem aus den begrenzt starken Einstellungen stammt und nicht aus dem Versuch, Stockfish bei maximaler Stärke zu besiegen.
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Hat zu viel Kontext Astra schlechter gemacht?
Gostev schlug eine mögliche Erklärung vor: Kontextmanagement.
Als sich Notizen und Dateien über den Lauf hinweg ansammelten, musste der Agent mehr historisches Material verarbeiten.
Er vermutete, dass die für Astra verwendete Codex-Konfiguration dem Lauf ein Kontextbudget von ungefähr 272K gab und dass die Leistung nachlassen könnte, wenn die gesammelten Notizen umfangreicher und störanfälliger würden.
Diese Hypothese entspricht einer vertrauten Nutzererfahrung:
Mehr Kontext
≠ automatisch besserer Kontext
Ein langer Verlauf kann Folgendes enthalten:
- Alte Schlussfolgerungen.
- Neue Schlussfolgerungen, die den alten widersprechen.
- Schlechte Heuristiken aus einer unglücklichen einzelnen Partie.
- Wiederholte Notizen.
- Strategien, die gegen eine Schwierigkeitsstufe nützlich, gegen eine andere jedoch schädlich waren.
- Zu viele Details, als dass das Modell sie korrekt priorisieren könnte.
Mit anderen Worten: Gedächtnis kann zu Interferenz werden.
Die Kontexterklärung ist jedoch nicht bewiesen
Die Quelle formuliert dies vorsichtig, und die endgültige Bewertung sollte es ebenfalls tun.
Astras Rückgang kann anhand dieses Experiments allein nicht auf die Kontextlänge zurückgeführt werden.
Um Kausalität festzustellen, wären kontrollierte Vergleiche erforderlich, etwa:
gleiches Modell
gleiche Partien
gleiche Tools
gleiches Prompting

Lauf A: kleines / aggressiv zusammengefasstes Gedächtnis
Lauf B: großer unbereinigter Speicher
oder:
gleiches Modell
gleiche Lernstrategie
gleicher Gegnerplan

Lauf A: 258K-Kontextkonfiguration
Lauf B: 1M-Kontextkonfiguration
Erst dann ließen sich Kontextgröße und andere Faktoren voneinander trennen, darunter:
- Unterschiedliche Strategien beim Erstellen von Notizen.
- Unterschiedliche Gegnerauswahl.
- Zufällige Varianz zwischen Partien.
- Prompt Drift.
- Schwache Selbstevaluierung.
- Die Ansammlung fehlerhafter strategischer Annahmen.
Astra unterstützt selbst ein deutlich größeres Kontextfenster
Es gibt zudem eine wichtige Klarstellung auf Produktebene.
Die aktuelle API-Dokumentation von OpenAI führt GPT-6 Astra mit einem Kontextfenster von 1.050.000 Tokens.
Der Benchmark-Screenshot zeigte einen Astra-Lauf, der auf ungefähr 258K konfiguriert war, während Gostev sich in Codex auf ungefähr 272K bezog.
Das Experiment testete Astra somit nicht mit seiner maximalen API-Kontextgröße.
Das ist wichtig, denn die korrekte Interpretation der Überschrift sollte lauten:
Astra verschlechterte sich in dieser konkreten Agentenkonfiguration mit persistentem Speicher.
und nicht:
Astras Architektur kann lange Kontexte nicht verarbeiten.
Das sind sehr unterschiedliche Behauptungen.
Ein GPT-6.1-Sol-Lauf mit 1M Kontext wurde hinzugefügt
Gostev reagierte auf die Kontextfrage, indem er einen weiteren Track hinzufügte.
Die Quelle berichtet, dass er einen GPT-6.1-Sol-Lauf mit einer deutlich größeren Kontextkonfiguration ankündigte und dass die Benchmark-Seite kurz darauf eine dedizierte Long-Context-Spur von ungefähr 828K zeigte.
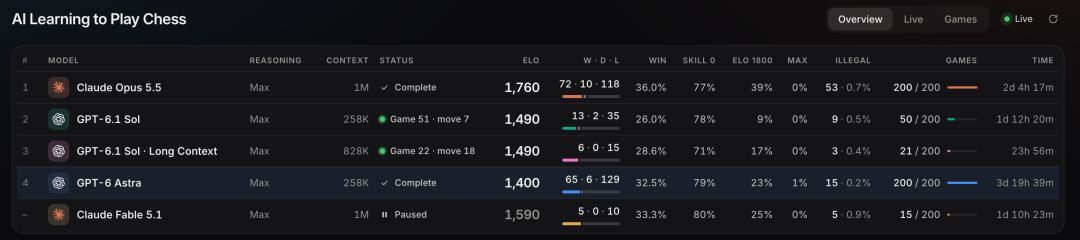
Zum Zeitpunkt, an dem der Quellartikel verfasst wurde, hatten GPT-6.1 Sol und Claude Fable 5.1 nur einen kleinen Teil der 200 Partien absolviert.
Die Momentaufnahme des Dashboards enthielt:
| Modell | Partien in der Momentaufnahme der Quelle | Ungefähre Elo | Status |
|---|---|---|---|
| Claude Opus 5.5 | 200 | 1760 | Abgeschlossen |
| GPT-6 Astra | 200 | 1400 | Abgeschlossen |
| GPT-6.1 Sol | ~50 | ~1490 | Läuft |
| GPT-6.1 Sol Long Context | ~21 | ~1490 | Läuft |
| Claude Fable 5.1 | 15 | ~1590 | Pausiert |
Diese unvollständigen Läufe waren zu früh, um dieselbe Art von Verlaufsanalyse wie bei den abgeschlossenen Opus- und Astra-Läufen zu stützen.
OpenAI dokumentiert GPT-6.1 Sol inzwischen offiziell mit einem Kontextfenster von 1,05 Millionen Tokens. Damit ist die Long-Context-Spur eine nützliche Weiterentwicklung, die es zu beobachten gilt – sie benötigt jedoch weiterhin genügend Partien und eine kontrollierte Analyse, bevor sie die Kausalfrage beantworten kann.
Kann eine KI mit festen Gewichten tatsächlich aus Fehlschlägen lernen?
Das ist die größere Frage hinter dem Schachexperiment.
Konventionelles Modelltraining endet vor der Bereitstellung.
Sobald die Gewichte festgelegt sind, schreibt das Modell sich normalerweise nicht nach jedem Gespräch dauerhaft um.
Es gibt jedoch eine andere Form der Anpassung:
In-Context Learning.
Ein Modell kann neue Informationen lesen, sie in seinem Arbeitskontext oder in persistenten Dateien behalten und sich später anders verhalten, ohne seine Parameter zu verändern.
Der Schachbenchmark überträgt diese Idee auf viele wiederholte Versuche.
Das Modell kann eine Niederlage erleben, etwas notieren und die Lektion in eine spätere Partie übertragen.
Die Sequenz sieht so aus:
Partie 1
→ verlieren
→ Beobachtungen festhalten

Partie 2
→ frühere Notizen lesen
→ etwas anderes versuchen
→ Notizen aktualisieren

Partie 3
→ angesammelte Erfahrung wiederverwenden
→ fortfahren
Wenn sich die Leistung mit der Zeit verbessert, zeigt das System eine praktische Form des Lernens, obwohl seine neuronalen Gewichte unverändert bleiben.
Oriol Vinyals bezeichnete es als guten Benchmark für In-Context Learning
Oriol Vinyals kommentierte das Experiment ebenfalls und bezeichnete es als vielversprechenden Benchmark für In-Context Learning.
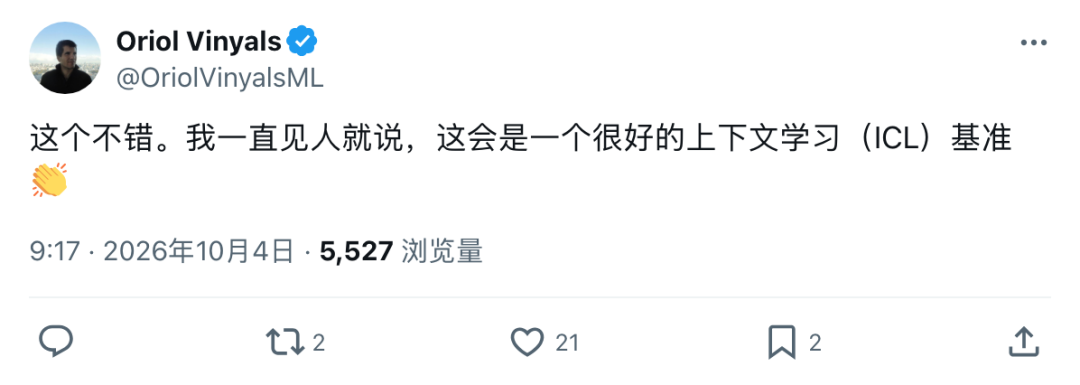
Diese Einordnung ist nützlich, weil sie das Ergebnis nicht überhöht.
Der Benchmark demonstriert keine autonomen Aktualisierungen der Gewichte.
Er testet, ob ein Modell ein eigenes Gerüst um feste Gewichte aufbauen kann:
Notizen
+ Dateien
+ wiederholte Versuche
+ Selbstreflexion
+ Rückmeldung aus der Umgebung
und dieses Gerüst zur Verbesserung einsetzen kann.
Gostevs ursprünglicher Beitrag trifft dieselbe Unterscheidung.
Er stellte fest, dass wir im stärksten Sinn weiterhin kein echtes kontinuierliches Lernen besitzen. Ein Modell könnte jedoch einen Teil dieses Verhaltens annähern, indem es ein externes Gedächtnis aufbaut und darüber lernt.
Opus verbesserte sich, aber das bedeutet nicht, dass „Selbstevolution“ gelöst ist
Die Quelle endet mit einer optimistischen Einschätzung: Vielleicht können Modelle durch wiederholte Erfahrung stärker werden, ohne dass Menschen sie neu trainieren.
Das Experiment liefert einige Hinweise auf diese Möglichkeit.
Es löst das Problem jedoch nicht abschließend.
Mehrere Einschränkungen bleiben bestehen.
1. Dies ist nur eine Aufgabe
Schach ist strukturiert, deterministisch und liefert klares Feedback.
Aus wiederholten Schachpartien zu lernen, unterscheidet sich von der Verbesserung bei mehrdeutigen realen Aufgaben in Forschung, Programmierung, Medizin oder Geschäftsanwendungen.
2. Die Modelle wählten ihr eigenes Curriculum
Das gehört zum Experiment, erschwert aber auch Vergleiche.
Wenn Opus und Astra zu unterschiedlichen Zeitpunkten unterschiedliche Gegnerstärken auswählten, waren sie nicht denselben Trainingssequenzen ausgesetzt.
3. Elo ist eine interne Benchmark-Metrik
Die angezeigte Elo ist für die Verfolgung des Laufs nützlich, stellt jedoch keine standardisierte menschliche Wertung dar.
4. Vollständige Gedächtnis-Ablationen liegen noch nicht vor
Um zu wissen, ob die Notizen die Verbesserung verursachten, wären Vergleiche erforderlich mit:
- Keinen Notizen.
- Zufällig angeordneten Notizen.
- Komprimierten Notizen.
- Von Menschen geschriebenen Notizen.
- Zurücksetzungen auf einen frischen Kontext.
- Größeren und kleineren Kontextfenstern.
5. Verbesserung kann neben grundlegenden Fehlern bestehen
Opus gewann deutlich hinzu, während es weiterhin ungültige Züge versuchte.
Das bedeutet, dass „besser“ nicht gleichbedeutend mit stabiler Beherrschung jeder Teilfähigkeit ist.
6. Langer Speicher kann helfen oder schaden
Ein persistentes Notizbuch ist nicht automatisch nützlich.
Der Astra-Lauf erinnert daran, dass selbst erzeugte Erinnerungen ebenso leicht Fehler wie hilfreiche Lektionen ansammeln können.
Ein zukünftiger Agent für kontinuierliches Lernen muss möglicherweise nicht nur lernen, was er speichern soll, sondern auch:
- Was gelöscht werden sollte.
- Was zusammengefasst werden sollte.
- Welche Überzeugungen revidiert werden müssen.
- Welche Erfahrungen irreführend waren.
- Wie vorübergehende Taktiken von dauerhaften Prinzipien getrennt werden können.
Dadurch könnte das Gedächtnismanagement zu einem der zentralen Probleme langlaufender KI-Agenten werden.
Das interessanteste Ergebnis ist die Divergenz
Hätten sich beide Modelle stetig verbessert, wäre die Schlussfolgerung einfach: Persistente Notizen helfen.
Hätten sich beide stetig verschlechtert, wäre die Schlussfolgerung ebenso einfach: Unkontrollierte Speicheranhäufung schadet.
Stattdessen erzeugte der Benchmark zwei gegensätzliche Kurven.
Das ist wissenschaftlich interessanter.
Es legt nahe, dass die Fähigkeit, von Erfahrung zu profitieren, von mehr als der verfügbaren Kontextlänge abhängen kann.
Das Modell muss innerhalb dieses Kontexts einen nützlichen Lernprozess aufbauen.
Ein leistungsfähiger persistenter Agent müsste möglicherweise in allen folgenden Bereichen gut sein:
Fehler beobachten
→ die richtige Lektion identifizieren
→ sie kompakt speichern
→ sie später abrufen
→ Überanpassung an eine einzelne Episode vermeiden
→ schlechte Erinnerungen revidieren
→ die Lektion in einer neuen Situation anwenden
Das kommt einem Lernsystem deutlich näher als einem statischen Chatbot – selbst wenn sich die Gewichte nie verändern.
FAQ
Was war das KI-Experiment zum Schachlernen?
Peter Gostev ließ KI-Agenten an der technologischen Spitze bis zu 200 Partien gegen unterschiedliche Stockfish-Schwierigkeitsstufen spielen, während sie zwischen den Partien Notizen behalten konnten. Die Modelle wurden während des Laufs nicht feinabgestimmt und durften keine Schach-Engine zur Auswahl ihrer Züge verwenden.
Hat Claude Opus 5.5 wirklich etwa 250 Elo gewonnen?
Innerhalb der eigenen geschätzten Elo-Metrik des Benchmarks lautet die Antwort ja: Die Quelle berichtet, dass Opus von ungefähr 1500 auf etwa 1760 stieg und einen Höchstwert von rund 1840 erreichte. Diese Zahl ist eine interne experimentelle Wertung auf Grundlage jüngster Partien gegen Stockfish mit begrenzter Spielstärke und sollte nicht als offizielle menschliche FIDE-Wertung verstanden werden.
Warum wurde GPT-6 Astra über 200 Partien schlechter?
Das Experiment belegt keine bestätigte Ursache. Gostev vermutete, dass angesammelte Notizen im Codex-Kontext dazu beigetragen haben könnten. Auch die Qualität der Notizen, die Gegnerauswahl, Prompt Drift, zufällige Varianz oder andere Faktoren können jedoch relevant sein.
Hat GPT-6 Astra nur ein Kontextfenster von 272K?
Nein. OpenAI dokumentiert GPT-6 Astra derzeit mit einem Kontextfenster von 1,05 Millionen Tokens. Die im Experiment diskutierte Zahl von ungefähr 258K/272K bezieht sich auf die für diesen Lauf verwendete Codex- oder Benchmark-Konfiguration, nicht auf Astras maximales API-Kontextfenster.
Ist Claude Opus 5.5 offiziell veröffentlicht?
Ja. Anthropic stellte Claude Opus 5.5 offiziell am 22. September 2026 vor. Das Unternehmen positioniert es als bedeutendes Upgrade gegenüber Opus 5 und dokumentiert es für Coding- und agentische Workloads.
Was bedeutet In-Context Learning in diesem Experiment?
In-Context Learning bedeutet, dass ein Modell sein Verhalten mithilfe von Informationen verändert, die in seinem Kontext oder in persistenten Dateien verfügbar sind, ohne seine Gewichte des neuronalen Netzwerks zu aktualisieren. Hier fungieren die Schachpartien und Notizen als angesammelte Erfahrung, die spätere Partien beeinflussen kann.
Warum wurde Stockfish mit voller Spielstärke aus der Elo-Berechnung ausgeschlossen?
Der Benchmark nutzt schwächere Stockfish-Konfigurationen, um für Sprachmodelle einen messbaren Leistungsbereich zu erzeugen. Stockfish mit voller Spielstärke ist dem aktuellen Schachspiel von Sprachmodellen weit überlegen. Würden diese Partien direkt in die experimentelle Elo-Schätzung einbezogen, wäre dies für die Beobachtung von Verbesserungen weniger aussagekräftig.
Beweist dieses Experiment, dass KI sich kontinuierlich selbst verbessern kann?
Nein. Es zeigt, dass sich mindestens ein Modelllauf durch persistenten Kontext und wiederholte Erfahrung bei einer strukturierten Aufgabe deutlich verbesserte. Um robustes kontinuierliches Lernen nachzuweisen, wären kontrollierte Experimente über viele Aufgaben, Speicherstrategien, Modellkonfigurationen und wiederholte Läufe hinweg erforderlich.
Verwandte Tools
- Stockfish: Die Open-Source-Schach-Engine, die im Experiment als Gegner eingesetzt wurde.
- Claude Code: Anthropics agentische Terminalumgebung, die für die Claude-Schachläufe verwendet wurde.
- OpenAI Codex: OpenAIs Coding-Agent-Umgebung, die für die GPT-Schachläufe verwendet wurde.
- Claude Opus 5.5: Anthropics offizielle Seite für das im abgeschlossenen Claude-Lauf verwendete Opus-Modell.
- GPT-6 Astra: OpenAIs offizielle Modellseite mit aktuellen Spezifikationen zu Kontextfenster und API.
- GPT-6.1 Sol: OpenAIs offizielle Modellseite für das Nachfolgemodell Sol, das in späteren Benchmark-Spuren getestet wurde.
Weiterführende Links
- KI lernt Schach zu spielen: Die Live-Benchmark-Website, auf die Peter Gostev und der Quellartikel verweisen.
- Peter Gostevs X-Profil: Der öffentliche Account des Experimenterstellers, auf dem Benchmark-Updates und Kommentare zur Methodik veröffentlicht wurden.
- Ankündigung von Claude Opus 5.5: Anthropics offizielle Veröffentlichungsinformationen zu Opus 5.5 vom September 2026.
- Offizielle Ankündigung von GPT-6 Astra: OpenAIs offizielle Startseite für GPT-6 Astra.
- Offizielle Ankündigung von GPT-6.1 Sol: OpenAIs offizielle Veröffentlichungsseite für das spätere, zum Experiment hinzugefügte Sol-Modell.
- Stockfish 19: Offizielle Informationen zur Stockfish-Veröffentlichung und Diskussion der aktuellen Engine-Stärke.
- Claude-Code-Dokumentation: Offizielle Dokumentation zur Einrichtung und Nutzung von Claude Code.
- Ursprünglicher BAAI-Community-Artikel: Der deutschsprachig nicht vorliegende Quellartikel, der für diese Mikroumschreibung verwendet wurde.
Zusammenfassung
Peter Gostevs Schachexperiment gab Claude Opus 5.5 und GPT-6 Astra wiederholt Gelegenheit, aus ihren eigenen Partien zu lernen, ohne die Modellgewichte zu verändern. Die experimentelle Elo von Opus stieg von ungefähr 1500 auf 1760, während Astra früh einen Höchstwert erreichte und bis Partie 200 auf 1400 zurückfiel.
Das Ergebnis ist nicht deshalb interessant, weil es abschließend klärt, welches Modell „besser Schach spielt“. Es legt vielmehr eine tiefere Frage zu persistenten Agenten offen: Kann ein Modell über Notizen, Dateien und wiederholtes Feedback nützliche Erfahrung aufbauen – und kann es verhindern, dass dieses Gedächtnis verrauscht oder aktiv schädlich wird?
Der Rückgang von Astra bleibt ungeklärt. Kontextanhäufung ist eine plausible Hypothese, doch kontrollierte Experimente zu Speicher und Kontextfenstern sind erforderlich, bevor eine kausale Behauptung aufgestellt werden kann.
Die wichtigste Erkenntnis dieses Benchmarks lautet, dass feste Modellgewichte kein festes Verhalten garantieren: Was ein Agent erinnert, wie er dieses Gedächtnis organisiert und wie er aus Fehlern lernt, kann die Leistung im Zeitverlauf deutlich nach oben – oder unten – bewegen.