Anthropic erklärte, dass Claude Sonnet 5.5 und Haiku 5.5 Opus 5.5 „in den kommenden Wochen“ folgen würden.
Sonnet 5.5 erschien nur sechs Tage später.
Das neue Claude-Modell der mittleren Preisklasse ist nicht einfach eine kleinere Version von Opus 5.5. Bei einigen Programmier-Benchmarks erzielt es tatsächlich höhere Ergebnisse.
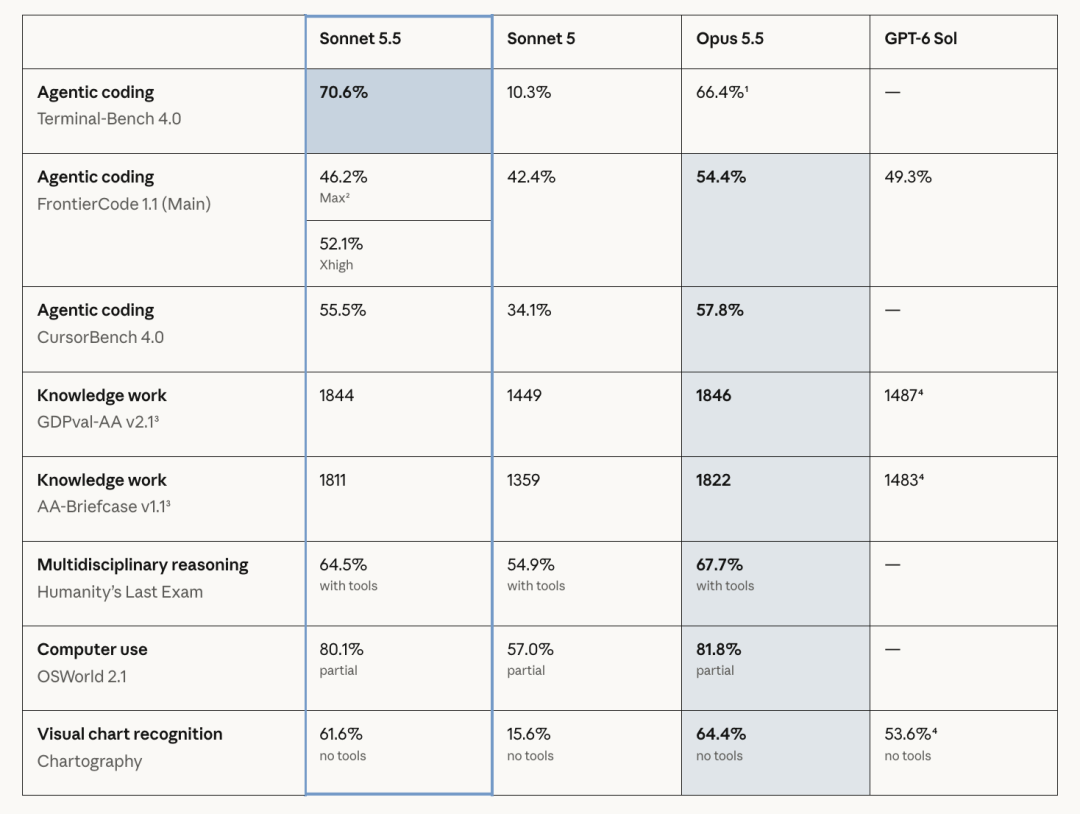
Das auffälligste Beispiel ist der Terminal-Bench 4.0:
Claude Sonnet 5.5: 70,6 %
Claude Opus 5.5:   66,4 %
Claude Sonnet 5:   10,3 %
Bei umfassenderer professioneller Arbeit liegt Opus 5.5 jedoch weiterhin knapp vorn.
Anthropic berichtet:
GDPval-AA v2.1
Opus 5.5:   1846 Elo
Sonnet 5.5: 1844 Elo

OSWorld 2.1
Opus 5.5:   81,8 %
Sonnet 5.5: 80,1 %
Damit liegt Sonnet 5.5 bei mehreren messbaren Aufgaben ungewöhnlich nah am Spitzenmodell von Anthropic und bleibt zugleich in der günstigeren Sonnet-Preisklasse.
Der Unterschied zwischen den Modellen bleibt jedoch relevant.
Anthropic zufolge ist Opus 5.5 weiterhin deutlich stärker bei komplexer, offener Arbeit, die über längere Zeit ein konsistentes Urteilsvermögen erfordert. Sonnet 5.5 richtet sich stärker an klar abgegrenzte Alltagsaufgaben wie:
- Programmieren
- Fehlerbehebung
- Code-Reviews
- Dokumente
- Präsentationen
- Tabellenkalkulationen
- Strukturierte Agentenaufgaben
- Schnelle iterative Arbeitsabläufe
Die sinnvolle Schlussfolgerung lautet daher nicht, dass Sonnet 5.5 Opus „ersetzt“ hat.
Vielmehr ist der Leistungsabstand bei vielen routinemäßigen und programmierintensiven Arbeitslasten deutlich kleiner geworden.
Der ursprüngliche Artikel beschreibt Sonnet 5.5 als den „mittleren Becher“, der dem „großen Becher“ hinterherjagt.
Diese Metapher passt überraschend gut zur Benchmark-Tabelle.
| Bewertung | Sonnet 5.5 | Opus 5.5 | Sonnet 5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 66,4 % | 10,3 % | — |
| FrontierCode 1.1 Main | 52,1 % bei Xhigh | 54,4 % | 42,4 % | bis zu 52,1 % |
| CursorBench 4.0 | 55,5 % | 57,8 % | 34,1 % | — |
| GDPval-AA v2.1 | 1844 | 1846 | 1449 | 1487 |
| Humanity's Last Exam | 64,5 % | 67,7 % | 54,9 % | — |
| OSWorld 2.1 | 80,1 % | 81,8 % | 57,0 % | — |
| Chartography | 61,6 % | 64,4 % | 15,6 % | 53,6 % |
Die Tabelle zeigt das tatsächliche Muster.
Sonnet 5.5 gewinnt einen wichtigen Programmier-Benchmark eindeutig, kommt bei mehreren anderen sehr nah heran, übertrifft Opus 5.5 jedoch nicht durchgängig.
Anthropic selbst trifft dieselbe Unterscheidung: Benchmark-Werte sind nur eine Perspektive auf die Modellqualität, und Opus bleibt stärker, wenn eine Aufgabe unklar oder offen angelegt ist oder über einen längeren Zeitraum hinweg ein konsistentes Urteilsvermögen erfordert.
Sonnet 5.5 nutzt Tools effizienter
Das Upgrade betrifft nicht nur die reinen Punktzahlen.
Frühe Tester stellten außerdem fest, dass Sonnet 5.5 seine Arbeitsweise verändert.
Im Vergleich zu Sonnet 5 fasst das Modell Tool-Aufrufe eher zusammen, wenn Aufgaben parallel ausgeführt werden können, statt alles Schritt für Schritt nacheinander zu verarbeiten.
Das Kundenfeedback von Anthropic enthält eine Programmierbewertung, bei der Sonnet 5.5 Folgendes nutzte:
~1/3 weniger Tool-Aufrufe
~1/2 so viele Shell-Ausführungen
um dieselbe Art von Aufgabe abzuschließen.
Das ist für Agentensysteme relevant, weil jeder zusätzliche Tool-Aufruf Folgendes verursachen kann:
- Latenz
- Token-Verbrauch
- Infrastrukturkosten
- Fehlerrisiko
- Zusätzlichen zu verwaltenden Zustand
Ein Modell, das mit weniger Tool-Interaktionen dasselbe Ergebnis erreicht, kann spürbar günstiger sein, selbst wenn sich der angegebene Token-Preis nicht verändert.
Base44: Ähnliche Ergebnisse mit halb so vielen Iterationen
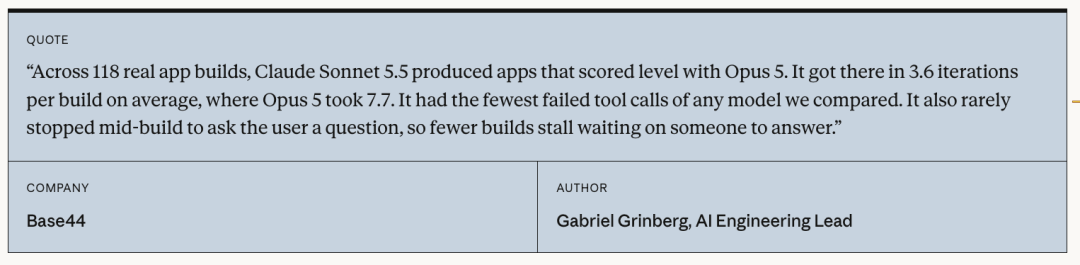
Base44 testete Sonnet 5.5 anhand von 118 realen Aufgaben zur Anwendungsentwicklung.
Das gemeldete Ergebnis war besonders praxisnah.
Sonnet 5.5 erzeugte Anwendungen, die auf demselben Niveau wie Opus 5 bewertet wurden, benötigte dafür jedoch:
Sonnet 5.5:
3,6 Iterationen pro Build im Durchschnitt

Opus 5:
7,7 Iterationen pro Build im Durchschnitt
Base44 erklärte außerdem, dass Sonnet 5.5 im Vergleich die wenigsten fehlgeschlagenen Tool-Aufrufe aufwies.
Das erinnert daran, dass sich die „Modellkosten“ nicht nur aus Folgendem zusammensetzen:
Preis der Eingabe-Token
+
Preis der Ausgabe-Token
Bei realen Agenten-Workflows hängen die Gesamtkosten außerdem von Folgendem ab:
Anzahl der Iterationen
Anzahl der Tool-Aufrufe
Fehlgeschlagene Aktionen
Wiederholungen
Menschliche Unterbrechungen
Zeit bis zum akzeptierten Ergebnis
Wenn ein Modell eine Aufgabe mit halb so vielen Iterationen abschließt, kann der effektive Kostenunterschied deutlich größer sein, als die API-Preistabelle vermuten lässt.
Epic Games setzte das Modell an großen Codebasen ein
Epic Games testete Sonnet 5.5 an deutlich größeren Softwaresystemen.
Dem von Anthropic veröffentlichten Kundenfeedback zufolge bewältigte das Modell Zehntausende Zeilen Gameplay-Systemcode und arbeitete dabei an Aufgaben wie:
- Audits des Systemdesigns
- Überprüfungen von Datenflüssen
- Mehrstündige Programmieraufgaben
Epic Games erklärte, dass das Modell eine Qualität erreichte, die normalerweise von einem höher eingestuften Modell erwartet wird, und dafür weniger präzise Vorgaben im Prompt benötigte.
Genau bei solchen Arbeitslasten kann ein kleineres Modell besonders wertvoll werden.
Ein Entwickler kann weiterhin Opus 5.5 verwenden wollen, um die Architektur festzulegen oder die schwierigsten unklaren Probleme zu lösen. Sonnet 5.5 kann jedoch deutlich mehr Implementierungs- und Review-Arbeit zu geringeren Kosten übernehmen.
Unity zählt eine Aufgabe erst, wenn das Projekt ausgeführt wird
Unity verwendete einen strengeren Abschlussstandard.
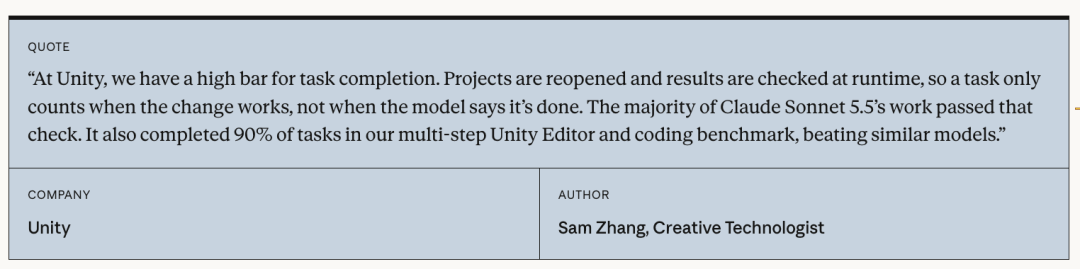
Statt einen Code-Patch einfach deshalb zu akzeptieren, weil das Modell erklärte, es sei fertig, öffnete Unity das Projekt erneut und überprüfte, ob das Ergebnis zur Laufzeit tatsächlich funktionierte.
Bei dieser Bewertung schloss Sonnet 5.5 in Unitys mehrstufigem Editor- und Programmier-Benchmark Folgendes ab:
90 %
Eine solche Prüfung ist aussagekräftiger als die reine Qualität der Codegenerierung.
Ein Patch kann korrekt aussehen und trotzdem scheitern, etwa wegen:
- Fehlender Abhängigkeiten
- Eines falschen Projektzustands
- Build-Fehlern
- Annahmen zur Laufzeit
- Fehlern bei der Tool-Nutzung
- Änderungen außerhalb des angeforderten Umfangs
Unitys Benchmark versucht, die tatsächliche End-to-End-Aufgabe zu messen und nicht nur die textuelle Antwort.
Sonnet 5.5 kann Pokémon Red anhand von Screenshots abschließen
Anthropic setzte außerdem eine seiner wiederkehrenden Demonstrationen für langfristige Aufgaben fort.
Sonnet 5.5 war das erste Sonnet-Modell der Claude-Familie, das Pokémon Red besiegte, während es ausschließlich mit Screenshots arbeitete.
Dieser Test ist nicht direkt als Programmier-Benchmark geeignet.
Sein Wert liegt woanders.
Das Spiel verlangt vom Modell:
- Einen visuellen Zustand zu interpretieren
- Sich an langfristige Ziele zu erinnern
- Über viele Schritte hinweg zu planen
- Sich von Fehlern zu erholen
- Über einen langen Zeitraum weiterzuarbeiten
Dieselben Eigenschaften sind für Computer-Use-Agenten und lang laufende Software-Workflows relevant.
Auch Design- und Büroaufgaben wurden verbessert
Der ursprüngliche Artikel weist darauf hin, dass Sonnet 5.5 nicht nur beim Programmieren leistungsfähiger ist.
Anthropic positioniert das Modell auch für hochwertige Dokumente, Präsentationen, Tabellenkalkulationen und visuelle Aufgaben.
Das Modell ist darauf ausgelegt, bestehende visuelle Konventionen zu befolgen, anstatt jedes Artefakt von Grund auf neu zu erstellen.
Wenn beispielsweise eine vorhandene Präsentationsvorlage vorgegeben wird, kann es weiterhin Folgendes verwenden:
- Layout
- Abstände
- Visuelle Hierarchie
- Stilkonventionen
- Gestaltungssprache
Anthropic zufolge reduziert dies den manuellen Nachbearbeitungsaufwand nach der Erstellung.
Damit ist Sonnet 5.5 besonders für Geschäftsprozesse relevant, bei denen die Aufgabe klar definiert ist, aber dennoch visuelle Konsistenz erfordert.
Der API-Preis wurde nicht erhöht
Trotz des Leistungssprungs behält Sonnet 5.5 die grundlegenden API-Preise von Sonnet 5 bei.
Anthropic nennt derzeit:
| Token-Typ | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Eingabe | 2 $ / 1 Mio. | 4 $ / 1 Mio. |
| Ausgabe | 10 $ / 1 Mio. | 20 $ / 1 Mio. |
| Cache-Lesen | 0,20 $ / 1 Mio. | 0,20 $ / 1 Mio. |
| Cache-Schreiben | 2,50 $ / 1 Mio. | 5 $ / 1 Mio. |
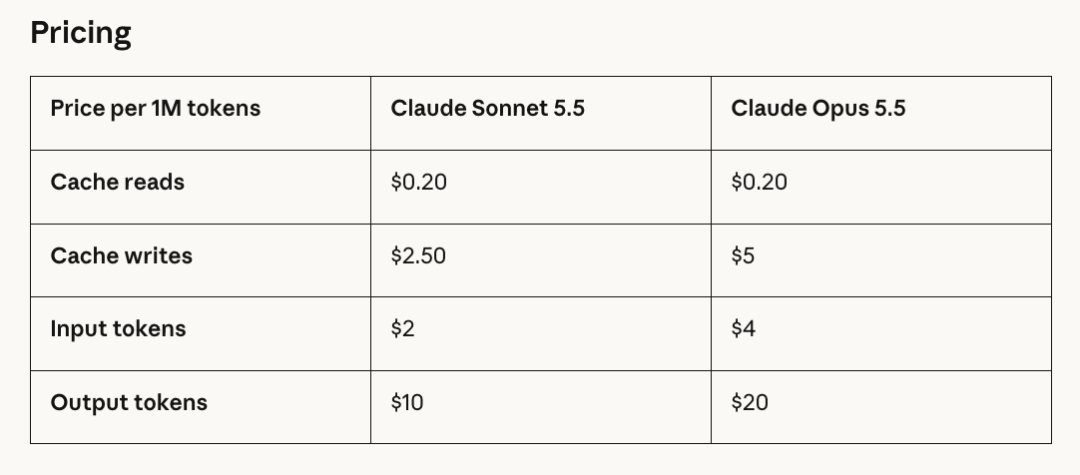
Auf Listenpreisebene kosten Standard-Eingabe- und -Ausgabe-Token von Sonnet 5.5 exakt halb so viel wie bei Opus 5.5.
Anthropic legt inzwischen jedoch größeren Wert auf eine andere Kennzahl:
Kosten pro abgeschlossener Aufgabe.
Die Kosten pro Aufgabe sind niedriger, obwohl die Token-Preise gleich geblieben sind
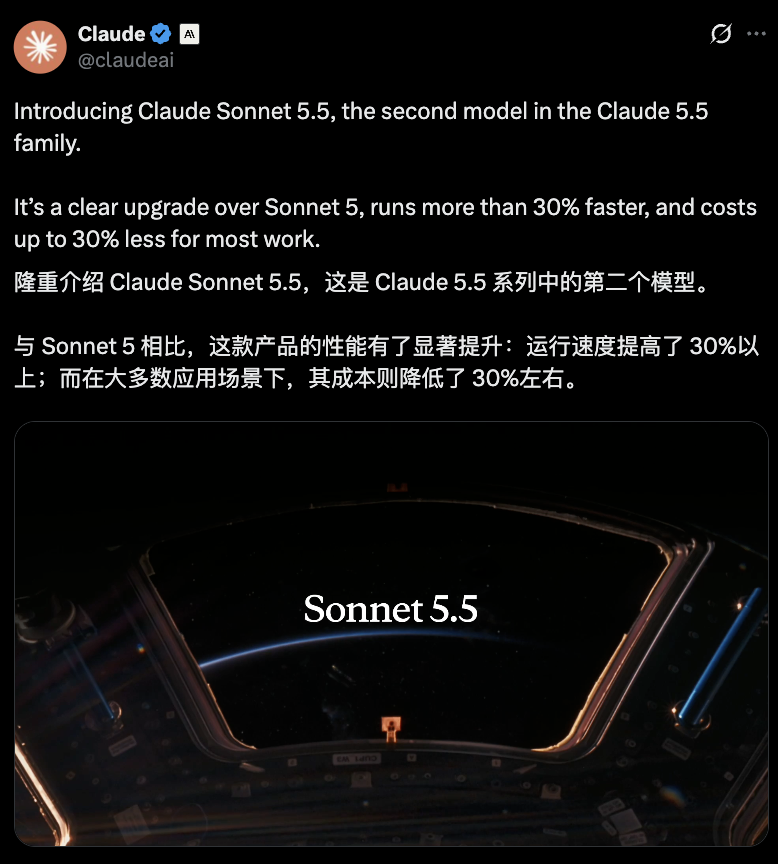
Anthropic zufolge erzeugt Sonnet 5.5 Ausgaben mehr als 30 % schneller als Sonnet 5.
Außerdem benötigt das Modell nach Angaben von Anthropic typischerweise weniger Token und weniger Schritte, um dieselbe Arbeit abzuschließen.
Daher berichtet Anthropic, dass Sonnet 5.5 für die meisten Arbeitslasten Folgendes kosten kann:
bis zu 30 % weniger pro Aufgabe
als Sonnet 5.
Wer ausschließlich auf den Token-Tarif von 2 $ / 10 $ schaut, übersieht daher einen Teil des Upgrades.
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Der nominale Tarif ist gleich geblieben.
Der Umfang der vom Modell benötigten Arbeit zum Abschluss einer Aufgabe ist gesunken.
Terminal-Bench: Mittlerer Aufwand kann Sonnet 5 bei einem Bruchteil der Kosten übertreffen
Anthropic stellt inzwischen mehrere Aufwandsstufen bereit.
Ein höherer Aufwand ermöglicht es dem Modell, länger zu schlussfolgern und mehr Arbeit zu überprüfen.
Ein geringerer Aufwand macht es schneller und günstiger.
In Claude Code und den Verbraucher-Apps von Anthropic ist der Standardaufwand Mittel. Auf der Claude-Plattform ist der Standard Hoch.
Im Terminal-Bench 4.0 zeigt die Kosten-Leistungs-Grafik von Anthropic, dass Sonnet 5.5 mit mittlerem Aufwand bereits das beste Ergebnis von Sonnet 5 übertrifft und pro Versuch ungefähr ein Zehntel davon kostet.
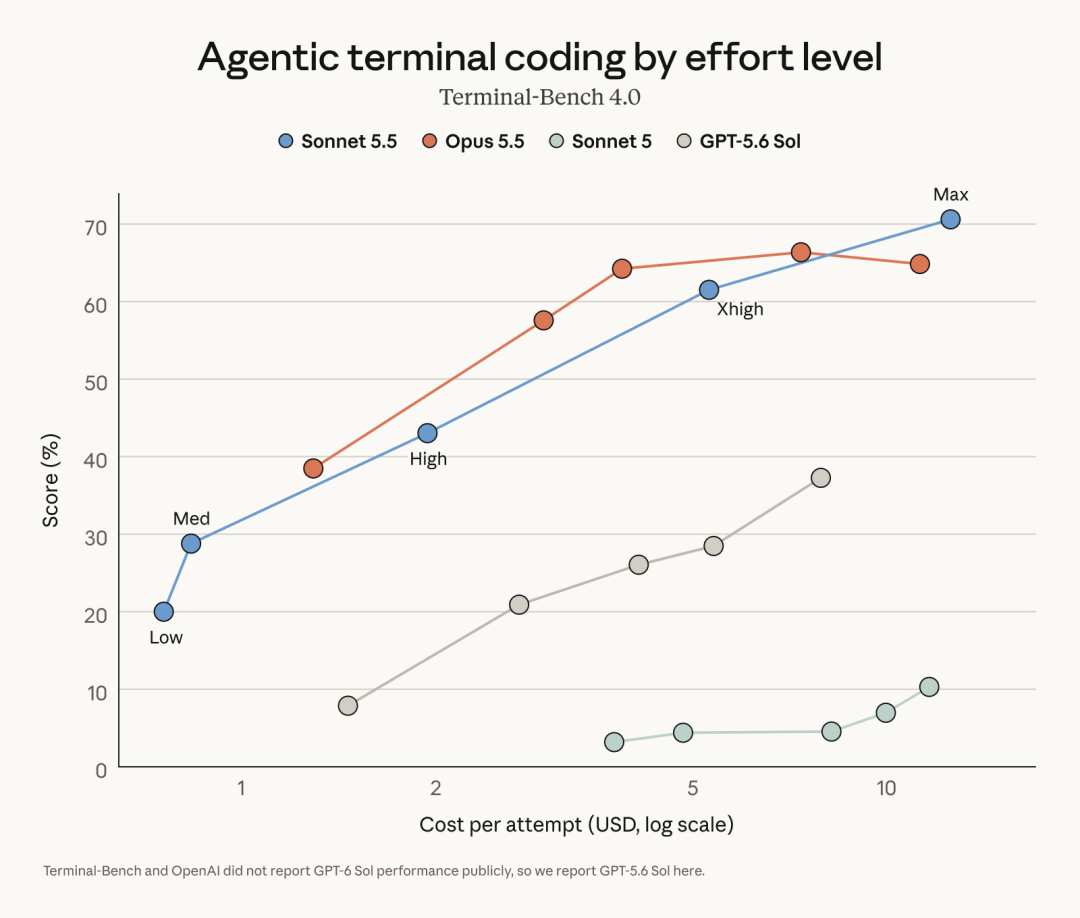
Die wichtige Erkenntnis lautet nicht, dass „Mittel“ immer die richtige Einstellung ist.
Vielmehr kann ein Entwickler Qualität und Kosten nun direkter steuern.
Für routinemäßige Programmieraufgaben kann eine niedrigere Aufwandsstufe bereits ausreichen.
Bei schwierigen Aufgaben gibt ein höherer Aufwand Sonnet mehr Zeit zum Schlussfolgern.
CursorBench zeigt ein ähnliches Muster
CursorBench 4.0 bewertet Programmierarbeit anhand realer Cursor-Sitzungen.
Sonnet 5.5 erreicht:
55,5 %
im Vergleich zu:
57,8 %
für Opus 5.5.
Die Kostengrafik von Anthropic zeigt, dass Sonnet 5.5 selbst bei relativ geringem Aufwand Sonnet 5s bestes Ergebnis für ungefähr ein Zehntel der Kosten pro Aufgabe übertreffen kann.
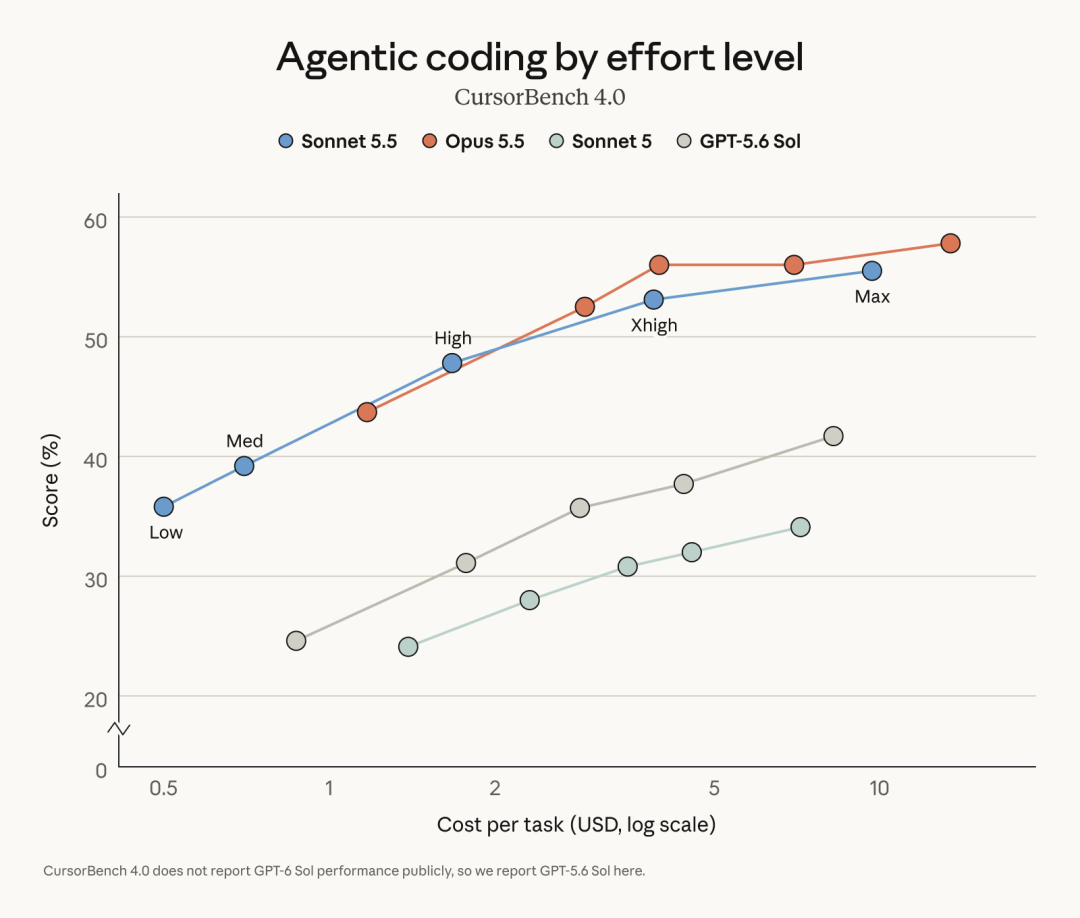
Hier wird das neue Sonnet besonders attraktiv.
Der absolute Benchmark-Abstand zu Opus kann so klein sein, dass das günstigere Modell für Programmieraufgaben mit hohem Volumen häufig die bessere Wahl für den produktiven Einsatz ist.
FrontierCode vergleicht Sonnet 5.5 mit GPT-6 Sol
Der ursprüngliche Artikel widmet FrontierCode 1.1 besondere Aufmerksamkeit, weil der Vergleich GPT-6 Sol einschließt.
Die veröffentlichte Grafik von Anthropic zeigt, dass Sonnet 5.5 bei einem Xhigh-Aufwand sein bestes FrontierCode-Ergebnis erreicht, während verschiedene Aufwandsstufen von GPT-6 Sol in einem ähnlichen Ergebnisbereich liegen.
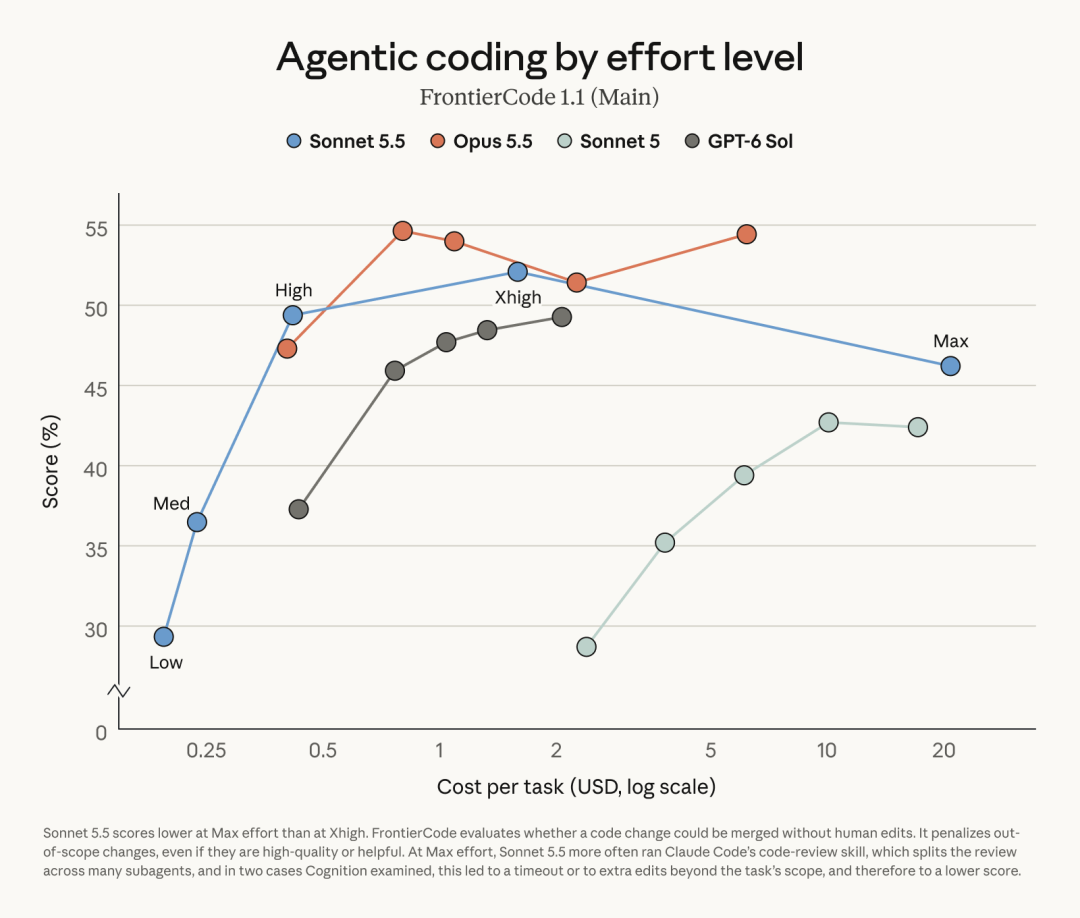
Bei hohem Aufwand liegt Sonnet 5.5 bereits ungefähr im Ergebnisbereich der stärkeren getesteten Einstellungen von GPT-6 Sol, während Anthropic deutlich niedrigere Kosten pro Aufgabe schätzt.
Der ursprüngliche Artikel fasst den Abstand für den in der Grafik von Anthropic hervorgehobenen vergleichbaren Punkt ungefähr so zusammen:
Aufgabenkosten von Sonnet 5.5:
~1/5 von GPT-6 Sol
Diese Zahl sollte als Benchmark-spezifischer Vergleich der Kosten pro Aufgabe verstanden werden, nicht als allgemeines Verhältnis der API-Preise.
Die Modelle:
- Haben unterschiedliche Preisstrukturen
- Verwenden unterschiedlich viel Schlussfolgerungsaufwand
- Erzeugen unterschiedlich viele Token
- Benötigen möglicherweise unterschiedlich viele Wiederholungen
- Werden bei bestimmten Aufwandsstufen miteinander verglichen
Daher ist es sicherer zu sagen, dass die Benchmark-Grafik von Anthropic zeigt, wie Sonnet 5.5 in diesem Versuchsaufbau eine ähnliche FrontierCode-Qualität bei deutlich niedrigeren gemessenen Aufgabenkosten erreicht.
Das bedeutet nicht, dass jede Sonnet-Arbeitslast exakt 80 % weniger kostet als GPT-6 Sol.
Sonnet 5.5 ersetzt Opus 5.5 nicht
Die Benchmark-Schlagzeilen machen es verlockend zu schlussfolgern, dass das günstigere Sonnet-Modell Opus überflüssig gemacht hat.
Anthropic weist diese Interpretation ausdrücklich zurück.
Die eigenen Tests und das Kundenfeedback zeigen weiterhin, dass Opus 5.5 bei Aufgaben deutlich stärker ist, die Folgendes erfordern:
- Offenes Schlussfolgern
- Länger anhaltendes Urteilsvermögen
- Unklarere Planung
- Architekturentscheidungen
- Komplexe Recherche
- Entscheidungsfindung über mehrere Schritte hinweg mit hohen Anforderungen
Eine praktische Strategie zur Modellzuordnung sieht daher eher so aus:
Opus 5.5
→ Architektur
→ Schwierige Planung
→ Unklare Recherche
→ Aufgaben mit höchster Komplexität

Sonnet 5.5
→ Implementierung
→ Fehlerbehebung
→ Reviews
→ Routinemäßige Agentenaufgaben
→ Dokumente und Büroarbeit
→ Programmieren mit hohem Volumen
Ein Anthropic-Kunde beschrieb die Beziehung ähnlich: Opus soll die Architektur definieren, anschließend soll Sonnet sie implementieren.
Das ist wahrscheinlich die nützlichste Art, die Familie 5.5 zu verstehen.
Sicherheitsvorkehrungen wurden parallel zur Programmierfähigkeit erweitert
Der ursprüngliche Artikel konzentriert sich hauptsächlich auf Leistung und Kosten, aber ein offizielles Detail ist erwähnenswert.
Anthropic erklärt, dass sich die Fähigkeiten von Sonnet 5.5 im Bereich Cybersicherheit so stark verbessert haben, dass es das erste Sonnet-Modell ist, das mit Cyber-Sicherheitsvorkehrungen und Fallback-Mechanismen startet, die denen der leistungsfähigsten Modelle von Anthropic ähneln.
Anthropic erklärt außerdem, dass die Schutzmaßnahmen auf eine begrenzte Gruppe risikoreicher Anfragen abzielen und routinemäßige Softwareentwicklung nicht beeinträchtigen sollen.
Das ist relevant, weil eine höhere Programmier- und Tool-Nutzungsleistung auch die Fähigkeit zur doppelten Verwendung im Sicherheitsbereich steigern kann.
Sonnet 5.5 ist auf den Claude-Plattformen verfügbar
Anthropic zufolge ist Sonnet 5.5 verfügbar über:
- Claude.ai
- Claude Code
- Claude Platform / API
- Amazon Web Services
- Google Cloud
- Microsoft Foundry
Die Modell-ID der API lautet:
claude-sonnet-5-5
Anthropic unterstützt für Sonnet 5.5 außerdem in geeigneten API-Konfigurationen die Aufbewahrung null Daten.
Teams, die von Sonnet 5 migrieren, empfiehlt Anthropic, die neuen Aufwandssteuerungen zu überprüfen und die Konfiguration zu überdenken, statt automatisch jede bisherige Laufzeiteinstellung unverändert zu übernehmen.
Haiku 5.5 folgt als Nächstes
Der Quellenartikel blickt abschließend auf das nächste Mitglied der Claude-5.5-Familie.
Anthropic erklärt, dass Haiku 5.5 in den kommenden Wochen folgen wird.
Seine Positionierung ist bereits klar:
hoher Durchsatz
+
kostenempfindliche Arbeitslasten
Wenn Sonnet 5.5 das schnelle Allzweck-Arbeitspferd und Opus 5.5 das Modell für schwierige offene Urteilsaufgaben ist, dürfte Haiku 5.5 die Wirtschaftlichkeit von Anwendungen mit hohem Volumen noch stärker in den Mittelpunkt rücken.
Die Richtung der Claude-5.5-Familie wird klarer.
Anthropic konkurriert nicht nur über reine Benchmark-Werte.
Die Modelle werden zunehmend anhand folgender Faktoren präsentiert:
Qualität
+
Geschwindigkeit
+
Kosten pro abgeschlossener Aufgabe
Für Entwickler könnte dies eine nützlichere Bereitstellungskennzahl sein als der Benchmark-Wert allein.
FAQ
Was ist Claude Sonnet 5.5?
Claude Sonnet 5.5 ist das neueste Sonnet-Modell von Anthropic und die zweite Veröffentlichung der Claude-5.5-Familie. Es wurde als schnelleres und kostengünstigeres Ergänzungsmodell zu Opus 5.5 für Programmierung, Agenten, Wissensarbeit, Dokumente, Präsentationen und andere klar abgegrenzte Aufgaben entwickelt.
Ist Sonnet 5.5 besser als Opus 5.5?
Bei einigen Benchmarks ja. Sonnet 5.5 erzielt im Terminal-Bench 4.0 70,6 % gegenüber 66,4 % bei Opus 5.5. Opus liegt bei den meisten umfassenderen Bewertungen jedoch weiterhin vorn und bleibt bei komplexer, offener Arbeit mit länger anhaltendem Urteilsvermögen stärker.
Wie viel kostet Claude Sonnet 5.5?
Anthropic nennt für die Standard-API einen Preis von 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Million Ausgabe-Token. Das Lesen aus dem Cache kostet 0,20 US-Dollar pro Million Token, das Schreiben in den Cache 2,50 US-Dollar pro Million Token.
Ist Sonnet 5.5 günstiger als Sonnet 5?
Die Token-Preise sind identisch, aber Anthropic zufolge verwendet Sonnet 5.5 typischerweise weniger Token und erledigt Aufgaben effizienter. Nach den Tests von Anthropic senkt dies bei vielen Arbeitslasten die Kosten pro Aufgabe um bis zu 30 %.
Wie viel schneller ist Sonnet 5.5?
Anthropic zufolge ist die Ausgabeerzeugung mehr als 30 % schneller als bei Sonnet 5. Externe Tester berichten außerdem bei vielen Programmieraufgaben von weniger Tool-Aufrufen, weniger Shell-Ausführungen und weniger Iterationen.
Wie schneidet Sonnet 5.5 im Vergleich zu GPT-6 Sol ab?
Die Kosten-Leistungs-Grafik von Anthropic für FrontierCode zeigt, dass Sonnet 5.5 in diesem Benchmark einen ähnlichen Qualitätsbereich wie die getesteten Einstellungen von GPT-6 Sol bei deutlich niedrigeren gemessenen Aufgabenkosten erreicht. Dies ist kein allgemeines Kostenverhältnis und sollte nicht als Beleg dafür verstanden werden, dass Sonnet bei jeder Programmier- oder Schlussfolgerungsaufgabe besser ist.
Welche Modell-ID sollten Entwickler verwenden?
Die offizielle Modell-ID der Claude-API lautet:
claude-sonnet-5-5
Anthropic erklärt, dass das Modell außerdem über AWS, Google Cloud und Microsoft Foundry verfügbar ist.
Wann wird Claude Haiku 5.5 veröffentlicht?
Anthropic erklärt, dass Haiku 5.5 in den kommenden Wochen erscheinen wird. Das Modell ist für Anwendungen mit hohem Durchsatz und kostenempfindliche Einsatzszenarien positioniert.
Verwandte Tools
- Claude: Die Benutzeroberfläche von Anthropic für die Arbeit mit Claude-Modellen.
- Claude Code: Die agentische Programmierumgebung von Anthropic für die Softwareentwicklung auf Repository-Ebene.
- Claude API: Offizielle API-Dokumentation für die Integration von
claude-sonnet-5-5in Anwendungen. - Amazon Bedrock: Die AWS-Plattform mit Claude-Modellen für Unternehmensanwendungen.
- Google Vertex AI: Die Google-Cloud-Plattform mit Zugriff auf Claude-Modelle.
- Microsoft Foundry: Die KI-Entwicklungsplattform von Microsoft mit Verfügbarkeit von Claude-Modellen.
Verwandte Links
- Originaler BAAI-Hub-Artikel: Der chinesischsprachige QbitAI-Artikel, der in dieser Veröffentlichung adaptiert und auf Fakten geprüft wurde.
- Anthropic — Claude Sonnet 5.5 wird vorgestellt: Primäre Ankündigung mit Benchmarks, Kundenbewertungen, Preisen, Diagrammen zu den Kosten pro Aufgabe und Sicherheitshinweisen.
- Claude-Sonnet-Produktseite: Offizielle Übersicht zu Einsatzbereichen, Verfügbarkeit und Preisen von Sonnet 5.5.
- Claude Opus 5.5: Offizielle Ankündigung von Opus 5.5 zum Vergleich mit dem Spitzenmodell von Anthropic.
- Anthropic-API-Dokumentation: Offizielle API-Dokumentation und Hinweise zur Modellintegration.
- Anthropic-Preise: Aktuelle Preisinformationen für Claude-Modelle und Produktpläne.
Zusammenfassung
Claude Sonnet 5.5 verringert den Abstand zwischen dem Modell der mittleren Preisklasse und dem Spitzenmodell von Anthropic stärker, als der Name vermuten lässt. Es übertrifft Opus 5.5 im Terminal-Bench 4.0, liegt bei GDPval-AA nur zwei Elo-Punkte zurück und kommt bei OSWorld und CursorBench beinahe an Opus heran.
Die größere Geschichte für den produktiven Einsatz ist die Effizienz. Sonnet 5.5 behält dieselben Token-Preise von 2 $ / 10 $ wie Sonnet 5 bei, läuft laut Anthropic jedoch mehr als 30 % schneller und kann die Kosten pro abgeschlossener Aufgabe um bis zu 30 % senken. Externe Tester berichten außerdem von weniger Tool-Aufrufen, weniger Shell-Ausführungen und deutlich weniger Iterationen.
Opus 5.5 bleibt die stärkere Wahl für schwierige, offene Aufgaben, die ein anhaltendes Urteilsvermögen erfordern. Sonnet 5.5 lässt sich besser als Arbeitspferd für hohe Volumina verstehen, das bei einer wachsenden Zahl klar abgegrenzter Aufgaben inzwischen eine Qualität auf Spitzenniveau erreicht.
Das wichtigste Upgrade von Sonnet 5.5 ist nicht ein einzelner Benchmark-Sieg, sondern wie nahe das Modell an die Qualität des Spitzenmodells herankommt und dabei den Preis der Sonnet-Klasse sowie deutlich niedrigere Kosten pro abgeschlossener Aufgabe beibehält.