Im Großteil des Computerzeitalters schien der Trend offensichtlich: Die Chipleistung verbesserte sich stetig, die Cloud-Infrastruktur expand...
Während des größten Teils des Computerzeitalters schien die Entwicklungsrichtung offensichtlich: Die Chip-Leistung verbesserte sich stetig, die Cloud-Infrastruktur expandierte kontinuierlich, und der effektive Preis für Rechenleistung sank.
KI könnte dieses Muster durchbrechen.
In einem Artikel vom 29. Juli 2026 stellte der Tech-Interviewer und Autor Dwarkesh Patel ein bewusst aggressives Szenario vor: Die Fähigkeit von Spitzen-KI, Rechenleistung in wirtschaftlichen Wert umzuwandeln, steigt drastisch, während sich das physische Angebot an fortschrittlicher Rechenleistung deutlich langsamer ausweitet.
In diesem Szenario könnte der Marktpreis für hochwertige KI-Rechenleistung um das Zehnfache oder mehr steigen, bevor er schließlich wieder auf den langfristigen Pfad fallender Kosten zurückkehrt.
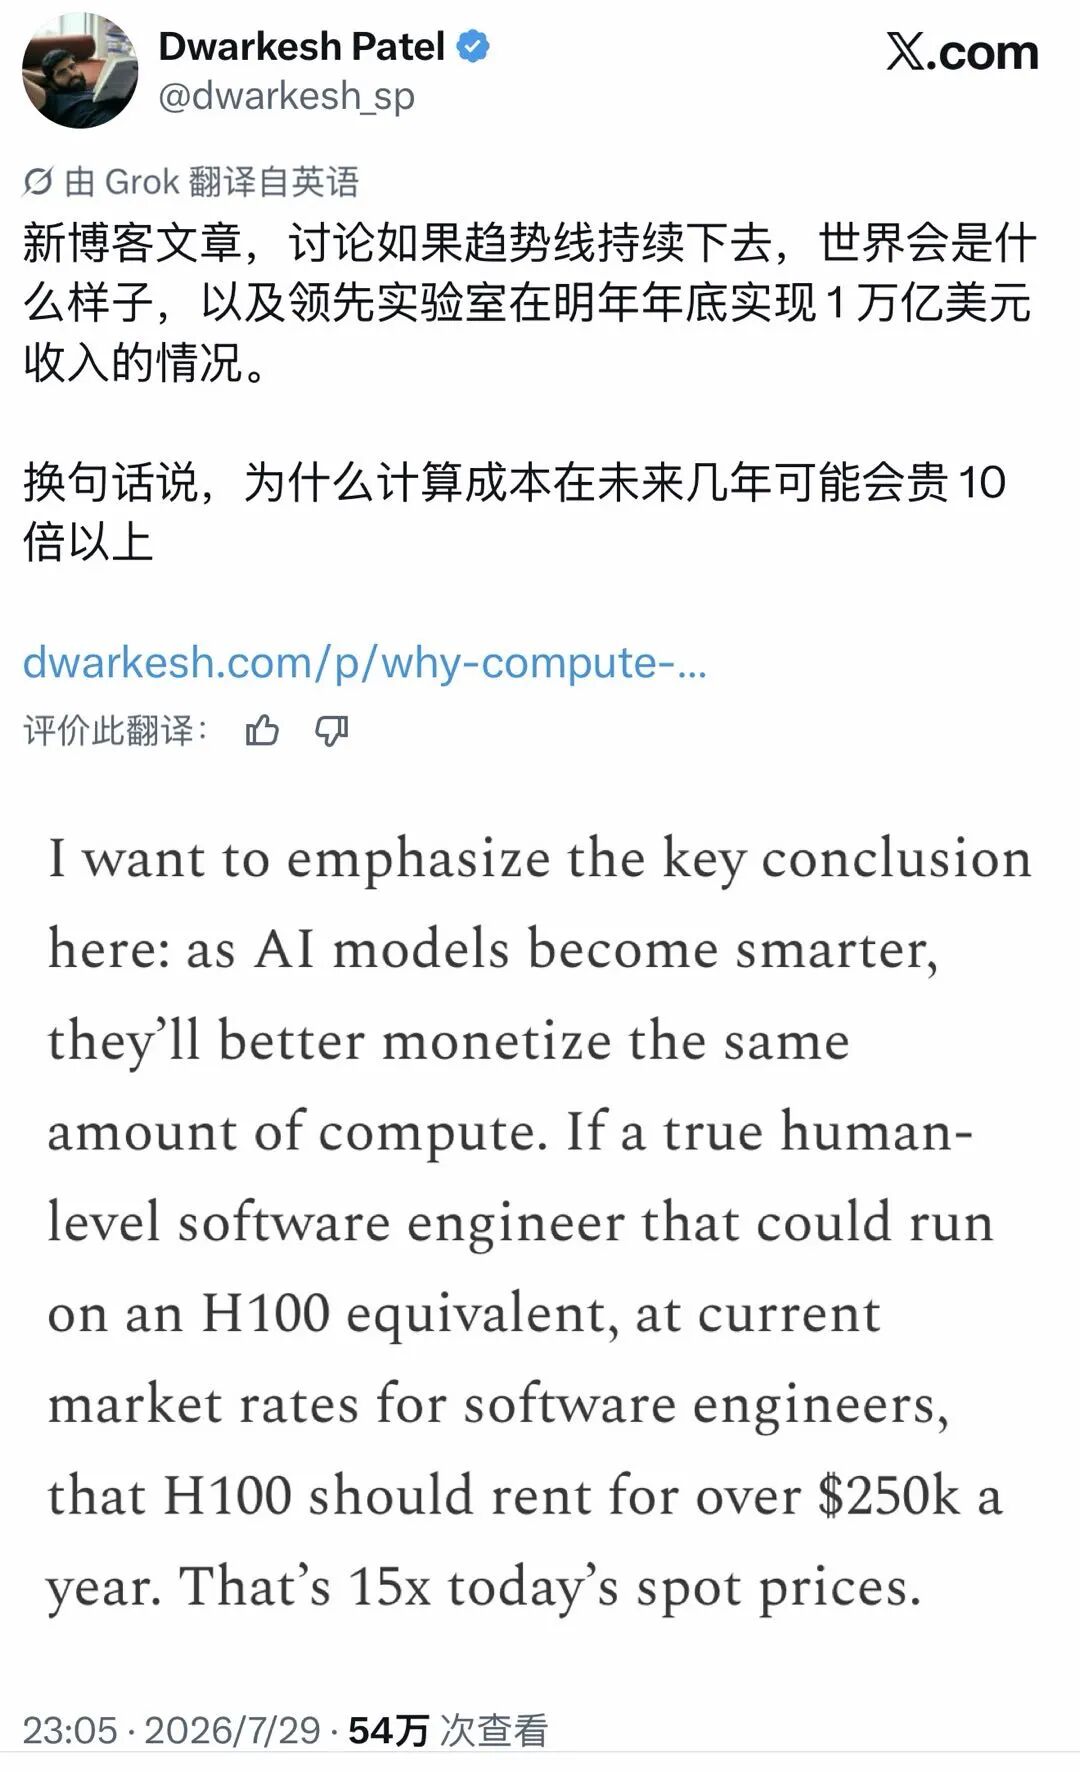
Das Argument beginnt mit einem provokativen Vergleich.
Wenn ein KI-Agent, der auf der Rechenleistung einer einzelnen NVIDIA H100 läuft, die Arbeit eines hochbezahlten Softwareingenieurs erledigen könnte, warum sollte der Mietpreis dieser GPU dann weiterhin hauptsächlich durch Hardware-Abschreibung und Cloud-Wettbewerb bestimmt werden?
Warum sollte der Preis nicht näher am wirtschaftlichen Wert der menschlichen Arbeit liegen, die er ersetzt oder verstärkt?
Der Originalartikel erweitert dieses Gedankenexperiment zu einer breiteren Prognose über KI-Labore, Rechenzentren, fortschrittliche Halbleiterkapazitäten und die Möglichkeit, dass die Welt eine Phase erheblicher Rechenleistungsinflation betritt.
Von Anfang an müssen mehrere wichtige Grenzen klargestellt werden:
Unter den oben genannten Voraussetzungen ist dieses Gedankenexperiment wertvoll, weil es eine Frage aufwirft, die die Branche oft vermeidet:
Was passiert, wenn der von KI geschaffene wirtschaftliche Wert schneller steigt als die Fähigkeit der Welt, die Infrastruktur zu produzieren, die ihren Betrieb unterstützt?
Das Argument beginnt mit einer Änderung der Vergleichseinheit.
Heutzutage wird Rechenleistung üblicherweise als Infrastruktur bepreist:
Patels Frage lautet: Was passiert, wenn dieselbe Hardware zum Behälter für autonome Arbeitskraft wird?
Stellen Sie sich einen KI-Softwareingenieur vor, der in der Lage ist:
Wenn dieser Agent während des Betriebs etwa eine H100-äquivalente Rechenleistung benötigt, ist die GPU nicht mehr nur eine
Serverkomponente. Sie ist Teil eines digitalen Produktionssystems.
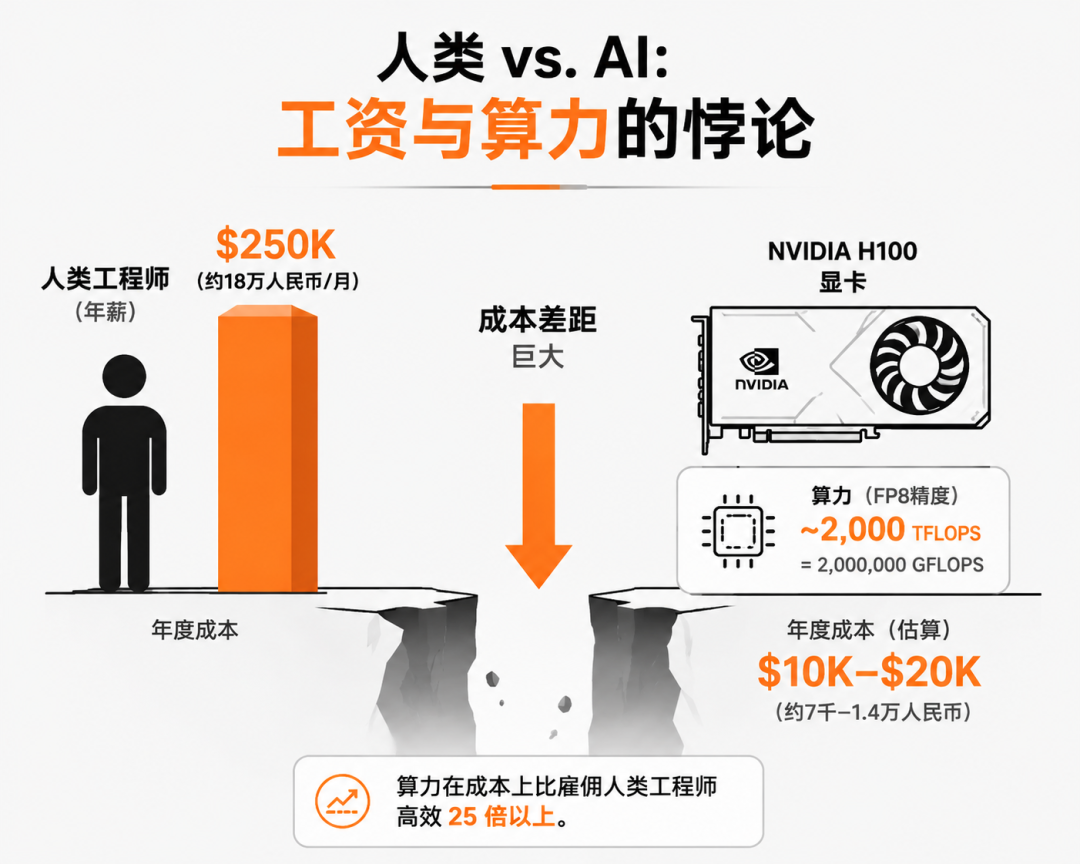
Patel verwendet den ganzzahligen Referenzwert von 250.000 US-Dollar pro Jahr für den Marktwert eines leistungsstarken Silicon-Valley-Softwareingenieurs.
Dann vergleicht er dies mit der jährlichen Schätzung für die Spot-Miete einer H100 (ca. 16.000 US-Dollar).
Die implizite Lücke beträgt:
250.000 / 16.000 ≈ 15,6-fach
In diesem vereinfachten Gedankenexperiment erscheint eine GPU, die eine gleichwertige digitale Arbeitskraft beherbergen kann, im Verhältnis zum Arbeitswert, den sie erzeugen kann, erheblich unterbewertet.
Diese Berechnung ist keine direkte Prognose, dass jede H100 für 250.000 US-Dollar vermietet wird.
Sie ignoriert mehrere wichtige Faktoren:
Patels enger gefasste Aussage ist, dass die Zahlungsbereitschaft für Rechenleistung drastisch steigen könnte, wenn Rechenleistung wertvollere Ergebnisse erzeugen kann.
Ein natürlicher Einwand ist, dass die Hinzufügung von Millionen von KI-Softwareingenieuren den Marktwert von Software-Engineering-Arbeit senken würde.
Wenn Software reichlich vorhanden wird, könnte ein digitaler Ingenieur nicht mehr 250.000 US-Dollar wert sein.
Patel räumt diese Möglichkeit ein, argumentiert jedoch, dass dies nicht automatisch geschieht.
Die Standard-Logik der Wirtschaftswissenschaften lehnt typischerweise die Vorstellung ab, dass die Menge „nützlicher Arbeit“ festgelegt ist. Zusätzliche qualifizierte Arbeitskräfte können neue Produkte, neue Unternehmen, neue Spezialisierungen und neue Nachfrage schaffen.
Aus dieser Perspektive erweitert eine massive Zunahme fähiger Arbeitskräfte nicht nur die Aufteilung bestehender Arbeit auf mehr Teilnehmer. Sie erweitert den Bereich des wirtschaftlich Möglichen.
KI könnte einen ungewöhnlich schnellen Arbeitsangebotsschock mit sich bringen, daher könnten historische Vergleiche nicht anwendbar sein. Selbst dann argumentiert Patel, dass es vernünftig ist, dass der Grenzwert von KI-Rechenleistung hoch bleibt, da neue Software und Dienstleistungen machbar werden.
Ein nützlicher Gegenpunkt aus der Diskussion unter Patels Artikel ist, dass der Arbeitswertvergleich am stärksten ist, wenn die gesamte Aufgabe in einer digitalen Umgebung abgeschlossen werden kann.
Software-Engineering kommt diesem Idealzustand nahe:
Der Vergleich wird schwächer, wenn physische Engpässe dominieren.
Ein KI-System
mag schnell ein Medikament entwerfen können, aber klinische Studien erfordern weiterhin Patienten, Regulierung, Herstellung und Zeit. Es mag eine Fabrik optimieren können, aber Bau, Genehmigungen, Lieferketten und Ausrüstung unterliegen weiterhin physischen Bedingungen.
In diesen Bereichen könnte Intelligenz aufhören, der primäre Engpass zu sein, bevor die Rechenleistung in der Lage ist, den vollen Wert der ersetzten menschlichen Arbeit zu übernehmen.
Der zweite Teil des Arguments wechselt von einer einzelnen GPU zu den Finanzen von Spitzen-KI-Labors.
Anthropic ist das Hauptbeispiel, da das Umsatzwachstum in jüngster Zeit außergewöhnlich schnell war.
Von Anthropic offiziell gemeldete Daten:
Dies sind annualisierte Umsatzraten, keine geprüften Jahresumsätze.
Sie beschreiben die Wachstumsgeschwindigkeit, die in den Umsätzen zu einem bestimmten Zeitpunkt impliziert ist.
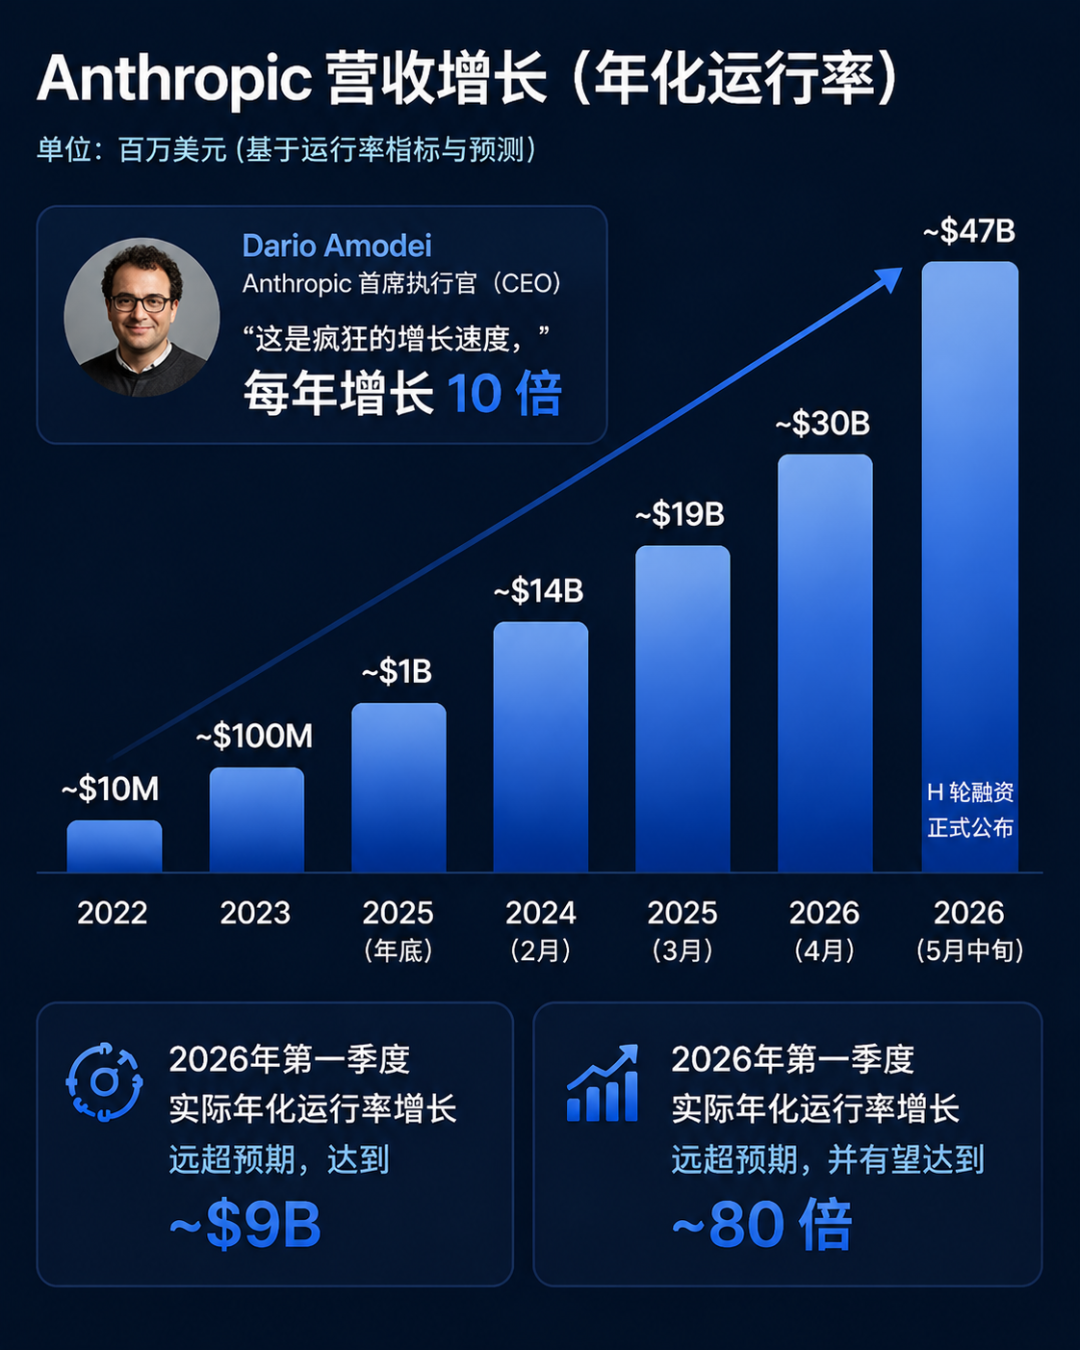
Patels Ausgangspunkt ist eine Beobachtung: Der Umsatz von Anthropic ist im Jahresvergleich um etwa eine Größenordnung gestiegen.
Anschließend konstruierte er ein bewusst extremes Extrapolationsszenario:
Patel stellt klar, dass diese Entwicklung nicht zwangsläufig eintreten muss und keine tiefere Ursache hat. Sie hängt von künftigen KI-Fähigkeiten, der Produktakzeptanz, der Preisgestaltung und dem Wettbewerb ab.
Der Zweck dieses Szenarios ist nicht die Behauptung, Anthropic prognostiziere einen Umsatz von einer Billion Dollar, sondern die Frage: Wenn ein KI-Unternehmen tatsächlich so schnell wächst, welche weiteren Bedingungen müssen erfüllt sein?
Patel vergleicht ein hypothetisches zehnfaches Umsatzwachstum mit einer geschätzten jährlichen Verdreifachung der KI-Rechenleistung.
Epoch AI schätzt, dass der globale KI-Rechenleistungsbestand im Jahr 2025, gemessen in H100-Äquivalenten, etwa um das Dreifache gestiegen ist – allerdings betont die Organisation auch, dass unternehmensbezogene und zukunftsgerichtete Schätzungen weiterhin mit Unsicherheiten behaftet sind.
Die daraus resultierende Diskrepanz beträgt etwa:
Wachstum der KI-Geschäftsnachfrage: 10-fach
Wachstum der physischen Rechenleistung: 3-fach
Lücke: ca. 3,3-fach
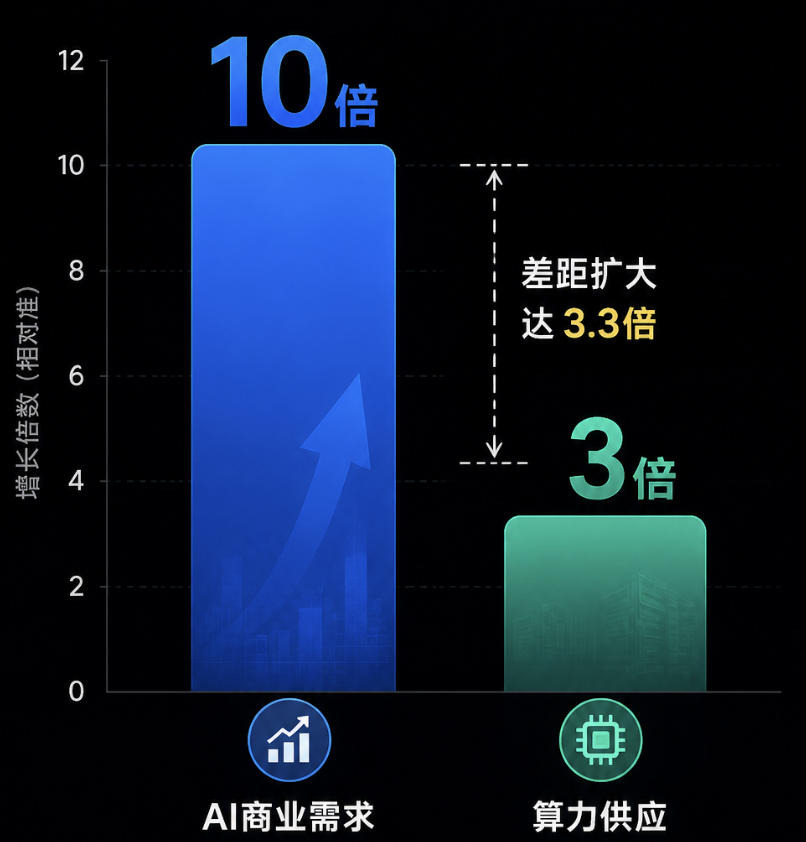
Wenn ein führendes Labor schneller wächst, als es seine verfügbare Rechenleistung ausbauen kann, dann muss eine Kombination aus den folgenden drei Dingen eintreten:
Patel ist der Ansicht, dass sich alle drei Faktoren bereits in gewissem Maße im Wandel befinden.
Modellanbieter investieren hohe Fixkosten in das Training von Modellen und verkaufen anschließend die erlernten Fähigkeiten an zahlreiche Kunden.
Dies birgt potenzielle Skaleneffekte.
Dieselben trainierten Fähigkeiten können über folgende Kanäle vermarktet werden:
Die Grenzkosten einer einzelnen zusätzlichen Anfrage können weit unter dem Wert liegen, den diese Anfrage schafft.
Patel weist darauf hin, dass sich die Inferenzmargen führender Labors bereits erheblich verbessert haben. Allerdings werden seine konkreten Margendaten für den Fable-Inferenzdienst von Anthropic ausdrücklich als grobe Schätzung präsentiert, nicht als geprüfte Unternehmensangaben.
Hohe Margen können einen Teil der Kluft zwischen Umsatzwachstum und Rechenleistungswachstum absorbieren.
Die Herausforderung liegt im Maßstab.
Im von Patel skizzierten Billionen-Dollar-Szenario müssten die Gewinnmargen – falls Preise und Rechenleistungsallokation nicht ausreichend angepasst werden – auf ein hohes Niveau von etwa 95 % steigen. Seiner Ansicht nach wäre selbst für führende Technologieplattformen ein solches Niveau außergewöhnlich hoch.
Die exakt erforderliche Gewinnmarge hängt von vielen Variablen ab, doch der zentrale Punkt bleibt bestehen: Gewinnmargen allein dürften kaum ausreichen, um die explosive Nachfrage mit der begrenzten Infrastruktur in Einklang zu bringen.
Die zweite Option besteht darin, einen größeren Anteil der Rechenleistung der Kundenbetreuung zuzuordnen.
Epoch AI schätzt, dass OpenAI im Jahr 2024 etwa 1,8 Milliarden US-Dollar für Inferenzrechenleistung und etwa 5 Milliarden US-Dollar für Forschungs- und Entwicklungsrechenleistung ausgegeben hat. Demnach entfällt auf Inferenzausgaben rund ein Viertel der gemeldeten Gesamtausgaben für Rechenleistung.
Mit zunehmender kommerzieller Nutzung kann der Inferenzanteil weiter steigen.
Dies stützt den Umsatz, stellt die führenden Labors jedoch vor ein strategisches Dilemma.
Inferenzdienste finanzieren die laufenden Rechnungen.
Training und Experimente hingegen erzeugen die Modelle, die die Produkte der nächsten Generation definieren könnten.
Ein Labor, das den Großteil seiner Rechenleistung für die Betreuung aktueller Modelle einsetzt, mag zwar unmittelbarere Einnahmen erzielen, verfügt aber über entsprechend weniger Infrastruktur für:
Patel beschreibt einen Silicon-Valley-Schwungradeffekt: Die aktuellen Inferenzeinnahmen tragen zur Finanzierung bei, die Finanzierung kauft mehr Rechenleistung, die Rechenleistung trainiert stärkere Modelle, und stärkere Modelle generieren mehr Umsatz.
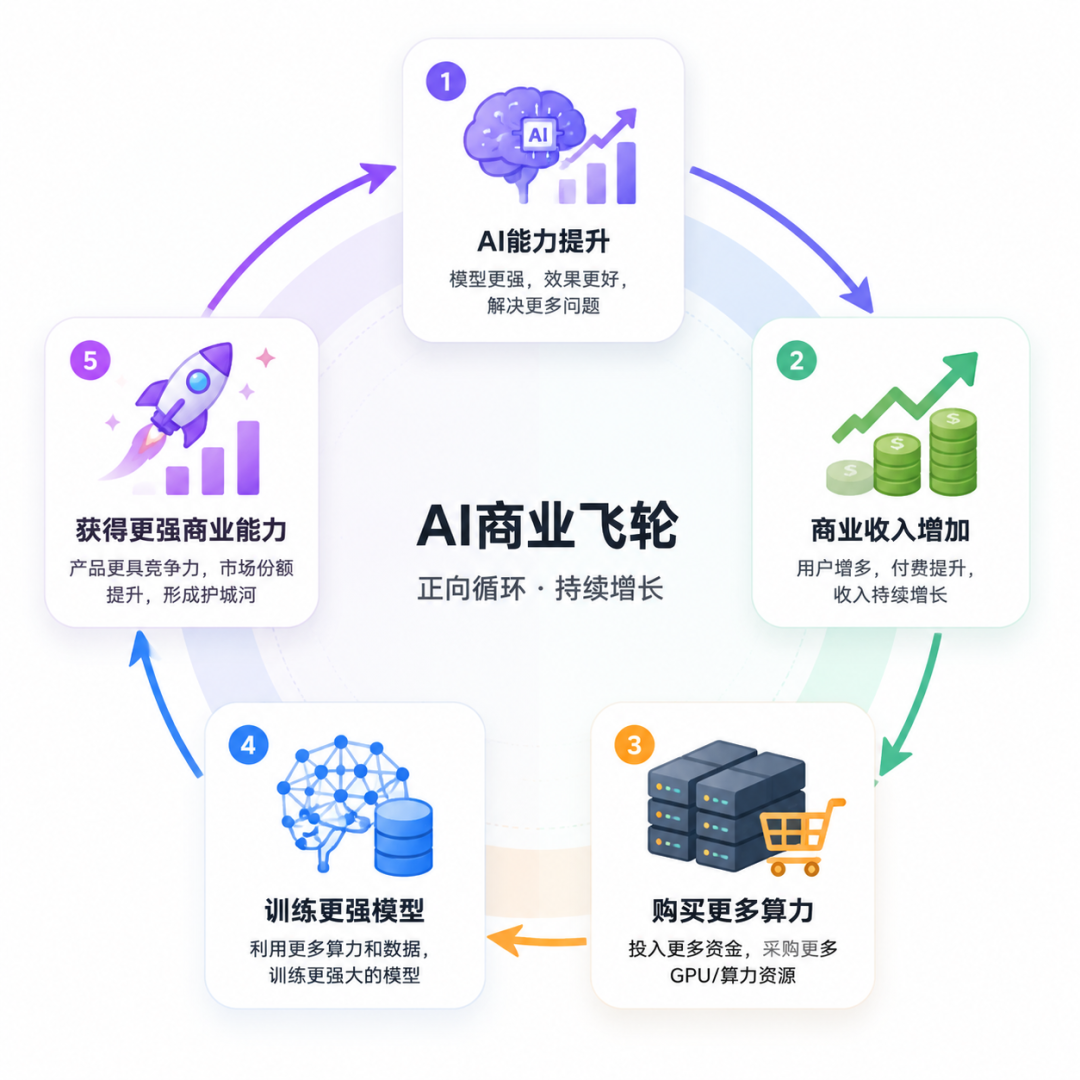
Diese Labors betrachten ihre heutigen Modelle in der Regel nicht als Endpunkt. Sie gehen davon aus, dass die aktuellen Spitzensysteme bald übertroffen werden.
Das macht sie zurückhaltend, sich vollständig in hochmargige Cloud-Dienstleister zu verwandeln, die statische Modelgenerationen bedienen.
steigen
Die verbleibende Anpassung ist der Preis.
Wenn KI-Labors und ihre Kunden aus jeder Einheit Rechenleistung mehr wirtschaftlichen Wert schöpfen können, sind sie in der Lage, aggressiver um knappe Infrastruktur zu bieten.
Das bedeutet nicht, dass der Preis pro GPU-Stunde überall gleichermaßen steigt.
Spitzenlabors benötigen eine spezialisierte Klasse von Rechenleistung:
Spot-Instanzen aus offenen Märkten sind kein gleichwertiger Ersatz für einen sicheren, mehrjährigen Vertrag über Infrastruktur im Multi-Gigawatt-Maßstab.
Jüngste Verträge verdeutlichen die Prämie für sofort verfügbare Kapazität.
Anthropic hat die Vereinbarung mit SpaceXAI für den Zugang zu Colossus 1 offiziell bestätigt und anschließend angegeben, die Kapazitäten bei Colossus 1 und Colossus 2 erweitert zu haben.
SpaceXAI beschreibt Colossus 1 als Anlage mit mehr als 220.000 NVIDIA-GPUs, darunter H100-, H200- und GB200-Systeme.
Axios berichtete, dass Anthropic zugestimmt hat, bis 2029 monatlich rund 1,25 Milliarden US-Dollar für diese Vereinbarung zu zahlen.
Eine anschließend von TechCrunch berichtete Regulierungsdatei zeigt, dass Google von Oktober 2026 bis Juni 2029 monatlich rund 920 Millionen US-Dollar an SpaceX zahlen wird, um Zugang zu etwa 110.000 GPUs und zugehörigen Komponenten zu erhalten.
Dies sind keine gewöhnlichen On-Demand-Cloud-Einkäufe.
Sie spiegeln den Wert wider, in einer Situation, in der der Bau neuer Rechenzentren, die Netzanbindung und die Chip-Lieferung Jahre dauern können, schnell Zugang zu massiver nutzbarer Infrastruktur zu erhalten.
Patel schätzt, dass der im Google-Deal implizite Preis pro GPU-Stunde etwa doppelt so hoch liegt wie der aktuelle Spotpreis der relevanten gemischten Hardware.
Dieser Vergleich ist näherungsweise, da der Vertrag mehr als nackte GPUs umfasst und die Hardware-Mischung verschiedene Generationen von Beschleunigern beinhaltet.
Der ursprüngliche Artikel verwendet industrielle Analogien.
Im Internetzeitalter kämpften Unternehmen um:
Frontier AI competition adds a more physical dimension:
Frontier GPU clusters resemble industrial production lines more than collections of ordinary rented servers.
Their output is not physical products but economically valuable intelligence:
Companies that control the most powerful models and the most reliable compute are likely to produce more of such digital work.
Spot capacity has several disadvantages for frontier workloads:
Labs training or running frontier models therefore value guaranteed compute more than buyers running short batch jobs.
This helps explain why contracted compute can command a premium even when public cloud offers appear cheaper.
Patel's argument relies on the claim that compute supply cannot react quickly enough to major demand shocks.
He summarizes annual compute growth as the product of three broad multipliers:
Annual AI compute growth ≈
1.4× hardware improvement
× 1.2× new wafer capacity
× 1.8× reallocation of leading-edge wafers to AI
≈ 3.0×
These numbers are estimates, not invariant physical constants.
They are meant to illustrate where recent growth comes from.
Semiconductor improvements increase effective compute delivered per watt, per chip, and per dollar.
Potential gains come from:
Progress is not without limits.
Each new process generation becomes more difficult and more expensive. Power density, leakage, yield, memory movement, and packaging increasingly determine actual performance.
AI systems can also gain efficiency through model and software improvements, which may offset hardware scarcity to some degree. Therefore, any compute price forecast depends on the speed of efficiency gains relative to demand growth.
New semiconductor capacity takes years for planning, financing, construction, equipment installation, qualification, and ramp-up.
The supply chain depends heavily on specialized systems, including extreme ultraviolet lithography equipment.
Advanced fabs also require:
Patel argues that EUV equipment availability constrains rapid capacity expansion at least until the end of the decade.
Higher prices can stimulate investment, but they cannot instantly produce a fully qualified leading-edge fab.
Much of the recent AI chip growth comes from shifting advanced manufacturing capacity from other products.
Smartphones, PCs, networking chips, and other devices compete for the same leading-edge process and packaging resources.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Patel cites an estimate that AI could rise from about 60% to 86% of TSMC's N3 capacity by the end of 2027.
This is a supply-model estimate, not publicly announced TSMC capacity guidance.
The implication is straightforward: the reallocation lever works only as long as non-AI demand still occupies transferable capacity.
Once AI already consumes most capacity at a given node, this growth lever weakens considerably.
Even if wafer supply expands, the whole system can still be constrained by:
Compute supply therefore resembles a chain, not a single factory's output.
Effective capacity is limited by the slowest critical link.
The source then makes a counterintuitive argument: if compute becomes more expensive, buyers might not switch to weaker models.
They might even prefer the strongest models even more.
Patel connects this to the Alchian–Allen effect.
When a fixed cost is added to goods of different quality, the higher-end version can become relatively more attractive because the quality premium shrinks as a share of the total price.
Assume underlying compute costs $20 per hour.
A strong model completes a task in one hour with a $5 model premium:
Strong model:
$20 compute + $5 premium = $25
A weak model has no premium but needs two hours due to retries and inefficient inference:
Weak model:
2 × $20 compute = $40
A model that appears free is actually more expensive on a per-completed-task basis.
The key metric is not price per token or model license fee, but cost per successful outcome.
More powerful models can reduce costs through:
If compute is cheap, the cost of inefficient attempts may be bearable.
If compute is expensive, wasted compute hurts more.
Labs that can extract the most useful output from every scarce GPU hour may be able to charge a significant premium.
The most aggressive version of the source article claims mediocre models may have no future.
That conclusion is too broad.
Smaller and specialized models remain attractive when:
A lightweight classifier does not need to become a frontier programming agent.
The Alchian–Allen argument applies when both models consume similar expensive infrastructure and the weaker model needs significantly more work to reach the same result.
When a smaller model is genuinely more efficient for a given task, the argument loses force.
Patel argues that rising compute prices could shift capacity away from low-value uses.
If a GPU can run an agent producing high-value software or business output, the opportunity cost of using the same hardware for one-off media content becomes much higher.
This could affect:
Markets do not necessarily eliminate content itself.
They may instead push it toward:
The key is resource allocation.
Frontier compute will tend to flow toward workloads with the highest willingness to pay.
The source article also raises several objections.
These matter because predictions of permanent resource scarcity are often proven wrong.
The $250,000 engineer comparison assumes GPUs can capture returns close to the current economic value of an engineer.
This assumption could fail because:
Some commentators note that digital workers may initially be highly valuable, but once AI labor becomes abundant, the value could settle around $50,000.
In that scenario, the value of compute could still rise, but not necessarily by 15 times.
Token prices are not the same as compute prices.
Models and serving systems keep improving through:
Cache
Zukünftige kostengünstige Video- oder Chat-Antworten könnten nur einen Bruchteil der aktuellen Rechenleistung benötigen.
Selbst wenn die Berechnung für Spitzen-Agenten teuer wird, könnten allgemeine KI-Dienste weiterhin billiger werden, da sie auf effizientere Modelle und Hardware umsteigen.
Modelle mit offenen Gewichten könnten Druck auf die Preisgestaltung von Frontier-APIs ausüben.
Wenn mehrere Modelle ähnliche Fähigkeiten bieten, können Nutzer zwischen folgenden Optionen wechseln:
Dies begrenzt die Fähigkeit eines einzelnen Labors, extrem hohe Gewinnmargen zu erzielen.
Rechenknappheit kann die zugrunde liegenden Infrastrukturkosten immer noch in die Höhe treiben, aber der Modellwettbewerb bestimmt, wie viel Wert das Labor behalten kann.
Die klassische Antwort auf Knappheit ist Investition.
Höhere Rechenpreise würden fördern:
Patel stimmt ebenfalls zu, dass Rechenleistung letztendlich wieder günstig werden dürfte.
Sein Argument zielt auf die aktuelle Übergangsphase ab, in der das Nachfragewachstum schneller sein könnte als die Reaktion der langfristigen physischen Infrastruktur.
Die Quelle vergleicht die Rechenvorhersagen mit der berühmten Wette zwischen dem Biologen Paul Ehrlich und dem Ökonomen Julian Simon.
1980 wählte Ehrlich einen Korb aus fünf Metallen und wettete, dass deren reale Preise im nächsten Jahrzehnt steigen würden.
Bis 1990 war der inflationsbereinigte Preis des Korbs gefallen, und Ehrlich zahlte Simon die Wette.
Diese Wette wird oft genutzt, um zu argumentieren, dass Knappheitsprognosen Innovation, Substitution und Angebotsreaktionen unterschätzen.
Die historische Interpretation ist
komplexer. Die Analyse weist darauf hin, dass andere Startjahrzehnte andere Gewinner hervorgebracht haben könnten.
Patel räumt ein, dass sein Rechenargument ähnlich ist wie Knappheitsprognosen, die sich oft als falsch erwiesen haben.
Er argumentiert, dass sich Rechenleistung vom Metallabbau unterscheiden könnte, da ihre kurzfristige Angebotselastizität geringer ist:
Daher liegt der Hauptunterschied in der Zeitfrage.
Können Preissignale und Innovation das effektive Rechenangebot erweitern, bevor die KI-Nachfrage den aktuellen Ausbau überfordert?
Anstatt den „10-fachen“ als feste Prognose zu betrachten, lässt sich das Argument in eine Reihe messbarer Variablen übersetzen.
Ein 10-facher Preisanstieg ist wahrscheinlicher, wenn:
Er ist weniger wahrscheinlich, wenn:
Selbst wenn die Rechenkosten nicht um das 10-fache steigen, hat das Argument praktische Bedeutung.
Verfolgen Sie:
Wenn ein günstigeres Modell wiederholt scheitert, ist es tatsächlich nicht günstig.
Reservieren Sie teure Frontier-Modelle für Aufgaben, die wirklich davon profitieren.
Verwenden Sie kleinere Modelle für:
Eskalieren Sie nur schwierige Fälle.
Vermeiden Sie es, das gesamte Produkt an ein einzelnes Modell oder einen einzelnen GPU-Anbieter zu binden.
Nützliche Abstraktionen umfassen:
Speicher
Langlaufende Agentenschleifen können durch wiederholten Kontext und übermäßige Tool-Ausgaben Rechenleistung verschwenden.
Verbesserungsbereiche:
Unternehmen mit vorhersehbarem Bedarf können profitieren von:
Die richtige Strategie hängt von der Auslastung ab. Reservierte Hardware ist bei Leerlauf teuer.
Das Argument verlagert den Fokus auch von Modell-Benchmarks auf Infrastruktur.
Wichtige Bereiche umfassen:
Wenn Intelligenz zu einem wichtigen wirtschaftlichen Input wird, wird die Kontrolle über diese Ebenen strategisch.
Das Ergebnis könnte Zentralisierung sein.
Labore mit den besten Modellen und den stärksten Einnahmen könnten neue Marktteilnehmer bei knappen Rechenressourcen überbieten. Diese Rechenressourcen helfen ihnen, ihre Modelle zu verbessern, was wiederum die Einnahmen steigert und das nächste Gebot erleichtert.
Dies ist eine sich verstärkende Schleife:
Bessere Modelle
    ↓
Wertvollere Produkte
    ↓
Mehr Einnahmen
    ↓
Mehr Zugang zu Rechenressourcen
    ↓
Mehr Training und Inferenz
    ↓
Bessere Modelle
Das Risiko besteht darin, dass die Intelligenzproduktion in den Händen einiger weniger Unternehmen konzentriert sein könnte, die in der Lage sind, enorme Infrastrukturinvestitionen zu stemmen.
Patel argumentiert, dass intelligentere KI-Modelle mehr Einnahmen pro Recheneinheit erzielen könnten, während das tatsächliche Angebot an fortgeschrittener Rechenleistung viel langsamer wächst. Wenn Nachfrage und Zahlungsbereitschaft schneller wachsen als das Angebot an Chips, Strom und Rechenzentren, könnten die Marktpreise stark steigen.
Nein. Anthropic berichtet offiziell, dass der annualisierte Umsatz im Mai 2026 die Marke von 47 Milliarden US-Dollar überschritten hat. Die Zahlen von 100 bis 150 Milliarden US-Dollar zum Jahresende sowie 1 Billion US-Dollar im Folgejahr sind Annahmen in Patels Gedankenexperiment und keine Unternehmensprognosen.
Dieser Vergleich untersucht, wie Rechenressourcen bewertet werden könnten, wenn ein System mit H100-Äquivalent einen KI-Agenten betreiben könnte, der die Arbeit eines hochbezahlten Ingenieurs übernimmt. Dies ist ein hypothetischer Wertmaßstab und kein Beweis dafür, dass aktuelle Agenten pro H100 einen Ingenieur ersetzen können.
Epoch AI schätzt, dass die gesamte globale KI-Rechenleistung im Jahr 2025, ausgedrückt in H100-Äquivalenten, etwa um das Dreifache gewachsen ist. Zukünftiges Wachstum ist ungewiss und hängt von Chipleistung, Fertigung, Verpackung, Strom, Bau und Investitionen ab.
Frontier-Labore benötigen sichere, zuverlässige, groß angelegte Cluster mit Hochgeschwindigkeitsnetzwerk und vorhersehbarer Leistung.
Langfristige Verfügbarkeit. Öffentliche Spot-Instanzen sind nicht gleichzusetzen mit dedizierten mehrjährigen Bereitstellungen mit Hunderttausenden koordinierten Beschleunigern.
Nicht unbedingt. Wenn das stärkste Modell dasselbe Ergebnis mit weniger Token, weniger Wiederholungen oder weniger Zeit erzielt, begünstigt teure Rechenleistung es tatsächlich. Für schmale, latenzempfindliche, private oder Edge-Workloads können kleinere spezialisierte Modelle jedoch weiterhin wirtschaftlicher sein.
Patel behauptet nicht, dass Rechenleistung dauerhaft teuer bleibt.
Sein Argument betrifft eine Übergangsphase – in der die KI-Nachfrage die Expansionsfähigkeit der Halbleiter- und Rechenzentrums-Lieferketten übersteigen könnte; langfristig könnten Hardware und Automatisierung Rechenleistung wieder günstiger machen.
Das Argument würde geschwächt, wenn das KI-Umsatzwachstum nachlässt, Modellfähigkeiten eine Obergrenze erreichen, Open-Source-Modelle zu sehr ähnlichen Alternativen werden, Effizienzsteigerungen bei Dienstleistungen schneller wachsen als die Nachfrage, oder die Expansion von Halbleiter- und Stromversorgung schneller als erwartet verläuft.
Dwarkesh Patels Argument des 10-fachen Rechenleistungspreises beginnt mit einer einfachen Idee: Wenn eine GPU KI-Agenten ausführen kann, die hochwertige Wissensarbeit leisten, könnte die Zahlungsbereitschaft für diese GPU eher am Wert dieser Arbeit gemessen werden als an den historischen Serverkosten.
In Kombination mit Anthropics schnellem Umsatzwachstum und Schätzungen, dass die globale KI-Rechenleistung jährlich um etwa das Dreifache expandiert, wird das Argument noch stärker. Wenn die kommerzielle KI-Nachfrage schneller wächst, muss die Anpassung über Gewinnmargen, Rechenleistungsallokation, steigende Infrastrukturpreise oder eine Kombination dieser drei erfolgen.
Diese Prognose ist keineswegs sicher. Energieeffizienzverbesserungen, Open-Source-Modelle, kleinere spezialisierte Systeme, neue Fabriken, neue Beschleuniger und ein verlangsamtes Fähigkeitswachstum könnten alle eine 10-fache Steigerung verhindern. Historische Prognosen über Ressourcenknappheit haben zudem oft die Fähigkeit zur adaptiven Anpassung unterschätzt.
Die wirklich bleibende Erkenntnis ist nicht, dass Rechenleistung genau um das 10-fache steigen muss, sondern dass intelligentere KI den wirtschaftlichen Wert jeder GPU schneller steigern kann, als die physische Welt neue GPUs herstellen und mit Strom versorgen kann.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



