For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/cuda-agent-trains-llms-to-write.md.
Das Seed-Team von ByteDance hat gemeinsam mit dem Institut für KI-Industrieforschung (AIR) der Tsinghua-Universität den CUDA-Agent vorgestel...
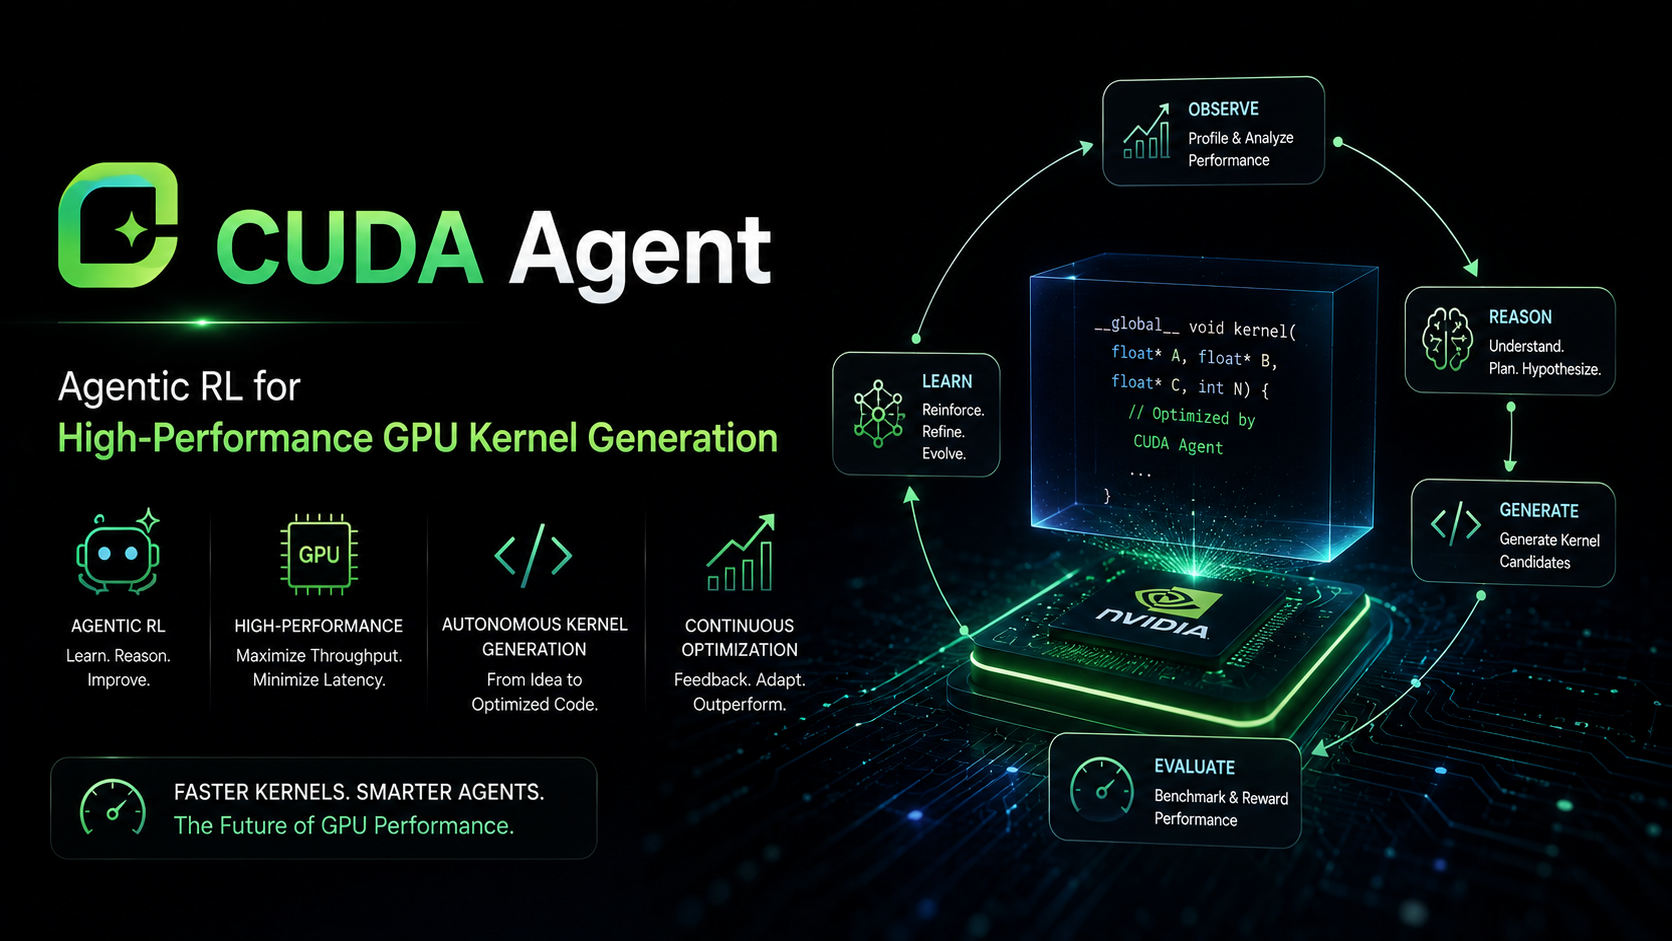
Das Seed-Team von ByteDance hat gemeinsam mit dem Institut für KI-Industrieforschung (AIR) der Tsinghua-Universität den CUDA-Agent vorgestellt – ein groß angelegtes System für intelligente Agenten-Verstärkungslernen, das Sprachmodelle dazu befähigt, leistungsstarke CUDA-Kernel zu generieren.
Diese Arbeit zielt auf eine langjährige Schwachstelle bei der KI-generierten Codegenerierung auf niedriger Ebene ab. Hochmoderne Sprachmodelle erzeugen oft CUDA-Code, der kompiliert und korrekt ausgeführt werden kann, aber für produktionsreife GPU-Workloads ist Korrektheit allein nicht ausreichend. Die generierten Kernel müssen auch mit hochoptimierten, compiler-generierten Implementierungen konkurrieren können.
CUDA-Agent ist genau um dieses zweite Problem herum aufgebaut: nicht nur die Erzeugung gültigen CUDA-Codes, sondern auch das iterative Erlernen von Profiling, Verifikation und Optimierung von Kerneln, bis eine signifikante Verbesserung der Laufzeit erreicht ist.
Vor der Einführung von Agenten-Verstärkungslernen zeigte das Seed1.6-Basismodell bereits beachtliche CUDA-Codierungsfähigkeiten auf KernelBench.
Bei den 250 KernelBench-Aufgaben der Stufen 1–3, die die Forscher verwendeten, erreichte Seed1.6 eine Pass-Rate von 74,0 %. Mit anderen Worten: Es konnte für die meisten Benchmark-Aufgaben des Basismodells funktional korrekte Lösungen generieren.
Die Leistungsfähigkeit sah jedoch anders aus.
Nur 27,2 % der vom Basismodell generierten Kernel waren schneller als torch.compile, wobei die geometrische mittlere Geschwindigkeit relativ zur Compiler-Baseline lediglich 0,69× betrug.
| Modell | Pass-Rate | Schneller als torch.compile | Geometrische mittlere Geschwindigkeit relativ zu torch.compile |
|---|---|---|---|
| Seed1.6 Basismodell | 74,0 % | 27,2 % | 0,69× |
| CUDA-Agent | 98,8 % | 96,8 % | 2,11× |
Diese Diskrepanz verdeutlicht die zentrale Herausforderung bei der automatischen GPU-Kernel-Generierung.
Sprachmodelle können die CUDA-Syntax verstehen, aber dennoch ineffiziente Speicherzugriffe, übermäßige Kernel-Starts, schlechte Blocking-Wahlen, unnötiges Synchronisieren und suboptimale Registerauslastung produzieren.
Performance-Profiling
Die SKILL.md-Datei begrenzt zudem Abkürzungen, die die Benchmark-Ergebnisse verfälschen könnten. Beispielsweise kann der Agent nicht einfach auf beliebige PyTorch-Operationen in benutzerdefinierten Kernel-Implementierungen zurückgreifen.
Dies ist wichtig, da Verstärkungslernsysteme Wege finden könnten, die Belohnung zu maximieren, ohne das beabsichtigte Optimierungsproblem zu lösen.
Die Forscher trainieren den CUDA-Agent mit Proximal Policy Optimization (PPO).
Eine zentrale Herausforderung besteht darin, dass GPU-Optimierung inhärent eine langfristige Aufgabe ist. Das Modell muss möglicherweise mehrere Runden von Codebearbeitung, Kompilierung, Debugging, Profiling und weiterer Optimierung durchlaufen, um ein ideales Ergebnis zu erzielen.
Daher verwendet die Arbeit unterschiedliche Kontextlängen und Trainingsphasen, um das Lernen zu stabilisieren.
Das Basismodell ist Seed1.6, ein Mixture-of-Experts-Modell mit 230 Milliarden Gesamtparametern und 23 Milliarden aktivierten Parametern.
Für das Agenten-Verstärkungslernen:
Dies ist komplexer als ein einfaches Feintuning des Modells auf einem Paar aus CUDA-Prompt und -Antwort.
Das Ziel ist es, dem Modell beizubringen, wie es seine eigenen Kernel durch wiederholte Interaktion mit Ausführungsfeedback verbessert.
Zuverlässige Leistungsmessung ist entscheidend, da die Laufzeit Teil der Belohnung ist.
Daher haben die Forscher eine Sandbox-Architektur mit entkoppelten CPU- und GPU-Ressourcen aufgebaut.
Eine Docker-basierte Terminal-Sandbox verarbeitet CPU-orientierte Aufgaben (wie Kompilierung), während Validierung und Performance-Profiling an einen dedizierten GPU-Sandbox-Pool mit 128 NVIDIA H20-GPUs delegiert werden.
Diese Trennung erfüllt einen doppelten Zweck.
Erstens isoliert sie Kompilierung und Agenteninteraktion von GPU-Benchmarks. Zweitens reduziert die dedizierte GPU-Zuweisung Störungen zwischen parallelen Workloads, was die Latenzmessungen stabiler macht.
Dies ist für Verstärkungslernen wichtig: Wenn Zeitmessungen durch Rauschen beeinträchtigt werden, erhält das Modell unzuverlässige Belohnungssignale und könnte falsches Optimierungsverhalten lernen.
Das endgültige System wurde auf 250 Aufgaben der KernelBench-Stufen 1 bis 3 evaluiert.
Der CUDA-Agent erreichte:
torch.compiletorch.compileDiese Ergebnisse stellen eine massive Verbesserung gegenüber dem Seed1.6-Ausgangspunkt dar.
Das Modell wurde nicht nur besser darin, Code zu generieren, der Korrektheitstests besteht, sondern seine generierten Kernel übertreffen auch mit höherer Wahrscheinlichkeit die Compiler-Baseline.
Ergebnisse nach KernelBench-Schwierigkeitsgrad
Die Leistungsverbesserungen bleiben über alle drei KernelBench-Schwierigkeitsstufen hinweg stark.
| KernelBench-Schwierigkeit | Pass-Rate | Anteil schneller als torch.compile | Geometrische mittlere Beschleunigung gegenüber torch.compile |
|---|---|---|---|
| Stufe 1 | 100,0 % | 97,0 % | 1,87× |
| Stufe 2 | 100,0 % | 100,0 % | 2,80× |
| Stufe 3 | 94,0 % | 90,0 % | 1,52× |
Besonders bemerkenswert ist die Leistung auf Stufe 2.
Diese Aufgaben umfassen Operatorsequenzen, bei denen Optimierungsmöglichkeiten durch Fusion und Speicherbewegungen entstehen, die statische Compiler-Heuristiken nicht immer effektiv nutzen können.
Die Autoren der Arbeit argumentieren, dass iterative Lernoptimierer einen breiteren Raum an Implementierungsstrategien durchsuchen können, einschließlich hardware-spezifischer Speicherzugriffsmuster, Blocking- und Fusionsentscheidungen.
Derzeit sind die vollständigen trainierten Modellgewichte nicht im öffentlichen Release dieses Projekts enthalten.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Allerdings haben die Forscher mehrere wichtige Komponenten des Trainings-Stacks veröffentlicht.
Der Datensatz CUDA-Agent-Ops-6K enthält 6.000 synthetische operatorbezogene Trainingsaufgaben.
Sein Aufbau umfasst:
torch, transformers usw.Die Filterphase entfernt Fälle mit Zufälligkeit, zu großer Einfachheit, Ungültigkeit oder zu großer Ähnlichkeit mit Evaluierungsaufgaben.
Der Datensatz wurde auf Hugging Face veröffentlicht und steht unter der CC BY 4.0-Lizenz.
Das GitHub-Repository enthält außerdem die CUDA-bezogene SKILL.md-Anweisungsdatei sowie die Agenten-Arbeitsumgebung.
Diese Materialien dokumentieren den Optimierungsworkflow, verfügbare Werkzeuge, Einschränkungen sowie die Einrichtung der Ausführungsumgebung zum Bootstrapping des Agenten.
Das Papier und das Repository beschreiben das Belohnungsdesign, die Warmup-Phasen, die Critic-Initialisierung und das PPO-basierte Trainingsschema zur Stabilisierung langfristiger Optimierungsprozesse.
Dies ist besonders nützlich für Forscher, die sich mit dem Training von Systemprogrammierungs-Agenten befassen, und nicht nur für die Reproduktion der endgültigen Benchmark-Ergebnisse.
CUDA-Kernel-Optimierung trägt einen Großteil der modernen KI-Infrastruktur.
Schnellere Kernel können verbessern:
Der ursprüngliche Artikel von AIBase wies auf dessen Bedeutung im KI-Bereich hin.
Potenzielle Anwendungen in Bereichen wie Infrastruktur, LLM-Inferenzdiensten, autonomen Fahren und quantitativem Handel – in diesen Bereichen können selbst winzige Latenzunterschiede entscheidend sein.
Die Ergebnisse von CUDA Agent bedeuten nicht, dass traditionelle Compiler überholt sind.
torch.compile bleibt eine leistungsstarke automatische Baseline, und die Bewertung von CUDA Agent selbst basiert auf einer kontrollierten Benchmark-Umgebung und einer spezifischen GPU-Umgebung.
Die Schlussfolgerungen dieser Studie sind zwar enger gefasst, aber dennoch wichtig: Mit ausreichendem Ausführungsfeedback und speziell entwickeltem Reinforcement Learning können Sprachmodelle Optimierungsstrategien erlernen, die bei der überwiegenden Mehrheit der getesteten GPU-Kernel-Aufgaben die statische Compiler-Baseline übertreffen.
Das bedeutet, dass die zugrunde liegende Performance-Engineering-Aufgabe in ein sinnvolles Gebiet für agentenbasiertes Lernen verwandelt wird – und nicht nur in eine einmalige Codegenerierung.
CUDA Agent ist ein groß angelegtes agentenbasiertes Reinforcement-Learning-System, das von ByteDance Seed, dem Institute for AI Industry Research (AIR) der Tsinghua-Universität und ihrem gemeinsamen SIA-Lab entwickelt wurde. Es trainiert Sprachmodelle, um CUDA-Kernel iterativ zu schreiben, zu validieren, zu analysieren und zu optimieren.
Die Studie verwendet Seed1.6 als Basismodell. Das Papier beschreibt es als Mixture-of-Experts-Modell mit insgesamt 230 Milliarden Parametern und 23 Milliarden aktiven Parametern.
KernelBench ist ein offener Benchmark zur Bewertung, ob Sprachmodelle korrekte und effiziente GPU-Kernel für PyTorch-Programme generieren können. CUDA Agent wurde auf 250 Aufgaben bewertet, die die Stufen 1 bis 3 von KernelBench abdecken.
torch.compile?Über den gesamten Benchmark hinweg erreicht CUDA Agent eine geometrische mittlere Beschleunigung von 2,11× gegenüber torch.compile. Die generierten Kernel sind bei 96,8 % der bewerteten Aufgaben schneller als die Compiler-Baseline.
Ja. Das System verwendet PPO in Kombination mit mehrstufigem Warmup, Pre-Training des Value-Modells, robustem Reward-Design und langen mehrrundigen Agenten-Trajektorien.
Das Training-Rollout erlaubt bis zu 150 Agentenrunden, während die Evaluierung bis zu 200 Runden erlaubt. Der Trainingskontext des Agenten umfasst 131.072 Token.
Das Projekt hat seine GitHub-Repository, die Agenten-Umgebung, SKILL.md, das Trainingsrezept und den CUDA-Agent-Ops-6K-Datensatz veröffentlicht. Die vollständig trainierten Modellgewichte sind nicht Teil der derzeitigen öffentlichen Veröffentlichung.
CUDA-Agent-Ops-6K ist ein Datensatz mit 6.000 synthetischen Operator-Level-CUDA-Trainingsaufgaben. Er wurde speziell für groß angelegtes agentenbasiertes Reinforcement Learning entwickelt und enthält Filterungsschritte, um sicherzustellen, dass die Aufgaben ausführbar, deterministisch, nicht trivial und von der KernelBench-Evaluierungsmenge getrennt sind.
SKILL.md und veröffentlichten Projektmaterialien.torch.compile-Ausführung zentrale Baselines in der Studie sind.Hochleistungs-CUDA-Kernel-Generierung.“
torch.compile: Offizielle PyTorch-Dokumentation für die in der Studie verwendete Compiler-Baseline.CUDA Agent löst eine spezifische Schwäche in von großen Sprachmodellen generiertem Systemcode: Generierter CUDA-Code muss nicht nur korrekt sein, sondern tatsächlich schneller als compiler-generierte Alternativen.
Ausgehend von Seed1.6 verbesserten die Forscher mit einer CUDA-spezifischen Agenten-Umgebung, Ausführungsfeedback, robustem Reward-Design und PPO-Training mit langem Horizont die Erfolgsquote von 74,0 % auf 98,8 % und den Anteil schnellerer Ergebnisse als torch.compile von 27,2 % auf 96,8 %.
Das Projekt hat außerdem einen Trainingsdatensatz mit 6.000 Aufgaben, SKILL.md, Materialien zur Agenten-Umgebung und ein Trainingsrezept veröffentlicht, die Forschern eine konkrete Grundlage für weitere Arbeiten in Richtung erlernter GPU-Optimierung bieten.
Der wichtigste Beitrag von CUDA Agent besteht darin, zu zeigen, dass Performance-Engineering selbst durch iterative Agenten-Schleifen erlernt werden kann – und nicht nur durch einmalige Codegenerierung approximiert werden muss.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



