For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/deepseek-flash-1017-harness-0-2-1-benchma-1cbf9b44.md.
DeepSeek hat V4.1 Flash zu **DeepSeek-V4.1-Flash-1017** aktualisiert. Die Version konzentriert sich auf besseres Schlussfolgern, Programmier...
DeepSeek hat V4.1 Flash zu DeepSeek-V4.1-Flash-1017 aktualisiert. Die Version konzentriert sich auf besseres Schlussfolgern, Programmieren, Agenten-Workflows und visuelle Aufgaben. Das zentrale Effizienzversprechen: bessere Ergebnisse bei kürzerer Laufzeit und kompakteren Ausgaben.
Laut Änderungsprotokoll vom 17. Oktober wurden die offizielle Website, die App und die API aktualisiert. API-Nutzer verwenden weiterhin deepseek-flash; die Aufrufmethode und die Modellpreise ändern sich durch dieses Update nicht.
DeepSeek empfiehlt außerdem ein Upgrade auf DeepSeek Harness 0.2.1-rc.1 oder höher, um die vorgesehene Nutzung zu ermöglichen. Die Veröffentlichung richtet sich ausdrücklich an Harness und andere Agentenplattformen, darunter Tencent CodeBuddy und WorkBuddy, und nicht nur an die Verbesserung eigenständiger Chat-Antworten.
Der vorgelegte Bericht beschreibt eine begrenzte Gutschrift von 6 RMB für berechtigte Erstnutzer, die sich bei Harness anmelden. Sie ist ab Erhalt sieben Tage gültig und nur verfügbar, solange der Vorrat reicht. Dabei handelt es sich um eine gemeldete Werbeaktion, nicht um einen dauerhaft geltenden API-Anspruch. Ob sie gilt und wann sie abläuft, sollte anhand der Angaben im jeweiligen Konto geprüft werden.
Die offizielle Modellkarte bezeichnet dies als kleinere Aktualisierung von V4.1 Flash. Die gemeldeten Änderungen bei mehreren agentenorientierten Benchmarks sind jedoch erheblich. So steigt Terminal-Bench 4.0 von 31,2 auf 42,3, während ProgramBench von 20,3 auf 29,1 zulegt.
Die folgende Tabelle gibt die Vergleiche aus der Quelle und der offiziellen Modellkarte wieder. Es handelt sich um angegebene Benchmark-Ergebnisse, nicht um Messwerte eines neuen, unabhängigen Testlaufs.
| Benchmark | Flash-1017 | Vorheriges V4.1 Flash | Kimi K3 | GLM-5.3 | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|---|---|---|
| HLE, ohne Tools | 42,6 (44,0*) | 36,8 (39,1*) | 43,5 | 42,0* | 44,5 | 56,3 |
| Terminal-Bench 4.0 | 42,3 | 31,2 | 12,6 | 37,9 | 39,9 | 51,8 |
| DeepSWE v1.1 | 77,0 | 74,2 | 67,5 | 66,9 | 73,0 | 74,0 |
| ProgramBench | 29,1 | 20,3 | 17,5 | 19,0 | 23,0 | 37,0 |
| NL2Repo-Bench | 68,2 | 65,4 | 58,0 | 58,0 | 56,8 | 75,3 |
| Automation-Bench v1.0.6 | 60,5 | 54,8 | 46,7 | 48,8 | 45,8 | 50,3 |
| Agents' Last Exam | 35,4 | 31,8 | 27,6 | 28,5 | 26,7 | 28,6 |
| Apex Bench v1.1 | 72,1 | 64,6 | 47,8 | 56,6 | 54,3 | 65,8 |
| Chartography, mit Tools | 83,0 | 78,9 | 68,1 | Nicht angegeben | 79,9 | 84,0 |
| BabyVision, mit Tools | 92,5 | 89,6 | 85,7 | Nicht angegeben | 88,9 | 94,1 |
| ZeroBench-main, mit Tools | 51,0 | 49,0 | 41,0 | Nicht angegeben | 53,0 | 52,0 |
* kennzeichnet die textbasierte HLE-Teilmenge. Für Terminal-Bench 4.0 wurde das Claude-Code-Harness verwendet, für DeepSWE v1.1 Mini-SWE-V2. In der Quellentabelle wird für ZeroBench-main Pass@5 angegeben. Die Ergebnisse dieser unterschiedlichen Aufgaben und Evaluierungsbedingungen sollten nicht zu einer allgemeinen Erfolgsquote zusammengefasst werden.
Das markantere Versprechen betrifft das Verhältnis zwischen Ergebnissen und Aufwand. DeepSeek gibt an, Laufzeit und Ausgabelänge reduziert und gleichzeitig die Leistung verbessert zu haben. Damit soll sich die Leistung-Kosten-Grenze über mehrere Harnesses hinweg erweitern.
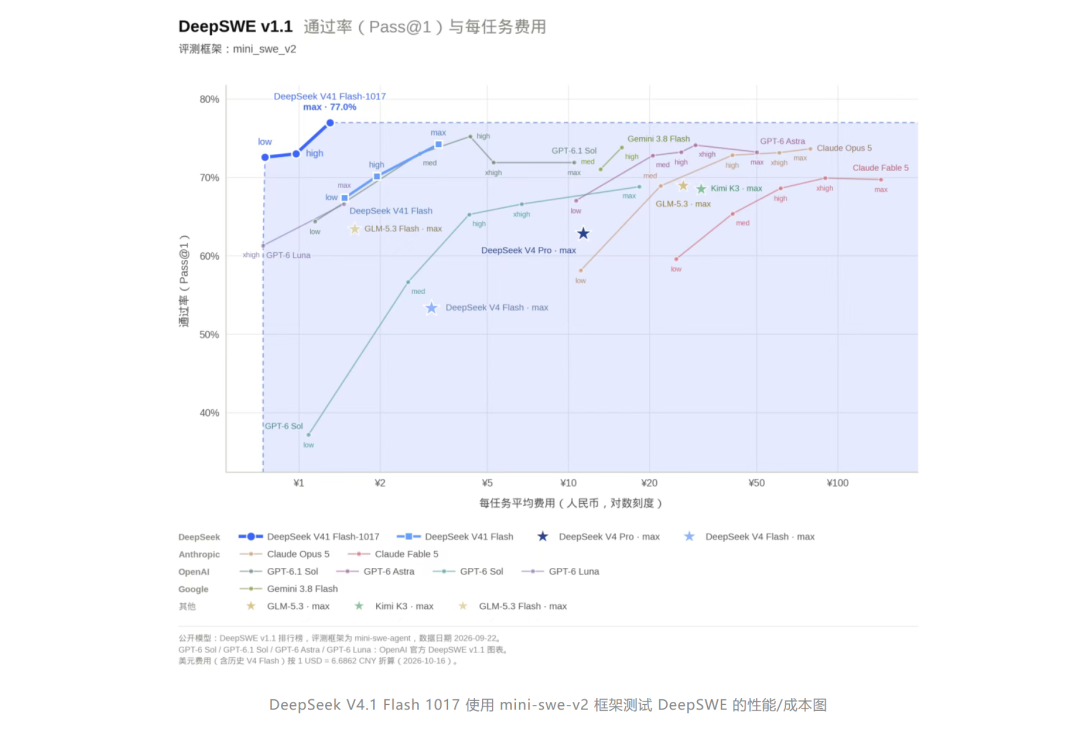
Das Diagramm vergleicht konkrete Aufgabenläufe, Harnesses und Reasoning-Einstellungen. Es bedeutet nicht, dass jedes Projekt günstiger wird oder dass sich ein bestimmter Wert in einer anderen Umgebung garantiert erreichen lässt. Tool-Ausführung, Wiederholungsversuche, Ausgabelänge und die genaue Formulierung einer Aufgabe wirken sich weiterhin auf die Kosten aus.
Die Quelle beschreibt die Programmierdemonstrationen der Veröffentlichung als Schritt hin zu einem Ansatz, bei dem ein gewünschtes Ergebnis beschrieben wird und der Agent anschließend Planung, Implementierung, Ausführung, Prüfung und Überarbeitung übernimmt. Das iterative Verhalten wird auf Reinforcement Learning mit Selbst-Feedback zurückgeführt.
Ein vorgestelltes Ergebnis ist eine navigierbare 3D-Szene nach dem Vorbild der Verbotenen Stadt. Statt eines einzelnen statischen Bildes zeigt das Beispiel einen per Code erstellten Schauplatz mit veränderbaren Blickwinkeln.
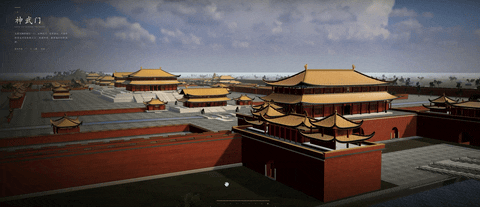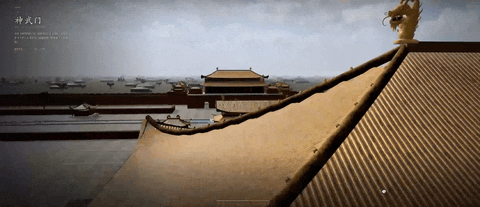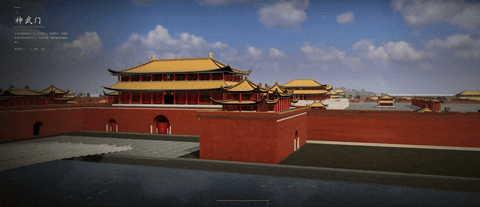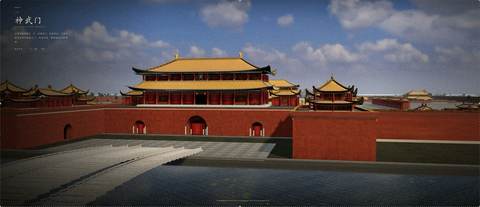
Weitere Beispiele sind ein browserbasiertes Rennspiel, ein von Portal inspiriertes Godot-Projekt und eine dynamische 3D-Welt, die verschiedene historische Epochen durchläuft.
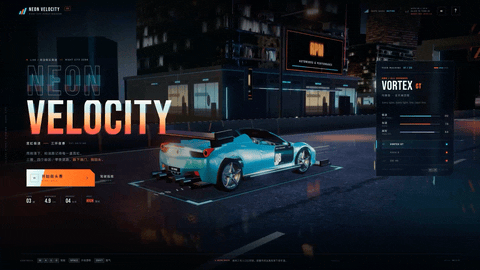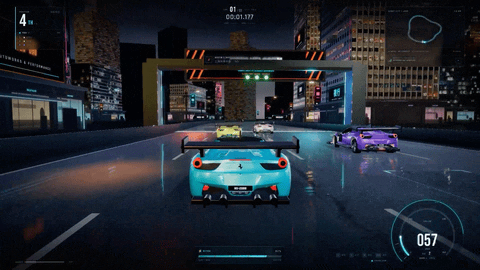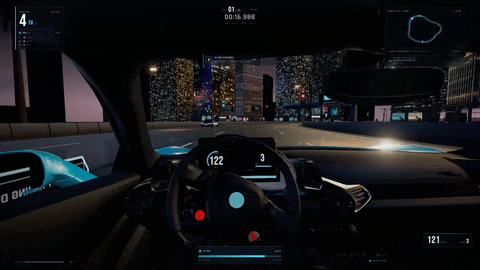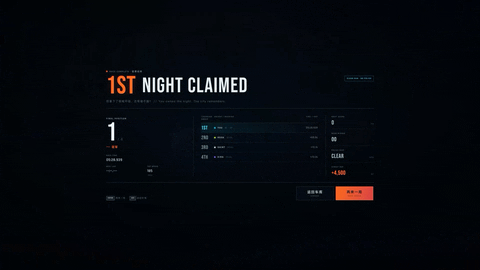
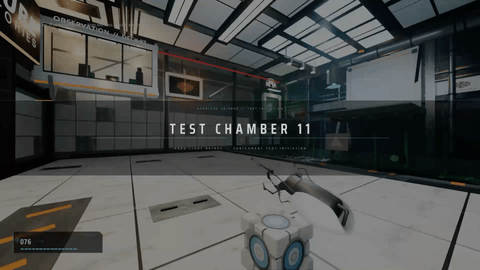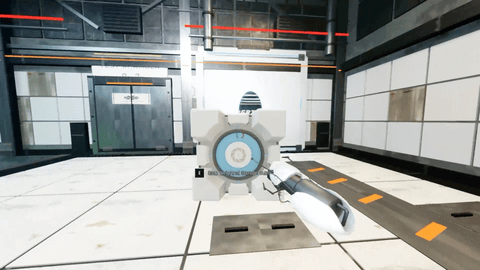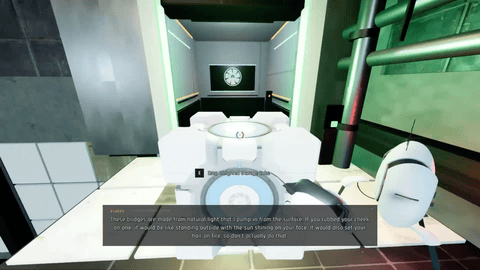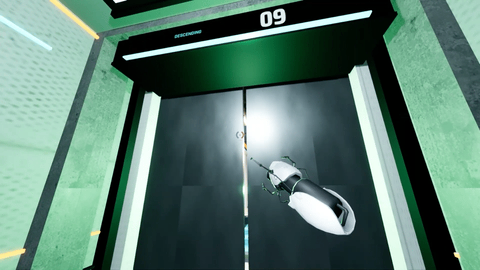
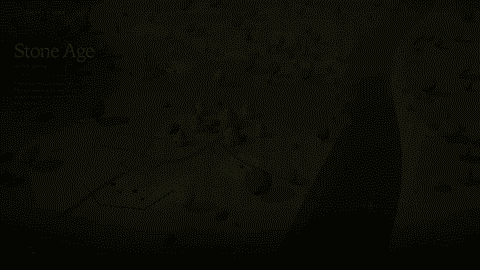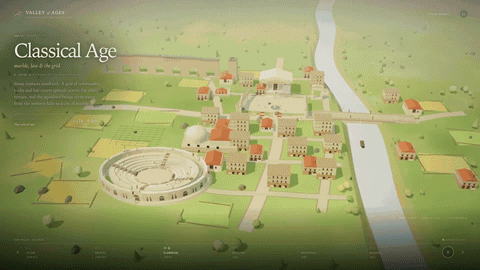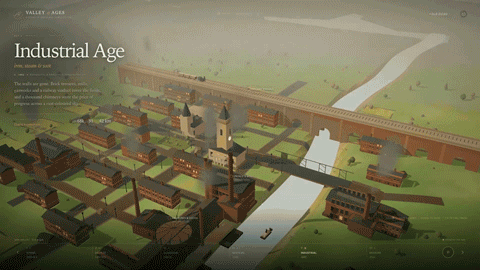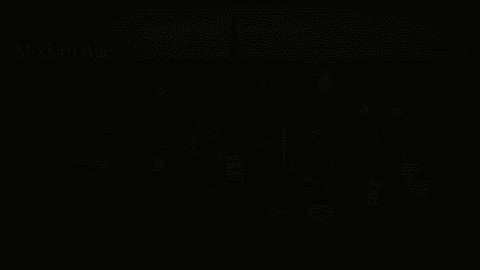
Diese Aufnahmen zeigen die für die Berichterstattung zur Veröffentlichung ausgewählten Beispiele. Sie geben weder eine vollständige Erfolgsquote über verschiedene Prompts hinweg noch den Umfang manueller Eingriffe oder die Reproduzierbarkeit durch neue Nutzer an. Auch ein überzeugender Screenshot ersetzt weder Funktionstests noch eine Prüfung des generierten Codes.
Vor der Ankündigung sollen Nutzer kurzzeitig einen Eintrag in der Modellliste entdeckt haben, der auf 1017 endete. Die Quelle berichtet außerdem von einer Änderung des System-Fingerprints von deepseek-flash sowie von informellen Meldungen über schnellere und knappere Ausgaben.
Eine Änderung des Fingerprints kann auf eine Änderung des Bereitstellungs- oder Konfigurationsverfahrens hindeuten. Für sich genommen belegt sie jedoch weder die Identität noch die Architektur oder Qualität eines Modells. Ebenso sind von Nutzern geteilte Szenenvergleiche einzelne Beispiele und keine kontrollierten Tests.
Das spätere Änderungsprotokoll und das Modell-Repository liefern eine eindeutigere Bestätigung: Es gibt eine benannte Veröffentlichung von DeepSeek-V4.1-Flash-1017, eine dokumentierte Benchmark-Tabelle und einen aktualisierten gehosteten Dienst. Die Existenz der Version muss nicht aus den früheren Hinweisen abgeleitet werden.
Laut Repository stehen Code und Gewichte unter der MIT-Lizenz. Außerdem verweist es Entwickler auf eine Referenz zur Kodierung und auf Inferenzanweisungen. Diese Veröffentlichung enthält keine Chat-Vorlage im Jinja-Format. Solche Implementierungsdetails sind für das selbst gehostete Modell wichtiger als ein allgemein und automatisch erzeugter Schnellstartbefehl.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Parallel zur Modellaktualisierung hat DeepSeek zwei Schnittstellen für das eigene Suchsystem freigegeben. Search findet relevante Seiten, während Fetch den Inhalt einer ausgewählten URL als Markdown abruft.
| API | Endpunkt | Funktion |
|---|---|---|
| Search | POST https://api.deepseek.com/v1/tools/search | Gibt sortierte Suchergebnisse zurück, optional mit Seiteninhalten. |
| Fetch | POST https://api.deepseek.com/v1/tools/fetch | Gibt den Seitentitel und den Seiteninhalt als Markdown zurück. |
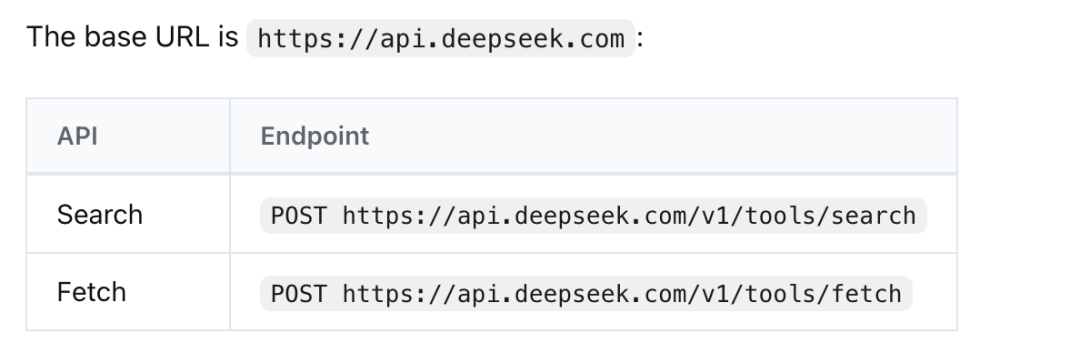
Für die Authentifizierung benötigen die APIs einen DeepSeek-API-Schlüssel. Search unterstützt Operatoren zum Ein- oder Ausschließen von Websites, zur Einschränkung der Sprache und zum Filtern nach Veröffentlichungsdatum. Ein Agent kann zunächst nach Quellen suchen, anschließend ausgewählte Seiten abrufen und deren Inhalte im nächsten Analyseschritt verwenden.
Der Abruf hängt weiterhin von der Verfügbarkeit der Zielwebsite und deren Zugriffsrichtlinien ab. Die Bereitstellung einer Search-API verschafft einem Agenten keinen uneingeschränkten Zugang zu allen Seiten im Internet.
Beide APIs werden pro erfolgreicher Anfrage abgerechnet, getrennt von den Gebühren für Modell-Tokens. Im chinesischen Leitfaden sind 5 RMB pro 1.000 erfolgreiche Anfragen für Search und für Fetch aufgeführt; der englische Leitfaden nennt jeweils 0,75 US-Dollar pro 1.000. Dies sind die in den jeweiligen Leitfäden veröffentlichten Preise und keine hier berechnete Währungsumrechnung.
Eine Anfrage ist kostenpflichtig, wenn sie den HTTP-Status 200 und ein brauchbares Ergebnis zurückgibt: bei Search eine nicht leere Ergebnisliste, bei Fetch Seiteninhalte. Fehlgeschlagene Anfragen, ergebnislose Suchen und Zeitüberschreitungen werden nicht berechnet. Die Angabe einer höheren Ergebniszahl über count ändert den Preis pro Anfrage nicht.
Die Leitfäden enthalten eine besondere Übergangsregel für Nutzer, die über Harness, Claude Code oder Codex auf DeepSeek zugreifen. Serverseitige Search- und Fetch-Tool-Aufrufe in diesen Workflows sind derzeit kostenlos; die Abrechnung pro Anfrage soll am 1. November 2026 um 00:00 Uhr Pekinger Zeit beginnen. Daraus folgt nicht, dass Modellinferenz oder jede direkte API-Anfrage bis zu diesem Datum kostenlos ist.
Es handelt sich um das Update von DeepSeek V4.1 Flash vom 17. Oktober. DeepSeek meldet Verbesserungen beim Schlussfolgern, Programmieren, bei Agentenaufgaben und bei visuellen Benchmarks sowie kürzere Ausgaben und kürzere Aufgabenausführungszeiten.
Laut Änderungsprotokoll soll für die gehostete API weiterhin deepseek-flash verwendet werden. Die Aufrufmethode und die Modellpreise bleiben durch diese Veröffentlichung unverändert.
DeepSeek empfiehlt für das aktualisierte Modell Version 0.2.1-rc.1 oder höher. Prüfen Sie die Version über den offiziellen Aktualisierungsmechanismus des Produkts, anstatt davon auszugehen, dass jede frühere Version der Reihe 0.2 dieselbe Integration bietet.
Nein. Die Berichterstattung zeigt ausgewählte Beispiele und keine gemessene Erfolgsquote für beliebige Prompts. Um ein interaktives Projekt nachzubilden, müssen Ausführung, Steuerung, Assets und generierter Code in der tatsächlichen Umgebung geprüft werden.
Search findet passende Seiten und gibt sortierte Ergebnisse zurück, optional mit Inhalten. Fetch ruft eine angegebene URL ab und gibt Titel und Markdown-Inhalt zurück – sofern die betreffende Website zugänglich ist.
Der im Leitfaden genannte vorübergehende Zeitraum ohne Berechnung gilt ausdrücklich für serverseitige Tool-Aufrufe über die genannten Agenten-Workflows. Die Abrechnung pro Anfrage für diese Aufrufe beginnt am 1. November 2026 um 00:00 Uhr Pekinger Zeit. Die Abrechnung für Modell-Tokens ist davon getrennt.
DeepSeek-V4.1-Flash-1017 verbindet bessere, gemeldete Agenten-Benchmark-Ergebnisse mit dem Ziel, den Aufgabenaufwand zu reduzieren. Bestehende gehostete Integrationen verwenden weiterhin den Alias deepseek-flash; Harness-Nutzer sollten auf die empfohlene Version aktualisieren.
Search und Fetch ergänzen den Workflow um die Suche nach Quellen und das Lesen von Seiten. Die Abrechnung pro Anfrage muss dabei getrennt von den Modell-Token-Kosten betrachtet werden.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



