For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/deepseek-flash-api-update-claims-what-is-2cceab91.md.
Einige DeepSeek-Nutzer glauben, dass die offizielle API bei der Erstellung visueller Coding-Demos deutlich besser geworden ist. In einem Ber...
Einige DeepSeek-Nutzer glauben, dass die offizielle API bei der Erstellung visueller Coding-Demos deutlich besser geworden ist. In einem Bericht vom 15. Oktober sammelte QbitAI Beispiele für detailliertere Szenen, flüssigere Animationen und verbesserte Beleuchtung; Nutzer datierten die wahrgenommene Veränderung auf etwa den 12. Oktober.
Das ist ein interessantes Signal, lässt jedoch eine wichtige Frage offen: Hat sich das zugrunde liegende Modell verändert, oder haben mehrere ungewöhnlich gute Generierungen diesen Eindruck erzeugt? Die öffentlich dokumentierte Modellzuordnung ist eindeutig. Das gemutmaßte Oktober-Update wird durch die für diesen Artikel geprüften offiziellen Materialien nicht bestätigt.
Die Beispiele im Bericht von QbitAI konzentrieren sich größtenteils auf generierte visuelle Projekte. Nutzer verweisen auf spielähnliche Szenen, ein Projekt im Minecraft-Stil und die bekannte Herausforderung, einen Pelikan auf einem Fahrrad darzustellen. Ihre Aufmerksamkeit gilt der Qualität des Ergebnisses: mehr Details, überzeugendere Bewegungen und eine stärkere Gesamtpräsentation.
Einige berichten zudem von einer langsameren Generierung. Das kann in einem Coding-Workflow relevant sein, in dem ein besseres Endartefakt zusätzliche Wartezeit rechtfertigen könnte. Diese Berichte belegen jedoch keine gemessene Veränderung der Servicelatenz über die API hinweg.
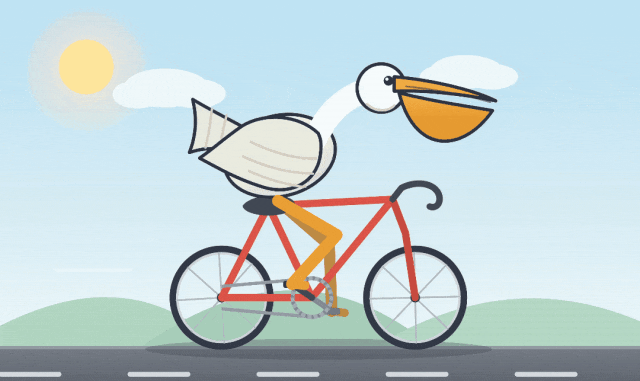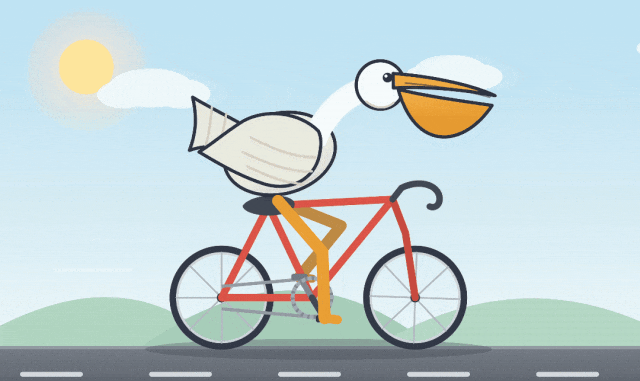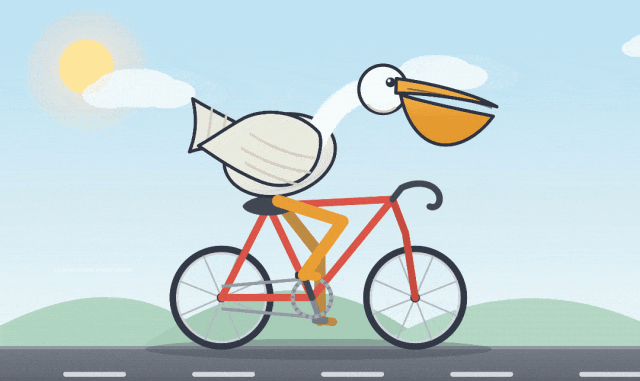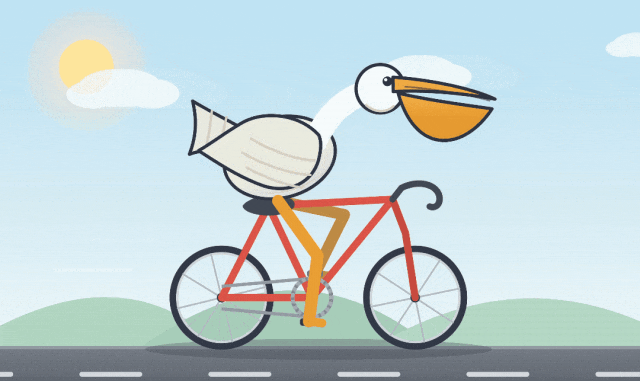
Quelle: QbitAI über BAAI Hub. Dieses illustrative Ergebnis ist eines der im Bericht besprochenen Beispiele und kein Nachweis für einen bestimmten Modell-Checkpoint.
Die Quelle hält auch Widerspruch fest. Andere Tester sahen keine klare Verbesserung, und zufällige Variationen blieben eine plausible Erklärung. Diese gemischten Beobachtungen gehören zur Geschichte und sind kein Detail, das zugunsten der stärksten Screenshots ausgeblendet werden kann.
Die API-Einführung von DeepSeek führt derzeit deepseek-flash und deepseek-v4-pro als dokumentierte Modellnamen auf. Sie ordnet deepseek-flash DeepSeek-V4.1-Flash zu.
Die offizielle Release-Ankündigung vom 10. September nennt DeepSeek-V4.1-Flash als veröffentlichtes Modell. Die am 15. Oktober geprüfte Update-Seite zeigte diese September-Veröffentlichung als neuesten sichtbaren Eintrag, ohne eine separate Ankündigung vom 12. Oktober.
| Name oder Behauptung | Was die geprüften Quellen belegen |
|---|---|
deepseek-flash | Der dokumentierte API-Name, der DeepSeek-V4.1-Flash zugeordnet ist. |
deepseek-v4-pro | Ein separat dokumentiertes Modell, das weiterhin verfügbar ist. |
deepseek-v4-flash | Ein Legacy-Alias, dessen eingestelltes zugrunde liegendes Modell auf V4.1-Flash geroutet wird. |
deepseek-v4-flash-vision-exp | Ein weiterer akzeptierter Legacy-Alias, der auf V4.1-Flash geroutet wird. |
| Ein Oktober-Release namens V4.2 Flash | Spekulationen der Community im Bericht; nicht durch die geprüften offiziellen Quellen bestätigt. |
Dieses Routing-Detail macht Vergleiche komplizierter. Zwei Anfragen mit unterschiedlichen Namen können dasselbe dokumentierte zugrunde liegende Modell erreichen. Daher ist ein Vergleich eines alten Alias mit deepseek-flash nicht automatisch ein Vergleich zweier Modellgenerationen.
Das Fehlen eines Changelog-Eintrags beweist nicht, dass keine Backend-Anpassung erfolgt ist. Es bedeutet, dass die verfügbaren offiziellen Aufzeichnungen die konkret verbreiteten Behauptungen über eine neue Version nicht belegen.
QbitAI beschreibt mehrere konkurrierende Erklärungen, die von Nutzern vorgeschlagen wurden: ein mögliches V4.2-Flash-Release, ein überarbeiteter V4.1-Checkpoint oder eine Änderung an einer anderen Modellkonfiguration. Keine davon lässt sich allein durch die Betrachtung einer generierten Szene belegen.
Eine Coding-Demo kann durch ein stärkeres visuelles Design besser aussehen und dennoch Fehler bei Eingabeverarbeitung, Kollisionslogik oder Leistung enthalten. Einige ausgewählte Erfolge sagen zudem wenig über die Fehlerrate bei gewöhnlichen Aufgaben aus.
Auch die Konfiguration der API ist relevant. Die Chat-Completion-Referenz von DeepSeek dokumentiert Thinking-Steuerungen und Reasoning-Aufwand. Ein sinnvoller Vergleich muss diese Einstellungen daher zusammen mit dem Prompt erfassen. Eine Anfrage mit einem anderen Reasoning-Budget ist kein gleichwertiger Test, selbst wenn die sichtbaren Anweisungen identisch sind.
Ein besonders leicht zu begehender Fehler ist die Annahme, bekannte Sampling-Parameter verhielten sich in jedem Modus gleich. Die aktuelle Referenz erklärt, dass temperature im Thinking-Modus keine Wirkung hat. Sie beschreibt außerdem modusspezifisches Verhalten für top_p, das geprüft werden sollte, bevor eine Parameteränderung als Erklärung für ein Ergebnis herangezogen wird.
Der sinnvollste nächste Schritt ist ein wiederholbarer Vergleich mit Aufgaben, die für Sie tatsächlich wichtig sind. Er kann klein sein, sollte aber ausreichend detailliert sein, um eine echte Verbesserung im Workflow von einer beeindruckenden Einzelgenerierung zu unterscheiden.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die API-Antwort enthält Felder wie model, system_fingerprint, created, Nutzung und finish_reason. Diese können einen Vergleich leichter überprüfbar machen. Die Dokumentation beschreibt system_fingerprint als Kennzeichnung der Backend-Konfiguration; das Feld sollte nicht als öffentlicher Decoder für exakte Modellgewichte oder als Ankündigung eines benannten Releases behandelt werden.
Für Teams, die die API bereits in Produktion einsetzen, bietet ein gespeicherter Evaluierungssatz außerdem eine praktische Ausgangsbasis für spätere Änderungen. Ein Ergebnis kann dann präzise beschrieben werden: Beispielsweise haben unter einer dokumentierten Konfiguration mehr Aufgaben bestanden, bei einer gemessenen Latenzdifferenz. Das ist umsetzbarer als die Behauptung, das Modell fühle sich einfach intelligenter an.
Der Bericht ist ein nützlicher Anlass, ein Modell bei Aufgaben erneut zu prüfen, bei denen frühere Ergebnisse schwach waren. Er belegt jedoch weder eine neue Deployment-Anforderung noch einen neuen Endpoint oder ein bestätigtes Ersatzmodell.
DeepSeek dokumentiert weiterhin die OpenAI-kompatible Basis-URL als https://api.deepseek.com und die Anthropic-kompatible Basis-URL als https://api.deepseek.com/anthropic. Dies sind API-Serviceadressen und keine Links, die im Browser eine gewöhnliche Dokumentationsseite bereitstellen sollen. Bestehende Integrationen sollten der aktuellen offiziellen Referenz folgen, statt Modellnamen aufgrund einer Vermutung aus sozialen Medien zu ändern.
Wenn das Budget wichtig ist, vergleichen Sie die aktuelle Preisseite mit dem tatsächlich verwendeten Modell und Nutzungsmuster. Eine wahrgenommene Qualitätsverbesserung allein belegt nicht, dass Antwortlänge, Latenz oder die Kosten für das Abschließen einer Aufgabe konstant geblieben sind.
In dem am 15. Oktober 2026 geprüften offiziellen Changelog wurde keine solche Ankündigung gefunden. QbitAI berichtet über Nutzerbeobachtungen um dieses Datum, die für sich allein kein Release bestätigen.
deepseek-flash derzeit?Die offizielle API-Einführung ordnet es DeepSeek-V4.1-Flash zu. Entwickler sollten diese aktuelle Dokumentation konsultieren, wenn sie die gegenwärtige Zuordnung benötigen, statt sie aus generierten Ergebnissen abzuleiten.
Laut Dokumentation werden deepseek-v4-flash und deepseek-v4-flash-vision-exp weiterhin akzeptiert, aber ihre ursprünglichen zugrunde liegenden Modelle wurden eingestellt. Anfragen über diese Aliasse werden zu V4.1-Flash geroutet und zu Flash-Preisen abgerechnet.
system_fingerprint, dass ein neues Modell veröffentlicht wurde?Nein. Das Feld kennzeichnet die Backend-Konfiguration und kann helfen, Unterschiede zwischen Durchläufen zu dokumentieren. Es identifiziert jedoch nicht eigenständig einen benannten Checkpoint und beweist keine spezifische Änderung der Modellgewichte.
Die aktuelle Chat-Completion-Referenz besagt, dass temperature im Thinking-Modus keine Wirkung hat. Dokumentieren Sie die Thinking- und Reasoning-Aufwand-Einstellungen, halten Sie die Aufgabe konstant und nutzen Sie wiederholte Versuche, statt anzunehmen, dass die Temperatur solche Durchläufe vergleichbar macht.
Trennen Sie die visuelle Bewertung von Funktionstests. Prüfen Sie Steuerung, Zustandsänderungen, Laden und Laufzeitfehler. Vergleichen Sie anschließend mehrere Versuche mit denselben Anforderungen und dokumentierten Einstellungen.
Der Bericht von QbitAI weist auf eine Gruppe von Nutzern hin, die stärkere visuelle Coding-Outputs von DeepSeek beobachten, während andere Tester nicht überzeugt sind. Die offizielle Dokumentation ordnet deepseek-flash V4.1-Flash zu, doch das geprüfte Changelog bestätigt das gemutmaßte Oktober-Update nicht.
Betrachten Sie die Beispiele als Anlass für eine kontrollierte Evaluierung und trennen Sie eine behauptete Verbesserung von einer unbestätigten Geschichte über eine neue Modellversion.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



