DeepSeek V4 Flash 0731 hat eine ungewöhnliche Mischung aus Reaktionen hervorgerufen. Entwickler sind von seinen Coding-Agent-Ergebnissen bee...
DeepSeek V4 Flash 0731 hat eine ungewöhnliche Kombination von Reaktionen hervorgerufen.
Entwickler sind von seinen Coding-Agent-Ergebnissen beeindruckt.
Infrastrukturteams interessieren sich für den 1-Millionen-Token-Kontext und die geringe Anzahl aktiver Parameter.
KI-Plattformen bieten kostenlose Nutzung und aggressive Rabatte an.
Und soziale Medien füllen sich mit Screenshots von Prototypen, deren gemeldete Inferenzkosten in Cent statt in Dollar gemessen werden.
Die am häufigsten geteilten Beispiele im Quellartikel waren:
Diese Beispiele fangen die Begeisterung ein, können aber auch mehrere unterschiedliche Dinge vermischen:
Das Modell ist wirklich günstig.
Das bedeutet nicht, dass jede Anwendung sieben Cent kosten wird.
Die nützliche Frage ist nicht, ob ein viraler Demo-Versuch exakt reproduzierbar ist. Es geht darum, wie DeepSeek einen so großen Fähigkeitssprung erreicht hat, ohne die Basisarchitektur zu ändern – und was die neue Kostenstruktur für Entwickler bedeutet.
Der offizielle API-Preis war bereits niedrig, bevor Drittanbieter-Aktionen angewendet wurden.
DeepSeek listet derzeit die folgenden Preise pro Million Tokens:
| Nutzungstyp | DeepSeek-V4-Flash-Preis |
|---|---|
| Eingabe, Cache-Treffer | 0,0028 $ |
| Eingabe, Cache-Fehl | 0,14 $ |
| Ausgabe | 0,28 $ |
Die API unterstützt:
low, high und max.Diese offiziellen Preise sind die Basislinie.
Plattformen können dann wählen:
Aus diesem Grund zahlt ein Entwickler möglicherweise den Listenpreis von DeepSeek, während ein anderer für einen begrenzten Zeitraum nichts zahlt.
OpenCode gab öffentlich bekannt, dass DeepSeek Flash am 1. August 8 Billionen Tokens über seine Plattform verarbeitet hat.
Der Beitrag schlüsselt die Zahl wie folgt auf:
5 T Tokens kostenlose Nutzung
+
3 T Tokens über OpenCode Go

Die aktuelle Zen-Dokumentation von OpenCode listet eine DeepSeek V4 Flash Free-Option auf, die für einen begrenzten Zeitraum verfügbar ist.
Dies ist eine wichtige Unterscheidung.
Die Zahl von acht Billionen Tokens bezieht sich auf den Datenverkehr über OpenCode, nicht auf die direkte Nutzung, die DeepSeek auf allen Plattformen meldet.
Es ist dennoch ein starkes Signal dafür, dass kostengünstige Modelle eine enorme Nachfrage erzeugen können, wenn sie in einen beliebten Coding-Agent-Workflow integriert werden.
Nous Research kündigte eine siebentägige Aktion an, bei der DeepSeek V4 Flash 0731 über Nous Portal in Zusammenarbeit mit Novita Labs mit 90 % Rabatt angeboten wird.

Der Werbebeitrag verglich die rabattierten Kosten mit Claude Fable 5 und behauptete einen mehr als 1.000-fachen Preisunterschied bei vergleichbaren Aufgaben.
Dieser Vergleich hängt von mehreren Faktoren ab:
Ein Preis-pro-Token-Vergleich ist nützlich, aber die aussagekräftigere Kennzahl ist:
Gesamtkosten pro akzeptierter Aufgabe
Ein Modell, das weniger teure Tokens verwendet, kann günstiger sein als ein billiges Modell, das wiederholt neu versucht.
Umgekehrt kann der Kostenvorteil enorm werden, wenn ein günstiges Modell auch leistungsfähig genug ist, die Aufgabe schnell abzuschließen.
Cline kündigte zunächst eine kostenlose Nutzung von V4 Flash 0731 über seinen Coding-Agent an.
Ein späterer öffentlicher Beitrag erklärte, das kostenlose Kontingent sei verdreifacht worden, da die Wirtschaftlichkeit nachhaltig erscheine.

Clines aktueller Modellkatalog und die ClinePass-Materialien enthalten DeepSeek V4 Flash als schnelle, kostengünstige Option für fokussierte Codierungsaufgaben.
Kostenlose Kontingente und Modellverfügbarkeit können sich ändern, daher sollten Nutzer die Live-Anbieterseite prüfen, anstatt sich auf einen alten Screenshot zu verlassen.
Die breitere Lektion ist dauerhafter.
Wenn Inferenz billig genug wird, kann eine Agentenplattform kostenlosen Zugang als Kundengewinnung nutzen, ohne die Kosten absorbieren zu müssen.
die gleichen Kosten, die es mit einem Premium-Frontier-Modell hätte.
Der Quellartikel enthält ein Dashboard mit:
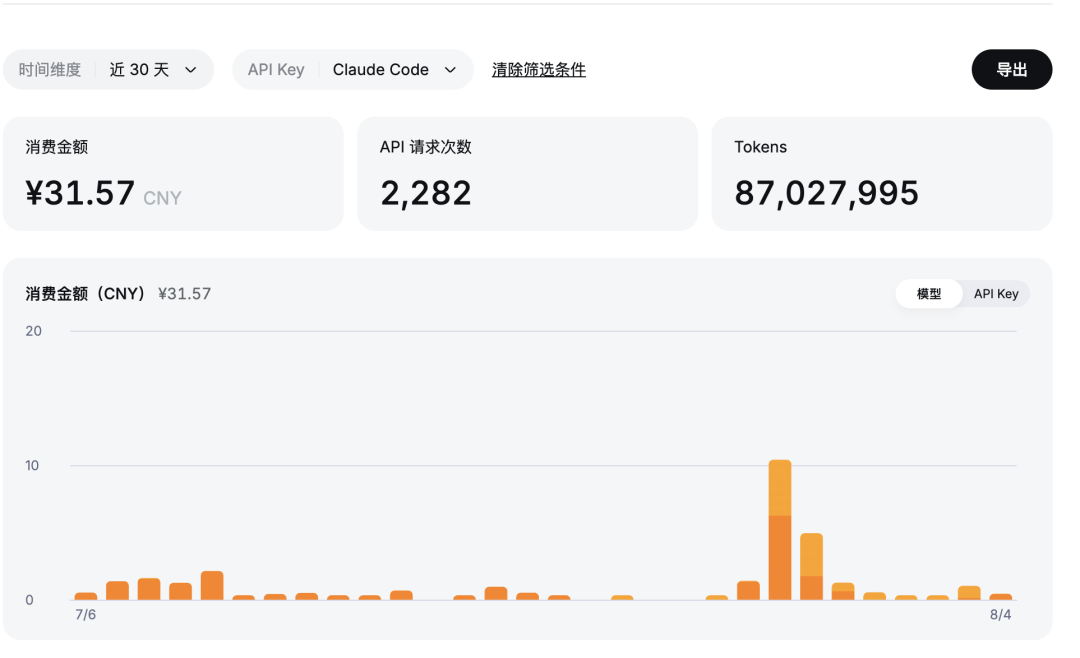
Der Screenshot ist nützlich, weil er die Größenordnung veranschaulicht, die Entwickler unter günstigen Nutzungsmustern sehen könnten.
Er enthält jedoch nicht genügend Informationen, um die Rechnung exakt zu rekonstruieren.
Zu den fehlenden Variablen gehören:
Ein langes, wiederholtes Systemprompt kann extrem günstig sein, wenn es den Cache trifft.
Ein langes, einzigartiges Prompt, das einmal gesendet wird, wird zum Cache-Miss-Eingabepreis abgerechnet.
Die Ausgabe ist außerdem viel teurer als der Cache-Eingang.
Bei Agentensystemen dominieren diese Unterschiede die endgültige Rechnung.
DeepSeek V4 Preview wurde am 24. April 2026 veröffentlicht.
Die Familie umfasste:
Die Preview-Veröffentlichung etablierte die Hauptarchitektur:
V4 Flash Preview wurde als die kleinere, schnellere und günstigere Alternative zu V4 Pro positioniert.
Das Update vom 31. Juli veränderte seine Wettbewerbsposition.
DeepSeek gibt an, dass V4 Flash 0731 dieselbe Modellarchitektur und -größe wie V4 Flash Preview verwendet.
Das Update entstand durch die Durchführung eines neuen Post-Training-Prozesses.
In vereinfachter Form:
Gleiche vortrainierte Basisarchitektur
+
neues Post-Training und Agentenoptimierung
=
wesentlich stärkeres Coding-Agent-Verhalten
Das ist wichtig, weil es zeigt, wie viel Leistungsfähigkeit in einem vortrainierten Modell latent vorhanden sein kann.
Architektur und Parameteranzahl sind nicht das gesamte Produkt.
Das Post-Training bestimmt, wie effektiv das Modell:
Die ursprüngliche V4-Flash-Modellkarte beschreibt das Basismodell wie folgt:
| Spezifikation | DeepSeek V4 Flash |
|---|---|
| Gesamte Basis-MoE-Parameter | 284B |
| Aktivierte Parameter | 13B |
| Kontextlänge | 1M |
| Lizenz | MIT |
| Hauptmodalität | Text |
| Basispräzision | FP8 / gemischte Niedrigpräzision je nach Checkpoint |
Die Modellkarte von 0731 besagt, dass die neue Version dieselbe Struktur wie die DSpark-Variante hat und ein angehängtes Modul für spekulative Dekodierung enthält.
Das erklärt, warum einige Metadaten von Modelldateien möglicherweise Folgendes zeigen
eine größere Gesamtzahl an Checkpoints als die 284B-Basis-MoE-Zahl.
Die klarste Beschreibung ist:
Das zugrunde liegende MoE-Modell von V4 Flash bleibt bei insgesamt etwa 284B mit 13B aktiven Parametern, während das 0731-Release zusätzlich die DSpark-Spekulationsdekodierungskomponente im veröffentlichten Checkpoint enthält.
Die Spekulationsdekodierung verwendet einen schnellen Entwurfsprozess, um mehrere zukünftige Tokens vorzuschlagen.
Das Hauptmodell überprüft dann diese Vorschläge.
Wenn Vorhersagen akzeptiert werden, kann das System mehrere Tokens mit weniger sequenzieller Arbeit erzeugen.
DeepSeeks 0731-Modellkarte bietet expliziten DSpark-Support für vLLM und SGLang.
Für vLLM lautet die relevante Konfiguration:
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Für SGLang verwendet die Modellkarte:
--speculative-algorithm DSPARK
DSpark verbessert nicht selbst die Denkfähigkeit des Modells.
Es ist eine Inferenzoptimierung, die darauf abzielt, die Dekodierungslatenz zu reduzieren oder den Durchsatz zu erhöhen, während die Ausgabeverteilung des Zielmodells unter der unterstützten Konfiguration erhalten bleibt.
DeepSeek veröffentlicht den folgenden Vergleich für V4 Flash 0731:
| Benchmark | V4 Flash 0731 | V4 Flash Preview | V4 Pro Preview |
|---|---|---|---|
| Terminal Bench 2.1 | 82,7 | 61,8 | 72,1 |
| NL2Repo | 54,2 | 39,4 | 38,5 |
| CyberGym | 76,7 | 38,7 | 52,7 |
| DeepSWE | 54,4 | 7,3 | 12,8 |
| Toolathlon-Verified | 70,3 | 49,7 | 55,9 |
| Agents' Last Exam | 25,2 | 15,8 | 16,5 |
| AutomationBench Public | 25,1 | 10,8 | 12,8 |
| DSBench-FullStack | 68,7 | 37,0 | 41,8 |
| DSBench-Hard | 59,6 | 25,8 | 31,1 |
Der dramatischste Anstieg ist bei DeepSWE:
7,3 → 54,4
CyberGym verdoppelt sich fast:
38,7 → 76,7
Terminal Bench 2.1 steigt um mehr als zwanzig Punkte:
61,8 → 82,7
Das neue Flash-Modell übertrifft V4 Pro Preview auch bei jedem Benchmark in DeepSeeks veröffentlichter Tabelle.
Das ist eine bedeutende Veränderung für ein Modell, das ursprünglich vor allem als günstigere und schnellere Option positioniert war.
Die Tabelle sollte nicht als reiner Vergleich roher Checkpoints gelesen werden.
DeepSeeks Modellkarte enthält mehrere wichtige Hinweise.
Für öffentliche Code-Agent-Aufgaben verwendete das Unternehmen:
DeepSeek Harness Minimalmodus
Reasoning-Effort: max
Temperatur: 1,0
Top-p: 0,95
DeepSeek Harness war zum Zeitpunkt der Verifizierung nicht öffentlich veröffentlicht worden.
Das bedeutet, dass externe Forscher die exakte Softwareumgebung, die für die veröffentlichten Code-Agent-Ergebnisse verwendet wurde, möglicherweise noch nicht reproduzieren können.
Zwei Tests sind ebenfalls intern:
Interne Benchmarks können für die Produktentwicklung nützlich sein, aber unabhängige Teams können ihre versteckten Aufgaben oder Kontaminationskontrollen nicht einsehen.
Die korrekte Interpretation ist:
DeepSeek berichtet eine große Verbesserung unter seinem gewählten Agenten-Stack und Evaluierungs-Setup. Die öffentliche Reproduzierbarkeit wird sich verbessern, wenn der Harness, Prompts, Logs und die vollständige Evaluierungskonfiguration verfügbar werden.
Ein Coding-Benchmark misst oft ein vollständiges System:
Modell
+
Systemprompt
+
Repository-Tools
+
Terminal

Ausführung
+
Kontextverwaltung
+
Wiederholungsrichtlinie
+
Test-Feedback
+
Patch-Übermittlungslogik

Dasselbe Modell kann unterschiedlich abschneiden, wenn sich eine Komponente ändert.

Ein besseres Testsystem könnte:

- Relevantere Dateien auswählen.
- Nützliche Terminalausgaben erhalten.
- Kontextüberlauf verhindern.
- Fehlgeschlagene Befehle intelligent wiederholen.
- Unproduktive Schleifen stoppen.
- Patches zuverlässiger anwenden.
- Dem Modell klarere Testergebnisse liefern.

Das macht das Modell nicht irrelevant.

Es bedeutet, dass das Benchmark-Ergebnis zur Kombination aus Modell und Testsystem gehört.

Die starken 0731-Zahlen deuten darauf hin, dass DeepSeek sowohl das Agentenverhalten des Modells als auch den umgebenden Bewertungsprozess verbessert hat.

## Artificial Analysis bewertet es mit 50

Artificial Analysis berichtet einen Intelligence-Index-Score von etwa **50** für DeepSeek V4 Flash 0731, etwa zehn Punkte über der vorherigen Flash-Version.

Das unabhängige Modellanalyse-Unternehmen beschreibt V4 Flash außerdem als außergewöhnlich günstig im Vergleich zu anderen bekannten Spitzensystemen.

Reuters fasste die Ergebnisse von Artificial Analysis zusammen und berichtete über durchschnittliche Benchmark-Testkosten von etwa drei US-Cent gemäß deren Methodik.

Dieser Vergleich unterstützt das Wertargument.

Es bedeutet nicht, dass jede Produktionsaufgabe drei Cent kostet.

Artificial Analysis berichtet außerdem schwächere Ergebnisse bei einigen Wissenszuverlässigkeitsmaßen.

Der Artikel zu V4 Flash 0731 merkt an:

- Die Allwissenheitsgenauigkeit blieb bei etwa 37 %.
- Die Halluzinationsrate sank, blieb aber mit etwa 84 % unter dieser Bewertung weiterhin hoch.

Diese Zahlen sind eine nützliche Erinnerung.

Ein Modell kann:

- Bei Coding-Agenten sehr stark sein.
- Extrem günstig sein.
- Bei einem zusammengesetzten Index wettbewerbsfähig sein.
- Bei einigen offenen Faktenfragen dennoch unzuverlässig sein.

„Bester Wert“ ist nicht dasselbe wie „am besten für jede Aufgabe“.

## Offizielle API-Preise

Der direkte DeepSeek-API-Preis ist:

| Abrechnungskategorie | Preis pro 1 Mio. Tokens |
|-|-|
| Cache-Treffer-Eingabe | \$0,0028 |
| Cache-Fehlschlag-Eingabe | \$0,14 |
| Ausgabe | \$0,28 |

Die Preislücke zwischen Cache-Treffer und Cache-Fehlschlag ist enorm:

```Plaintext
\$0,14 ÷ \$0,0028 = 50
Zwischengespeicherte Eingabe ist fünfzigmal günstiger als nicht zwischengespeicherte Eingabe.
Bei langlebigen Agenten wird die Prompt-Struktur zur Kostenarchitektur.
Angenommen, eine Anfrage verwendet:
100.000 nicht zwischengespeicherte Eingabe-Tokens
20.000 Ausgabe-Tokens
Die direkten Modellkosten betragen:
Eingabe:
100.000 / 1.000.000 × \$0,14
= \$0,014

Ausgabe:
20.000 / 1.000.000 × \$0,28
= \$0,0056

Gesamt:
\$0,0196
Das ist weniger als zwei US-Cent.
Nehmen wir nun an, dass dasselbe 100.000-Token-Präfix zwischengespeichert ist:
Zwischengespeicherte Eingabe:
100.000 / 1.000.000 × \$0,0028
= \$0,00028

Ausgabe:
20.000 / 1.000.000 × \$0,28
= \$0,0056

Gesamt:
\$0,00588
Die Ausgabe dominiert nun die Rechnung.
Diese Beispiele erklären, warum kostengünstige Coding-Prototypen plausibel sind.
Sie enthalten nicht:
Agentisches Coding ist selten eine einzelne Anfrage.
Ein typischer Arbeitsablauf kann Folgendes umfassen:
Fehler.
7. Erneut bearbeiten.
8. Tests erneut ausführen.
9. Den Diff überprüfen.
10. Die endgültige Antwort erstellen.
Jeder Schritt kann einen weiteren Modellaufruf erzeugen.
Eine scheinbar kleine Aufgabe kann teuer werden, wenn:
V4 Flash reduziert die Kosten dieser Fehler.
Es beseitigt sie nicht.
DeepSeek verwendet plattenbasiertes Kontext-Caching.
Wenn dasselbe Präfix wiederverwendet wird, können die passenden Eingabe-Tokens den niedrigeren Cache-Trefferpreis erhalten.
Gute Kandidaten für ein stabiles Präfix sind:
Ein vereinfachtes Prompt-Design ist:
Stabiles wiederverwendbares Präfix
+
neue Benutzeranfrage
+
letztes Werkzeugergebnis
Ein weniger cache-freundliches Design ist:
Neu angeordnete Anweisungen
+
umgeschriebene Repository-Zusammenfassung
+
sich ändernde Zeitstempel
+
zufällige Anfrage-Metadaten
+
neue Benutzeranfrage
Kleine Präfixänderungen können die Cache-Wiederverwendung reduzieren.
Entwickler sollten die Token-Nutzungsfelder prüfen, anstatt anzunehmen, dass ein langer Prompt gecacht wurde.
DeepSeek bietet auch user_id-Isolierung für Datenschutz und Planung. Cache-Wiederverwendung und Benutzerisolierung sollten zusammen entworfen werden, damit der Kontext eines Kunden nicht versehentlich mit dem eines anderen vermischt wird.
Die offizielle Basis-URL bleibt:
https://api.deepseek.com
Die Modell-ID ist:
deepseek-v4-flash
DeepSeek sagt, dass die stabile API-ID automatisch die neueste offizielle Flash-Version bedient.
Das ist praktisch, aber Produktionsteams sollten den zurückgegebenen Modell-Fingerabdruck aufzeichnen und Änderungen testen, da das Verhalten hinter einer stabilen ID aktualisiert werden kann.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this function and propose a safe refactor.",
        }
    ],
)

print(response.choices[0].message.content)
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-flash",
    "messages": [
      {
        "role": "user",
        "content": "Write a small Python CLI that validates JSON files."
      }
    ]
  }'
Entwickler sollten die Live-API-Referenz prüfen, um die genauen Reasoning-Effort- und Thinking-Mode-Felder zu erfahren, die von ihrem Endpunkt und der SDK-Version unterstützt werden.
Die Dokumentation zum Denkmodus von DeepSeek besagt, dass bei einer Runde mit Werkzeugaufrufen das reasoning_content aus der Assistenten-Nachricht in nachfolgenden Anfragen zurückgegeben werden muss.
Ein mehrrundiger Agent sollte Folgendes bewahren:
contentreasoning_content
tool_callsDas Verwerfen des Reasoning-Zustands kann die Kontinuität verringern oder Probleme bei der Anfragevalidierung verursachen.
Dies ist besonders relevant bei der Integration über einen OpenAI-kompatiblen Client, der normalerweise anbieterspezifische Reasoning-Felder ignoriert.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
DeepSeek bietet mehr als eine Schnittstelle an.
Verwenden Sie die standardmäßige DeepSeek-Basis-URL und die Modell-ID:
deepseek-v4-flash
DeepSeek dokumentiert auch eine Schnittstelle im Anthropic-Format.
Dies kann Software, die um Claude-artige Nachrichten herum aufgebaut ist, dabei helfen, sich mit weniger Anwendungsänderungen mit DeepSeek zu verbinden.
Kompatibilität garantiert kein identisches Verhalten.
Anbieterspezifische Felder, Reasoning-Verlauf, Tool-Schemas, Sicherheitsverhalten und Fehlerbehandlung müssen weiterhin getestet werden.
DeepSeek gibt an, dass das 0731-Release das Responses-API-Format nativ unterstützt und für die Verwendung im Codex-Stil angepasst wurde.
Dies ist wichtig für Coding-Agent-Produkte, die zunehmend von zustandsbehafteten Response-Objekten, Tool-Aufrufen und strukturierten Agentenschleifen abhängen.
DeepSeek hat die V4 Flash 0731-Gewichte auf Hugging Face unter der MIT-Lizenz veröffentlicht.
Dies ermöglicht Entwicklern, das Modell unter Beachtung der Lizenzbedingungen zu untersuchen, zu modifizieren, bereitzustellen und weiterzuverbreiten.
Die Veröffentlichung offener Gewichte bietet mehr Kontrolle als ein reines API-Modell.
Teams können:
Die praktische Hürde ist die Hardware.
„Offene Gewichte“ bedeutet nicht „läuft auf einem normalen Laptop“.
Die offizielle 0731-Modellkarte enthält ein vLLM-Beispiel für einen einzelnen 4×GB300-Knoten:
vllm serve deepseek-ai/DeepSeek-V4-Flash-0731 \
  --trust-remote-code \
  --kv-cache-dtype fp8 \
  --block-size 256 \
  --data-parallel-size 4 \
  --enable-expert-parallel \
  --moe-backend deep_gemm_mega_moe \
  --attention-config '{"use_fp4_indexer_cache": true}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Dieses Beispiel veranschaulicht die Infrastrukturklasse, die für vollwertiges Serving erwartet wird.
Es sollte nicht als die einzige unterstützte Konfiguration interpretiert werden.
Das vLLM-Rezept könnte im Laufe der Zeit Unterstützung für andere GPU-Topologien hinzufügen.
Das offizielle SGLang-Beispiel lautet:
sglang serve \
  --trust-remote-code \
  --model-path deepseek-ai/DeepSeek-V4-Flash-0731 \
  --tp 4 \
  --moe-runner-backend flashinfer_mxfp4 \
  --speculative-algorithm DSPARK \
  --mem-fraction-static 0.90 \
  --chunked-prefill-size 4096 \
  --swa-full-tokens-ratio 0.1
Die Ziel- und Entwurfsgewichte stammen aus demselben Checkpoint, daher besagt die Dokumentation, dass kein separater spekulativer Entwurfsmodell-Pfad festgelegt werden sollte.
Inferenz-Engines entwickeln sich schnell weiter.
Verwenden Sie die aktuelle Modellkarte und das Serving-Engine-Rezept, anstatt einen alten Startbefehl aus dem Preview-Release zu kopieren.
Auch wenn nur etwa
Für ein Token sind 13B Parameter aktiv, die vollständigen Modellgewichte müssen während des gesamten Serving-Betriebs verfügbar bleiben.
Die Bereitstellungsplanung muss Folgendes berücksichtigen:
Kleinere Quantisierungen können Experimente auf unterschiedlicher Hardware ermöglichen, können jedoch Qualität, Geschwindigkeit oder unterstützte Kontextlänge verändern.
Für die meisten einzelnen Entwickler ist die direkte API oder ein gehosteter Anbieter einfacher und günstiger als das Selbst-Hosten.
Es gibt drei gängige Möglichkeiten, V4 Flash zu nutzen.
| Weg | Hauptvorteil | Hauptnachteil |
|---|---|---|
| DeepSeek API | Offizielle Preise und aktuelles offizielles Modell | Daten verlassen Ihre Umgebung; stabile ID kann aktualisiert werden |
| Drittanbieter-Plattform | Kostenlose Kontingente, integrierte Agenten, einfachere Abrechnung | Aktionen und Routing können sich ändern |
| Selbst gehostete Gewichte | Maximale Kontrolle und Datenschutz | Erhebliche Hardware- und Engineering-Anforderungen |
Der günstigste Weg hängt von der Arbeitslast ab.
Ein kostenloses Cline- oder OpenCode-Kontingent ist möglicherweise am besten für Experimente geeignet.
Die direkte API ist möglicherweise am besten für vorhersehbare Nutzung in kleinem Umfang geeignet.
Selbst-Hosten wird erst bei ausreichend hohem, kontinuierlichem Volumen oder wenn Datenschutzanforderungen dominieren, attraktiv.
Der Quellartikel vergleicht kostengünstige KI mit der Massenproduktion von Automobilen.
Die Analogie ist unvollkommen, aber nützlich.
Wenn eine Technologie dramatisch billiger wird, kauft der Markt nicht einfach dieselbe Menge zu einem niedrigeren Preis.
Neue Anwendungen werden möglich.
Kostengünstige Agentenmodelle können Experimente unterstützen, die zuvor vor dem Testen abgelehnt worden wären.
Beispiele hierfür sind:
Der Wert liegt nicht darin, dass das Modell die gesamte Softwareentwicklung ersetzt.
Es senkt die Kosten der Frage:
Lohnt es sich, diese Idee weiterzuverfolgen?
Kostengünstige Generierung kann eine überzeugende erste Demo erzeugen.
Ein Produktionsprodukt benötigt weiterhin:
Eine Modellrechnung von sieben Cent bedeutet kein Geschäft für sieben Cent.
Es bedeutet, dass das erste rechenintensive Experiment möglicherweise günstig genug ist, um es zu versuchen.
Das verändert, wer teilnehmen kann und wie viele Ideen getestet werden können.
Der Quellartikel enthält einen leichtgewichtigen Dokument-Arbeitsbereich als eines der Beispiele dafür, was Entwickler mit kostengünstigen Codierungsagenten bauten.
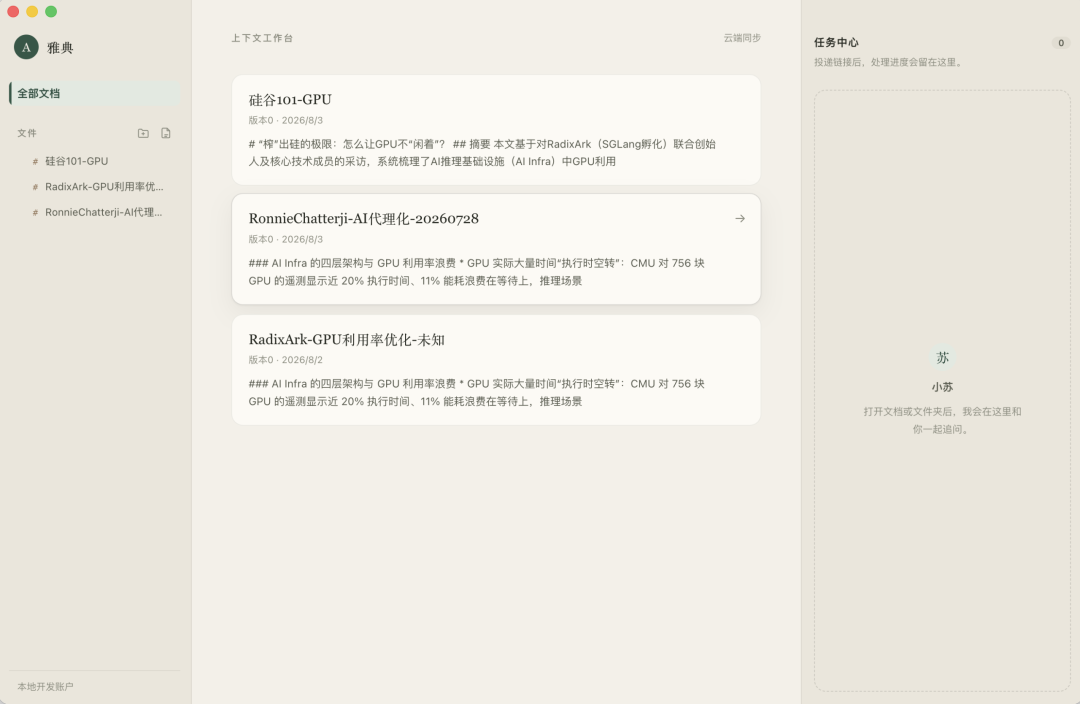
Ein Screenshot kann nicht belegen, wie viel von der Anwendung durch das Modell erzeugt wurde, wie viel manuelle Bearbeitung erforderlich war oder ob das Produkt sicher und wartbar ist.
Er zeigt jedoch die Art von Projekt, deren Prototyping durch kostengünstige Codierungsmodelle erleichtert wird.
V4 Flash 0731 ist besonders attraktiv, wenn:
Es kann weniger geeignet sein, wenn:
Ein Modell-Router kann Flash mit einem stärkeren oder spezialisierteren System kombinieren.
Zum Beispiel:
Routinemäßige Repository-Änderungen
→ V4 Flash

Hochriskante Architektur- oder Sicherheitsentscheidungen
→ stärkeres Modell + menschliche Überprüfung
Wenn Modellaufrufe teuer sind, versuchen Entwickler, jede Anfrage zu minimieren.
Wenn Aufrufe günstig werden, kann sich ein Agent leisten:
Dies kann die Zuverlässigkeit erhöhen.
Es kann auch Token verschwenden.
Das richtige Ziel ist nicht der minimale Token-Verbrauch.
Es ist:
Niedrigste Gesamtkosten, die die erforderliche Qualität erreichen
DeepSeek beschreibt die offizielle Flash-API als öffentliche Beta.
Preisgestaltung, Verhalten, Limits und Modellversionen können sich ändern.
Produktionsteams sollten Regressionstests aufrechterhalten.
Die stärksten Code-Agent-Ergebnisse verwenden eine nicht veröffentlichte Harness-Konfiguration.
Eine exakte unabhängige Reproduktion ist derzeit nicht ohne Weiteres möglich.
Ausgabe, Wiederholungen, Tools und nicht zwischengespeicherter Kontext können die endgültigen Kosten dominieren.
Ein Fenster mit 1 Million Token ist eine Kapazitätsgrenze, keine Empfehlung, bei jeder Anfrage eine Million Token zu senden.
Große Prefill-Workloads erhöhen Latenz und Kosten.
Unabhängige Bewertungen zeigen, dass Wert- und Codierungsstärke mit einer hohen Halluzinationsrate bei faktischen Tests koexistieren können.
Kritische Fakten sollten gegen Quellen geprüft werden.
Kostengünstige Modelle können mehr Code generieren, als ein Team sicher prüfen kann.
Automatisierte Tests, statische Analyse, Abhängigkeitsscans und menschliche Überprüfung bleiben notwendig.
Drittanbieter-kostenlose Modelle und Rabatte können verschwinden.
Baue kein dauerhaftes Geschäftsmodell auf einer siebentägigen oder zeitlich begrenzten Subvention auf.
Die Modell-ID deepseek-v4-flash verweist auf die aktuelle Version.
Ein Upgrade hinter dieser ID kann Ausgaben verändern, ohne dass sich Code in deiner Anwendung ändert.
Halte Systemanweisungen und Tool-Definitionen konsistent, um die Cache-Wiederverwendung zu verbessern.
Verlasse dich nicht nur auf die gesamten Eingabetokens.
Setze ein realistisches Ausgabebudget für die Aufgabe.
Reserviere max für Aufgaben, die von längerer Überlegung profitieren.
Stoppe Schleifen, die keine Fortschritte machen.
Nutze Linter, Tests, Schema-Validatoren und deterministische Prüfungen.
Eskaliere nur, wenn die Aufgabe einen Test nicht besteht oder eine Risikoschwelle überschreitet.
Berücksichtige fehlgeschlagene Versuche und menschliche Überprüfung.
Der Quellartikel endet mit einem möglichen nächsten Schritt im DeepSeek-Entwicklerökosystem.
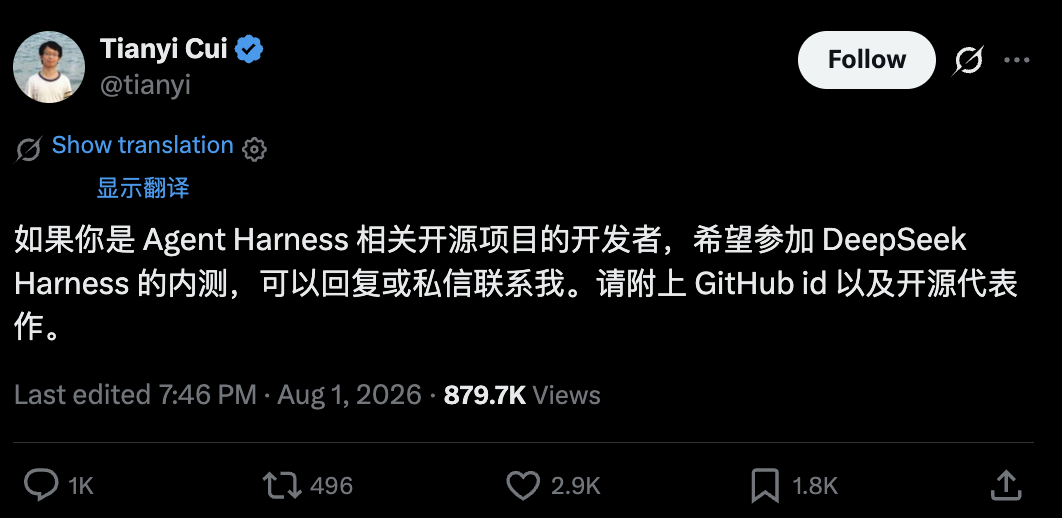
Tianyi Cui, in der Quelle als Verantwortlicher für DeepSeek Harness identifiziert, veröffentlichte eine Rekrutierungsmeldung für Entwickler von Open-Source-Agent-Harness-Projekten.
Die Meldung lud interessierte Entwickler ein, ein GitHub-Konto und repräsentative Open-Source-Arbeiten zu teilen, um an internen Tests teilzunehmen.
DeepSeeks eigenes Änderungsprotokoll vom 31. Juli sagt ebenfalls, dass der minimale Modus von DeepSeek Harness für die Benchmark-Auswertung „bald veröffentlicht“ werde.
Zum Zeitpunkt der Überprüfung konnte ich Folgendes nicht finden:
Die Belege stützen diese engere Schlussfolgerung:
DeepSeek testet einen Agent-Harness und beabsichtigt, zumindest Teile des Frameworks zu veröffentlichen, aber der endgültige Produktname, der öffentliche Umfang und der Startzeitpunkt bleiben unbestätigt.
Das Modell, die API und die offenen Gewichte sind jetzt verfügbar.
Der Harness ist noch ein zukünftiges Ökosystem-Komponente.
Ein First-Party-Harness könnte DeepSeek helfen, den vollständigen Coding-Agent-Stack zu kontrollieren.
Er könnte Folgendes bieten:
DeepSeek dokumentiert bereits Integrationen mit externen Harnesses und Coding-Agenten.
Ein First-Party-Tool könnte benchmarkspezifische Optimierungen in ein Produkt verwandeln, das normale Entwickler nutzen können.
Es könnte auch aufzeigen, wie viel von V4 Flash 0731s Benchmark-Sprung vom Checkpoint und wie viel von der Agent-Laufzeitumgebung stammt.
Mehrere Entwicklungen werden darüber entscheiden, ob der V4-Flash-Moment zu einem dauerhaften Ökosystemwandel wird.
DeepSeek gibt an, dass die offizielle V4-Pro-Veröffentlichung dem Flash-Update folgen wird.
Die Leistungs- und Preislücke zwischen Pro und Flash wird Routing-Entscheidungen beeinflussen.
Eine öffentliche Veröffentlichung würde die Reproduzierbarkeit von Benchmarks verbessern und Entwicklern ein modellnatives Agent-Framework bieten.
Der direkte Preis ist bereits niedrig, aber Werbeaktionen von Drittanbietern könnten nicht bestehen bleiben.
Günstige Inferenz zieht sehr hohen Datenverkehr an.
Latenz, Ratenbegrenzungen und Zuverlässigkeit werden wichtig, wenn die Nutzung skaliert.
vLLM, SGLang, Hardware-Anbieter und Quantisierungsprojekte werden bestimmen, wie zugänglich Self-Hosting wird.
Weitere öffentliche Bewertungen sollten testen:
DeepSeek V4 Flash 0731 ist die offizielle Veröffentlichung von V4 Flash vom 31. Juli, die derzeit über die deepseek-v4-flash-API in der öffentlichen Beta bereitgestellt wird. DeepSeek gibt an, dass es die Basisarchitektur und -größe des Preview-Modells beibehält, während die Agent-Fähigkeiten durch neues Post-Training erheblich verbessert werden.
Die offizielle DeepSeek-API listet 0,14 US-Dollar pro Million Cache-Miss-Input-Tokens, 0,0028 US-Dollar pro Million Cache-Hit-Input-Tokens und 0,28 US-Dollar pro Million Output-Tokens auf. Plattformen von Drittanbietern können andere Preise, kostenlose Kontingente oder temporäre Rabatte anbieten.
Der Quellenartikel zitiert ein Community-Beispiel mit diesen gemeldeten Modellkosten. Das Beispiel wird nicht von vollständigen Prompts, Token-Protokollen, Cache-Daten, Wiederholungen, Tool-Kosten oder Aufzeichnungen menschlicher Arbeit begleitet, daher sollte es eher als Anekdote denn als garantierte Kostenkalkulation betrachtet werden.
DeepSeek meldet 82,7 auf Terminal Bench 2.1, 76,7 auf CyberGym, 54,4 auf DeepSWE, 70,3 auf Toolathlon-Verified und 54,2 auf NL2Repo. Öffentliche Code-Agent-Bewertungen verwendeten den unveröffentlichten Minimalmodus von DeepSeek Harness mit maximalem Denkaufwand.
Die Modellgewichte und das Repository werden unter der MIT-Lizenz veröffentlicht, daher sind „Open-Weight“ und weitgehend erlaubende Nutzung zutreffende Beschreibungen. Das Ausführen des vollständigen Checkpoints erfordert weiterhin erhebliche Multi-GPU-Infrastruktur.
Ja, DeepSeek veröffentlicht Gewichte und Serving-Anleitungen für vLLM und SGLang. Die offiziellen Beispiele im vollen Umfang verwenden fortschrittliche Multi-GPU-Hardware, daher ist ein normales Laptop nicht die Zielumgebung für das vollständige Modell.
Die offizielle API und die Modellkarte geben ein Kontextfenster von 1 Million Tokens an. Die API listet auch eine
maximale Ausgabelänge von 384.000 Tokens, aber die Nutzung des maximalen Kontexts oder der maximalen Ausgabe kann Latenz und Ressourcenverbrauch erheblich erhöhen.
DeepSeek hat öffentlich einen Harness-Minimalmodus erwähnt und Open-Source-Harness-Entwickler für interne Tests angeworben. Ein vollständiges öffentliches Repository, eine endgültige Produktspezifikation und ein bestätigtes Veröffentlichungsdatum wurden bei der Überprüfung nicht gefunden.
reasoning_content über Tool-Aufrufe hinweg.DeepSeek V4 Flash 0731 behält die Basis des Preview-Modells
Architektur und Größe, nutzt jedoch neues Post-Training, um einen großen Sprung in der Leistung von Coding-Agenten zu erzielen. DeepSeek meldet 82,7 auf Terminal Bench 2.1, 76,7 auf CyberGym und 54,4 auf DeepSWE, obwohl die stärksten öffentlichen Code-Agenten-Ergebnisse von einer nicht veröffentlichten DeepSeek-Harness-Konfiguration abhängen.
Der offizielle API-Preis ist ungewöhnlich niedrig: 0,14 US-Dollar pro Million nicht zwischengespeicherter Eingabe-Tokens, 0,0028 US-Dollar pro Million zwischengespeicherter Eingabe-Tokens und 0,28 US-Dollar pro Million Ausgabe-Tokens. Kostenlose Kontingente und Rabatte von Drittanbietern können den Zugang noch günstiger machen, aber diese Aktionen sind vorübergehend und sollten nicht mit dem dauerhaften Listenpreis verwechselt werden.
Die Open-Weight-MIT-Veröffentlichung, der Kontext von 1 Million Tokens, Responses- und Anthropic-kompatible APIs sowie die Unterstützung in vLLM und SGLang machen das Modell über gehostete und selbstverwaltete Wege zugänglich. Eine vollständige lokale Bereitstellung bleibt ein ernsthaftes Multi-GPU-Infrastrukturprojekt.
Die viralen Sieben-Cent- und Fünfzig-Cent-Prototypen sind plausible Beispiele dafür, wie niedrig die marginale Modellrechnung werden kann, aber sie sind keine vollständigen Produktkostenstudien. Agentenschleifen, Ausgabelänge, Cache-Fehler, Tools, Tests und menschliche Arbeit spielen weiterhin eine Rolle.
DeepSeek V4 Flash 0731 ist wichtig, nicht weil jede Anwendung jetzt nur noch ein paar Cent kostet, sondern weil leistungsfähiges agentisches Codieren billig genug geworden ist, dass weitaus mehr Entwickler in sinnvollem Umfang experimentieren können.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



