DeepSeek V4 Flash 0731 geht in die öffentliche Beta-Phase und bringt ein bekanntes Versprechen mit: stärkere Code- und Agentenfähigkeiten zu...

DeepSeek V4 Flash 0731 ist in die öffentliche Beta-Phase eingetreten – mit einem vertrauten Versprechen: stärkere Coding- und Agent-Fähigkeiten zu extrem niedrigen API-Preisen.
Entwickler setzten diese Behauptung schnell in praktische Experimente um.
Einer der am weitesten verbreiteten Fälle stammt von einem Hermes-Agent-Lauf, bei dem DeepSeek V4 Flash allein mit einem einzigen Anfangsprompt ein spielbares Ego-3D-Shooter-Spiel erzeugte. Berichten zufolge dauerte das Projekt 32 Minuten, und die Modellnutzungskosten betrugen nur 0,07 US-Dollar.
Das Endergebnis umfasste:
DeepSeek V4 unterstützt ein Kontextfenster von 1 Million Token.
Traditionelle Aufmerksamkeitssysteme werden in dieser Größenordnung extrem teuer, da jedes neue Token möglicherweise einen großen Teil des vorherigen Kontexts überprüfen und große KV-Caches verwalten muss.
Der technische Bericht von DeepSeek beschreibt ein hybrides Aufmerksamkeitsdesign, das kombiniert:
Die Gesamtstrategie besteht darin, bei jedem Schritt eine vollständige und teure Aufmerksamkeitsberechnung über die gesamte Historie zu vermeiden.
Das System komprimiert und filtert den Kontext, sodass das Modell die Berechnung auf die nützlichsten Informationen konzentrieren kann.
DeepSeek berichtet, dass V4 Pro in einer Umgebung mit 1 Million Token Kontext benötigt:
27 % der FLOPs von DeepSeek V3.2 pro Token-Inferenz.
Diese genauen Prozentsätze stammen aus dem technischen Paper für V4 Pro und sind keine separaten Audit-Daten für Flash.
V4 Flash verwendet dieselbe Architekturfamilie und profitiert daher von denselben Designprinzipien für lange Kontexte.
Die praktischen Auswirkungen umfassen reduzierte:
sowie Speicherverkehr
Das veröffentlichte V4 Flash Modell verwendet gemischte Low-Precision-Gewichte.
DeepSeek listet:
FP4 + FP8 Mischpräzision
Die geringere Präzision reduziert die Datenmenge, die während der Inferenz gespeichert, aus dem Speicher geladen, zwischen Geräten übertragen und verarbeitet werden muss.
Dies ist wichtig, da moderne LLM-Inferenz oft durch Speicherbandbreite begrenzt ist, nicht nur durch rohe Rechenleistung.
Wenn Hardware und Kernel effizient für dieses Format ausgelegt sind, können kleinere Datenrepräsentationen den Durchsatz steigern.
Niedrige Präzision ist nicht automatisch kostenlos.
Schlechte Quantisierung verschlechtert die Modellqualität.
DeepSeek hat das Modell von Grund auf für das gewählte Präzisionsschema entworfen und trainiert, anstatt sich auf nachträgliche Community-Quantisierung zu verlassen.
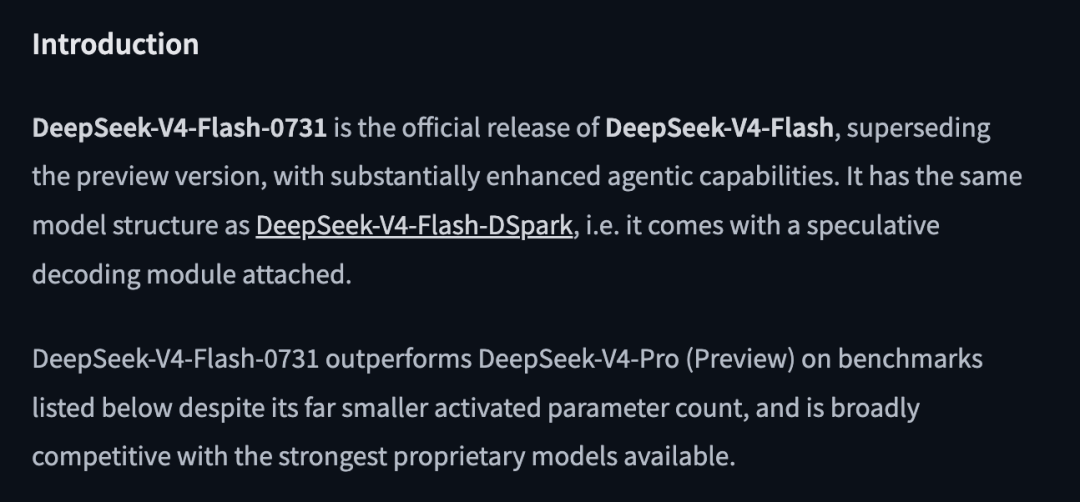
DeepSeek gibt an, dass die offizielle 0731-Version dieselbe Modellarchitektur und -größe wie das V4 Flash Preview beibehält.
Das Unternehmen hat für dieses Update kein vollständiges Pretraining erneut durchgeführt.
Stattdessen wurde der Post-Training-Prozess überarbeitet.
Der Quellartikel fasst die Änderungen wie folgt zusammen:
Der technische Bericht von DeepSeek beschreibt den breiteren V4 Post-Training-Prozess als:
Das 0731-Update konzentriert sich darauf, diese Fähigkeiten in realen Agenten-Workflows zu verbessern.
DeepSeek-V4-Flash-0731 wird mit einem DSpark-Spekulations-Dekodierungsmodul ausgeliefert.
Spekulative Dekodierung verwendet einen kleineren oder günstigeren Entwurfspfad, um mehrere zukünftige Token vorzuschlagen.
Das Hauptmodell validiert diese Vorschläge in einem Stapel.
Der vereinfachte Ablauf ist:
Entwurfsmodul schlägt Token vor
→ Hauptmodell validiert gleichzeitig
→ Akzeptierte Token werden ausgegeben
→ Abgelehnte Pfade werden korrigiert
Wenn die Entwurfsvorhersagen genau sind, kann das System mehrere akzeptierte Token mit deutlich weniger teuren, sequenziellen Hauptmodell-Inferenzen generieren.
DeepSeek bietet DSpark-Unterstützung für vLLM und SGLang an.
Für vLLM verwendet die offizielle Modellkarte:
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Für SGLang lautet die entsprechende Option:
--speculative-algorithm DSPARK
DeepSeek gibt an, dass die Gewichte des Zielmodells und des Entwurfsmodells im selben Checkpoint gespeichert sind, sodass SGLang keinen separaten Entwurfsmodellpfad benötigt.
Spekulative Dekodierung verbessert hauptsächlich Servicegeschwindigkeit und Durchsatz.
Sie erklärt selbst nicht die verbesserte Denkfähigkeit des Modells.
Diese Verbesserungen stammen aus dem aktualisierten Post-Training-Prozess.
DeepSeek berichtet deutliche Verbesserungen bei mehreren agentenfokussierten Tests im Vergleich zum V4 Flash Preview.
| Benchmark | V4 Flash 0731 | V4 Flash Preview | V4 Pro Preview |
|---|---|---|---|
| Terminal Bench 2.1 | 82,7 | 61,8 | 72,1 |
| NL2Repo | 54,2 | 39,4 | 38,5 |
| CyberGym | 76,7 | 38,7 | 52,7 |
| DeepSWE | 54,4 | 7,3 |
12,8 |
| Toolathlon-Verified | 70,3 | 49,7 | 55,9 |
| Agents' Last Exam | 25,2 | 15,8 | 16,5 |
| AutomationBench Public | 25,1 | 10,8 | 12,8 |
| DSBench-FullStack | 68,7 | 37,0 | 41,8 |
| DSBench-Hard | 59,6 | 25,8 | 31,1 |
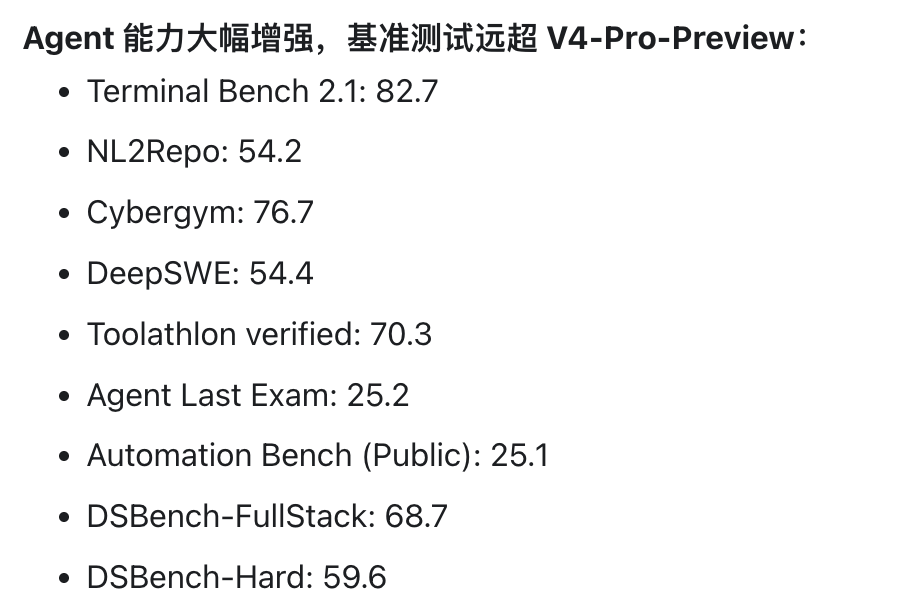
DeepSeek gibt an, dass die öffentlichen Code-Agenten-Benchmarks mit der folgenden Konfiguration ausgeführt wurden:
DeepSeek Harness Minimalmodus
reasoning_effort = max
top_p = 0,95
temperature = 1,0
Zum Zeitpunkt des offiziellen Updates war das Testframework noch nicht öffentlich verfügbar.
DSBench-FullStack und DSBench-Hard sind interne Benchmarks von DeepSeek.
Das bedeutet, dass ihre Ergebnisse als Referenznachweis für die Berichte des Unternehmens dienen können, aber nicht unabhängig überprüfbar sind wie vollständig öffentliche Benchmark-Suiten.
Terminal Bench bewertet die Fähigkeit von Agenten, Aufgaben in einer Terminalumgebung zu erledigen.
Das Modell muss möglicherweise Dateien untersuchen, Befehle ausführen, Abhängigkeiten installieren, Fehler debuggen, Code ändern und die Fertigstellung verifizieren.
Eine hohe Punktzahl spiegelt die kombinierte Leistung von Modell, Agentenframework, Tool-Strategie, Denkbudget und Laufzeitumgebung wider.
Toolathlon bewertet langfristige Aufgaben über mehrere Softwareanwendungen und Tools hinweg.
Der Benchmark umfasst Szenarien mit Kalender, Dateisystem, Notion, WooCommerce, Kubernetes und BigQuery.
Die Aufgaben erfordern mehrere Tool-Interaktionen und werden durch ausführungsbasierte Evaluatoren verifiziert.
Die von DeepSeek berichteten 70,3 Punkte stellen eine deutliche Verbesserung gegenüber dem Preview-Modell dar.
Dies sollte jedoch nicht als 70,3-prozentige Erfolgsgarantie für jede reale Geschäftsautomatisierung interpretiert werden.
Die Spielebeispiele in der Quelle zeigen einen wichtigen Unterschied zwischen Benchmark-Leistung und kreativem Coding.
V4 Flash schneidet in offiziellen Agenten-Evaluationen stark ab, aber ein Spielvergleich erforderte dennoch drei Iterationen.
Benchmarks können die Erfolgsrate bei klar definierten Aufgabensätzen und bekannten Bewertungsregeln messen.
Kreative Projekte können dagegen vage visuelle Anforderungen, Browserkompatibilitätsprobleme, Physik-Engine-Fehler, fehlende Assets, subjektive Qualitätsurteile enthalten – und es gibt keine einzelne Testsuite, die Erfolg definiert.
In solchen Szenarien sind kostengünstige Modelle besonders nützlich, da Workflows mehrere Iterationen verkraften können.
Ihr Wert liegt nicht unbedingt darin, beim ersten Versuch perfekt zu sein.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Es könnte sein:
Akzeptable Qualität
×
Viele erschwingliche Versuche
DeepSeek stellt das Modell auf folgende Weise bereit:
Die OpenAI-kompatible Base-URL lautet:
https://api.deepseek.com
Die Anthropic-kompatible Base-URL lautet:
https://api.deepseek.com/anthropic
DeepSeek gibt an, dass V4 Flash derzeit das einzige V4-API-Modell ist, das die Responses API unterstützt.
Die Unterstützung für V4 Pro wird separat geplant.
Die Kompatibilität mit der Responses API ermöglicht es dem Modell außerdem, über die dokumentierte Konfiguration von DeepSeek in Codex verwendet zu werden.
DeepSeek V4 Flash unterstützt sowohl den Denkmodus als auch den Nicht-Denkmodus.
Der Denkmodus ist der Standardmodus.
Für lokale Inferenz unterstützt die offizielle Modellkarte drei Stufen der Denkanstrengung:
low
high
max
DeepSeek empfiehlt:
temperature = 1.0
top_p = 0.95
für Agentenszenarien.
Für die Denkanstrengungsstufen high und max empfiehlt das Unternehmen, eine maximale Ausgabelänge von bis zu 384K Tokens zuzulassen.
Höhere Denkeinstellungen können die Leistung bei schwierigen Aufgaben verbessern, aber auch Latenz, Ausgabevolumen, API-Kosten und die Dauer von Agentenschleifen erhöhen.
Produktionssysteme sollten die niedrigste Anstrengungsstufe bewerten, die die Aufgabenanforderungen zuverlässig erfüllen kann.
DeepSeek hat die V4 Flash 0731-Gewichte unter der MIT-Lizenz auf Hugging Face veröffentlicht.
Dies macht das Modell im Vergleich zu vielen großen kommerziellen Veröffentlichungen ungewöhnlich freizügig lizenziert.
Entwickler können das offizielle Modell-Repository mit unterstützten Engines verwenden, darunter:
Das Modell ist relativ groß.
Das Kernmodell hat 284B Parameter, und im 0731-Checkpoint ist zusätzlich eine DSpark-Komponente enthalten.
Der Betrieb mit akzeptabler Geschwindigkeit erfordert erhebliche Speicher- und Hardwareressourcen.
Dass die Gewichte herunterladbar sind, bedeutet nicht, dass das vollständige Modell reibungslos auf einem normalen Consumer-Laptop läuft.
Community-Quantisierungen können den Speicherbedarf senken, aber Genauigkeit, Durchsatz, Kontextkapazität, DSpark-Verhalten und die Zuverlässigkeit von Tool-Aufrufen verändern.
Die Quellen kommen zu dem Schluss, dass V4 Flash nicht in jedem Vergleich das beste Ergebnis erzielt, aber beim Preis-Leistungs-Verhältnis kaum zu schlagen ist.
Dies ist eine vernünftige Zusammenfassung der Beispiele, mit einer wichtigen Einschränkung:
Das Preis-Leistungs-Verhältnis hängt vom gesamten Workflow ab.
V4 Flash ist besonders attraktiv, wenn:
In folgenden Fällen können teurere Frontier-Modelle insgesamt dennoch wirtschaftlicher sein:
Der richtige Vergleich ist nicht:
Preis pro Token
sondern:
Kosten pro verifiziert erfolgreicher Aufgabe
Testen Sie nicht nur sorgfältig ausgearbeitete Demos.
Verwenden Sie Aufgaben, die dem Produktions-Workload entsprechen, einschließlich schwieriger und komplexer Szenarien.
Halten Sie Prompts, Tools, Zeitlimits, Wiederholungsstrategien, Frameworks, Sandboxes, Testsuiten und Inference-Einstellungen zwischen verschiedenen Modellen konsistent.
Verfolgen Sie Cache-Miss-Eingaben, Cache-Hit-Eingaben, Ausgabe-Tokens, Tool-Aufrufe, Wiederholungsversuche, Laufzeit, menschliche Überprüfung und fehlgeschlagene Versuche.
Für Code: Tests ausführen und Wartbarkeit prüfen.
Für Spiele: Steuerung, Kollisionen, Leistung und Browser-Kompatibilität prüfen.
Wenn stabiler Kontext über mehrere Agentenschritte hinweg wiederholt wiederverwendet wird, werden Modelle mit extrem niedrigem Cache-Hit-Preis wertvoller.
Ein Modell, das nach drei billigen Versuchen erfolgreich ist, kann kosteneffizienter sein als ein Modell, das beim ersten Versuch zu einem hohen Preis erfolgreich ist.
Wenn Wiederholungen langsam oder riskant sind, kann das Gegenteil der Fall sein.
DeepSeek V4 Flash 0731 ist die offizielle Post-Training-Version des kleineren V4-Mixture-of-Experts-Modells von DeepSeek. Sie ersetzt die Vorschauversion, fügt ein DSpark-Spekulations-Dekodierungsmodul hinzu und konzentriert sich auf Codierungs- und Tool-nutzende Agentenaufgaben.
Die derzeit von DeepSeek veröffentlichten regulären Preise betragen: 0,0028 USD pro Million Cache-Hit-Eingabe-Tokens, 0,14 USD pro Million Cache-Miss-Eingabe-Tokens und 0,28 USD pro Million Ausgabe-Tokens. Das Unternehmen hat angekündigt, dass zukünftige Richtlinien die Preise während bestimmter Spitzenzeiten verdoppeln werden.
Ein Entwickler berichtete, dass ein einzelner Lauf von Hermes Agent in 32 Minuten ein spielbares Ego-Shooter-Spiel für 0,07 USD erzeugte. Dies ist eine Social-Media-Fallstudie und kein standardisierter Benchmark. Daher können die Kosten für andere Aufgaben höher oder niedriger sein.
Der V4-Technikbericht listet für das Kernmodell Flash insgesamt 284 Milliarden Parameter auf, mit 13 Milliarden aktiven Parametern pro Token. Das vollständige 0731-Versions-Repository kann etwa 304 Milliarden Parameter anzeigen, da es die begleitende DSpark-Spekulations-Dekodierungskomponente enthält.
Die niedrigen Kosten ergeben sich aus spärlicher Mixture-of-Experts-Aktivierung, komprimierter Langkontext-Aufmerksamkeit, FP4/FP8-Gemischtpräzision, Prompt-Caching, spekulativer Dekodierung und Hochparallelitäts-Serving. Pro Token wird nur ein kleiner Teil der Experten aktiviert.
Bei den aktuellen API-Preisen ist es viel günstiger und hat sich in mehreren Community-Demos als konkurrenzfähig erwiesen. Opus 5 und GPT-5.6 können bei bestimmten Aufgaben dennoch eine stärkere Erstversuch-Zuverlässigkeit oder Qualität bieten, und die viralen Vergleiche sind keine kontrollierten Benchmarks.
Ja. DeepSeek hat die Gewichte unter der MIT-Lizenz veröffentlicht und Anleitungen für die Verwendung mit vLLM und SGLang bereitgestellt. Das vollständige Modell ist extrem groß, daher erfordert eine reale lokale Bereitstellung erheblichen Beschleunigerspeicher oder aggressive Community-Quantisierung.
Ja. DeepSeek gibt an, dass die offizielle Flash-Version die Responses API nativ unterstützt und für die Verwendung mit Codex angepasst wurde. Die aktuelle V4 Pro API unterstützt die Responses API noch nicht.
0731](https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-0731): Offizielles Modell-Repository mit Gewichten, Benchmarks, Lizenz und Bereitstellungsanleitungen.
DeepSeek V4 Flash 0731 hat große Aufmerksamkeit erregt, da Entwickler berichten, dass sie mit nur wenigen Cent vollständige interaktive Demos erstellen können. Ein Ego-Shooter-Spiel soll nur 0,07 US-Dollar gekostet haben, während Vergleiche in sozialen Medien zeigen, dass die Aufgabenkosten um ein Vielfaches niedriger sind als bei Claude Opus 5 oder GPT-5.6.
Diese Beispiele sind keine kontrollierten Benchmarks, aber die offiziellen API-Preise unterstützen den Kernpunkt. V4 Flash kostet 0,14 US-Dollar pro Million nicht zwischengespeicherter Eingabe-Tokens, 0,28 US-Dollar pro Million Ausgabe-Tokens und lediglich 0,0028 US-Dollar bei Cache-Treffern – erstaunlich niedrig.
Die Wirtschaftlichkeit ergibt sich aus dem gesamten System: ein 284B-MoE-Kern mit 13B aktiven Parametern pro Token, komprimierte Long-Context-Aufmerksamkeit, FP4/FP8-Gewichte, ein Million-Token-Kontextfenster, effiziente Serving-Fähigkeiten sowie DSpark-spekulatives Decoding. Das 0731-Update behält die Preview-Architektur bei und verbessert das Agentenverhalten durch neues Post-Training.
Der stärkste offizielle Beleg ist die Verbesserung der Benchmarks: Terminal Bench 2.1 stieg von 61,8 auf 82,7, Toolathlon-Verified von 49,7 auf 70,3, während das Modell weiterhin die Flash-Preisklasse beibehält.
Der Vorteil von V4 Flash liegt nicht darin, dass es in jedem Vergleich gewinnt – sondern darin, dass die extrem niedrigen Grenzkosten es praktikabel machen,
agentische Experimente in einem Umfang wiederholt durchzuführen, der bei vielen Frontmodell-Preisen kaum realisierbar wäre.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



