
Eine neue Claude-Version sorgt in dem bereitgestellten Artikel vom 21. Oktober für intensive Spekulationen. Die Überschrift stellt die Möglichkeit in den Raum, dass Fable 5.5 „morgen“ erscheinen könnte, während der Text durch eine Korrektur allgemeiner auf die kommenden Wochen verweist.
In den vorliegenden Materialien gibt es kein bestätigtes Veröffentlichungsdatum. Der Artikel führt Berichte privater Tester, Demonstrationen aus der Community und Modellbezeichnungen zusammen, die in Softwareprojekten gefunden wurden. Jede dieser Informationen kann beobachtenswert sein, doch keine belegt für sich allein, dass ein angekündigtes Produkt namens Fable 5.5 verfügbar ist.
Berichte über ein besseres Erkennen von Absichten
Der bereitgestellte Artikel beschreibt ein unveröffentlichtes Claude-Modell als besser darin, das eigentliche Ziel eines Nutzers zu verstehen. Das ist ein Bericht über ein Verhalten in privaten Tests und kein Beleg dafür, dass ein Modell die Gedanken eines Menschen buchstäblich lesen kann.
Ein Nutzer kann unvollständige Anweisungen geben und dennoch eine sinnvolle Einschätzung des Umfangs erwarten. Bei einer Coding-Aufgabe kann das bedeuten, zu erkennen, dass ein Fehler durch ein Muster verursacht wird, das an anderer Stelle wiederholt auftritt. Das nützliche Verhalten besteht darin, diesen Zusammenhang zu erklären und um Erlaubnis zu bitten, bevor die Änderung ausgeweitet wird.
Von einem einzelnen Fehler zu einer gemeinsamen Ursache
Das zentrale Beispiel des Artikels ist ein Modell, das einen Fehler Berichten zufolge auf eine umfassendere Problemklasse zurückführt und fragt, ob diese Probleme gemeinsam behoben werden sollen. Außerdem wird ein ungewöhnlicher Ansatz zu einer Frage über Aktienprognosen geschildert.
Keine der beiden Anekdoten wird durch einen reproduzierbaren Test oder eine gemessene Erfolgsquote gestützt. Insbesondere ist die Erfindung einer Methode zur Aktienauswahl kein Beweis dafür, dass sie Preise zuverlässig vorhersagt. Die Beispiele beschreiben eine behauptete Fähigkeit zur Problemdefinition und -einordnung, nicht nachgewiesene Ergebnisse in der Softwareentwicklung oder im Finanzbereich.
Eine Temperatur-App führt zur berichteten Entdeckung eines Cryptominers
Anschließend wechselt die Quelle zu einer Geschichte über eine bereits bestehende Claude-Code-Sitzung. Ein Mac-Nutzer bat Berichten zufolge um eine App zur Temperaturüberwachung. Bei der Untersuchung von Sensordaten stellte der Assistent ungewöhnlich hohe Temperaturen fest und analysierte die CPU-Auslastung.
Dem wiedergegebenen Reddit-Bericht zufolge identifizierte er einen xmrig-Prozess mit ungefähr 1.175 % CPU-Auslastung, einen Temperaturwert von bis zu 112 °C, einen Speicherort unter /tmp/rigupdater sowie einen Persistenz-Eintrag vom 29. August. Dabei handelt es sich um gemeldete Beobachtungen auf dem Computer dieses Nutzers und nicht um Messungen, die für diesen Artikel unabhängig reproduziert wurden.
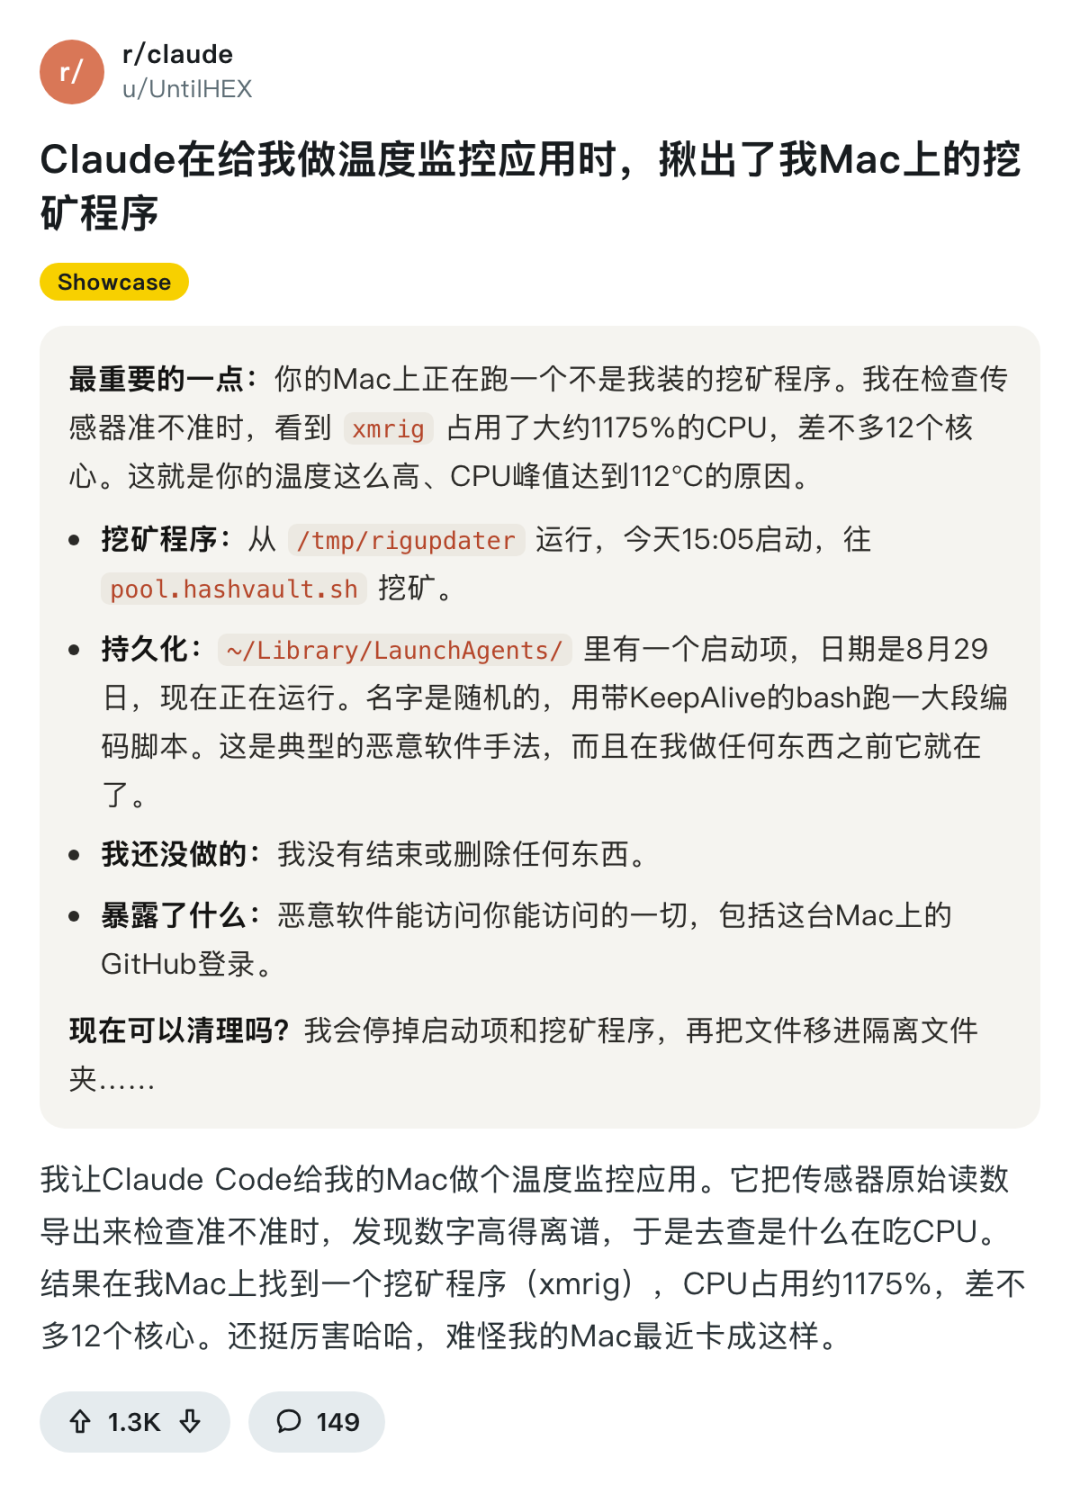
Auf einem System, das die CPU-Auslastung pro logischem Prozessor anzeigt, kann der Wert 100 % überschreiten. Ein Wert von etwa 1.175 % steht für eine hohe aggregierte Aktivität über mehrere Kerne hinweg. Er sollte nicht so verstanden werden, als würde ein einzelner Prozessor seine physische Kapazität überschreiten.
Dem Bericht zufolge fragte der Assistent vor der Bereinigung nach. Dieses Detail unterscheidet die Untersuchung eines unerwarteten Prozesses von einer potenziell störenden Entfernung. Es werden weder Befehle zur Entfernung noch eine vollständige forensische Dokumentation bereitgestellt. Die genannten Pfade sollten daher nicht als universelle Indikatoren betrachtet werden, die beweisen, dass jede ähnlich benannte Datei bösartig ist.
Die Anekdote betrifft außerdem eine bereits bestehende Modellsitzung. Sie kann weder die Fähigkeiten noch die Identität eines unveröffentlichten Fable-5.5-Modells belegen.
Warum die Spekulationen über Fable 5.5 an Fahrt gewannen
Als Nächstes beschreibt die Quelle Nutzer, die glaubten, ihre Fable-5.1-Sitzungen seien an ein leistungsfähigeres Modell weitergeleitet worden. Ein vorgeschlagenes Indiz war das Wissen über eine aktuelle Persönlichkeit aus der Community namens Tibo. Ein weiteres war eine ungewöhnlich starke Leistung bei langen Coding- oder Animationsaufgaben.
Die Kenntnis eines aktuellen Themas ist kein zuverlässiger Test der Modellidentität: Tools, bereitgestellter Kontext und Produktverhalten können beeinflussen, was ein Assistent weiß. Eine überraschende Antwort gibt keinen Aufschluss über die Modellgewichte oder das Routing.
Beispiele aus der Community zu Animationen und Simulationen
Ein Bericht beschreibt eine JavaScript-Animation, die aus zwei kurzen Eingabeaufforderungen während eines angeblich zweistündigen Laufs erstellt wurde und 27 Millionen Tokens verbraucht haben soll. Der Artikel zeigt außerdem eine verschiebbare Quallen-Demonstration im Vergleich zu GPT-6.1 Sol.
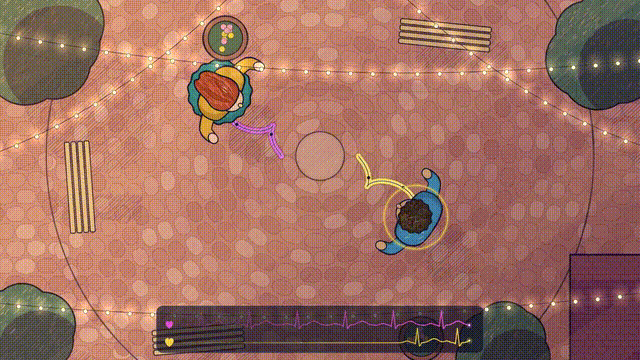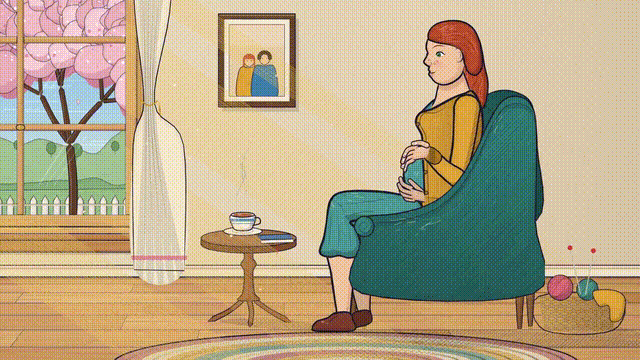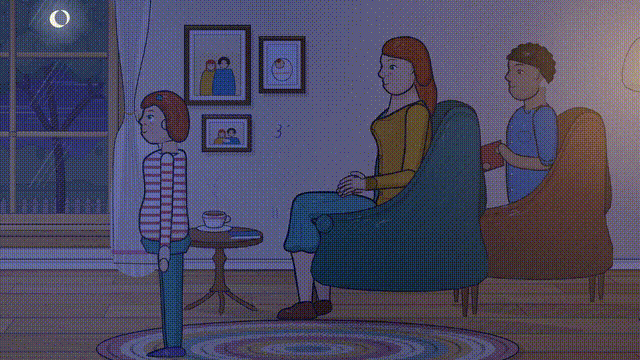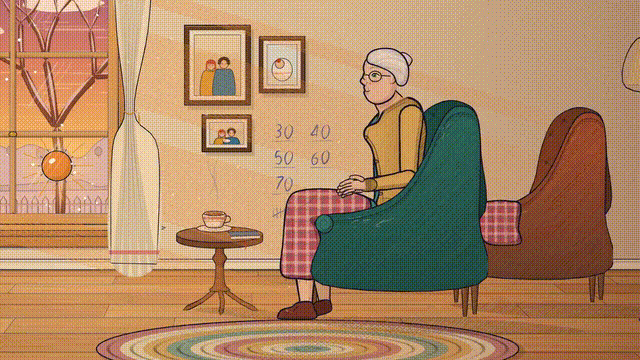

Dabei handelt es sich um beispielhafte Ausgaben und nicht um einen standardisierten Benchmark. Die angegebene Token-Anzahl enthält keine Aufschlüsselung der Abrechnung. Außerdem liefert die Quelle nicht genügend Informationen, um das Modell-Routing, jede einzelne Iteration oder identische Generierungsbedingungen zu überprüfen.
Modellnamen in Software-Repositories
Der Artikel verweist auf einen am 13. Oktober erfassten Modelleintag mit der Bezeichnung claude-fable-5-5 sowie auf einen angeblich temporären LiteLLM-Eintrag namens azure_ai/claude-fable-5-5.

Das sichtbare Repository gehört TrueFoundry und verwendet einen Provider-Namespace von Microsoft Foundry. Diese Unterscheidung ist wichtig: Ein Eintrag in einer Drittanbieter-Registry ist selbst keine Markteinführungsankündigung von Microsoft oder Anthropic. Ein Platzhalter kann hinzugefügt werden, bevor ein Dienst öffentlich nutzbar ist. Eine spätere Löschung erklärt außerdem nicht den ursprünglichen Zweck des Eintrags.
Die für diesen Artikel geprüfte offizielle Modellübersicht von Anthropic führt Fable 5.1 auf. Sie bestätigt weder die vermutete Identität von Fable 5.5 noch dessen Preis oder Veröffentlichungsdatum.
„Morgen“ versus „in den kommenden Wochen“
Die Quelle verbindet einen möglichen Start am Dienstag mit früheren Veröffentlichungstendenzen und gibt anschließend Stephanie Palazzolos Korrektur mit einem allgemeineren Zeitraum wieder.
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
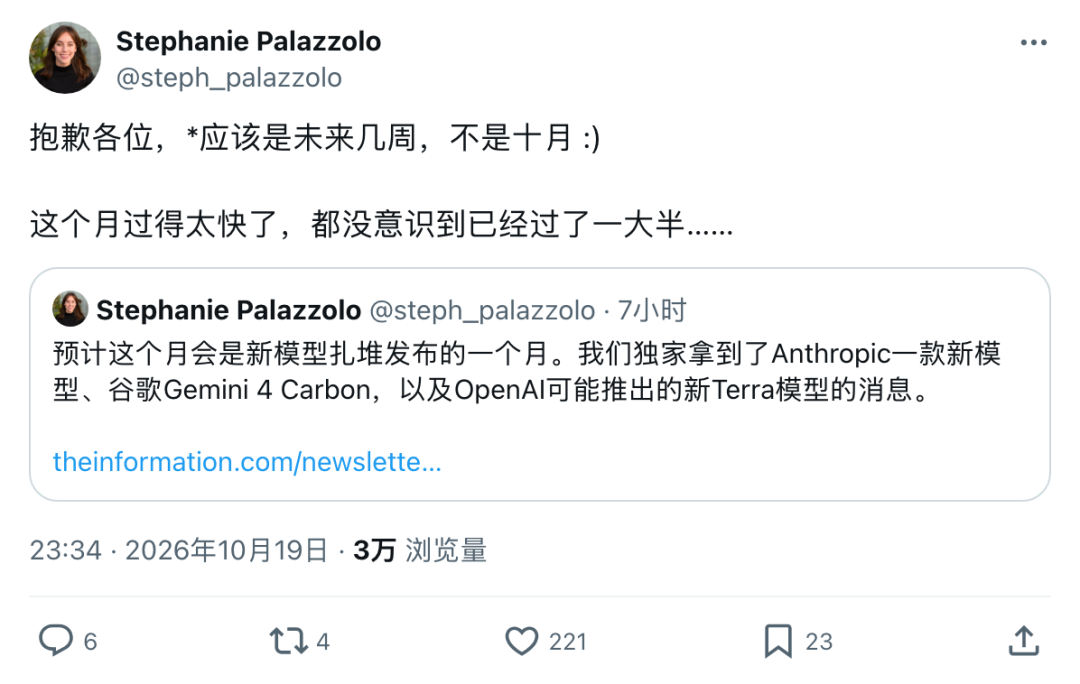
Ein Muster bei den Wochentagen früherer Veröffentlichungen ist kein Zeitplan. Auch „in den kommenden Wochen“ ist eine gemeldete Erwartung und keine garantierte Frist oder Grundlage für die Aussage, dass die Veröffentlichung höchstens eine festgelegte Anzahl von Wochen entfernt ist.
Berichte über Google und OpenAI verstärken die Diskussion
Der Abschnitt zu Google beschreibt Tests von Carbon innerhalb von Jetski. Berichten zufolge verglichen Mitarbeitende dessen Coding-Verhalten mit Opus 5.5. Erwähnt werden außerdem visuelles Verständnis und Frontend-Tests. Dabei handelt es sich weiterhin um interne Eindrücke und nicht um Ergebnisse eines unabhängig reproduzierten direkten Vergleichs.
Die Quelle enthält außerdem einen Vergleich von Aktionspreisen für Argon mit einem Enddatum am 30. November. Da in dieser Berichterstattung kein vollständiger, verifizierter Tarif angegeben wird, sollte dieser Vergleich nicht als Kaufpreis verwendet werden. Modell, Kontextlänge, Caching und Abrechnungskanal müssen übereinstimmen, bevor Preise sinnvoll verglichen werden können.
Bei OpenAI spricht die Quelle über ein zukünftiges Terra-Modell und über die angebliche Ersetzung von 18 Microsoft-Evaluierungseinstellungen durch eine GPT-6.1-Terra-Kennung.

Diese Sichtung belegt weder einen öffentlichen Preis noch ein Veröffentlichungsdatum. Auch die zusätzliche Darstellung eines künftigen Spitzenmodells, das einige Komponenten eines rekurrenten Transformers verwenden soll, wird hier nicht durch eine verifizierte öffentliche Beschreibung der Architektur gestützt.
Was lange Coding-Aufgaben zeigen müssten
Der letzte Abschnitt argumentiert, dass ein besseres Urteilsvermögen wichtiger wird, je länger Aufgaben dauern. Das ist eine plausible Hypothese, die überprüft werden sollte: Kleine Planungsfehler können sich bei einer umfangreichen Änderung fortpflanzen, während eine bessere Diagnose unnötige Arbeit reduzieren kann.
Die Quelle enthält Zahlen zum Traffic-Wachstum, nennt jedoch nicht genügend methodische Details, um eine Kausalität oder eine allgemeine Marktregel zu belegen. Sie werden hier nicht als verifizierte Messwerte dargestellt.
Für die besprochenen Coding-Beispiele bleibt der praktische Maßstab konkret: Hat der Agent das zugrunde liegende Problem gefunden, bestehendes funktionierendes Verhalten erhalten, seine Änderungen getestet und vor einer Ausweitung des Umfangs nachgefragt? Eine eindrucksvolle Demonstration kann diese Bewertung anstoßen. Sie kann sie jedoch nicht ersetzen und auch nicht belegen, dass allgemeine Intelligenz erreicht wurde.
FAQ
Ist Fable 5.5 für morgen bestätigt?
Nein. Aus den bereitgestellten Materialien ergibt sich kein bestätigtes Datum. Die Quelle selbst enthält eine Korrektur hin zu einer allgemeineren Erwartung „in den kommenden Wochen“.
Belegt ein Eintrag in einer Modell-Registry eine Markteinführung?
Er zeigt, dass ein Name in einem Softwareprojekt erfasst wurde. Das garantiert weder einen öffentlichen Endpunkt noch Kontozugriff oder eine offizielle Produktspezifikation.
Hatte die Cryptominer-Geschichte mit Fable 5.5 zu tun?
Der Artikel stellt sie als Erfahrung mit einer bestehenden Claude-Code-Sitzung dar. Er authentifiziert weder das genaue Modell noch belegt er, dass die vermutete Veröffentlichung daran beteiligt war.
Kann die CPU-Auslastung auf einem Mac 100 % überschreiten?
Ja, wenn die Anzeige die Auslastung über mehrere logische Prozessoren aggregiert. Der gemeldete Wert von 1.175 % steht für eine hohe Aktivität über mehrere Kerne hinweg und nicht dafür, dass ein einzelner Kern seine Kapazität überschreitet.
Belegen die Animationsbeispiele, dass das Modell besser ist als GPT-6.1 Sol?
Sie veranschaulichen ausgewählte Ergebnisse aus der Community unter unvollständig dokumentierten Bedingungen. Ohne verifizierte Modellidentitäten und vergleichbare Tests können sie keine allgemeine Rangfolge belegen.
Wo sollten Entwickler die öffentlich verfügbare Claude-Modellreihe prüfen?
Die offizielle Modellübersicht von Anthropic enthält veröffentlichte Kennungen und Links zu den Spezifikationen. Zum Zeitpunkt der Prüfung für diesen Artikel führte sie Fable 5.1 auf, bestätigte jedoch Fable 5.5 nicht.
Verwandte Tools
- Claude: Öffentliche Assistentenplattform von Anthropic für Modelle, die für ein Konto verfügbar sind.
- Claude-Modellübersicht: Offizielle Spezifikationen zur Prüfung veröffentlichter Claude-Modellkennungen.
- LiteLLM: Ein Integrationsprojekt für mehrere Anbieter, das in den Berichten über die Modellnamen erwähnt wird.
Verwandte Links
- Bereitgestellter Artikel auf BAAI Hub: Quelle der Zusammenfassung, der Community-Beispiele und der wiedergegebenen Screenshots.
- Offizielle Modellübersicht von Anthropic: Die für diesen Artikel geprüfte öffentliche Modellreihe.
- Referenz von The Information: Der von der Quelle zitierte, zugangsbeschränkte Bericht; der vollständige Text wurde nicht abgerufen.
- Referenz zu Stephanie Palazzolo: Die zusammen mit der Diskussion über den Veröffentlichungszeitpunkt angegebene Social-Media-Referenz.
- Zusätzliche Social-Media-Referenz: Eine weitere von der Quelle aufgeführte Referenz und keine offizielle Produktankündigung.
- OpenAI-Modellkatalog: Offizielle veröffentlichte Modelllisten zur Prüfung von OpenAI-Kennungen.
Zusammenfassung
Die Spekulationen über Fable 5.5 verbinden Sichtungen von Modellnamen, gemeldete Eindrücke von Testern und Coding-Beispiele aus der Community. Die bereitgestellten Belege bestätigen weder einen Veröffentlichungstermin noch ein verborgenes Routing oder einen allgemeinen Leistungsvorsprung.
Das relevante Signal, auf das man achten sollte, ist eine verifizierte Veröffentlichung mit reproduzierbarem Verhalten – insbesondere bei langen Aufgaben, bei denen Diagnose, Tests und die Kontrolle des Umfangs entscheidend sind.


