For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/flux-3-image-klein-specs-gpu-memory-api-a-c62c858a.md.
Black Forest Labs veröffentlichte **FLUX 3 Image Klein** am 15. Oktober als Open-Weights-Modell für die Bildgenerierung und Bildbearbeitung....
Black Forest Labs veröffentlichte FLUX 3 Image Klein am 15. Oktober als Open-Weights-Modell für die Bildgenerierung und Bildbearbeitung. Ein einziges Modell verarbeitet Text-zu-Bild-Anfragen, Bearbeitungen anhand einer Referenz und Kompositionen auf Basis mehrerer Referenzen.
Der Bildgenerator enthält 5,6 Milliarden Parameter. Diese Zahl schließt den separaten Textencoder aus – ein wichtiges Detail beim Vergleich von Modellgrößen oder bei der Planung lokaler Hardware. BFL bietet sowohl einen Basis-Checkpoint für Anpassungen als auch einen destillierten Checkpoint für eine schnellere Generierung sowie Zugang über seine API.
Die Veröffentlichung kombiniert einen kleineren Generator mit Unterstützung für bis zu zehn Referenzbilder, nativer 4K-Generierung und Bounding-Box-Steuerung. Bereitstellungsentscheidungen hängen jedoch weiterhin vom Checkpoint, der Präzision, der Inferenzimplementierung und den Lizenzbedingungen ab.
Das Modell akzeptiert einen Prompt und bis zu zehn Referenzbilder und gibt ein Bild zurück. Referenzeingaben können dabei helfen, ein Motiv zu verankern oder Material aus mehreren Quellen zu kombinieren, während die schriftliche Beschreibung die gewünschte Szene und Komposition steuert.
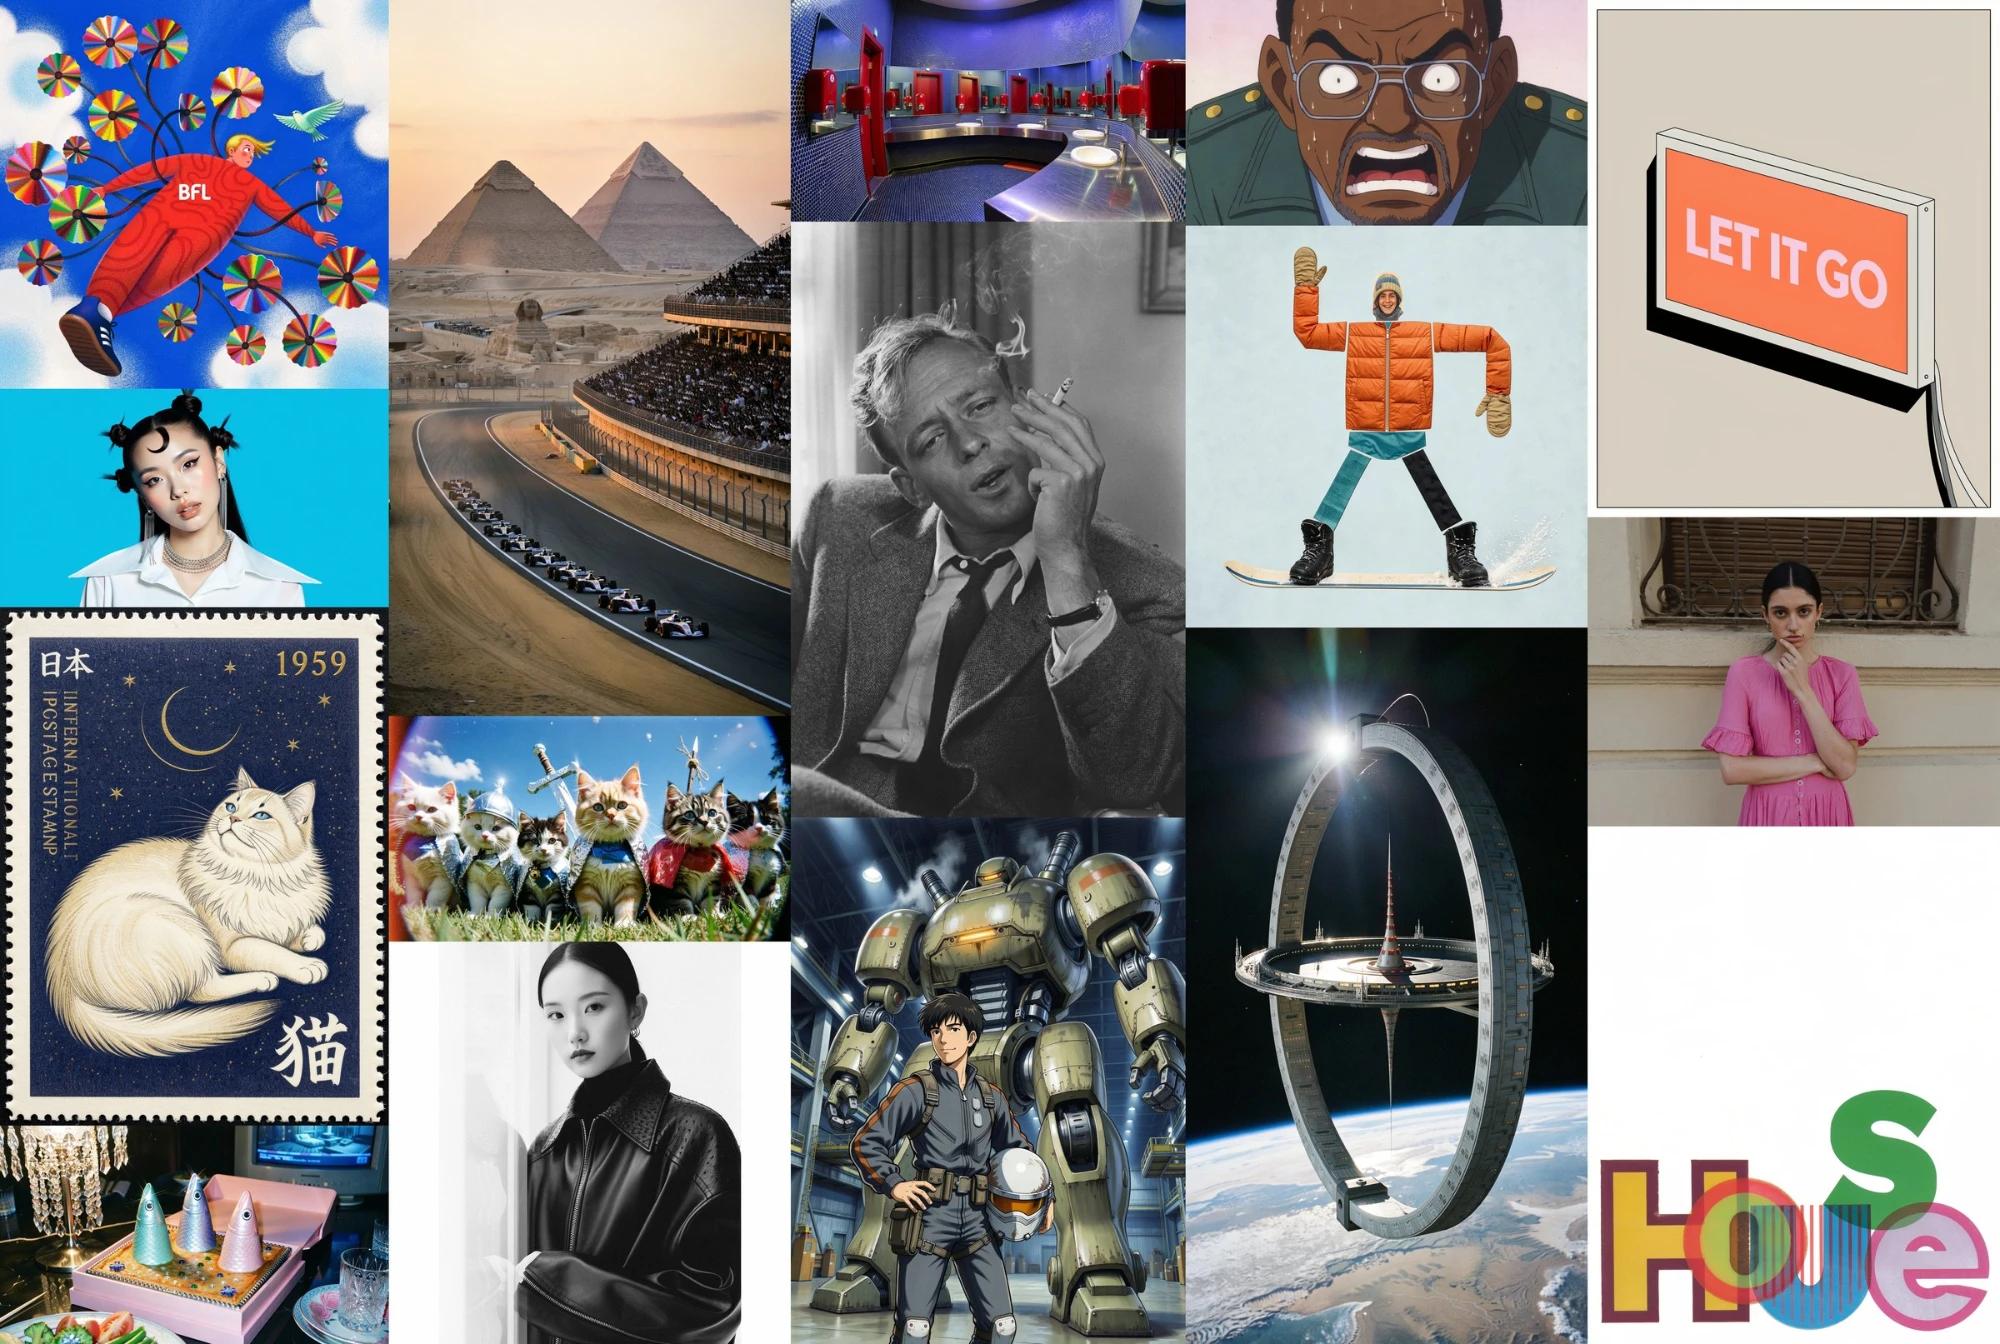
Quelle: Black Forest Labs. Dies ist eine vom Herausgeber ausgewählte Sammlung generierter Ergebnisse und keine unabhängige Qualitätsbewertung.
BFL beschreibt das Modell als Ergebnis gemeinsamer Erkenntnisse aus der Bild-, Video- und Audioforschung der FLUX-3-Familie. Für Image Klein selbst umfasst die veröffentlichte Schnittstelle Bildgenerierung und Bildbearbeitung; dieser Forschungshintergrund bedeutet nicht, dass der Checkpoint Audio oder Video generiert.
Bounding Boxes steuern die Positionierung und Skalierung von Elementen. Die offizielle Modellkarte definiert ein Koordinatenraster von 0 bis 1000 und ordnet jede Box als oben, links, unten, rechts an. Sie weist außerdem darauf hin, dass Boxen keine harten Pixelmasken sind: Elemente können über sie hinausreichen, kleine Elemente können verschwinden und Bearbeitungen können Bereiche außerhalb der angeforderten Region beeinflussen.
Die von BFL gehostete API ergänzt Pixel Restoration, die unbearbeitete Regionen exakt erhalten soll. Diese Serving-Funktion sollte nicht als uneingeschränkte Eigenschaft einer Inferenz mit dem unveränderten Checkpoint betrachtet werden.
Die beiden wichtigsten Checkpoints dienen unterschiedlichen Zwecken:
| Checkpoint | Veröffentlichte Schrittzahl | Guidance-Einstellung | Vorgesehene Nutzung |
|---|---|---|---|
| Klein Base | 50 | 3,5 | Fine-Tuning, LoRA-Training und Forschung |
| Klein | 16 | Keine | Generierung, Bearbeitung und selbst gehostete Inferenz |
Quelle: Offizielle Modellkarte von BFL. Der destillierte Checkpoint ist auch das Modell hinter der gehosteten Image-Klein-API.
Das Modell verwendet Qwen3-VL-4B-Instruct als separaten Textencoder. Das Hugging-Face-Paket umfasst den Bildtransformer, den Textencoder und den Bildautoencoder; dort werden BF16-, FP8- und NVFP4-Varianten beschrieben, während die Ankündigung zur Veröffentlichung außerdem von NVIDIA unterstützte INT8-Builds nennt.
Für Anpassungen verweist BFL Entwickler auf das Basismodell. Die Ankündigung nennt Unterstützung durch Diffusers, Ostris's AI Toolkit und NVIDIA NeMo AutoModel für LoRA und weitere Trainingsworkflows.
BFL berichtet, dass Image Klein in seinen internen Text-zu-Bild-, Bearbeitungs- und Multi-Reference-Vergleichen gegenüber den ausgewählten Alternativen führt. Der Launch-Artikel hebt gegenüber FLUX.2 [klein] 9B Verbesserungen von 91 Elo bei Text-zu-Bild und 70 Elo bei der Bearbeitung hervor, während 38 % weniger Generatorparameter verwendet werden.
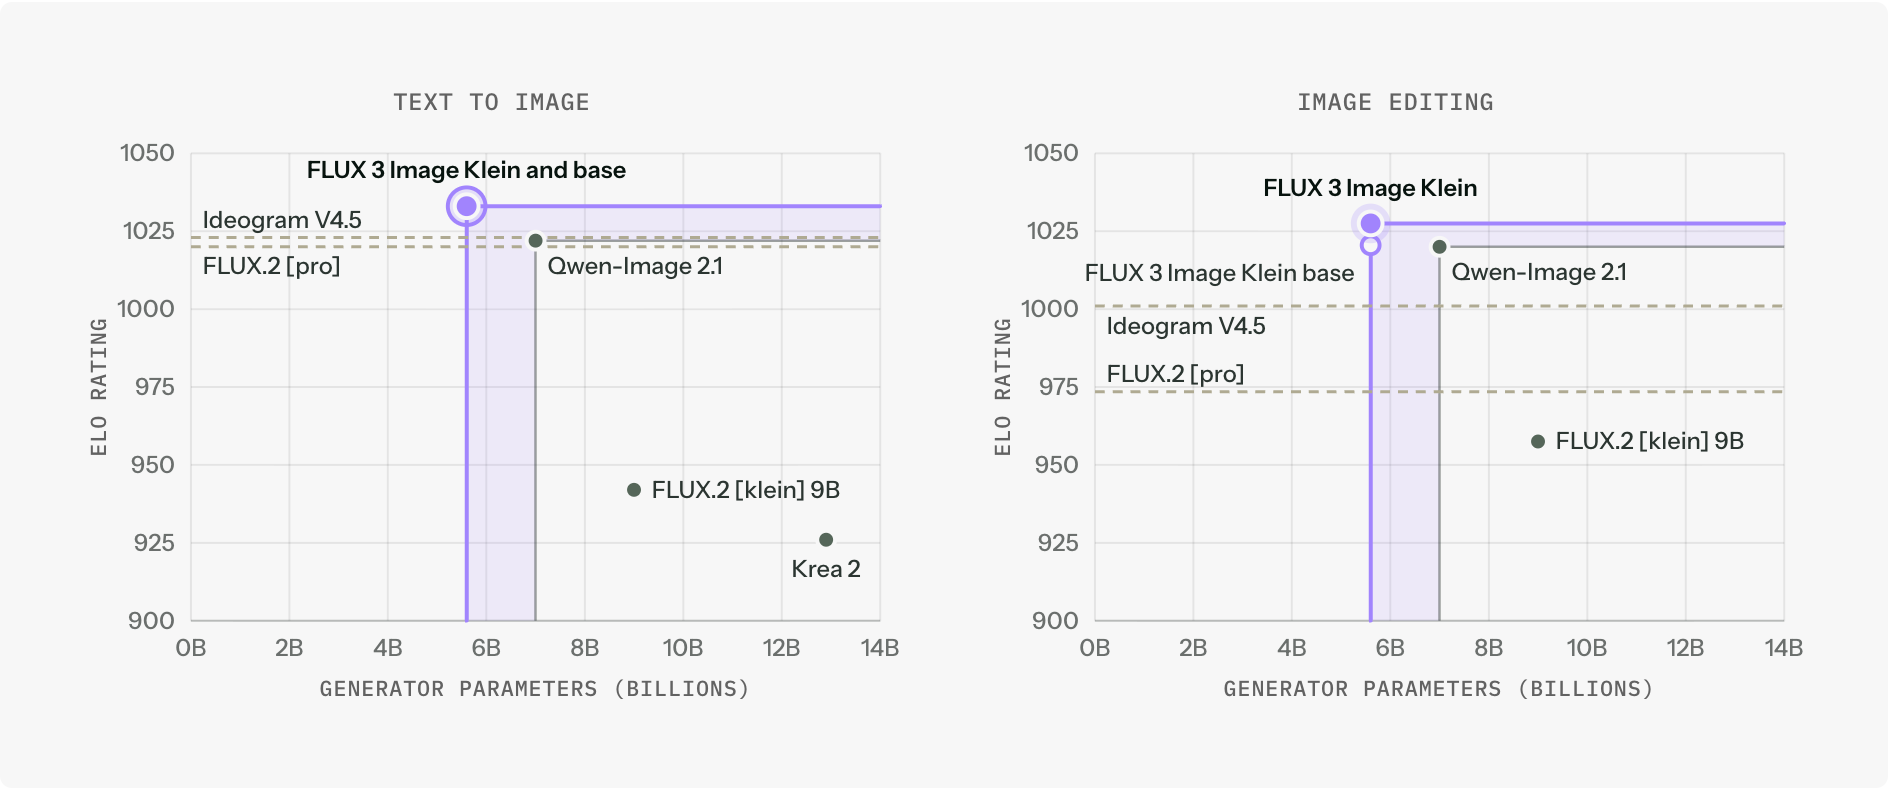
Quelle: Black Forest Labs. Die Parameterzahlen der Generatoren schließen Textencoder aus; Krea 2 ist vom Bearbeitungsvergleich ausgeschlossen, weil es diese Aufgabe nicht unterstützt.
Diese Bewertungen beschreiben das Vergleichsfeld und das Evaluierungsverfahren von BFL. Sie belegen nicht, dass das Modell für jeden Prompt, Stil, jede Sprache oder Bearbeitungsvorgabe das beste Ergebnis liefert. Für einen produktiven Workflow sollten die Arten von Referenzen und Bearbeitungen getestet werden, die in diesem Workflow tatsächlich vorkommen.
Die Launch-Ankündigung nennt für die Generatorgewichte Anforderungen von 11,2 GB in BF16 und 5,6 GB in FP8. Das sind Gewichtgrößen und keine vollständigen Budgets für den GPU-Speicher.
BFL gibt an, dass ein optimierter INT8-Build über unterstützte ComfyUI- oder Diffusers-Konfigurationen auf GeForce-RTX-GPUs mit nur 8 GB VRAM laufen kann. Diese Aussage hängt vom Build und der Implementierung ab; sie bedeutet nicht, dass die unveränderte Referenzpipeline in 8 GB passt.
Die Modellkarte berichtet für den Referenzcode den folgenden Spitzenwert beim Speicher auf einer B200 bei 1024 mal 1024 Pixeln, bei deaktiviertem Prompt-Upsampler:
| Präzision | Gemeldeter Spitzenwert des GPU-Speichers |
|---|---|
| BF16 | 31 GB |
| FP8 | 26 GB |
| NVFP4 | 25 GB |
Dieselbe Karte besagt, dass der Prompt-Upsampler auf einer 80-GB-GPU etwa 28 GB zusätzlich benötigt. Textencoding, Zwischenaktivierungen, Auflösung und Referenzverarbeitung erklären mit, warum der Gesamtspeicher größer ist als die gespeicherten Gewichte des Generators.
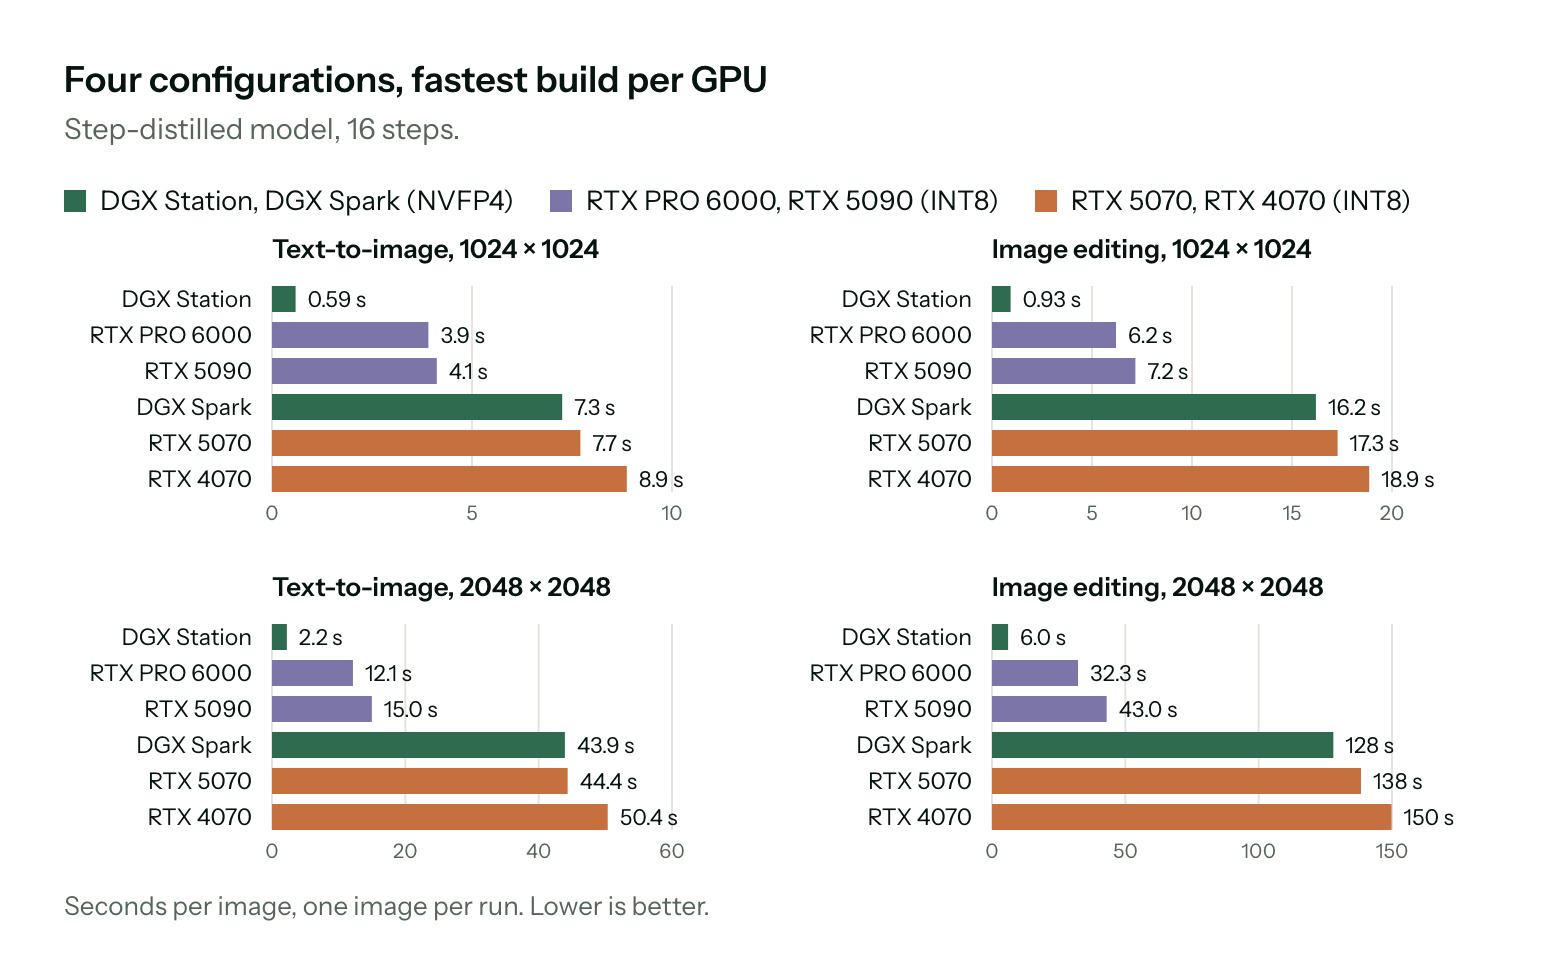
Quelle: BFL, gemessen von NVIDIA. Das Diagramm verwendet ein Bild pro Durchlauf und den jeweils schnellsten aufgeführten Build pro GPU; RTX-Messungen nutzen ComfyUI. Es handelt sich um Generierungszeiten und nicht um vollständige API-Antwortzeiten.
Für den destillierten Checkpoint mit 16 Schritten berichtet das Diagramm 4,1 Sekunden für ein Text-zu-Bild-Ergebnis mit 1024 mal 1024 auf einer RTX 5090 und 8,9 Sekunden auf einer RTX 4070. Die Bearbeitung dauert in diesen Messungen länger, und die größeren Konfigurationen mit 2048 mal 2048 sind deutlich langsamer.
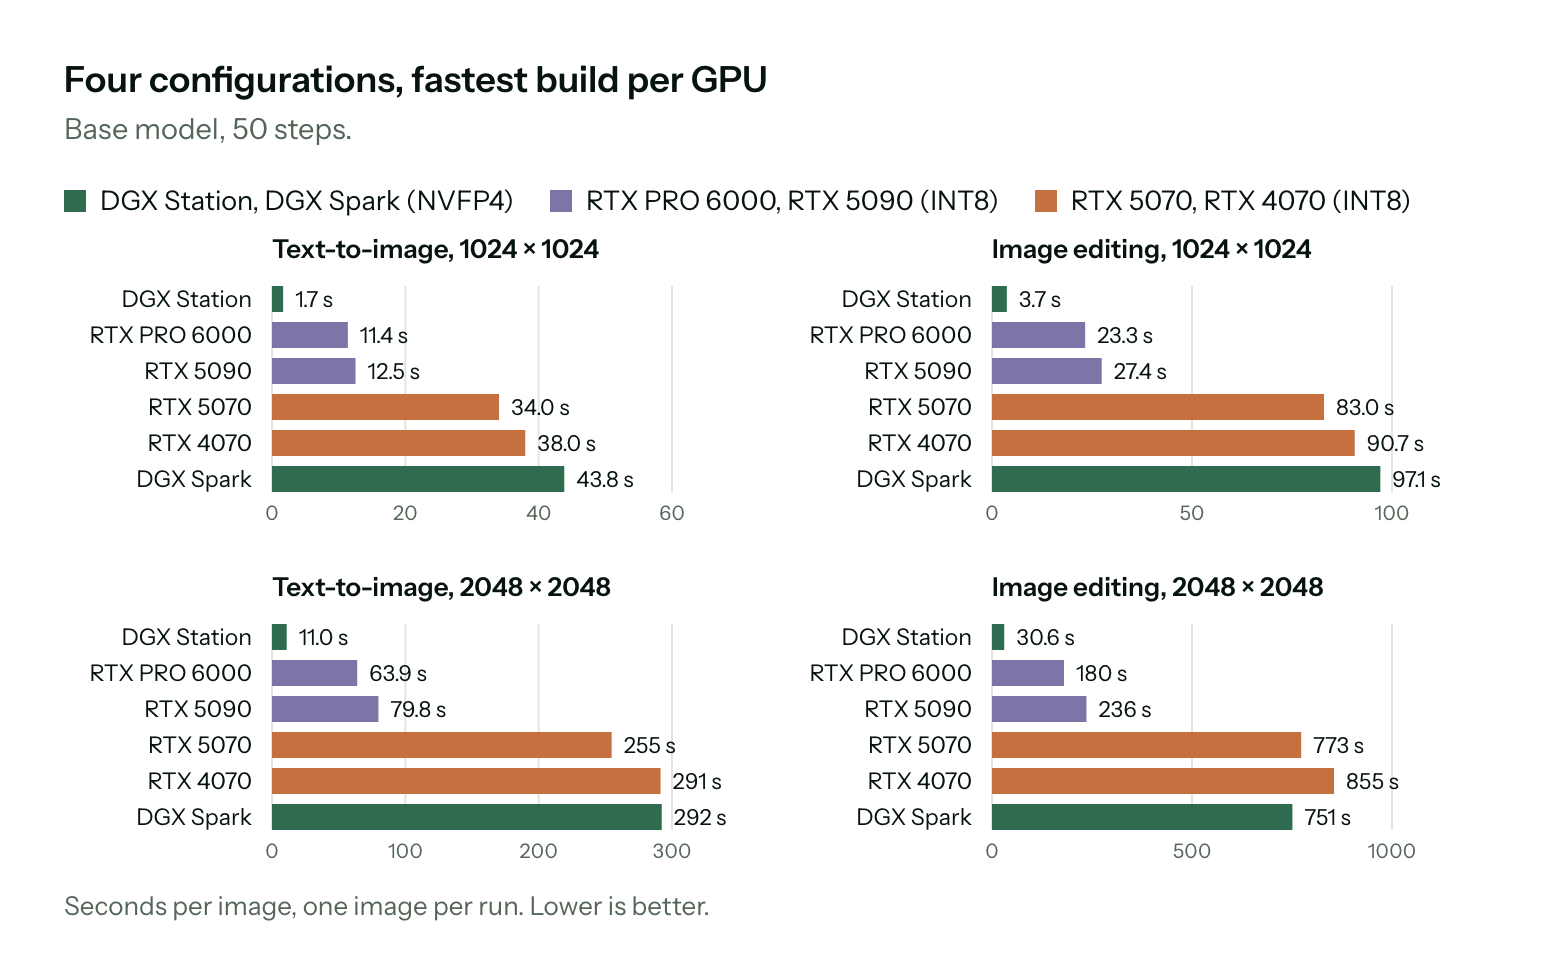
Quelle: BFL, gemessen von NVIDIA. Dieses Diagramm verwendet den Basis-Checkpoint mit 50 Schritten und den schnellsten für jede GPU gezeigten Build.
Das Basismodell mit 50 Schritten weist ein anderes Geschwindigkeitsprofil auf. Seine Ergebnisse sollten getrennt vom destillierten Modell betrachtet werden, insbesondere bei der Schätzung der Iterationszeit für Training oder Referenzbildbearbeitung.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die BFL-API stellt das destillierte Modell als flux-3-image-klein bereit. Laut Launch-Ankündigung beginnt die Preisgestaltung bei 0,009 US-Dollar pro 1K-Bild und umfasst Prompt-Upsampling sowie Pixel Restoration im gehosteten Angebot. Prüfen Sie vor der Kalkulation einer Produktionsrechnung die aktuelle API-Dokumentation und die Kontopreise.
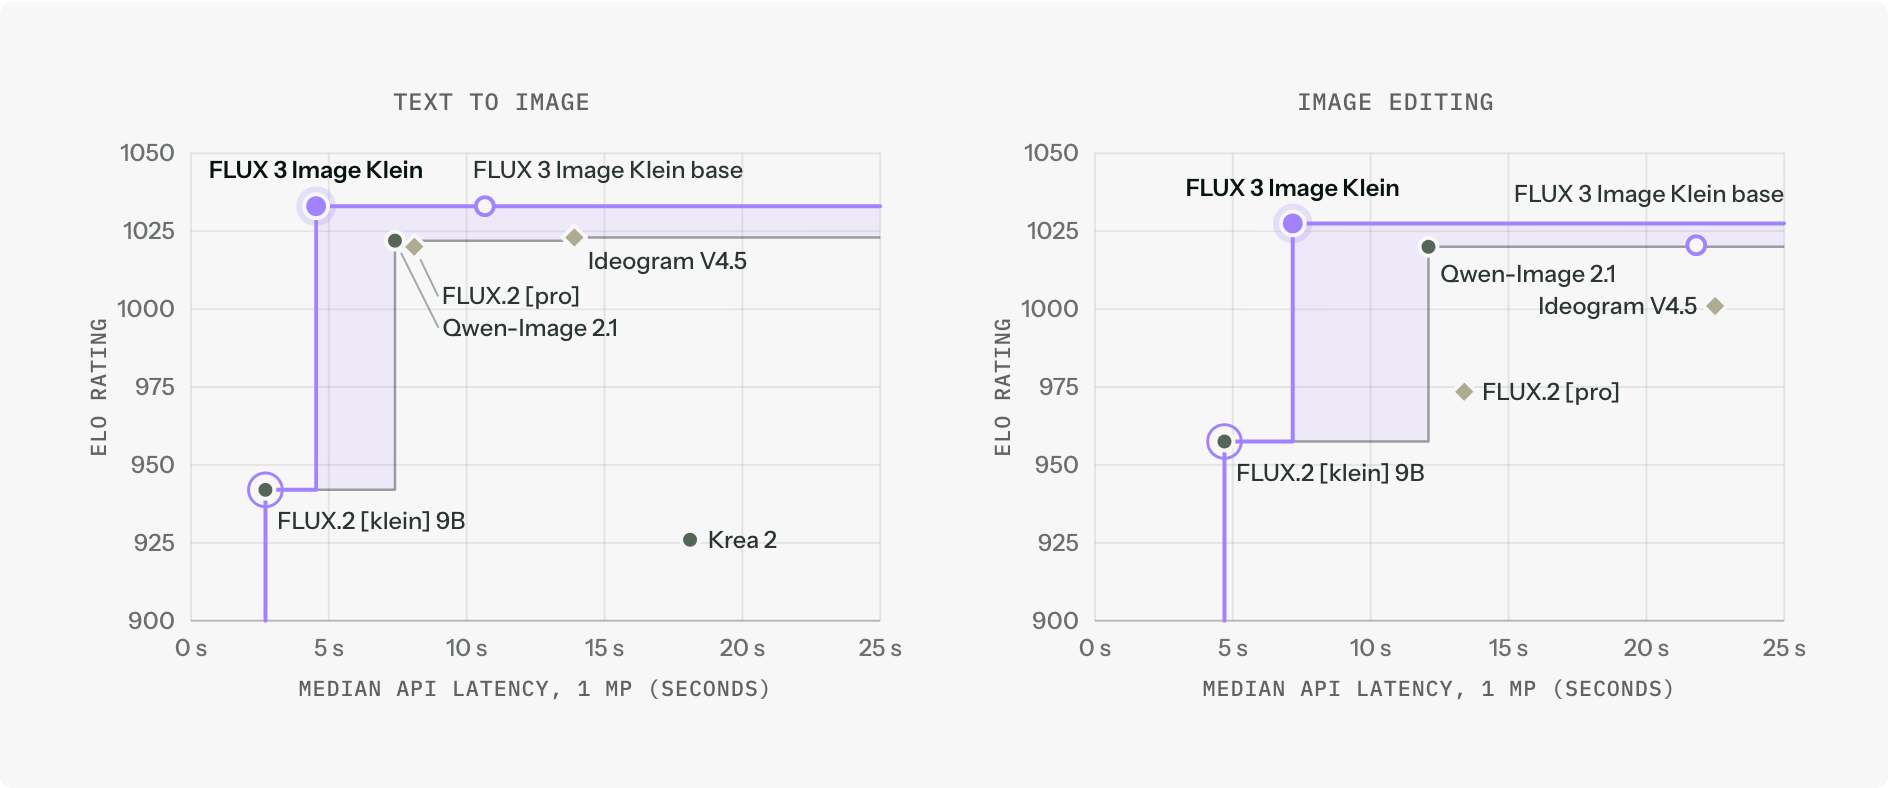
Quelle: Black Forest Labs. Der veröffentlichte Vergleich verwendet fertige 1-MP-Bilder und berücksichtigt Warteschlangen; BFL maß sein eigenes Modell auf seinen Servern, während Messungen von Wettbewerbern clientseitig erfolgten und Polling sowie Netzwerkzeit einschlossen.
Diese Unterschiede bei den Messungen sind für die Interpretation der Geschwindigkeitsrangfolge relevant. Lokale Generierungszeit, serverseitiges Timing und vom Client beobachtete API-Latenz beantworten verwandte, aber unterschiedliche Fragen. Eine Anwendung sollte die Zeit von der eigenen Anfrageübermittlung bis zum Vorliegen eines nutzbaren Ergebnisses messen.
Die offizielle Modellkarte betont vollständige Szenenbeschreibungen. Kurze Anweisungen, die direkt an das Bildmodell gesendet werden, können generische Ergebnisse erzeugen oder eine Bearbeitung unbeabsichtigt umgestalten.
Eine praktische Reihenfolge für die Evaluierung ist:
Die Referenz-CLI lädt den Prompt-Upsampler von BFL standardmäßig. Diffusers ruft ihn nicht automatisch auf; daher muss dieser Schritt bei Nutzung der dokumentierten modularen Pipeline separat behandelt werden.
Die Release-Ankündigung enthält einen Zitierblock, der hier zur Quellenangabe wiedergegeben wird:
@misc{bfl2026flux3imageklein,
  author       = {{Black Forest Labs}},
  title        = {{FLUX} 3 Image Klein},
  year         = {2026},
  url          = {https://bfl.ai/blog/flux-3-image-klein},
}
Image Klein verwendet die FLUX Kommunity License v1.0. Die Modellkarte beschreibt eine nichtkommerzielle Nutzung sowie eine Ausnahme für kommerzielle Output-Generierung für qualifizierte Nutzer mit weniger als 5 Millionen US-Dollar annualisiertem Bruttoumsatz, einschließlich verbundener Unternehmen und vorbehaltlich der Vereinbarung.
Diese Ausnahme ist keine pauschale Erlaubnis für jedes kommerzielle Training, jede Weiterverbreitung oder jedes Service-Modell. Größere Organisationen und andere Nutzungsarten müssen die kommerziellen Lizenzbedingungen von BFL prüfen oder die gehostete API gemäß ihren geltenden Bedingungen nutzen. Der separate Qwen-Textencoder verwendet Apache-2.0.
BFL berichtet über Filterung der Trainingsdaten, Maßnahmen nach dem Training, internes Red Teaming und eine Bewertung durch Cinder. Diese Maßnahmen beseitigen nicht die in der Modellkarte genannten Einschränkungen: Generierter Text kann ungenau sein, Prompt-Folgen kann fehlschlagen, Verzerrungen können auftreten und Bearbeitungen können unbeabsichtigte Regionen verändern.
Es ist das Open-Weights-Bildmodell von BFL für Text-zu-Bild-Generierung, Bildbearbeitung und Kompositionen mit mehreren Referenzen. Die Angabe von 5,6 Milliarden Parametern beschreibt den Bildtransformer und schließt den separaten Textencoder aus.
BFL gibt an, dass unterstützte optimierte INT8-Konfigurationen auf GPUs mit nur 8 GB VRAM laufen können. Die Referenzimplementierung weist deutlich höhere dokumentierte Spitzenwerte beim Speicher aus, daher hängt die Hardwareeignung von der vollständigen Laufzeitkonfiguration ab.
Klein Base ist der nicht destillierte Checkpoint für Fine-Tuning, LoRA und Forschung mit einer veröffentlichten Konfiguration von 50 Schritten. Klein ist für Generierung und Bearbeitung destilliert, nutzt eine veröffentlichte Konfiguration mit 16 Schritten und keine Guidance.
Nein. Die offizielle Modellkarte besagt, dass Boxen Positionierung und Skalierung steuern, statt eine harte Maske zu erzwingen. Die Pixel-Restoration-Funktion der gehosteten API ist ein separater Bestandteil des Serving-Workflows.
Die Lizenz enthält für qualifizierte Nutzer unterhalb der Schwelle von 5 Millionen US-Dollar annualisiertem Bruttoumsatz eine Ausnahme für kommerzielle Outputs, vorbehaltlich aller Bedingungen. Kommerzielles Fine-Tuning, Vertrieb und andere Vereinbarungen erfordern die Prüfung der vollständigen Vereinbarung, statt sich allein auf die Umsatzschwelle zu stützen.
Die dokumentierte Diffusers-Pipeline führt den Prompt-Upsampler nicht selbst aus. BFL empfiehlt, zunächst seinen Upsampler oder ein anderes geeignetes Sprachmodell auszuführen und die daraus resultierende vollständige Beschreibung an die Bildpipeline zu übergeben.
FLUX 3 Image Klein vereint Text-zu-Bild-Generierung, referenzbasierte Bearbeitung und Layout-Steuerung in einem kleineren Open-Weights-Bildgenerator. Die Basis- und destillierten Checkpoints bieten Entwicklern getrennte Wege für Anpassungen und schnellere Inferenz.
Die wichtigsten Bereitstellungsdetails liegen jenseits der Parameterzahl: vollständiger Speicherbedarf, Prompt-Upsampling, Bearbeitungsverhalten und Lizenzumfang. Wählen und bewerten Sie die vollständige Pipeline, statt eine Gewichtgröße oder einen Launch-Benchmark als vollständige Bereitstellungsspezifikation zu behandeln.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.
