For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/gemini-4-argon-arc-agi-3-97-5-score-cost-f02ba71b.md.
ARC Prize hat für Gemini 4 Argon einen **verifizierten ARC-AGI-3-Score von 97,5 % bekannt gegeben**. Damit ist Google DeepMind laut dem Vera...
ARC Prize hat für Gemini 4 Argon einen verifizierten ARC-AGI-3-Score von 97,5 % bekannt gegeben. Damit ist Google DeepMind laut dem Veranstalter das zweite Frontier-Labor, das bei diesem Benchmark die Marke von 95 % überschreitet.
Ein ebenso wichtiger Vergleich gehört zu diesem Ergebnis: Dieselbe Modellfamilie erreichte 49,8 % mit dem Standard-Harness, gegenüber 97,5 % mit einem Provider Adapter. Die gemeldeten Evaluierungskosten lagen bei etwa 5.800 beziehungsweise 4.800 US-Dollar.
Dabei handelt es sich um Ergebnisse konfigurierter Systeme. Bevor sich aus der Schlagzeilenzahl Schlussfolgerungen ziehen lassen, müssen der Benchmark, das Reasoning-Niveau, das Harness und die unvollständigen Durchläufe berücksichtigt werden.
Die Bekanntgabe von ARC Prize enthält folgende Zahlen:
| Benchmark und Einstellung | Gemeldeter Score | Gemeldete Evaluierungskosten |
|---|---|---|
| ARC-AGI-1, beste gemeldete Einstellung | 98,5 % | Etwa 0,16 US-Dollar pro Aufgabe |
| ARC-AGI-2, beste gemeldete Einstellung | 91,3 % | Etwa 0,32 US-Dollar pro Aufgabe |
| ARC-AGI-3, Provider Adapter, niedriges Reasoning-Niveau | 97,5 % | Etwa 4.800 US-Dollar für die Evaluierung |
| ARC-AGI-3, Standard, niedriges Reasoning-Niveau | 49,8 % | Etwa 5.800 US-Dollar für die Evaluierung |
Die Kosteneinheiten unterscheiden sich. Die Beträge für ARC-AGI-1 und ARC-AGI-2 gelten pro Aufgabe; die Beträge für ARC-AGI-3 beziehen sich auf den gesamten Evaluierungslauf. Ohne diesen Unterschied zu berücksichtigen, sollten die Kosten nicht auf einer einheitlichen Skala verglichen werden.
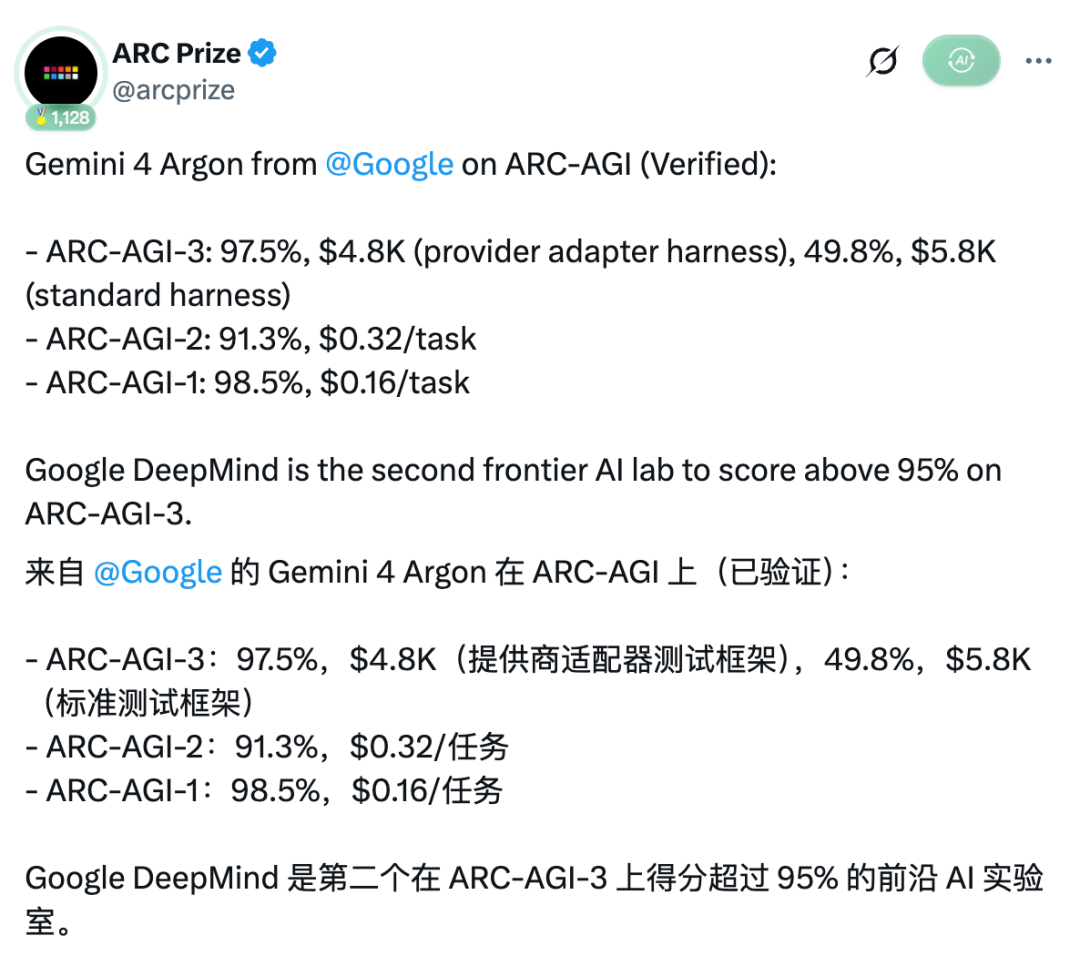
Die Bekanntgabe der verifizierten Scores von ARC Prize, wie sie im Ausgangsbericht wiedergegeben wird.
Die aktuelle Tabelle nennt genauere Kosten für die besten Einstellungen: 0,162 US-Dollar pro Aufgabe bei ARC-AGI-1 und 0,325 US-Dollar bei ARC-AGI-2. Für ARC-AGI-2 werden 91,3 % aufgeführt, was mit der Bekanntgabe übereinstimmt. Im begleitenden Absatz der Ergebnisseite steht jedoch 91,2 %. Dieser Artikel übernimmt den angekündigten und tabellarisch aufgeführten Wert und weist zugleich auf die Abweichung hin.
ARC-AGI-3 unterscheidet sich von den ersten beiden Generationen. Statt aus statischen Beispielen ein Ausgaberaster abzuleiten, erkundet ein Agent unbekannte interaktive Umgebungen, findet heraus, wie Aktionen funktionieren, und lernt, Ziele zu erreichen – ohne natürlichsprachliche Anweisungen, die das Spiel erklären.
ARC Prize beschreibt den Test als Messung der Effizienz beim Kompetenzerwerb sowie der Anpassungsfähigkeit und Planung über einen längeren Zeitraum. Der Score bedeutet daher nicht einfach „den Prozentsatz gewonnener Spiele“. Laut der Erläuterung des Benchmarks setzt ein Score von 100 % voraus, die Spiele mindestens so effizient abzuschließen wie die menschliche Referenz.
Der Ausgangsbericht zeichnet den Wandel von Scores unter 1 % bei Frontier-Modellen um den Start von ARC-AGI-3 im März bis hin zu nahezu maximalen Ergebnissen später im Jahr nach. Er hebt zunächst das frühere GPT-6-Astra-Ergebnis von OpenAI hervor und anschließend den Einstieg von Gemini mit einem Score von mehr als 95 %.
Das ist eine beträchtliche Veränderung bei dieser Evaluierung. Es bedeutet nicht, dass der Veranstalter jede denkbare Form des Reasonings getestet oder nachgewiesen hat, dass eines der beiden Systeme jede neue Aufgabe so erlernen kann wie ein Mensch.
Der Bericht beschreibt außerdem eine hohe Aktionseffizienz bei 25 öffentlichen Spielen: 62 % weniger Aktionen als bei einer menschlichen Ausgangsbasis, drei Spiele mit einer Geschwindigkeit auf oder über den Speedrun-Rekorden und sechs Spiele innerhalb von 10 % dieser Rekorde. Diese konkreten Vergleiche sind im Ausgangsbericht beschriebene Beobachtungen aus dem öffentlichen Testsatz. Sie sollten weder auf alle 55 Evaluierungsaufgaben noch auf beliebige Spiele übertragen werden.
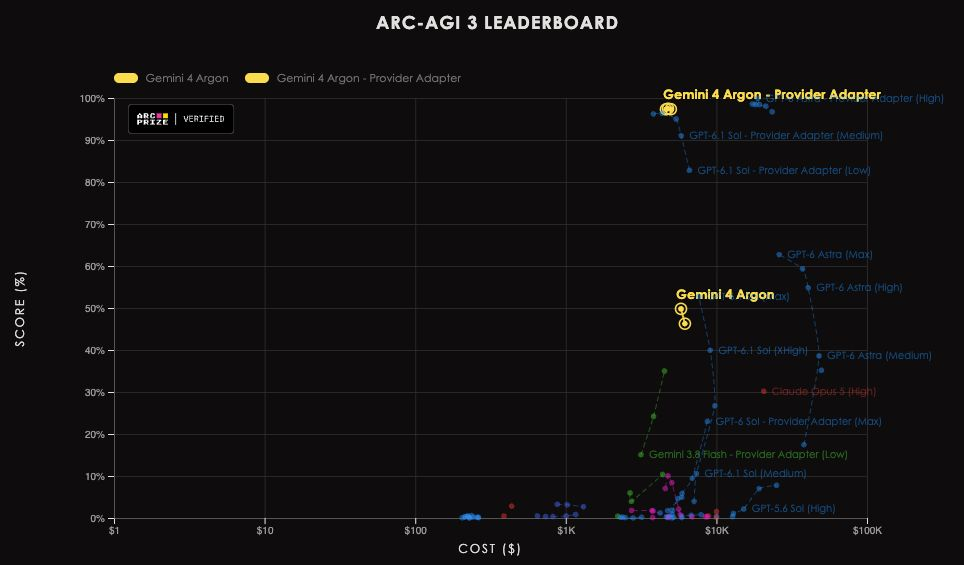
Im Bericht enthaltene Bildschirmaufnahme der Bestenliste; die aktuelle Ergebnisseite enthält die jeweils gültigen Konfigurationsdetails.
Ein Agent-Harness steuert die Interaktion rund um ein Modell: wie Beobachtungen übermittelt werden, wie Aktionen ausgeführt werden, welcher Kontext erhalten bleibt und was passiert, wenn eine Unterhaltung lang wird.
ARC Prize definiert die beiden Bedingungen getrennt:
Für Gemini 4 Argon zeigen die aktuellen Ergebnisse:
| Reasoning-Niveau | Standard-Harness | Provider-Adapter-Harness |
|---|---|---|
| Niedrig | 49,8 % | 97,5 % |
| Mittel | 46,3 % | 97,3 % |
| Hoch | Kein vollständiger gemeldeter Vergleichswert | 97,3 % |
Der Unterschied beim niedrigen Reasoning-Niveau beträgt 47,7 Prozentpunkte. Das zeigt, dass das konfigurierte Interaktionssystem das gemessene Ergebnis wesentlich beeinflusst. Es isoliert jedoch keinen einzelnen kausalen Mechanismus. Neben der Harness-Bezeichnung müssen auch die Kontextverwaltung, die Ausführungsbedingungen, die API-Zuverlässigkeit und weitere Einstellungen berücksichtigt werden.
ARC Prize berichtet insbesondere von API-Problemen, die vollständige Evaluierungen mit dem Standard-Harness verhinderten. Die Durchläufe mit niedrigem, mittlerem und hohem Reasoning-Niveau wurden jeweils für 42, 46 beziehungsweise 19 der 55 Aufgaben abgeschlossen. Die gemeldeten Gesamtscores umfassen alle 55 Aufgaben und berücksichtigen Teilpunkte aus unvollständigen Durchläufen. Die Angaben zur Zahl der abgeschlossenen Aufgaben bedeuten nicht, dass 42 oder 46 Spiele zwingend vollständig gelöst wurden.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Der unvollständige Standard-Durchlauf mit hohem Reasoning-Niveau wurde aus der Grafik ausgeschlossen. In dieser Evaluierung ergab sich somit keine vollständig abgeschlossene, sauber vergleichbare Reihe von Standard-Ergebnissen, aus der sich ein Effekt höherer Reasoning-Leistung ablesen ließe.
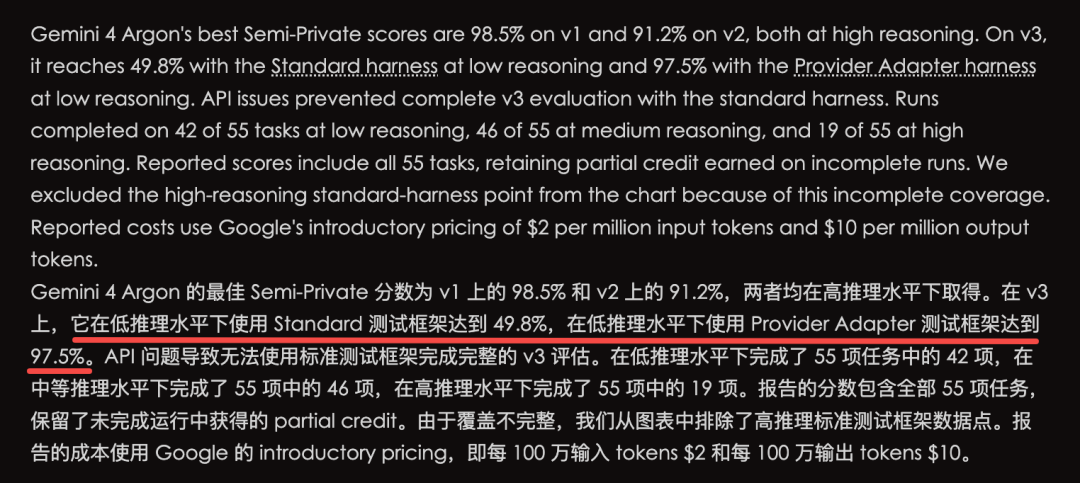
Hinweis zu Konfiguration und Abdeckung aus dem Ausgangsbericht; für Aktualisierungen sollten Leserinnen und Leser die aktuelle Ergebnisseite konsultieren.
Laut ARC Prize beruhen die Kostenschätzungen auf den Einführungspreisen der Google API von 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Million Ausgabe-Token. Sie sind kein Festpreis für die Lösung einer neuen realen Aufgabe und können sich mit Änderungen an Preisen oder Konfigurationen verändern.
Die wichtigste praktische Erkenntnis des Ausgangsberichts ist zutreffend: Ein Modellname und eine einzelne Prozentzahl lassen wesentliche Aspekte des geprüften Systems unberücksichtigt. Zwei Scores unter demselben Modellnamen können unterschiedliche Fragen beantworten, wenn sich ihre Schnittstellen zur Kontextverwaltung unterscheiden.
Die Richtlinien von ARC Prize sehen ausdrücklich getrennte Berichte für die beiden Harnesses vor, da sie unterschiedliche Evaluierungsfragen behandeln. Die verifizierten Ergebnisse beruhen auf vom Veranstalter durchgeführten Evaluierungen mit veröffentlichter Methodik. Sie sind aussagekräftiger als eine unbelegte Anbieterpräsentation, bleiben aber auf die getestete Aufgabenverteilung und die konkreten Bedingungen beschränkt.
Wer diese Ergebnisse vergleicht, sollte sich in dieser Reihenfolge Benchmark-Version, genaue Modellkonfiguration, Reasoning-Niveau, Harness, Aufgabenabdeckung, Bewertungsregeln und Kosteneinheit ansehen. So lassen sich echte Verbesserungen leichter von Vergleichen zwischen unterschiedlichen Experimenten unterscheiden.
Die Leistung nahe der Obergrenze wirft außerdem die Forschungsfrage auf, wie viel Spielraum ein Test noch bietet. Dadurch verschwinden die verbleibenden Einschränkungen jedoch nicht, und die Bezeichnung „AGI-Benchmark“ wird nicht zum Beweis allgemeiner Intelligenz.
ARC Prize meldet beim Provider-Adapter-Harness mit niedrigem Reasoning-Niveau 97,5 %. Das Ergebnis mit niedrigem Reasoning-Niveau beim Standard-Harness lag bei 49,8 % und wurde unter einer anderen Evaluierungsbedingung mit unvollständigen Durchläufen erzielt.
Nein. ARC-AGI-3 misst die Leistung mit einem effizienzorientierten Bewertungssystem und kann Teilpunkte vergeben. Ein Score sollte nicht direkt in eine Anzahl vollständig abgeschlossener Spiele umgerechnet werden.
Das Standard-Harness ist eine minimale, anbieterneutrale Schnittstelle, die vom Modell ausgewählte Notizen beibehält. Der Provider Adapter kann anbieterspezifische Funktionen zur Kontextverwaltung nutzen, darunter das Bewahren des Reasoning-Zustands und das Verdichten von Unterhaltungen.
Die angekündigten Durchläufe mit niedrigem Reasoning-Niveau kosteten mit dem Provider Adapter etwa 4.800 US-Dollar und mit dem Standard-Harness etwa 5.800 US-Dollar. ARC Prize zufolge beruhen diese Schätzungen auf den Einführungspreisen für Token. Es handelt sich um Gesamtkosten der Evaluierung, nicht um Preise pro Aufgabe.
ARC Prize bezeichnet die Ergebnisse als verifiziert und veröffentlicht seine Testrichtlinien sowie eine Ergebnisseite für das jeweilige Modell. Dieser Artikel hat diese Quellen geprüft, die Evaluierung aber weder erneut durchgeführt noch die Scores unabhängig reproduziert.
Kein einzelner Benchmark kann diese Schlussfolgerung belegen. Das Ergebnis zeigt eine starke Leistung bei ARC-AGI-3 mit der angegebenen Systemkonfiguration. Für Aussagen zur Zuverlässigkeit und Verallgemeinerung über diese Bedingungen hinaus sind weitere Belege erforderlich.
Die verifizierten ARC-AGI-Ergebnisse von Gemini 4 Argon zeigen eine hohe Leistung bei statischen und interaktiven Tests. Die Schlagzeilenzahl von 97,5 % bei ARC-AGI-3 bezieht sich auf eine spezifische Konfiguration mit niedrigem Reasoning-Niveau und Provider Adapter. Die gemeldeten Evaluierungskosten lagen bei etwa 4.800 US-Dollar.
Das Ergebnis mit dem Standard-Harness, die unvollständigen Durchläufe und die Unterschiede bei der Kontextverwaltung sind für die Einordnung des Vergleichs entscheidend. Modell, Harness und Evaluierungsbedingungen müssen gemeinsam betrachtet werden; die Prozentzahl allein belegt keine AGI.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



