For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/gemini-4-argon-launch-access-api-pricing-cf4e0dbb.md.
Googles [Ankündigung zu Gemini 4 Argon](https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/)...
Googles Ankündigung zu Gemini 4 Argon stellt ein Modell für schwierige, umfangreiche Aufgaben vor: große Codeänderungen, visuelle Erstellung, wissenschaftliches Schlussfolgern und Aufgaben, die über einen kurzen Austausch hinausgehen. Der Start umfasst sowohl Entwicklerprodukte als auch Consumer-Erlebnisse, wobei sich die Zugangsbedingungen unterscheiden.
Die praktische Bedeutung liegt in diesen Details. Die Einführungspreise für die API haben ein Enddatum, das Limit von einer Million Tokens wird zwischen mehreren Inhaltsarten geteilt, und eine hervorgehobene Beschleunigung in der Softwareentwicklung gilt für einen bestimmten Teil einer Arbeitslast. Die zugrunde liegende Dokumentation erleichtert eine realistische Bewertung der Ankündigung erheblich.
Google beschreibt kostenpflichtigen API-Zugang über AI Studio und die Gemini-Plattform; die Verfügbarkeit für Entwickler erstreckt sich außerdem auf Android Studio. Abonnenten von Google AI Ultra erhalten Zugang über Antigravity und AI Studio, während der Rollout der Consumer-Gemini-App und des Search AI Mode Google-AI-Pro- und Ultra-Abonnenten umfasst.
Dies sind unterschiedliche Produkte mit unterschiedlichen Berechtigungen. Google-AI-Pro-Zugang zu einem Consumer-Erlebnis bedeutet nicht automatisch, dass derselbe Tarif Entwicklerzugang zu Argon in AI Studio oder ein kostenloses API-Kontingent einschließt.
Für eine Integration sollten Sie die aktuellen Anforderungen für den Entwicklerzugang prüfen, statt sich auf eine allgemeine Launch-Schlagzeile zu verlassen. Die AI-Studio-Preisseite führt das API-Modell als gemini-4-argon auf und nennt keine kostenlose Stufe dafür.
Nach Prüfung am 15. Oktober nennt Googles Standard-API-Preisdokumentation zwei Zeiträume für Gemini 4 Argon. Die folgenden Preise verstehen sich in US-Dollar pro einer Million Tokens.
| Token-Kategorie | Bis 30. November 2026 | Ab 1. Dezember 2026 |
|---|---|---|
| Eingabe | 2,00 $ | 4,00 $ |
| Ausgabe einschließlich Thinking | 10,00 $ | 20,00 $ |
| Implizit zwischengespeicherte Eingabe | 0,10 $ | 0,20 $ |
Die in der Launch-Ankündigung genannten Einführungsraten für Eingabe und Ausgabe sind daher zeitlich begrenzt und keine dauerhaften Preise. Die Preisgestaltung für zwischengespeicherte Eingaben entspricht einer Reduzierung von 95 % gegenüber dem jeweiligen Eingabepreis, gilt jedoch für berechtigte implizit zwischengespeicherte Eingaben; die Seite führt explizites Caching für dieses Modell nicht als unterstützt auf.
Token-Preise beschreiben zudem nicht zwingend die Gesamtkosten einer Anwendung. Separat abgerechnete Tools und wiederholte Anfragen eines Workflows können weitere Kosten verursachen. Eine Produktionsschätzung sollte daher das tatsächliche Anfrageverhalten und die aktuelle Dokumentation berücksichtigen.
Googles Dokumentation für Long Decode beschreibt ein einheitliches Limit von 1.048.576 Tokens, das zwischen Eingabe, Thinking und Ausgabe geteilt wird. Es ist kein Versprechen über eine Million Eingabe-Tokens plus weitere eine Million Tokens generierter Ausgabe.
Die Interactions API begrenzt synchrone oder gestreamte Ausgaben normalerweise auf 65.536 Tokens. Eine Generierung über dieses Limit hinaus erfordert gemäß Dokumentation den Hintergrundmodus, eine größere Einstellung für max_output_tokens sowie aktivierten Storage. Der Server führt die längere Generierung in Fortsetzungs-Hops aus.
Bei der Planung einer solchen Aufgabe sind zwei Details wichtig. Erstens umfasst max_output_tokens sowohl Thinking als auch die zurückgegebene Ausgabe. Zweitens können Fortsetzungs-Hops die Eingabe erneut zählen; der dokumentierte Rabatt für implizites Caching gilt, sofern berechtigt. Long Decode ist keine unbegrenzte, kostenlose Erweiterung einer einzelnen Anfrage.
Diese Fähigkeit kann bei einer langen Implementierung oder einer umfangreichen Analyse helfen, doch ein großes Ausgabebudget ist keine Korrektheitsgarantie. Das Ergebnis muss weiterhin geprüft werden, und die Eingabe verbraucht einen Teil desselben Gesamtbudgets.
Google berichtet über den Einsatz von Argon bei einem Refactoring, das Hunderte Dateien in Chrome umfasste. Die Codebasis wird mit ungefähr 40 Millionen Zeilen beschrieben, darunter ein Legacy-Bereich von etwa sechs Millionen Zeilen. Laut Google verkürzte sich die Arbeit von einer Aufgabe im Bereich von Monaten auf einen Zeitraum von Wochen. Dies sind von Google berichtete Projektergebnisse und kein allgemeines Versprechen für beliebige Änderungen an Repositories.
Der ADK-Engineering-Artikel liefert einen besser überprüfbaren Fall. Er betrifft ein Python-Repository mit rund 205.000 Zeilen in ungefähr 800 Quelldateien, das von einer großen öffentlichen Testsuite unterstützt wird.
Die Arbeit erfolgte in zwei Runden. Ein erster zweistündiger Versuch zeigte Schwächen auf; ein späterer Lauf über Nacht verwendete Projektskills und ein Antigravity-Ziel. Das Modell schlug sechs Optimierungen in 32 Dateien vor, doch die Maintainer behielten zwei bei und lehnten vier ab. Die schließlich zusammengeführte Arbeit kombinierte Änderungen aus beiden Runden in 22 Dateien und ergänzte 17 Testfunktionen.
Die akzeptierten Optimierungen betrafen das Filtern vor dem Kopieren von Daten im In-Memory-Session-Service sowie verzögerte Paketimporte. Der öffentlich zusammengeführte Commit stellt den resultierenden Code zur Prüfung bereit.
Der Benchmark ist nützlich, weil er mehrere Zeitmessungen trennt, statt eine einzelne Beschleunigung als universell darzustellen.
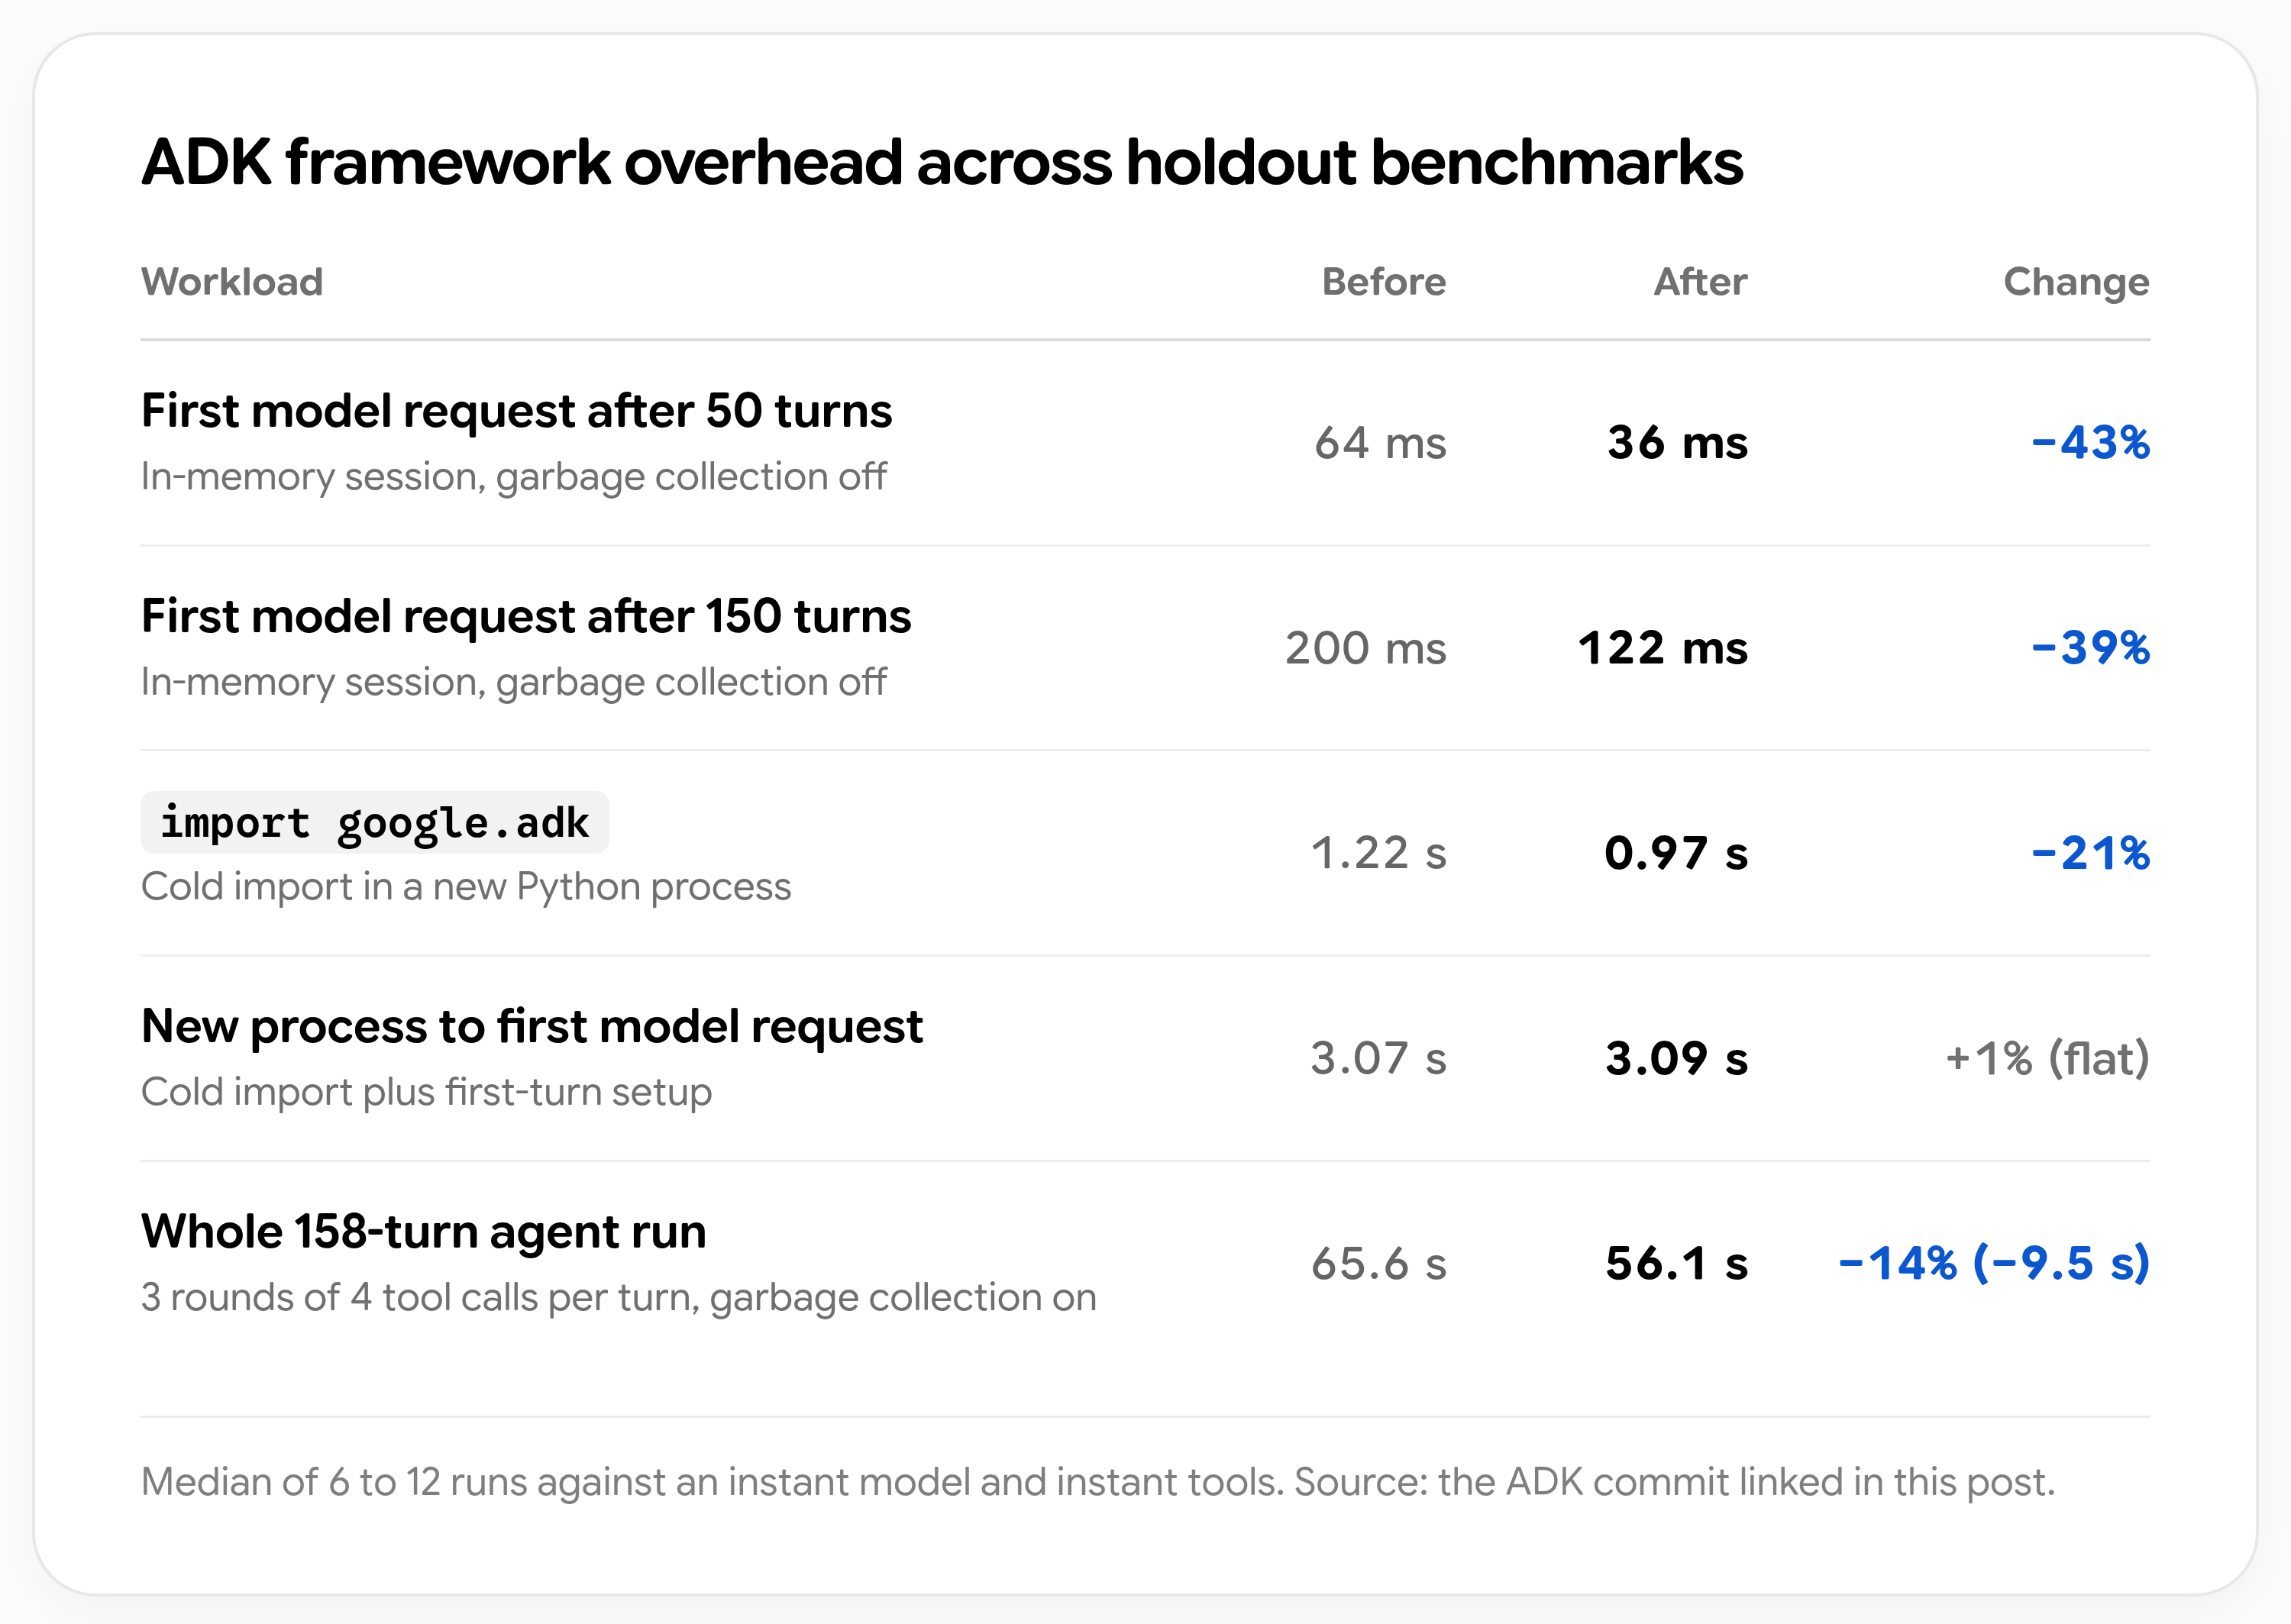
Quelle: Google Developers Blog, ADK-Optimierungsstudie. Die Messungen verwenden ein Instant-Modell und Tools zur Isolierung des Framework-Overheads, mit Medianwerten aus mehreren Durchläufen.
| Messung | Vorher | Nachher | Berichtete Veränderung |
|---|---|---|---|
| Erste Modellanfrage nach 50 Turns | 64 ms | 36 ms | 43 % schneller |
| Erste Modellanfrage nach 150 Turns | 200 ms | 122 ms | 39 % schneller |
| Kalter Import | 1,22 s | 0,97 s | 21 % schneller |
| Neuer Prozess bis zur ersten Anfrage | 3,07 s | 3,09 s | Praktisch unverändert |
| Gesamter Lauf über 158 Turns | 65,6 s | 56,1 s | 14 % schneller |
Der Gewinn von ungefähr 40 % betrifft einen Pfad zur Session-Vorbereitung im getesteten In-Memory-Service. Er sollte nicht so beschrieben werden, als mache er jede ADK-Anwendung um 40 % schneller – insbesondere nicht, wenn ein Deployment ein anderes Storage-Backend verwendet oder den Großteil seiner Zeit auf Modell- und Tool-Antworten wartet.
Kalte Importe verbesserten sich, die Zeit vom neuen Prozess bis zur ersten Anfrage jedoch nicht. Dies ist eine praktische Erinnerung daran, den für Nutzer sichtbaren Workflow zu messen, statt anzunehmen, dass eine lokale Optimierung jede End-to-End-Kennzahl verbessert.
Die vorgeschlagene Änderung bestand alle 16.892 öffentlichen Unit-Tests. Dennoch schlugen 25 interne Testziele fehl, weil erwartet wurde, dass entfernte Importe weiterhin patchbar bleiben. Die Maintainer stellten die Kompatibilität mit Lazy Accessors her, statt einen erfolgreichen öffentlichen Testlauf als ausreichenden Sicherheitsnachweis zu behandeln.
Andere vorgeschlagene Änderungen wurden unter anderem wegen veralteter Cache-Daten, einer Abhängigkeit von einem privaten OpenTelemetry-Attribut, geringerer Lesbarkeit ohne End-to-End-Vorteil und einer Optimierung abgelehnt, deren Gewinn nur in einer synthetischen Arbeitslast sichtbar war.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Damit ist das Beispiel nützlicher als eine Erfolgsgeschichte über unbeaufsichtigtes Coding. Das Modell erzeugte Verbesserungskandidaten; Maintainer bewerteten die Evidenz, lehnten ungeeignete Patches ab und behoben ein Kompatibilitätsproblem, bevor die akzeptierte Arbeit zusammengeführt wurde.
Google berichtet außerdem über eine Optimierung der Gemma-4-E2B-Inferenz mit vLLM auf einer NVIDIA A100. In diesem konkreten Setup stieg der Durchsatz von 37.900 auf 108.000 Tokens pro Sekunde, was bei Token-Parität einer berichteten Verbesserung um das 2,85-Fache entspricht.
Dies ist ein konfigurationsspezifisches Ergebnis. Es belegt nicht dieselbe Beschleunigung für ein anderes Modell, eine andere GPU, ein anderes Batch-Muster oder einen anderen Deployment-Stack und sollte nicht mit Preis oder Latenz einer gehosteten Argon-API-Anfrage verwechselt werden.
Zu den kreativen Demonstrationen des Launches gehören ein dreidimensionaler Tempel, der mit Blender und visueller Kritik erstellt wurde, sowie ein von einem Schreibtischfoto inspiriertes Rennspielerlebnis, das mit mehreren Tools zusammengesetzt wurde. Letzteres kombiniert Blender MCP, generierte Texturen, Three.js und zusätzliche Medienfunktionen. Das fertige Artefakt ist daher ein Workflow-Ergebnis und kein Beleg dafür, dass ein einzelner Plain-Text-Aufruf jedes Asset ohne weitere Unterstützung erstellt.
Diese Beispiele zeigen, welche Arten von Projekten Google Entwickler ausprobieren lassen möchte. Sie ersetzen keine direkte Prüfung von generiertem Code, physikalischem Verhalten, Asset-Lizenzen oder Browser-Performance.
Der Launch reicht über Softwareentwicklung hinaus in mehrere Forschungsbereiche. Jedes Ergebnis adressiert ein engeres Problem, als es der Name des jeweiligen Fachgebiets vermuten lassen könnte.
Die Robotik-Demonstration folgt demselben Muster. Googles Apollo-Roboter beobachtet einen Menschen beim Cornhole-Spiel, erstellt eine Simulation und erzielt anschließend in der berichteten Demonstration sieben aufeinanderfolgende reale Treffer. Das ist Evidenz für den gezeigten Durchlauf, keine Zuverlässigkeitsschätzung für beliebige Roboter, Umgebungen oder physische Aufgaben.
Google erklärt, dass interne Code-Einreichungen um 35 % gestiegen und Rollback-Raten um etwa ein Drittel gesunken seien. Dies sind unternehmensseitig berichtete interne Werte; der Launch-Artikel stellt sie nicht als kontrollierte Vorhersage dafür dar, was eine andere Organisation erreichen wird.
Der ADK-Fall bietet einen praktischeren Weg, die übergeordnete Aussage zu bewerten. Beginnen Sie mit einer Aufgabe, deren Ausgangswert messbar ist, behalten Sie Tests und Kompatibilitätsprüfungen bei und bewerten Sie den final akzeptierten Patch. Auch die Zeit für Prüfung und Nachbesserung einer Änderung gehört zum Ergebnis.
Für Forschungsarbeit lautet die entsprechende Frage, ob die Ausgabe die relevante Fachprüfung besteht: einen Beweis, ein Laborexperiment, eine unabhängige Berechnung oder eine sorgfältig konzipierte Evaluation. Eine plausible Erklärung des Modells ist nur eine Stufe dieses Prozesses.
Die am 15. Oktober 2026 geprüfte AI-Studio-Preisseite führt keine kostenlose Stufe für gemini-4-argon auf. Consumer-Abonnementzugang und Entwickler-API-Zugang unterliegen unterschiedlichen Bedingungen. Daher sollte nicht angenommen werden, dass eine Google-AI-Pro-Consumer-Funktion das API-Modell einschließt.
Die dokumentierten Standard-Einführungspreise betragen bis zum 30. November 2026 2 $ pro einer Million Eingabe-Tokens und 10 $ pro einer Million Ausgabe-Tokens einschließlich Thinking. Ab dem 1. Dezember nennt die Seite jeweils 4 $ und 20 $; berechtigte implizit zwischengespeicherte Eingaben werden separat bepreist, und Tool-Gebühren können die Gesamtkosten erhöhen.
Nein. Google dokumentiert ein gemeinsames Budget von 1.048.576 Tokens für Eingabe, Thinking und Ausgabe. Eine längere Eingabe lässt daher weniger Raum für die anderen Teile der Interaktion.
Die Long-Decode-Dokumentation erfordert Hintergrundmodus, Storage und einen max_output_tokens-Wert oberhalb des üblichen Limits. Fortsetzungs-Hops unterliegen weiterhin dem gemeinsamen Budget und dem dokumentierten Abrechnungsverhalten. Anwendungen sollten daher die aktuellen Anweisungen der Interactions API befolgen.
Nein. Das Ergebnis von ungefähr 40 % betrifft einen spezifischen Pfad zur In-Memory-Session-Vorbereitung in Googles Benchmark. Der vollständige Lauf über 158 Turns verbesserte sich um 14 %, während die Zeit vom neuen Prozess bis zur ersten Anfrage praktisch unverändert blieb.
Nein. Die berichteten Ergebnisse betreffen definierte Forschungsprobleme und Demonstrationen. Sie benötigen angemessene unabhängige Validierung, fachliche Prüfung und Deployment-Tests, bevor sie auf klinische, industrielle oder physische Anwendungen verallgemeinert werden.
Gemini 4 Argon bringt eine breite Palette berichteter Fähigkeiten in den Bereichen Code, visuelle Projekte und Forschung. Zu den unmittelbar relevanten praktischen Details gehören kostenpflichtiger Entwicklerzugang, Einführungspreise, die nach November enden, sowie ein gemeinsames Kontextbudget, das Thinking und Ausgabe einschließt.
Die stärkste Engineering-Evidenz liefern die akzeptierten, getesteten ADK-Änderungen und ihre messbaren Grenzen; menschliche Prüfung bleibt Teil des Ergebnisses.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



