For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/glm-5-3-highspeed-in-zcode-490-tps-test-1-df8d564e.md.
Ein neuer Modellname von Z.ai ist still und leise in ZCode aufgetaucht: **GLM-5.3 Highspeed**.
Ein neuer Modellname von Z.ai ist still und leise in ZCode aufgetaucht: GLM-5.3 Highspeed.
Das Modell erschien in ZCode 3.15.1, wo einige Abonnenten zufällig für einen HighSpeed-Test ausgewählt werden. Ein Nutzer, @leo114119, veröffentlichte einen Lauf mit einer Ausgabegeschwindigkeit von fast 490 Token pro Sekunde; ein weiterer Screenshot zeigt ungefähr 493 Tok/s.
Das ist eine bemerkenswerte Zahl.
Wenn ein Modell 490 Ausgabetoken pro Sekunde dauerhaft erreichen könnte, würde die Generierung von 10.000 Ausgabetoken nur etwa folgende Zeit beanspruchen:
10.000 / 490 ≈ 20,4 Sekunden
Diese Berechnung umfasst nur die Token-Generierungsphase. Sie berücksichtigt weder die Zeit bis zum ersten Token, internes Reasoning vor der sichtbaren Ausgabe, Tool-Aufrufe, Netzwerklatenz noch Pausen innerhalb eines Agenten-Workflows.
Noch wichtiger: Das Ergebnis von 490 TPS ist derzeit eine Community-Beobachtung und keine offizielle Durchsatzgarantie von Z.ai.
Bestätigt ist, dass ZCode 3.15.1 einen zufälligen GLM-HighSpeed-Test für Abonnenten eingeführt hat und dass der Bezeichner glm-5.3-highspeed bereits in Pis öffentlichem Modellkatalog vorhanden ist.
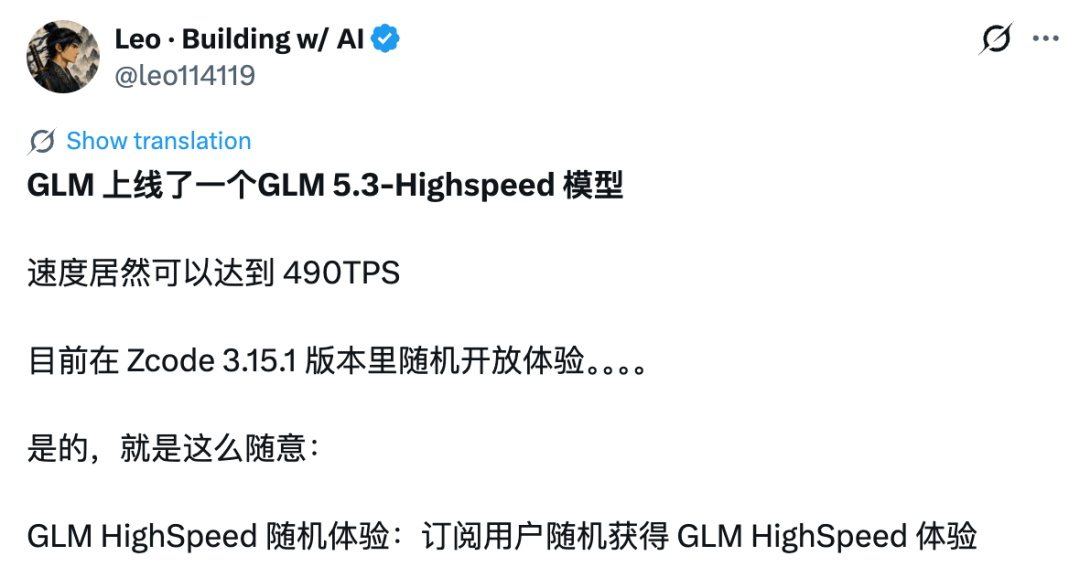
Der erste Hinweis ist nicht nur ein Social-Media-Screenshot.
In den offiziellen Release Notes von ZCode für Version 3.15.1 heißt es:
Abonnenten können jetzt zufällig für einen GLM-HighSpeed-Test ausgewählt werden.
Diese Formulierung ist relevant, weil sie erklärt, weshalb der Zugriff von Konto zu Konto unterschiedlich ist.
Der Quellartikel berichtet, dass der Autor versuchte, GLM-5.3 Highspeed manuell hinzuzufügen und zu aktivieren, es jedoch mit einem Lite-Abonnement nicht nutzen konnte.
Die Benutzeroberfläche zeigte, dass das Modell existierte, der aktuelle Tarif jedoch keinen Zugriff einschloss.
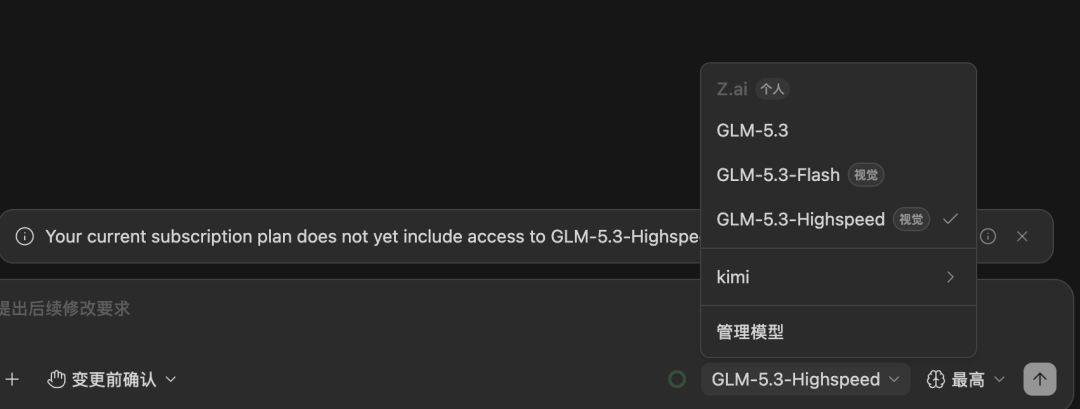
Das entspricht der aktuellen Rollout-Strategie von ZCode:
Update auf ZCode 3.15.1
        ↓
Abonnentenkonto
        ↓
Zufällige Berechtigung für den HighSpeed-Test
        ↓
Testzugriff erscheint im Client, wenn das Konto ausgewählt wurde
Derzeit wird dies nicht als Funktion beschrieben, die für jede kostenpflichtige Tarifstufe automatisch verfügbar ist.
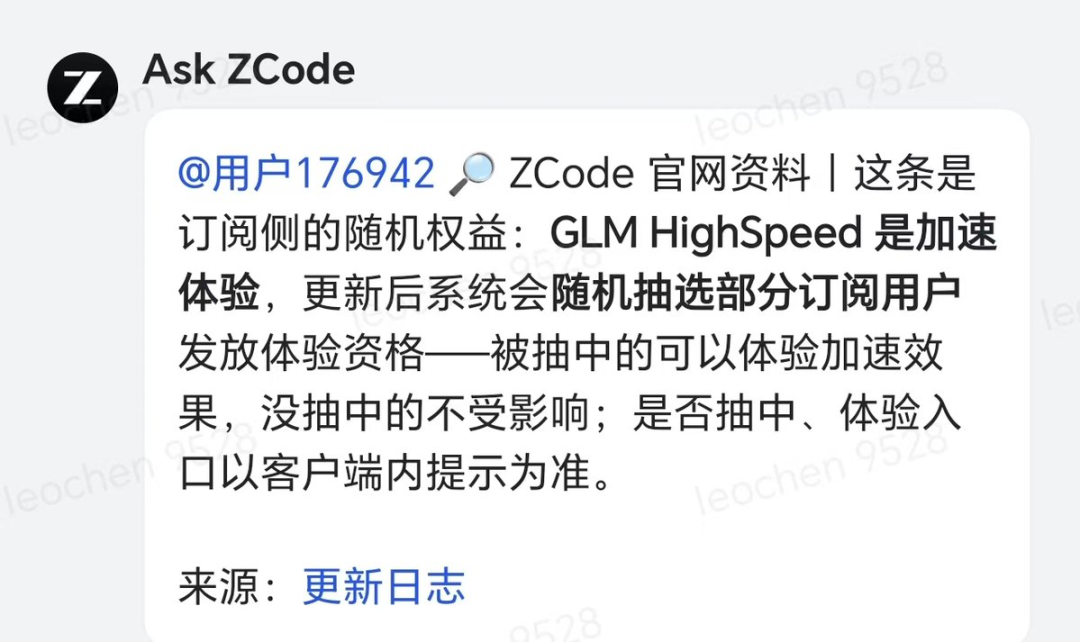
Ein Community-Screenshot, der die eigene Formulierung von ZCode zusammenfasst, betont denselben Punkt: Die HighSpeed-Erfahrung ist ein zufällig zugewiesener Vorteil für Abonnenten, und der Client ist die maßgebliche Quelle dafür, ob ein bestimmtes Konto ausgewählt wurde.
Der wichtigste Grund für die Aufmerksamkeit rund um das Modell ist der Geschwindigkeitsscreenshot.
Der Quellnutzer veröffentlichte einen Lauf mit etwa 493 Tok/s.
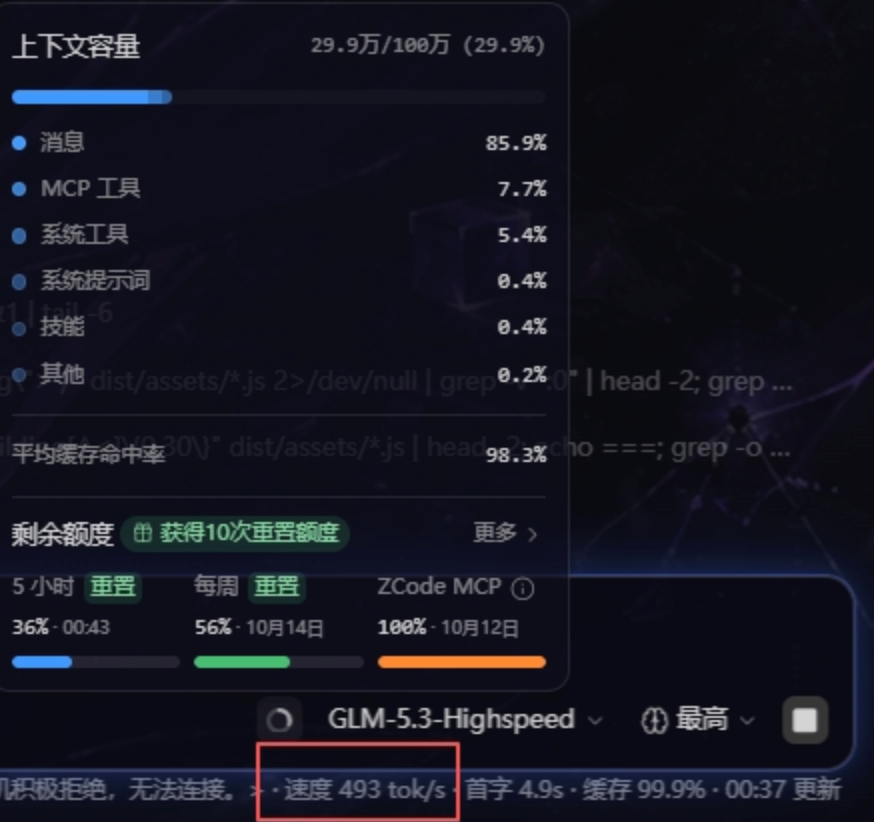
Das liegt der Schlagzeilenzahl von 490 TPS so nahe, dass der Unterschied nicht aussagekräftig ist.
Es ist jedoch sinnvoll, genau zu unterscheiden, was dieser Screenshot aussagt und was nicht.
GLM-5.3-Highspeed.Der Durchsatz kann stark abhängen von:
Die richtige Schlussfolgerung lautet daher derzeit:
GLM-5.3 Highspeed hat in mindestens einem öffentlichen ZCode-Test einen sehr hohen Ausgabedurchsatz demonstriert, aber Z.ai hat bislang keine formale Spezifikation von 490 TPS veröffentlicht.
Die Zahl sticht heraus, weil die GLM-Familie bereits mehrere geschwindigkeitsorientierte Serving-Optionen bietet.
Die Dokumentation von Z.ai besagt, dass GLM-5.3-FlashX bis zu 200 Token/s erreichen kann. FlashX ist die Highspeed-Serving-Variante von GLM-5.3-Flash.
Die Dokumentation von Pi und Z.ai führt GLM-5.3-Flash mit einem Kontextfenster von 1 Mio. Token und einer maximalen Ausgabe in der 128K-Klasse auf, während FlashX auf geringere Serving-Latenz und schnellere Generierung ausgerichtet ist.
Der Originalartikel verweist außerdem auf eine Messung von Artificial Analysis mit ungefähr 60 Token/s für GLM-5.3-Flash über die First-Party-API von Z.ai zum Zeitpunkt der Erstellung.
Unabhängige Durchsatzmessungen ändern sich im Zeitverlauf, und spätere Momentaufnahmen unterschieden sich je nach Anbieter und Datum deutlich. Eine einzelne Zahl sollte daher nicht als dauerhaft angesehen werden.
Ein hilfreicher Vergleich lautet daher:
| Modell / Serving-Pfad | Berichtete oder dokumentierte Geschwindigkeit | Status |
|---|---|---|
| GLM-5.3 Highspeed in ZCode | ~490–493 Tok/s in einem Nutzerscreenshot | Community-Beobachtung / zufälliger Test |
| GLM-5.3-FlashX | Bis zu 200 Tok/s | Öffentlich dokumentierte geschwindigkeitsorientierte Variante |
| GLM-5.3-Flash über die Z.ai-API | Deutlich niedriger in unabhängigen First-Party-Momentaufnahmen | Unabhängige Messung variiert nach Datum/Anbieter |
Die Lücke ist groß genug, dass sich natürlich die Frage stellt, was „Highspeed“ tatsächlich bedeutet.
glm-5.3-highspeed bereits aufDer Modellname erschien nicht nur in ZCode.
Der öffentliche Modellkatalog von Pi hat bereits eine Seite für GLM-5.3 Highspeed.
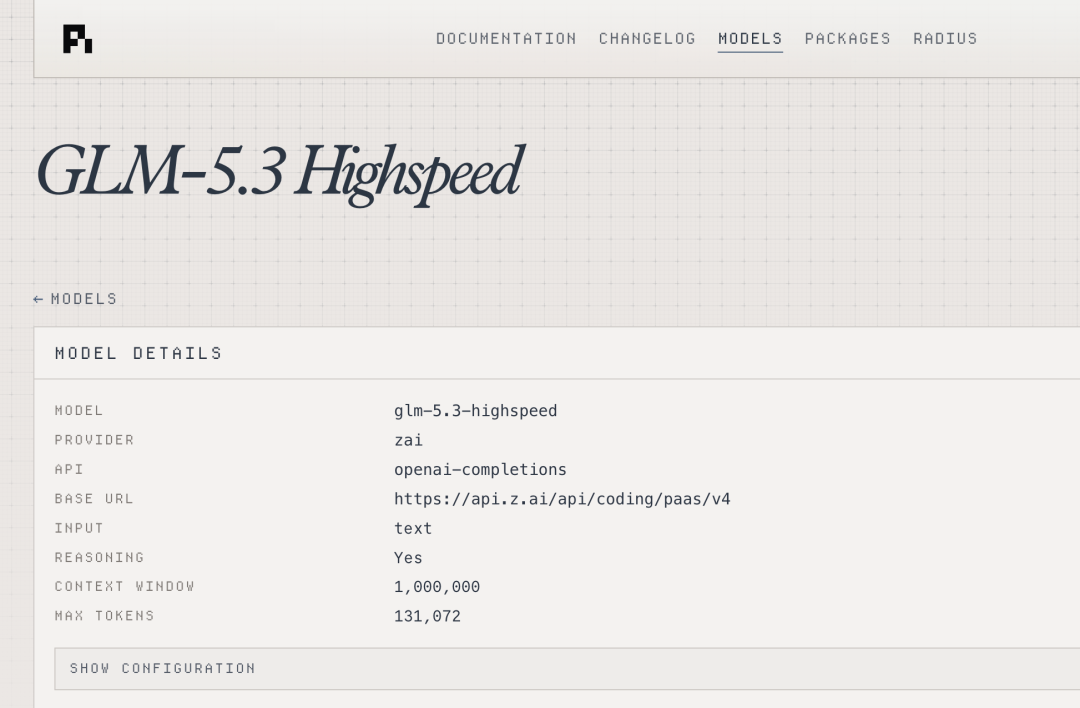
Die aufgeführte Konfiguration lautet:
| Feld | Wert |
|---|---|
| Modell-ID | glm-5.3-highspeed |
| Anbieter | zai |
| API-Stil | OpenAI-kompatible Completions |
| Eingabe | Text |
| Reasoning | Ja |
| Kontextfenster | 1.000.000 Token |
| Maximale Ausgabe | 131.072 Token |
| Reasoning-Stufen | niedrig / hoch / maximal |
Der von Pi angezeigte Endpunkt lautet:
https://api.z.ai/api/coding/paas/v4
Pi ordnet das Modell außerdem dem Coding-API-Format von Z.ai zu.
Zwei Details sind besonders bemerkenswert.
Das entspricht der Langkontext-Konfiguration, die in aktuellen Tools der GLM-5.3-Familie zu sehen ist.
Für Coding-Agenten kann ein Kontext von 1 Mio. Token nützlich sein für:
Das entspricht ungefähr 128K Token.
Auch dies passt zur aktuellen Lang-Ausgabe-Konfiguration mehrerer Einträge der GLM-5.3-Familie.
Der Pi-Eintrag deutet daher nicht auf eine offensichtlich andere Kontextarchitektur im Vergleich zur normalen GLM-5.3-Linie hin.
Er bestätigt vor allem, dass der Highspeed-Bezeichner real genug ist, um über eine strukturierte Anbieterkonfiguration zu verfügen.
Pi ordnet drei aktive Reasoning-Einstellungen zu:
niedrig
hoch
maximal
Der Quellartikel weist darauf hin, dass diese Einstellungen auch aus der regulären GLM-5.3-Konfiguration bekannt sind.
Das liefert einen weiteren Grund, nicht davon auszugehen, dass Highspeed ein vollständig neues Basismodell ist.
Es könnte sich handeln um:
Ohne eine Modellkarte von Z.ai lassen sich diese Möglichkeiten noch nicht zuverlässig voneinander trennen.
Der Name allein reicht nicht aus.
An dieser Stelle wird die Geschichte spekulativ.
Bevor die ZCode-Screenshots erschienen, hatten Reddit-Nutzer glm-5.3-highspeed bereits im Pi-Katalog entdeckt und gefragt, ob es mit Omen Alpha verbunden sein könnte.
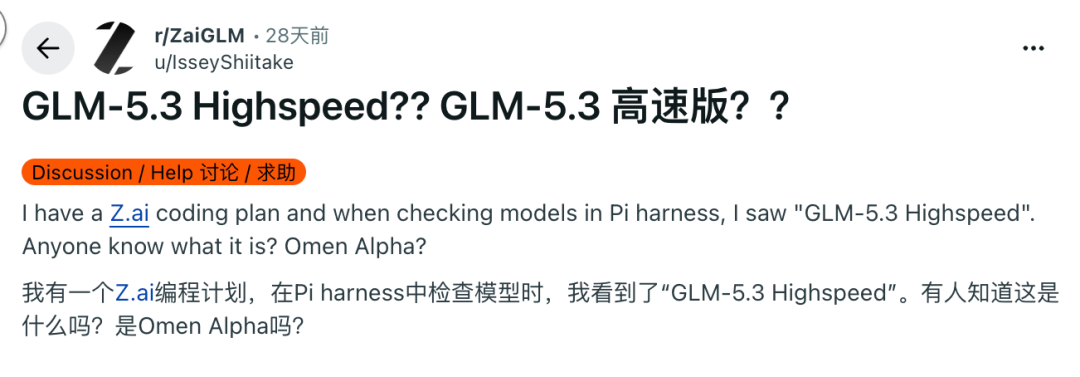
Omen Alpha ist ein anonymes Modell, das in OpenCode-Tests auftauchte.
Community-Mitglieder hatten es aufgrund beobachteten Verhaltens und Hinweisen aus der Infrastruktur bereits mit Zhipu/Z.ai in Verbindung gebracht.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Eine Reddit-Antwort spekulierte, dass es sich um eine neue Highspeed-GLM-Variante mit einer Qualität nahe GLM-5.3-Flash, aber deutlich höherem Durchsatz handeln könnte.
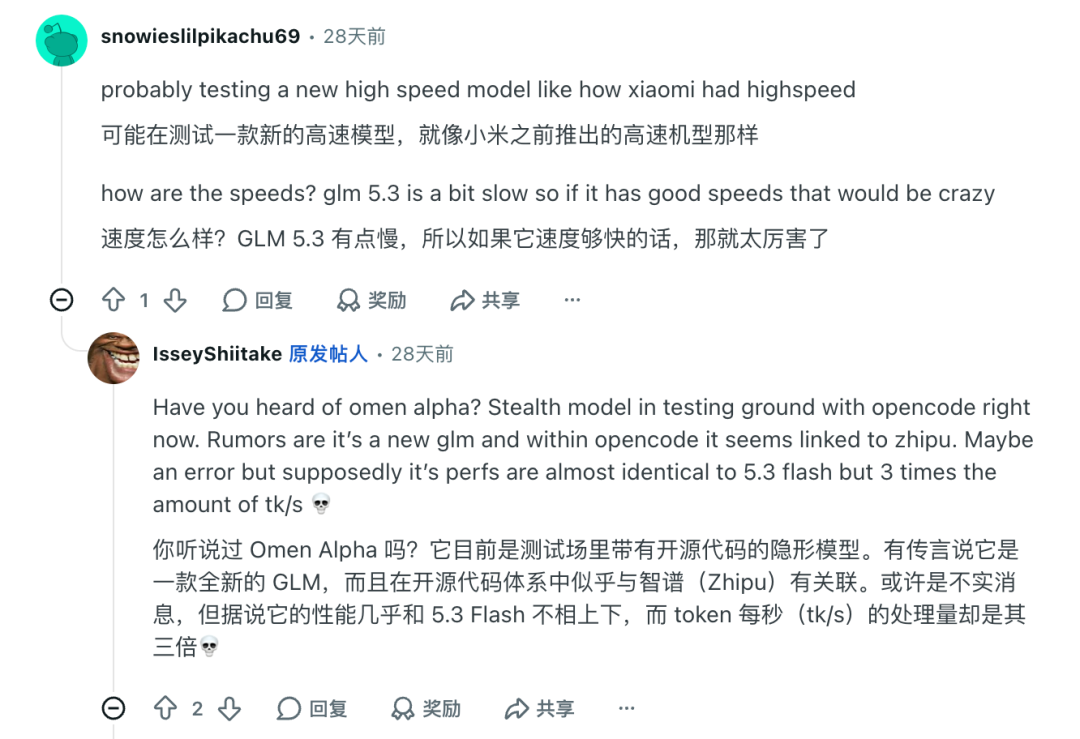
Ein weiterer Screenshot aus einer Quelle zeigt einen omen-alpha-Modelleintrag, der mit einer Zhipu-bezogenen Anbieterbezeichnung verbunden ist, was die Theorie weiter befeuerte.
Nichts davon belegt die Identität jedoch abschließend.
Der Originalartikel nennt mehrere Vermutungen:
Diese Namen sollten als Community-Spekulation betrachtet werden, bis Z.ai eine offizielle Zuordnung veröffentlicht.
Zwei Endpunkte können sich sehr ähnlich anfühlen, obwohl sie nicht dasselbe Modell sind.
Das beobachtete Verhalten kann beeinflusst werden durch:
Verhaltensähnlichkeit ist daher ein Indiz, aber kein Beweis.
Der Name selbst ist für Zhipu nicht ungewöhnlich.
Das Unternehmen hat bereits Highspeed-Versionen von GLM-Modellen veröffentlicht.
Der Quellartikel verweist auf GLM-5.1-highspeed, das im Mai 2026 mit einer Ausgabegeschwindigkeit von rund 400 Token/s beworben wurde.
Die neuere GLM-5.3-Familie umfasst außerdem FlashX, eine öffentlich verfügbare geschwindigkeitsorientierte Variante, die mit bis zu 200 Token/s dokumentiert ist.
Dies deutet auf ein breiteres Produktmuster hin:
Basis- oder Flaggschiffmodell
        ↓
Highspeed-Serving-Pfad
        ↓
Geringere Latenz / höherer Durchsatz für interaktive Workloads
Dieses Muster macht ein GLM-5.3-Highspeed-Produkt technisch plausibel, ohne neue Modellgewichte vorauszusetzen.
Das bleibt eine Schlussfolgerung, keine offizielle Produktbeschreibung.
Warum sind 490 TPS überhaupt relevant?
Bei einer kurzen Antwort mit 200 Token beträgt der Unterschied zwischen 100 TPS und 500 TPS nur einige Sekunden.
Bei langen Agentenausgaben, Codegenerierung oder umfangreichem Reasoning wird der Unterschied deutlich größer.
Zum Beispiel:
| Ausgabelänge | 100 Tok/s | 200 Tok/s | 490 Tok/s |
|---|---|---|---|
| 1.000 Token | 10,0 s | 5,0 s | ~2,0 s |
| 5.000 Token | 50,0 s | 25,0 s | ~10,2 s |
| 10.000 Token | 100,0 s | 50,0 s | ~20,4 s |
Dies sind ausschließlich vereinfachte Berechnungen der Decodierzeit.
Reale Agentenaufgaben umfassen außerdem:
Schnelleres Decodieren kann lange iterative Workflows dennoch deutlich reaktionsfähiger machen.
Das ist besonders bei Coding-Agenten wie ZCode relevant, bei denen eine Nutzeranfrage mehrere Modellaufrufe statt nur einer finalen Antwort erzeugen kann.
Der Screenshot mit ~493 Tok/s zeigt außerdem eine extrem hohe Cache-Trefferquote.
Das ist bemerkenswert.
Eine hohe Cache-Trefferquote kann den Umfang wiederholter Prompt-Verarbeitung in langen Agentensitzungen reduzieren.
Eine typische Coding-Sitzung kann wiederholt Folgendes mitführen:
Systemanweisungen
+ Repository-Kontext
+ Tool-Definitionen
+ vorherige Unterhaltung
+ aktuelle Diffs
Wenn ein großer Teil dieses Kontexts effizient wiederverwendet wird, muss das System bei jeder Runde weniger auf der Eingabeseite neu berechnen.
Die angezeigte Tok/s-Zahl bezieht sich jedoch in der Regel auf den Durchsatz der Ausgabeerzeugung und nicht allein auf den Prompt-Cache-Durchsatz.
Die Cache-Zahl ist trotzdem wichtig, weil die Gesamtlatenz der Sitzung deutlich besser wirken kann, wenn Prompt-Wiederverwendung und schnelles Decodieren gemeinsam gut funktionieren.
Das ist ein weiterer Grund, weshalb ein Screenshot das Modell nicht vollständig charakterisieren kann.
GLM-5.3-FlashX bietet den klarsten öffentlichen Vergleich, weil die Dokumentation von Z.ai es bereits als geschwindigkeitsorientiertes Modell beschreibt.
Zu den aktuell veröffentlichten Informationen über FlashX gehören:
glm-5.3-flashx.FlashX zeigt daher, dass Z.ai bereits bereit ist, dedizierte Varianten mit hohem Durchsatz zu entwickeln, ohne sie als vollständig neue Intelligenzgenerationen zu präsentieren.
GLM-5.3 Highspeed könnte derselben Produktlogik in einer noch schnelleren Serving-Stufe folgen.
Dies bleibt eine Schlussfolgerung und keine offizielle Produktbeschreibung.
Die derzeitigen Belege lassen sich in drei Vertrauensstufen einteilen.
glm-5.3-highspeed als Z.ai-Modell auf.Diese Unterscheidung ist die sicherste Art, den aktuellen Rollout zu interpretieren.
GLM-5.3 Highspeed ist ein Modellbezeichner von Z.ai, der in ZCode und im öffentlichen Modellkatalog von Pi aufgetaucht ist. ZCode 3.15.1 bestätigt offiziell einen zufälligen GLM-HighSpeed-Test für Abonnenten, aber Z.ai hat in den hier geprüften Quellen noch keine vollständige eigenständige Modellkarte für GLM-5.3 Highspeed veröffentlicht.
Ein öffentlicher Nutzerscreenshot zeigt in einem ZCode-Lauf ungefähr 493 Tok/s; darauf basiert die Schlagzeile mit 490 TPS. Dies ist eine nützliche Beobachtung, aber keine offizielle Garantie für dauerhaft erreichten Durchsatz. Die Leistung kann je nach Workload, Cache-Verhalten, Region und Serverbedingungen variieren.
Pi führt derzeit ein Kontextfenster mit 1.000.000 Token und eine maximale Ausgabe von 131.072 Token für glm-5.3-highspeed auf. Diese Werte ähneln der Langkontext-Konfiguration anderer aktueller Modelle der GLM-5.3-Familie.
Nein. Im offiziellen Changelog von ZCode v3.15.1 heißt es, dass Abonnenten zufällig für den GLM-HighSpeed-Test ausgewählt werden. Wenn Ihr Konto nicht ausgewählt wurde, bedeutet die Sichtbarkeit des Modellnamens nicht zwangsläufig, dass Sie ihn ausführen können.
Es gibt keine offizielle Bestätigung, dass beide Produkte identisch sind. FlashX ist eine öffentlich verfügbare Highspeed-Variante von GLM-5.3-Flash, die mit bis zu 200 Tok/s dokumentiert ist, während GLM-5.3 Highspeed derzeit über ZCode-Tests und Pis Katalog für Coding-Anbieter erscheint.
Das bleibt Spekulation. Reddit- und OpenCode-Nutzer haben Omen Alpha mit Zhipu/Z.ai in Verbindung gebracht, aber keine offizielle Quelle bestätigt, dass Omen Alpha glm-5.3-highspeed zugeordnet ist.
Coding-Agenten führen oft mehrere lange Modellaufrufe aus, während sie Dateien lesen, Patches schreiben, Tools ausführen und Ergebnisse prüfen. Ein höherer Decodierdurchsatz kann die Wartezeit zwischen diesen Schritten verringern, insbesondere wenn das Modell pro Aufruf Tausende Token erzeugt.
Nutzen Sie den aktuellen ZCode-Client, nachdem Sie auf eine Version mit dem Test aktualisiert haben. In den eigenen Release Notes von ZCode heißt es, dass der Zugriff zufällig Abonnenten zugewiesen wird. Die Konto- und Client-Oberfläche ist daher die praktische maßgebliche Quelle für die Berechtigung.
glm-5.3-highspeed offenlegt.GLM-5.3 Highspeed ist nicht länger nur ein vereinzelter Modellname: ZCode 3.15.1 bestätigt offiziell einen zufällig zugewiesenen GLM-HighSpeed-Test für Abonnenten, und Pi stellt bereits eine strukturierte glm-5.3-highspeed-Konfiguration mit einem Kontextfenster von 1 Mio. Token und einem Ausgabelimit von 131.072 Token bereit.
Die auffällige Zahl von 490–493 Tok/s stammt aus einem realen öffentlichen Screenshot, bleibt aber eine Nutzerbeobachtung und keine formale Durchsatzgarantie von Z.ai. Die vorsichtigste Interpretation ist, dass Z.ai einen sehr schnellen Serving-Pfad für Coding testet und die vollständige Produktspezifikation noch nicht veröffentlicht hat.
Die Verbindung zu Omen Alpha ist weiterhin ungeklärt. Möglicherweise stellt sich eine Beziehung heraus, doch die aktuellen Hinweise sind indirekt und von der Community getrieben, nicht offiziell.
Heute bestätigt sind der Rollout und der Modellbezeichner; noch nicht bestätigt sind die genaue Architektur, öffentliche Preise, dauerhafter Durchsatz und die Frage, ob Omen Alpha dasselbe Modell ist.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



