For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/glm-legal-explained-harvey-lab-scores-leg-ebeccf7b.md.
Z.ai hat GLM-Legal vorgestellt, ein spezialisiertes Modell für Aufgaben wie Vertragsprüfung, die Verknüpfung von Beweismitteln und Complianc...
Z.ai hat GLM-Legal vorgestellt, ein spezialisiertes Modell für Aufgaben wie Vertragsprüfung, die Verknüpfung von Beweismitteln und Compliance-Recherchen. Der Schwerpunkt liegt auf dem Weg von Ausgangsmaterialien zu einem verwendbaren Entwurf – nicht darauf, eine isolierte Frage zu einem Rechtsbegriff zu beantworten.
Der vorliegende Bericht hebt Spitzenplätze unter den Modellen mit offenen Gewichten bei zwei juristischen Benchmarks hervor. Aussagekräftiger als die Schlagzeile sind die zugrunde liegenden Zahlen: Rund 19,2 % der Aufgaben wurden beim Harvey Legal Agent Benchmark vollständig bestanden, beim LegalBench lag die Genauigkeit bei 86,23 %.
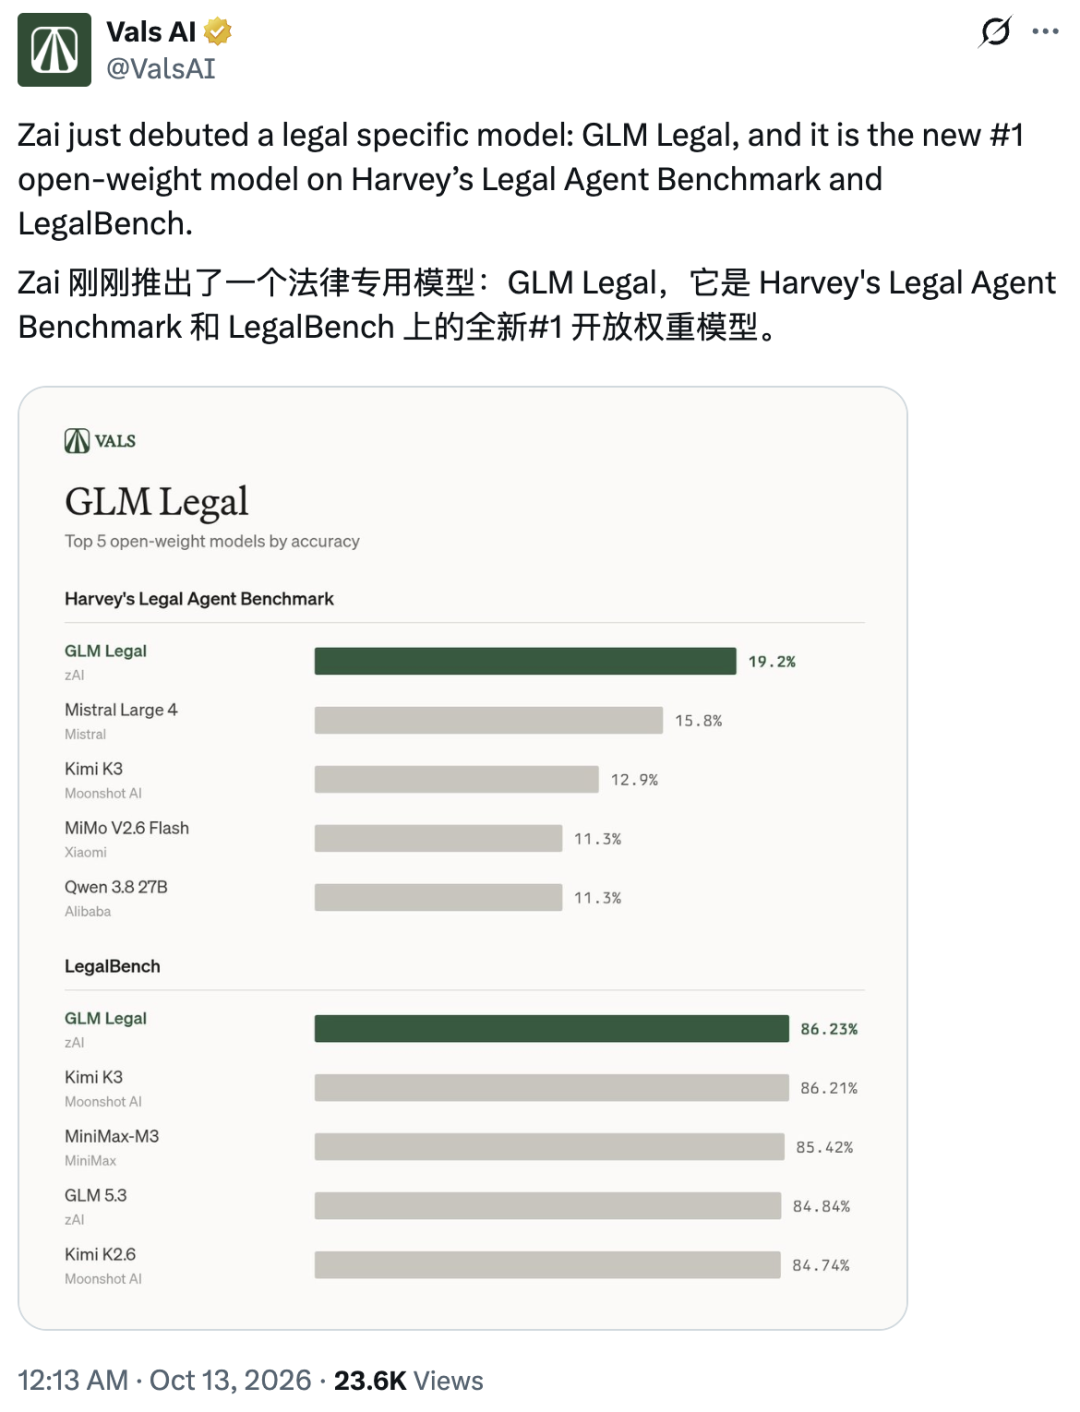
Diese Prozentwerte messen unterschiedliche Dinge. Sie belegen weder, dass das Modell für jede Rechtsordnung das beste System ist, noch, dass es eigenständig die Verantwortung für einen Rechtsfall übernehmen kann.
Die offizielle Ankündigung beschreibt Bewertungen komplexer Ausführung, spezialisierten juristischen Denkens und praxisnaher juristischer Arbeitsabläufe. Die Ergebnisse zur chinesischen Rechtspraxis basieren auf PLawBench; weitere Beispiele betreffen englischsprachige Materialien und grenzüberschreitende Datenschutzfragen.
Dieser Umfang beantwortet eine naheliegende Frage zum Modell: Es wird nicht als ausschließlich englischsprachiger juristischer Chatbot vorgestellt. Das bedeutet jedoch nicht, dass jede Ausgabe aktuell oder in jedem Land anwendbar ist. Ob ein Entwurf nützlich ist, hängt weiterhin vom maßgeblichen Recht, den Fakten, dem Zeitpunkt und der fachlichen Prüfung ab.
Die erste Demonstration betrifft einen Kunden, der seinen Softwaredienstleister wechselt. Die Aufgabe besteht darin, die Kündigungs- und Übergabeklauseln zu prüfen, damit der Kunde Materialien zurückerhält und das Projekt weiterführen kann.
Im Vergleich zur Antwort des Basismodells GLM-5.3-Flash schlägt das spezialisierte Modell konkretere Änderungen vor. In diesem Beispiel empfiehlt es, die Kündigungsfrist bei einer ordentlichen Kündigung von 60 auf 30 Tage zu verkürzen, die Nachbesserungsfrist für bestimmte schwerwiegende Vertragsverletzungen zu streichen und bis zu 90 Tage Übergangsunterstützung hinzuzufügen.
Außerdem verknüpft es die vorgeschlagene Rückgabe von Arbeitsergebnissen mit den bestehenden Vertragsbestimmungen zum Eigentum an Arbeitsergebnissen. Dabei berücksichtigt es auch unfertige und unbezahlte Arbeiten und nicht nur fertiggestellte, bezahlte Leistungen. Der Umfang der Übergabe umfasst Quellcode, Dokumentation, Daten und Wissenstransfer.
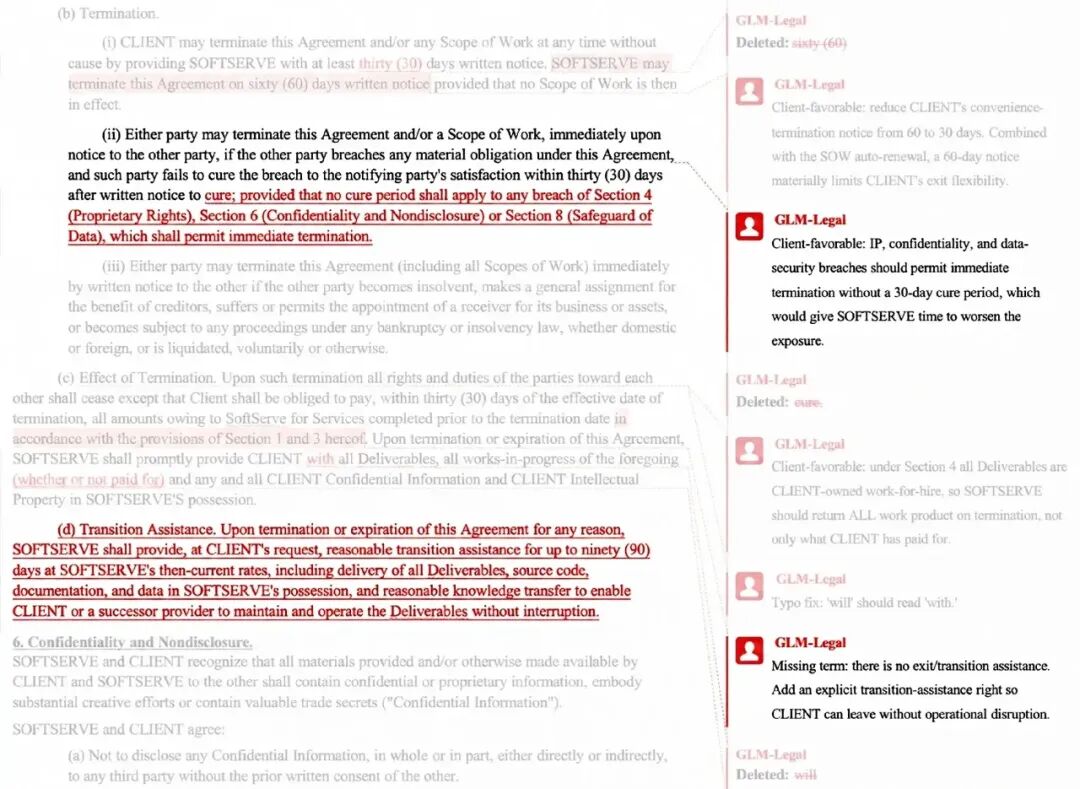
Dies sind vorgeschlagene Verhandlungspositionen für den vorgelegten Vertrag. Eine Kündigungsfrist von 30 Tagen oder eine Übergabe über 90 Tage ist keine allgemeine rechtliche Vorgabe. Ob diese Bedingungen geeignet sind, hängt vom Vertrag, der Position des Kunden, der Preisgestaltung und dem anwendbaren Recht ab.
In der zweiten Demonstration erhält der Agent 40 Dokumente zu einem Streit über ein Softwareprojekt. Ein Fortschrittsbericht für den Kunden beschreibt das Projekt als zu 60 % abgeschlossen, während eine interne Momentaufnahme einen Fertigstellungsgrad von etwa 41 % ausweist.
Sowohl das Basis- als auch das spezialisierte Modell erkennen diese Abweichung. GLM-Legal geht weiter und verknüpft den Fortschrittsbericht mit einer früheren Warnung zum Meilenstein, internen Anweisungen zu Offenlegung und Rechnungsstellung sowie Vertragsbestimmungen zu Zahlungen und fortgeltenden Rechten.
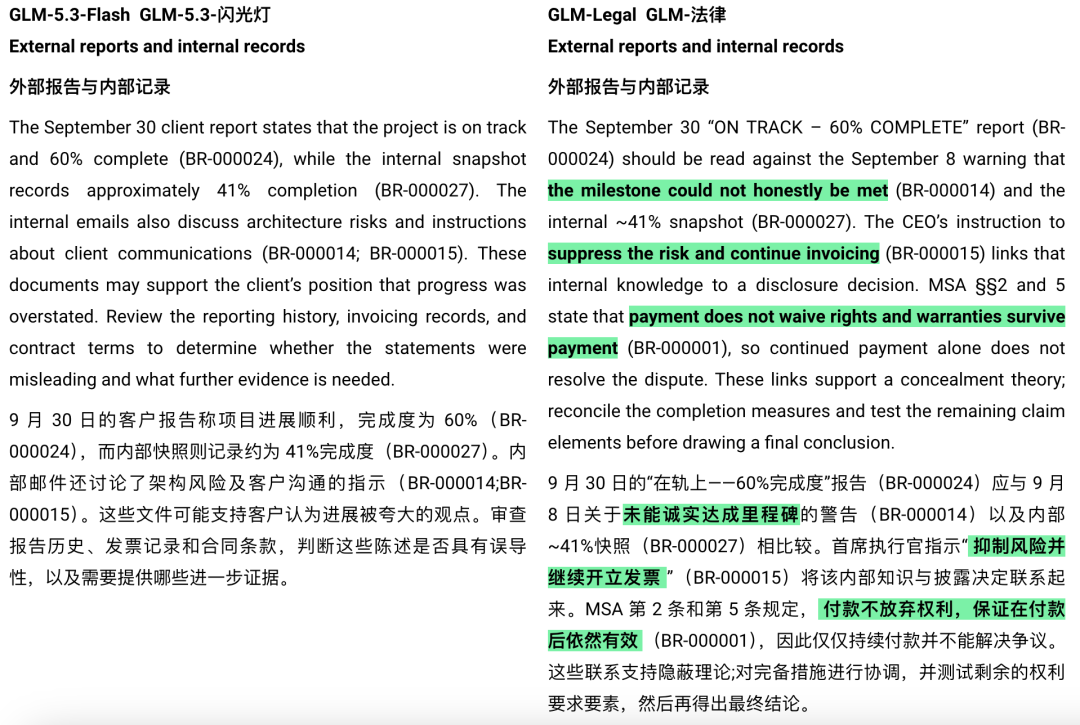
Dadurch ergibt sich ein klarerer Untersuchungsweg: feststellen, welche Originaldokumente die jeweiligen Punkte stützen, die unterschiedlichen Angaben zum Fertigstellungsgrad abgleichen und die übrigen Voraussetzungen eines möglichen Anspruchs prüfen. Die Ausgabe entwirft eine mögliche Falltheorie; allein aus widersprüchlichen Prozentangaben wird jedoch keine abschließende Feststellung von Betrug oder Haftung.
Das dritte Beispiel betrifft den Start einer Website in Singapur, Malaysia und Indonesien. Zum Arbeitsablauf gehören Tracking, Marketing-E-Mails und Cloud-Speicherung im Ausland.
GLM-Legal ordnet eine Reihe von Prioritäten vor dem Marktstart: Datenschutzhinweise, Einwilligungsnachweise, gesonderte Einwilligungen für Marketing, die Unterdrückung von Abmeldungen, eine Übersicht der Datenstandorte von Anbietern sowie die Prüfung vertraglicher und datentransferbezogener Schutzmaßnahmen. Die Antwort unterscheidet zwischen einer vorsichtigen gemeinsamen Grundlinie und Fragen, die noch länderspezifisch geklärt werden müssen.
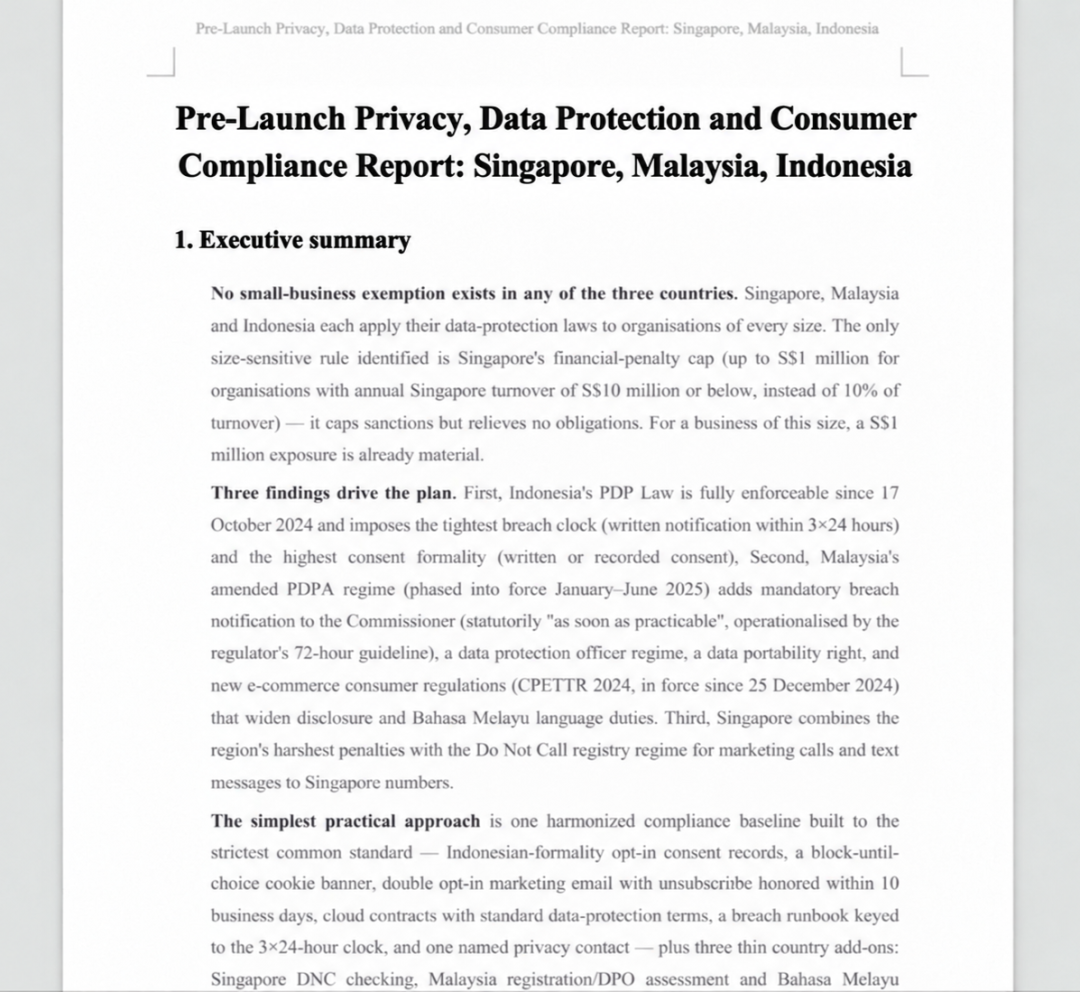
Der praktische Nutzen besteht in einem Entwurf mit Maßnahmen, die ein Team zuweisen und überprüfen kann. Die Demonstration ersetzt weder die Prüfung der aktuellen Gesetzgebung und behördlichen Leitlinien noch die Analyse der tatsächlichen Datenflüsse oder der lokalen Anforderungen an den jeweiligen Dienst.
Harvey hat LAB für Aufgaben entwickelt, die Associates in einer Anwaltskanzlei erhalten könnten: eine Anfrage eines Partners, einen Mandatsfall mit unterstützenden Unterlagen und ein Arbeitsergebnis, das eine andere Person prüfen kann. Die erste Version umfasst mehr als 1.200 Aufgaben aus 24 Rechtsgebieten sowie über 75.000 von Fachleuten erstellte Bewertungskriterien.
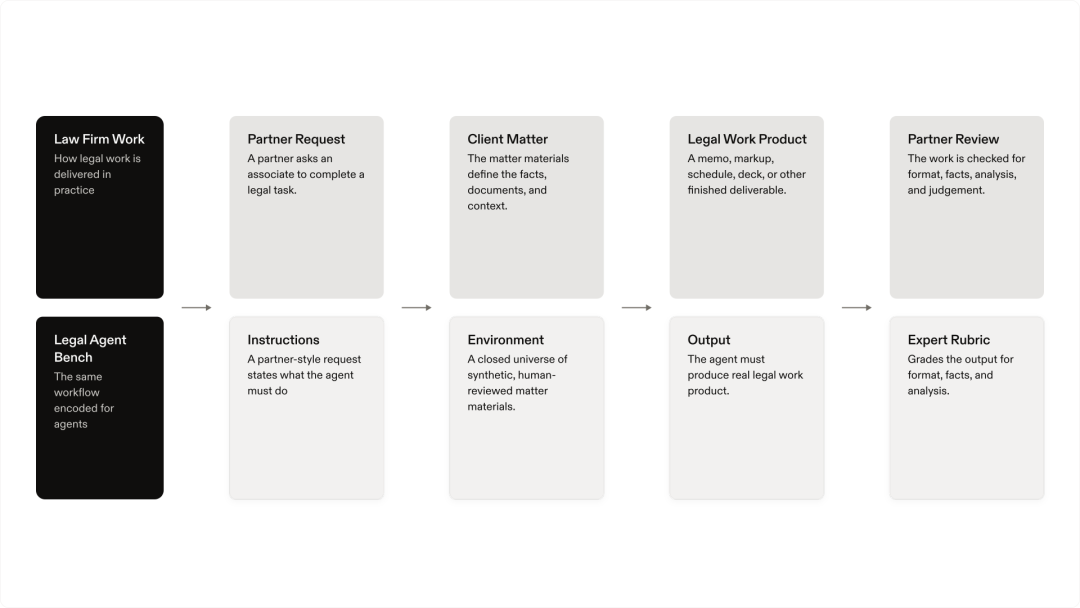
Der Benchmark verwendet eine All-Pass-Bewertung. Eine Aufgabe gilt nur dann als abgeschlossen, wenn jedes erforderliche Kriterium erfüllt ist. Dazu zählen unter anderem Fakten, Quellenangaben, Schlussfolgerungen, Fristen, Geldbeträge und Ausgabeformat. Fehlt eine wesentliche Anforderung, gilt die Aufgabe nicht als vollständig bestanden.
| Bewertung | Ergebnis in den geprüften Materialien | Was gemessen wird |
|---|---|---|
| Harvey LAB | 19,17 %, gerundet 19,2 % | Anteil der Aufgaben, bei denen alle erforderlichen Kriterien erfüllt sind. |
| LegalBench | 86,23 % auf der aktuellen Vals-Modellseite | Genauigkeit bei einer separaten Sammlung von Aufgaben zum juristischen Denken. |
| PLawBench | Z.ai berichtet von gleichwertigen Ergebnissen mit führenden Frontier-Systemen | Bewertung chinesischer Rechtspraxis; nicht dieselbe Kennzahl wie die beiden Vals-Ergebnisse. |
In der ursprünglichen Vals-Ankündigung wird GLM-Legal zum damaligen Vergleichszeitpunkt als führendes Modell mit offenen Gewichten auf LAB und LegalBench bezeichnet. Die Gesamtplatzierungen umfassen auch proprietäre Systeme: Auf der für diesen Artikel geprüften Vals-Seite belegte das Modell Platz sieben von 80 bei LAB und Platz 15 von 151 bei LegalBench. Ranglisten und Stichprobengrößen können sich ändern, wenn weitere Bewertungen hinzukommen.
Eine All-Pass-Rate von 19,2 % ist ein Fortschrittsnachweis unter einem strengen Maßstab. Zugleich bedeutet sie, dass der weit überwiegende Teil der bewerteten Aufgaben nicht alle Kriterien erfüllte. Das spricht dafür, Fehlerfälle zu untersuchen und eine Prüfung beizubehalten – nicht dafür, das Modell als autonome Anwaltskanzlei zu behandeln.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die Quelle vergleicht GLM-Legal auf der LAB-Rangliste mit Gemini 4 Argon. In dieser Momentaufnahme lagen die Ergebnisse beim Aufgabenbestehen nahe beieinander, GLM-Legal benötigte jedoch ungefähr eine halbe Stunde länger und kostete pro Test deutlich weniger; der angegebene Kostenunterschied lag bei etwa dem Faktor 70.
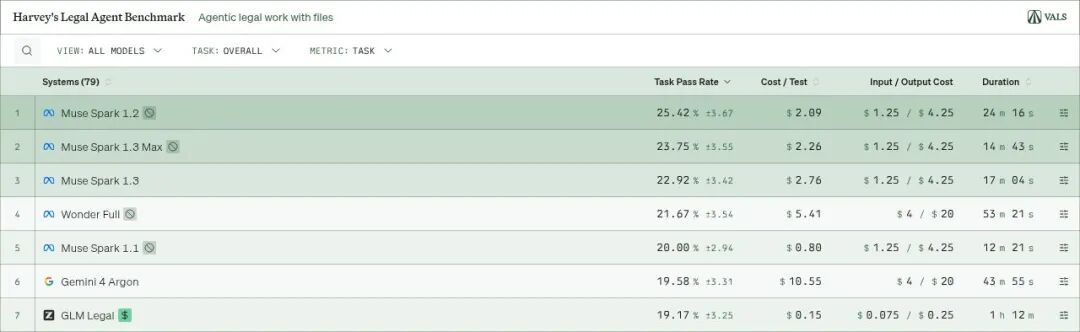
Dabei handelt es sich um Messwerte aus einem Benchmark-Durchlauf und nicht um eine Garantie für einen anderen Dokumentensatz oder die monatlichen Kosten eines Teams. Werkzeugeinsatz, Aufbau des Testsystems, Einstellungen für Schlussfolgerungen, Aufgabenlänge und Wiederholungsversuche beeinflussen die praktische Wirtschaftlichkeit.
Die offizielle Beschreibung des Trainings beginnt mit GLM-5.3-Flash und ergänzt die Spezialisierung in mehreren Stufen:
Der Harness ist Teil des Systems, das weiterentwickelt wird. Ein identisches Modell kann in einer anderen Werkzeugumgebung möglicherweise nicht dieselbe Qualität des demonstrierten Arbeitsablaufs erreichen.
Z.ai lädt Anwaltskanzleien, Legal-Tech-Unternehmen, interne Rechtsteams und selbstständig tätige Fachleute ein, einen Zugang zur API-Beta von GLM-Legal zu beantragen. Laut Ankündigung sollen die juristischen Funktionen auch in AutoClaw verfügbar werden; die Beispiele zur Bearbeitung von Word-Dokumenten und zu Recherchen werden in diesem Zusammenhang beschrieben.
Vals bezeichnet GLM-Legal als Modell mit offenen Gewichten. Die hier geprüften Einführungsunterlagen belegen jedoch weder einen herunterladbaren Checkpoint noch dessen Lizenzbedingungen, den unterstützten Inferenz-Stack oder die Hardwareanforderungen. Es gibt hier keine verifizierte Grundlage für einen Docker-Installationsbefehl oder die Behauptung, dass eine lokale Bereitstellung bereits allgemein verfügbar ist.
Für ein Team, das das Modell derzeit prüft, ist der konkrete, in der Ankündigung genannte Weg die offizielle Beratung und die Bewerbung für die Beta. Die tatsächlichen Zugangsbedingungen der Beta und die Verfügbarkeit von AutoClaw sollten zum Zeitpunkt der Nutzung geprüft werden.
Der vorliegende Bericht ordnet GLM-Legal neben Zhipus früherer Zusammenarbeit mit PowerLaw am Modell PowerLawGLM aus dem Jahr 2023 ein. Außerdem verweist er auf Harvey’s Tenet als weiteres Beispiel dafür, wie ein allgemeines Modell durch domänenspezifisches Post-Training spezialisiert werden kann.
Die gemeinsame Idee ist einfach: Juristisches Wissen allein reicht nicht aus. Ein nützlicher Assistent muss Ausgangsmaterialien ordnen, Fakten von Schlussfolgerungen trennen, Werkzeuge angemessen einsetzen und Arbeitsergebnisse liefern, die Fachleute prüfen können. Die hier betrachtete Veröffentlichung von GLM-Legal liefert Hinweise auf diesen Ansatz, lässt aber weiterhin erheblichen Spielraum, die Zuverlässigkeit bei vollständigen Aufgaben zu verbessern.
GLM-Legal ist das spezialisierte Rechtsmodell von Z.ai, das auf GLM-5.3-Flash basiert. Die Ankündigung konzentriert sich auf Agenten-Workflows wie Vertragsprüfung, Beweisanalyse und Compliance-Recherchen.
Die Aussage im vorliegenden Bericht, das Modell sei führend, bezieht sich auf Vergleiche zwischen Modellen mit offenen Gewichten bei bestimmten Benchmarks. Die Gesamt-Ranglisten umfassen auch proprietäre Systeme, und Benchmark-Platzierungen belegen nicht, dass sich ein Modell für jede juristische Aufgabe eignet.
Nein. Der All-Pass-Wert von LAB misst den Anteil der Aufgaben, bei denen sämtliche erforderlichen Bewertungskriterien erfüllt wurden. Die Angabe von 86,23 % bei LegalBench ist eine andere Kennzahl aus einer anderen Bewertung.
Z.ai berichtet über Ergebnisse auf PLawBench, das Beratungen, Analysen und Entwürfe zum chinesischen Recht abdeckt. Das stützt den vorgesehenen Einsatzbereich im chinesischen Recht. Eine konkrete Antwort muss jedoch weiterhin anhand der einschlägigen Fakten und des aktuellen Rechts geprüft werden.
Die geprüften Materialien enthalten weder einen verifizierten Download für einen Checkpoint noch Lizenzangaben, Hardwarespezifikationen oder eine Docker-Bereitstellungsanleitung. Obwohl Vals das Modell als eines mit offenen Gewichten einstuft, wird in den hier beschriebenen offiziellen Einführungsinformationen eine Bewerbung für die API-Beta als Zugangsweg genannt.
In der Ankündigung beschreibt Z.ai die Integration von GLM-Legal in AutoClaw als bevorstehend. Die Beispiele zeigen den vorgesehenen Arbeitsablauf, belegen jedoch keinen uneingeschränkten Zugang für alle Nutzer.
GLM-Legal verbindet juristisches Domänentraining mit der Optimierung agentischer Arbeitsabläufe. Die Demonstrationen legen den Schwerpunkt auf konkrete, überprüfbare Arbeitsergebnisse. Die Benchmark-Ergebnisse sind innerhalb der angegebenen Vergleiche vielversprechend; zugleich macht der strenge LAB-Wert die verbleibende Zuverlässigkeitslücke sichtbar.
Nutzen Sie die Beta und die Benchmark-Ergebnisse, um konkrete Arbeitsabläufe zu bewerten. Leiten Sie aus einer Ranglistenposition jedoch keine pauschale Aussage über juristische Kompetenz oder Einsatzbereitschaft ab.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



