For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/gpt-5-6-sol-cerebras-750-tokens-per-second.md.
Die gemeldete Spitzenleistung von GPT-5.6 Sol mit 750 Tokens pro Sekunde zeigt, wie Latenzarme Inferenz das praktische Verhalten von KI-Agen...
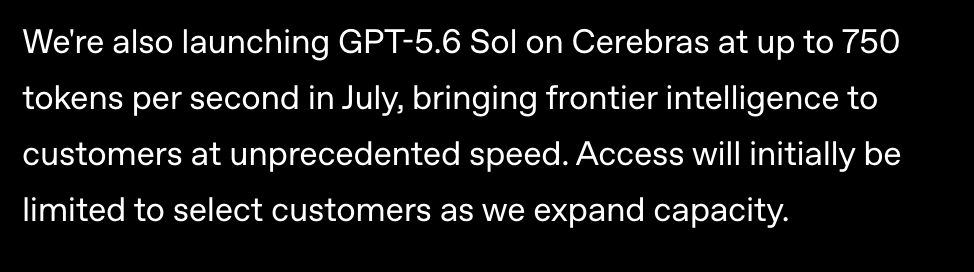
GPT-5.6 Sol verschiebt die Diskussion über Spitzenmodelle weg von der reinen Leistungsfähigkeit hin zu etwas, das ebenso wichtig ist: der Antwortgeschwindigkeit.
OpenAI hat mitgeteilt, dass GPT-5.6 Sol auf der Cerebras-Infrastruktur mit bis zu 750 Token pro Sekunde laufen kann. Bei dieser Geschwindigkeit fühlt sich ein KI-System nicht mehr wie ein Werkzeug an, das nach jeder Aktion eine Pause einlegt. Code-Agenten, Browser-Operatoren, Forschungsassistenten und computersteuernde Systeme können mehrstufige Arbeitsabläufe mit deutlich weniger Wartezeit zwischen Entscheidungen durchlaufen.
Die genannte Zahl ist offiziell. Viele der in diesem Zusammenhang diskutierten Architekturdetails sind es jedoch nicht. Schätzungen, dass das Modell etwa drei Billionen Parameter umfasst, 70 bis 100 Wafer-Systeme nutzt oder jeder Wafer eine Netzwerkschicht zugeordnet bekommt, stammen aus externen technischen Analysen und nicht aus einer veröffentlichten OpenAI-Spezifikation.
Dieser Artikel hält diese Unterscheidung klar. Er erläutert, was bestätigt wurde, was eine plausible technische Theorie bleibt und warum die Kombination von GPT-5.6 und Wafer-skalierter Inferenz für Echtzeit-KI wichtig ist.
Ein Durchsatz von 750 Token pro Sekunde ist schwer zu würdigen, bis man ihn mit der Art und Weise vergleicht, wie Menschen KI-Systeme tatsächlich nutzen.
Eine lange Antwort, die einst Zeile für Zeile erschien, kann nun fast sofort erzeugt werden. Noch wichtiger: Das Modell kann interne Überlegungen, Tool-Aufrufe, Code-Generierung, Oberflächenaktionen und Folgeentscheidungen viel schneller durchlaufen. Der Vorteil besteht nicht nur darin, dass Text früher ankommt. Die gesamte Agentenschleife wird reaktionsfähiger.
Diese Veränderung ist in Arbeitsabläufen wie diesen von Bedeutung:
Bei herkömmlichem Chat mag eine kurze Verzögerung akzeptabel sein. Bei einem Agenten, der auf einen Button klicken, das Ergebnis prüfen, seinen Plan überarbeiten und weitermachen muss, erhöht jeder Hin- und Rückweg die Reibung. Hochgeschwindigkeits-Inferenz reduziert diese angesammelte Latenzzeit.
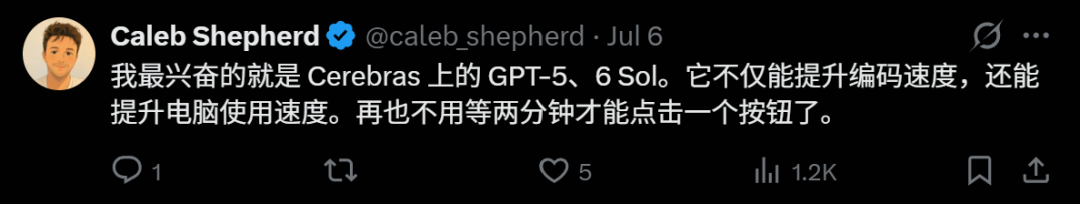
Der Entwickler Caleb Shepherd hob diesen Unterschied in der Diskussion um GPT-5.6 Sol hervor. Der wichtigste Gewinn ist nicht nur schnelleres Code-Schreiben, sondern schnelleres Computern: Ein Agent sollte keine Minuten mehr brauchen, um eine Folge einfacher Oberflächenaktionen abzuschließen.
Frage zur Modellgröße
Die Geschwindigkeitsangabe warf sofort eine technische Frage auf: Wie kann ein hochmodernes multimodales Modell auf Wafer-Maßstab-Hardware so schnell laufen?
Öffentliche OpenAI-Dokumentationen beschreiben GPT-5.6 Sol als das Spitzenmodell der GPT-5.6-Familie mit Text- und Bildeingabe, einem Kontextfenster von 1.050.000 Token und bis zu 128.000 Ausgabe-Token. Die Parameteranzahl des Modells, die Anzahl der aktiven Parameter, die Anzahl der Schichten, das Aufmerksamkeitsdesign oder die physische Bereitstellungstopologie werden nicht veröffentlicht.
Diese fehlenden Informationen veranlassten Entwickler und Infrastrukturspezialisten, auf der Grundlage des bekannten Wissens über Cerebras-Hardware rückwärts zu schließen.
Peter Gostev fasste das Kernproblem zusammen: Wenn GPT-5.6 Sol das vollständige multimodale Modell und nicht eine reduzierte Variante ist, könnte es zu groß sein, um in ein einzelnes Wafer-System zu passen. Die verbleibenden Möglichkeiten umfassen ein kleineres als erwartetes Modell, eine neue Hardwarekonfiguration oder eine Multi-System-Serving-Architektur.
[Image: Tweet von Peter Gostev, der Probleme im Zusammenhang mit dem Modell GPT-5.6 Sol auf Cerebras diskutiert. Er glaubt, dass dieses Modell, einschließlich der visuellen Fähigkeiten, möglicherweise völlig identisch mit dem Vorgängermodell ist, im Gegensatz zu GPT-5.3 - Codex - Spark. Auf dem Cerebras-Chip könnten möglicherweise nur 1001 700–900B-Modellprozessoren Platz finden, daher könnte GPT-5.6 Sol zu groß sein, was einen neuen Cerebras-Chip oder eine neue Technologie zur Kombination mehrerer Chips erfordert. Wenn es sich um dasselbe Modell handelt, das zu einem angemessenen Preis weit verbreitet verfügbar ist, wäre das eine bemerkenswerte Sache.]
Eine viel diskutierte Schätzung stammt vom technischen Experten Bleys Goodson. Seine Analyse schlug für GPT-5.6 Sol Folgendes vor:
Diese Zahlen sind keine offizielle Spezifikation. Sie sind eine technische Schätzung, die auf Modell-Serving-Einschränkungen, Speicheranforderungen und der bekannten Fähigkeit von Cerebras-Clustern basiert, sehr große Modelle über mehrere Systeme zu verteilen.
Der auffälligste Teil der Theorie ist nicht einfach die Anzahl der Wafer. Es ist die vorgeschlagene Abbildung zwischen Modellarchitektur und Hardware.
[Image: Tweet des technischen Experten Bleys Goodson zur Bereitstellung des Modells GPT-5.6 Sol. Er gibt an, dass das Modell 2 bis 4 Billionen Parameter hat, auf 70 bis 100 Wafern bereitgestellt wird, wobei maximal eine Schicht pro Wafer platziert wird, und das Modell etwa 70 bis 90 Schichten hat. Es gibt zwei Implementierungsmöglichkeiten: eine mit einem großen KV-Cache und eine mit einem leichteren KV-Cache-Design, ähnlich wie DeepSeekV4 oder einem hybriden SSM-Modell. Er arbeitet mit Cerebras zusammen und hält unter Berücksichtigung der Hardwarefaktoren die zweite Option für wahrscheinlicher. Die SRAM-Bandbreite ist für einen großen KV-Cache wertvoll, die Gesamtkapazität beträgt 3 TB, 150B aktive Kapazität, 70 Schichten sind am wahrscheinlichsten.]
Das vorgeschlagene Design weist jeder Hauptnetzwerkschicht ihr eigenes Wafer-System zu. Aktivierungen würden sich als Pipeline durch die Wafer bewegen, während jeder Wafer die seiner Schicht zugewiesene Berechnung durchführt.
Bei einer herkömmlichen verteilten GPU-Bereitstellung kann die Modellausführung komplexen Tensor-Parallelismus, Experten-Parallelismus und häufige Kommunikation zwischen Knoten umfassen. Kommunikationsaufwand kann zu einem ernsthaften Engpass werden, insbesondere wenn das Modell groß ist und das Ziel niedrige Latenz und nicht maximaler Batch-Durchsatz ist.
Eine Schicht-pro-Wafer-Pipeline verfolgt einen anderen Ansatz. Sobald die Pipeline gefüllt ist, können mehrere Token gleichzeitig in verschiedenen Stufen verarbeitet werden. Das Hinzufügen von Stufen kann die
Verzögerung, bis das erste Token erscheint, reduziert jedoch nicht zwangsläufig den stationären Tokendurchsatz im gleichen Verhältnis.
Dies hilft zu erklären, warum ein extrem großes Modell nach Beginn der Generierung schnell bleiben kann. Es erklärt auch, warum der Einsatz teuer sein kann: Um eine hohe sequenzielle Geschwindigkeit zu erreichen, kann es erforderlich sein, einer einzigen Modellreplik eine sehr große Menge an Hardware zu widmen.
Der Quellartikel zitiert eine externe Tokenomics-Schätzung, die GPT-5.6 Sol als ein Drei-Billionen-Parameter-System modelliert, das unter einem Satz von Annahmen etwa 70 Wafer-Scale-Systeme benötigt.
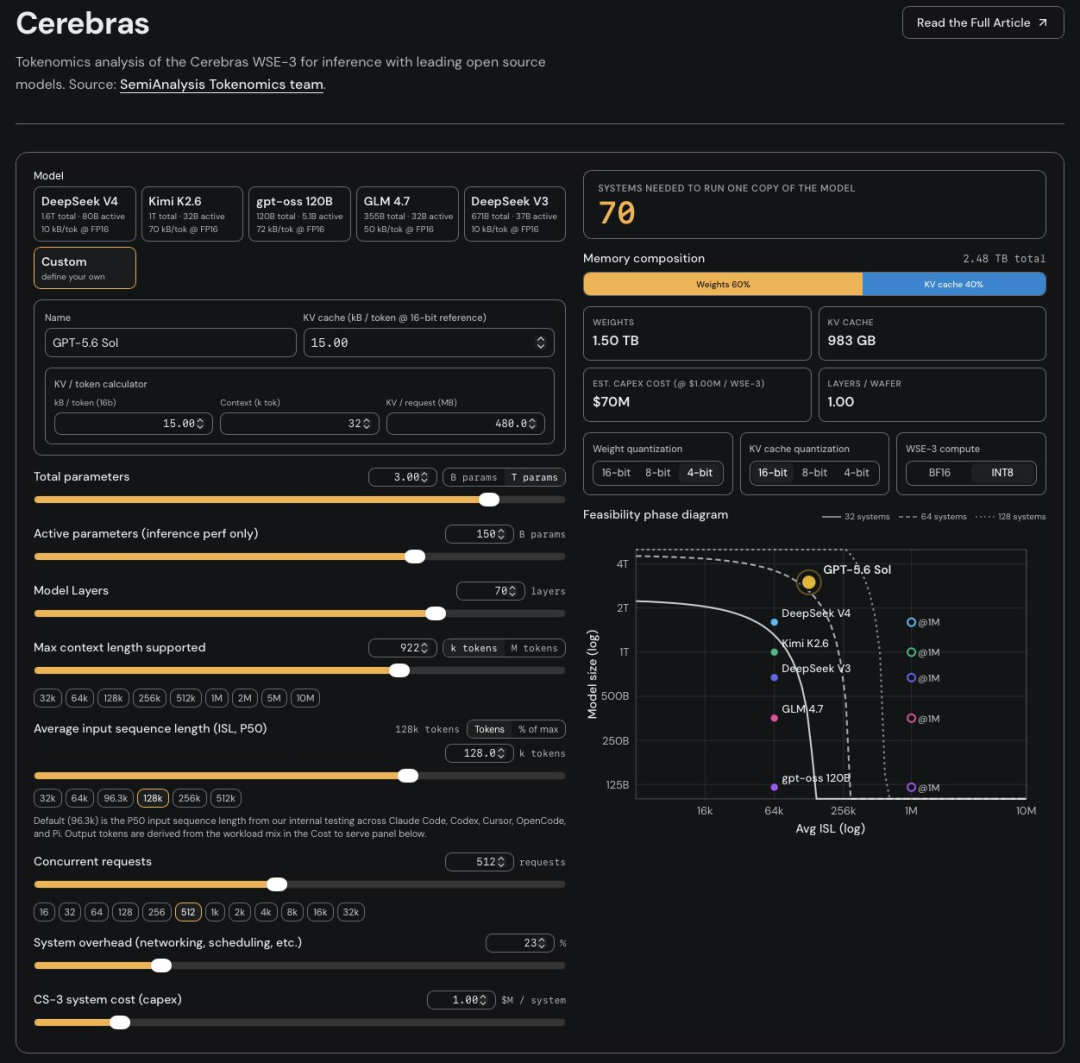
Wichtig: Die Schätzung von 70 bis 100 Wafern und die Beschreibung „ein Wafer pro Schicht" bleiben fundierte Spekulationen. OpenAI und Cerebras haben diese physikalische Topologie nicht öffentlich bestätigt.
Rechenleistung ist nur ein Teil des Problems. Autoregressive Modelle verwalten außerdem einen Key-Value-Cache, allgemein als KV-Cache bezeichnet, sodass sie Informationen aus vorherigen Token wiederverwenden können, anstatt die gesamte Sequenz neu zu berechnen.
Bei Modellen mit langem Kontext kann dieser Cache eine große Menge Speicher verbrauchen. Die Herausforderung wird noch größer, wenn das System viele gleichzeitige Anfragen unterstützen muss.
Cerebras-Wafer-Scale-Prozessoren enthalten große Mengen schnellen On-Chip-SRAMs. Dieser Speicher bietet eine außergewöhnliche Bandbreite, ist aber dennoch eine begrenzte und wertvolle Ressource. Eine herkömmliche Aufmerksamkeitsarchitektur mit einem großen KV-Cache-Fußabdruck könnte zu viel Kapazität verbrauchen und die Vorteile der Verarbeitung in der Nähe des Prozessors verringern.
Dies führt zu der Theorie, dass GPT-5.6 Sol möglicherweise eine Architektur verwendet, die auf geringere Cache-Anforderungen ausgelegt ist. In der Quelle diskutierte Möglichkeiten sind:
Das genaue Design ist unbekannt. OpenAI hat nicht genügend architektonische Details veröffentlicht, um zu bestimmen, welche dieser Methoden, falls überhaupt eine, verwendet wird.
Was mit Sicherheit gesagt werden kann, ist, dass Hardware-Software-Co-Design in diesem Maßstab zunehmend an Bedeutung gewinnt. Ein Modell, das nur für generische Beschleuniger-Cluster optimiert ist, könnte auf einem Wafer-Scale-System erhebliche ungenutzte Leistung lassen.
Eine weitere Hypothese ist, dass verschiedene Hardware unterschiedliche Teile des Modells verarbeiten könnte.
Die Transformer-Inferenz wird von zwei großen Kategorien von Arbeit dominiert:
Parameter
Der Entwickler John Lam schlug vor, dass herkömmliche Beschleuniger die Aufmerksamkeit übernehmen könnten, während Cerebras-Systeme die Feed-Forward-Netzwerkschichten verarbeiten. Diese Art der Aufmerksamkeits-FFN-Zerlegung könnte jede Arbeitslast der für sie am besten geeigneten Hardware-Architektur zuweisen.
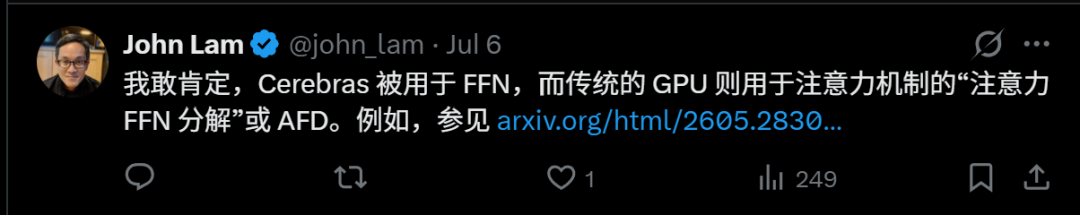
Auch dies ist eine Hypothese und kein offengelegtes Detail des GPT-5.6-Einsatzes. Es ist technisch relevant, weil heterogene Inferenzsysteme immer praktikabler werden. Anstatt zu erwarten, dass ein einziger Beschleuniger jede Operation gleich gut ausführt, können Anbieter ein Modell über spezialisierte Rechen-, Speicher- und Netzwerksysteme aufteilen.
Der Preis dafür ist eine größere Systemkomplexität. Terminplanung, Aktivierungsübertragung, Fehlerbehandlung und Latenzkontrolle werden alle schwieriger, wenn eine Anfrage mehrere Hardware-Arten durchläuft.
Cerebras hat bereits gezeigt, dass Wafer-Scale-Systeme sehr große Mixture-of-Experts-Modelle mit ungewöhnlich hoher Geschwindigkeit bedienen können.
In seinem offiziellen Material zu Kimi K2.6 beschreibt Cerebras ein offenes Modell mit einer Billion Parametern, das mit nahezu 1.000 Tokens pro Sekunde bedient wird. Das Unternehmen gibt an, dass die Modellgewichte über mehrere Wafer verteilt werden können, während die Aktivierungen zwischen ihnen gestreamt werden. Es beschreibt auch die Speicherung der ursprünglichen Gewichte mit niedrigerer Präzision bei gleichzeitiger Berechnung mit höherer Präzision, unterstützt durch benutzerdefinierte Kerne und spekulatives Decoding.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Dies ist ein wichtiger Beleg dafür, dass Multi-Wafer-Inferenz real und betriebsbereit ist. Es beweist nicht, dass GPT-5.6 Sol dieselbe Konfiguration, dieselbe Präzisionsstrategie oder dieselbe Modellpartitionierung verwendet.
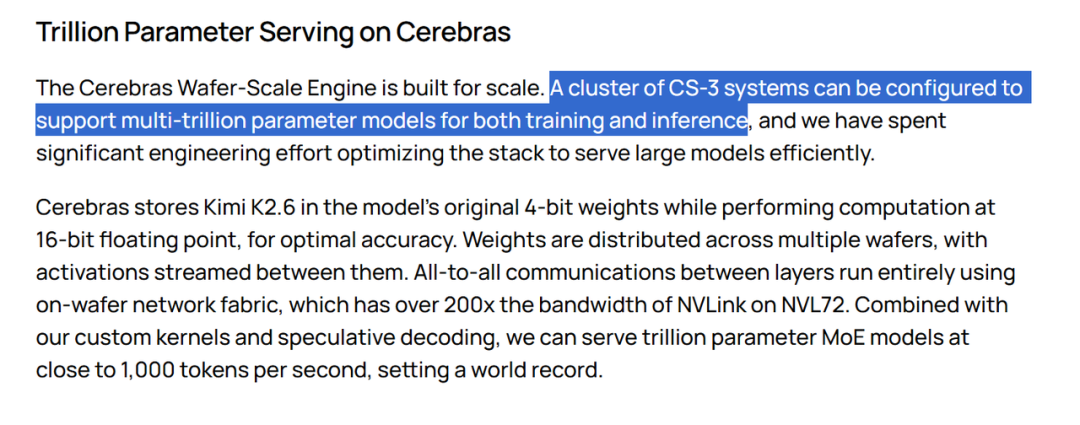
Der Kimi-Einsatz zeigt durchaus, warum Cerebras für die Latenzstrategie von OpenAI relevant ist. Wafer-Scale-Systeme sind um eine extrem hohe geräteinterne Bandbreite herum aufgebaut und verringern die Abhängigkeit von der Kommunikation zwischen vielen separaten Beschleunigerpaketen.
In der Ankündigung der Partnerschaft von OpenAI im Januar 2026 hieß es, das Unternehmen plane, 750 MW ultraflexible Cerebras-Rechenleistung hinzuzufügen. Das Ziel war einfach: die Inferenzlatenz zu reduzieren und interaktive KI unmittelbarer wirken zu lassen.
OpenAI beschrieb die Cerebras-gestützte Version von GPT-5.6 Sol zunächst als eine begrenzte Einführung für ausgewählte Kunden, während die Kapazität erweitert wird.
Diese Einschränkung ist nachvollziehbar. Eine Bereitstellung, die dutzende Wafer-Scale-Systeme für jede Modellreplik widmet, wäre teuer, kapazitätsbeschränkt und
schwer sofort zu skalieren. Hochgeschwindigkeitszugriff kann daher zuerst für Arbeitslasten positioniert werden, bei denen Latenz einen direkten Geschäftswert hat.
Beispiele umfassen:
Die aktuelle GPT-5.6-Dokumentation von OpenAI listet Sol, Terra und Luna für unterstützte Produkte und API-Zugriff auf. Die spezielle, auf Cerebras basierende Konfiguration mit 750 Token pro Sekunde kann jedoch separate Kapazitäts-, Berechtigungs- oder Routing-Beschränkungen im Vergleich zum standardmäßigen GPT-5.6-Zugriff aufweisen.
Die Cerebras-Partnerschaft ist Teil einer breiter angelegten Infrastrukturstrategie von OpenAI.
Im Juni 2026 stellten OpenAI und Broadcom offiziell Jalapeño vor, OpenAIs ersten Intelligenzprozessor. Es handelt sich um einen kundenspezifischen Beschleuniger, der von Anfang an für moderne LLM-Inferenz entwickelt wurde und nicht um einen Allzweckprozessor, der von älteren Arbeitslasten abgeleitet wurde.
Laut OpenAI basierte der Chip auf der Modell-Roadmap des Unternehmens, den Kerneln, Serving-Systemen, dem Speicherverhalten, den Netzwerkanforderungen und den Produktanforderungen. Broadcom steuert Siliziumimplementierung und Netzwerkexpertise bei, während Celestica die Board- und Rack-Integration unterstützt.
OpenAI gibt außerdem an, dass der erste Chip in neun Monaten vom ersten Design zum Fertigungs-Tape-Out gelangte, wobei KI-Modelle Teile des Design- und Optimierungsprozesses unterstützten.
Mehrere Punkte sind bereits bestätigt:
Jalapeño macht die Cerebras-Partnerschaft nicht überflüssig. Vielmehr können die beiden Bemühungen als komplementär verstanden werden. Cerebras gibt OpenAI Zugang zu einer etablierten Architektur mit extrem niedriger Latenz, während Jalapeño ihm eine größere langfristige Kontrolle über den eigenen Inferenz-Stack gibt.
Der größere Wandel ist klar: Grenzüberschreitende KI-Unternehmen behandeln Hardware nicht mehr als neutrale Schicht unter dem Modell.
OpenAI arbeitet nun bereichsübergreifend an:
Dies ermöglicht es dem Unternehmen, den Stack auf ein gemeinsames Ziel hin zu optimieren. Eine Änderung der Modellarchitektur kann den Speicherdruck verringern. Ein Chip kann um die häufigsten Kernel des Modells herum entwickelt werden. Die Vernetzung kann für die Aktivierungs- und Parameterbewegungsmuster ausgewählt werden, die am wichtigsten sind. Serving-Systeme können diese Gewinne dann als niedrigere Latenz oder niedrigere Kosten ausweisen.
Das Ergebnis ist eine Rückkopplungsschleife:
Leistungsfähige Modelle führen zu besseren Produkten und einer höheren Nutzung.
5. Die gesteigerte Nutzung finanziert die nächste Infrastrukturgeneration.
Die GPT-5.6-Sol-Konfiguration mit 750 Token pro Sekunde ist daher mehr als eine Geschwindigkeitsdemonstration. Sie ist ein Beispiel dafür, dass Modell, Hardware, Netzwerk und Serving-Software als ein System konzipiert sind.
Es ist wichtig, diese Kategorien getrennt zu behandeln. Die spekulativen Ideen sind technisch plausibel und hilfreich, um das Systemdesign-Problem zu verstehen, sollten aber nicht als offizielle GPT-5.6-Spezifikationen dargestellt werden.
GPT-5.6 Sol ist das leistungsfähigste Modell der GPT-5.6-Familie von OpenAI. OpenAI positioniert es für komplexe professionelle Arbeiten in den Bereichen Programmierung, Forschung, Computernutzung, Wissenschaft, Cybersicherheit und andere anspruchsvolle agentische Arbeitsabläufe.
OpenAI hat eine Cerebras-gestützte GPT-5.6-Sol-Konfiguration angekündigt, die mit bis zu 750 Token pro Sekunde laufen kann. Die tatsächliche Anwendungsgeschwindigkeit kann jedoch je nach Eingabeaufforderungsgröße, Tool-Nutzung, Reasoning-Einstellungen, Netzwerklatenz und Kapazität variieren.
Diese Zahl stammt aus externen technischen Schätzungen, nicht aus einer offiziellen Architekturoffenlegung. OpenAI und Cerebras haben weder die Anzahl der Wafer des Modells noch sein genaues physisches Bereitstellungsdesign bestätigt.
Es beschreibt eine Pipeline, bei der jedes Wafer-Scale-System eine große Modellebene enthält und berechnet und die Aktivierungen an die nächste Stufe weitergibt. Das Design könnte nach dem Füllen der Pipeline einen hohen Tokendurchsatz aufrechterhalten, aber es bleibt eine Theorie über GPT-5.6 Sol und keine bestätigte Tatsache.
Der KV-Cache wächst mit der Kontextlänge, der Modellarchitektur, der Batch-Größe und den gleichzeitigen Nutzern. Selbst sehr schneller On-Chip-Speicher hat eine begrenzte Kapazität, daher kann die Reduzierung der Cache-Größe und der Speicherbewegung für die latenzarme Bedienung unerlässlich sein.
Cerebras kann bei bestimmten Inferenz-Workloads deutlich schneller sein, da seine Wafer-Scale-Architektur eine hohe On-Device-Bandbreite bietet und einige Kommunikations-Overheads vermeidet.
in Multi-GPU-Systemen. Die Leistung hängt weiterhin vom Modell, der Batch-Größe, der Genauigkeit, dem Kontext und der Bereitstellungskonfiguration ab.
Jalapeño ist OpenAIs erster kundenspezifischer Intelligence-Prozessor, der gemeinsam mit Broadcom für LLM-Inferenz entwickelt wurde. OpenAI gibt an, dass er Teil einer mehrgenerationalen, vollständigen Compute-Plattform ist und darauf abzielt, Leistung, Effizienz und Skalierbarkeit zu verbessern.
Ja. Die API-Dokumentation von OpenAI listet GPT-5.6 Sol auf und identifiziert gpt-5.6 als Alias, der zur Sol-Stufe führt. Verfügbarkeit, Ratenbegrenzungen, Preise und unterstützte Funktionen hängen vom Entwicklerkonto und den aktuellen API-Bedingungen ab.
GPThe gemeldete Spitzenleistung von GPT-5.6 Sol mit 750 Tokens pro Sekunde zeigt, wie latenzarme Inferenz das praktische Verhalten von KI-Agenten verändern kann. Die wichtigste Verbesserung ist nicht nur schnellerer Text, sondern kürzere Verzögerungen bei wiederholtem Reasoning, Tool-Nutzung, Programmierung und Computersteuerungszyklen.
Cerebras hat bereits gezeigt, dass Wafer-Scale-Systeme Modelle mit einer Billion Parametern mit fast 1.000 Tokens pro Sekunde bedienen können. Das macht eine große Multi-Wafer-Bereitstellung von GPT-5.6 plausibel, aber die viel diskutierten Parameterzahlen, Wafer-Zahlen, Cache-Architektur und Attention-FFN-Aufteilung bleiben externe Schätzungen.
OpenAIs Cerebras-Partnerschaft und sein kundenspezifischer Jalapeño-Chip weisen in die gleiche Richtung: Die nächsten Fortschritte in der KI werden zunehmend aus dem Co-Design von Modellen, Speicher, Vernetzung, Beschleunigern und Bereitstellung resultieren.
Systeme gemeinsam.
Der bestätigte Durchbruch ist die Grenzinferenz mit 750 Token pro Sekunde; das genaue Hardware-Layout dahinter wurde noch nicht öffentlich bekannt gegeben.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



