For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/gpt-5-6-sol-s-1m.md.
OpenAI hat den Zugriff auf das Millionen-Token-Kontextfenster von GPT-5.6 Sol in Codex erweitert, sodass Entwickler, die sich mit einem Chat...
OpenAI hat den Zugriff auf das Millionen-Token-Kontextfenster von GPT-5.6 Sol in Codex erweitert, sodass Entwickler beim Login mit einem ChatGPT-Konto größeren Kontext erhalten – nicht mehr nur über die API-Key-Authentifizierung.
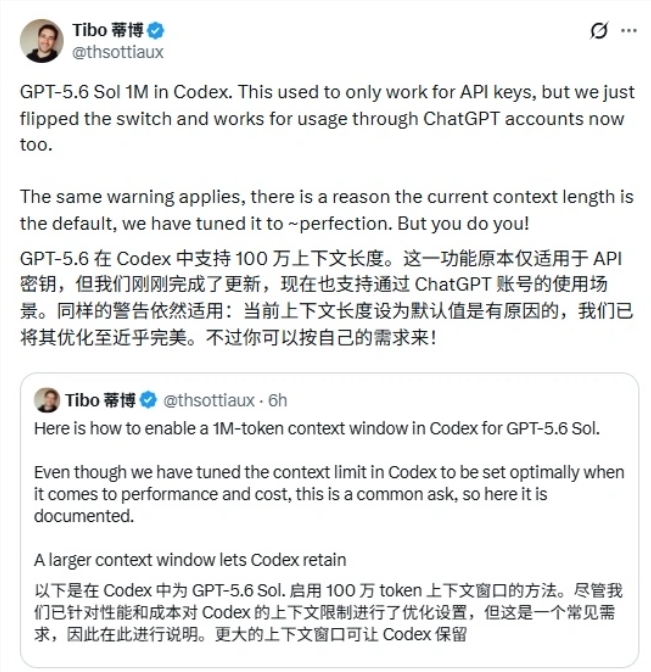
Dieses Update wurde von Tibo, dem bei OpenAI für Codex und ChatGPT zuständigen Ingenieur, hervorgehoben. Laut der in der ursprünglichen AIBase-Meldung geteilten Ankündigung war der 1-Millionen-Kontextmodus von GPT-5.6 Sol bisher nur für API-Key-Nutzer verfügbar, doch nun wurde der Schalter auch für die Nutzung mit ChatGPT-Konten aktiviert.
Die aktuellen Modelldokumentationen von OpenAI listen GPT-5.6 Sol mit einem Kontextfenster von 1.050.000 Token und maximal 128.000 Ausgabe-Token auf. Dies bietet Codex mehr Raum, um mehr Quellcode, Tool-Ergebnisse, Anweisungen und Konversationsverlauf zu behalten, bevor ein Kontextmanagement oder eine Komprimierung erforderlich wird.
Für Entwickler, die mit großen Codebasen, langen Debugging-Sitzungen, Migrationen oder mehrstufigen Refactorings arbeiten, ist diese Option sehr nützlich. OpenAI weist jedoch auch darauf hin, dass Nutzer nicht davon ausgehen sollten, dass das maximal mögliche Kontextfenster immer die beste Standardeinstellung ist.
Die eigentliche Änderung besteht darin, dass die Langkontext-Funktion nicht mehr nur Entwicklern vorbehalten ist, die Codex über einen API-Key authentifizieren.
Die Ankündigung besagt, dass die Funktion jetzt auch über ChatGPT-Konten verfügbar ist. Die aktuellen Codex-Preisdokumente von OpenAI bestätigen, dass Plus-, Pro-, Business-, Enterprise- und andere unterstützte ChatGPT-Tarife den Codex-Zugriff beinhalten und die GPT-5.6-Modellfamilie in berechtigten kostenpflichtigen Tarifen verwendet werden kann.
Das offizielle Kontextfenster von GPT-5.6 Sol selbst sieht wie folgt aus:
| Spezifikation | GPT-5.6 Sol |
|---|---|
| Kontextfenster | 1.050.000 Token |
| Maximale Ausgabe | 128.000 Token |
| Modell-ID | gpt-5.6-sol |
| Alias | gpt-5.6 |
Das größere Fenster erlaubt es einer Codex-Sitzung, mehr Arbeitsinformationen auf einmal zu behalten.
Dazu können gehören:
Für kleinere Aufgaben macht dieser zusätzliche Platz möglicherweise keinen großen praktischen Unterschied. Bei großen Produktions-Repositories kann das Behalten von mehr Projektzustand jedoch die Häufigkeit verringern, mit der älteres Material zusammengefasst oder aus dem aktiven Kontext verworfen wird.
Die offizielle Codex-Konfigurationsreferenz von OpenAI dokumentiert die Einstellung:
model_context_window
Sie gibt die Anzahl der Kontextfenster-Token an, die für das aktuelle Modell verfügbar sind.
Die Beispielkonfiguration von OpenAI zeigt außerdem, dass Codex, wenn dieser Wert nicht gesetzt ist, normalerweise den Standardwert des Modells oder der Voreinstellung verwendet. Mit anderen Worten: Nutzer müssen die maximale Kontextgröße im normalen Betrieb nicht manuell erzwingen.
Die ursprüngliche Ankündigung betonte ausdrücklich, dass die Millionen-Token-Option etwas ist, das Nutzer bei Bedarf selbst wählen können.
Diese Unterscheidung ist wichtig, denn ein größeres Kontextfenster ist eine Fähigkeit und nicht unbedingt die beste Standardeinstellung für jede Sitzung.
Tibo erinnerte außerdem daran, dass die aktuelle Standard-Kontextlänge von Codex bewusst gewählt wurde.
Laut der Ankündigung hat OpenAI die regulären Einstellungen nach einer Abwägung zwischen Leistung und Kosten angepasst. Nutzer können den größeren Kontext frei wählen, aber die Standardeinstellung soll typische Codierungssitzungen effizient ablaufen lassen.
Dies steht im Einklang mit den offiziellen Preisrichtlinien für Codex von OpenAI.
OpenAI weist darauf hin, dass scheinbar ähnliche Aufgaben die Nutzerkontingente in sehr unterschiedlichem Maße verbrauchen können, da der Verbrauch von folgenden Faktoren abhängt:
Das bedeutet, dass das Millionen-Token-Fenster nicht als „kostenloser zusätzlicher Speicher“ verstanden werden sollte.
Je mehr Kontext eine Sitzung aktiv verarbeitet, desto mehr Token müssen möglicherweise gelesen, zwischengespeichert, verwaltet oder komprimiert werden. Für Nutzer, die innerhalb der tarifbasierten Codex-Limits arbeiten, verbraucht ein größerer Kontext daher schneller verfügbare Kontingente.
Die tokenbasierten Tariftabellen von OpenAI behandeln extrem lange Kontexte ebenfalls als eigenständige Arbeitslasten. In unterstützten Work- und Codex-Umgebungen können Eingaben, die die Langkontext-Schwelle überschreiten, im Rahmen der geltenden tokenbasierten Preisgestaltung höheren Token-Sätzen unterliegen.
Codex enthält bereits Kontextmanagement-Mechanismen, die darauf ausgelegt sind, lange Sitzungen nutzbar zu halten.
Für gewöhnliche Fehlerbehebungen, fokussierte Feature-Entwicklung, Code-Reviews oder kleinere Repository-Änderungen reicht die Standardkontextkonfiguration möglicherweise bereits aus.
Es bringt nicht unbedingt einen Vorteil, wenn Entwickler das gesamte Repository und alle früheren Tool-Ergebnisse dauerhaft im aktiven Fenster behalten.
Sinnvoller ist es, die Kontextgröße an die Aufgabe anzupassen.
Das Millionen-Token-Kontextfenster ist am attraktivsten, wenn die Arbeit tatsächlich von einer großen Menge gleichzeitig relevanter Informationen abhängt, zum Beispiel:
Für schmale Aufgaben, die nur wenige Dateien betreffen, ist der Standardkontext möglicherweise effizienter.
Einer der Hauptvorteile des erweiterten Fensters ist, dass Codex mehr Verlauf behalten kann, bevor ältere Informationen komprimiert werden müssen.
Kontextkomprimierung ist nützlich, da kein Agent unbegrenzt Verlauf mit sich führen kann. Die Komprimierung ersetzt jedoch zwangsläufig detailliertes früheres Material durch kürzere Darstellungen.
Ein größeres Fenster verzögert diesen Kompromiss.
Eine lange Codierungssitzung kann sich beispielsweise ansammeln:
Wenn der aktive Kontext überfüllt wird, muss Codex möglicherweise früheren Verlauf komprimieren oder anderweitig verwalten.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Mit dem vollständigen 1,05M-Token-Fenster von GPT-5.6 Sol kann mehr Informationen über einen längeren Zeitraum direkt zugänglich bleiben.
Dies ist besonders nützlich, wenn frühere Details für Entscheidungen in späteren Phasen der Aufgabe weiterhin wichtig sind.
Dieser Nutzen hängt jedoch von der Arbeitslast ab. Informationen verfügbar zu halten, hilft nur, wenn sie auch weiterhin relevant sind.
Die wichtigste Warnung im ursprünglichen AIBase-Artikel betraf die Nutzungslimits.
Einige Entwickler berichten, dass die Aktivierung des vollständigen Millionen-Token-Kontexts dazu führen kann, dass ihr verfügbares Codex-Kontingent in intensiven Sitzungen schneller schrumpft.
Aus tokenmetrischer Sicht ist dieses Verhalten nicht überraschend.
OpenAIs eigene Codex-Dokumentation erklärt, dass allein die Promptlänge den Verbrauch nicht bestimmt. Kontext, Reasoning, Tools, Retrieval und Caching beeinflussen alle, wie viel Kontingent eine Aufgabe verbraucht.
Daher führt ein größerer Kontext zu schwereren Runden, sobald die Sitzung tatsächlich auf diesen Raum anwächst.
Das bedeutet nicht, dass jede Anfrage sofort eine Million Token verbraucht, nur weil das maximale Fenster aktiviert ist. Es bedeutet, dass Sitzungen auf eine größere Größe anwachsen können und ausreichend große Anfragen in Bezug auf Token oder geplante Nutzung teurer sein können als ähnliche Anfragen mit einem kleineren Arbeitskontext.
Daher ist es sicherer, das maximale Fenster standardmäßig nur dann zu aktivieren, wenn es tatsächlich ein Problem löst.
Die neue Option ist am nützlichsten, wenn die Kosten für verlorenen Kontext höher sind als die Kosten für das Mitführen von Kontext.
Erwägen Sie das größere Fenster in folgenden Fällen:
Codex muss eine sehr große Codebasis verstehen.
Behalten Sie in den folgenden Fällen die normale Kontextkonfiguration bei:
Die wesentliche Änderung besteht darin, dass Entwickler jetzt eine Wahl haben.
Bisher war die im Quellbericht beschriebene vollständige Kontextfunktion auf die Nutzung von API-Schlüsseln beschränkt. ChatGPT-Kontobenutzer können jetzt bei Bedarf das größere Fenster für ihre Arbeitslast auswählen.
Die offizielle Modelldokumentation von OpenAI listet GPT-5.6 Sol mit einem Kontextfenster von 1.050.000 Tokens auf. Das Modell unterstützt außerdem bis zu 128.000 Ausgabe-Tokens.
Ja. Von AIBase berichtete und vom OpenAI-Ingenieur Tibo angekündigte Updates zeigen, dass der Millionen-Token-Kontext von GPT-5.6 Sol für authentifizierte Codex-Sitzungen aktiviert wurde.
Die Nutzung erfolgt über ein ChatGPT-Konto und ist nicht auf die API-Schlüssel-Methode beschränkt.
Für den in diesem Update beschriebenen ChatGPT-Kontopfad nicht. Die API-Schlüssel-Authentifizierung wird weiterhin unterstützt, aber diese Änderung erweitert die Funktion ausdrücklich auf die Nutzung über ChatGPT-Konten.
Nein. In der Ankündigung wird darauf hingewiesen, dass die normalen Kontexteinstellungen von Codex bewusst auf Leistung und Kosten abgestimmt sind. Das größere Fenster ist eine Option für Benutzer mit besonderen Anforderungen, die zusätzlichen Kontext benötigen.
Der Kontext beeinflusst die Informationsmenge, die das Modell verarbeitet. Die Preisgestaltungsdokumentation von OpenAI für Codex weist darauf hin, dass Modellauswahl, Kontext, Reasoning, Tool-Nutzung, Abruf und Caching den Verbrauch beeinflussen. Daher verbrauchen lange Sitzungen und kontextintensive Sitzungen mehr Kontingente.
Nein. Das Kontextfenster ist eine maximale Kapazität und keine feste Token-Gebühr pro Gesprächsrunde. Der tatsächliche Verbrauch hängt davon ab, wie viel Inhalt in der Sitzung enthalten ist und wie viele Daten das Modell verarbeitet.
Große Codebasis-Refactorings, lange Debugging-Sitzungen, Architekturmigrationen, modulübergreifende Analysen sowie erweiterte Agenten-Workflows sind geeignete Szenarien. Kleine Korrekturen und klar abgegrenzte Aufgaben benötigen normalerweise kein maximales Fenster.
OpenAI dokumentiert model_context_window in der offiziellen Codex-Konfigurationsreferenz und im Leitfaden für erweiterte Konfigurationen. In den Beispielkonfigurationen wird darauf hingewiesen, dass Codex, wenn dieser Wert nicht festgelegt ist, den Modell- oder voreingestellten Standardwert verwendet.
model_context_window und anderen Modelleinstellungen.config.toml inklusive optionaler manueller Kontextfenster-Einstellung.openai.com/codex/pricing): Offizielle Informationen zu Paketverfügbarkeit, Nutzungsrichtlinien sowie dazu, wie Kontext und andere Faktoren den Verbrauch beeinflussen.
Das vollständige Millionen-Token-Kontextfenster von GPT-5.6 Sol ist nicht mehr ausschließlich auf Codex-Sitzungen mit API-Schlüssel-Authentifizierung beschränkt. ChatGPT-Kontobenutzer haben jetzt ebenfalls Zugriff auf die größere Kontextoption, was bei langen Codierungs-Sitzungen mehr Platz für Repository-Inhalte, Tool-Ausgaben und Gesprächsverlauf bietet.
Das maximale Fenster ist nicht als Ersatz für die regulären Codex-Standardeinstellungen für jede Aufgabe gedacht. OpenAI hat die Standardeinstellungen sorgfältig abgestimmt, um ein Gleichgewicht zwischen Leistung und Kosten zu erreichen. Die 1,05-Millionen-Token-Option ist am nützlichsten für wirklich große Repositories und langfristige Engineering-Arbeit.
Für alltägliche Korrekturen ist der Standardkontext möglicherweise weiterhin effizienter. Für komplexe Projekte, bei denen der Verlust früherer Details zu einem echten Engpass wird, bietet die neue Option Entwicklern erheblich mehr Spielraum.
Die wesentliche Aktualisierung besteht nicht darin, dass jede Codex-Sitzung eine Million Tokens verwenden sollte, sondern darin, dass ChatGPT-Benutzer jetzt den vollständigen GPT-5.6-Sol-Kontext wählen können, wenn das Projekt es tatsächlich erfordert.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



