For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/gpt-5-6-sol-vision-benchmark.md.
GPT-5.6 Sol könnte einer der größten Sprünge von OpenAI im praktischen visuellen Verständnis der letzten Zeit sein. Roboflow testete die GPT...
GPT-5.6 Sol könnte einer der größten Sprünge von OpenAI im Bereich praktischer visueller Verständnisfähigkeiten sein.
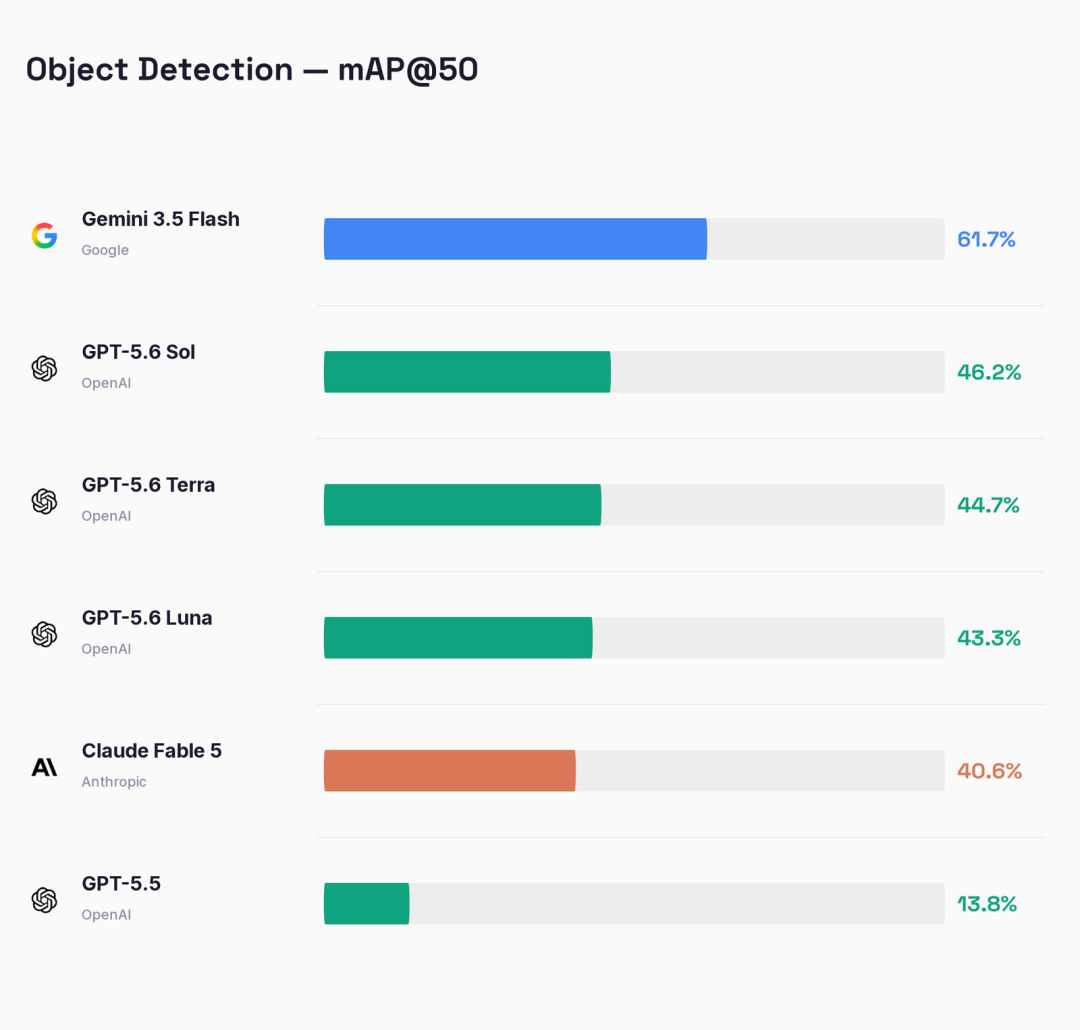
Roboflow testete die GPT-5.6-Familie – Sol, Terra und Luna – anhand eines Vision-Language-Modell-Benchmarks, der Objekterkennung, Objektzählung, OCR und gezielte Datenextraktion abdeckt. Das auffälligste Ergebnis stammte aus der Objekterkennung: GPT-5.5 erzielte nur 13,8 mAP@50, während GPT-5.6 Sol 46,2 erreichte – mehr als das Dreifache des vorherigen Ergebnisses in Roboflows Benchmark zur Markteinführung.
Auch Terra und Luna verbesserten sich deutlich und erreichten 44,7 bzw. 43,3.
Roboflows Piotr Skalski beschrieb Sol als das bis dahin stärkste Vision-Modell, das OpenAI veröffentlicht hatte. Diese Schlussfolgerung bezieht sich speziell auf Roboflows Bewertung und sollte nicht als universelle Rangfolge über alle Computer-Vision-Aufgaben verstanden werden, aber die Verbesserung gegenüber GPT-5.5 ist erheblich.
Die Verbesserungen sind jedoch nicht einheitlich. Sol verbessert sich stark beim Lokalisieren von Objekten, beim Zählen, beim Verstehen räumlicher Beschränkungen und beim Erkennen von Dokumentbereichen, übertrifft GPT-5.5 jedoch nicht bei jeder OCR-ähnlichen Aufgabe. Es zeigt außerdem ein spezifisches Fehlermuster bei sehr großen Bildern, bei denen Begrenzungsrahmen instabil werden können.
Das Ergebnis ist ein nützlicheres Bild als eine einfache Schlagzeile über das „beste Vision-Modell": GPT-5.6 ist deutlich leistungsfähiger bei visuellen Aufgaben, aber die Modellwahl hängt weiterhin von Genauigkeit, Latenz, Kosten, Bildgröße und der genauen Aufgabe ab.
Objekterkennung war historisch ein Schwachbereich für Allzweck-GPT-Modelle.
Die Aufgabe klingt einfach: Jedes relevante Objekt in einem Bild identifizieren und einen Begrenzungsrahmen darum zurückgeben. In der Praxis muss ein Vision-Language-Modell die Zielkategorie korrekt verstehen, jede Instanz lokalisieren, Koordinaten im erforderlichen Format generieren und Duplikate oder falsch platzierte Rahmen vermeiden.
In Roboflows Benchmark hatte GPT-5.5 dabei große Schwierigkeiten.
GPT-5.6 verändert das Bild.
| Modell | Objekterkennung mAP@50 |
|---|---|
| Gemini 3.5 Flash | 61,7 |
| GPT-5.6 Sol | 46,2 |
| GPT-5.6 Terra | 44,7 |
| GPT-5.6 Luna | 43,3 |
| Claude Fable 5 | 40,6 |
| GPT-5.5 | 13,8 |
Diese Werte stammen aus dem Roboflow-Benchmark-Schnappschuss, der im ursprünglichen Artikel und in der Roboflow-Analyse vom Juli 2026 diskutiert wird. Roboflows Live-Benchmark kann sich ändern, wenn sich Datensätze, Testumgebungen, Modellversionen und Leaderboard-Methodik weiterentwickeln.
Eines der nützlichsten Beispiele ist die Dokument-Layout-Analyse.
Sol konnte Bereiche wie folgende identifizieren:
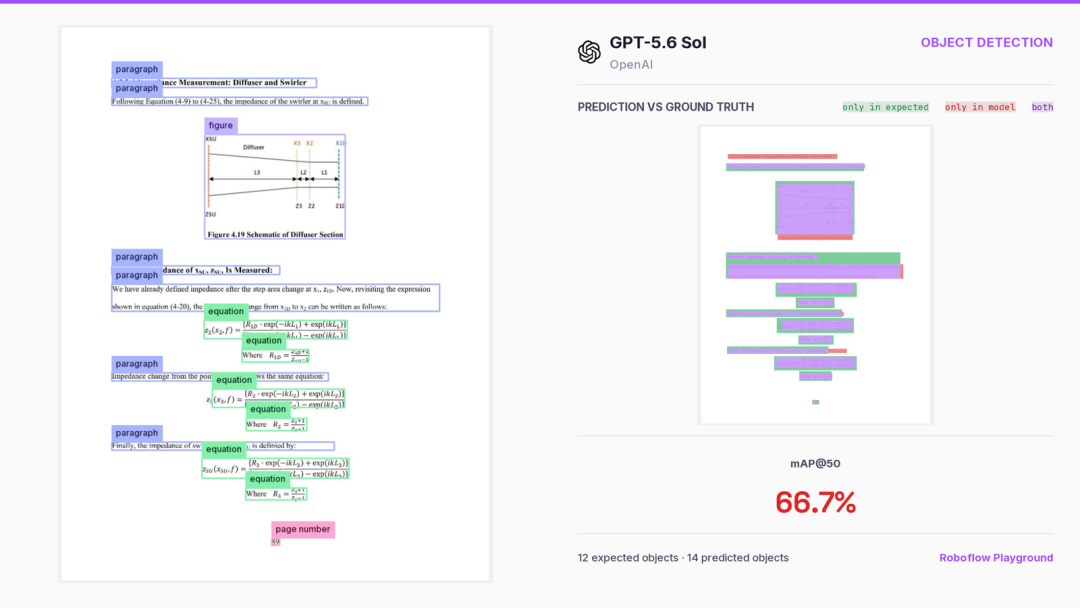
Dies ist für Dokumentenverarbeitungs-Pipelines von Bedeutung, da OCR oft nicht der erste Schritt ist.
Ein typisches System muss zunächst die Frage beantworten:
Wo befindet sich der relevante Inhalt auf dieser Seite?
Erst dann ist es sinnvoll, Text zu transkribieren, ein Datum zu extrahieren, eine Tabelle zu lesen oder eine Region an einen spezialisierten Parser weiterzuleiten.
Für Verträge, Rechnungen, Formulare, Berichte und gescannte PDFs kann eine bessere Regionserkennung daher den gesamten nachgelagerten Workflow verbessern.
Roboflow stellte fest, dass GPT-5.6 am besten abschneidet, wenn bei Objekterkennungs-Prompts absolute XYXY-Pixelkoordinaten angefordert werden.
Dieses Detail wird leicht übersehen.
Laut Roboflow reduzierte eine falsche Koordinatendarstellung die Erkennungsleistung von GPT-5.6 in den Tests um etwa 15 mAP-Punkte. Gemini 3.5 Flash verhielt sich anders und zeigte die beste Leistung mit normalisierten YXYX-Koordinaten auf einer Skala von 0–1000.
Das bedeutet, dass die Benchmark-Qualität – und die reale Produktionsqualität – stark vom angeforderten Ausgabeformat abhängen kann.
Eine praktische GPT-5.6-Erkennungsanweisung würde daher die Koordinatenkonvention explizit festlegen, anstatt vage nach „Begrenzungsrahmen" zu fragen.
Dichte Bilder sind für die VLM-basierte Objekterkennung schwierig, da das Modell Objektlabels und Koordinaten normalerweise als Text ausgibt.
Je mehr Objekte vorhanden sind, desto länger wird diese Ausgabe. Das schafft mehr Möglichkeiten für:
Roboflow testete Szenen mit vielen dicht beieinanderliegenden, visuell ähnlichen Objekten, darunter Pillen und Eier.
Sol bewältigte diese Fälle weitaus besser als frühere OpenAI-Modelle.
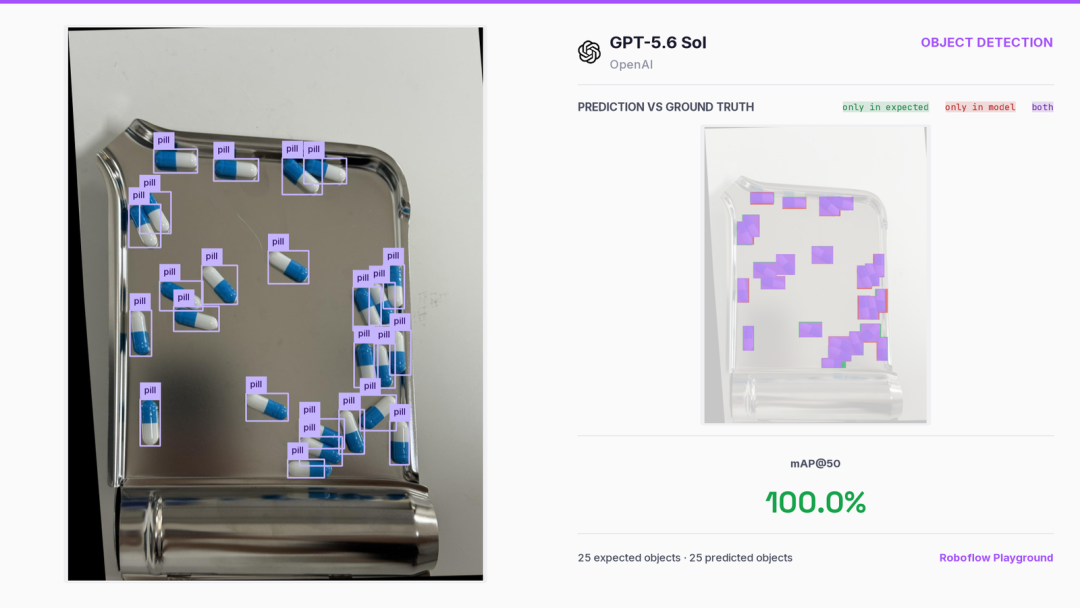
Das Ergebnis deutet darauf hin, dass GPT-5.6 sich über die bloße Erkennung des Gesamtinhalts eines Bildes hinaus in Richtung strukturierterer Lokalisierungsarbeit bewegt.
Das macht es nicht zu einem Ersatz für jeden spezialisierten Detektor. Spezialisierte Objekterkennungsmodelle können in eingeschränkten Produktionsumgebungen weiterhin schneller, kostengünstiger, einfacher zu kalibrieren oder zuverlässiger sein. Aber die Kluft zwischen einem allgemeinen multimodalen Modell und einer spezialisierten Vision-Pipeline wird deutlich kleiner.
Die Zählung verbesserte sich bei Sol, Terra und Luna.
Roboflow berichtete:
| Modell | Zählgenauigkeit |
|---|---|
| GPT-5.6 Sol | 73,0% |
| GPT-5.6 Terra | 67,6% |
| GPT-5.6 Luna | 66,2% |
| GPT-5.5 | 64,9% |
Die Verbesserung ist besonders bemerkenswert
für Sol, aber selbst Luna – das günstigste Modell der GPT-5.6-Familie – übertraf GPT-5.5 in diesem Benchmark.
Einige Beispiele von Roboflow erforderten mehr, als nur eine Gesamtzahl sichtbarer Objekte zurückzugeben.
In einem Test musste Sol nur Einschusslöcher innerhalb bestimmter Wertungszonen auf einer Zielscheibe zählen. Das erforderte zwei Ebenen visueller Schlussfolgerung:
Das Modell war bei dem von Roboflow hervorgehobenen Beispiel erfolgreich.
Das kommt der realen visuellen Automatisierung näher, als einfach zu fragen: „Wie viele Objekte sind in diesem Bild?“
Anwendungen enthalten häufig Bedingungsregeln wie:
Ein allgemeines multimodales Modell, das Erkennung mit Regeln in natürlicher Sprache kombinieren kann, ist in Workflows nützlich, in denen sich die visuelle Logik häufig ändert.
Der Benchmark enthält auch Beispiele, die schwierig bleiben.
Blisterverpackungen waren eine Herausforderung, da befüllte und leere Fächer bei Reflexionen sehr ähnlich aussehen können. Sich wiederholende Layouts können das Modell zusätzlich verwirren.
Roboflow zeigte außerdem ein Beispiel mit ungewöhnlichen Süßigkeiten, bei dem Sol eine falsche Anzahl zurückgab. Es war nicht klar, ob das Modell beim Zählen scheiterte oder missverstand, welche Objekte zur angefragten Kategorie gehörten.
Diese Unterscheidung ist in Produktionssystemen wichtig.
Eine falsche Anzahl kann mehrere verschiedene Ursachen haben:
Erkennungsfehler
Kategorienmissverständnis
Missverständnis räumlicher Regeln
Doppelte Erkennung
Übersehenes Objekt
Koordinatenfehler
Die endgültige Zahl allein verrät nicht, in welcher Stufe der Fehler aufgetreten ist.
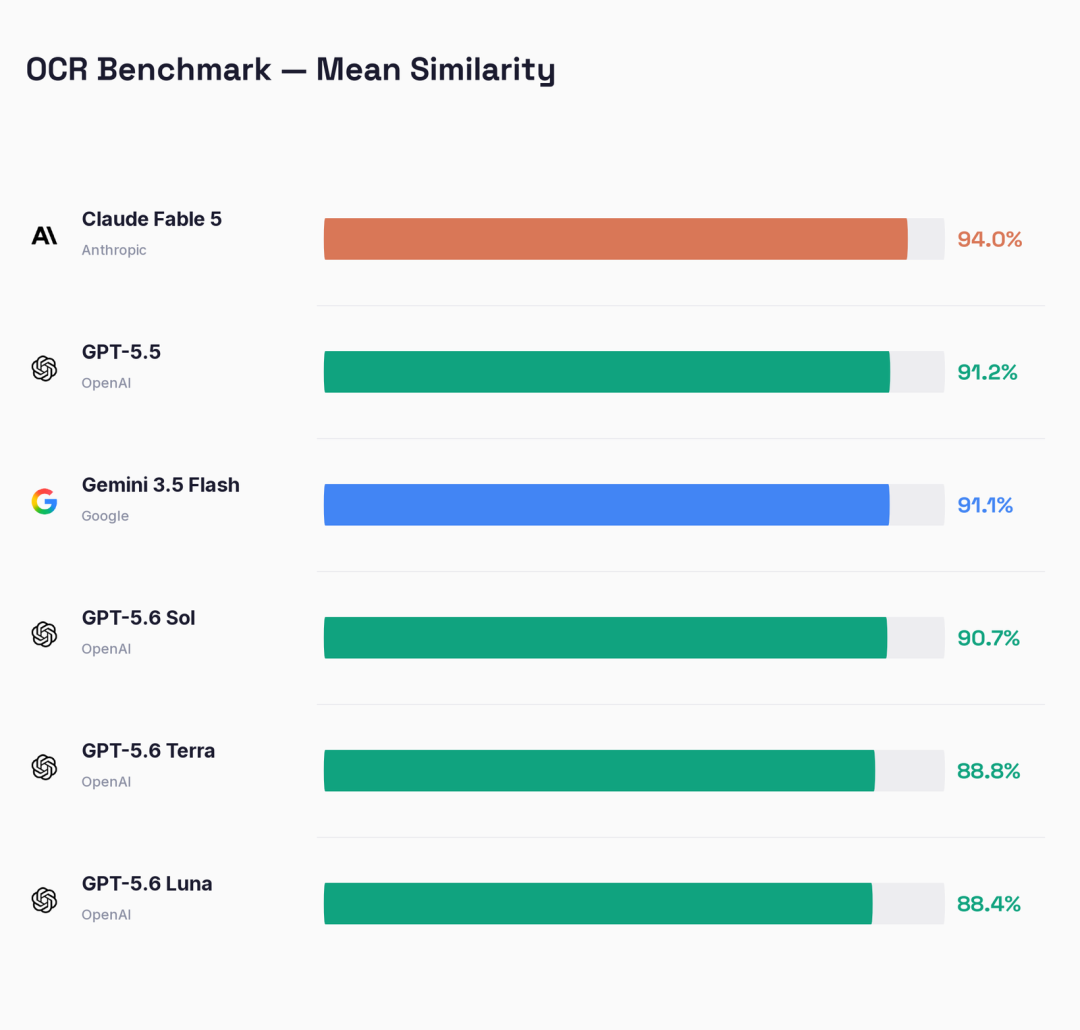
Der kontraintuitivste Teil des Benchmarks ist OCR.
Sol's Ergebnis für die Transkription von Volltext betrug 90,7 %, knapp unter GPT-5.5 mit 91,2 %.
Der Unterschied ist gering, bedeutet aber, dass das neue Flaggschiff nicht in jeder visuellen Kategorie Verbesserungen erzielte.
Roboflow trennte zwei verwandte Aufgaben:
Die zweite Kategorie zeigte eine größere Regression.
| Modell | OCR | Gezielte Textextraktion |
|---|---|---|
| GPT-5.5 | 91,2 % | 87,6 % |
| GPT-5.6 Sol | 90,7 % | 82,5 % |
| GPT-5.6 Terra | 88,8 % | 79,4 % |
| GPT-5.6 Luna | 88,4 % | 81,4 % |
Sol's Extraktionswert fiel in diesem Benchmark-Schnappschuss gegenüber GPT-5.5 um mehr als fünf Punkte.
Das Modell bewältigte dennoch mehrere schwierige Beispiele gut.
Roboflow zeigte, wie Sol handschriftliche
Notizen mit hoher Zeichenähnlichkeit.
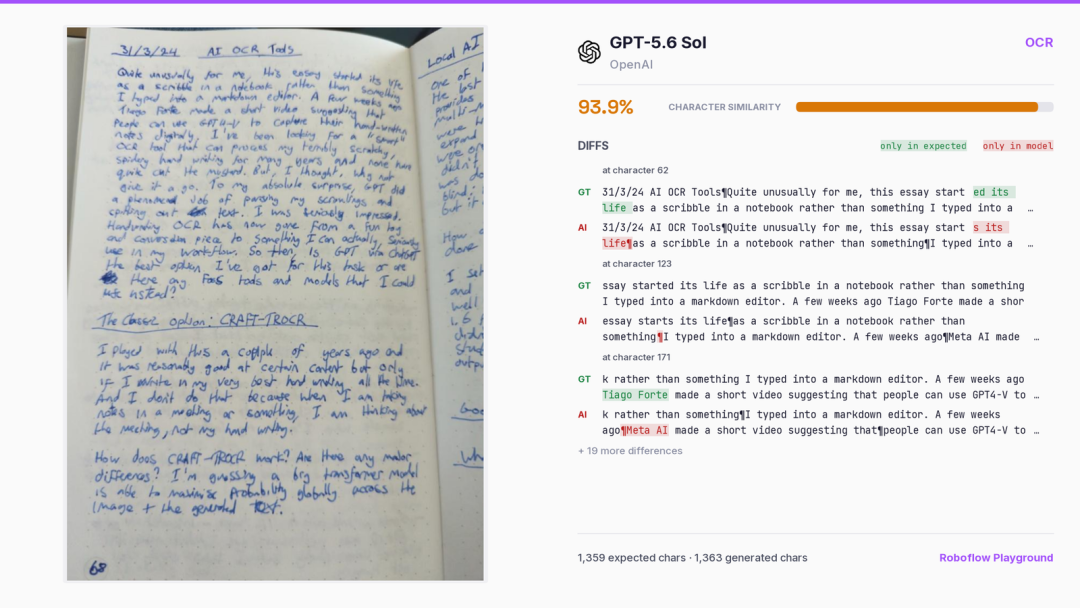
Außerdem las es erfolgreich Text aus optisch komplexen Szenen, darunter eine reifengroße Beschriftung auf einer schmutzigen, gekrümmten Oberfläche und eine Live-Anzeige in einer Hockey-Übertragung.
Diese Beispiele zeigen, dass die OCR-Einschränkung des Modells nicht einfach „kleiner Text ist unmöglich“ ist.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Seine Leistung hängt von Kontrast, Ausrichtung, Reflexionen, Schriftgröße, umgebender visueller Unordnung und der genauen Extraktionsanweisung ab.
Eines der deutlichsten Versagen betraf ein Verfallsdatum auf einer Blisterpackung.
Der Text war klein, vertikal ausgerichtet, kontrastarm und von reflektierender Verpackung beeinflusst.
Sol konnte das angeforderte Datum nicht korrekt extrahieren.
Dies ist eine nützliche Erinnerung für Dokument- und Industrieworkflows: Beeindruckende Beispiele bei Handschrift oder Übertragungsgrafik garantieren keine Zuverlässigkeit bei Verpackungen, geprägtem Text, reflektierenden Materialien oder winzigen kontrastarmen Etiketten.
Bei kritischen Extraktionen sollte die Modellausgabe weiterhin gegen eine spezielle OCR-Engine, einen deterministischen Parser, ein Barcodesystem oder einen menschlichen Überprüfungsprozess validiert werden, wo dies angemessen ist.
Roboflow entdeckte einen weiteren wichtigen Fehlermodus bei der Objekterkennung.
Bei einigen Bildern lieferte Sol Begrenzungsrahmen in Bildbereichen, die kaum oder gar keine Überlappung mit den tatsächlichen Objekten hatten. Die falschen Rahmen erschienen manchmal in unnatürlich regelmäßigen Mustern, wie Reihen oder gleichmäßig verteilten Gruppen.
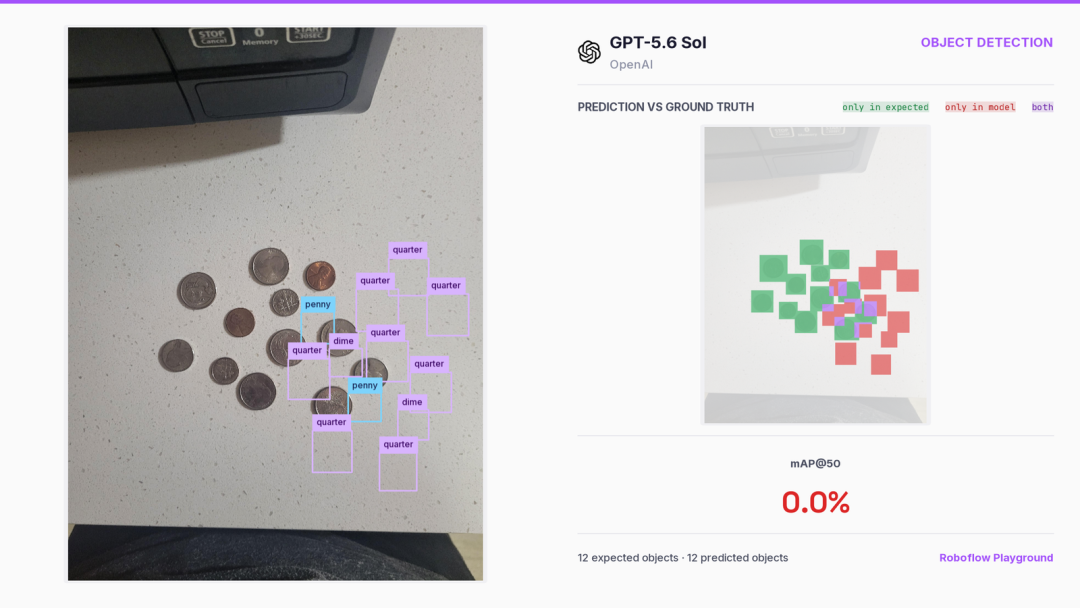
Roboflow gibt an, diese Beispiele mit OpenAI geteilt zu haben und die Antwort erhalten zu haben, dass Sol bei Bildern um 2.000 × 2.000 Pixel oder größer weniger stabil wird, insbesondere bei geringerem Denkaufwand.
Diese Klarstellung stammt aus Roboflows Bericht und nicht aus einer eigenständigen OpenAI-Dokumentationsseite, daher ist es am besten als eine Einschränkung zu beschreiben, die Roboflow zufolge OpenAI bestätigt hat.
Ein höherer Denkaufwand verbesserte die Stabilität in Roboflows Tests.
Der Kompromiss ist einfach:
Höherer Denkaufwand
→ mehr Tokens
→ höhere Latenz
→ höhere Kosten
Dies kann für die Analyse von wenigen, aber wertvollen Bildern sinnvoll sein, bei denen eine fehlgeschlagene Erkennung teuer ist.
Für sehr große Stapel ist es weniger attraktiv.
Roboflow empfiehlt in der Praxis, große Bilder vor dem Senden an die API zu verkleinern oder zuzuschneiden.
Dies kann auf zwei Arten helfen:
Für die Dokumentenverarbeitung kann das Kacheln oder Zuschneiden eines großen Scans in sinnvolle Regionen auch die
Aufgabe einfacher zu bewerten und erneut zu versuchen.
Die visuellen Verbesserungen haben ihren Preis.
In Roboflows Juli-Benchmark sahen die geschätzten Kosten pro Bild und die Latenz ungefähr so aus:
| Modell | Ungefähre Kosten pro Bild | Ungefähre Latenz |
|---|---|---|
| GPT-5.6 Sol | 0,025 $ | ~10 s |
| GPT-5.6 Terra | 0,01 $ | ~6 s |
| GPT-5.6 Luna | < 0,005 $ | ~5 s |
| Gemini 3.5 Flash | 0,008 $ | Schneller als Sol im zitierten Vergleich |
Dies sind benchmarkspezifische Schätzungen, keine festen API-Preise pro Bild. Die Bildkosten hängen von Bildabmessungen, Prompt-Länge, Ausgabetokens, Reasoning-Aufwand, Anbietereinstellungen und aktuellen Token-Preisen ab.
Die aktuellen API-Preise von OpenAI unterscheiden sich auch innerhalb der GPT-5.6-Familie erheblich. Sol ist die Premium-Stufe, Terra die ausgewogene Stufe und Luna ist für stark frequentierte, kosten敏感的 Workloads optimiert.
Das macht Luna besonders interessant, wenn ein Workflow das verbesserte visuelle Verhalten der GPT-5.6-Generation benötigt, sich aber Sol nicht für jedes Bild leisten kann.
Die Schlussfolgerung des ursprünglichen Artikels ist nicht, dass GPT-5.6 jetzt alle Vision-Benchmarks dominiert.
Im Juli-Vergleich von Roboflow blieb Gemini 3.5 Flash bei Objekterkennung und Zählung vor GPT-5.6 Sol, während es deutlich weniger pro Bild kostete.
Das macht Gemini 3.5 Flash attraktiv für hochfrequente Workloads wie:
Die offizielle Gemini-Dokumentation von Google beschreibt Gemini 3.5 Flash als multimodales Modell, das Bild-, Video-, Audio-, Text- und PDF-Eingaben mit einem Kontextfenster von 1 Million Tokens unterstützt. Die API-Preise sind ebenfalls für Produktionsnutzung mit hohem Durchsatz ausgelegt.
Die praktische Wahl ist daher workloadspezifisch.
GPT-5.6 Sol könnte die bessere Wahl sein, wenn:
Terra oder Luna können besser sein, wenn:
Eine abgestufte Pipeline kann oft wirtschaftlicher sein, als jedes Bild direkt an das Flaggschiff-Modell zu senden.
Die wichtigste Änderung bei GPT-5.6 ist nicht, dass es plötzlich eine perfekte OCR-Engine oder ein dedizierter Detektor wurde.
Es ist, dass visuelle Fähigkeiten innerhalb breiterer Agenten-Workflows nutzbar werden.
Sol kann zunehmend kombinieren:
Der Launch von GPT-5.6 durch OpenAI betont stärkere Computernutzung, multimodales Reasoning und agentische Workflows. Roboflows Benchmark hilft zu zeigen
wie diese Verbesserungen auf der Ebene der niedrigeren visuellen Verarbeitung aussehen.
Für Entwickler ist dieser Unterschied von Bedeutung.
Ein traditionelles Computer-Vision-System kann separate Modelle für Erkennung, OCR, Dokumentanalyse und nachgelagertes Denken erfordern. Ein modernes VLM kann mehrere dieser Operationen über eine einzige Schnittstelle ausführen, obwohl spezialisierte Modelle es in Bezug auf Genauigkeit, Kosten, Geschwindigkeit oder Vorhersehbarkeit weiterhin übertreffen können.
Die nächste Stufe des VLM-Wettbewerbs dreht sich daher weniger darum, ob ein Modell ein Bild beschreiben kann, sondern mehr darum, ob es strukturierte visuelle Aufgaben zuverlässig genug ausführen kann, um in der Produktion nützlich zu sein.
Die Roboflow-Ergebnisse weisen auf einige praktische Regeln für Entwickler hin, die GPT-5.6 bei visuellen Arbeitslasten testen.
Roboflow beschrieb GPT-5.6 Sol als das stärkste OpenAI-Vision-Modell, das es zu diesem Zeitpunkt getestet hatte. OpenAI positioniert Sol auch als das Flaggschiffmodell von GPT-5.6 und unterstützt offiziell Bildeingabe, aber "am besten" hängt weiterhin von der visuellen Aufgabe und dem Benchmark ab.
Im Roboflow-Benchmark vom Juli 2026 erreichte GPT-5.5 13,8 mAP@50, während GPT-5.6 Sol 46,2 erreichte. Das ist mehr als eine Verdreifachung des gemeldeten Wertes.
Es ist leistungsfähig, aber der Benchmark zeigt keine universelle Verbesserung. Sol erreichte 90,7% im Roboflow-OCR-Test gegenüber 91,2% für GPT-5.5, und der Wert für gezielte Text-Extraktion lag in dieser Bewertung ebenfalls niedriger als bei GPT-5.5.
Roboflow empfiehlt, für GPT-5.6-Erkennungsaufgaben absolute XYXY-Koordinaten in Bildpixeln anzufordern. Die Tests zeigten, dass das Koordinatenformat einen erheblichen Einfluss auf die gemessene Leistung hatte.
Roboflow sagt, OpenAI habe bestätigt, dass Sol bei etwa 2.000 × 2.000 Pixeln oder mehr instabil werden kann, insbesondere bei geringerem Denkaufwand. Das Verkleinern oder Beschneiden des Bildes oder die Erhöhung des Denkaufwands verbesserten in Roboflow-Tests die Ergebnisse.
Ja. Luna erreichte 43,3 mAP@50 bei der Objekterkennung und 66,2% beim Zählen im zitierten Roboflow-Benchmark, beides deutlich stärker als das Erkennungsergebnis von GPT-5.5. OpenAI positioniert Luna als die kostengünstigste GPT-5.6-Stufe, was sie zu
relevant für Hochlast-Workloads.
Nicht universell, aber es blieb stärker bei den von Roboflow zitierten Benchmarks für Objekterkennung und Zählung, während es in diesem Benchmark auch pro Bild günstiger war. Sol kann weiterhin vorzuziehen sein, wenn Vision in komplexere Denk- oder Agenten-Workflows eingebettet ist.
Manchmal, aber nicht automatisch. Ein allgemeines VLM kann gemischte visuelle Workflows vereinfachen, während dedizierte Detektoren und OCR-Systeme für eng begrenzte Produktionsaufgaben weiterhin bessere Latenz, vorhersehbare Ausgaben, Domänenoptimierung oder geringere Kosten bieten können.
Roboflow-Benchmark zeigt eine deutliche Verbesserung der praktischen visuellen Fähigkeiten von GPT-5.6. Sols Objekterkennungsergebnis stieg von 13,8 mAP@50 bei GPT-5.5 auf 46,2, während die Zählung auf 73% verbesserte. Auch Terra und Luna erzielten große Gewinne, was darauf hindeutet, dass das visuelle Upgrade über die gesamte Familie reicht und nicht nur auf das Flaggschiff beschränkt ist.
Die Verbesserung ist nicht universell. OCR blieb nahe bei GPT-5.5, die gezielte Textextraktion ging im zitierten Benchmark zurück, und große Bilder können instabile Begrenzungsrahmen erzeugen. Kosten und Latenz bleiben ebenfalls wichtig, wobei Gemini 3.5 Flash eine starke
Position für Hochvolumen-Erkennung und -Zählung im Vergleich von Roboflow.
GPT-5.6 Sol ist ein wesentlich glaubwürdigerer allgemeiner Vision-Arbeiter als GPT-5.5, aber Produktionsteams sollten Modelle weiterhin nach Aufgabe, Bildgröße, Zuverlässigkeit, Latenz und Kosten auswählen – nicht nach einem einzigen Schlagzeilen-Benchmark.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



