For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/gpt-55-codex-516-reasoning-token-clustering.md.
Dieser Artikel erläutert die von Entwicklern gemeldete Anomalie bei den `516` Reasoning-Token von GPT-5.5 Codex, einschließlich des wichtigs...
In den vergangenen Tagen haben Entwickler, die OpenAI Codex verwenden, über ein seltsames Muster diskutiert: Einige Antworten von GPT-5.5 scheinen bei einer sehr spezifischen Anzahl von Reasoning-Tokens zu stoppen — 516.
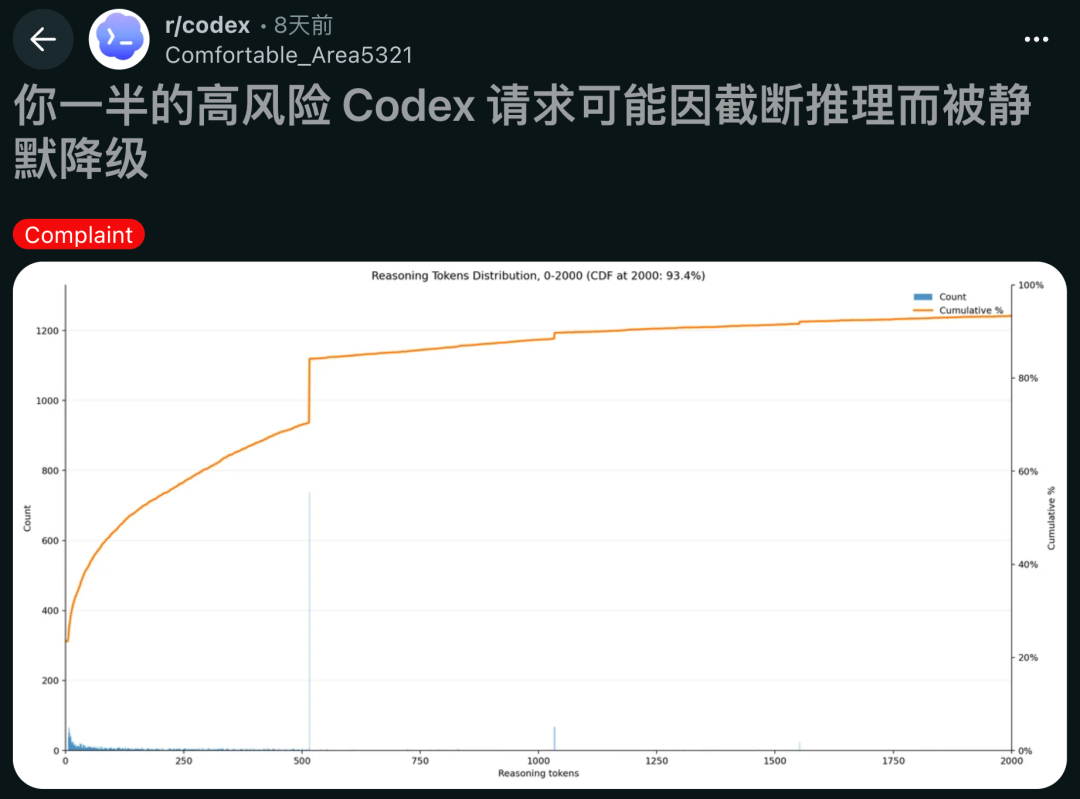
Der ursprüngliche Bericht belegt nicht, dass OpenAI das Schlussfolgern heimlich abschneidet. Die engere Aussage ist vorsichtiger formuliert: In Telemetriedaten, die in einem öffentlichen GitHub-Issue geteilt wurden, zeigt sich ein ungewöhnliches, GPT-5.5-spezifisches Clustering um reasoning_output_tokens = 516, mit zusätzlichen Spitzenwerten nahe 1034 und 1552.
Dieses Detail ist wichtig, weil Entwickler nicht nur fragen, ob GPT-5.5 Fehler macht. Sie fragen, ob das Modell bei komplexen Aufgaben manchmal einen kürzeren Schlussfolgerungspfad nimmt und dann Antworten zurückgibt, die weniger verlässlich wirken als erwartet.
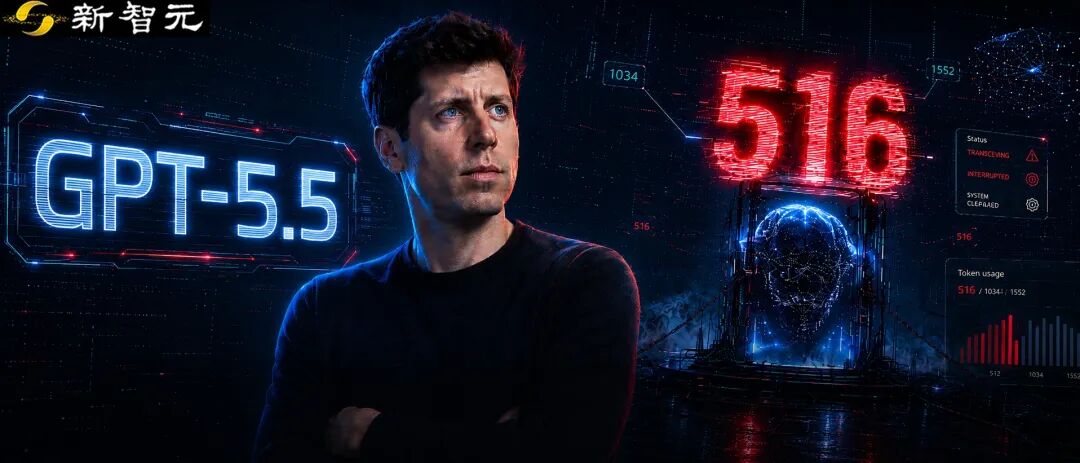
Die Diskussion begann mit einer überraschend spezifischen Zahl: 516.
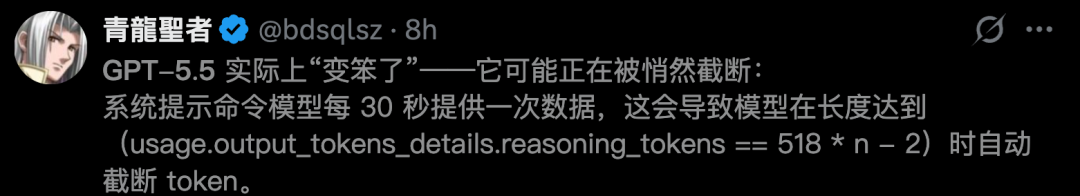
Laut Berichten von Entwicklern hat GPT-5.5 in letzter Zeit bei einigen komplexen Programmier- und Schlussfolgerungsaufgaben innerhalb von Codex schwächere Leistungen gezeigt. Auffällig war dabei nicht nur, dass das Modell manchmal falsche Antworten lieferte. Mehrere fehlgeschlagene oder verdächtige Antworten schienen an derselben Grenze bei den Reasoning-Tokens zu stoppen.
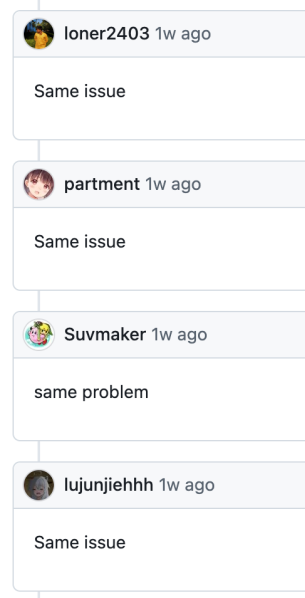
Anschließend beteiligten sich mehrere Codex-Nutzer an der Diskussion und erklärten, sie hätten ein ähnliches Verhalten beobachtet.
Die zentrale Frage ist einfach: Warum würde ein erstklassiges Reasoning-Modell wiederholt genau bei ein und derselben Token-Anzahl landen?
Die wichtigste öffentliche Referenz ist GitHub-Issue #30364, eröffnet im Repository openai/codex.
In diesem Issue meldete der Entwickler ein aggregiertes Muster in den token_count-Metadaten von Codex. Die Behauptung lautete, dass Antworten von gpt-5.5 überproportional häufig genau bei reasoning_output_tokens = 516 landeten, mit zusätzlichen festen Grenzwert-Spitzen um 1034 und 1552.

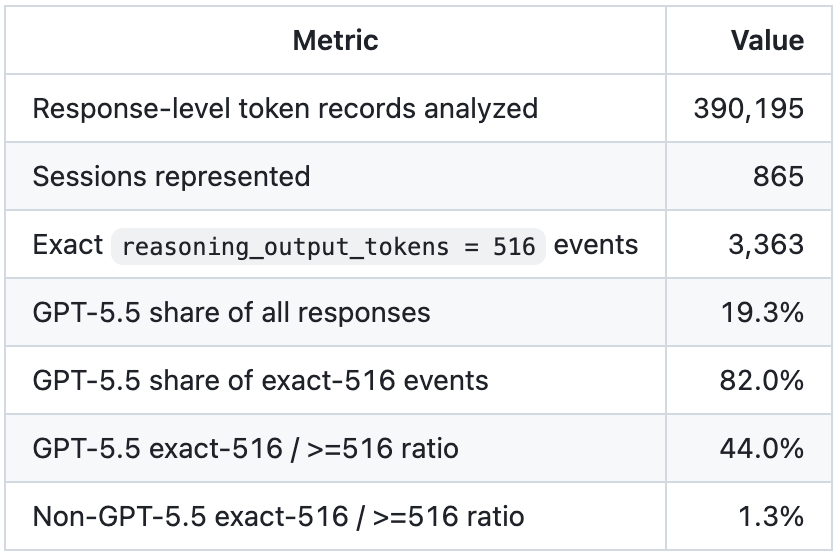
Der Bericht deckte ein Zeitfenster vom 1. Februar bis zum 27. Juni 2026 ab. Analysiert wurden 390.195 Token-Datensätze auf Antwortebene über 865 Sitzungen hinweg.
| Metrik | Wert |
|---|---|
| Analysierte Token-Datensätze auf Antwortebene | 390.195 |
| Repräsentierte Sitzungen | 865 |
Exakte Ereignisse mit reasoning_output_tokens = 516 | 3.363 |
| Anteil von GPT-5.5 an allen Antworten | 19,3 % |
| Anteil von GPT-5.5 an exakten 516-Ereignissen | 82,0 % |
| Verhältnis exakte 516 / >=516 bei GPT-5.5 | 44,0 % |
| Verhältnis exakte 516 / >=516 bei Nicht-GPT-5.5 | 1,3 % |
Das Issue verglich GPT-5.5 außerdem mit anderen Modellen der GPT-Familie. Die Lücke war groß genug, dass Entwickler vermuteten, es handle sich nicht bloß um eine normale Verteilung der Reasoning-Längen.
| Modell | Antwortdatensätze | Exakte 516 / >=516 |
|---|---|---|
gpt-5.5 | 75.401 | 44,0 % |
gpt-5.4 | 25.214 | 19,8 % |
gpt-5.2 | 247.575 | 0,34 % |
gpt-5.3-codex | 13.333 | 0,0 % |
gpt-5.3-codex-spark | 26.179 | 0,0 % |
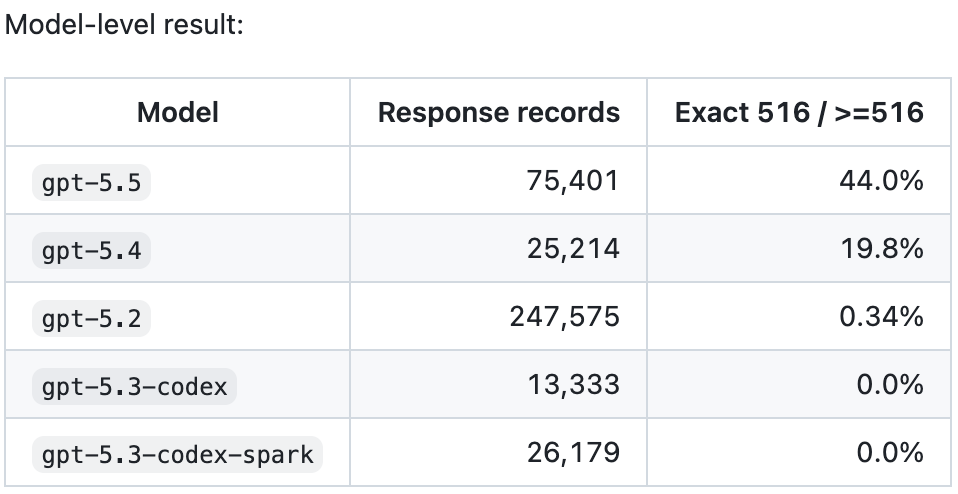
Der Originalartikel fasste den Punkt prägnant zusammen: GPT-5.5 machte nur einen Minderheitsanteil der Gesamtantworten aus, schien in diesem Datensatz jedoch für die meisten exakten 516-Ereignisse verantwortlich zu sein.
Die gesamte Intensität des Schlussfolgerns nahm ab
Eine mögliche Verteidigung wäre, dass GPT-5.5 einfach mehr nachdenkt, sodass natürlich mehr Antworten in höhere Bereiche von Reasoning-Tokens gelangen.
Doch die gemeldeten Daten weisen in die entgegengesetzte Richtung.
Im Mai und Juni, als die genaue 516er-Häufung Berichten zufolge deutlicher wurde, sank die gesamte Reasoning-Token-Intensität von GPT-5.5. Sowohl die durchschnittliche Anzahl der Reasoning-Tokens als auch die P90-Anzahl der Reasoning-Tokens lagen unter den Werten früherer Monate.
| Monat | Durchschnittliche Reasoning-Tokens | P90 Reasoning-Tokens |
|---|---|---|
| Feb 2026 | 268.1 | 772 |
| Mär 2026 | 256.8 | 723 |
| Apr 2026 | 228.7 | 669 |
| Mai 2026 | 106.9 | 344 |
| Jun 2026 | 168.5 | 515 |
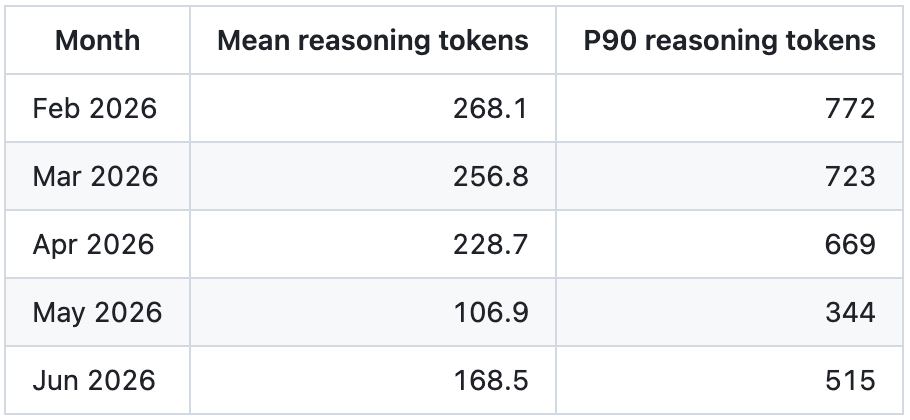
Deshalb empfanden Entwickler das Muster als unangenehm. Einerseits traten exakte 516er-Ereignisse häufiger auf. Andererseits schien das Modell insgesamt weniger Reasoning-Tokens zu verbrauchen.
Das führte zu einer ernsteren Sorge: Bei komplexen oder risikoreichen Aufgaben könnte GPT-5.5 mitunter an ein verborgenes Reasoning-Budget, einen Abschneidepunkt, eine Fallback-Route oder ein bestimmtes Scheduler-Verhalten stoßen, bevor es einen tieferen Schlussfolgerungspfad abgeschlossen hat.
Um es klar zu sagen: Dies bleibt eine von Entwicklern gemeldete Anomalie und ist keine offizielle Erklärung von OpenAI.
Die Diskussion auf GitHub zog schnell weitere Nutzer an, die angaben, ähnliche Probleme erlebt zu haben.
Das Problem steht auch im Zusammenhang mit einem früheren Bericht, #29353, in dem ein Entwickler ein reproduzierbares Muster in Codex Desktop bei der Verwendung von gpt-5.5 mit xhigh reasoning beschrieb.
In dieser Reproduktion gingen einige frische Durchläufe direkt zu einer endgültigen Antwort über, verwendeten genau 516 Reasoning-Output-Tokens und lieferten eine falsche Antwort zurück. Andere Durchläufe verbrauchten Tausende von Reasoning-Tokens, erzeugten eine sichtbare Zwischenphase und lieferten die erwartete Antwort zurück.
Dieser frühere Vorgang klärte die Frage nicht, ließ den späteren zusammenfassenden Bericht jedoch weniger isoliert erscheinen.
Die Diskussion verlagerte sich auch über GitHub hinaus. Screenshots im Originalartikel zeigen Entwickler, die darüber diskutieren, ob ein Teil risikoreicher Codex-Anfragen möglicherweise aufgrund einer Abschneidung des Schlussfolgerns stillschweigend herabgestuft wird.
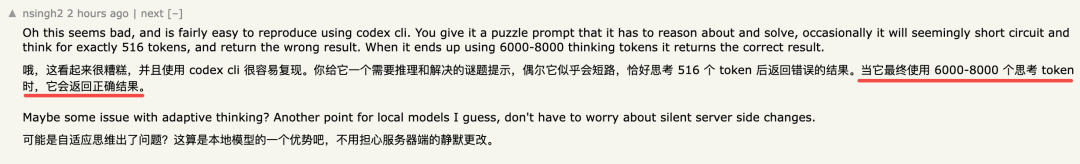
Ein im Artikel gezeigter Kommentar argumentierte, dass manche Reasoning-Probleme 6.000 bis 8.000 Denktokens benötigen, bevor die richtige Antwort erscheint. Wenn ein Modell in diesen Fällen bereits bei etwa 516 Tokens stoppt, könnte es die Antwort zu früh liefern.
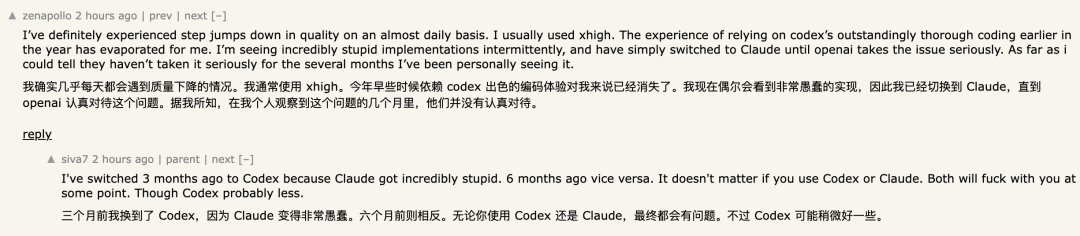
Ein weiterer Screenshot zeigte Nutzer, die Codex und Claude verglichen, wobei einige sagten, sie wechselten je nach Woche das Tool, je nachdem, welches sich gerade weniger kaputt anfühle.
Die zentrale Forderung der Community ist nicht kompliziert. Entwickler möchten, dass OpenAI oder das Codex-Team erklärt, was rund um 516, 1034 und 1552 geschieht.
Zu den offenen Fragen gehören:
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
516 ein normaler Stopppunkt, eine degradierte Stufe oder ein interner Schwellenwert?Das ursprüngliche GitHub-Issue behauptet vorsichtig nicht, damit sei eine versteckte Abschneidung der Chain-of-Thought bewiesen. Die stärkere Aussage lautet lediglich, dass die Häufung modellspezifisch und schwellenwertartig genug aussieht, um eine Untersuchung zu rechtfertigen.
Die zweite Hälfte des ursprünglichen Artikels verlagert den Fokus von der Leistung auf die Persönlichkeit.
Ein Entwickler namens Angel verglich ChatGPT mit GPT-5.5 Instant und Claude Fable 5 anhand von nebeneinander dargestellten Screenshots. Die Beschwerde betraf nicht die Frage, ob das Modell antworten konnte. Es ging darum, wie sich der Assistent verhielt.
Der Artikel hebt drei wiederkehrende Frustrationen hervor.
Die erste Beschwerde ist, dass ChatGPT selbst einfache gesprächsartige Antworten tendenziell überformatiert.
Als es gebeten wurde, natürlicher und weniger KI-haft zu sein, antwortete ChatGPT Berichten zufolge mit einer strukturierten Erklärung darüber, wie es natürlich sein würde. Claude dagegen gab eine
viel kürzere und lockerere Antwort.
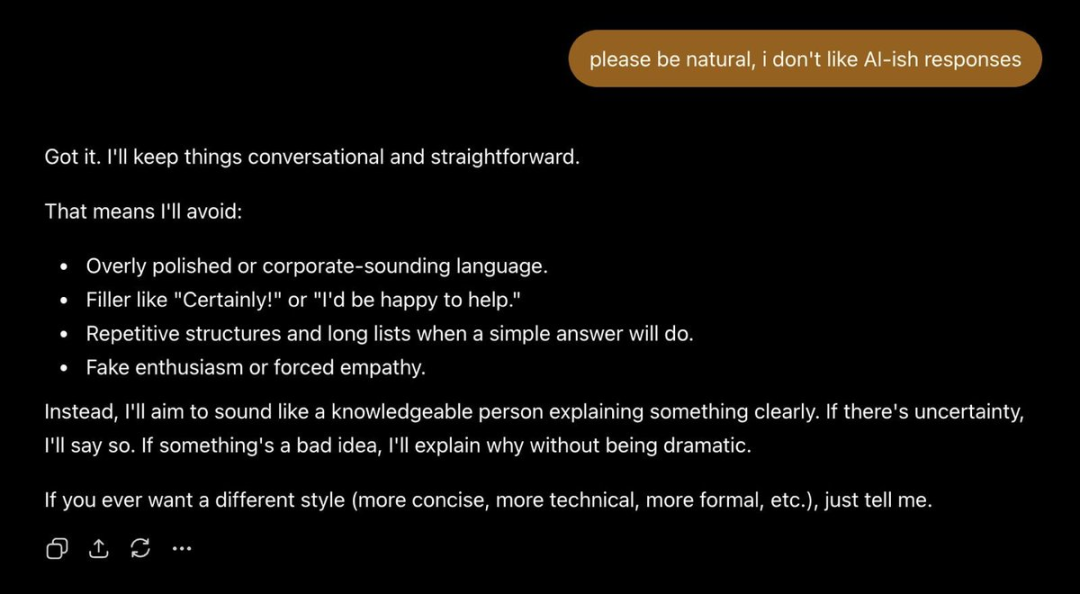
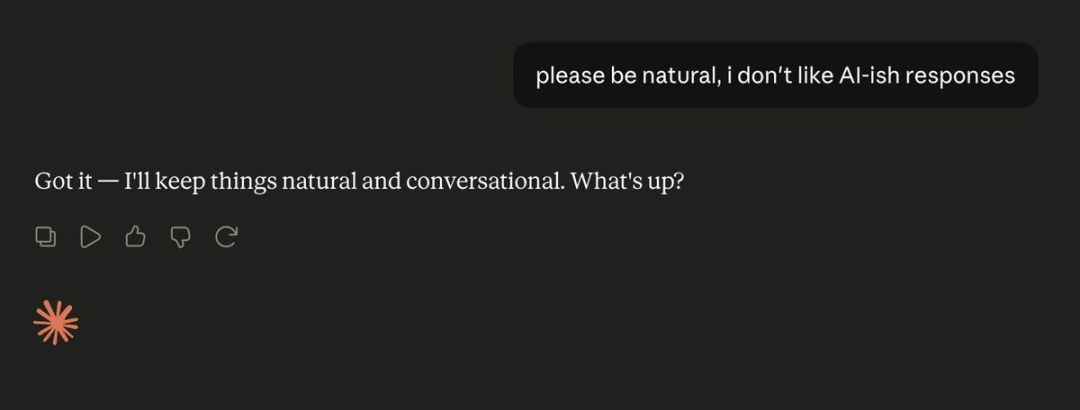
Das Problem ist nicht, dass Aufzählungspunkte immer schlecht sind. Bei technischen Erklärungen sind sie nützlich. Das Problem ist, dass sich ein Chat-Assistent steif anfühlen kann, wenn er aus jeder kleinen Anfrage Überschriften, Fettdruck, Listen und Anschlussvorschläge macht.
Die zweite Beschwerde betrifft übermäßiges Redigieren.
Wenn es gebeten wird, einen Satz oder einen Tweet zu prüfen, versucht ChatGPT oft, ihn zu verbessern, umzuschreiben oder Alternativen anzubieten, selbst wenn der Nutzer vielleicht nur ein einfaches „das ist so in Ordnung“ hören möchte.
Der Originalartikel stellt dem ein eher Claude-typisches Verhalten gegenüber, bei dem der Assistent häufiger sagt, dass der Text so akzeptabel ist, wie er ist, wenn keine echte Korrektur nötig ist.
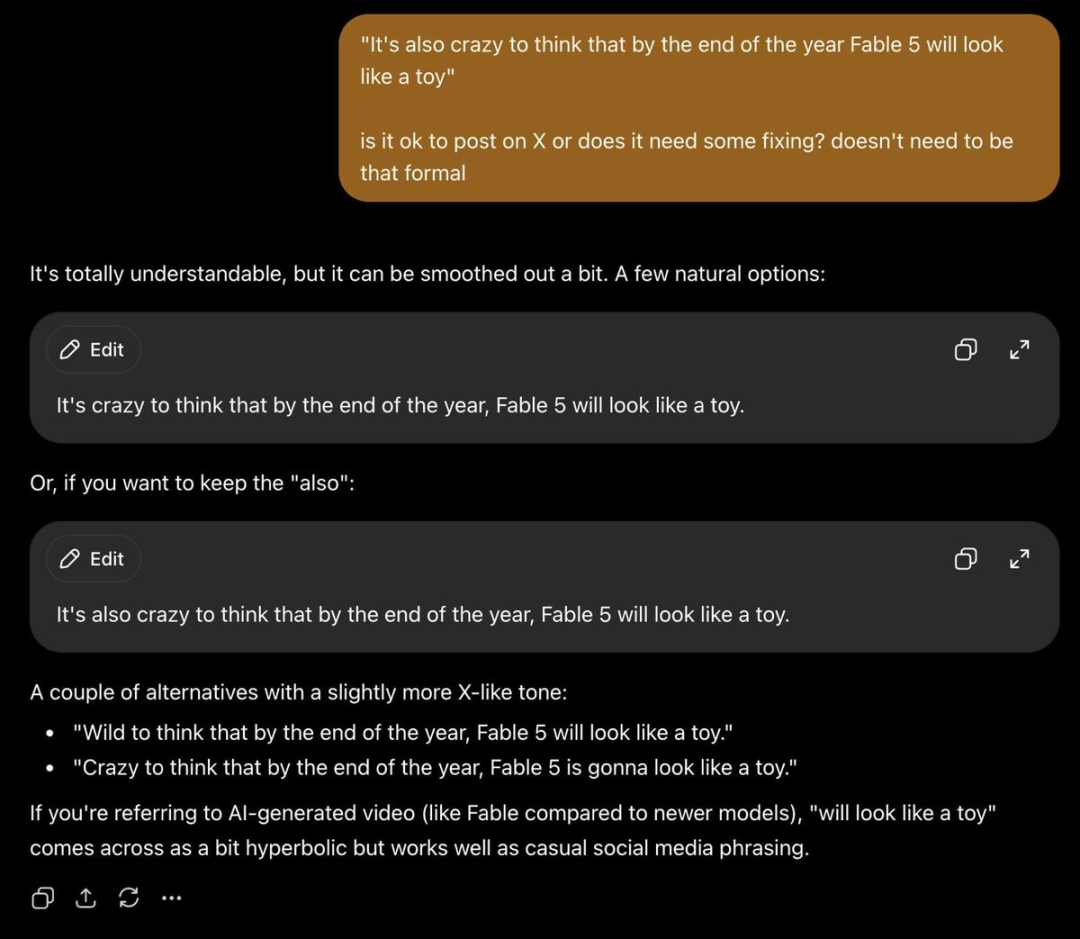
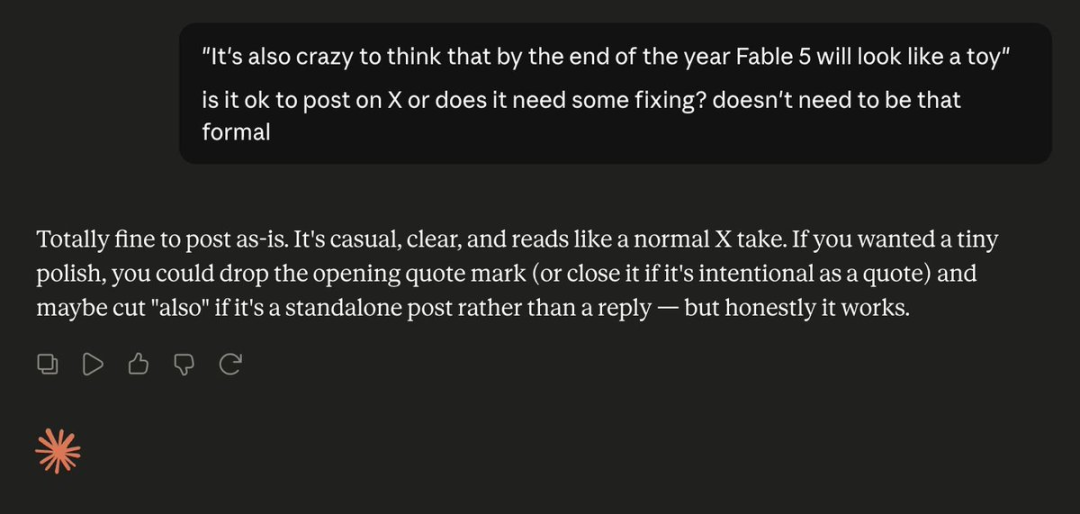
Für Nutzer, die locker schreiben, kann das Reibung erzeugen. Ein Modell, das den Nutzer ständig „korrigiert“, wirkt dann weniger wie ein Helfer und mehr wie ein strenger Lektor.
Die dritte Beschwerde ist, dass ChatGPT oft mehr liefert als verlangt.
Im Beispiel des Artikels bittet ein Nutzer um einen Witz. ChatGPT gibt einen Witz, fügt noch einen hinzu, dann einen dritten und fragt anschließend noch nach dem bevorzugten Humorstil des Nutzers. Claude gibt eine kürzere Antwort.
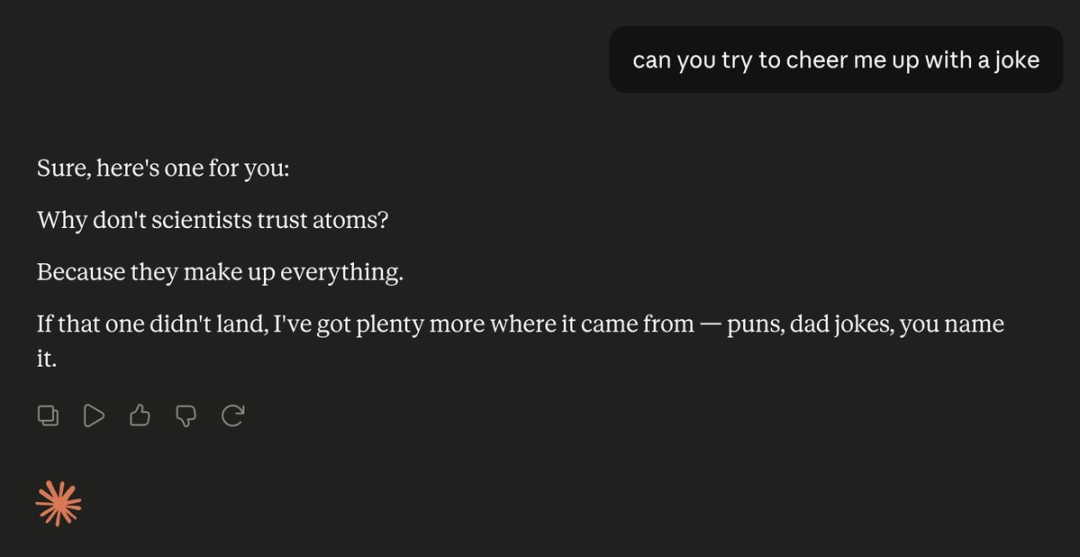
Dies ist ein subtils Produktproblem. Mehr Ausgabe kann in einem Benchmark hilfreich wirken, aber in einem Gespräch kann es sich so anfühlen, als würde der Assistent nicht zuhören.
Für einen Coding-Agenten ist Zuverlässigkeit entscheidend. Wenn ein Modell zu früh stoppt, einen kürzeren Denkpfad nimmt oder bei schwierigen Aufgaben an eine feste Token-Grenze stößt, müssen Entwickler das wissen. Sie verlassen sich auf diese Tools für Debugging, Code-Review, Architekturentscheidungen und Änderungen in Produktionsumgebungen.
Für einen Chat-Assistenten zählt auch die Persönlichkeit. Wenn jede Antwort übermäßig formatiert, überkorrigierend oder mit zu vielen Optionen überladen ist, wird die Nutzererfahrung mit der Zeit schwerfälliger.
Das übergreifende Argument des Artikels ist, dass beide Probleme auf dasselbe Produktrisiko hindeuten: Ein Assistent kann darin gut werden, „eine Antwort zu liefern“, und gleichzeitig schlechter darin werden, dem Nutzer im jeweiligen Moment tatsächlich zu helfen.
Damit sind Berichte von Entwicklern gemeint, wonach einige GPT-5.5-Codex-Antworten offenbar genau bei reasoning_output_tokens = 516 gehäuft auftreten. Die wichtigste öffentliche Referenz ist GitHub-Issue #30364 im Repository openai/codex. Dem Issue zufolge ist dieses Muster bei GPT-5.5 deutlich ausgeprägter als bei mehreren anderen Modellen.
Nein. Das GitHub-Issue selbst sagt, dass es keine versteckte Abschneidung der Chain-of-Thought beweist. Die vorsichtigere Schlussfolgerung ist, dass die gemeldeten Daten ein ungewöhnliches Muster fester Token-Häufungen zeigen, das mit einem schwellenwertbasierten Verhalten des Reasoning-Budgets vereinbar sein könnte.
Die Zahl ist wichtig, weil sich wiederholende exakt gleiche Stopppunkte weniger natürlich anfühlen können als eine normale Verteilung unterschiedlicher Reasoning-Längen. Im gemeldeten Datensatz traten 516, 1034 und 1552 als Spitzen an festen Grenzen auf. Entwickler fragen, ob diese durch ein Budget, Routing-Verhalten, einen Fallback-Pfad oder einen anderen Backend-Mechanismus verursacht werden.
OpenAI Codex ist ein Coding-Agent für die Softwareentwicklung. Laut der Entwicklerdokumentation von OpenAI kann Codex beim Lesen von Codebasen, beim Bearbeiten von Dateien, beim Beheben von Bugs, bei Code-Reviews und bei Softwareaufgaben in lokalen oder Cloud-Umgebungen helfen.
Die öffentliche Diskussion konzentriert sich hauptsächlich auf Codex und Metadaten von Codex Desktop. Die stärksten Behauptungen im Artikel beziehen sich auf token_count-Daten von Codex und GitHub-Issues im Repository openai/codex. Es sollte nicht auf jede Nutzung von ChatGPT oder der OpenAI-API verallgemeinert werden.
Fall ohne separate Belege.
Der Artikel nutzt den Vergleich, um über die „Persönlichkeit“ von Assistenten zu sprechen, nicht nur über die reine Reasoning-Leistung. Screenshots zeigen Beschwerden darüber, dass ChatGPT zu stark strukturiert, zu stark korrigierend und zu eifrig darin sein kann, mehrere Optionen anzubieten, während Antworten im Stil von Claude manchmal kürzer und gesprächiger sind.
Entwickler sollten nach Möglichkeit reproduzierbare Beispiele, Metadaten, Zeitstempel, Modelleinstellungen und Aufgaben-Prompts sichern. Ein klarer Bericht mit Token-Anzahlen, erwartetem Verhalten, tatsächlichem Verhalten und Schritten zur Reproduktion ist hilfreicher als eine vage Beschwerde.
gpt-5.5, xhigh-Reasoning und exakt 516 Reasoning-Tokens.Dieser Artikel erklärt die von Entwicklern gemeldete GPT-5.5-Codex-516-Reasoning-Token-Anomalie, einschließlich des wichtigsten GitHub-
das Problem, die gemeldeten aggregierten Daten und die Sorge, dass einige komplexe Aufgaben möglicherweise zu früh beendet werden.
Es behandelt außerdem eine zweite Beschwerde zur Nutzererfahrung: ChatGPTs Tendenz, einfache Anfragen übermäßig zu formatieren, übermäßig zu korrigieren und übermäßig ausführlich zu beantworten. Dieser Teil der Diskussion ist subjektiver, ist aber wichtig, weil die Persönlichkeit des Assistenten die alltägliche Produkterfahrung direkt beeinflusst.
Der wichtige Punkt ist, das 516-Muster nicht als bewiesene versteckte Abschneidung zu betrachten. Die öffentlich verfügbaren Hinweise lassen sich besser als eine Anomalie im Modellverhalten verstehen, die untersucht werden sollte.
Für Entwickler ist die praktische Schlussfolgerung einfach: Wenn sich ein KI-Coding-Agent plötzlich deutlich schlechter anfühlt, sollte man Metadaten sammeln, Läufe vergleichen und reproduzierbare Muster melden, anstatt sich nur auf Eindrücke zu verlassen.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



