For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/gpt-6-1-sol-500k-context-codex-usage-and-f5e586e1.md.
Lange Programmiersitzungen sammeln mehr als Chatnachrichten an. Ein Agent benötigt zudem Platz für Quelldateien, Befehlsausgaben, Testfehler...
Lange Programmiersitzungen sammeln mehr als Chatnachrichten an. Ein Agent benötigt zudem Platz für Quelldateien, Befehlsausgaben, Testfehler und Entscheidungen, die früher in der Aufgabe getroffen wurden. Wenn dieser Arbeitskontext voll ist, muss der Agent ihn verdichten, bevor er fortfahren kann.
Ein Bericht des chinesischen KI-Nachrichtenportals Xinzhiyuan, der auf BAAI Hub erneut veröffentlicht wurde, beschreibt eine Erhöhung des Standardkontexts von GPT-6.1 Sol in Codex und ChatGPT Work von 272K auf 500K Token. Der Bericht schreibt die Ankündigung Thibault Sottiaux von OpenAI zu und erklärt, dass die Änderung einen separaten Zuschlag für langen Kontext bei der Nutzung über Abonnements abschafft. Das ist eine spezifischere Aussage als die Schlagzeile, die nahelegt, das Upgrade sei einfach „kostenlos“.
Die offizielle Dokumentation von OpenAI bestätigt die Verfügbarkeit von GPT-6.1 Sol und erläutert, wie die Nutzung gezählt wird. Die genaue Änderung auf 500K und die Ankündigung zum Wegfall des Zuschlags werden im Folgenden weiterhin dem zitierten Bericht und dem Screenshot der Ankündigung zugeschrieben; die geprüften offiziellen Dokumentationsseiten nannten diesen neuen Standardwert nicht unabhängig.
Der Wechsel von 272.000 auf 500.000 Token schafft ungefähr 84 % mehr Kapazität. Die Quelle rundet dies auf etwa 80 % ab. Ihr Screenshot der Ankündigung beschreibt außerdem ein maximales Kontextfenster von einer Million Token und besagt, dass Nutzer den Standardwert überschreiben können.
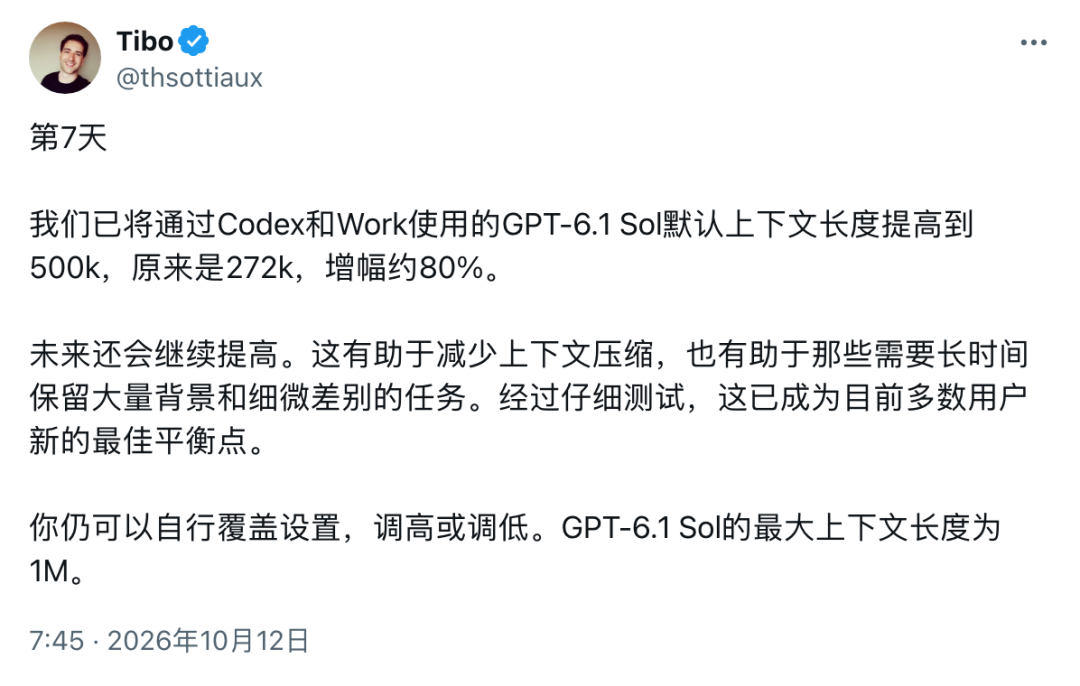
Quelle: ein chinesischsprachiger Screenshot von Thibault Sottiauxs Ankündigung, reproduziert von Xinzhiyuan auf BAAI Hub; die englische Beschreibung ist redaktionell.
Der praktische Vorteil besteht darin, dass mehr Aufgabenverlauf verfügbar bleiben kann, bevor eine Verdichtung erforderlich wird. Bei einer Änderung in einem Repository können dazu die ursprüngliche Kompatibilitätsanforderung, bereits untersuchte Dateien, gescheiterte Ansätze und die neuesten Testergebnisse gehören.
Ein größeres Fenster garantiert nicht, dass ein Agent jede Anforderung erinnert oder korrekte Änderungen vornimmt. Es verändert, wie viele Informationen im aktiven Kontext bleiben können; die Qualität seiner Entscheidungen muss weiterhin überprüft werden.
Bei der Verdichtung wird ein Teil des angesammelten Verlaufs durch eine kürzere Darstellung ersetzt. Dadurch kann ein Agent weiterarbeiten, ohne jede frühere Zeile der Tool-Ausgabe vollständig zu bewahren.
Der Nachteil besteht darin, dass ein verdichteter Verlauf nützliche Details verlieren kann. Eine Programmieraufgabe kann abgeschlossen wirken, obwohl eine frühere Anforderung fehlt, etwa die Beibehaltung eines alten API-Antwortformats. Mehr relevanter Kontext kann die Häufigkeit dieser Übergänge verringern, beseitigt aber nicht die Notwendigkeit von Regressionstests.
Die Konfigurationsreferenz von OpenAI dokumentiert model_context_window und model_auto_compact_token_limit. Dabei handelt es sich um unterschiedliche Einstellungen: Die eine beschreibt den verfügbaren Kontext des Modells, die andere legt fest, wann die automatische Verdichtung ausgelöst wird. Das Vorhandensein dieser Einstellungen belegt nicht, dass jedes Modell oder Konto dieselben Werte unterstützt.
Die Quelle unterscheidet zwischen einem Zuschlag für langen Kontext und dem gewöhnlichen Verbrauch innerhalb eines Abonnements. Eine Aufgabe kann weiterhin ein Kontingent verbrauchen, auch wenn kein zusätzlicher Multiplikator allein aufgrund ihres langen Kontexts angewendet wird.
Die offizielle Preisdokumentation von OpenAI stützt diese grundsätzliche Unterscheidung. Sie erklärt, dass die Nutzung von der Modellwahl, dem Kontext, dem Reasoning, Tool-Einsatz, Retrieval und Caching abhängt. Längere Aufgaben, die mehr Informationen behalten, können wesentlich mehr Kontingent verbrauchen als kurze, fokussierte Anfragen.
| Konzept | Was es beschreibt |
|---|---|
| Kontextkapazität | Wie viele Informationen das Modell während einer Anfrage oder Sitzung halten kann |
| Abonnementnutzung | Wie eine Aufgabe das enthaltene Kontingent oder Guthaben verbraucht |
| Zwischengespeicherte Eingabe | Zuvor verarbeitete Eingaben, die möglicherweise zu einem anderen Satz wiederverwendet werden können |
| API-Preise | Separate Kosten bei Authentifizierung und Bezahlung über einen API-Schlüssel |
Eine kurze Folgeanweisung wie „weiter“ kann zu einer weiteren umfangreichen Modellanfrage führen. Der Agent benötigt möglicherweise frühere Dateien, Anforderungen und Tool-Ergebnisse, um zu entscheiden, was zu tun ist. Zwischengespeicherte Eingaben können günstiger zu verarbeiten sein, sind aber nicht zwangsläufig unlimitiert.
Die Quelle beschreibt außerdem eine frühere Erhöhung auf 372K, die nach einem höher als erwarteten Verbrauch innerhalb von Abonnements wieder zurückgenommen wurde. Dieser Bericht ist nützlicher Kontext für die Ankündigung, sollte aber nicht als aktuelle Abrechnungsregel oder als Zusage darüber verstanden werden, wie viel eine einzelne Aufgabe kosten wird.
Die Quelle vergleicht den gemeldeten neuen Standardwert mit Konfigurationen mit einer Million Token in Claude Code. Ein sinnvoller Vergleich erfordert mehr als die größte Zahl auf einer Modellkarte: Standardwerte, Verdichtungsschwellen, Kontozugang, Preise und die umgebende Agentensoftware können sich alle unterscheiden.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die spezifischen Claude-Modellgrenzen und die Verdichtungsschwelle der Quelle wurden für diesen Artikel nicht unabhängig anhand der Dokumentation von Anthropic geprüft. Sie sollten daher nicht als aktuelle Konfigurationsempfehlung behandelt werden.
Für die tägliche Arbeit sollten Sie drei Aspekte gemeinsam prüfen:
Die offizielle Modellberatung von OpenAI macht die Verfügbarkeit ebenfalls von Tarif, Client, Rollout und Workspace-Einstellungen abhängig. Eine Ankündigung zur Kapazität gewährt keinen Zugang zu einem Modell, das anderweitig nicht verfügbar ist.
GPT-6.1 Sol ist ein von OpenAI dokumentiertes Modell für komplexe Arbeit mit Code, Anwendungen und Dokumenten. Die offizielle Anleitung beschreibt es als Modell mit einer Leistung nahe Astra zu geringeren Kosten; die Verfügbarkeit hängt vom Tarif und Client des Nutzers ab.
Es bedeutet, dass das Modell in dieser Konfiguration mit einem Kontext von ungefähr 500.000 Token arbeiten kann. Token umfassen mehr als die jüngste Nachricht des Nutzers; daher können Dateien, Aufgabenverlauf, Tool-Ausgaben und Antworten relevant sein.
Die Quelle berichtet von keinem separaten Zuschlag für langen Kontext bei der Abonnementnutzung, was sich von unbegrenztem Zugang unterscheidet. Die Aufgabe verbraucht weiterhin das geltende Kontingent, und der Zugang zu GPT-6.1 Sol hängt von Tarif und Rollout ab.
Es kann die Verdichtung hinauszögern, indem mehr Platz verfügbar wird. Eine ausreichend lange Sitzung kann ihr Limit dennoch erreichen, und auch die konfigurierte Verdichtungsschwelle beeinflusst, wann eine Zusammenfassung ausgelöst wird.
Nein. OpenAI erklärt ausdrücklich, dass API-Tokenpreise von der Abonnementnutzung getrennt sind und nicht verwendet werden sollten, um die Anzahl enthaltener Aufgaben zu schätzen.
Nicht allein deshalb, weil ein größerer Wert in einem Bericht erwähnt wird. Prüfen Sie das unterstützte Modell und die Konfiguration und vergleichen Sie dann Abschlussqualität, Latenz und Nutzung bei einer repräsentativen Aufgabe, bevor Sie Ihre übliche Einrichtung ändern.
Der gemeldete 500K-Standardwert gibt GPT-6.1 Sol in Codex und Work mehr Platz für Dateien, Anforderungen und Arbeitsverlauf. Sein deutlichster möglicher Vorteil sind weniger Unterbrechungen durch Verdichtung während einer langen Aufgabe.
Mehr Kontextkapazität ist nützlich, beseitigt jedoch weder Abonnementlimits noch API-Kosten oder die Notwendigkeit, das Endergebnis zu prüfen.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



