For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/gpt-6-astra-unitree-g1-homebody-kitchen-r-56df14d6.md.
Das HomeBody-Projekt von Stanford und Caltech verbindet GPT Astra mit einem humanoiden Unitree G1, um eine unbekannte Küche zu erkunden, ein...
Der nächste Schritt bei Embodied AI ist nicht eine weitere Demo mit einem Roboterarm auf einem Tisch.
Ein humanoider Unitree G1 wurde nun dabei gezeigt, wie er eine unbekannte Küche erkundet, sich merkt, wo sich Gegenstände befinden, Dinge im Raum aufräumt, Schubladen öffnet, nicht mehr sichtbare Medikamente holt und sie einer Person übergibt.
Das Projekt heißt HomeBody und stammt von Forschern der Stanford University und des California Institute of Technology (Caltech).
Die zentrale Idee ist überraschend einfach:
Ein fortschrittliches Vision-Language-Modell behandelt Roboter-Skills wie Werkzeuge.
Anstatt das Modell jeden Gelenkbefehl ausgeben zu lassen, ermöglicht HomeBody GPT Astra, die Aufgabe zu verstehen, den nächsten Schritt zu bestimmen und wiederverwendbare Skills für Navigation, Aufheben, Ablegen, das Öffnen von Schubladen und das Entnehmen von Gegenständen aufzurufen.
Dadurch wird das Modell zu einem übergeordneten Planer und nicht zu einem Motorcontroller auf niedriger Ebene.
Das Ergebnis ist ein Workflow mit einem längeren Planungshorizont als beim üblichen Setup „Objekt sehen, aufheben, stoppen“.
In der Küchendemo erkundet der Roboter zunächst die Umgebung und baut ein dauerhaftes räumliches Gedächtnis auf. Anschließend rekonstruiert er einen digitalen Zwilling, richtet diese Darstellung an der realen Umgebung aus und nutzt gespeicherte Beobachtungen, um spätere Anweisungen auszuführen.
Der Nutzer kann beispielsweise sagen:
„Räume die Küche auf. Lege die Kaffeebeutel auf die Kücheninsel und wirf die verdorbenen Kartons weg.“
Der G1 bewegt sich anschließend zwischen verschiedenen Orten, sammelt die Kaffeebeutel ein und entsorgt die genannten Kartons.
Eine zweite Aufgabe ist noch aussagekräftiger:
„Ich habe meine Medikamente vergessen. Kannst du sie mir holen? Wirf bei dieser Gelegenheit auch den schlechten Karton weg.“
Zum Zeitpunkt der Anfrage ist das Medikament nicht sichtbar.
HomeBody durchsucht sein gespeichertes räumliches Gedächtnis, erinnert sich an die Schublade, in der das Medikament zuvor gesehen wurde, navigiert dorthin, öffnet die Schublade, holt das Medikament, übergibt es der Person und erledigt zusätzlich die Entsorgung des Kartons.
Das ist der entscheidende Wandel.
Der Roboter reagiert nicht mehr nur auf das, was sich gerade vor seiner Kamera befindet. Er kombiniert aktuelle Wahrnehmung, gespeicherte Beobachtungen, Raumgeometrie, Navigation, Manipulation und Aufgabenplanung im gesamten Raum.
HomeBodys Kerndesign lässt sich in einem Satz zusammenfassen:
GPT Astra wählt und sequenziert Roboter-Skills über strukturierte Tool-Aufrufe.
Das Modell ist dafür verantwortlich, das Ziel des Nutzers zu verstehen und den nächsten erforderlichen Schritt zu bestimmen.
Der Roboter-Stack übernimmt die physischen Details.
Eine vereinfachte Darstellung sieht so aus:
Nutzeranweisung
      ↓
GPT Astra / System 2
      ↓
Skill + Ziel auswählen
      ↓
Navigation / Aufheben / Ablegen / Schublade öffnen / Aus Schublade entnehmen
      ↓
Wahrnehmung + Bewegungsplanung + Steuerung auf niedriger Ebene
      ↓
Ausführungsergebnis
      ↓
Ergebnis an GPT Astra zurückgeben
      ↓
Nächste Aktion auswählen
Bevor der Roboter etwas aus einer unbekannten Küche holen kann, benötigt er jedoch mehr als eine Skill-Bibliothek.
Er muss wissen, wie die Küche aussieht und wo sich zuvor gesehene Gegenstände befinden.
HomeBody baut diesen Kontext in drei Stufen auf.
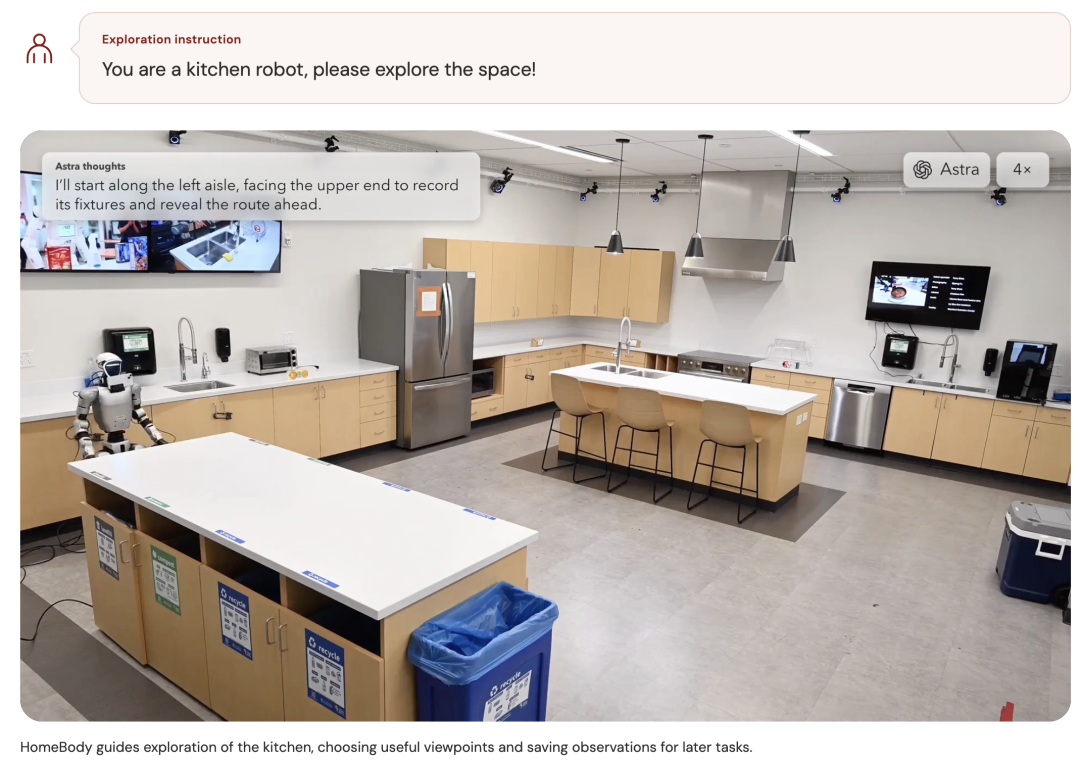
Die erste Anweisung ist bewusst einfach:
Du bist ein Küchenroboter. Bitte erkunde den Raum!
GPT Astra wählt anschließend geeignete Blickwinkel aus und führt den G1 durch den Raum.
Während der Erkundung sammelt HomeBody mehrere Datenarten, darunter:
Die Kamera zeigt den Inhalt des Raums.
LiDAR und andere Sensoren liefern gemessene räumliche Strukturen.
SLAM – simultane Lokalisierung und Kartierung – hilft dem Roboter, eine Karte aufzubauen und gleichzeitig seine eigene Position innerhalb dieser Karte zu schätzen.
Der entscheidende Punkt ist die Persistenz.
Wenn sich der G1 von einem Gegenstand wegdreht, verschwindet die Information nicht zusammen mit dem Kamerabild.
HomeBody speichert Beobachtungen und verknüpft sie mit Orten, damit spätere Aufgaben sie abrufen können.
So kann eine Anfrage wie „Bring mir meine Medikamente“ auch dann funktionieren, wenn das Medikament aktuell in einer Schublade verborgen oder außerhalb des Sichtfelds des Roboters liegt.
Die Erkundung allein reicht nicht aus.
Als Nächstes nutzt HomeBody GPT Astra als Real2Sim-Agenten, um eine digitale Rekonstruktion der Umgebung in NVIDIA Isaac Sim zu erstellen.
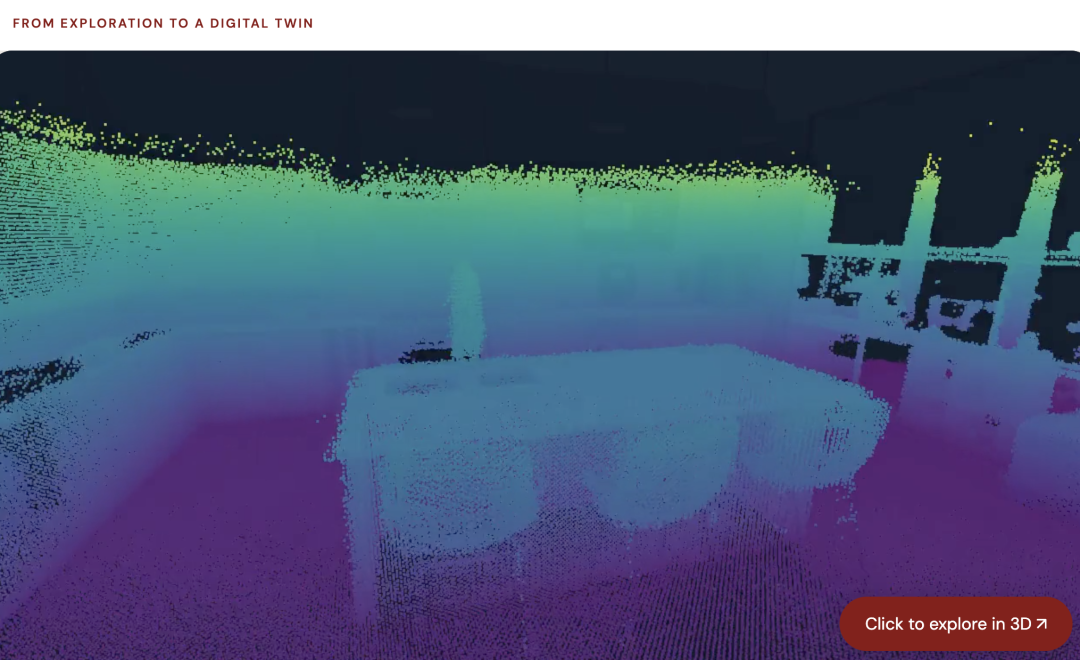
Der digitale Zwilling dient als räumliches Modell der Küche.
Er stellt dem System eine strukturierte Repräsentation bereit von:
Wichtig ist, dass die Rekonstruktion nicht nur auf dem Erscheinungsbild basiert.
HomeBody speist auch gemessene SLAM-Geometrie in den Real2Sim-Prozess ein.
Dadurch erhält die Rekonstruktion reale Maßvorgaben.
Das ist wichtig, weil eine visuell überzeugende Rekonstruktion für Robotik nicht ausreicht.
Der Roboter muss wissen, ob ein Durchgang tatsächlich breit genug zum Hindurchgehen ist, ob der Körper nah genug an einer Schublade positioniert werden kann und ob ein Arm ein Ziel erreichen kann, ohne mit der Umgebung zu kollidieren.
Anschließend richtet das System die reale SLAM-Karte und die rekonstruierte Simulation in einem gemeinsamen Koordinatensystem aus.
Gespeicherte Kameraaufnahmen, semantische Beschreibungen und Roboterpositionen können so mit physischen Orten im Raum verknüpft werden.
Der Roboter erinnert sich also nicht nur an:
Ich habe eine Medikamentenflasche gesehen.
HomeBody kann etwas bewahren, das eher dieser Information entspricht:
Ich habe das Medikament in dieser Schublade
an diesem gespeicherten Ort
im gemeinsamen Raumkoordinatensystem gesehen.
Das ermöglicht das spätere Wiederfinden.
Nach der Erkundung und Rekonstruktion kann der Nutzer eine alltägliche Aufgabe stellen.
Zum Beispiel:
Räume die Küche auf.
Lege die Kaffeebeutel auf die Kücheninsel
und wirf die verdorbenen Kartons weg.
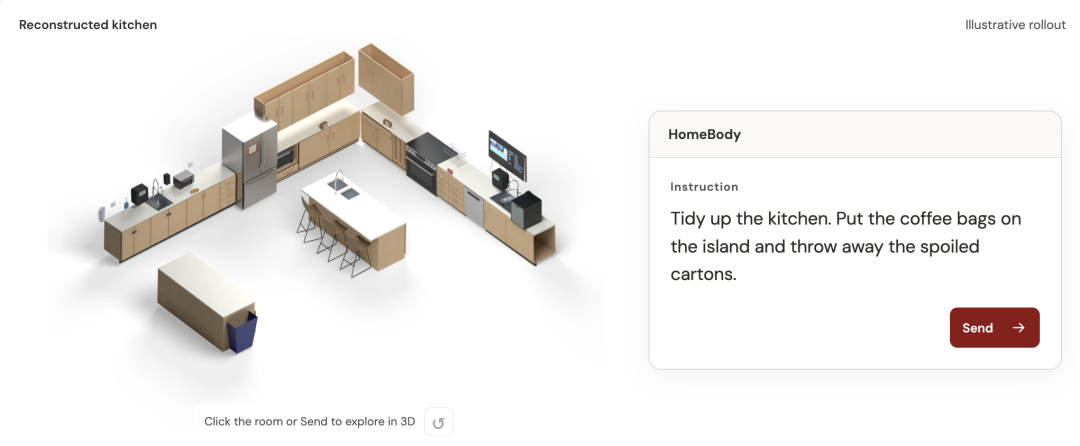
In jeder Phase kann GPT Astra Folgendes berücksichtigen:
Anschließend wählt es den nächsten Skill und das nächste Ziel aus.
Die Medikamentendemo zeigt, warum das nützlich ist.
Der Nutzer gibt die Schublade nicht an.
Das Modell kann sich an eine frühere Beobachtung erinnern, zurück zum richtigen Bereich navigieren, die Schublade öffnen, die Flasche holen, sie übergeben und danach mit der noch offenen Aufräumanweisung fortfahren.
Die Aufgabe ist lang genug, dass kein einzelnes Kamerabild alle Informationen enthält, die für ihre vollständige Ausführung erforderlich sind.
Genau hier wird ein dauerhaftes räumliches Gedächtnis wertvoll.
Das ist das wichtigste Architekturdetail von HomeBody.
Wenn man hört, dass „GPT einen humanoiden Roboter steuert“, kann leicht der Eindruck entstehen, das Sprachmodell gebe direkt jeden Gelenkwinkel aus.
Das tut das System nicht.
Frühere Arbeiten wie RoboCurve zeigten, wie fortschrittliche Modelle Roboterarm-Aufgaben steuern können, indem sie Kamerabilder und Roboterzustände beobachten und anschließend Werkzeuge verwenden, die Greiferposition, Orientierung sowie den geöffneten oder geschlossenen Zustand festlegen.
HomeBody arbeitet auf einer höheren Abstraktionsebene.
Das Modell ruft vollständige, wiederverwendbare Skills auf.
Das Projekt beschreibt den gängigen Humanoiden-Stack anhand von drei konzeptionellen Ebenen:
Eine konventionelle Architektur mit gelerntem Aktionsmodell kann so aussehen:
System-2-VLM
     ↓
System-1-VLA
     ↓
System-0-Ganzkörpercontroller
HomeBody verändert die mittlere Ebene dieser Pipeline.
Statt ein gelerntes VLA-Modell dazu zu zwingen, eine übergeordnete Absicht in Aktionen zu übersetzen, ruft das VLM direkt eine kombinierbare Skill-Bibliothek auf.
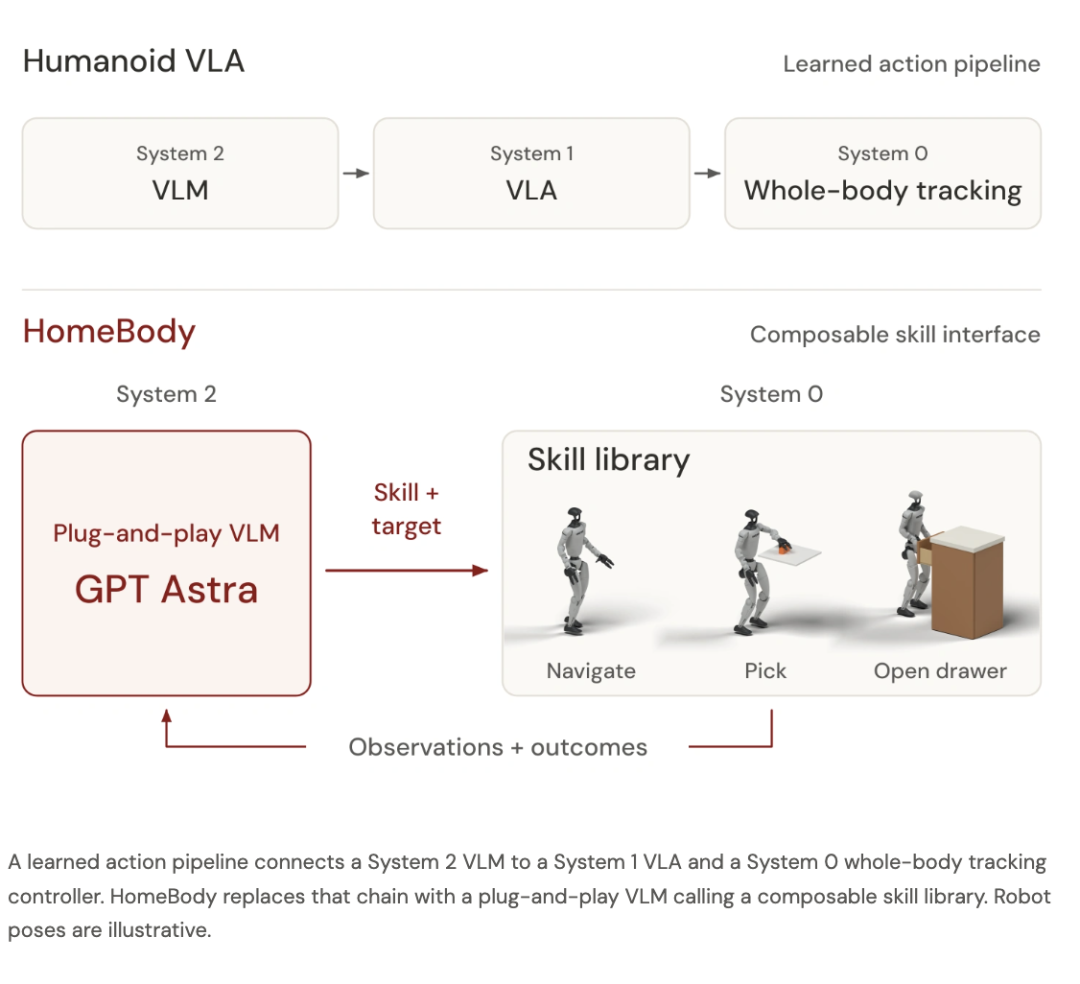
Die resultierende Struktur ähnelt eher dieser:
System-2-VLM
     ↓
Skill-Bibliothek
     ↓
Bewegungsplanung + Wahrnehmung
     ↓
System-0-Ganzkörpersteuerung
Das aktuelle Skill-Vokabular von HomeBody umfasst:
| Skill | Was das übergeordnete Modell bereitstellt | Was der Skill übernimmt |
|---|---|---|
| Navigieren | Zielort und Orientierung | Routenplanung und Ausführung der Fortbewegung |
| Aufheben | Bildpunkt und Auswahl der Hand | Segmentierung, Tiefenbestimmung, Greifpose, Armtrajektorie und Wiederholungsversuche |
| Ablegen | Hand und dreidimensionales Ablageziel | Gehaltenen Gegenstand zum Ziel bewegen und loslassen |
| Schublade öffnen | Ziel von Schublade oder Griff | Ausrichtung, Einhakpose und Sequenz zum Zurückziehen |
| Aus Schublade entnehmen | Zielobjekt in einer geöffneten Schublade | Heranreichen, Greifen, Anheben und lokale Wiederholungslogik |
Alle Skills verwenden eine gemeinsame Schnittstelle für Ziele und Ausführungsergebnisse.
Das Modell muss die interne Implementierung jedes einzelnen Skills nicht verstehen.
Es muss lediglich entscheiden, welcher Skill ausgeführt werden soll und welches Ziel er erhalten soll.
Bei einer Aufhebeaktion wählt GPT Astra einen Punkt im Bild der Ego-Kamera aus und entscheidet, welche Hand verwendet werden soll.
Danach übernimmt der Skill-Stack.
Laut der HomeBody-Implementierung:
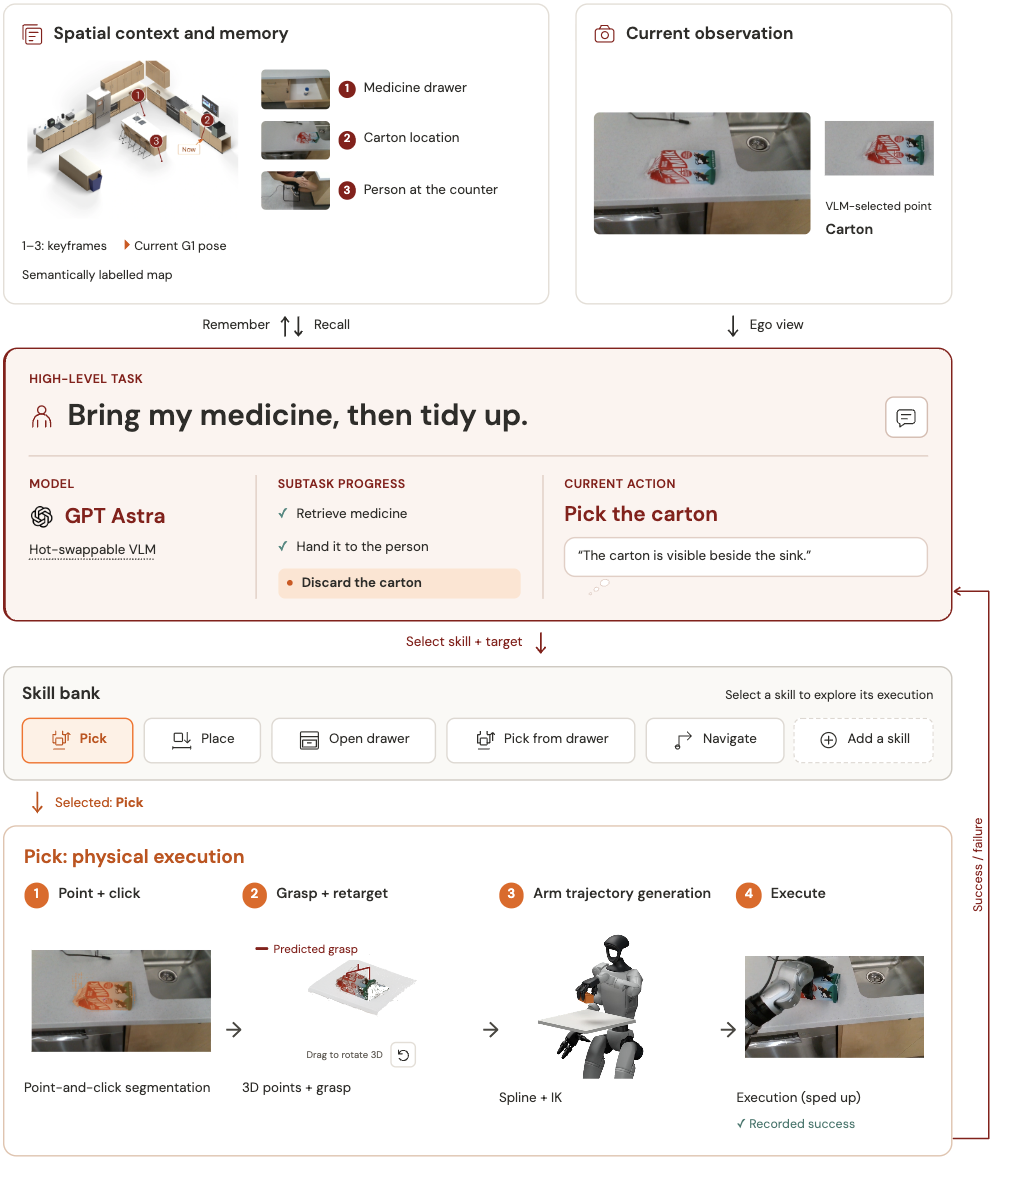
Mit anderen Worten:
GPT entscheidet, was aufgehoben wird
und welche Hand verwendet wird.

Der Roboter-Skill entscheidet,
wie die Hand physisch dorthin gelangt.
Diese Trennung hält das fortschrittliche Modell auf die Aufgabenplanung und das Schlussfolgern fokussiert, anstatt es für die Echtzeit-Motorsteuerung verantwortlich zu machen.
Die physische Welt ist ungenau.
Ein Objekt kann sich im Kamerabild verschieben, während sich der Roboter ihm nähert.
Ein Greifer kann sich schließen, ohne Kontakt herzustellen.
Der Roboter muss möglicherweise seine Position anpassen.
HomeBody verlangt deshalb nicht für jede noch so kleine Korrektur eine neue GPT-Entscheidung.
Das Projekt nutzt Segmentierung und SAM-2.1-Tracking mit einer speichergestützten Auswahl im SAMURAI-Stil, um Ziele zwischen den Bildern zu verfolgen.
Visuelle Servoregelung kann anschließend die Ausrichtung lokal korrigieren.
Wenn ein Greifversuch scheitert, kann der Skill einen anderen Greifkandidaten ausprobieren oder den Roboter neu positionieren und die Planung wiederholen.
Diese lokalen Wiederholungsversuche sind begrenzt.
Wenn der lokale Skill sich nicht mehr selbstständig erholen kann, sendet er den Fehlergrund an GPT Astra zurück.
Das VLM kann dann ein anderes Ziel auswählen, den Roboter neu positionieren oder den übergeordneten Plan ändern.
Der Ablauf wird zu:
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Entscheiden
  ↓
Skill ausführen
  ↓
Ergebnis beobachten
  ↓
Wenn möglich lokal wiederholen
  ↓
Ergebnis an GPT Astra zurückgeben
  ↓
Bei Bedarf neu planen
So lassen sich mehrere Skills zu einer längeren Sequenz verketten, etwa:
Zur Schublade navigieren
→ Schublade öffnen
→ Medikament aufheben
→ Zur Person navigieren
→ Medikament übergeben
→ Karton finden
→ Karton wegwerfen
Selbst wenn der übergeordnete Planer den richtigen Skill auswählt, muss ein humanoider Roboter beim Gehen und Greifen weiterhin sein Gleichgewicht halten.
HomeBody nutzt das vortrainierte AMO (Adaptive Motion Optimization) für eine unterkörperseitige Steuerung, die den Oberkörper berücksichtigt.
Der Controller berücksichtigt Ziele des Oberkörpers und koordiniert gleichzeitig die Fortbewegung.
Laut der Projektseite laufen Arm- und Handbefehle mit 250 Hz, während die AMO-Policy bei jedem fünften Steuerungstakt mit 50 Hz aktualisiert wird.
Auch deshalb muss die Aussage „kein zusätzliches Training“ kontextualisiert werden.
Für die neue Küche ist keine neu trainierte, umgebungsspezifische Aktionspolicy erforderlich.
Das System hängt jedoch weiterhin von zuvor trainierten und entwickelten Komponenten unterhalb des VLM ab.
Eine der stärksten Aussagen von HomeBody ist, dass das System in eine zuvor unbekannte Küche wechseln kann, ohne umgebungsspezifische Trainingsdaten zu sammeln oder eine neue Aktionspolicy für diesen Raum zu lernen.
Das ist relevant.
Die Bereitstellung herkömmlicher Roboter erfordert häufig Demonstrationen, Policy-Training oder eine umgebungsspezifische Feinabstimmung, bevor der Roboter zuverlässig handeln kann.
HomeBody kombiniert stattdessen:
Dadurch wird ein Teil des Anpassungsaufwands vom erneuten Training auf Schlussfolgern + Kartierung + wiederverwendbare Werkzeuge verlagert.
Der vollständige HomeBody-Ablauf lässt sich so zusammenfassen:
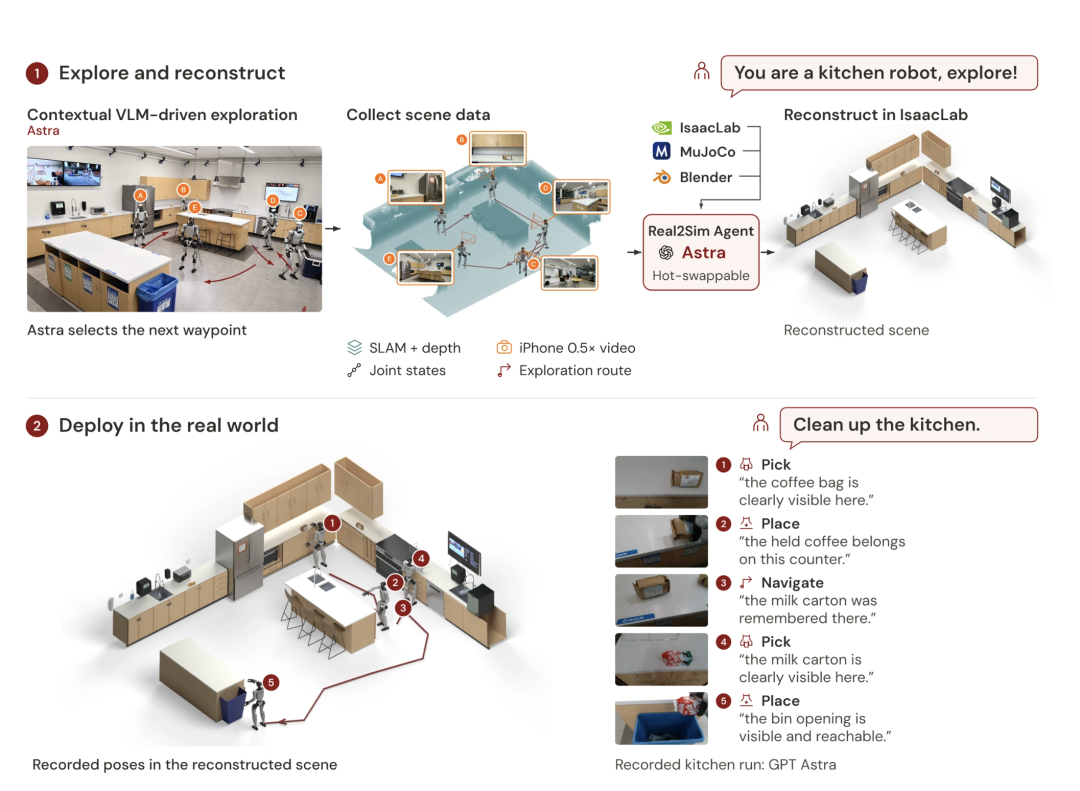
Unbekannten Raum erkunden
        ↓
Ego-Beobachtungen + SLAM + Posen sammeln
        ↓
Digitalen Zwilling mit Real2Sim erstellen
        ↓
Reale und simulierte Koordinatensysteme ausrichten
        ↓
Räumliche Beobachtungen speichern
        ↓
Alltägliche Anweisung erhalten
        ↓
GPT Astra wählt Skill + Ziel
        ↓
Lokaler Robotik-Stack führt aus
        ↓
Ergebnis zurückgeben
        ↓
Fortfahren, bis die Aufgabe abgeschlossen ist
Die Forschungsdemo ist beeindruckend, aber sie entspricht nicht dem Szenario, einfach einen G1 zu kaufen, einen API-Schlüssel einzugeben und einen Haushaltsroboter zu erhalten.
Der aktuelle HomeBody-Stack benötigt weiterhin eine umfangreiche Robotikinfrastruktur.
Die Forscher berichten, dass Wahrnehmung, Bewegungsplanung und Skill-Ausführung auf einem einzelnen Razer-Blade-Laptop mit einer RTX-4090-GPU laufen.
GPT Astra wird remote ausgeführt und sendet Skill-Anfragen und Ziele an den lokalen Rechner.
Damit ist die Architektur auf zwei Rechenumgebungen verteilt:
Remote ausgeführtes fortschrittliches Modell
→ Schlussfolgern auf hoher Ebene und Skill-Auswahl

Lokales RTX-4090-System
→ Wahrnehmung, Geometrie, Planung, Skills, Ausführung
Das Projekt nennt außerdem mehrere praktische Kosten und Einschränkungen.
Der digitale Zwilling muss erstellt werden, bevor der vollständige Workflow seine räumliche Repräsentation verwenden kann.
Das verlängert die Vorbereitung.
Das remote ausgeführte fortschrittliche Modell wird während der Planung und der Real2Sim-Arbeit aufgerufen.
Dadurch entstehen API-Kosten.
Astra reagiert nicht sofort.
Die Forscher weisen auf Pausen zwischen den Skills hin, während das Schlussfolgern auf hoher Ebene abgeschlossen wird.
Bei Haushaltsaufgaben sind diese Pausen relevant, weil physische Aufgaben ohnehin deutlich länger dauern als rein digitale.
Auch die langfristige Manipulation mit einem Humanoiden stößt an mechanische Grenzen.
Auf der HomeBody-Seite wird ausdrücklich eine Überhitzung der Finger-Servos während längerer Betriebszeiten erwähnt.
Der Roboter kann nur Aufgaben ausführen, die von seinen aktuellen Händen, seiner Reichweite, seinem Gleichgewicht, seiner Wahrnehmung und dem implementierten Skill-Set unterstützt werden.
Das Projekt ist daher eine Forschungsdemonstration für Autonomie über lange Planungshorizonte und noch kein allgemeiner Haushaltsassistent, der beliebige Hausarbeiten erledigen kann.
HomeBody ist Teil einer größeren Forschungswelle, die fortschrittliche Modelle mit physischen Robotern verbindet.
Der Ausgangsartikel hebt drei zunehmend verbreitete Ansätze hervor.
In einem RoboCurve-ähnlichen Setup erhält das Modell Bilder und Roboterzustände und ruft anschließend Werkzeuge auf, die Ziele spezifizieren, etwa:
Ein Stack für inverse Kinematik oder Steuerung auf niedriger Ebene wandelt diese Ziele in Roboterbewegungen um.
Das Modell bleibt in einer häufigen Schleife aus Beobachten, Entscheiden und Handeln.
Ein zweiter Ansatz nutzt ein fortschrittliches Sprach-/Bildmodell für langsames Schlussfolgern auf hoher Ebene und ein gelerntes VLA-Modell zur Erzeugung von Aktionen.
Konzeptionell:
VLM-Planer
→ Aktionsmodell VLA
→ Controller auf niedriger Ebene
Dadurch bleibt das fortschrittliche Modell oberhalb der Motorebene, während weiterhin eine gelernte Policy Pläne in physische Aktionen übersetzt.
HomeBody wählt einen anderen Weg.
Das Projekt verzichtet auf die Notwendigkeit eines gelernten VLA-Modells in der Mitte und ermöglicht es dem fortschrittlichen VLM stattdessen, direkt wiederverwendbare Skills aufzurufen.
Diese Skills können selbst aus klassischen Algorithmen, gelernten Policies oder anderen Controllern bestehen.
Das HomeBody-Projekt erlaubt ausdrücklich, über die gemeinsame Schnittstelle neue Skills hinzuzufügen.
Dadurch wird die Architektur modular:
Das VLM ersetzen
oder
einen neuen Skill hinzufügen,
ohne den gesamten Roboter-Stack neu zu entwerfen
Die tiefere Idee besteht nicht einfach darin, eine weitere System-0-Schicht hinzuzufügen.
Es handelt sich um eine andere Verbindung zwischen Schlussfolgern und physischer Ausführung.
Zusammen mit dem räumlichen Gedächtnis ermöglicht diese Verbindung dem Roboter, in einem Raum zu arbeiten, anstatt nur an einer einzelnen Tischfläche.
Der Ausgangsartikel endet mit einem Blick auf Ergebnisse von RoboCurve zur Bewertung der Robotersteuerung durch Drittanbieter.
Diese Ergebnisse sollten als aufgabenspezifische Messungen aus Robotik-Benchmarks verstanden werden, nicht als universelle Aussagen über die allgemeine Intelligenz von Modellen.
In einem von Jay Chooi veröffentlichten RoboCurve-Ergebnis erzielte GPT-6 Sol bei der Robotik-Aufgabenreihe Berichten zufolge etwa das 1,6-Fache des Ergebnisses von GPT-5.6 Sol und kostete pro Versuch etwa 47 % weniger.
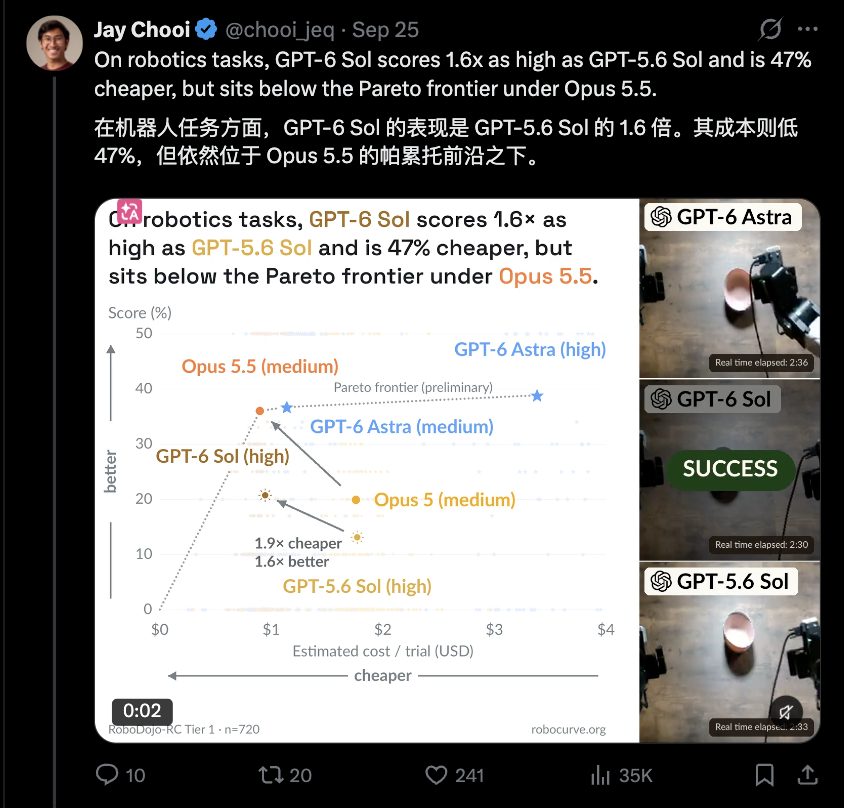
Dieselbe Grafik ordnete GPT-6 Sol unterhalb der vorläufigen Pareto-Grenze ein, die durch stärkere Opus-5.5-Konfigurationen in dieser Evaluierung gebildet wurde.
Das ist ein nützlicher Hinweis darauf, dass Kosten und Robotersteuerungsleistung nicht immer gemeinsam steigen oder fallen.
Ein günstigeres Modell kann operativ die bessere Wahl sein, selbst wenn ein anderes Modell weiterhin eine höhere Punktzahl erreicht.
Ein separates RoboCurve-Ergebnis umfasste 360 Robotikversuche.
Der gemeldete Durchschnitt zeigte, dass Opus 5.5 ungefähr das 1,8-Fache der Punktzahl von Opus 5 erreichte, bei etwa der Hälfte der Kosten. Gleichzeitig entsprach der Mittelwert ungefähr dem von Astra, jedoch bei rund 21 % niedrigeren Kosten.
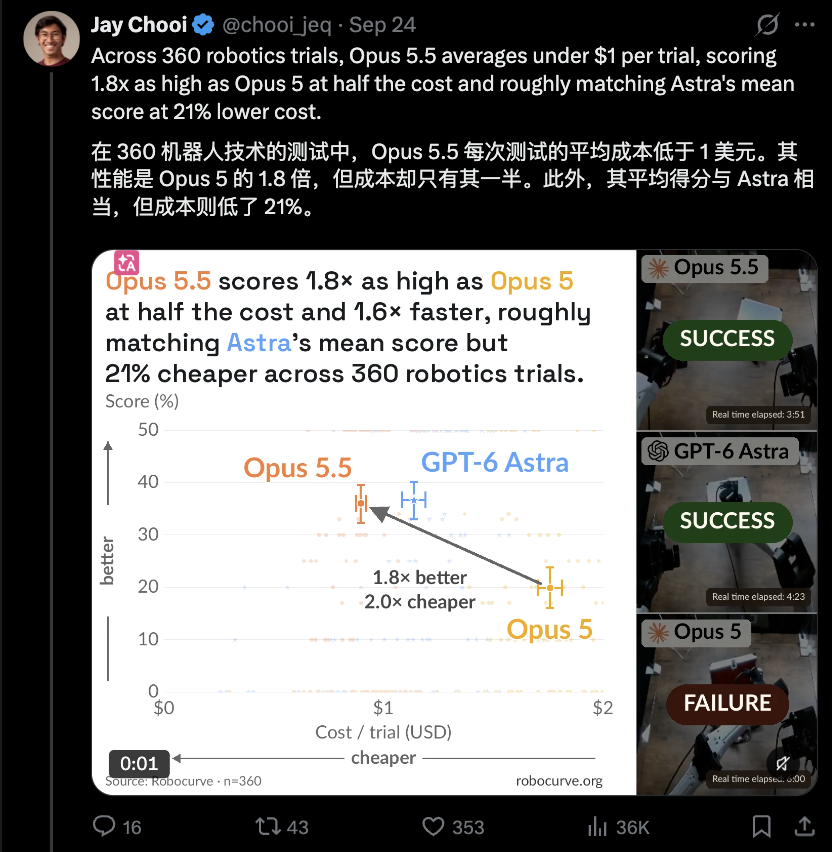
Auch hierbei handelt es sich nicht um einen allgemeinen Benchmark von Anthropic oder OpenAI.
Es ist eine Robotik-Evaluierung eines Drittanbieters über eine bestimmte Auswahl an Aufgaben, Hardware, Prompts und Versuchsbedingungen.
Diese Unterscheidung ist wichtig, weil die Leistung bei Embodied AI vom gesamten System abhängt:
Modell
×
Prompting
×
Roboterhardware
×
Wahrnehmung
×
Steuerungs-Stack
×
Skill-Design
×
Aufgabendefinition
Ein Modell, das bei einem Coding-Benchmark am besten abschneidet, muss nicht das Modell mit dem besten Kosten-Leistungs-Verhältnis bei der Steuerung eines Roboters sein.
Das Interessanteste an HomeBody ist nicht, dass ein Humanoider einen Kaffeebeutel bewegt hat.
Roboter manipulieren seit Jahren Gegenstände.
Der wichtige Wandel ist architektonischer Natur.
HomeBody zeigt eine praktische Möglichkeit, Folgendes zu verbinden:
Das fortschrittliche Modell muss nicht jedes motorische Detail lernen.
Der Roboter benötigt keine neue End-to-End-Policy, die speziell für jede einzelne Küche trainiert wurde.
Stattdessen schlussfolgert ein allgemeines Modell über eine strukturierte Umgebung und koordiniert wiederverwendbare Fähigkeiten.
Das ähnelt der zunehmenden Arbeitsweise von Software-Agenten:
Modell schlussfolgert
→ ruft Werkzeuge auf
→ liest Ergebnisse
→ wählt das nächste Werkzeug
HomeBody bringt dasselbe Muster in die physische Welt.
Die Werkzeuge sind nicht mehr Websuche, Python oder eine Datenbank.
Sie sind:
Navigieren
Aufheben
Ablegen
Schublade öffnen
Aus Schublade entnehmen
Deshalb wirkt das Projekt wie ein wichtiger Schritt für Embodied Agents.
HomeBody ist ein Forschungssystem von Stanford und Caltech, das einem humanoiden Roboter ein dauerhaftes räumliches Gedächtnis und eine Bibliothek kombinierbarer motorischer Skills gibt. Ein fortschrittliches Vision-Language-Modell plant Aufgaben mit langem Zeithorizont und ruft diese Skills über strukturierte Tool-Schnittstellen auf.
Nein. Auf der HomeBody-Projektseite wird der Planer als GPT Astra bezeichnet und als System-2-Modell auf hoher Ebene eingesetzt. Navigation, Manipulation, Wahrnehmung, Bewegungsplanung, Wiederholungsversuche und Ganzkörpersteuerung werden von Robotikmodulen und vortrainierten Controllern auf niedrigerer Ebene übernommen.
Die Forscher geben an, dass die demonstrierte unbekannte Küche keine umgebungsspezifischen Trainingsdaten oder zusätzliches Policy-Lernen erfordert. Das System stützt sich weiterhin auf vortrainierte Wahrnehmungsmodelle, wiederverwendbare Skills, SLAM, Planungssoftware und einen vortrainierten AMO-Ganzkörpercontroller.
Während der Erkundung speichert HomeBody Ego-Kameraaufnahmen zusammen mit semantischen Inhalten und Positionen in einem gemeinsamen räumlichen Koordinatensystem. Wenn sich eine spätere Anfrage auf einen nicht sichtbaren Gegenstand bezieht, kann GPT Astra einen gespeicherten Keyframe abrufen und zum erinnerten Ort navigieren.
Die Real2Sim-Phase stellt dem Planer auf hoher Ebene ein strukturiertes räumliches Modell des Raums bereit. HomeBody verankert die Rekonstruktion außerdem mit gemessener SLAM-Geometrie, sodass Navigations- und Manipulationsentscheidungen an realen Abmessungen und nicht nur am visuellen Erscheinungsbild ausgerichtet sind.
Das Projekt berichtet, dass lokale Skills, Wahrnehmung und Bewegungsplanung auf einem Razer-Blade-Laptop mit einer RTX-4090-GPU laufen, während GPT Astra remote ausgeführt wird. Das aktuelle Setup benötigt außerdem die Humanoiden-Hardware, Kameras, LiDAR-/SLAM-Komponenten, Netzwerkverbindungen und den Robotik-Software-Stack des Projekts.
Nein. Das Projekt demonstriert eine bedeutende Autonomie über lange Planungshorizonte, aber zu den eigenen Einschränkungen gehören die Einrichtungszeit für Real2Sim, API-Kosten, Latenz beim Schlussfolgern, Grenzen bei der Manipulation und Probleme mit der Hardware-Ausdauer wie die Überhitzung der Finger-Servos.
Nein. Die im Ausgangstext diskutierten Zahlen stammen von RoboCurve, einem unabhängigen Evaluator eines Drittanbieters, und gelten für dessen Robotik-Aufgabenreihen und Versuchsbedingungen. Sie sollten nicht außerhalb dieses Kontexts zu allgemeinen Modellrankings verallgemeinert werden.
HomeBody zeigt, wie ein fortschrittliches Modell zum Planer auf hoher Ebene für einen Humanoiden werden kann, ohne jeden Motorbefehl auf niedriger Ebene direkt zu erzeugen. GPT Astra erkundet einen unbekannten Raum, nutzt eine Real2Sim-Rekonstruktion und ein dauerhaftes räumliches Gedächtnis und kombiniert anschließend Navigations- und Manipulations-Skills, um Küchenaufgaben mit langem Planungshorizont zu erledigen.
Die zentrale Designentscheidung ist die Modularität. Das Modell entscheidet, was als Nächstes geschehen soll, während Wahrnehmung, Geometrie, Bewegungsplanung, lokale Wiederholungsversuche und Ganzkörpersteuerung entscheiden, wie der Roboter dies physisch ausführt. Dadurch kann das System eine neue Küche betreten, ohne eine neue umgebungsspezifische Aktionspolicy zu trainieren, obwohl es weiterhin auf umfangreiche vortrainierte und entwickelte Robotikinfrastruktur angewiesen ist.
Die aktuelle Implementierung bleibt ein Forschungssystem und ist noch kein sofort einsatzbereiter Haushaltsroboter: Sie benötigt einen lokalen Rechner der RTX-4090-Klasse, Remote-Inferenz des Modells, eine Simulationskonfiguration, API-Zugriff und robuste Roboterhardware. Die Forscher dokumentieren außerdem Latenz- und Ausdauergrenzen, die bei langen Aufgaben in der realen Welt weiterhin relevant sind.
Der entscheidende Schritt lautet nicht einfach „GPT kann einen Roboter steuern“, sondern dass ein allgemeines Modell nun räumliches Gedächtnis und wiederverwendbare physische Skills ähnlich einsetzen kann, wie ein Software-Agent Werkzeuge verwendet.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



