
OpenAI hat GPT-6 Astra am 3. September 2026 vorgestellt; in Peking war bereits der 4. September. OpenAI bezeichnet es als sein bislang intelligentestes und am besten ausgerichtetes Modell und positioniert es für anspruchsvolle End-to-End-Aufgaben in den Bereichen Computernutzung, Web-Browsing, Softwareentwicklung, Cybersicherheit, Wissenschaft und professionelle Workflows.
Diese Einordnung ist wichtig, weil Astra nicht am besten als einfacher „nächster Chatbot“ verstanden werden sollte.
Die sichtbarsten Verbesserungen konzentrieren sich auf Aufgaben, bei denen ein Modell über viele Schritte hinweg weiterarbeiten muss: eine Umgebung untersuchen, Tools verwenden, einen Plan überarbeiten, Fehler bewältigen, Software bedienen und ein fertiges Ergebnis liefern statt nur eine einzelne Antwort.
Der ursprüngliche Artikel beschreibt diesen Wandel als Beginn einer „nativen Agenten-Ära“. Das ist grundsätzlich eine hilfreiche Einordnung, doch die Umsetzung ist differenzierter, als zu sagen, der gesamte Agenten-Harness sei in die Modellgewichte verschoben worden.
OpenAIs eigene Dokumentation beschreibt zwei zusammenwirkende Ebenen:
- GPT-6 Astra, trainiert für lange, mehrstufige Workflows, die effektive Nutzung von Tools, die Aufteilung von Arbeit, die Delegation an Unteragenten und kohärentes Arbeiten bei sich ändernden Anforderungen.
- Der agentische Harness, etwa die von Codex und ChatGPT Work verwendete Orchestrierungsebene, die das Modell mit Tools, der Benutzerumgebung, Kontextverwaltung, Berechtigungen und Ausführungsschleifen verbindet.
Mit anderen Worten: Astra ist deutlich stärker auf Agentenaufgaben ausgerichtet, aber eine Anwendung benötigt weiterhin eine Ausführungsumgebung rund um das Modell.
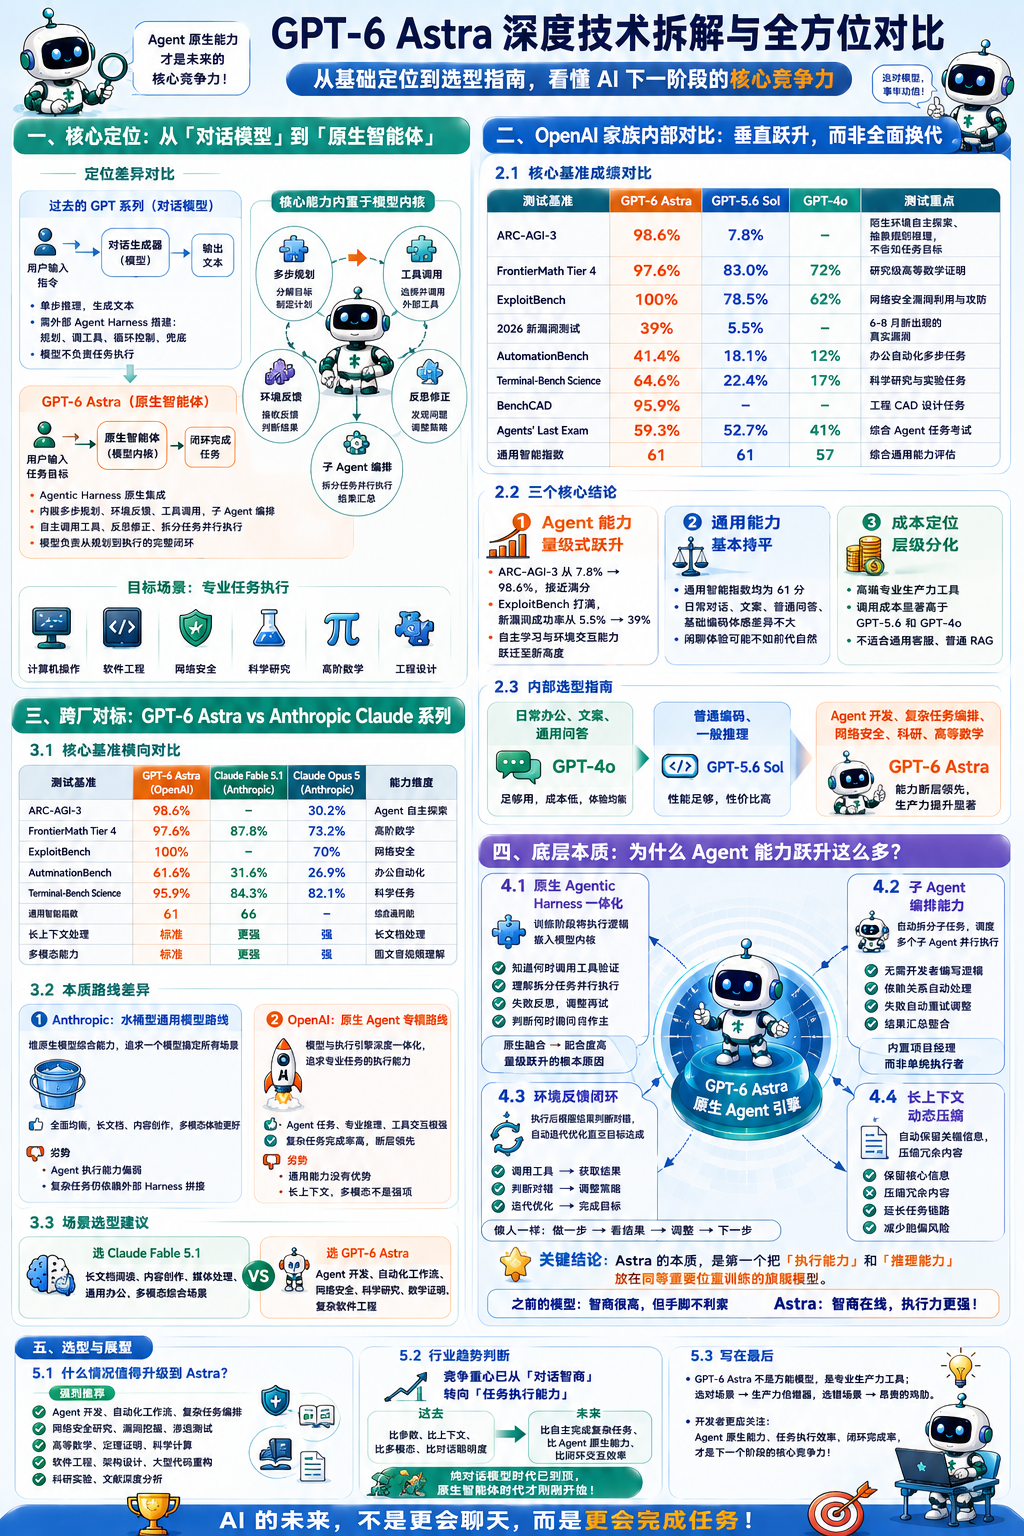
Dieser Artikel behält die ursprüngliche fünfteilige Struktur bei und untersucht Astra aus fünf Perspektiven:
- Die zentrale Positionierung.
- Der Vergleich innerhalb der OpenAI-Modellfamilie.
- Der anbieterübergreifende Vergleich mit Anthropic Claude.
- Die technischen Gründe für den Sprung bei Agentenaufgaben.
- Hinweise zur Modellauswahl und die Bedeutung dieses Wandels für Entwickler.
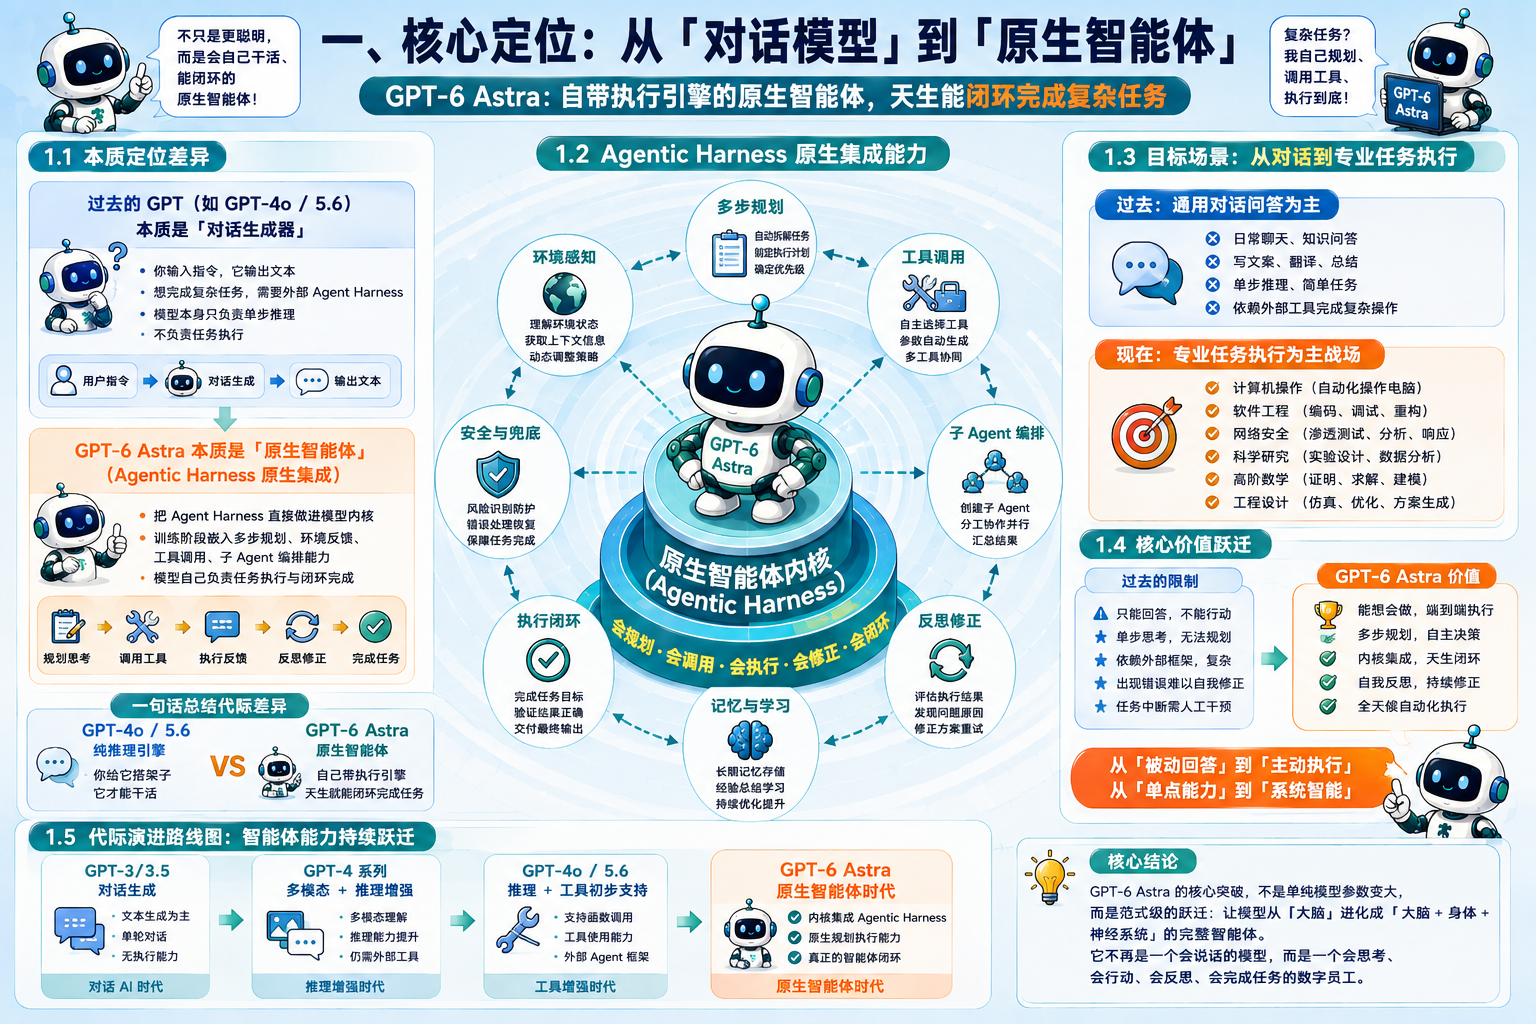
Bevor wir uns die Benchmarkzahlen ansehen, ist es hilfreich, das Modell vom umgebenden Produkt-Stack zu trennen.
1.1 Frühere GPT-Workflows benötigten meist mehr externe Orchestrierung
Ein herkömmlicher Workflow mit einem Sprachmodell lässt sich leicht vorstellen:
Nutzerprompt
→ Schlussfolgerung des Modells
→ Modellantwort
Bei einem komplexeren Agenten ergänzt die umgebende Anwendung normalerweise eine weitere Ebene:
Nutzerziel
→ Agenten-Harness
→ Modell
→ Tool-Aufruf
→ Ergebnis aus der Umgebung
→ Modell
→ nächste Aktion
→ Endergebnis
Dieser externe Harness entscheidet, wie Tools bereitgestellt werden, wie Ergebnisse zurückgegeben werden, wie der Kontext fortgeführt wird, welche Berechtigungen gelten und wann die Schleife beendet werden soll.
OpenAI verwendet diese Architektur weiterhin. Tatsächlich hat das Unternehmen den agentischen Harness von Codex/ChatGPT Work separat als Rust-Orchestrierungsebene beschrieben, die Modelle, Tools und die Benutzerumgebung miteinander verbindet.
1.2 Was sich mit GPT-6 Astra tatsächlich verändert hat
Astra wurde umfassender für die Verhaltensweisen trainiert, die den Harness nützlich machen.
OpenAIs Modellleitfaden hebt unter anderem folgende Fähigkeiten hervor:
- Komplexe, mehrstufige Workflows über Code, Browser und professionelle Software hinweg auszuführen.
- Weiter zu schlussfolgern, während asynchrone Tools ausgeführt werden.
- Steuerung mitten in einem Turn anzunehmen, ohne bereits abgeschlossene Arbeit zu verwerfen.
- Arbeit über lang laufende Gespräche hinweg zu bewahren.
- Arbeit aufzuteilen und an Unteragenten zu delegieren, wenn der Harness Kollaborationstools bereitstellt.
- Computernutzungstools effektiver einzusetzen.
- Näher an den Aufgabengrenzen zu bleiben und gezielte Fragen zu stellen, wenn eine Entscheidung das Ergebnis wesentlich verändern könnte.
Der Unterschied lässt sich daher besser als gemeinsames Design von Modell und Harness beschreiben und nicht als „der Harness ist verschwunden und im Modell aufgegangen“.
1.3 Die Ziel-Workloads haben sich verschoben
Das praktische Ziel besteht nicht mehr nur aus:
- Allgemeiner Fragenbeantwortung.
- Texterstellung.
- Einmaliger Codegenerierung.
- Einfacher Zusammenfassung.
Astra ist vor allem auf anspruchsvollere Ausführungs-Workloads ausgerichtet, darunter:
- Computernutzung.
- Browser-Workflows.
- Softwareentwicklung.
- Wissenschaftliche Analysen.
- Professionelle Dokumentenarbeit.
- Komplexe Recherche.
- Autorisierte Cybersicherheit und defensive Sicherheitsforschung.
- CAD- und Engineering-Aufgaben.
OpenAIs Einführungsmaterial betont wiederholt End-to-End-Arbeit und nicht lediglich eine bessere Konversationspersönlichkeit.
1.4 Die Kurzfassung
Eine hilfreiche Betrachtungsweise des Generationswechsels ist:
Älterer modellzentrierter Workflow:
starkes Schlussfolgern + externe Orchestrierung

GPT-6-Astra-Workflow:
stärker für Agentenaufgaben trainiertes Schlussfolgern + eine darauf ausgelegte externe Orchestrierung
Das zweite System ist leistungsfähiger, weil das Modell selbst besser darin ist, zu planen, Feedback zu nutzen, Tools zu bedienen, Arbeit zu delegieren und über lange Aufgabenverläufe hinweg kohärent zu bleiben.
2. Vergleich innerhalb der OpenAI-Familie: Ein vertikaler Sprung, kein universeller Ersatz
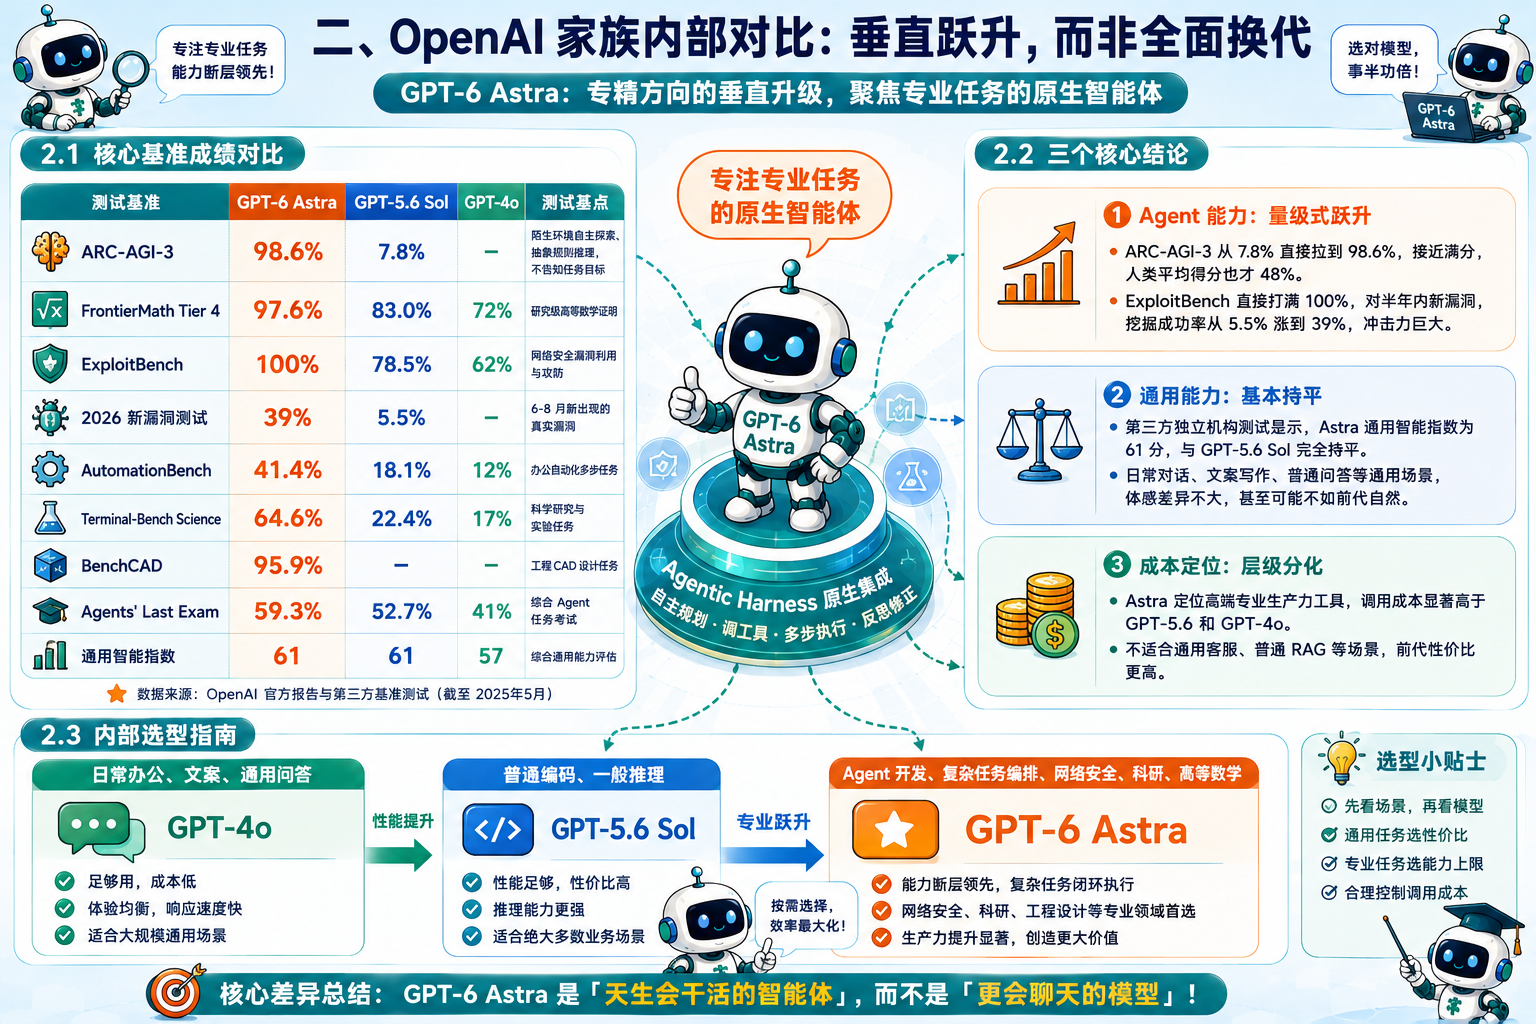
Der nützlichste Punkt des ursprünglichen Artikels ist, dass Astra nicht automatisch jedes günstigere Modell für jeden Workload ersetzt.
Die größten Verbesserungen zeigen sich bei anspruchsvollen Agenten- und professionellen Aufgaben.
2.1 Vergleich zentraler Benchmarks
Die folgende Tabelle verwendet, sofern verfügbar, Werte aus dem offiziellen Vergleich zur Einführung von GPT-6 Astra durch OpenAI.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Was wird getestet? |
|---|---|---|---|
| ARC-AGI-3 | 99,9 % | 7,8 % | Neue interaktive Umgebungen und die Entdeckung abstrakter Regeln |
| FrontierMath Tier 4 (v2) | 97,6 % | 83,0 % | Mathematik auf Forschungsniveau |
| ExploitBench | 100,0 % | 78,5 % | Entwicklung von Exploits für bekannte Schwachstellen in Evaluationsumgebungen |
| ExploitBench, Juni–August 2026 | 39,0 % | 5,5 % | Aktuelle Schwachstellen nach dem Wissensstichtag des Modells |
| AutomationBench | 41,4 % | 18,1 % | Mehrstufige professionelle Automatisierung |
| Terminal-Bench Science 0.1 | 64,6 % | 22,4 % | Wissenschaftliche Workflows mit Code und Terminal-Tools |
| BenchCAD | 95,9 % | 83,3 % | CAD-Rekonstruktion aus Darstellungen mehrerer Perspektiven |
| Agents’ Last Exam | 59,3 % | 53,6 % | Komplexe professionelle Aufgaben mit Computernutzung |
| Artificial Analysis Intelligence Index v4.1.1 bei der Einführung | 61,2 | 60,9 | Unabhängiger, zusammengesetzter Intelligenzindex |
Beim Lesen dieser Tabelle sind einige Details wichtig.
Erstens rundet OpenAIs Überschrift den Wert für FrontierMath Tier 4 auf 98 %, während die Benchmarktabelle für die v2-Evaluation 97,6 % ausweist.
Zweitens ist das auffällige Ergebnis bei ARC-AGI-3 ein agentischer interaktiver Benchmark. OpenAI weist darauf hin, dass Astra mit dem Responses-API-Harness ausgeführt wurde und dass sich die Evaluationsumgebung von produktivem ChatGPT unterscheiden kann.
Drittens wurden die Cybersicherheitswerte unter kontrollierten Evaluationsbedingungen gemessen. OpenAI stuft Astra im Rahmen seines Preparedness Framework inzwischen als Modell ein, das die Fähigkeitsschwelle Critical im Bereich Cybersicherheit erreicht, und setzt für diese Fähigkeiten stärkere Schutzmaßnahmen ein.
2.2 Drei zentrale Schlussfolgerungen
① Agentische Aufgaben und Aufgaben mit Umgebungsinteraktion zeigen den größten Sprung
ARC-AGI-3 ist das deutlichste Beispiel.
Astra erreicht in OpenAIs veröffentlichter Evaluation 99,9 % gegenüber 7,8 % bei GPT-5.6 Sol. Der Benchmark verlangt, dass ein System Ziele und Regeln durch Interaktion ableitet, statt lediglich aus einem statischen Prompt zu antworten.
Dasselbe Muster zeigt sich bei mehreren operativen Benchmarks:
- AutomationBench: 41,4 % gegenüber 18,1 %.
- Terminal-Bench Science: 64,6 % gegenüber 22,4 %.
- Der aktuelle ExploitBench-Datensatz: 39,0 % gegenüber 5,5 %.
Deshalb kann sich Astra bei Agenten-Workflows wie ein deutlich größerer Generationssprung anfühlen als im gewöhnlichen Chat.
② Die allgemeine zusammengesetzte Intelligenz liegt deutlich näher beieinander
Beim Artificial Analysis Intelligence Index v4.1.1 zum Zeitpunkt der Einführung meldete OpenAI:
GPT-6 Astra: 61,2
GPT-5.6 Sol: 60,9
Claude Fable 5.1: 65,7
Der Abstand zwischen Astra und Sol bei diesem zusammengesetzten Index war im Vergleich zum Abstand bei ARC-AGI-3 oder Terminal-Bench Science sehr gering.
Artificial Analysis verwendet inzwischen v4.2 mit einer anderen Benchmark-Zusammensetzung, sodass sich die absoluten Zahlen geändert haben. Die übergeordnete Schlussfolgerung bleibt bestehen: Astras herausragender Vorteil besteht nicht darin, dass sich jede allgemeine Intelligenzmetrik plötzlich verdoppelt.
③ Der Preis ordnet Astra eindeutig in die Premiumklasse ein
Die Standardpreise von OpenAI für die GPT-6-Astra-API lauten:
| Tokentyp | Preis pro 1 Mio. Token |
|---|---|
| Eingabe | 10,00 $ |
| Zwischengespeicherte Eingabe | 1,00 $ |
| Cache-Schreibvorgang | 12,50 $ |
| Ausgabe | 50,00 $ |
GPT-5.6 Sol ist derzeit günstiger und kostet 4 $ pro Million Eingabetoken sowie 20 $ pro Million Ausgabetoken.
Astra ist daher vor allem dann sinnvoll, wenn eine bessere Aufgabenerledigung den höheren Tokenpreis ausgleicht.
Es gibt außerdem ein wichtiges Detail bei der Preisgestaltung für lange Kontexte: Anfragen mit mehr als 272.000 Eingabetoken werden für die gesamte Anfrage zu höheren Sätzen abgerechnet – laut aktueller Astra-Modellseite mit dem Doppelten der Eingabe- und Cachesätze sowie dem 1,5-Fachen der Ausgabesätze.
2.3 Interner Leitfaden zur Modellauswahl
Der ursprüngliche Artikel verwendete GPT-4o als kostengünstige Option für allgemeine Aufgaben. GPT-4o ist weiterhin im API-Katalog vorhanden, doch OpenAIs aktuelle Modellleitlinien verweisen Entwickler bei den meisten neuen Integrationen inzwischen auf neuere Modelle der GPT-5.6-Familie.
Ein aktuellerer Leitfaden zur Auswahl lautet:
| Szenario | Empfohlener Ausgangspunkt | Warum? |
|---|---|---|
| Allgemeine Aufgaben mit hohem Volumen und Kostensensibilität | GPT-5.6 Luna oder Terra | Geringere Kosten und für viele routinemäßige Workloads ausreichende Fähigkeiten |
| Professionelles Schlussfolgern und Programmieren | GPT-5.6 Sol | Starke professionelle Leistung bei geringerem Preis als Astra |
| Schwierige End-to-End-Workflows, Computernutzung, wissenschaftliche Aufgaben, fortgeschrittene Agentenarbeit | GPT-6 Astra | Am besten geeignet für anspruchsvolle mehrstufige Ausführung und toolintensive Arbeit |
| Bestehende GPT-4o-Integration | GPT-4o kann weiterhin geeignet sein | Noch verfügbar, aber nicht die Standardempfehlung für neue Frontier-Workflows |
Die praktische Regel ist einfach:
Beginne mit dem günstigsten Modell, das die Aufgabe zuverlässig erledigt. Wechsle zu Astra, wenn Aufgabenerfolg, Autonomie oder Ausführungsqualität wichtiger sind als der reine Tokenpreis.
3. Anbieterübergreifender Vergleich: GPT-6 Astra vs. Anthropic Claude
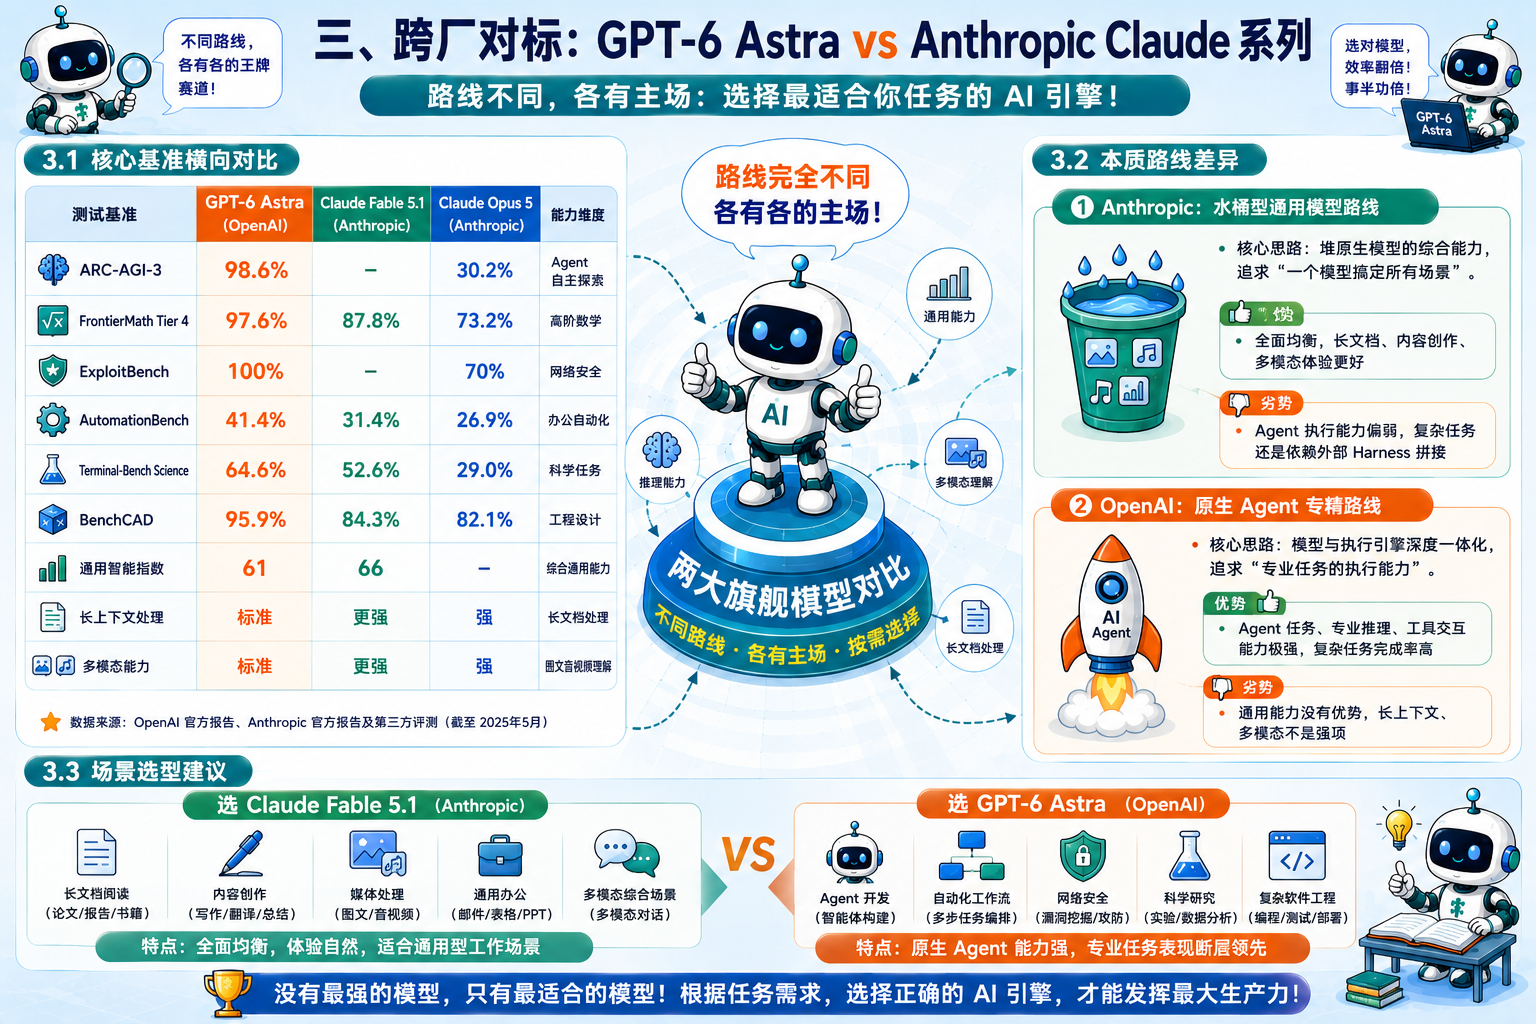
Der Ausgangsartikel stellt OpenAI und Anthropic so dar, als würden sie völlig unterschiedliche Wege verfolgen.
An dieser Betonung ist etwas Wahres, doch die aktuellen Produkte überschneiden sich stärker, als diese Darstellung vermuten lässt.
Auch Claude Fable 5.1 wurde ausdrücklich für lang laufende Agenten, Programmierung, Browsernutzung, Unternehmens-Workflows und verwaltete Agentenausführung entwickelt. Astra ist ebenfalls ein multimodales Modell mit einem Kontextfenster von 1 Million Token und starkem allgemeinen Schlussfolgern.
Der genauere Vergleich lautet daher nicht: „Das eine ist ein Agent, das andere nicht.“
Entscheidend ist vielmehr, wo jedes System derzeit die stärksten Belege und die deutlichste Produktgewichtung zeigt.
3.1 Vergleich zentraler Benchmarks
Die folgenden Werte stammen, sofern nicht anders angegeben, aus OpenAIs Vergleichstabelle zur Einführung.
| Benchmark | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5 | Fähigkeitsdimension |
|---|---|---|---|---|
| ARC-AGI-3 | 99,9 % | — | 30,2 % | Interaktives abstraktes Schlussfolgern |
| FrontierMath Tier 4 (v2) | 97,6 % | 87,8 % | 73,2 % | Fortgeschrittene Mathematik |
| ExploitBench | 100,0 % | — | 70,0 % | Cybersicherheits-Evaluation |
| AutomationBench | 41,4 % | 31,4 % | 26,9 % | Professionelle Automatisierung |
| Terminal-Bench Science 0.1 | 64,6 % | 52,6 % | 30,0 % | Wissenschaftliche Workflows |
| BenchCAD | 95,9 % | 84,3 % | 82,1 % | Engineering/CAD |
| Agents’ Last Exam | 59,3 % | — | 55,5 % | Professionelle Aufgaben mit Computernutzung |
| Artificial Analysis Intelligence Index v4.1.1 bei der Einführung von Astra | 61,2 | 65,7 | 63,1 | Unabhängiger, zusammengesetzter Index |
Ein Gedankenstrich bedeutet nicht, dass das Modell nicht leistungsfähig ist. Er bedeutet, dass OpenAIs Vergleichstabelle für diesen Eintrag keinen direkt vergleichbaren Wert veröffentlicht hat.
3.2 Der nützlichere Vergleich der unterschiedlichen Schwerpunkte
① Anthropic: Lang laufende Wissensarbeit und Programmierung mit starken allgemeinen Fähigkeiten
Anthropic positioniert Claude Fable 5.1 als sein leistungsfähigstes allgemein verfügbares Modell für anspruchsvolle Programmier- und Wissensarbeitsaufgaben.
Die offizielle Produktseite betont:
- Lang laufende Projekte, die Stunden dauern können.
- Programmierung über ganze Codebasen hinweg.
- Verwaltete Agenten.
- Browserbedienung.
- Unternehmens-Workflows.
- Visuelles Verständnis von Diagrammen, Grafiken, Tabellen, Dateien und PDFs.
- Kontext der 1-Millionen-Token-Klasse.
- Hochwertige Recherche und professionelle Arbeit.
Fable 5.1 führte außerdem den Artificial-Analysis-Kompositindex v4.1.1 zum Zeitpunkt der Einführung an und gehört weiterhin zu den stärksten Modellen auf der aktuellen unabhängigen Rangliste.
Daher wäre es falsch, Claude auf ein „Chatmodell zu reduzieren, das weiterhin einen externen Harness benötigt“. Wie Astra ist auch Claude Teil eines Agenten-Stacks; sowohl das Modell als auch die umgebende Ausführungsumgebung sind entscheidend.
② OpenAI: Stärkere Belege bei mehreren Benchmarks für Computernutzung und Tool-Ausführung
Astras Ergebnisse zur Einführung sind besonders stark in folgenden Bereichen:
- Computernutzung.
- AutomationBench.
- ARC-AGI-3.
- Terminal-Bench Science.
- BenchCAD.
- Cybersicherheits-Evaluation.
OpenAI führte rund um Astra außerdem API-Funktionen mit Agentenfokus ein, etwa asynchrone Tool-Aufrufe und Steuerung mitten im Turn. Das Unternehmen dokumentiert zudem, dass Astra Arbeit aufteilen und an Unteragenten delegieren kann, wenn der Harness Kollaborationstools bereitstellt.
Das macht Astra besonders attraktiv, wenn es weniger darum geht, eine einzelne ausgefeilte Antwort zu erzeugen, sondern vielmehr darum, einen anspruchsvollen Workflow über mehrere Tools und Umgebungen hinweg abzuschließen.
3.3 Langer Kontext und Multimodalität sind keine einseitigen Vorteile
Der ursprüngliche Artikel bezeichnet Astras langen Kontext und Multimodalität lediglich als „Standard“ und Claude als stärker.
Die aktuellen Spezifikationen machen diese Schlussfolgerung zu pauschal.
GPT-6 Astra unterstützt:
- Ein Kontextfenster von 1.050.000 Token.
- Bildeingaben.
- Textausgaben.
- Websuche.
- Dateisuche.
- Computernutzung.
- MCP.
- Code Interpreter und eine gehostete Shell über die Responses API.
Claude Fable 5.1 unterstützt ebenfalls einen Kontext der 1-Millionen-Token-Klasse, Bildeingaben, das Verständnis von Dateien und PDFs, Programmierung, Browsernutzung und lang laufende Agenten-Workflows.
Die richtige Entscheidung sollte daher aus dem konkreten Workload und einer eigenen Evaluation hervorgehen und nicht allein aus der Größe des Kontextfensters.
3.4 Szenariobasierte Auswahl
Wähle zunächst Claude Fable 5.1, wenn dein Workload vor allem von Folgendem geprägt ist:
- Umfangreichen Wissensarbeitsprojekten.
- Langen Programmierprojekten, bei denen der Claude-Workflow zu deinem Team passt.
- Dokumentenintensiver Analyse.
- Detaillierter Interpretation von PDFs, Tabellen und Grafiken.
- Verwalteten Agenten-Workflows innerhalb des Anthropic-Ökosystems.
Wähle zunächst GPT-6 Astra, wenn dein Workload vor allem von Folgendem geprägt ist:
- Komplexen Aufgaben mit Computernutzung.
- Toolintensiver End-to-End-Automatisierung.
- Schwierigen wissenschaftlichen Workflows.
- CAD- und Engineering-Automatisierung.
- Agentenorchestrierung innerhalb des OpenAI-Ökosystems.
- Autorisierter defensiver Cybersicherheitsforschung und Schwachstellenforschung im Rahmen der geltenden Schutzmaßnahmen und Richtlinien.
Bei wichtigen Produktionssystemen solltest du beide Modelle zunächst anhand repräsentativer eigener Aufgaben testen, bevor du dich standardisierst.
4. Der technische Kern: Warum ist die Leistung bei Agentenaufgaben so stark gestiegen?
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
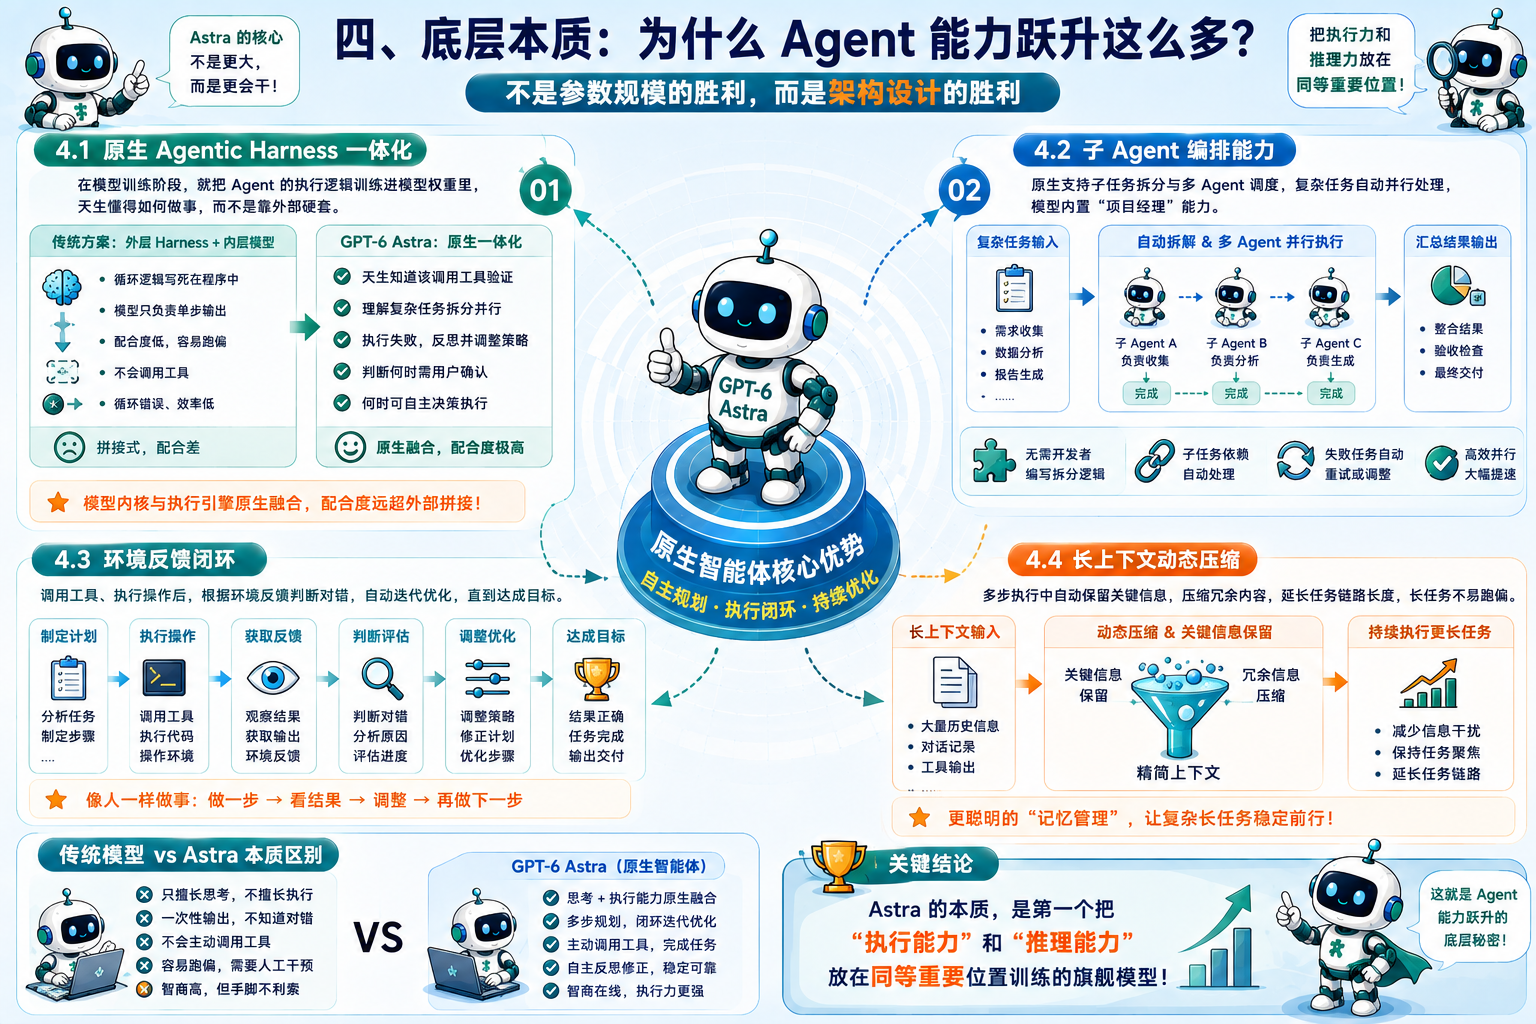
Der Ausgangsartikel führt Astras Verbesserungen hauptsächlich auf die Architektur und nicht auf die Anzahl der Parameter zurück.
OpenAI hat die Parameterzahl von Astra nicht offengelegt. Daher lassen sich Aussagen über den direkten Einfluss der Modellgröße nicht überprüfen.
Dokumentiert hat OpenAI eine Kombination aus Modelltraining, Verbesserungen zur Inferenzzeit und dem Design eines agentischen Harness.
4.1 Gemeinsames Design von Modell und Harness
Die wichtigste Korrektur zum Ausgangstext liegt an dieser Stelle.
OpenAI sagt nicht, dass der gesamte Agentic Harness buchstäblich in Astras Modellgewichte eingebettet wurde.
OpenAI beschreibt seinen agentischen Harness separat als Orchestrierungsebene, die Modelle, Tools und die Benutzerumgebung verbindet. Außerdem erklärt OpenAI, dass Astra darauf trainiert wurde, mehrstufige Arbeit innerhalb solcher Systeme effektiver auszuführen.
Die praktische Architektur sieht eher so aus:
Nutzerziel
   ↓
Agentischer Harness / Responses API
   ↓
GPT-6 Astra
   ↓
Tool-Anfrage oder delegierte Teilaufgabe
   ↓
Anwendung / Tool führt die Arbeit aus
   ↓
Ergebnis kehrt zu Astra zurück
   ↓
Astra aktualisiert seinen Plan
   ↓
Fortsetzung bis zum Abschluss
Diese Unterscheidung ist für Entwickler wichtig, weil die Anwendung weiterhin zentrale Verantwortlichkeiten übernimmt, etwa:
- Implementierung der Tools.
- Berechtigungen.
- Authentifizierung.
- Isolierung der Umgebung.
- Genehmigungsrichtlinien.
- Wiederholungs- und Fehlerbehandlung.
- Protokollierung und Beobachtbarkeit.
- Sicherheitsgrenzen.
Ein besseres Modell verringert den Bedarf an fehleranfälligen Prompt- und Orchestrierungslogiken, beseitigt aber nicht die Notwendigkeit systemischer Entwicklung.
4.2 Delegation an Unteragenten
OpenAI zufolge wurde GPT-6 Astra darauf trainiert, Arbeit aufzuteilen und an Unteragenten zu delegieren, die parallel arbeiten können.
Der offizielle Leitfaden erklärt jedoch ebenfalls ausdrücklich, dass dies dann geschieht, wenn du in deinem Harness ein Multi-Agenten-System implementierst und Kollaborationstools bereitstellst.
Das bedeutet, dass Astra ein Verhalten ähnlich dem eines Projektmanagers beitragen kann:
Komplexes Ziel
→ Aufteilung in unabhängige Arbeitsstränge
→ Parallele Delegation
→ Ergebnisse sammeln
→ Abhängigkeiten auflösen
→ Hauptaufgabe fortsetzen
Die eigentliche Erstellung, Ausführungsumgebung und Kommunikationsschnittstelle dieser Unteragenten stammen jedoch weiterhin aus dem umgebenden Agentensystem.
4.3 Feedbackschleifen mit der Umgebung
Astras stärkste Ergebnisse entstehen häufig bei Benchmarks, in denen das Modell mit einer Umgebung interagieren und Resultate beobachten kann.
Eine robuste Agentenschleife sieht so aus:
Planen
→ handeln
→ Ergebnis beobachten
→ beurteilen, ob es funktioniert hat
→ Plan überarbeiten
→ erneut handeln
Das unterscheidet sich grundlegend von der einmaligen Textgenerierung.
Das Modell kann zurückgegebene Tool-Ergebnisse nutzen, um zu entscheiden, ob es fortfahren, einen Versuch wiederholen, die Strategie ändern oder den Benutzer um eine Klarstellung bitten soll.
Die aktuellen Funktionen der Responses API von OpenAI unterstützen diesen Arbeitsstil unter anderem mit:
- Tool-Aufrufen.
- Asynchronen Tool-Aufrufen.
- Steuerung mitten im Turn.
- Persistiertem Reasoning.
- Gesprächszustand.
- Komprimierung.
- Computernutzung.
4.4 Verwaltung langer Kontexte und Komprimierung
Lange Agentenaufgaben erzeugen ein Problem bei der Kontextverwaltung.
Jedes Tool-Ergebnis, jede Datei, jeder Reasoning-Zweig und jede frühere Aktion kann mehr Verlauf hinzufügen. Wenn das System einfach alles erneut übermittelt, wird der Kontext teuer und unübersichtlich.
Astra verfügt über ein Kontextfenster von 1,05 Millionen Token, doch OpenAI unterstützt für lang laufende Gespräche mit der Responses API außerdem eine explizite Komprimierung.
Das nützliche Muster lautet:
Großer Aufgabenverlauf
→ wichtigen aktuellen Zustand bewahren
→ ältere Informationen komprimieren
→ für die Fortsetzung benötigte Fakten erhalten
→ Arbeit fortsetzen
Komprimierung ist kein magisches Gedächtnis. Entwickler sollten dauerhaften Projektstatus weiterhin in Repositories, Datenbanken, Dokumenten oder anderen Speichern sichern, statt sich auf ein unendlich wachsendes Gespräch zu verlassen.
4.5 Asynchrone Tool-Aufrufe verändern lang laufende Arbeit
Eine der neuen API-Funktionen von Astra sind asynchrone Tool-Aufrufe.
Das Modell kann weiter schlussfolgern, andere Tools aufrufen oder unabhängige Teile einer Aufgabe beantworten, während die Anwendung noch ein anderes Tool ausführt. Sobald dieses Tool fertig ist, sendet die Anwendung sein Ergebnis über die ursprüngliche Aufrufkennung zurück.
Das reduziert unnötige Wartezeiten in Workflows, in denen ein Tool langsam ist.
Es zeigt außerdem, warum der Sprung bei Agentenaufgaben eine Verbesserung auf Systemebene und nicht einfach nur ein größeres neuronales Netzwerk ist.
4.6 Sicherheit ist Teil der Agentenarchitektur
Eine autonomere Ausführung erhöht die Kosten eines Fehlers.
OpenAI kombiniert Astra daher mit stärkeren Schutzmaßnahmen und einer Überwachung auf Fehlanpassung. Die Sicherheitsinformationen des Unternehmens besagen, dass Astra das erste OpenAI-Modell ist, das als Modell mit der Fähigkeitsschwelle Critical im Bereich Cybersicherheit eingestuft wurde.
OpenAI berichtet außerdem von verbessertem Verhalten bei Tests, mit denen untersucht wird, ob das Modell über autorisierte Aufgabengrenzen hinausgeht.
Für Entwickler bedeutet das, dass die Architektur Folgendes enthalten sollte:
- Eng begrenzte Tool-Berechtigungen.
- Explizite Autorisierungsgrenzen.
- Isolierung riskanter Umgebungen.
- Menschliche Bestätigung für folgenschwere Aktionen.
- Überwachung und Prüfprotokolle.
- Eine zuverlässige Stopp- oder Not-Aus-Funktion.
Ein leistungsfähigeres Agentenmodell macht diese Kontrollen wichtiger, nicht weniger wichtig.
Zentrale Schlussfolgerung: Astras Sprung lässt sich am besten als Kombination aus stärker auf Agentenaufgaben trainiertem Modellverhalten und einem leistungsfähigeren Ausführungs-Stack verstehen. Schlussfolgern und Ausführung sind enger koordiniert, doch Harness, Tools, Berechtigungen und Umgebung bleiben separate technische Ebenen.
5. Modellauswahl und Ausblick
5.1 Wann lohnt sich das Upgrade auf GPT-6 Astra?
Geeignete Einsatzfälle
Astra ist eine starke Option für:
- Komplexe Agentenanwendungen.
- Lang laufende Automatisierungs-Workflows.
- Computernutzungsaufgaben über reale Software hinweg.
- Umfangreiche Softwareentwicklungsaufgaben.
- Wissenschaftliche Workflows mit Code und Tools.
- CAD- und Engineering-Automatisierung.
- Fortgeschrittenes mathematisches Schlussfolgern.
- Autorisierte defensive Cybersicherheit und Schwachstellenforschung, sofern der Zugriff zulässig ist.
In diesen Bereichen zeigen OpenAIs veröffentlichte Evaluationen die deutlichste Trennung zu GPT-5.6 Sol.
Meist nicht erforderlich
Astra ist häufig nicht erforderlich für:
- Routinemäßige Texterstellung.
- Einfache Klassifizierung.
- Grundlegende Extraktion.
- Kundensupport mit hohem Volumen und geringem Risiko.
- Unkomplizierte RAG-Frage-Antwort-Workflows.
- Kleine Transformationen, bei denen günstigere Modelle bereits die Qualitätsanforderungen erfüllen.
- Workloads, bei denen sich der hohe Astra-Tokenpreis nicht durch eine bessere Aufgabenerledigung rechtfertigen lässt.
Für diese Szenarien können GPT-5.6 Terra oder Luna wirtschaftlichere Ausgangspunkte sein, während Sol weiterhin eine starke Standardwahl für professionelle Aufgaben ist.
5.2 Kosten sollten pro abgeschlossener Aufgabe und nicht nur pro Token gemessen werden
Astras Tokenpreise von 10/50 $ liegen deutlich über den Preisen von 4/20 $ für GPT-5.6 Sol.
Bei Agenten-Workflows ist es jedoch nicht immer am günstigsten, das Modell mit dem niedrigsten Tokenpreis auszuwählen.
Ein günstigeres Modell kann Folgendes erfordern:
- Mehr Wiederholungsversuche.
- Mehr Tool-Aufrufe.
- Mehr manuelle Korrekturen.
- Mehr menschliche Überwachung.
- Längere Aufgabenverläufe.
OpenAI zufolge erzielte Astra bei mehreren Evaluationen zur Einführung bessere Ergebnisse mit weniger Ausgabetoken und teilweise geringeren geschätzten API-Kosten pro abgeschlossener Benchmark-Aufgabe, obwohl der Preis pro Token höher ist.
So sollte ein Agentenmodell in der Produktion bewertet werden:
Gesamtkosten einer erfolgreichen Aufgabe
= Modell-Token
+ Tool-Kosten
+ Wiederholungsversuche
+ Latenz
+ menschliche Prüfung
+ Fehlerkosten
5.3 Die Wettbewerbsmetrik verschiebt sich in Richtung Aufgabenerledigung
Der größere Trend im Ausgangsartikel ist überzeugend.
Jahrelang konzentrierten sich Vergleiche von Frontier-Modellen stark auf:
- Größe der Parameterzahl.
- Kontextlänge.
- Statische Reasoning-Tests.
- Qualität allgemeiner Konversation.
- Multimodale Eingaben.
Diese Faktoren sind weiterhin wichtig.
Die nächste Phase fragt jedoch zunehmend:
- Kann das Modell eine mehrstündige Aufgabe abschließen?
- Kann es Software zuverlässig bedienen?
- Kann es sich nach einem fehlgeschlagenen Tool-Aufruf erholen?
- Kann es innerhalb der Autorisierungsgrenzen bleiben?
- Kann es Arbeit intelligent delegieren?
- Kann es während der Arbeit neue Anweisungen integrieren?
- Kann es ein fertiges Artefakt statt nur eines Vorschlags erzeugen?
Astra ist eines der deutlichsten Beispiele für diesen Wandel.
5.4 „Agenten-nativ“ bedeutet nicht „kein Harness erforderlich“
Dies ist die wichtigste technische Erkenntnis.
Ein Modell kann stark agentenorientiert sein und trotzdem einen Harness benötigen.
Je besser das Modell bei der Ausführung komplexer Aufgaben wird, desto wertvoller wird ein gut konzipierter Harness, weil er Folgendes bereitstellt:
- Sicheren Tool-Zugriff.
- Zuverlässigen Zustand.
- Kontextverwaltung.
- Nebenläufigkeit.
- Genehmigungen.
- Sandboxing.
- Beobachtbarkeit.
- Wiederherstellungslogik.
Entwickler sollten daher nicht aufhören, sich mit Agentenentwicklung zu beschäftigen, nur weil Astra besser mit Agentenaufgaben umgehen kann.
Sie sollten sie noch gründlicher erlernen.
5.5 Abschließende Perspektive
GPT-6 Astra sollte weder als universeller Ersatz betrachtet noch abgetan werden, nur weil ein allgemeiner zusammengesetzter Score nahe an dem eines anderen Frontier-Modells liegt.
Sein größter Wert zeigt sich, wenn die Aufgabe ein Workflow und kein Prompt ist.
Wenn deine Anwendung hauptsächlich kurze Antworten benötigt, kann ein günstigeres Modell die bessere technische Wahl sein.
Wenn deine Anwendung ein KI-System benötigt, das über viele Schritte hinweg untersuchen, entscheiden, handeln, überprüfen, sich erholen und fortfahren kann, ist Astra deutlich interessanter.
Das ist das eigentliche Signal dieses Generationswechsels.
FAQ
Was ist GPT-6 Astra?
GPT-6 Astra ist OpenAIs aktuelles Flaggschiffmodell für anspruchsvolle End-to-End-Arbeit. OpenAI positioniert es für komplexes Schlussfolgern, Programmierung, Computernutzung, Recherche, professionelle Workflows und toolintensive Agentenaufgaben.
Ist GPT-6 Astra wirklich ein „natives Agentenmodell“?
Es ist genauer, Astra als für Agentenaufgaben optimiertes Modell zu bezeichnen, statt zu sagen, der gesamte Agenten-Harness befinde sich im Modell. Astra wurde für mehrstufige Arbeit, Tool-Nutzung und die Delegation an Unteragenten trainiert, während Codex, ChatGPT Work oder deine eigene Anwendung weiterhin den externen Harness, die Tools, Berechtigungen und die Ausführungsumgebung bereitstellen.
Wie lautet die API-Modell-ID von GPT-6 Astra?
Die API-Modell-ID lautet gpt-6-astra. OpenAI stellt es derzeit über die Responses API und Chat Completions bereit, wobei die Tool-Aufrufe für Astra rund um die Responses API dokumentiert sind.
Wie viel kostet GPT-6 Astra?
Die Standardpreise für die API betragen 10 $ pro Million Eingabetoken und 50 $ pro Million Ausgabetoken. Zwischengespeicherte Eingaben kosten 1 $ pro Million Token, Cache-Schreibvorgänge 12,50 $ pro Million Token. Anfragen mit mehr als 272.000 Eingabetoken unterliegen nach den aktuellen Preisregeln höheren Sätzen für lange Kontexte.
Wie vergleicht sich GPT-6 Astra mit GPT-5.6 Sol?
Astra ist bei mehreren veröffentlichten agentischen Evaluationen und Aufgaben mit Umgebungsinteraktion deutlich stärker, darunter ARC-AGI-3, AutomationBench, Terminal-Bench Science und aktuelle Cybersicherheitsaufgaben. Sol ist weiterhin deutlich günstiger und eine starke Wahl für allgemeines professionelles Schlussfolgern und Programmieren, wenn die Aufgabenausführung auf Astra-Niveau nicht erforderlich ist.
Wie vergleicht sich GPT-6 Astra mit Claude Fable 5.1?
Beide sind Frontier-Modelle für komplexe, lang laufende Aufgaben. Astra zeigt derzeit besonders starke Ergebnisse in OpenAIs Vergleichen zu Computernutzung, Automatisierung, Wissenschaft, CAD und Cybersicherheit. Claude Fable 5.1 ist bei Programmierung und Wissensarbeit äußerst leistungsfähig und führte je nach Indexversion und Einstellungen für den Leistungsaufwand die jüngsten zusammengesetzten Artificial-Analysis-Evaluationen an.
Wie groß ist das Kontextfenster von GPT-6 Astra?
OpenAI dokumentiert ein Kontextfenster von 1.050.000 Token mit bis zu 128.000 Ausgabetoken. Sehr lange Anfragen sind teurer, und Entwickler sollten für lang laufende Agenten-Workflows weiterhin Komprimierung und dauerhaft gespeicherten externen Zustand verwenden.
Wann sollte ich Astra statt eines günstigeren Modells auswählen?
Wähle Astra, wenn höhere Erfolgsquoten bei schwierigen mehrstufigen Aufgaben den Premiumpreis rechtfertigen können. Für routinemäßige Extraktion, Support, Texterstellung, einfache RAG-Aufgaben oder Workloads mit hohem Volumen und geringem Risiko ist ein günstigeres Modell in der Regel der bessere Ausgangspunkt.
Verwandte Tools
- OpenAI Responses API: Die wichtigste API-Oberfläche für toolintensive und zustandsbehaftete Agenten-Workflows mit GPT-6 Astra.
- OpenAI Codex: OpenAIs Umgebung für Programmieragenten, die Frontier-Modelle mit einem externen agentischen Harness und Entwicklungstools kombiniert.
- GPT-6-Astra-Modellseite: Offizielle Modellspezifikationen, Preise, Kontextfenster, Tools und Ratenlimits.
- Anthropic Claude: Offizielle Produktseite von Claude Fable 5.1 für Programmierung, Wissensarbeit, visuelle Verarbeitung und lang laufende Agenten.
- Artificial Analysis: Unabhängige Plattform für Modell-Benchmarking und den Vergleich der API-Leistung.
- ARC Prize: Organisation hinter den ARC-AGI-Evaluationen, einschließlich interaktiver Benchmarks zum abstrakten Schlussfolgern.
Verwandte Links
- OpenAI: GPT-6 Astra – Eine neue Generation von Intelligenz: Offizielle Ankündigung, Benchmarktabellen, Verfügbarkeit und Informationen zum Preiskontext.
- OpenAI-Dokumentation zu GPT-6 Astra: Offizielle API-Modelldetails, unterstützte Tools, Kontextlimits und Tokenpreise.
- OpenAI-Leitfaden für GPT-6 Astra: Offizielle Hinweise zu asynchronen Tools, Steuerung mitten im Turn, Delegation an Unteragenten, Prompting und Migration.
- OpenAI-Sicherheitsübersicht zu GPT-6 Astra: Allgemeine Informationen zu Sicherheit und Bereitstellung von Astra.
- OpenAI: Der Weg zu Astra – Kritische Fähigkeiten und Schutzmaßnahmen für Frontier-Modelle: Hintergrund zur Bewertung von Astras Cybersicherheitsfähigkeiten und zu den Schutzmaßnahmen.
- Anthropic Claude Fable 5.1: Offizielle Informationen zu Verfügbarkeit, Preisen, Einsatzfällen, Schutzmaßnahmen und Benchmarks von Fable 5.1.
- Artificial Analysis: GPT-6 Astra: Unabhängige Auswertungen zu Leistung, Preisen und dem Intelligence Index von Astra.
- Originaler CSDN-Artikel: Originaler chinesischer Artikel, lizenziert unter CC BY-SA 4.0.
Zusammenfassung
GPT-6 Astra ist ein bedeutender Schritt für agentische Workflows. Die genaueste Beschreibung lautet jedoch nicht: „OpenAI hat den gesamten Agenten-Harness in das Modell integriert.“ Astra wurde besser für eine lange, mehrstufige Ausführung trainiert, während Codex, ChatGPT Work, die Responses API und individuelle Anwendungen weiterhin die Orchestrierung, Tools, Berechtigungen und Umgebung bereitstellen.
Die stärksten veröffentlichten Verbesserungen zeigen sich bei interaktivem Schlussfolgern, Computernutzung, professioneller Automatisierung, wissenschaftlichen Workflows, CAD und Cybersicherheits-Evaluationen. Bei breit angelegten zusammengesetzten Intelligenzmetriken kann der Unterschied zu anderen Frontier-Modellen deutlich kleiner ausfallen. Deshalb sollte Astra günstigere Modelle bei Routineaufgaben nicht automatisch ersetzen.
Für Entwickler ist die strategische Veränderung klar: Bei der Modellauswahl geht es zunehmend um erfolgreiche Aufgabenerledigung innerhalb eines Systems und nicht nur um die Qualität einer Antwort in einem Chatfenster.
GPT-6 Astra ist vor allem dann relevant, wenn das Problem nicht lautet: „Was sollte die KI sagen?“, sondern: „Kann die KI die Arbeit sicher von Anfang bis Ende erledigen?“


