For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/gpt-6-pro-parallel-agents-in-chatgpt-setu-69606eac.md.
Das GPT-6-Pro-Update von ChatGPT vom 16. Oktober ermöglicht es mehreren Agenten, an unterschiedlichen Teilen einer Aufgabe zu arbeiten. Nutz...
Das GPT-6-Pro-Update von ChatGPT vom 16. Oktober ermöglicht es mehreren Agenten, an unterschiedlichen Teilen einer Aufgabe zu arbeiten. Nutzer können ihren Fortschritt in der Unterhaltung verfolgen und abgeschlossene Aufgaben öffnen, um die Ergebnisse der einzelnen Agenten zu prüfen.
OpenAI kündigt außerdem schnellere Antworten sowie eine verbesserte Nutzung von Plugins und Tools an. In dieser Ankündigung werden jedoch weder eine quantifizierte Geschwindigkeitssteigerung noch eine maximale Anzahl von Agenten oder eine vollständige Erklärung zur Zusammenführung der Ergebnisse veröffentlicht.
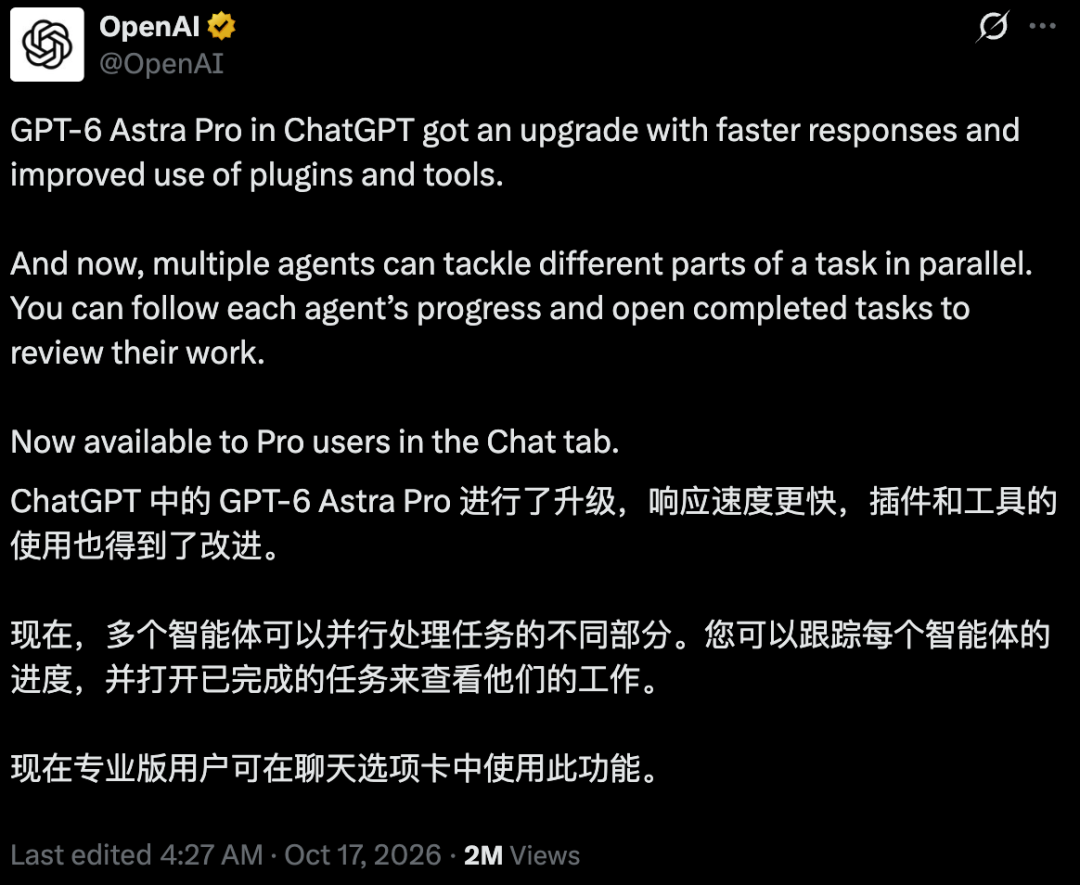
Das Update wird für berechtigte Pro-Nutzer ausgerollt. Die Verfügbarkeit in verwalteten Workspaces hängt von den Einstellungen und der Rollout-Berechtigung ab. Dass mehrere Agenten verfügbar sind, bedeutet nicht, dass jede Aufgabe schneller abgeschlossen wird: Nutzer müssen das kombinierte Ergebnis weiterhin selbst bewerten.
Die Quelle beschreibt folgenden Auswahlpfad:
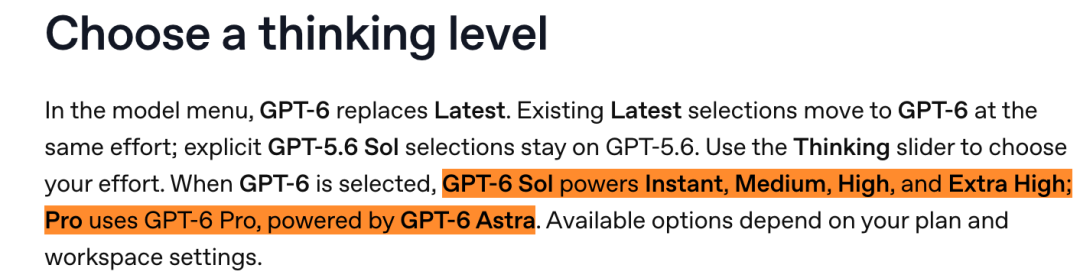
Bei GPT-6 verwenden die Einstellungen von Instant bis Extra High Sol, während Pro GPT-6 Pro auf Basis von Astra nutzt. Die verfügbaren Einstellungen hängen vom Tarif und vom Workspace-Zugriff ab. In der Ankündigung des Updates wird keine Prompt-Syntax angegeben, die eine bestimmte Anzahl von Agenten garantiert.
Die erste Änderung betrifft die Antwortgeschwindigkeit. „Schneller“ ist die genannte Verbesserung; die Quelle liefert keine kontrollierte Messung der Bearbeitungszeit vor und nach dem Update.
Die zweite Änderung betrifft die Tool-Nutzung. Ein Modell muss häufig suchen, Dateien prüfen oder mit einem externen Dienst interagieren, um eine Aufgabe abzuschließen. Eine bessere Tool-Verarbeitung könnte fehlgeschlagene Aufrufe und festgefahrene Schleifen reduzieren. Einzelne Beschwerden über Schleifen messen jedoch nicht die Wirksamkeit des Updates.
Für externe Dienste sind weiterhin die entsprechende Kontoverbindung und die erforderlichen Berechtigungen nötig. Eine Delegation autorisiert nicht automatisch den Zugriff auf ein neues System.
Die dritte Änderung ist paralleles Arbeiten. Ein Vergleich von drei Produkten könnte in unabhängige Untersuchungen aufgeteilt werden, bevor die Ergebnisse hinsichtlich Preis, Funktionen und Einschränkungen abgeglichen werden. Im Gegensatz dazu sind das Lesen eines Dokuments, die Auswahl eines darauf basierenden Tarifs und die Bearbeitung einer Datei gemäß diesem Plan voneinander abhängige Schritte.
Die Quelle enthält ein Nutzerbeispiel, bei dem eine Recherche zu einem Produktanforderungsdokument und Aufgaben-Tickets führt. Das ist ein potenziell nützlicher Workflow: Ein Artefakt wird zur Eingabe für die nächste Stufe.
Andere Nutzer weisen auf den Verwaltungsaufwand hin. Wenn jeder Agent einen langen Bericht in einem anderen Format zurückgibt, verbringt der Nutzer möglicherweise die eingesparte Wartezeit damit, die Ergebnisse abzugleichen. Fortschrittsanzeigen zeigen Aktivität, belegen aber nicht, dass die Arbeit korrekt ist.
Lege vor dem Start fest, was als Abschluss gilt: die zu beantwortenden Fragen, den Zeitraum, die benötigten Quellen und das Format des Ergebnisses. Ein Ergebnis, das Belege mit Schlussfolgerungen verknüpft, lässt sich leichter prüfen als eines, das lediglich den Erfolg erklärt.
Der Bericht vergleicht das Update anschließend mit dem Research-System von Anthropic. Der technische Bericht von Anthropic vom Juni 2025 beschreibt einen Orchestrator, der Recherchen plant, unabhängige Suchen delegiert und die zurückgegebenen Ergebnisse zusammenführt, ergänzt durch eine separate Zitierphase.
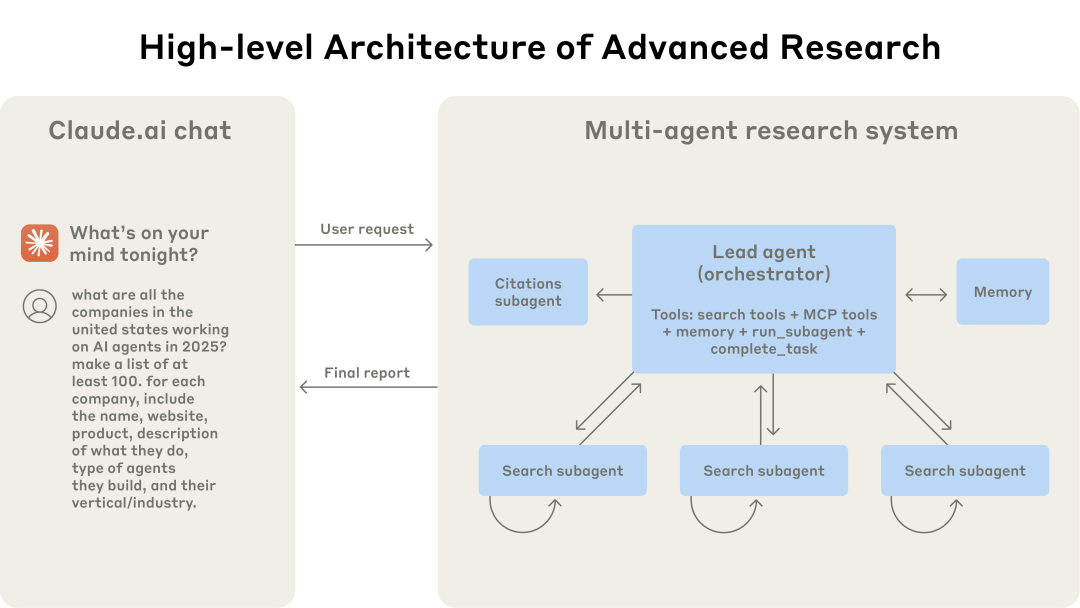
Das Design eignet sich besonders für breit gefasste Fragen mit mehreren unabhängigen Recherchepfaden. Anthropic betont außerdem, dass mehr Agenten mehr Tokens verbrauchen und dass sich eng voneinander abhängige Arbeiten möglicherweise nicht für diesen Ansatz eignen.
Die Quelle erweitert diesen Vergleich auf die dynamischen Workflows von Claude Code Projects und Managed Agents. Sie zitiert eine Demonstration von Anthropic zur Fehlersuche in 116.000 Codezeilen mit 70 absichtlich eingefügten Fehlern: In Einzelagenten-Läufen wurden 14, 15 und 27 Fehler gefunden, während dynamische Workflows jeweils 66 Fehler fanden. Das sind berichtete Ergebnisse für dieses Setup und keine allgemeine Garantie oder ein direkter Vergleich mit der neuen Funktion von ChatGPT.
Verschiedene Systeme bieten unterschiedliche Möglichkeiten, Aufgaben zu delegieren, Projektkontext zu bewahren und Hintergrundprozesse auszuführen. Die gemeinsame Verwendung mehrerer Agenten bedeutet nicht, dass ihr Zugriff, ihre Berechtigungen oder ihr Laufzeitverhalten identisch sind.
Anthropic beschreibt einen frühen Fehler bei der Delegation, bei dem zwei Agenten sich mit überschneidenden aktuellen Informationen beschäftigten, während ein weiterer ein anderes Jahr untersuchte. Das Problem waren nicht ausreichend klar abgegrenzte Aufgabenbereiche.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Ein hilfreiches Delegationsbriefing legt Ziel, Quellen, Umfang und Ausgabeformat fest. Es teilt jedem Bearbeiter außerdem mit, was in den Zuständigkeitsbereich anderer gehört. Ohne diese Grenzen können parallele Aktivitäten Suchvorgänge duplizieren und wichtige Lücken hinterlassen.
Auch das Zusammenführen erfordert Sorgfalt. Produktpreise müssen einheitliche Abrechnungszeiträume und Datumsangaben verwenden; Forschungsschlussfolgerungen müssen widersprüchliche Belege unterscheiden; Codeänderungen müssen mit Schnittstellen und Benennungen übereinstimmen. Zwei Agenten, die dieselbe Datei ändern, können Konflikte verursachen, selbst wenn beide Änderungen für sich genommen sinnvoll aussehen.
Kleine Aufgaben rechtfertigen möglicherweise nicht den Einrichtungs- und Übergabeaufwand. Ein sequenzieller Ansatz ist oft angemessen, wenn die Arbeit von früheren Entscheidungen abhängt oder Ressourcen wie Browser-Tabs begrenzt werden sollen.
Der Bericht unterscheidet den Astra-Zugriff in Work oder Codex vom GPT-6-Pro-Zugriff in Chat. Der Zugriff auf Astra Plus in anderen Umgebungen belegt nicht, dass ein Nutzer für diese Chat-Funktion berechtigt ist.
Außerdem unterscheidet der Bericht die Kontingente für Pro-Modelle in Chat vom gemeinsamen Nutzungspool für Work und Codex. Die wiedergegebenen Hilfeinformationen beschreiben ein wöchentliches GPT-6-Pro-Limit bei Pro $200 sowie ein gemeinsames wöchentliches Kontingent für Pro-Modelle bei Pro $100. Diese Regeln sind zeitabhängig. Prüfe daher vor der Planung eines Arbeitsaufwands den verlinkten offiziellen Modellartikel und den Hinweis im eigenen Konto.
Eine Anekdote über eine plötzlich gesunkene Codex-Nutzungsgrenze kann nicht belegen, wie die parallele Agentenarbeit in Chat abgerechnet wird. Die Ankündigung enthält keine Formel für die Abrechnung pro Agent. Ein kostenpflichtiges Pro-Abonnement sollte daher ebenfalls nicht als unbegrenzte Nutzung jedes Pro-Modells verstanden werden.
Der sinnvolle Vergleich ist der gesamte Aufwand, der für ein akzeptables Ergebnis erforderlich ist. Berücksichtige Koordination, wiederholte Tool-Aufrufe, den verbrauchten Nutzungsumfang sowie die Zeit, die eine Person für die Korrektur von Auslassungen oder Widersprüchen benötigt.
Bei Recherchen solltest du die Abdeckung der Belege prüfen und feststellen, ob die Schlussfolgerungen mit diesen übereinstimmen. Bei Code solltest du das Verhalten untersuchen und geeignete Prüfungen durchführen. Eine Aufgabe ist abgeschlossen, wenn das Ergebnis ihre Anforderungen erfüllt, nicht bereits dann, wenn jeder Agent den Status „abgeschlossen“ anzeigt.
Es ermöglicht mehreren Agenten, unterschiedliche Teile einer Aufgabe zu bearbeiten, während der Fortschritt in der Unterhaltung sichtbar bleibt. Abgeschlossene Aufgaben können zur Prüfung geöffnet werden.
Wähle in einem berechtigten Konto GPT-6 im Chat aus und wähle Pro beim Thinking-Regler. Wenn die Option fehlt, können der Tarifzugriff, die Workspace-Einstellungen oder der Rollout der Grund sein.
Unabhängige Recherchepfade können von paralleler Arbeit profitieren. Abhängige Schritte, kleine Aufgaben und Änderungen an gemeinsam genutzten Dateien können jedoch mehr Koordinationsaufwand verursachen, als sie einsparen.
Die geprüfte Ankündigung des Updates nennt keine maximale Anzahl. Sie veröffentlicht auch keine Regeln, die garantieren, wie viele Agenten eine bestimmte Anfrage auslösen wird.
Die Quelle und die verlinkte Modellhilfe beschreiben die geltenden Nutzungskontingente. Nutzer sollten den Hinweis zum Limit der jeweiligen Umgebung prüfen, anstatt davon auszugehen, dass Chat, Work und Codex identische Grenzen verwenden.
Der Status „abgeschlossen“ bedeutet, dass die Aufgabe ein Ergebnis zurückgegeben hat. Quellen, Dateien und Schlussfolgerungen müssen weiterhin anhand der Anforderungen validiert werden, insbesondere wenn mehrere Ergebnisse zusammengeführt werden müssen.
Das Update von GPT-6 Pro verbindet paralleles Arbeiten mit sichtbarem Fortschritt und überprüfbaren Ergebnissen. Außerdem kündigt es Verbesserungen bei Antwortgeschwindigkeit und Tool-Nutzung an, ohne eine vollständige Aufschlüsselung von Leistung oder Abrechnung zu veröffentlichen.
Eine gute Delegation reduziert Wartezeit nur dann, wenn die Ergebnisse korrekt, kompatibel und schnell zu prüfen sind.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



