For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/grok-45-coding-benchmarks-token-efficiency.md.
Grok 4.5 ist ein Grenzmodell, das auf Programmierung, Agenten und Wissensarbeit ausgerichtet ist. Seine stärksten praktischen Vorteile sind ...
Grok 4.5 katapultiert xAI zurück an die Spitze des Wettrennens um Programmiermodelle.
Das am 8. Juli 2026 veröffentlichte Modell wurde für Softwareentwicklung, agentische Aufgaben und breitere Wissensarbeit konzipiert. Es wurde mit Cursor trainiert und ist nun über die xAI-API, Grok Build und Cursor verfügbar. Die Schlagzeile betrifft nicht nur die Modellqualität. Grok 4.5 positioniert sich auch um schnelleres Serving, weniger generierte Token und niedrigere Kosten pro abgeschlossener Aufgabe.
Die offizielle Modelldokumentation listet ein 500.000-Token-Kontextfenster, Text- und Bildeingabe, konfigurierbares Reasoning, Funktionsaufrufe, Unterstützung für strukturierte Ausgaben und API-Preise von 2 $ pro Million Eingabe-Token und 6 $ pro Million Ausgabe-Token auf.
Dieser Artikel erläutert, wo Grok 4.5 gut abschneidet, wie seine Effizienzbehauptungen zu interpretieren sind, was sich beim Training geändert hat und warum der umgebende Inferenz-Stack genauso wichtig werden könnte wie das Modell selbst.

Grok 4.5 ist xAIs Flaggschiff-Modell für Programmierung, agentische Arbeit und allgemeine computergestützte Wissensaufgaben. Die offiziellen Launch-Materialien beschreiben es als ein Modell, das langlaufende Arbeiten bewältigen, Werkzeuge nutzen, sich von Fehlern erholen und Ergebnisse verifizieren kann, anstatt nach einer einzigen Antwort anzuhalten.
Das platziert es in derselben breiten Kategorie wie High-End-Modelle, die für autonomes Programmieren, änderungen auf Repository-Ebene, technische Recherche, Datenanalyse und mehrschrittige Büro-Workflows verwendet werden.
| Punkt | Grok 4.5 |
|---|---|
| Modellname | grok-4.5 |
| Primäre Anwendungsfälle | Programmieren, agentische Aufgaben, Wissensarbeit |
| Eingabemodalitäten | Text und Bilder |
| Ausgabemodalität | Text |
| Kontextfenster | 500.000 Token |
| Reasoning | Konfigurierbar |
| Funktionsaufrufe | Unterstützt |
| Strukturierte Ausgaben | Unterstützt |
| Eingabepreis | 2 $ pro 1 Mio. Token |
| Preis für gecachte Eingabe | 0,50 $ pro 1 Mio. Token |
| Ausgabepreis | 6 $ pro 1 Mio. Token |
| Gemeldete Serving-Geschwindigkeit | Bis zu 80 Token pro Sekunde |
| Verfügbarkeit | xAI-API, Grok Build, Cursor |
Das 500K-Kontextfenster ist groß genug für umfangreiche Codebasen, lange technische Dokumente, dateiübergreifende Untersuchungen und ausgedehnte Agenten-Historien. Ein großes Kontextfenster garantiert nicht automatisch bessere Ergebnisse, gibt Werkzeugen aber mehr Raum, um relevantes Quellmaterial ohne aggressive Kürzung bereitzustellen.
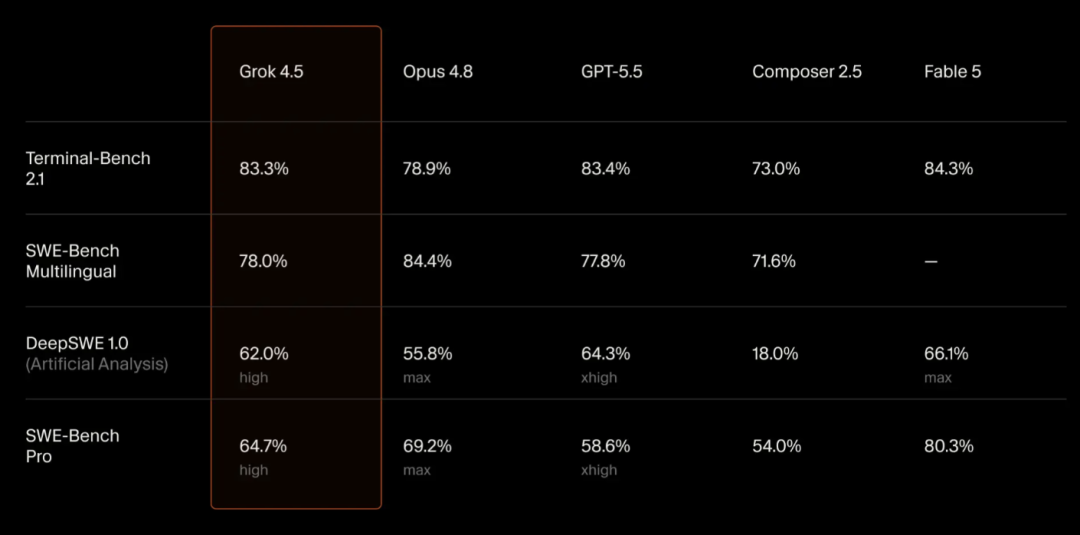
Die offizielle xAI-Ankündigung veröffentlicht Ergebnisse aus mehreren Softwareentwicklungs-Evaluierungen. Grok 4.5 ist nicht das Spitzenmodell bei jedem Benchmark, bleibt aber wettbewerbsfähig mit anderen Frontier-Systemen.
| Benchmark | Grok 4.5 | Ausgewählte Vergleichsergebnisse |
|---|---|---|
| DeepSWE 1.0 | 62,0% | Fable max 66,1%; GPT-5.5 xhigh 64,31%; Opus 4.8 max 55,75% |
| DeepSWE 1.1 | 53,0% | Fable max 70%; GPT-5.5 xhigh 67%; |
Opus 4.8 max 59 % |
| Terminal-Bench 2.1 | 83,3 % | Fable max 84,3 %; GPT-5.5 xhigh 83,4 %; Opus 4.8 max 78,9 % |
| SWE-Bench Pro | 64,7 % | Fable max 80,4 %; Opus 4.8 max 69,2 %; Opus 4.7 max 64,3 % |
| SWE Marathon | 29,0 % | Opus 4.8 max 26,0 %; Fable max 24,0 %; Opus 4.7 max 16,0 % |
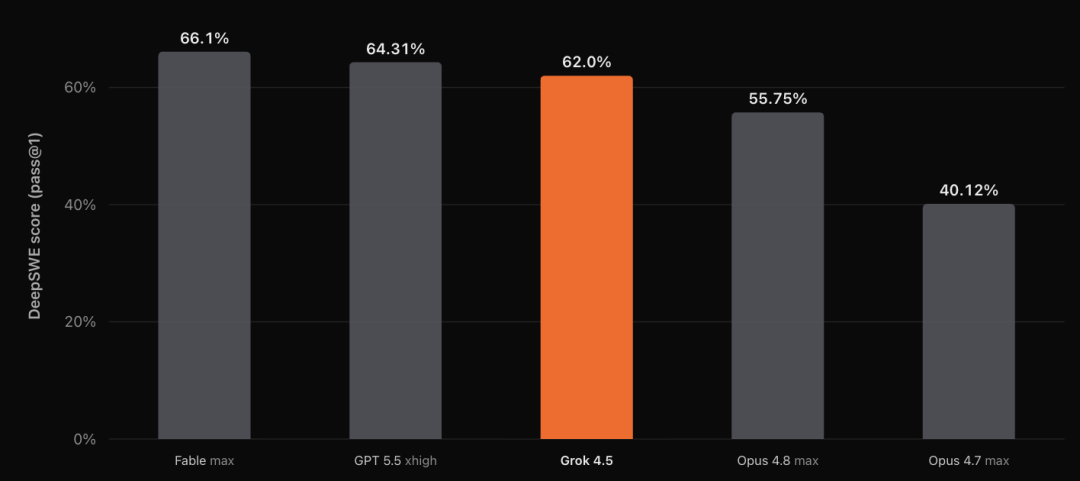
Diese Zahlen deuten auf ein Modell hin, das besonders stark bei Terminal-Aufgaben, praktischen Engineering-Aufgaben und längeren agentenbasierten Arbeitsabläufen ist. Sie sollten dennoch mit Vorsicht interpretiert werden. Benchmark-Umgebungen, Reasoning-Einstellungen, Tool-Zugriff und anbieterspezifische Konfigurationen können das Ergebnis beeinflussen.
Cursor hat zudem offengelegt, dass ein älterer Snapshot der Cursor-Codebasis versehentlich in den Trainingsdaten enthalten war, was Auswirkungen auf CursorBench haben könnte. Das Unternehmen hat diesen Benchmark aus seinem öffentlichen Vergleich ausgeschlossen und erklärt, dass die Daten nicht für zukünftige Modelle verwendet werden.
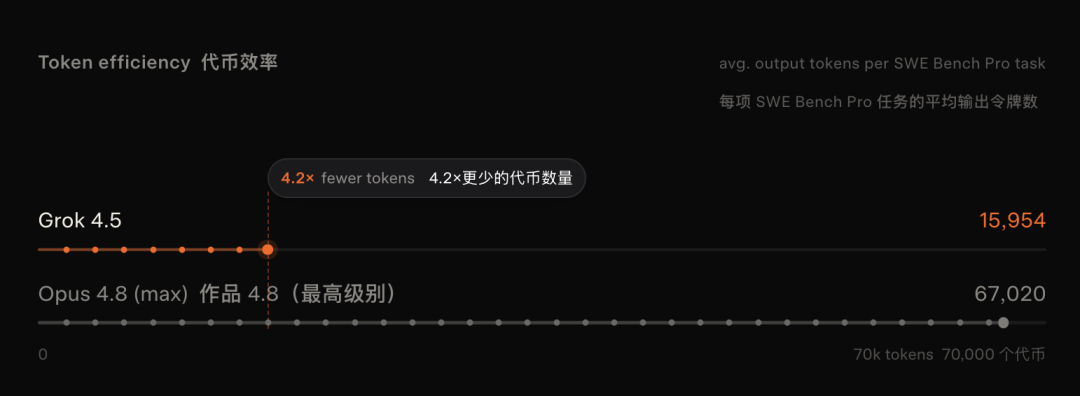
Die praktischste Behauptung in Bezug auf Grok 4.5 betrifft die Effizienz.
xAI gibt an, dass das Modell mit bis zu 80 Tokens pro Sekunde ausgeliefert wird. Das ist schnell genug, um lange Reasoning-Spuren, Repository-Bearbeitungen und iterative Agenten-Spiralen reaktionsschneller erscheinen zu lassen als langsamere Premium-Modelle.
Das Unternehmen berichtet außerdem, dass Grok 4.5 bei einer SWE-Bench Pro-Aufgabe durchschnittlich 15.954 Ausgabe-Tokens verwendete, verglichen mit 67.020 Ausgabe-Tokens für Opus 4.8 bei dessen maximaler Einstellung. Das entspricht etwa 4,2-mal weniger Ausgabe-Tokens bei der gemessenen Arbeitslast.
Token-Effizienz ist aus drei Gründen wichtig:
Die entscheidende Kennzahl ist nicht einfach der Preis pro Million Tokens. Teams sollten die Kosten für die Erledigung derselben Aufgabe bei einem akzeptablen Qualitätsniveau vergleichen. Ein Modell mit einem höheren gelisteten Token-Preis kann dennoch günstiger sein, wenn es weniger Versuche, weniger Tool-Aufrufe oder weniger
generierte Token.
Der Basis-API-Preis ist:
| Token-Typ | Preis |
|---|---|
| Eingabe | 2 $ pro 1 Mio. Token |
| Zwischengespeicherte Eingabe | 0,50 $ pro 1 Mio. Token |
| Ausgabe | 6 $ pro 1 Mio. Token |
Cursor bietet in seinem eigenen Modellangebot auch eine schnellere Variante für 4 $ pro Million Eingabe-Token und 18 $ pro Million Ausgabe-Token an. Preis und Verfügbarkeit können je nach Plattform variieren, daher sollten Produktionsteams den Tarif in der von ihnen tatsächlich genutzten Umgebung bestätigen.
Grok 4.5 soll mehr können, als nur eine Funktion zu vervollständigen oder einen Fehler zu erklären. Die offiziellen Beispiele umfassen:
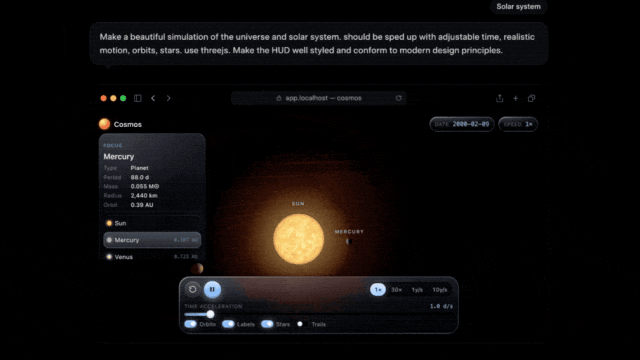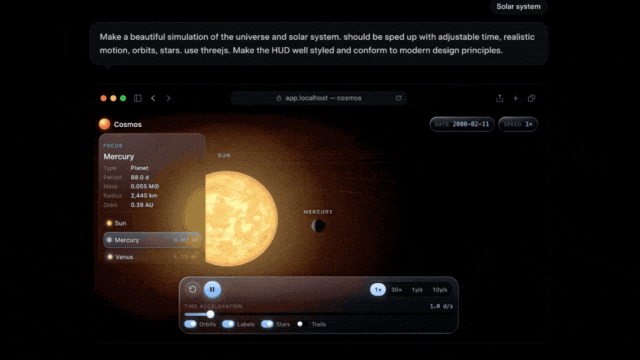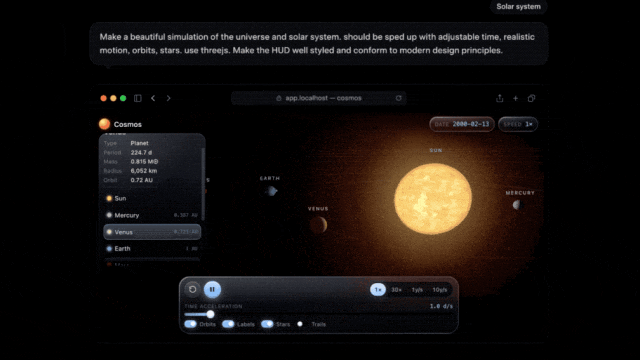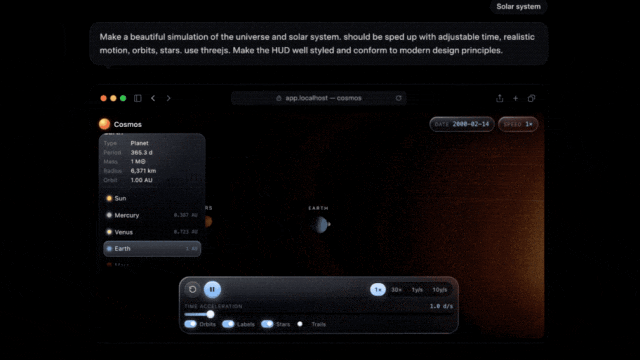
Die Sonnensystem-Demo ist nützlich, weil sie Design, Frontend-Code, 3D-Rendering, Steuerung und Interaktionslogik kombiniert. Sie ist kein Beweis dafür, dass jede Ein-Prompt-Anwendung produktionsreif ist, aber sie zeigt die Art von integrierter Aufgabe, für deren Bewältigung das Modell optimiert wird.
Grok 4.5 erstreckt sich auch auf die Büroarbeit. In den Launch-Materialien erstellt es strukturierte Geschäftspräsentationsfolien und arbeitet mit Tabellenkalkulationen, die Formeln, Websuche und mehrere Blätter umfassen.

Für Entwicklungsteams könnte ein praktischer Workflow so aussehen:
Ein Modell kann schnell und leistungsfähig sein und dennoch falsche Annahmen, unsichere Änderungen oder unvollständige Validierungen produzieren. Die beste Nutzung agentischer Codierungsmodelle ist in der Regel strukturierte Automatisierung mit sichtbaren Belegen, nicht uneingeschränkte Autonomie.
Die Effizienzgewinne werden nicht als einfache Optimierung des Serving präsentiert. Sowohl xAI als auch Cursor beschreiben Änderungen in der Modellarchitektur, Datenaufbereitung, verstärkendem Lernen und verteiltem Training.
Cursor beschreibt Grok 4.5 als ein Mixture-of-Experts-Modell. In einem MoE-System wird für ein bestimmtes Token oder eine Aufgabe nur ein Teil des Netzwerks aktiviert. Dies kann die Gesamtkapazität des Modells erhöhen, ohne dass jeder Parameter an jedem Inferenzschritt teilnehmen muss.
Die offiziellen Quellen veröffentlichen nicht genügend Implementierungsdetails, um die exakte Rechenleistung pro Token zu berechnen. Daher ist es genauer, sich auf gemessenes Verhalten – Geschwindigkeit, Benchmark-Qualität und Token-Verbrauch – zu konzentrieren, als aus einer unbestätigten Parameteranzahl auf die Leistung zu schließen.
xAI gibt an, dass Grok 4.5 auf Zehntausenden von NVIDIA GB300 GPUs trainiert wurde. Training in diesem Maßstab erfordert mehr als nur rohe Hardware. Lange Läufe benötigen stabile verteilte Systeme, Checkpoint-Wiederherstellung, Netzwerke, Datenpipelines und Überwachung, die Tausende von Beschleunigern produktiv halten können.
Die Ankündigung betont Stabilitätstechniken, die für sehr große Trainingsläufe entwickelt wurden. Dies ist wichtig, da ein Fehler in einem langen Experiment eine große Menge an Rechenleistung verschwenden kann, wenn das System sich nicht effizient erholen kann.
Die Trainingspipeline umfasste:
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Ziel ist es, die Dichte nützlicher Trainingssignale zu verbessern, anstatt sich nur auf das rohe Token-Volumen zu verlassen. Wiederholte, minderwertige oder schwach relevante Daten können die Trainingskosten erhöhen, ohne die gleiche Verbesserung zu bieten wie sorgfältig ausgewählte Beispiele.
Cursor gibt an, dass das Modell mit Billionen von Tokens von Cursor-Daten trainiert wurde. Laut dem Unternehmen erfasst der Datensatz Interaktionen zwischen Benutzern, Codebasen, Software-Tools und Agenten.
Diese Unterscheidung ist wichtig. Ein reiner Code-Datensatz lehrt Syntax, Muster, Bibliotheken und gängige Implementierungen. Interaktionsdaten können auch die Arbeitsabfolge lehren:
Das hilft zu erklären, warum Grok 4.5 eher auf Softwareentwicklung als auf isolierte Codevervollständigung ausgerichtet ist.
xAI gibt an, dass sein Verstärkungslernprogramm Hunderttausende von Aufgaben abdeckt, mit einem Fokus auf mehrschrittige Softwareentwicklung und andere technische Arbeiten.
Cursor beschreibt Umgebungen, die das Modell darauf trainieren:
Die Unternehmen haben auch verteilte Agentensysteme gebaut, um diese Trainingsumgebungen in großem Maßstab zu generieren, zu testen und zu verfeinern. Einige Agentenbereitstellungen können stundenlang laufen, während der größere Trainingsprozess asynchron weiterläuft.
Dies ist eine bedeutende Abkehr von enger Benchmark-Optimierung. Das Modell wird nicht nur darauf trainiert, eine korrekte endgültige Antwort zu liefern, sondern den Prozess zu navigieren, der dorthin führt.
zu einer.
Modellgewichte sind nur ein Teil des Endprodukts.
Eine öffentliche Stellungnahme von Elon Musk besagte, dass Grok 4.5 noch nicht die intern entwickelte C/C++-Inferenzsoftware von xAI verwende, die speziell auf die GB300-Hardware abgestimmt ist. Er deutete an, dass der optimierte Stack die Servergeschwindigkeit möglicherweise verdoppeln oder weiter verbessern könnte.
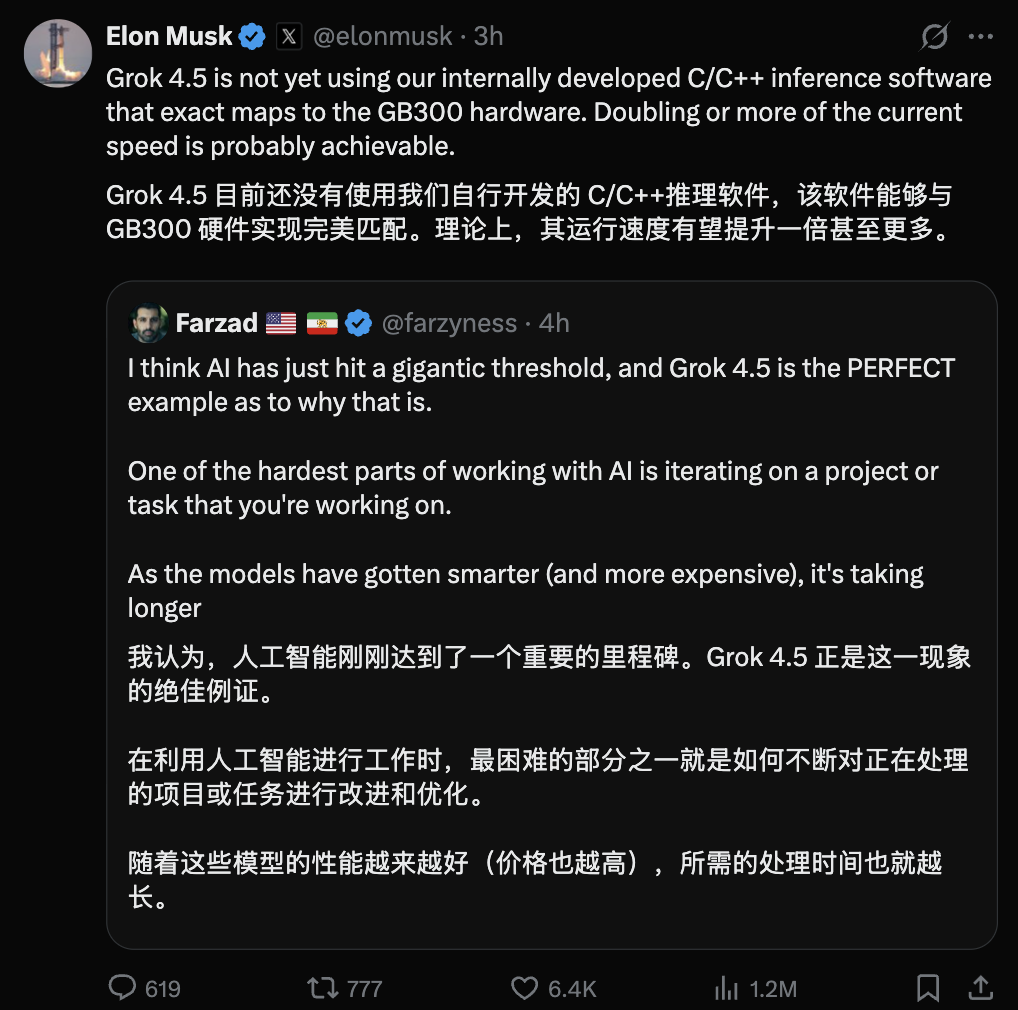
Dies ist eine zukunftsorientierte Behauptung und kein gemessenes Produktionsergebnis, daher sollte sie nicht als garantierte Leistung betrachtet werden. Dennoch zeigt sie, wohin sich der Modellwettbewerb bewegt.
Wenn Grenzmodelle in der Benchmark-Qualität näher zusammenrücken, kann das umgebende System den praktischen Vorteil schaffen:
Für Benutzer bedeutet dies, dass Modellvergleiche mehr als nur einen einzigen Intelligenzwert umfassen sollten. Ein Modell, das schneller antwortet, weniger Token erzeugt, Caching effektiv nutzt und Aufgaben mit weniger Wiederholungen abschließt, könnte einen besseren praktischen Nutzen bieten, selbst wenn ein anderes Modell bei einem Benchmark führt.
Grok 4.5 ist über die Responses API von xAI verfügbar. Das folgende Python-Beispiel verwendet die OpenAI-kompatible Client-Schnittstelle:
import os
from openai import OpenAI

api_key = os.environ.get("XAI_API_KEY")
if not api_key:
    raise RuntimeError("Set the XAI_API_KEY environment variable first.")

client = OpenAI(
    api_key=api_key,
    base_url="https://api.x.ai/v1",
)

response = client.responses.create(
    model="grok-4.5",
    input=(
        "Review this JavaScript function, fix the bug, "
        "and explain the change: "
        "function median(values) { values.sort(); "
        "return values[values.length / 2]; }"
    ),
)

print(response.output_text)
Bevor Sie das Modell in der Produktion verwenden:
Grok 4.5 ist das Grenzmodell von xAI für Programmierung, agentische Aufgaben und Wissensarbeit. Es unterstützt Text- und Bildeingaben, konfigurierbares Denken, Funktionsaufrufe und strukturierte Ausgaben.
Die offizielle xAI-Modelldokumentation gibt ein Kontextfenster von 500.000 Token an. Die tatsächlich nutzbare Kontextlänge kann vom Anfrageformat, der Tool-Ausgabe und plattformspezifischen Grenzen abhängen.
Der veröffentlichte Grundpreis beträgt 2 $ pro
Million Eingabe-Token, 0,50 $ pro Million zwischengespeicherter Eingabe-Token und 6 $ pro Million Ausgabe-Token. Plattformspezifische Varianten oder priorisierte Dienste können andere Tarife verwenden.
Die Antwort hängt vom Benchmark und Workflow ab. Grok 4.5 ist bei mehreren Engineering-Tests wettbewerbsfähig und liegt bei einigen Vergleichen vorn, während andere Modelle bei anderen Tests die Nase vorn haben. Geschwindigkeit, Token-Nutzung, Tool-Zuverlässigkeit und Kosten für die Aufgabenabwicklung sollten zusammen mit den Benchmark-Werten bewertet werden.
xAI berichtet, dass Grok 4.5 durchschnittlich 15.954 Ausgabe-Token pro SWE-Bench Pro-Aufgabe verwendete, verglichen mit 67.020 bei Opus 4.8 in seiner maximalen Einstellung. Das sind etwa 4,2-mal weniger Ausgabe-Token für die gemessene Arbeitslast.
Ja. Die offizielle Modellseite listet Text- und Bildeingabe mit Textausgabe auf. Dies macht es geeignet für Aufgaben wie Screenshot-Analyse, Dokumentenprüfung und visuellen Kontext innerhalb eines Agenten-Workflows.
Ja. Cursor gibt an, dass Grok 4.5 auf seinen Desktop-, Web-, iOS-, CLI- und SDK-Angeboten verfügbar ist. Nutzungskontingente und Preise hängen vom gewählten Cursor-Plan ab.
Es kann als Reasoning-Modell innerhalb eines Produktionsagenten verwendet werden, aber das umgebende System benötigt dennoch Berechtigungskontrollen, Validierung, Beobachtbarkeit, Wiederholungsversuche und menschliche Genehmigung für Aktionen mit hohen Auswirkungen. Benchmark-Stärke ersetzt nicht die Notwendigkeit operativer Sicherheitsvorkehrungen.
Grok 4.5 ist ein Spitzenmodell, das auf Codierung, Agenten und Wissensarbeit ausgerichtet ist. Seine stärksten praktischen Vorteile sind
Die Kombination aus wettbewerbsfähiger technischer Leistung, einer Verarbeitungsgeschwindigkeit von bis zu 80 Token pro Sekunde, einem 500.000 Token umfassenden Kontextfenster und einem geringeren Token-Verbrauch im veröffentlichten SWE-Bench Pro-Vergleich.
Der Trainingsansatz vereint große Infrastrukturen, kuratierte Daten, Interaktionsspuren von Cursor und verstärkendes Lernen in realistischen Werkzeugumgebungen. Dies hilft, das Modell von isolierter Codegenerierung hin zu längeren, durchgängigen Arbeitsabläufen zu führen.
Die Hauptbotschaft ist nicht nur, dass Grok leistungsfähiger geworden ist; es geht darum, dass xAI bei den Gesamtkosten und der Geschwindigkeit der Erledigung realer Aufgaben konkurriert.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



