For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/h-jepa-explained-hierarchical-jepa-world-f7e48311.md.
Das Weltmodell-Startup von Yann LeCun, **Advanced Machine Intelligence (AMI)**, hat eines seiner ersten großen Forschungsergebnisse veröffen...
Das Weltmodell-Startup von Yann LeCun, Advanced Machine Intelligence (AMI), hat eines seiner ersten großen Forschungsergebnisse veröffentlicht.
In der Studie H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning stellen Forschende von AMI, der New York University, INRIA Paris und der Brown University ein hierarchisches Weltmodell vor, das aus mehreren aktionskonditionierten JEPAs besteht.
Die zentrale Idee ist einfach: Statt eine einzige latente Repräsentation sowohl für die unmittelbare Motorsteuerung als auch für die langfristige Planung einzusetzen, gibt H-JEPA den verschiedenen Hierarchieebenen unterschiedliche Zeitskalen und Repräsentationsräume.
Höhere Ebenen blicken weiter in die Zukunft und planen auf einer gröberen Ebene. Ihre vorhergesagten Zwischenzustände werden zu Unterzielen für die niedrigeren Ebenen, die diese schrittweise verfeinern, bis das System ausführbare Aktionen erreicht.
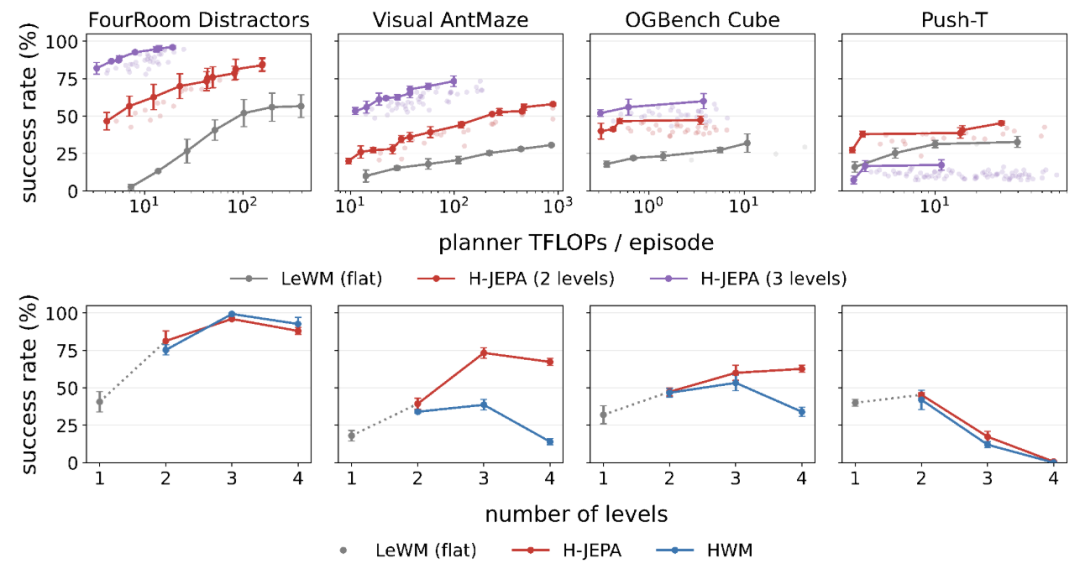
Im Visual AntMaze erreicht das dreistufige H-JEPA eine Planungserfolgsrate von etwa 73,3 %, verglichen mit 18,0 % für die flache LeWorldModel-Baseline. Gleichzeitig erzielt es eine bessere Erfolgsrate-gegen-Rechenaufwand-Kurve.
Das Projekt folgt der von AMI seit der Gründung betonten Open-Research-Ausrichtung. Die Autoren haben den Trainings- und Evaluierungscode, vortrainierte Checkpoints und unterstützende Datensätze veröffentlicht.
Das offizielle GitHub-Repository steht unter der MIT-Lizenz. Das veröffentlichte H-JEPA-Checkpoint-Repository auf Hugging Face ist ebenfalls als MIT-lizenziert gekennzeichnet, während das zugehörige Datensatz-Repository unter CC BY 4.0 veröffentlicht wurde.
LeCun plädiert seit Jahren für hierarchische Planung.
Die zugrunde liegende Intuition ähnelt der Art und Weise, wie Menschen komplexe Aufgaben der realen Welt planen.
Stellen Sie sich vor, Sie sitzen in einem Büro an der New York University und beschließen, nach Paris zu reisen.
Auf der höchsten Ebene sind das Reiseziel, der Flug und der Zeitplan die wichtigsten Informationen. Sobald dies entschieden ist, wird die nächste Ebene konkreter: das Büro verlassen, nach unten gehen, den Flughafen erreichen und den Flug besteigen.
Auf der niedrigsten Ebene verschiebt sich der Fokus erneut. Beim Hinuntergehen einer Treppe benötigt man Informationen über den Boden, die nächste Stufe und die Körperbewegung. Details, die bei der Auswahl eines Transatlantikflugs irrelevant waren, werden plötzlich entscheidend.
Dasselbe Problem tritt in der Robotik auf.
Ein übergeordneter Planer muss das Aufgabenziel, räumliche Beziehungen und die langfristige Bewegungsrichtung verstehen. Eine untergeordnete Steuerung benötigt präzise Informationen über die unmittelbare Bewegung und die Körperkonfiguration.
Wenn eine einzige Repräsentation jedes Detail auf jeder Zeitskala bewahren muss, wird die Planung unnötig schwierig.
Beispielsweise kann sich ein vierbeiniger Roboter bereits am richtigen Ort befinden, während sich die Position seiner Beine vom Zielbild unterscheidet. Eine Repräsentation, die sich zu stark auf die sich schnell verändernden Beindetails konzentriert, könnte den Roboter fälschlicherweise als weit vom Ziel entfernt einstufen, obwohl seine für die Aufgabe relevante Position bereits korrekt ist.
Die H-JEPA-Studie untersucht dieses Problem anhand einer spezifischeren Frage:
Kann jede Ebene die Informationen erlernen, die auf ihrer eigenen Zeitskala wichtig sind, und gleichzeitig ermöglichen, dass der übergeordnete Plan in Aktionen auf niedriger Ebene übersetzt wird?
H-JEPA weist jeder Hierarchieebene drei zentrale Komponenten zu:
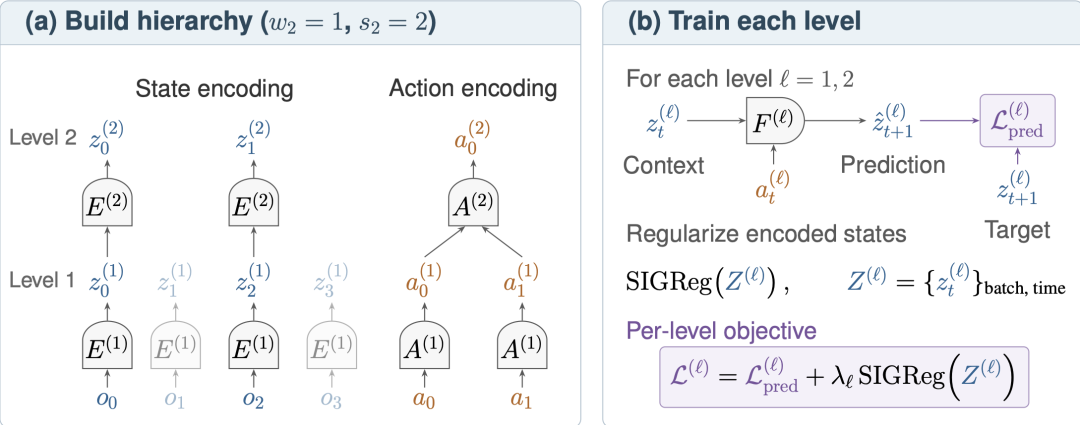
Der Zustands-Encoder extrahiert eine latente Repräsentation der Umgebung.
Auf der niedrigsten Ebene arbeitet der Encoder direkt mit visuellen Beobachtungen. Höhere Ebenen erhalten Repräsentationen der niedrigeren Ebenen und erlernen schrittweise abstraktere Versionen des Zustands.
Dadurch können höhere Ebenen Details ausblenden, die sich schnell verändern, über lange Zeithorizonte schwer vorherzusagen oder für die langfristige Planung irrelevant sind.
In den Visual-AntMaze-Experimenten unterdrücken höhere Ebenen zunehmend Informationen über die Beinstellung der Ameise, während sie Informationen über die Position der Ameise und den Aufbau des Labyrinths bewahren.
Genau diese Art der Abstraktion soll die Hierarchie erlernen.
Der Aktions-Encoder beschreibt die Auswirkungen von Aktionen auf den jeweiligen Zeitskalen.
Auf der niedrigsten Ebene entsprechen Aktionen relativ konkreten Steuerungsänderungen. Auf höheren Ebenen werden mehrere Aktionen der niedrigeren Ebenen zu einer gröberen Repräsentation zusammengefasst, die beschreibt, wie sich der Zustand über einen längeren Zeitraum verändert.
Dadurch erhält jede Schicht eine andere zeitliche Auflösung.
Im beschriebenen Aufbau umfasst ein Vorhersageschritt auf einer höheren Ebene mehr Umgebungsschritte als auf der darunterliegenden Ebene.
Der Prädiktor kombiniert den aktuellen latenten Zustand mit der kodierten Aktion, um den zukünftigen latenten Zustand zu schätzen.
Jede Ebene erlernt somit ihr eigenes aktionskonditioniertes Weltmodell.
Der entscheidende Unterschied zu einem flachen Weltmodell besteht darin, dass H-JEPA nicht verlangt, dass jede Ebene innerhalb desselben gemeinsamen latenten Raums Vorhersagen trifft.
Stattdessen kann jede Ebene eine Repräsentation entwickeln, die zu ihrem eigenen Zeithorizont passt.
Bei der Inferenz verläuft die Planung von der Spitze der Hierarchie nach unten.
Die oberste Ebene sucht zunächst nach einem groben Pfad zum endgültigen Ziel.
Der vorhergesagte Zwischenzustand wird anschließend zu einem Unterziel für die darunterliegende Ebene. Diese sucht nach einem detaillierteren Plan, der das zugewiesene Unterziel erreicht. Der Prozess wird fortgesetzt, bis die niedrigste Ebene primitive Aktionen erzeugt.
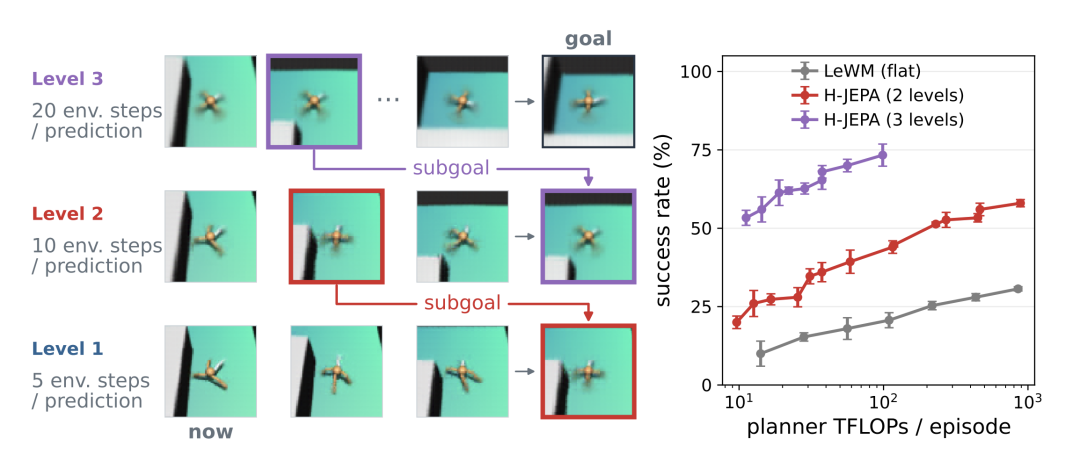
Dadurch entsteht ein grob-zu-fein verlaufender Planungsprozess:
Nach der Ausführung eines Aktionspräfixes beobachtet das System den neuen Zustand und plant erneut.
Durch dieses wiederholte Neuplanen kann die Hierarchie auf die tatsächliche Umgebung reagieren, anstatt sich auf einen einzigen langen Open-Loop-Plan festzulegen.
Die Hierarchie wird end-to-end trainiert.
Das bedeutet, dass die Ebenen nicht als isolierte Module trainiert werden. Ziele auf höheren Ebenen können die Encoder der niedrigeren Ebenen beeinflussen, sodass sich die gesamte Repräsentationshierarchie gemeinsam entwickelt.
Das Training von Weltmodellen weist jedoch einen klassischen Fehlermodus auf: den Repräsentationskollaps.
Wenn ein Encoder jeden Eingangszustand auf denselben latenten Vektor abbildet, kann ein Prädiktor trivialerweise denselben Vektor ausgeben und einen niedrigen Vorhersagefehler erzielen, ohne etwas Nützliches über die Umgebung zu lernen.
H-JEPA begegnet diesem Problem mit SIGReg, der sogenannten Sketched Isotropic Gaussian Regularization, die zuvor in der Arbeit LeJEPA von Randall Balestriero und Yann LeCun eingeführt wurde.
SIGReg beschränkt die Verteilung der latenten Repräsentationen, sodass unterschiedliche Beobachtungen nicht auf dieselbe Repräsentation kollabieren.
Das frühere LeWorldModel wendete diese Form der Regularisierung auf das End-to-End-Training eines Weltmodells aus Pixeln an. H-JEPA verwendet LeWorldModel als Grundlage auf der niedrigsten Ebene und ergänzt darüber weitere JEPA-Ebenen.
Damit bleibt das grundlegende JEPA-Prinzip erhalten: Nützliche Repräsentationen der Zukunft vorhersagen, statt jedes zukünftige Pixel zu rekonstruieren.
Die Studie evaluiert H-JEPA in vier simulierten Umgebungen für Navigation und Manipulation:
Außerdem wird die Offline-Planung anhand realer Robotertrajektorien aus dem DROID-Datensatz evaluiert.
Visual AntMaze zeigt den deutlichsten Vorteil der Hierarchie.
Dem offiziellen Repository zufolge erreicht ein dreistufiges H-JEPA eine Planungserfolgsrate von 73,3 %, verglichen mit 18,0 % für die flache LeWorldModel-Baseline.
Die Hierarchie verbessert außerdem den Kompromiss zwischen Erfolgsrate und Rechenaufwand des Planers.
Das ist wichtig, weil ein hierarchischer Planer nur dann nützlich ist, wenn die zusätzlichen Ebenen die Planung nicht prohibitiv teuer machen.
Die Hierarchie verbessert sich auch in den anderen simulierten Umgebungen gegenüber der flachen Baseline, doch mehr Ebenen sind nicht immer besser.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Der Quellartikel hebt Push-T als wichtiges Gegenbeispiel hervor: Das zweistufige Modell ist besser als die flache Baseline, während eine dritte oder vierte Ebene die Leistung verringern kann.
Die Studie führt dies teilweise auf die Aufgabenlänge zurück. Kürzere Trajektorien liefern weniger aussagekräftige Beispiele für sehr hohe Ebenen, die über lange Zeithorizonte arbeiten.
Das deutet auf eine wichtige Einschränkung hin:
Eine Hierarchie ist nützlich, wenn die Aufgabe tatsächlich eine Struktur über mehrere Zeitskalen hinweg enthält. Das mechanische Hinzufügen weiterer Ebenen garantiert keine bessere Leistung.
Reale Roboterdaten schaffen ein weiteres Repräsentationsproblem.
In vielfältigen Videos kann ein rein prädiktives Ziel den Fokus stark auf stabile Hintergrundinformationen legen, weil sich der Hintergrund leicht vorhersagen lässt. Der sich bewegende Roboter, der für die Steuerung tatsächlich wichtig ist, erhält möglicherweise weniger Repräsentationskapazität.
Um dieses Problem zu adressieren, ergänzen die Forschenden in den DROID-Experimenten eine Inversdynamik-Supervision.
Das Modell wird nicht nur darauf trainiert, zukünftige latente Zustände vorherzusagen, sondern auch die Aktion abzuleiten, die aufeinanderfolgende latente Zustände miteinander verbindet.
Dadurch soll die Repräsentation Informationen über die Bewegung und den steuerbaren Zustand des Roboters bewahren.
Die H-JEPA-Projektseite berichtet, dass die erlernte zweite Ebene die Genauigkeit der Offline-Planung gegenüber der flachen Baseline verbessert und gleichzeitig den Rechenaufwand des Planers reduziert.
Die DROID-Evaluierung ist offline: Die Studie vergleicht vorhergesagte Endeffektorpfade mit Experten- bzw. Referenztrajektorien, ohne einen Erfolg bei geschlossenen Regelkreisen mit realen Robotern zu behaupten.
Diese Unterscheidung ist wichtig, wenn die Ergebnisse interpretiert werden.
Die Autoren haben die H-JEPA-Implementierung auf GitHub veröffentlicht.
Das offizielle Repository enthält Trainings- und Planungscode für:
Außerdem stellt es Skripte zur Reproduktion ausgewählter Abbildungen und Tabellen aus der Studie bereit.
Das Checkpoint-Repository auf Hugging Face enthält derzeit vortrainierte Modelle für das flache LeWorldModel, zwei-, drei- und vierstufige H-JEPA-Varianten sowie Shared-Space-HWM-Baselines für die Simulationstasks und zusätzlich DROID-Checkpoints.
Das zugehörige H-JEPA-Datensatz-Repository enthält die Simulationsdaten, Planungsbewertungsaufgaben, Probing-Datensätze und DROID-bezogenen Daten, die für die Veröffentlichung benötigt werden.
Damit ist die Arbeit mehr als eine reine Demonstration in einer Studie: Forschende können die Implementierung untersuchen, trainierte Modelle laden und versuchen, die berichteten Planungsergebnisse zu reproduzieren.
H-JEPA folgt derselben übergeordneten Forschungsrichtung, die LeCun seit Jahren vertritt.
JEPA steht für Joint-Embedding Predictive Architecture.
Ein herkömmliches Sprachmodell lernt, indem es zukünftige Tokens vorhersagt. Ein visuelles JEPA lernt hingegen Repräsentationen von Beobachtungen und sagt Zielrepräsentationen im latenten Raum voraus.
Bei Weltmodellen wie H-JEPA werden Aktionen in den Prozess einbezogen, sodass das Modell vorhersagen kann, wie sich seine interne Repräsentation der Welt nach einer Aktion verändert.
Ein Planer kann anschließend die vorhergesagten Konsequenzen verschiedener Aktionen vergleichen und nach einem Pfad zum Ziel suchen.
Dies entspricht LeCuns langjähriger Auffassung, dass Intelligenz mehr als Sprachgenerierung erfordert. In seiner Forschungsagenda müssen Systeme die Welt verstehen, die Konsequenzen von Aktionen vorhersagen, relevante Zustände speichern und über längere Zeiträume planen.
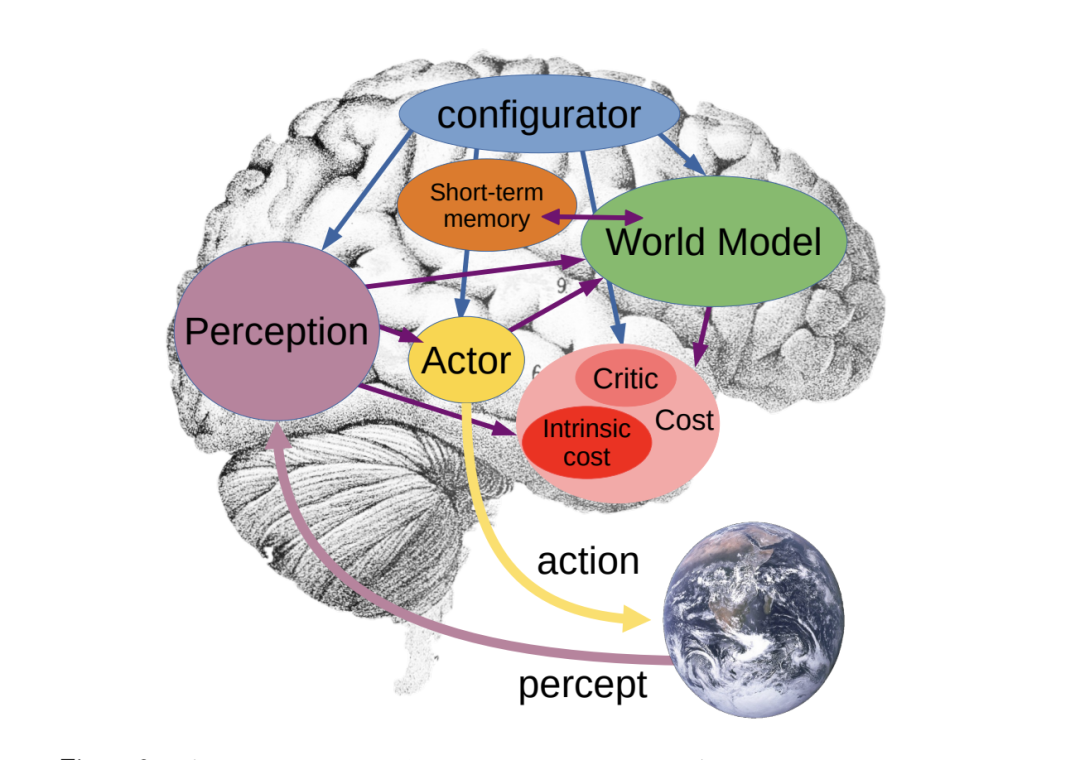
Der ursprüngliche Artikel verweist außerdem auf LeCuns wiederholte Kritik an der Annahme, dass die alleinige Skalierung großer Sprachmodelle zwangsläufig zu menschenähnlicher Intelligenz führen werde. Gleichzeitig hat er anerkannt, dass auf LLMs basierende Werkzeuge in der Praxis äußerst nützlich sind.
H-JEPA sollte daher nicht als Versuch verstanden werden, alle heutigen Sprachmodelle zu ersetzen, sondern als konkretes Experiment mit der alternativen Architektur, für die LeCun seit Jahren eintritt.
Diese Forschungsrichtung ist nun Teil der Geschäftsstrategie von AMI.
AMI nahm laut Reuters und anderen zeitnahen Berichten im März 2026 1,03 Milliarden US-Dollar bei einer Pre-Money-Bewertung von 3,5 Milliarden US-Dollar auf.
Das Unternehmen wird von einem Team geführt, zu dem unter anderem folgende Personen gehören:
Michael Rabbat gehört außerdem zu den Autoren der H-JEPA-Studie.
AMI beschreibt sein Ziel als den Aufbau von Systemen, die die Welt verstehen, ein dauerhaftes Gedächtnis bewahren, schlussfolgern und planen können sowie steuerbar und sicher bleiben.
Zum Zeitpunkt des BAAI-Quellartikels präsentierte sich das Unternehmen weiterhin vor allem über seine Forschung, sein Team und Stellenausschreibungen und noch nicht über ein breit verfügbares öffentliches Produkt.
H-JEPA ist daher auch deshalb bedeutsam, weil das Projekt ein konkretes technisches Ergebnis aus der Weltmodell-These des Startups liefert.
Der Quellartikel schließt mit einem Vergleich zwischen AMI und einem weiteren bekannten Weltmodell-Unternehmen: World Labs von Fei-Fei Li.
Am 28. September 2026 gab AMD eine endgültige Vereinbarung zur Übernahme von World Labs bekannt.
Eine SEC-Einreichung von AMD bewertet die vollständig in Aktien abgewickelte Transaktion vorbehaltlich üblicher Anpassungen mit rund 8,2 Milliarden US-Dollar.
Die beiden Unternehmen verfolgen unterschiedliche organisatorische Wege, spiegeln jedoch beide die wachsende Bedeutung von Weltmodellen, räumlicher Intelligenz, Robotik, Simulation und physischer KI wider.
AMI entwickelt sein eigenes Forschungsprogramm zu hierarchischen prädiktiven Modellen weiter, während World Labs auf die Integration in ein großes Unternehmen für KI-Computing zusteuert.
Bei H-JEPA ist die unmittelbare Frage eher technischer als unternehmerischer Natur: Wie weit lässt sich hierarchische Planung im latenten Raum von simulierter Steuerung und Offline-Robotervideos auf komplexere Systeme mit geschlossenem Regelkreis in der realen Welt skalieren?
Das ist der nächste Test für die Architektur.
H-JEPA ist ein end-to-end trainiertes hierarchisches Weltmodell für visuelle Planung. Es stapelt mehrere aktionskonditionierte JEPAs, sodass höhere Ebenen weiter in die Zukunft vorhersagen und latente Unterziele an niedrigere Ebenen weitergeben.
Ein flaches Weltmodell verwendet eine Repräsentation und eine Planungsskala. H-JEPA lernt separate latente Räume auf mehreren Zeitskalen. Dadurch können sich höhere Ebenen auf langsame, aufgabenrelevante Strukturen konzentrieren, während niedrigere Ebenen die für die Steuerung erforderlichen Details bewahren.
Das offizielle GitHub-Repository berichtet für ein dreistufiges H-JEPA eine Planungserfolgsrate von etwa 73,3 %, gegenüber 18,0 % für die flache LeWorldModel-Baseline. Die Hierarchie erzielt außerdem einen besseren Kompromiss zwischen Erfolg und Rechenaufwand des Planers.
SIGReg steht für Sketched Isotropic Gaussian Regularization. Die Methode wurde in LeJEPA eingeführt, um latente Verteilungen zu beschränken und einen Repräsentationskollaps zu verhindern, bei dem ein Encoder viele unterschiedliche Zustände auf nahezu dasselbe Embedding abbildet.
Ja. Die offiziellen GitHub-Codeveröffentlichungen stehen unter der MIT-Lizenz, und vortrainierte Checkpoints sind auf Hugging Face verfügbar. Das zugehörige H-JEPA-Datensatz-Repository wurde unter CC BY 4.0 veröffentlicht.
Die Studie erweitert den Ansatz mithilfe von Inversdynamik-Supervision auf vielfältige Videos realer Roboter aus DROID. Diese Experimente bewerten die Genauigkeit der Offline-Planung, nicht den vollständigen Erfolg von Roboteraufgaben im geschlossenen Regelkreis. Das Ergebnis sollte daher nicht als autonome Bereitstellung in der realen Welt überinterpretiert werden.
Nein. Die Studie zeigt, dass tiefere Hierarchien hilfreich sind, wenn eine Aufgabe sinnvolle Strukturen über mehrere Zeitskalen hinweg enthält. Sehr tiefe Hierarchien können jedoch bei kürzeren Aufgaben wie Push-T schaden, weil höhere Ebenen möglicherweise zu wenig nützliche Trainingssignale erhalten.
H-JEPA folgt LeCuns JEPA- und Weltmodell-These: Kompakte Repräsentationen der Welt erlernen, zukünftige latente Zustände statt jedes Pixels vorhersagen und diese Vorhersagen für die Planung nutzen. H-JEPA fügt eine explizite Hierarchie hinzu, sodass unterschiedliche Ebenen auf verschiedenen Zeitskalen und Abstraktionsstufen arbeiten können.
H-JEPA überführt die Idee eines JEPA-Weltmodells in eine explizite Planungshierarchie. Höhere Ebenen arbeiten über längere Zeithorizonte und mit abstrakteren Repräsentationen, während niedrigere Ebenen diese Pläne in zunehmend konkrete Unterziele und Aktionen übersetzen.
Das stärkste Ergebnis zeigt sich bei Visual AntMaze: Dort erreicht ein dreistufiges H-JEPA eine Planungserfolgsrate von ungefähr 73 % gegenüber 18 % für die flache LeWorldModel-Baseline und verbessert zugleich die Planungseffizienz. Die Arbeit zeigt außerdem, dass eine Hierarchie nicht automatisch nützlich ist: Aufgabenzeitskala und Datenverfügbarkeit bestimmen, ob zusätzliche Ebenen helfen.
Für eine neue Forschungsarbeit ist das Projekt ungewöhnlich gut reproduzierbar, da Code, Checkpoints und Datensätze bereits öffentlich verfügbar sind.
Der wichtigste Beitrag von H-JEPA ist nicht einfach ein besserer Labyrinthwert, sondern der konkrete Nachweis, dass Weltmodelle davon profitieren können, für unterschiedliche Planungshorizonte verschiedene Repräsentationen zu erlernen.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



