For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/harness2-explained-recursive-agent-harnes-65188473.md.
Harness², auch als Harness2 bezeichnet, untersucht eine praktische Form rekursiver Verbesserung: die Veränderung der Software rund um ein ei...
Harness², auch als Harness2 bezeichnet, untersucht eine praktische Form rekursiver Verbesserung: die Veränderung der Software rund um ein eingefrorenes Sprachmodell. Die bearbeitbare Laufzeitumgebung umfasst Prompts, Schutzmechanismen, Speicher, Skills, Anleitungen für Tools, Skripte, Subagenten und Middleware.
Die Forschung stammt von Google Cloud AI Research und der Northwestern University. Anstatt nach jedem Fehler ein neues Modell zu trainieren, untersucht das System die Ausführung eines Agenten, testet Änderungen an dessen Harness und bewahrt Belege dafür auf, welche Änderungen geholfen haben.
Die Autoren berichten, dass ein Verbesserungsschritt den durchschnittlichen WorkBuddy-Bench-Score von GLM-5 unter OpenCode von 64,2 auf 75,7 erhöht. Das entspricht einem Anstieg um 11,5 Punkte in einer bestimmten Evaluation und stellt keine für jedes Modell oder jede Anwendung garantierte Verbesserung dar.
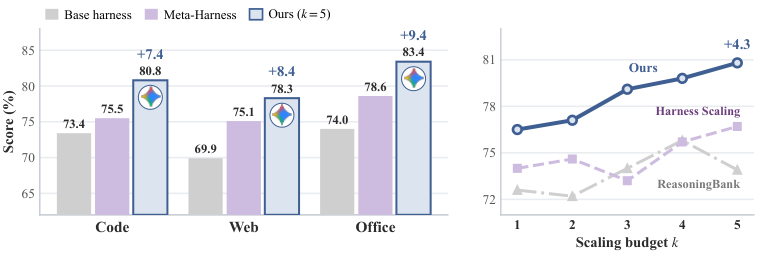
Abbildung des Forschungsteams, reproduziert im QbitAI/BAAI-Bericht.
Zwei Probleme bilden die Motivation für diese Arbeit.
Harness2 trennt den Harness für die aktuelle Ausführung vom Prozess, der ihn verbessert. Eine spätere Aufgabe beginnt mit dem gemeinsamen Basis-Harness. Der Verbesserungsprozess greift selektiv auf frühere Erkenntnisse zurück, anstatt blind alle vorherigen Regeln zu übernehmen.
Das System zeichnet zunächst eine Referenzausführung mit dem ursprünglichen Harness auf. Anschließend nutzt es diesen Ablauf, um Schwachstellen zu identifizieren und mögliche Reparaturen zu testen.
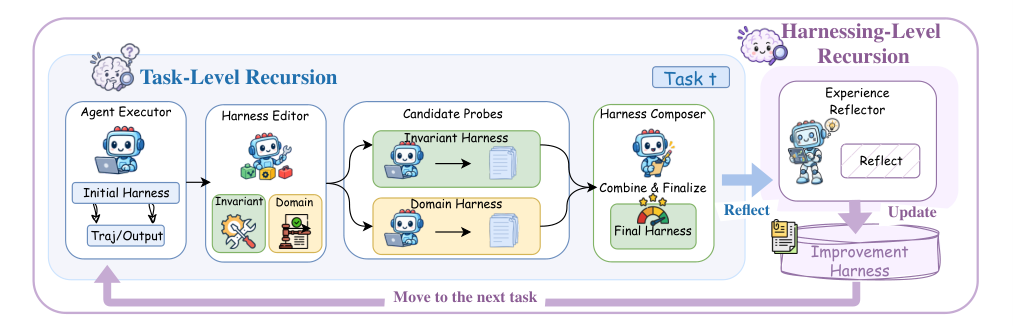
Der Verbesserungsschritt umfasst drei Phasen:
Der Verhaltensvergleich dient während der Anpassung als Ersatz für nicht verfügbares Ground-Truth-Feedback. Er ist kein unfehlbarer Prüfer der endgültigen Korrektheit. Eine externe Benchmark-Evaluation bleibt wichtig, wenn gemessen werden soll, ob die Methode funktioniert.
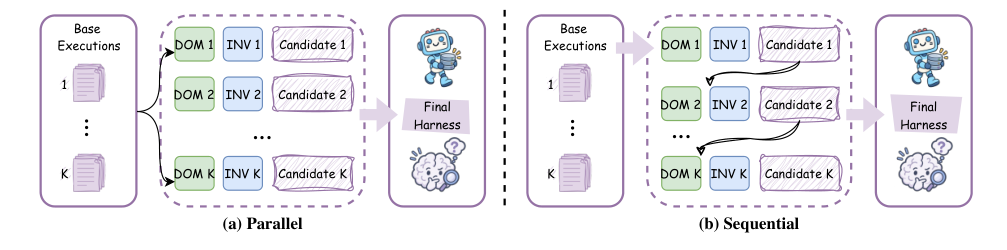
Die Methode kann durch parallele Rekursion breiter suchen oder durch sequenzielle Rekursion aufeinanderfolgende Überarbeitungen vornehmen. Bei einem parallelen Budget k prüft sie k allgemeine und k domänenspezifische Kandidaten und erzeugt anschließend k Zusammenstellungen. Mehr Kandidaten erfordern mehr Rechenaufwand.
Nach einer Aufgabe untersucht ein Erfahrungsreflektor den Referenzablauf, die vorgeschlagenen Änderungen, die Prüfnachweise und die Entscheidungen beim Zusammenführen. Er erfasst wiederverwendbare Komponenten und Erkenntnisse, darunter auch Notizen in EXPERIENCE.md.
Die nächste Aufgabe erhält den Basis-Harness für die Ausführung. Der Bearbeitungsprozess kann jedoch auf frühere Erkenntnisse zurückgreifen. Dauerhaft gespeichert wird Wissen darüber, wann eine Reparatur nützlich ist, nicht die Annahme, dass die vollständige Konfiguration der letzten Aufgabe dauerhaft übernommen werden sollte.
Die Modellparameter bleiben unverändert. Es handelt sich um eine Laufzeitanpassung durch Dateien und Ausführungsnachweise, nicht um einen Beleg für ein autonomes Training von Modellgewichten.
Die Studie bewertet die Code-, Web- und Office-Ergebnisse von WorkBuddy-Bench, professionelle Aufgaben aus JobBench sowie Harveys Legal Agent Benchmark. Verwendet werden GLM-5 und Gemini 3.5 Flash mit OpenCode und Codex als Ausführungs-Harnesses.
Der Standard-Editor ist Claude Opus 4.8 unter OpenCode. Daher beziehen sich die wichtigsten Ergebnisse auf ein Verbesserungssystem rund um den Ausführer. Sie sollten nicht als kostenloser Fähigkeitszuwachs des Ausführers allein beschrieben werden.
| Ausführermodell | Initialer Harness | WorkBuddy-Basisdurchschnitt | Ein Harness2-Schritt | Zuwachs |
|---|---|---|---|---|
| GLM-5 | OpenCode | 64,2 | 75,7 | 11,5 Punkte |
| GLM-5 | Codex | 64,4 | 75,3 | 10,9 Punkte |
| Gemini 3.5 Flash | OpenCode | 72,4 | 77,5 | 5,1 Punkte |
| Gemini 3.5 Flash | Codex | 74,5 | 77,5 | 3,0 Punkte |
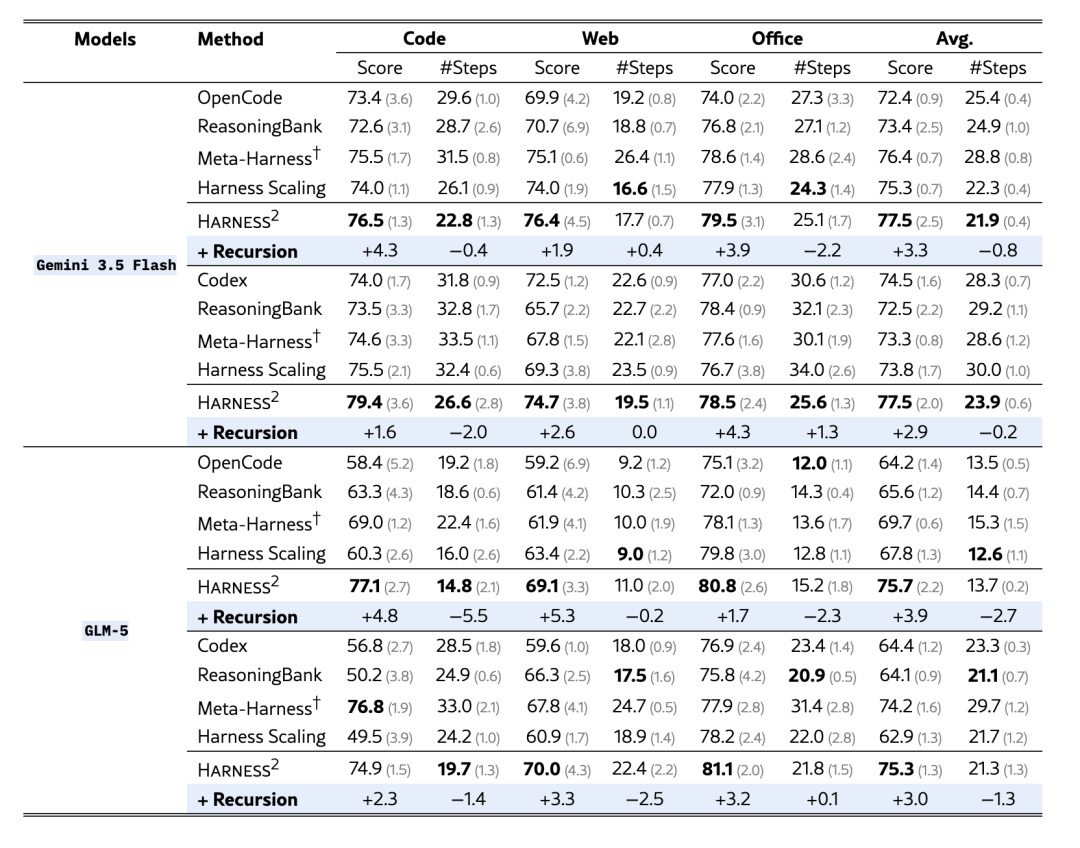
GLM-5 mit dem verbesserten Harness übertrifft in diesem Vergleich die entsprechende unveränderte Gemini-Baseline. Das veranschaulicht, wie das Laufzeitdesign die Rangfolge von Modellen beeinflussen kann. Es belegt nicht, dass GLM-5 bei jeder Aufgabe leistungsfähiger ist.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
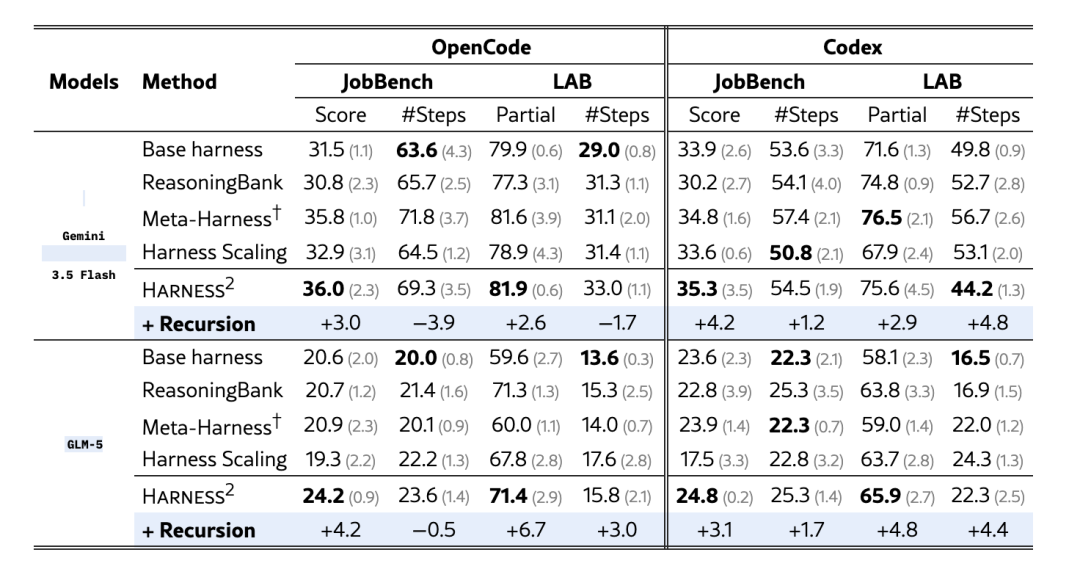
Das Paper berichtet über Ein-Schritt-Zuwächse von bis zu 4,5 Punkten bei JobBench und 11,8 Prozentpunkten beim LAB-Partial-Wert, also der Bestehensrate pro Kriterium. Partial unterscheidet sich vom Anteil der Aufgaben, die jedes einzelne Kriterium erfüllen.
Eine Erhöhung des parallelen Budgets auf k=5 bringt zusätzlich zu einem Schritt bis zu 3,9 WorkBuddy-Punkte, 4,2 JobBench-Punkte und 6,7 Prozentpunkte beim LAB-Partial-Wert. Die Haupttabellen berichten Mittelwerte und Standardabweichungen aus drei Durchläufen mit zufällig gemischter Aufgabenreihenfolge.
Auch das Transferexperiment ist aufschlussreich. Eine auf JobBench aufgebaute Bibliothek verbessert die Ein-Schritt-Verfeinerung von WorkBuddy um 0,6 Punkte bei Code, 0,5 Punkte im Web und 2,9 Punkte im Office-Bereich, ohne für diesen Vergleich zusätzliche Prüfungen durchzuführen.
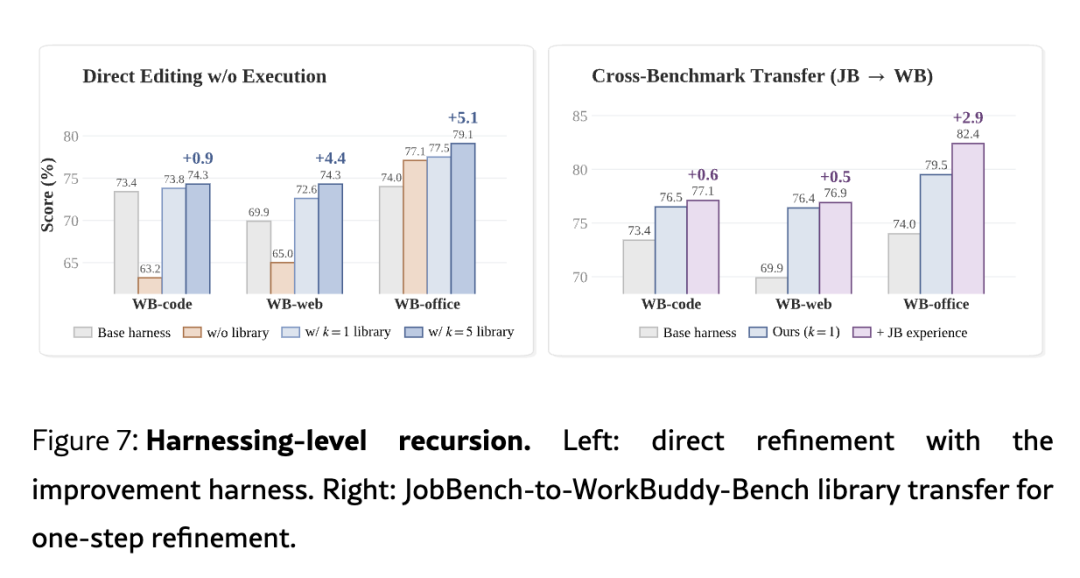
Diese Ergebnisse sprechen für eine selektive Wiederverwendung von Verbesserungserfahrungen. Sie zeigen jedoch nicht, dass jede angesammelte Regel übertragbar ist, und machen es nicht überflüssig, einen übernommenen Harness auf der tatsächlichen Aufgabenverteilung zu prüfen.
Das Paper nennt neun Autoren: Ruiyao Xu, Yanfei Chen, Zhongying CuiZhu, Bhavana Dalvi Mishra, Yifei Ming, Han Yu, Rujun Han, Chen-Yu Lee und Tomas Pfister. Die Quelle stellt Xu, eine Doktorandin beziehungsweise einen Doktoranden an der Northwestern University, sowie die Google-Cloud-Forscher Chen und CuiZhu vor.
Das öffentliche Repository unterstützt beide Ausführungs-Harnesses und beide Rekursionsmodi. Es nennt Linux, Python 3.12 und uv; modellgestützte Benchmarks haben zusätzliche Abhängigkeiten und verursachen API-Kosten. WorkBuddy benötigt Docker, während LAB unter anderem Tools wie Pandoc und Poppler erfordert.
Die README weist außerdem darauf hin, dass der Netzwerkzugriff des Ausführers uneingeschränkt ist und die Codex-Ausführungs-Sandbox in diesem Setup deaktiviert wurde. Nutzer von Benchmarks müssen vor der Evaluation Einschränkungen konfigurieren, die den Zugriff auf Antworten und Bewertungsrichtlinien verhindern. Die Laufzeitverbesserungen des Papers sollten gemeinsam mit diesen Ausführungs- und Evaluationsbedingungen bewertet werden.
Harness2 verändert die Laufzeitumgebung rund um ein Sprachmodell, einschließlich Prompts, Tools, Speicher und Skills. Die zugrunde liegenden Modellgewichte bleiben unverändert.
Die Rekursion auf Aufgabenebene testet und kombiniert Reparaturen für die aktuelle Aufgabe. Die Rekursion auf Harnessing-Ebene bewahrt Nachweise und wiederverwendbare Erkenntnisse, um spätere Bearbeitungsentscheidungen zu verbessern.
Die Anpassungsmethode nutzt Kontraste zwischen Ausführungsabläufen anstelle eines Ground-Truth-Prüfers. Dadurch stehen auch dann Belege zur Verfügung, wenn Labels fehlen. Das garantiert jedoch nicht, dass das resultierende Artefakt korrekt ist.
Nein. Dabei handelt es sich um die in der Studie berichtete durchschnittliche Verbesserung von GLM-5/OpenCode bei WorkBuddy. Andere Kombinationen aus Modell, Harness und Benchmark erzielen andere Zuwächse.
Es fügt zusätzliche Kandidatenausführungen und Verbesserungsarbeit hinzu. Das Paper analysiert die Leistung zusammen mit dem gesamten Rechenaufwand, einschließlich Ausführungs- und Verbesserungs-Token.
Das Repository nennt Docker für WorkBuddy-Bench. Die lokale deterministische Demo und andere Benchmarks haben andere Anforderungen. Befolgen Sie daher die Anweisungen für den ausgewählten Workflow.
Harness2 kombiniert aufgabenspezifische Experimente mit einer Bibliothek von Erkenntnissen zur Verbesserung von Agent-Laufzeitumgebungen. Die berichteten Zuwächse zeigen, dass Prompts, Tool-Nutzung und die Ausführungsstruktur die Ergebnisse spürbar verändern können, selbst wenn die Modellgewichte unverändert bleiben.
Die Nachweise sprechen für ein besseres Harness-Engineering unter den getesteten Bedingungen, wobei Grenzen bei Rechenaufwand, Verifikation und Transfer sichtbar bleiben.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



