For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/houmo-m50-open-source-software-for-local-1781bd08.md.
Die Verlagerung einer KI-Arbeitslast auf ein lokales Gerät erfordert mehr als einen leistungsfähigen Beschleuniger. Entwickler benötigen ein...
Die Verlagerung einer KI-Arbeitslast auf ein lokales Gerät erfordert mehr als einen leistungsfähigen Beschleuniger. Entwickler benötigen eine Möglichkeit, Modelle vorzubereiten, sie effizient auszuführen, mehrere Komponenten zu verbinden und das fertige Produkt zu warten.
Houmos jüngste Ökosystem-Ankündigung befasst sich mit dieser Softwareschicht. Laut dem bereitgestellten Bericht plant das Unternehmen, seinen KI-Software-Stack schrittweise zu veröffentlichen; 15 Projekte sollen bis Januar 2027 erscheinen. Mehrere Repositories sind bereits öffentlich, darunter Modellbeispiele, Quantisierungstools und Anpassungen bekannter Inferenz-Frameworks.
Die Unterscheidung zwischen der Roadmap und dem heute verfügbaren Code ist wichtig. Ein Plan zur Öffnung des vollständigen Stacks bedeutet nicht, dass jede Komponente bereits veröffentlicht wurde oder dass sämtliche Runtime-Abhängigkeiten entfallen sind.
Der Bericht gliedert den Stack in vier Schichten:
| Schicht | Rolle bei einer Bereitstellung |
|---|---|
| Modellvorbereitung | Quantisierung, Kompilierung, Genauigkeitsprüfungen und Konvertierung in ein unterstütztes Format |
| Inferenz-Framework, Operatoren und Runtime | Ausführung und Scheduling auf Houmo-Hardware |
| Domänen-Kits, Pipelines und Middleware | Koordination zwischen Modellen und Anwendungskomponenten |
| Bereitstellung und Betrieb | Updates, Monitoring und Verwaltung über bereitgestellte Geräte hinweg |
Ein Meeting-Assistent veranschaulicht, warum diese Schichten zusammengehören. Die Spracherkennung muss ein Sprachmodell versorgen, das Sprachmodell muss ein nützliches Protokoll erzeugen, und die Anwendung muss es speichern oder anzeigen. Jede Phase hat eigene Anforderungen an Speicher, Latenz und Kompatibilität.
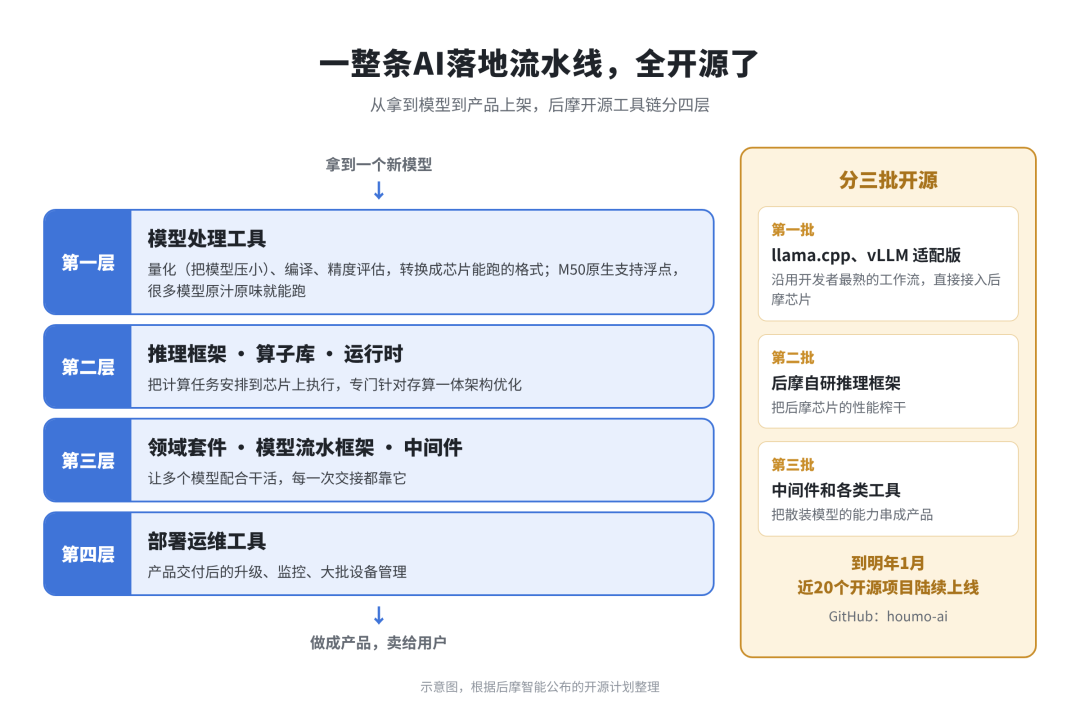
Diagramm des Software-Stacks aus dem Xinzhiyuan/BAAI-Bericht; die ursprünglichen Beschriftungen sind auf Chinesisch.
Die berichtete Veröffentlichungsreihenfolge beginnt mit Anpassungen von llama.cpp und vLLM, gefolgt von Houmos eigenem Inferenz-Framework und anschließend Middleware sowie weiteren Tools. Die breitere Roadmap umfasst außerdem Infrastruktur für die Verwaltung von Beschleunigern und Clustern.
Das öffentliche Repository postmo-modelzoo beschreibt Beispiele für Quantisierung, Kompilierung, Genauigkeitsbewertung, Leistungsmessung und Anwendungsbereitstellung. Zu den Modellkategorien gehören Spracherkennung, Sprachgenerierung, Sprachmodelle, Vision-Language-Modelle, Embeddings, OCR, Segmentierung und Bildgenerierung.
Weitere sichtbare Repositories umfassen postmo-quantflow, postmo-gptqmodel, vllm-postmo sowie Houmo-Forks von llama.cpp und vLLM. Entwickler sollten die README-Datei und den aktuellen Branch jedes Repositories prüfen, statt von identischen Installationsverfahren oder Support-Niveaus auszugehen.
Die README für Modellbeispiele nennt mehrere konkrete Einschränkungen:
houmo-tcim-runtime und houmo-drv ab.Diese Anforderungen sind für die Planung wichtig. Ein offenes Beispiel-Repository bietet überprüfbaren Integrationscode, ist jedoch keine hardwareunabhängige Ausführungsumgebung.
Die Quelle gibt an, dass mehr als 100 Kunden und über 150 geplante Endgeräteprodukte mit dem M50 verbunden sind. Diese Zahlen beschreiben die berichtete Ökosystem-Pipeline und nicht geprüfte Auslieferungen.
Der Bericht beschreibt Lenovos P7 als etwa 300 Gramm schweren KI-Computer mit einer maximalen Systemleistungsaufnahme von 30 W. Er berichtet über den lokalen Betrieb eines Modells mit 122 Milliarden Parametern bei 50 Token pro Sekunde und Unterstützung für einen Kontext von 128K.
Diese Zahlen sollten zusammen mit den fehlenden Testbedingungen betrachtet werden. Der Artikel liefert nicht genügend Details zu Modellarchitektur, Präzision, Arbeitslast und Messkonfiguration, um sie als allgemeine Leistungsgarantie zu behandeln. Insbesondere lässt sich allein aus der Parameterzahl nicht ableiten, wie viel Speicher eine Bereitstellung benötigt.
Der M50 selbst wird mit 160 TOPS INT8-Leistung, einem typischen Leistungswert von 10 W und Unterstützung für bis zu 48 GB LPDDR5/5X-Speicher beschrieben. Beschleunigerleistung, Gesamtleistungsaufnahme des Systems, theoretischer Durchsatz und Geschwindigkeit der Token-Generierung messen unterschiedliche Dinge.
Weitere berichtete Produkte sind eine M50-Version von Deepshards Truffle 1, Ugreens HomeAgent HA100 Pro und das ClawHouse X1. Ihre Beispiele konzentrieren sich auf lokalen Speicher, Medienverarbeitung im Haushalt und persönliche Agentenoberflächen. Angebundene Dienste wie E-Mail sind weiterhin auf Authentifizierung und Netzwerkzugang angewiesen, selbst wenn ein Modell lokal ausgeführt wird.
Der Bericht beschreibt einen Great-Wall-N90-Pro-Laptop mit Kylin V11, der ein 35B-Modell offline mit 30 Token pro Sekunde ausführt. Außerdem behandelt er einen Begleitroboter, der lokale Verarbeitung für Wahrnehmung und Gedächtnis nutzt, sowie ein Bildungsgerät auf Basis von LM5040-Beschleunigerkarten, die jeweils vier M50-Chips integrieren.
Die berichteten Rechen- und Speicherwerte des Bildungssystems gelten für die zusammengestellte Maschine, nicht für einen einzelnen M50. Leser, die Produkte vergleichen, sollten nach der tatsächlichen Kartenanzahl, der Speichertopologie, der Präzision und der gemessenen Arbeitslast fragen.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die Architekturdiskussion unterscheidet Mixture-of-Experts-Modelle von dichten Modellen. Ein MoE-Modell kann für ein Token nur eine Teilmenge von Experten aktivieren und muss dennoch seinen breiteren Parametersatz speichern. Dichte Modelle verwenden typischerweise bei jedem Schritt einen größeren Anteil ihrer Parameter, wodurch Speicherverkehr zu einem wichtigen Faktor wird.
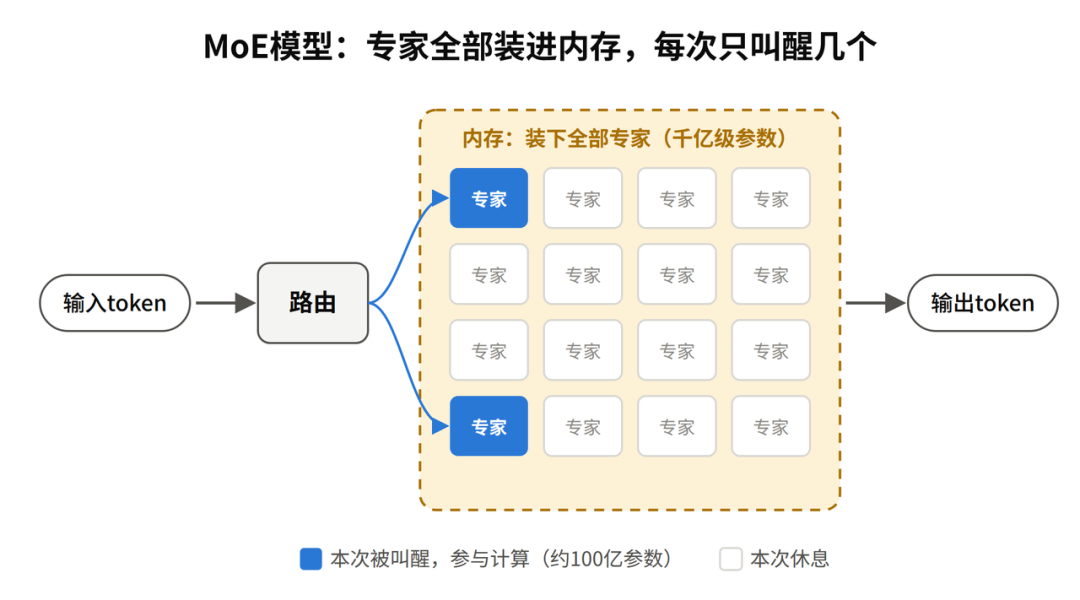
MoE-Illustration aus dem Quellenbericht; die ursprünglichen Beschriftungen erläutern gespeicherte und aktivierte Experten.
Houmo stellt zwei Entwicklungswege vor: 2D Compute-in-Memory, das Kapazität und Rechenleistung mit externem Speicher betont, und 3D Compute-in-Memory, das durch ein gestapeltes Design die Bandbreite betont. Der Bericht beschreibt SRAM-basierte Berechnungen in der Logikschicht als Unterscheidungsmerkmal des letzteren Ansatzes.
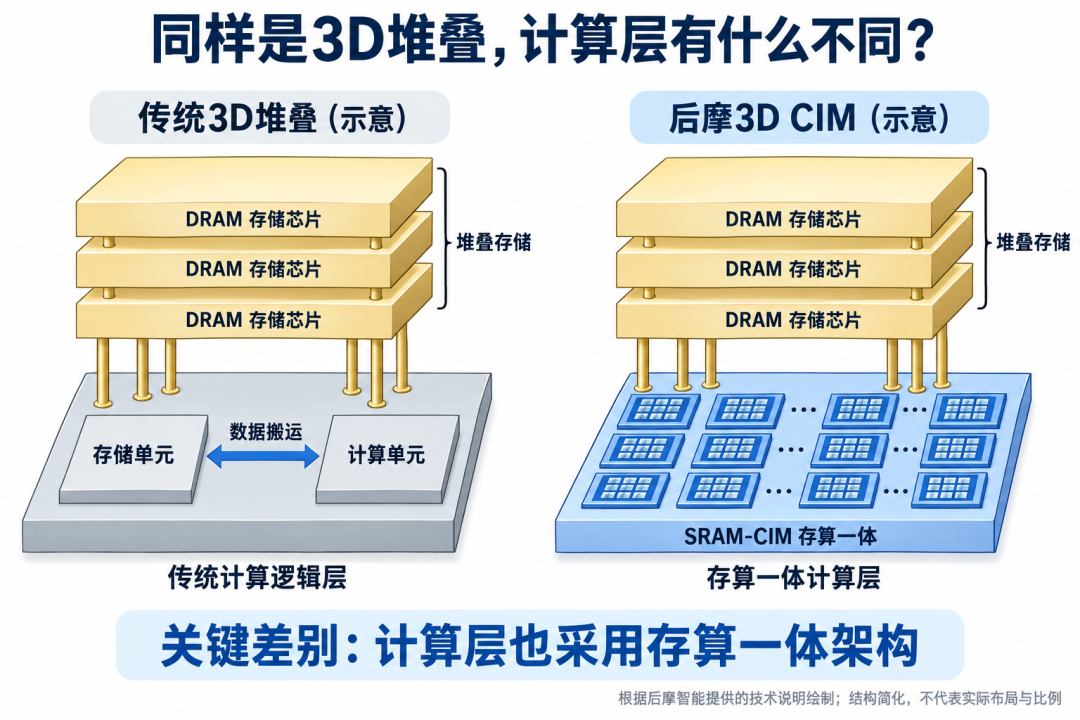
Architekturvergleich aus dem Xinzhiyuan/BAAI-Bericht, kein unabhängiger Benchmark.
Die Flächen- und Leistungsvergleiche des Unternehmens hängen davon ab, was jeweils verglichen wird. Sie sollten nicht ohne offengelegte Messumgebung auf jeden Chip oder jedes Modell übertragen werden. Zukünftige Verweise auf Flash oder RRAM beschreiben zudem eine Entwicklungsrichtung, nicht die Zusicherung einer aktuellen Produktverfügbarkeit.
Die Quelle verbindet diese Ankündigung mit der früheren Arbeit von Gründer und CEO Qiang Wu an GPGPU und OpenCL. Praktisch betrachtet ermöglicht die Veröffentlichung von Tools Entwicklern, Integrationsverhalten zu prüfen, Beispiele anzupassen und Fehlerbehebungen beizutragen.
Dieser Zugang kann wiederholte Arbeit bei Geräteherstellern reduzieren. Er beseitigt jedoch nicht die Notwendigkeit, Qualität, Thermik, Speichernutzung, Lizenzierung, Offline-Betrieb und Wiederherstellungsverhalten im Endprodukt zu testen. Ein reproduzierbares Beispiel auf der vorgesehenen Hardware ist ein besserer Ausgangspunkt als eine Schlagzeile über Parameterzahlen.
M50 ist ein Edge-KI-Beschleuniger für die im Bericht beschriebenen Szenarien auf lokalen Geräten. Beispiele umfassen Agent-Computer, Laptops, Heimsysteme, Roboter und Edge-Inferenzgeräte.
Der Bericht beschreibt einen stufenweisen Plan bis Januar 2027. Mehrere Repositories sind bereits öffentlich, Entwickler sollten jedoch den tatsächlichen Veröffentlichungsstatus und die Lizenz jeder Komponente prüfen.
Das Repository enthält Vorbereitungs- und Bewertungstools mit unterschiedlichen Plattformanforderungen. Seine Inferenzbeispiele benötigen unterstützte Houmo-Hardware und Runtime-Bibliotheken; die Quantisierung großer Modelle erfordert außerdem eine GPU.
Lokale Inferenz kann ohne einen Cloud-Modellservice funktionieren, wenn die erforderlichen Ressourcen installiert sind. Aufgaben mit Live-E-Mail, Messaging oder anderen Onlinediensten benötigen weiterhin Konnektivität und Autorisierung.
Nein. TOPS ist ein Operationsdurchsatzwert bei einer angegebenen Präzision, während die Token-Geschwindigkeit von Modellarchitektur, Speicherverkehr, Präzision und Softwareverhalten abhängt. Vergleichen Sie Messwerte für dasselbe Modell und dieselbe Arbeitslast.
Nein. Laut README müssen die meisten Datensätze von Drittanbietern separat bezogen und nach ihren jeweiligen Bedingungen verwendet werden. Die Repository-Lizenz gewährt keine kommerziellen Rechte an allen referenzierten Daten- oder Modellressourcen.
Houmos Ankündigung soll den Weg von der Modellvorbereitung bis zu einem funktionsfähigen Edge-Produkt einfacher wiederverwendbar machen. Öffentliche Repositories stellen bereits nützliche Beispiele bereit, während der breitere Stack weiterhin einem stufenweisen Veröffentlichungsplan folgt.
Die berichteten M50-Geräte zeigen mehrere mögliche Bereitstellungsformate, doch die praktische Entscheidung hängt weiterhin von den genauen Modellen, der Hardware und den Runtime-Anforderungen ab. Beginnen Sie mit einem unterstützten Beispiel und messen Sie die vollständige Produktarbeitslast.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.
