For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/jev-decision-model-typesafe-ai-870m-serie-7b7d7513.md.
Innerhalb weniger Wochen entwickelte sich TypeSafe AI von einem relativ unbekannten Unternehmen zu einem der meistbeobachteten Infrastruktur...
Innerhalb weniger Wochen entwickelte sich TypeSafe AI von einem relativ unbekannten Unternehmen zu einem der meistbeobachteten Infrastruktur-Start-ups im KI-Bereich.
Das Unternehmen hat nun eine Series A über 870 Millionen US-Dollar bei einer Post-Money-Bewertung von 7,5 Milliarden US-Dollar angekündigt.
Das wäre unter allen Umständen bemerkenswert. Ungewöhnlich an dieser Geschichte ist jedoch das Produkt hinter dieser Dynamik: Jev, ein Modell, das nicht versucht, ein Chatbot zu sein, keine langen Texte erzeugt und nicht in erster Linie zum Schreiben von Code entwickelt wurde.
Seine Aufgabe ist deutlich enger gefasst.
Es trifft Entscheidungen.
Eine typische Jev-Anfrage sieht eher so aus:
Ausgehend von diesem Zustand,
welche Option sollte die Software auswählen?
als so:
Bitte schreibe mir eine ausführliche Erklärung.
TypeSafe bezeichnet Jev als ein System-One-Modell: ein Modell, das für schnelle, begrenzte und strukturierte Entscheidungen entwickelt wurde, die Software direkt verwenden kann.
Anstelle von frei formuliertem Text liefert Jev beispielsweise:
Dieser enge Fokus macht Jev kostengünstig und schnell genug, um in hochvolumigen Software-Workflows eingesetzt zu werden, in denen ein herkömmliches Frontier-LLM unnötig langsam oder teuer wäre.
Und die Reaktion des Marktes war extrem.
TypeSafe AI wurde 2024 in San Francisco gegründet.
Vor dem Start von Jev war das Unternehmen etwa zwei Jahre lang im Stealth-Modus tätig.
Der öffentliche Durchbruch erfolgte am 15. September 2026, als TypeSafe sein erstes System-One-Modell vorstellte und den zugrunde liegenden Trainingsansatz erklärte: Reinforcement Learning for Calibrated Decisions beziehungsweise RLCD.
Die ursprüngliche Quelle berichtet, dass TypeSafe zuvor rund um den Start von Jev eine Seed-Runde über 40 Millionen US-Dollar angekündigt hatte. Weniger als einen Monat später gab das Unternehmen die deutlich größere Series A bekannt.
Der offizielle Finanzierungsbeitrag von TypeSafe bestätigt:
| Punkt | Bestätigtes Detail |
|---|---|
| Series A | 870 Millionen US-Dollar |
| Post-Money-Bewertung | 7,5 Milliarden US-Dollar |
| Lead-Investor | Andreessen Horowitz |
| Weitere genannte Teilnehmer | Sequoia Capital, DCVC, Angel-Investoren |
| Neues Mitglied im Board | Martin Casado |
Das Unternehmen will das neue Kapital nach eigenen Angaben nutzen, um:
Der entscheidende Punkt ist, dass Investoren nicht nur auf ein weiteres universell einsetzbares Frontier-Modell setzen.
Sie setzen auf eine andere Modellkategorie.
Die Grundidee von Jev ist einfach: Viele Softwaresysteme benötigen keine Absätze.
Sie benötigen eine Entscheidung.
Beispiele sind:
Herkömmliche LLMs können diese Fragen beantworten, tun dies jedoch typischerweise durch autoregressive Texterzeugung.
TypeSafe argumentiert, dass dies verschwenderisch ist, wenn die Anwendung die Form der Antwort bereits kennt.
Das Design von Jev sieht stattdessen so aus:
Strukturierter Zustand
      ↓
Typisierte Fragen
      ↓
Parallele Entscheidungsberechnung
      ↓
Wahrscheinlichkeiten + begrenzte Ausgaben
      ↓
Anwendung verzweigt auf Grundlage des Ergebnisses
TypeSafe beschreibt dies als „maschinen-native“ Intelligenz: Das Modell ist darauf optimiert, in Code eingebunden zu werden, statt Sprache zu erzeugen, die ein Mensch lesen muss.
TypeSafe listet Jev derzeit zu folgenden Preisen:
Eingabe: 0,042 $ / 1 Mio. Token
Ausgabe: Kostenlos / wird nicht abgerechnet
Dieser Preis liegt deutlich unter dem vieler universell einsetzbarer Frontier-Modelle.
Der Grund liegt in der Architektur.
Jev erzeugt nicht beliebigen Text Token für Token. TypeSafe zufolge liefert der Sampler die begrenzten Ausgaben für eine Entscheidung parallel.
Das Unternehmen gibt für seinen Dienst eine End-to-End-Latenz von ungefähr 70–500 ms an und erklärt, Jev könne bei vergleichbaren System-One-Workloads 40- bis 200-mal schneller sein.
Diese Angaben stammen aus der von TypeSafe veröffentlichten eigenen Evaluation und sollten als Anbieterangaben für die Aufgabenform verstanden werden, auf die Jev ausgelegt ist.
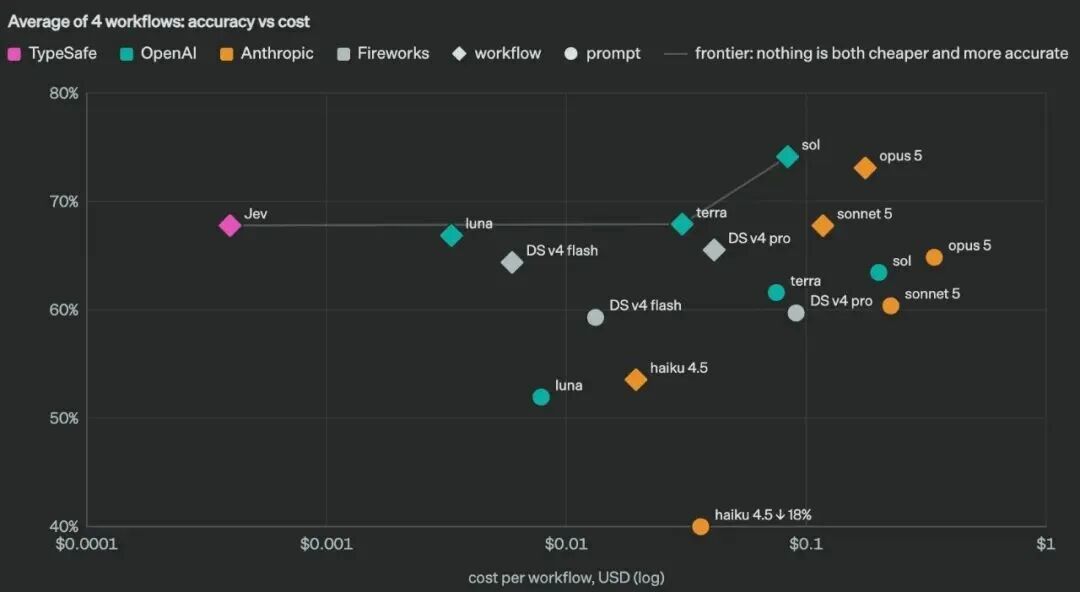
Eine der stärksten Aussagen von TypeSafe ist, dass Jev keine Typfehler erzeugt.
Das muss präzise interpretiert werden.
Es bedeutet, dass Jev einen Wert zurückgibt, der dem Ausgabevertrag entspricht, wenn die Anwendung ein begrenztes Ausgabeschema vorgibt.
Zum Beispiel:
Zulässige Antwort:
- genehmigen
- prüfen
- ablehnen
Jev sollte nicht plötzlich Folgendes zurückgeben:
Hier ist ein fünf Absätze langer Aufsatz über meine Argumentation ...
Das ist eine wichtige Zuverlässigkeitseigenschaft für Produktionssoftware.
Typsicherheit bedeutet jedoch nicht, dass die semantische Entscheidung immer korrekt ist.
Ein Modell kann einen gültigen Wert ablehnen zurückgeben und trotzdem die falsche Geschäftsentscheidung treffen.
Deshalb liefert Jev auch Wahrscheinlichkeiten und Konfidenzinformationen. So kann die Anwendung Schwellenwerte definieren, etwa:
Konfidenz >= 0,95
→ automatisieren

0,70 <= Konfidenz < 0,95
→ sekundäre Prüfung

Konfidenz < 0,70
→ menschliche Prüfung
Der Nutzen des Modells hängt daher sowohl von der Klassifikationsqualität als auch von der Kalibrierung ab.
Das stärkste unabhängige Adoptionssignal im ursprünglichen Artikel kommt von Vercel.
Vercel fügte Jev kurz nach dem Start zum AI Gateway hinzu und beobachtete, wie schnell zahlende Teams damit begannen, es zu nutzen.
Vercel zufolge erreichte Jev innerhalb von 24 Stunden fast 13 % der zahlenden Teams.
Damit war die Reichweite mehr als doppelt so groß wie bei jedem früheren Modellstart in der Geschichte des AI Gateway zu diesem Zeitpunkt.
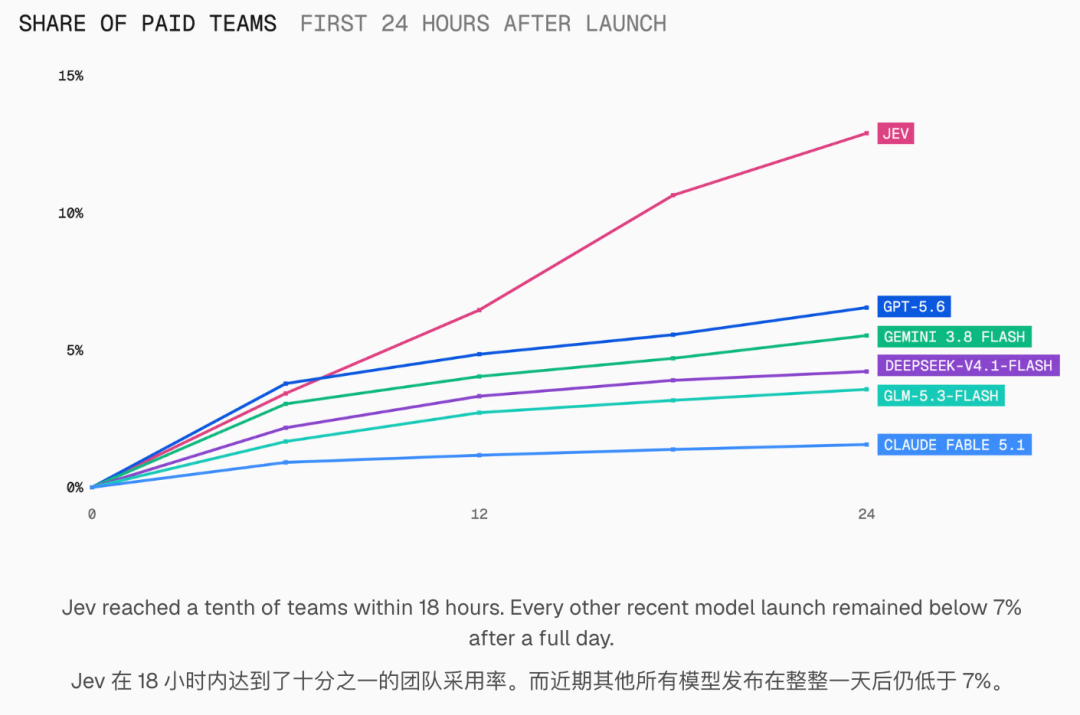
Vercel stellte außerdem fest, dass Jev innerhalb der ersten zwölf Stunden jedes Vergleichsmodell überholte und seinen Vorsprung am ersten Tag weiter ausbaute.
Das ist relevant, weil sich die Nutzung von Jev von der eines gelegentlich verwendeten Chatbots unterscheidet.
Ein Mensch probiert einen neuen Chatbot vielleicht einige Male aus und hört dann wieder auf.
Ein in Software eingebettetes Modell kann dagegen kontinuierlich Anfragen erhalten.
Dadurch entsteht ein völlig anderes Nutzungsmuster:
Menschlicher Chatbot:
Benutzer öffnet die Anwendung
→ sendet eine Nachricht
→ wartet
→ schließt die Anwendung

Entscheidungsmodell in Software:
Anfrage geht ein
→ Entscheidungsmodell wird ausgeführt
→ Anwendung verzweigt
→ den ganzen Tag wiederholen
Der Ausgangsartikel bringt dies mit einer einfachen Beobachtung auf den Punkt:
Menschen schlafen. Code nicht.
Der ursprüngliche Artikel zitiert außerdem TypeSafe und Investoren mit der Aussage, dass Jev innerhalb von drei Tagen nach dem Start ungefähr eine Billion verarbeitete Token erreicht habe.
TypeSafe beschrieb den Datenverkehr später als anhaltend und nicht als einmalige Spitze.
Im Beitrag zur Series A erklärt das Unternehmen inzwischen, dass ungefähr ein Drittel der Fortune 500 Jev nutzt oder integriert. Außerdem behauptet es, Kunden hätten in Produktionskosten bereits Millionen US-Dollar eingespart.
Dabei handelt es sich um eigene Geschäftskennzahlen von TypeSafe und nicht um unabhängig geprüfte Zahlen. Sie helfen jedoch zu erklären, warum Investoren Jev als mehr als nur eine virale Entwicklerdemo betrachteten.
Das Nutzungsmuster deutet auf eine Nachfrage zwischen Maschinen hin.
Sobald Jev in folgende Bereiche eingebettet ist:
kann es jedes Mal aufgerufen werden, wenn die umgebende Software diesen Zweig erreicht.
Genau für diese Arbeitslast wurde TypeSafe entwickelt.
Die Entstehungsgeschichte von Jev ist ungewöhnlich symmetrisch.
Der Mitgründer und CEO von TypeSafe, Diogo Almeida, arbeitete zuvor bei Google Brain und OpenAI.
Auf der eigenen Teamseite beschreibt TypeSafe ihn als Miterfinder von RLHF und InstructGPT – Arbeiten, die zur Entwicklung von ChatGPT und GPT-4 beitrugen.
Bei OpenAI arbeitete Almeida an Methoden, die dazu beitrugen, aus reinen Sprachmodellen Systeme zu machen, die Anweisungen befolgen und natürlich mit Menschen interagieren konnten.
Nach seinem Weggang von OpenAI wurde er zunehmend skeptisch, dass Chat die Standardschnittstelle für Intelligenz innerhalb von Software sein sollte.
In TypeSafes Beitrag zum Start von Jev fasste er diesen Wandel so zusammen: Wenn Modelle in Gesprächen äußerst leistungsfähig geworden seien, warum habe sich die Automatisierung dann nicht ebenso schnell weiterentwickelt?
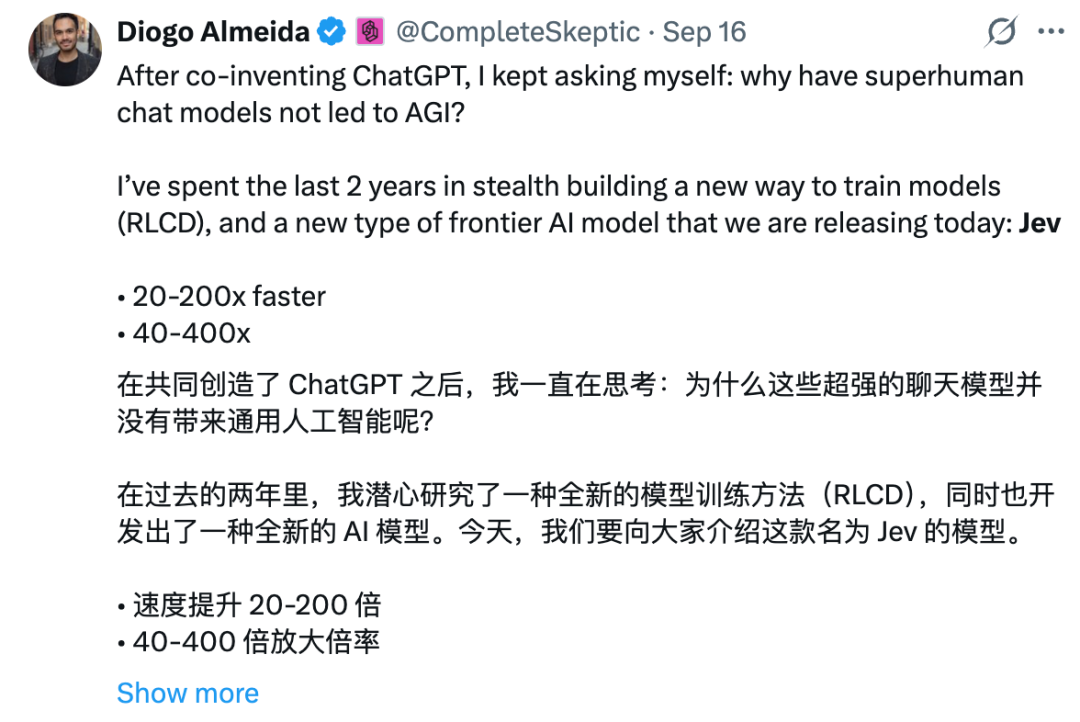
Ein Chatbot ist auf Flexibilität optimiert.
Diese Flexibilität ist wertvoll, wenn ein Mensch die Ausgabe liest.
Produktionssoftware benötigt jedoch häufig das Gegenteil:
Die Position von TypeSafe lautet, dass universelle Sprachgenerierung für diese Aufgaben häufig eine unnötig leistungsfähige Abstraktion darstellt.
Anstatt ein Frontier-Modell aufzufordern, eine strukturierte Antwort zu schreiben und anschließend den Text zu validieren, wurde Jev entwickelt, um die begrenzte Entscheidung direkt zu treffen.
Der Slogan des Unternehmens bringt diese Philosophie auf den Punkt:
Baue für die Produktion, nicht für Gott.
Die Formulierung ist bewusst provokant, aber die zugrunde liegende Idee ist praktisch: Optimiere für Software, die zuverlässig in der Produktion funktioniert, statt jedes KI-Produkt als Schritt hin zu einem universellen Modell zu betrachten.
TypeSafe nennt seine Trainingsmethode Reinforcement Learning for Calibrated Decisions (RLCD).
Das Unternehmen stellt sie zwei bekannten Ansätzen gegenüber:
| Trainingsrichtung | Primäres Optimierungsziel |
|---|---|
| RLHF | Antworten, die Menschen bevorzugen |
| RLVR | Überprüfbare Ergebnisse des Schlussfolgerns |
| RLCD | Kalibrierte strukturierte Entscheidungen |
Bei Jev steht die Kalibrierung im Mittelpunkt.
Wenn ein Modell 0,90 angibt, besteht das Ziel darin, dass Ereignisse mit ungefähr dieser Konfidenz über eine geeignete Evaluationsverteilung hinweg tatsächlich in etwa 90 % der Fälle korrekt sind.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Das ist für die Gestaltung automatisierter Workflows deutlich nützlicher als ein unkalibriertes Label allein.
Eine Anwendung kann die Unsicherheit des Modells anschließend in Richtlinien übersetzen:
hohe Konfidenz
→ automatisieren

mittlere Konfidenz
→ ein anderes Modell abfragen oder weitere Regeln anwenden

niedrige Konfidenz
→ an eine Person eskalieren
Das ist ein Grund, warum Entscheidungsmodelle für hochvolumige Systeme attraktiv sind.
Sie beseitigen Unsicherheit nicht.
Sie machen Unsicherheit für Software leichter nutzbar.
Der ursprüngliche Artikel hebt außerdem Almeidas Skepsis gegenüber öffentlichen Benchmark-Wettbewerben hervor.
TypeSafe veröffentlicht zwar Evaluationen, verwendet in seinen Startunterlagen jedoch ungewöhnlich viel Raum auf die Dokumentation von Einschränkungen.
Das Unternehmen weist beispielsweise ausdrücklich darauf hin, dass:
Das ist eine wichtige Unterscheidung.
TypeSafe vermarktet sein Modell weiterhin offensiv, behauptet aber nicht, dass Jev Frontier-LLMs überall ersetzen sollte.
Die eigene Dokumentation des Unternehmens ordnet die Produkte unterschiedlich ein:
Generatives LLM
→ schreiben, schlussfolgern, erklären, programmieren, konversieren

Entscheidungsmodell
→ klassifizieren, routen, bewerten, verifizieren, freigeben, priorisieren
Beide können innerhalb desselben Systems zusammenarbeiten.
Die Führung von TypeSafe geht über Almeida hinaus.
Auf der offiziellen Teamseite werden genannt:
Zum weiteren Team gehören Personen von Unternehmen wie OpenAI, Google Brain, Meta/FAIR, Stripe, Airbnb, Plaid und Docker.
Dieser Hintergrund hilft, den Produktschwerpunkt zu erklären.
Bei Jev geht es weniger darum, eine neue Verbraucheroberfläche zu schaffen, sondern eher darum, etwas zu entwickeln, das Entwickler tief in die Infrastruktur einbetten können.
Die schnelle Akzeptanz von Jev hatte noch einen weiteren Effekt.
Sie bestätigte die Kategorie schnell genug, dass große Infrastruktur- und Modellunternehmen innerhalb weniger Wochen konkurrierende Produkte veröffentlichten.
Der ursprüngliche Artikel endet genau mit diesem Wandel.
Microsoft kündigte Microsoft-Decision-1 an, ein Modell, das speziell für strukturierte Entscheidungsbewertungen entwickelt wurde.
Das Modell basiert auf Qwen3.5-9B und ist über Microsoft Foundry als öffentliche Vorschau verfügbar.
Es unterstützt Aufgaben wie:
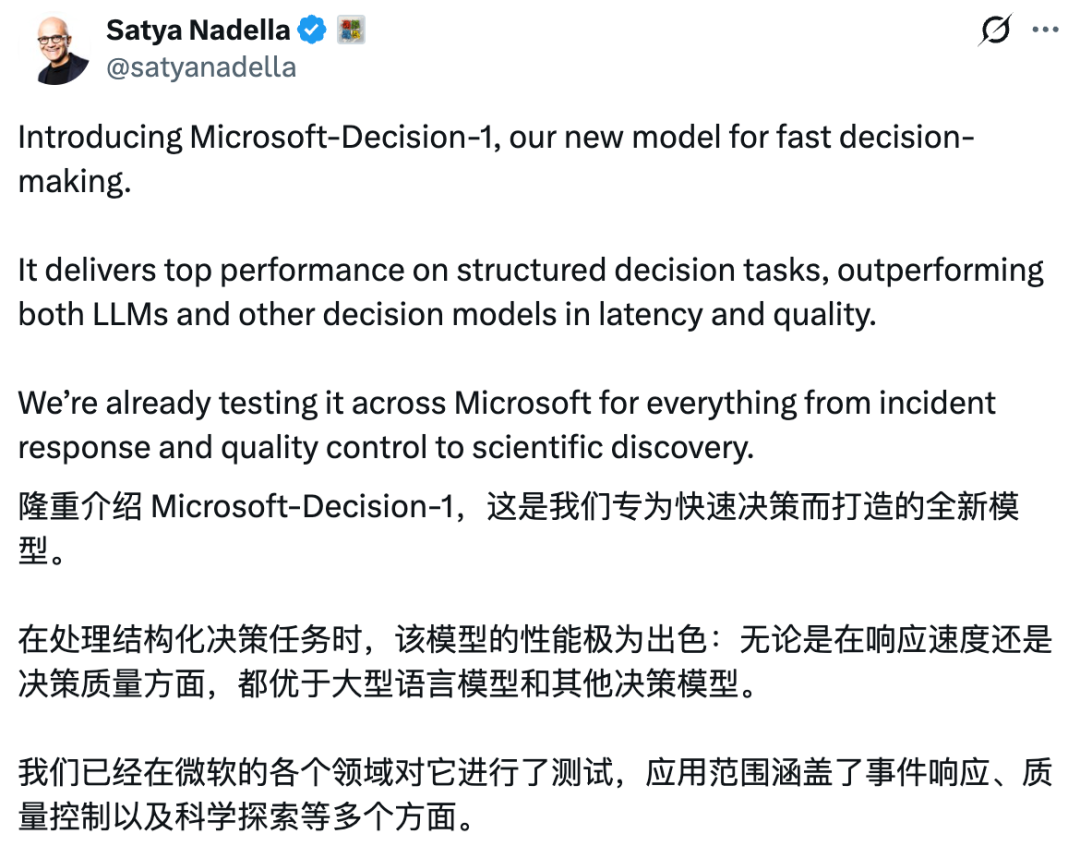
Wenn eine feste Gruppe von Optionen vorgegeben wird, gibt Microsoft-Decision-1 kalibrierte Wahrscheinlichkeitswerte für diese Optionen zurück.
Microsoft berichtet, dass das Modell in seinem Vergleich mit 36 Benchmarks und fast 150.000 Fragen die höchste Genauigkeit erreichte. Außerdem sei es in der internen Evaluation deutlich schneller als GPT-6 Sol gewesen.
Diese Angaben stammen aus den eigenen Benchmark-Ergebnissen von Microsoft. Entwickler sollten das Modell daher anhand ihrer eigenen Workloads validieren, bevor sie die Werte als universelle Leistungsrangliste betrachten.
OpenAI schlug mit seiner Decisions API, die am 6. Oktober 2026 als öffentliche Beta veröffentlicht wurde, in dieselbe Richtung ein.
Die API basiert auf GPT-6 Luna und akzeptiert Text, Bilder oder beides.
Sie unterstützt drei Arten strukturierter Fragen:
| Typ | Ergebnis |
|---|---|
| Prädikat | Wahrscheinlichkeit, dass eine Bedingung wahr ist |
| Auswahl | Eine Auswahl aus den bereitgestellten Optionen plus Wahrscheinlichkeiten |
| Bewertung | Wahrscheinlichkeitsgewichtete Bewertung über geordnete Stufen |
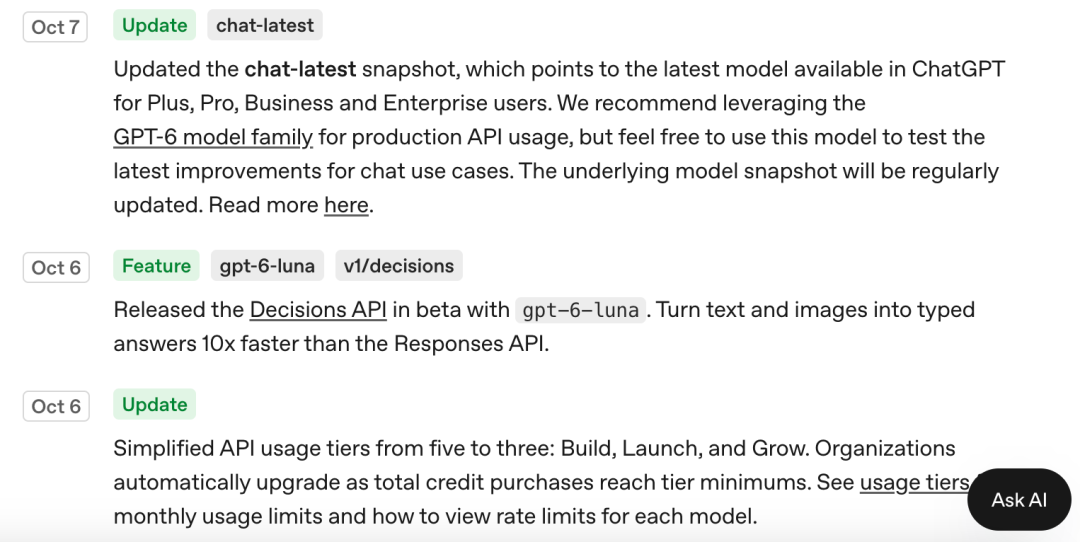
OpenAI zufolge kann die dedizierte API Entscheidungen bei der entsprechenden Aufgabenform ungefähr zehnmal schneller zurückgeben als GPT-6 Luna über die Responses API.
Die Preise der Beta sind ungewöhnlich einfach:
Eingabe: 0,10 $ / 1 Mio. Token
Ausgabe: keine Gebühr für Ausgabetoken
Cache-Lesegebühr: keine
Cache-Schreibgebühr: keine
Der wesentliche Unterschied zu Jev liegt in der Architektur.
Jev ist die eigens entwickelte System-One-Modellfamilie von TypeSafe.
Die Decisions API von OpenAI stellt dagegen eine spezialisierte Entscheidungsschnittstelle rund um GPT-6 Luna bereit.
Aus Sicht eines Anwendungsentwicklers bedienen beide jedoch ein ähnliches Bedürfnis:
Zustand hinein
→ typisierte begrenzte Entscheidung heraus
Cloudflare trat noch früher in den Markt ein und kündigte am 1. Oktober Clef und Clef-flash an.
Beide sind Entscheidungsmodelle, die über Workers AI verfügbar sind. Cloudflare hat außerdem ihre Gewichte unter der Apache-2.0-Lizenz als Open Source veröffentlicht.
Sie folgen einer mit Jev kompatiblen API-Struktur, wodurch sie sich leichter in Workflows austauschen lassen, die auf System-One-Entscheidungsanfragen basieren.
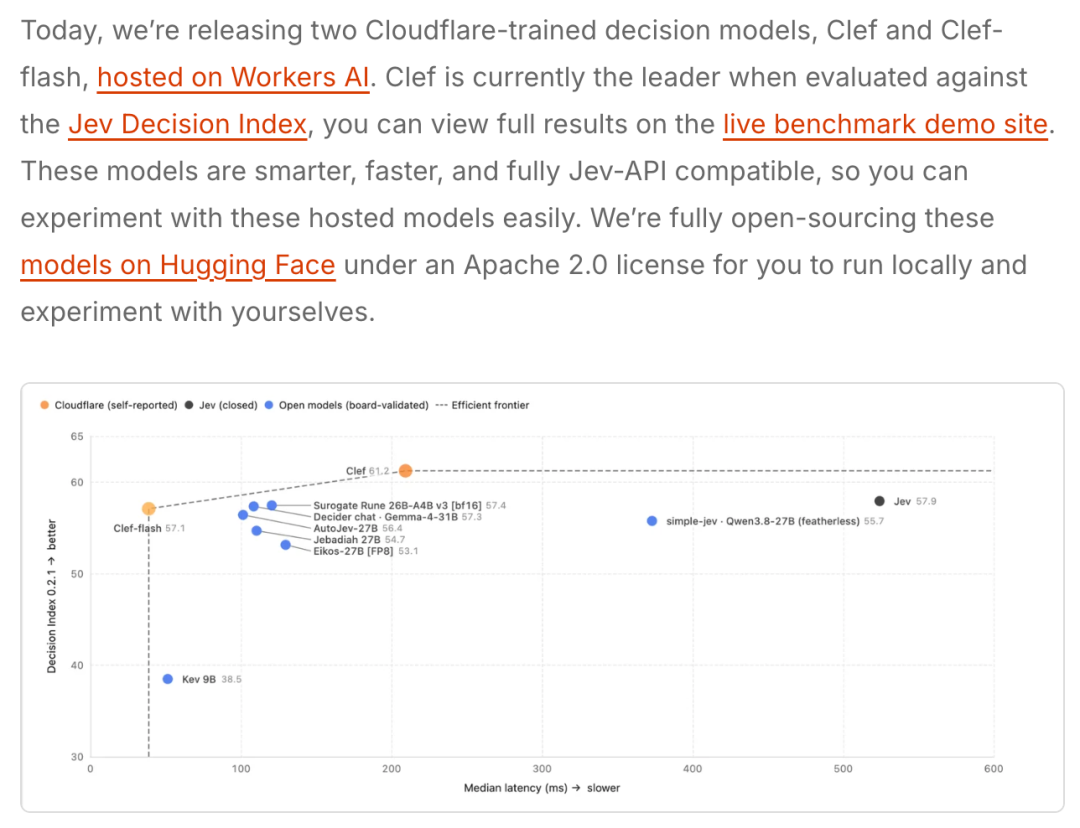
Cloudflare berichtet:
| Modell | Größe | Kontext | Vorgesehener Schwerpunkt |
|---|---|---|---|
| Clef | 27B | 64K | Höhere Entscheidungsqualität |
| Clef-flash | 9B | 64K | Sehr geringe Latenz |
In Cloudflares eigener Testsuite lagen Clef oder Clef-flash bei sieben von zehn hervorgehobenen Entscheidungsbenchmarks vorn. Jev blieb bei einigen Einzelaufgaben wie When2Call und BRIGHT stärker.
Cloudflare meldete außerdem folgende mediane Latenzen:
Clef:       209,3 ms
Clef-flash: 38,8 ms
Jev:        524,1 ms
Auch diese Zahlen stammen aus der Evaluationsumgebung von Cloudflare.
Sie sind als Wettbewerbsnachweis nützlich, stellen aber keine universelle Latenzgarantie für jede Bereitstellung dar.
Der zentrale Punkt des Ausgangsartikels ist nicht nur, dass Jev eine enorme Finanzierungsrunde eingeworben hat.
Es geht darum, dass eine Modellkategorie fast sofort von ungewöhnlich zu stark umkämpft wurde.
Innerhalb weniger Wochen umfasste der Markt:
Jede Implementierung unterscheidet sich, doch alle teilen eine gemeinsame Erkenntnis:
Nicht jede KI-Anfrage benötigt generativen Text.
Viele Produktionsaufgaben ähneln eher intelligenten if-Anweisungen.
Zum Beispiel:
wenn Betrugswahrscheinlichkeit > 0,98:
    blockieren()
sonst wenn Betrugswahrscheinlichkeit > 0,70:
    prüfen()
sonst:
    zulassen()
Die schwierige Aufgabe besteht nicht darin, den Zweig zu schreiben.
Sie besteht darin, aus unordentlichem Kontext aus der realen Welt eine nützliche, kalibrierte Wahrscheinlichkeit zu erzeugen.
Entscheidungsmodelle sollen diese Fähigkeit kostengünstig genug machen, damit sie überall eingesetzt werden kann.
Auf den ersten Blick wirken spezialisierte Entscheidungsmodelle wie eine Bedrohung für universell einsetzbare LLMs.
In der Praxis könnten sie den gesamten KI-Verbrauch erhöhen.
Ein universell einsetzbarer Agent kann ein Entscheidungsmodell an häufigen Kontrollpunkten verwenden:
Benutzeranfrage
→ Entscheidungsmodell wählt die Route
→ LLM übernimmt komplexes Schlussfolgern nur bei Bedarf
→ Entscheidungsmodell bewertet die Ausgabe
→ Workflow wird fortgesetzt oder eskaliert
Dadurch können Entwickler teures Schlussfolgern auf die Teile beschränken, die es tatsächlich benötigen.
Alles andere kann von günstigeren begrenzten Modellen übernommen werden.
Das Ergebnis könnten insgesamt mehr KI-Aufrufe sein, nicht weniger.
Diese Idee steht im Einklang mit dem Namen Jev, der sich laut TypeSafe auf den Ökonomen William Stanley Jevons und das Jevons-Paradoxon bezieht: Eine höhere Effizienz kann den Gesamtverbrauch erhöhen, weil niedrigere Kosten neue Anwendungsfälle ermöglichen.
In der KI-Infrastruktur könnte dieselbe Logik so aussehen:
günstigere Entscheidungen
→ mehr Entscheidungen werden wirtschaftlich
→ mehr Software erhält KI-Kontrollpunkte
→ die gesamte Nutzung maschineller Intelligenz steigt
Jev ist das erste System-One-Modell von TypeSafe AI. Es wurde für schnelle, strukturierte Entscheidungen statt für die Erzeugung frei formulierter Texte entwickelt. Das Modell verarbeitet den Anwendungszustand zusammen mit typisierten Fragen und gibt begrenzte Antworten mit Wahrscheinlichkeiten und Konfidenzinformationen zurück.
TypeSafe listet Jev derzeit mit 0,042 US-Dollar pro Million Eingabetoken und berechnet keine Ausgabetoken. Diese Preisgestaltung gilt für Jevs strukturierte Entscheidungsschnittstelle, nicht für ein universelles Textgenerierungsmodell.
Die stärkste formale Aussage von TypeSafe bezieht sich auf die Ausgabetypsicherheit: Ein begrenztes Schema verhindert, dass das Modell beliebige, fehlerhaft formatierte Ausgaben erzeugt. Das bedeutet nicht, dass jede semantische Entscheidung korrekt ist. Deshalb bleiben Kalibrierung, Schwellenwerte, Evaluation und menschliche Prüfung wichtig.
Vercel zufolge nutzten innerhalb von 24 Stunden nach dem Start im AI Gateway fast 13 % der zahlenden Teams Jev. Vercel bezeichnete es zu diesem Zeitpunkt als das am schnellsten angenommene Modell in der Geschichte des AI Gateway.
Die Decisions API ist ein OpenAI-Endpunkt in der öffentlichen Beta, der auf GPT-6 Luna basiert. Sie akzeptiert Text- und Bildbelege und gibt Prädikatswahrscheinlichkeiten, Auswahlen oder Bewertungen zurück. OpenAI behauptet für diese Entscheidungsaufgaben eine ungefähr zehnmal niedrigere Latenz als bei der Nutzung von GPT-6 Luna über die Responses API.
Microsoft-Decision-1 ist ein strukturiertes Entscheidungsmodell, das in der öffentlichen Vorschau von Microsoft Foundry verfügbar ist. Es basiert auf Qwen3.5-9B und wurde für Klassifizierung, Routing, Ranking, Bewertung, Verifizierung und Workflow-Steuerung entwickelt.
Cloudflare beschreibt Clef und Clef-flash als Open-Source- beziehungsweise Open-Weight-Entscheidungsmodelle und hat sie unter der Apache-2.0-Lizenz veröffentlicht. Sie werden außerdem über Workers AI gehostet und verwenden einen mit Jev kompatiblen System-One-API-Stil.
In der Regel nicht. Entscheidungsmodelle eignen sich am besten für begrenzte Entscheidungen mit hohem Volumen, während universelle LLMs weiterhin besser für Generierung, Erklärungen, komplexes Schlussfolgern und offene Tool-Nutzung geeignet sind. Viele Produktionssysteme werden beide Modelltypen einsetzen.
Die Series A von TypeSafe AI über 870 Millionen US-Dollar ist relevant, weil sie mehr als nur ein einzelnes Start-up bestätigt. Sie bestätigt eine Modellkategorie: schnelle, begrenzte und maschinenlesbare Entscheidungssysteme, die dafür entwickelt wurden, tief in Produktionssoftware eingebettet zu werden.
Die schnelle Akzeptanz von Jev bei Vercel, der niedrige Eingabepreis, die strukturierten Ausgaben und das auf Kalibrierung ausgerichtete Design zeigen, warum Entwickler interessiert sind. Die stärksten Leistungsangaben müssen jedoch weiterhin im Kontext gelesen werden: Einige stammen direkt von TypeSafe, während Vercel, Cloudflare, Microsoft und OpenAI eigene Messungen unter unterschiedlichen Bedingungen veröffentlichen.
Das wichtigste Marktsignal ist, wie schnell Wettbewerber folgten. Innerhalb weniger Wochen verfügten Microsoft, OpenAI und Cloudflare über Produkte, die auf dasselbe Grundproblem zielten.
Jevs größte Leistung besteht möglicherweise nicht in einem einzelnen Benchmark oder einer einzelnen Finanzierungsrunde – sondern darin, bewiesen zu haben, dass ein großer Teil der Produktions-KI überhaupt nicht sprechen muss.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



