Das AI-Unternehmen Moon's Dark Side hat sein Versprechen eingelöst und die vollständigen Gewichte von Kimi K3 veröffentlicht – dem bislang g...
Moonshot AI hat sein Versprechen eingelöst und die vollständigen Gewichte seines bisher größten und ambitioniertesten Modells – Kimi K3 – veröffentlicht.
Das Modell kann nun über die offiziellen Hugging Face- und GitHub-Seiten von Moonshot AI heruntergeladen werden, begleitet von einem detaillierten technischen Bericht sowie unterstützenden Infrastrukturprojekten.
Kimi K3 ist ein nativ multimodales Mixture-of-Experts-Modell mit insgesamt 2,8 Billionen Parametern, von denen pro Token etwa 104 Milliarden Parameter aktiviert werden, und verfügt über ein Kontextfenster von 1 Million Token.
Moonshot positioniert es als ein Open-Weight-Spitzenteam, das speziell für langfristige Programmieraufgaben, Forschung, multimodales Verständnis, wissensbasierte Agentenarbeit sowie Reasoning-Aufgaben entwickelt wurde, die Hunderte oder Tausende von Schritten umfassen können.
Die Bedeutung dieser Veröffentlichung liegt in zwei Aspekten.
Erstens erweitert das Modell selbst die Größenordnung der Open-Weight-Modelle auf die 3-Billionen-Parameter-Klasse.
Zweitens geht die Offenlegung von Moonshot weit über die Modell-Checkpoints hinaus. Die veröffentlichten Materialien beschreiben detailliert die Architektur, die Post-Training-Strategien, die Infrastruktur für langes Kontext-Reinforcement-Learning, das Expert-Parallel-Training-System, Reasoning-Optimierungen, Benchmark-Ergebnisse sowie mehrere langfristige technische Fallstudien.
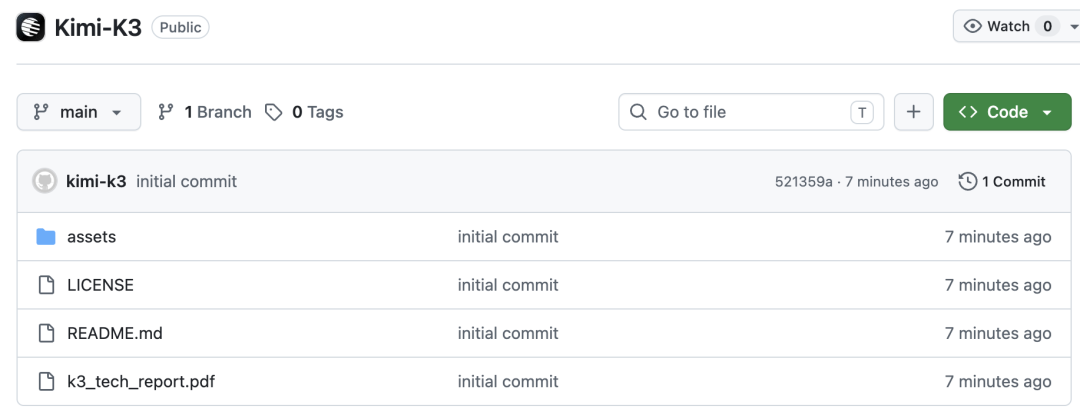
Moonshot hatte zuvor die Ankündigung von Kimi K3 gemacht und versprochen, die vollständigen Gewichte bis zum 27. Juli 2026 zu veröffentlichen.
Diese Veröffentlichung ist nun erfolgt.
Das offizielle Modell ist über die folgenden Kanäle erhältlich:
Das GitHub-Repository enthält eine README-Datei, die Kimi K3-Lizenz, den vollständigen technischen Bericht, Ressourcen zu Architektur und Benchmarks, Bereitstellungsanleitungen sowie Modellnutzungshinweise.
Die Hugging Face-Modellkarte bietet Zugang zur Modellkonfiguration und zu den veröffentlichten Gewichten.
Dies bedeutet, dass das Modell von einem geplanten Open-Release eines gehosteten Spitzensystems zu einem Modell übergegangen ist, das Forscher und qualifizierte Infrastrukturteams gemäß den Bedingungen der Kimi K3-Lizenz tatsächlich herunterladen, inspizieren, bereitstellen, feinabstimmen und anpassen können.
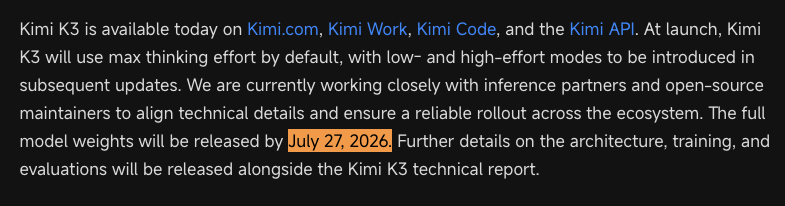
Kimi K3 lässt sich am besten als ein Modell mit offenen Gewichten und öffentlichem Code sowie Dokumentation beschreiben.
Die Lizenz gewährt weitreichende Rechte, die es Nutzern erlauben, Kopien unter den Lizenzbedingungen zu verwenden, zu vervielfältigen, zu modifizieren, zu verfeinern, bereitzustellen, abgeleitete Werke zu erstellen, weiterzuverteilen, Unterlizenzen zu vergeben und zu verkaufen.
Allerdings,
enthält die Lizenz zusätzliche kommerzielle Anforderungen.
Beispielsweise muss ein Unternehmen, das ein qualifiziertes Model-as-a-Service-Geschäft betreibt und einen Gesamtumsatz von mehr als 20 Millionen US-Dollar in einem Zeitraum von zwölf aufeinanderfolgenden Monaten erzielt, vor der kommerziellen Nutzung von Kimi K3 oder dessen Ableitungen eine separate Vereinbarung mit Moonshot AI abschließen.
Die Lizenz enthält auch Darstellungsanforderungen für bestimmte sehr große kommerzielle Produkte oder Dienste, die bestimmte Benutzer- oder Umsatzschwellen überschreiten.
Die interne Nutzung sowie die Nutzung über offizielle Moonshot-Produkte oder zertifizierte Reasoning-Partner werden unterschiedlich behandelt.
Daher sollte jeder, der Kimi K3 für kommerzielle Zwecke nutzen möchte, die tatsächliche Lizenz sorgfältig lesen und nicht davon ausgehen, dass sie mit Apache 2.0, MIT oder anderen Standard-Permissive-Lizenzen identisch ist.
Die Gesamtkapazität von Kimi K3 ist enorm, aber sein Mixture-of-Experts (MoE)-Design bedeutet, dass nicht alle 2,8 Billionen Parameter für jedes Token aktiviert werden.
Die offizielle Modellkarte listet die folgenden Informationen auf:
| Spezifikation | Kimi K3 |
|---|---|
| Architektur | Mixture of Experts (MoE) |
| Gesamtparameter | 2,8 T |
| Aktivierte Parameter | 104 B |
| Anzahl Schichten | 93 |
| Dichte Schichten | 1 |
| Anzahl gerouteter Experten | 896 |
| Anzahl pro Token ausgewählter Experten | 16 |
| Anzahl gemeinsamer Experten | 2 |
| Vokabulargröße | 160 K |
| Kontextlänge | 1.048.576 Tokens |
| Visueller Encoder | MoonViT-V2 |
| Parameter im visuellen Encoder | 401 M |
| Quantisierungsmethode | MXFP4 Gewichte / MXFP8 Aktivierungen |
| Modalitäten | Text und Bild |
Der technische Bericht bietet einen genaueren Architekturvergleich mit Kimi K2.
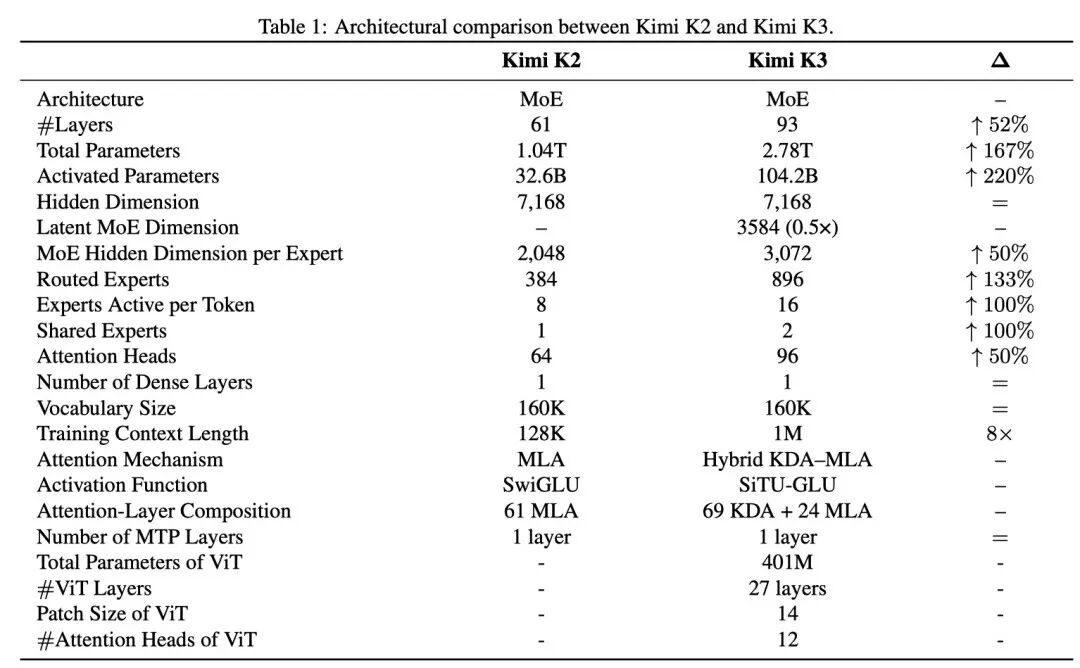
Im Vergleich zu Kimi K2 hat K3 die Tiefe des Modells und die Expertensparsity erhöht und gleichzeitig neue Aufmerksamkeits- und Residuen-Mechanismen eingeführt.
Moonshot gibt an, dass die kombinierte Verbesserung von Architektur und Trainingsmethode auf Basis von Kimi K2 die Skalierungseffizienz insgesamt um etwa das 2,5-fache gesteigert hat.
Diese Aussage bezieht sich auf die Effizienz, mit der zusätzliche Rechenleistung in Modellfähigkeiten umgewandelt wird, und nicht auf eine allgemeine 2,5-fache Beschleunigung der Inferenz.
Kimi K3 ist als nativ multimodales Modell konzipiert, nicht als Sprachmodell, dem erst am Ende des Trainings ein visuelles Modul hinzugefügt wird.
Sein visueller Encoder MoonViT-V2 verfügt über etwa 401 Millionen Parameter.
Der technische Bericht weist darauf hin, dass MoonViT-V2 von Grund auf mit dem nächsten Token-Vorhersageziel des Modells trainiert wurde und nicht von einem kontrastiv vorab trainierten visuellen Modell wie SigLIP initialisiert wurde.
Moonshot berichtet, dass dieser Ansatz während des Trainings stabil blieb und eine wettbewerbsfähige visuelle Leistung erreichte.

Die vom Modell unterstützte Kontextlänge beträgt:
1.048.576 Token
Diese Größenordnung ist besonders wichtig für Agenten-Systeme, da eine langlebige Kodierungs- oder Forschungsaufgabe Repository-Inhalte, Tool-Ausgaben, Logs, Screenshots, Forschungsmaterialien, Zwischenpläne, Testfehlschläge, vorherige Reasoning-Ergebnisse und mehrfache Korrekturschritte ansammeln kann.
Ein Kontext von einer Million Token hebt die Notwendigkeit des Kontextmanagements nicht auf, ermöglicht es K3 jedoch, einen wesentlich größeren Arbeitsverlauf als herkömmliche Kurzkontext-Systeme zu speichern.
Der technische Bericht führt die Größe und Stabilität von K3 auf mehrere architektonische Änderungen zurück.
Die drei auffälligsten sind:
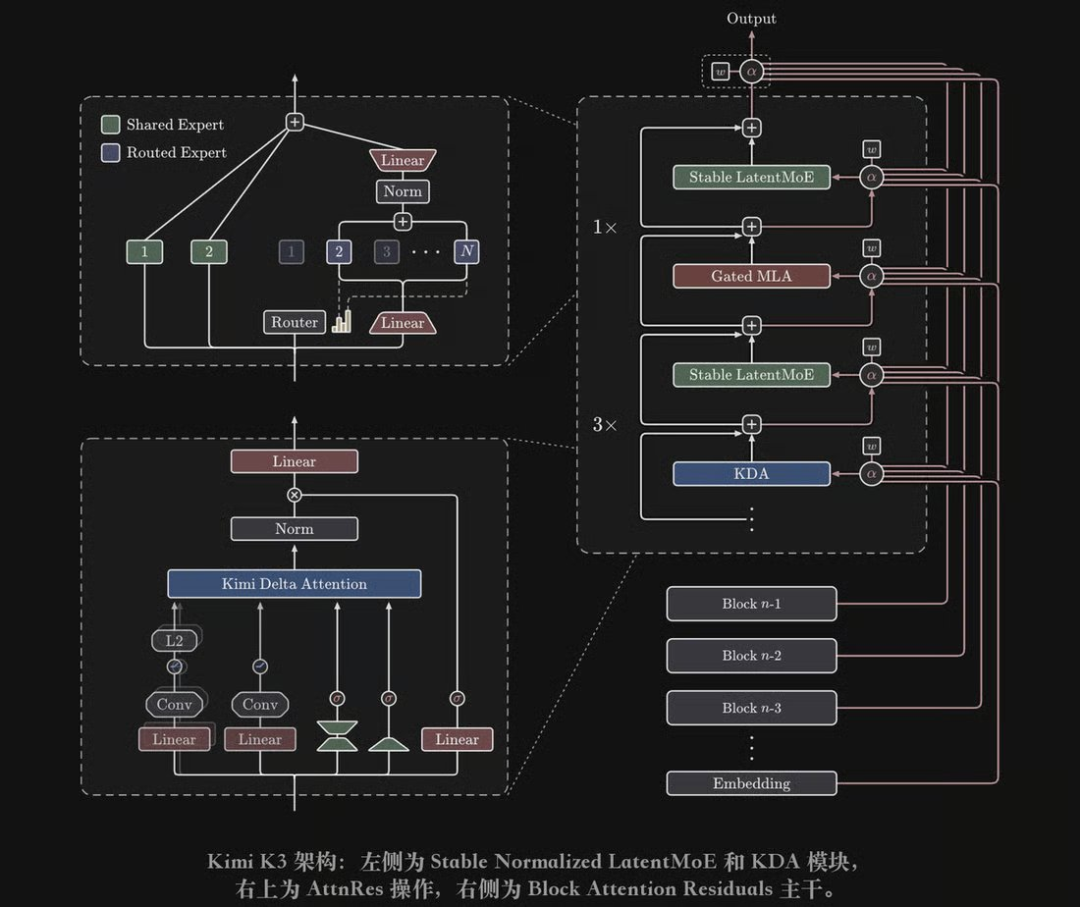
Kimi K3 verwendet ein hybrides Aufmerksamkeitsdesign.
Die offizielle Modellkarte listet auf:
69 Schichten KDA + 24 Schichten Gated-MLA
Diese Architektur folgt einem sich wiederholenden Muster, bei dem mehrere Kimi-Delta-Aufmerksamkeitsschichten mit periodischen Gated-Multi-Head-Latent-Aufmerksamkeitsschichten kombiniert werden.
KDA ist eine lineare Aufmerksamkeitsmechanik, die darauf abzielt, den Speicher- und Rechenaufwand im Zusammenhang mit extrem langen Kontexten zu reduzieren.
Anstatt einen traditionellen KV-Cache zu verwenden, der mit jedem Token wächst, pflegt KDA einen rekurrenten Zustand.
Dies macht es für Sequenzen mit einer Million Token attraktiv.
Moonshot hat KDA zuvor durch die Kimi-Linear-Research-Reihe eingeführt, und das Team berichtet, dass KDA unter seinen Bewertungsbedingungen den KV-Cache-Bedarf reduziert und den Long-Context-Decoding-Durchsatz im Vergleich zur Full-Attention erhöht.
K3 ersetzt die globale Aufmerksamkeit nicht vollständig.
Periodische Gated-MLA-Schichten bewahren die Fähigkeit des Modells, Informationen im gesamten Kontext global abzurufen.
Daher versucht dieses hybride Design, zwei Ziele auszugleichen:
Die Idee ist nicht, dass lineare Aufmerksamkeit der globalen immer überlegen ist, sondern dass jeder Mechanismus verschiedene Teile des Langkontext-Problems behandelt.
Tiefe neuronale Netze müssen Informationen über mehrere Ebenen hinweg leiten und gleichzeitig vermeiden, dass nützliche Darstellungen allmählich verloren gehen.
Kimi K3 führt Attention Residuals (AttnRes) ein, um die Art und Weise zu ändern, wie Informationen in der Tiefe fließen.
Anstatt sich auf einen einheitlichen sequentiellen Residuenfluss zu verlassen, erlaubt dieser Mechanismus nachfolgenden Modulen, von vorherigen Modulen erzeugte Darstellungen selektiv abzurufen.
Konzeptionell gibt dies dem Netzwerk einen Lernmechanismus, mit dem es entscheiden kann,
welche frühen Informationen direkt zugänglich bleiben sollen.
Das Ziel ist es, in einem 93-schichtigen Modell den Informationsfluss zu verbessern, ohne jedes Merkmal strikt durch genau denselben Residuenpfad zu zwingen.
Kimi K3 verbessert die MoE-Sparsity erheblich.
Das Modell enthält:
896 Routing-Experten
Aber pro Token werden nur aktiviert:
16 Routing-Experten
Zusätzlich enthält das Modell zwei gemeinsame Experten.
Dadurch ist die Gesamtparametrizität des Modells sehr groß, aber die aktive Rechenleistung ist weit geringer als die Gesamtparameterzahl.
Bei dieser Sparsity werden Trainingsstabilität und Expertenbalance zu kniffligen Problemen.
Das stabile LatentMoE-Design von Moonshot beinhaltet mehrere Mechanismen zur Lösung dieser Probleme.
Kimi K3 ersetzt SwiGLU durch SiTU-GLU, eine Aktivierungsfunktion, die unbegrenztes Wachstum bei extremer Skalierung vermeiden soll.

Das System verwendet auch eine Methode zum Lastausgleich basierend auf dynamischen Routing-Bias, anstatt sich vollständig auf traditionelle, hilfsweise Balancierungsverlustfunktionen zu verlassen.
Das Ziel ist es, die Verteilung der getrouteten Token über die Experten hinweg gleichmäßiger zu gestalten, ohne zu viele Störungen im Training einzuführen.
Der technische Bericht von Kimi K3 betont insbesondere das Post-Training für langlebige Agenten.
Das Modell wurde in drei Bereichen trainiert:
Es unterstützt auch mehrere Stufen der Reasoning-Genauigkeit:
Das endgültige Modell kombiniert verschiedene spezialisierte Strategien durch Multi-Teacher On-Policy Distillation (MOPD).
Anstatt separate, permanente Modelle für jeden Bereich und jede Genauigkeitsstufe zu trainieren, trainiert Moonshot spezialisierte Lehrermodelle und integriert deren Verhalten in eine einheitliche K3-Strategie.
Im technischen Bericht wird AgentENV beschrieben, eine Infrastrukturschicht, die für die persistente Bereitstellung von Agenten aufgebaut wurde.
Das System basiert auf Firecracker.
Die Mikro-VM-Umgebung ermöglicht es Agenten, in einem reproduzierbaren Sandkasten lange Aktionssequenzen auszuführen.
Eine Trainingsaufgabe kann Folgendes umfassen:
Dies unterscheidet sich vom Reinforcement Learning basierend auf kurzen Frage-Antwort-Runden.
Ein Agent kann Hunderte von Tool-Aufrufen ausführen und über mehrere virtuelle Tage hinweg einen Zustand in der simulierten Umgebung aufrechterhalten.
Die Quelle beschreibt eine simulierte Umgebung, die Anwendungen wie Slack, Notion und Gmail umfasst.
Die Hauptherausforderung des Trainings ist die Persistenz: Sowohl der Umgebungszustand als auch der lange Kontextzustand des Modells müssen verfügbar bleiben.
Während des langen Bereitstellungsprozesses.
Das langzyklische Training erfordert zudem eine große Anzahl schwieriger Aufgaben.
Moonshot beschreibt eine Task-Generierungs-Pipeline, die um einen hierarchischen Wissensgraphen herum organisiert ist.
Dieser Graph umfasst Bereiche wie Informatik, KI, Codierung, Mathematik, Physik, Chemie, Biomedizin und Geisteswissenschaften.
Verwandte Konzepte können gemeinsam abgetastet werden, relevante öffentliche Materialien werden abgerufen, und daraus werden neue Bewertungs- oder Trainingsaufgaben synthetisiert.
Der Zweck des Graphen ist es, Aufgaben zu erstellen, die tatsächliche Tool-Nutzung und mehrschrittiges Denken erfordern, nicht nur das Auswendiglernen von Antworten.
Ein 2,8T-Modell mit einem Millionen-Token-Kontextfenster lässt sich nicht allein durch die Modellarchitektur effizient trainieren und servieren.
Der technische Bericht von Moonshot beschreibt Systemarbeit, die KDA-Kernel, Kontext-Parallelität, Expertenparallelität, Speicherverwaltung, langzyklische RL-Scheduling, Prefix-Caching, spekulative Dekodierung und Service-Zugangskontrolle umfasst.
Ein Teil davon ist bereits öffentlich zugänglich.
MoonEP ist eine von Moonshot Open Source bereitgestellte Kommunikationsbibliothek für Expertenparallelität.
Beim MoE-Training kann das Routing stark unausgeglichen sein.
Weil der Router bestimmte Experten bevorzugt, kann ein Rang viel mehr Tokens erhalten als ein anderer. Wenn dies passiert, muss das schnellste Gerät auf das langsamste warten.
MoonEP verwendet dynamische redundante Experten, um dieses Problem zu lösen.
Es kann temporäre Expertenkopien basierend auf dem aktuellen Routing-Muster erstellen, wodurch die Arbeitslast der Tokens auf den Rängen ausgeglichen wird.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Das Projekt beschreibt sein Ziel, jeden Rang genau auf der erwarteten gerouteten Token-Last zu halten und gleichzeitig den Kommunikationsaufwand zu reduzieren.
Dies ist im Maßstab von K3 entscheidend, da die Verteilung von 896 Experten in einem großen Cluster enorme Synchronisationsprobleme mit sich bringt.
FlashKDA bietet eine auf CUTLASS basierende, leistungsstarke Implementierung des Kimi Delta Attention Kernels.
Das öffentliche Repository listet derzeit die folgenden Anforderungen auf:
SM90 oder neuer
CUDA 12.9 oder neuer
PyTorch 2.4 oder neuer
Das Repository enthält Korrektheitstests und Benchmark-Daten für unterstützte Hardware.
FlashKDA zielt darauf ab, den Aufmerksamkeitsmechanismus zu beschleunigen, der die langen Kontextarchitekturen von K3 praktikabel macht.
Kimi K3 verwendet ab der Phase des supervidierten Feintunings ein quantisierungsbewusstes Training.
Die offizielle Konfiguration listet:
MXFP4-Gewichte
MXFP8-Aktivierungen
Dies unterscheidet sich davon, zuerst ein vollständig hochpräzises Modell zu trainieren und erst nach dem Training zu quantisieren.
Das Modell wird darauf trainiert, diese niedrigeren Präzisionsformate direkt in der Pipeline zu verwenden.
Dies hilft, Speicher- und Kommunikationsaufwand zu reduzieren.
Dies ist jedoch eine Anforderung, aber es macht das 2,8T-Modell nicht zu einem gewöhnlichen Desktop-Modell.
Die Gewichte sind öffentlich, aber "herunterladbar" bedeutet nicht "einfach auf einem Laptop lauffähig".
Kimi K3 hat insgesamt 2,8 Billionen Parameter.
Selbst mit spärlicher Aktivierung und niedrigen Bitformaten erfordert der vollständige Lauf des Modells viel aggregierten Beschleunigerspeicher, Hochbandbreiten-Geräteverbindungen, Expertenparallelausführung, eine kompatible Inferenz-Engine und effiziente Unterstützung für KDA, MLA und MoE.
Das offizielle Repository von Moonshot empfiehlt:
Das Ökosystem entwickelt sich noch schnell weiter. Die Unterstützung kann von spezifischen Schemata, Kernels, Quantisierungsmodi und Hardware abhängen.
Bevor Sie eine selbst gehostete Umgebung aufbauen, überprüfen Sie die neueste Kimi K3-Bereitstellungsdokumentation und gehen Sie nicht davon aus, dass Standard-Transformer-Service-Setups funktionieren.
Für die meisten Einzelpersonen und kleinen Teams ist eine gehostete API wahrscheinlich viel einfacher als das Ausführen des vollständigen Modells.
Moonshot bietet Kimi K3 auch über seine offizielle API-Plattform an:
Der Modellbezeichner ist:
kimi-k3
Kimi K3 verwendet Inferenzfunktionen und gibt das Feld reasoning_content zurück.
Die offizielle Modellkarte beschreibt drei Inferenzaufwandsstufen:
low
high
max
Ein wichtiges Implementierungsdetail ist die beibehaltene Denkhistorie.
Für mehrrundige Agent-Workflows gibt Moonshot an, dass Entwickler die gesamte vorherige Assistentennachricht (einschließlich reasoning_content, content und tool_calls) an die nächste Anfrage zurückgeben sollten.
Das Weglassen eines Teils dieses Zustands könnte die Kontinuität beeinträchtigen, da die Trainingsweise von K3 die Beibehaltung der Denkhistorie erfordert.
Der technische Bericht von Moonshot bewertet Kimi K3 in den Bereichen Denken und Wissen, Codierung, Agent-Workflows und Vision.
Die eigene Evaluierungssuite des Unternehmens stuft K3 als eines der derzeit leistungsfähigsten verfügbaren Modelle ein und positioniert es in bestimmten Aufgaben vor vielen Open-Weight- und proprietären Systemen.
Gleichzeitig stellt der Bericht klar, dass das Modell insgesamt immer noch hinter den leistungsstärksten proprietären Systemen zurückbleibt, insbesondere hinter Claude Fable 5 und GPT-5.6 Sol.
Diese Einschränkung ist wichtig.
Die Behauptung ist nicht, dass K3 alle Benchmarks gewinnt.
Die plausiblere Schlussfolgerung ist, dass Kimi K3 Open-Weights in eine Leistungsdomäne gebracht hat, die bis vor kurzem hauptsächlich mit führenden proprietären Systemen verbunden war.

Mehrere Benchmark-Vergleiche verwenden auch unterschiedliche Agent-Tools, darunter Kimi Code, Claude Code, Codex und offizielle Benchmark-Tools.
Daher sollten Agent-Benchmark-Scores nicht als reine Darstellung der Modellfähigkeit interpretiert werden.
Messungen. Die umgebenden Tools, Prompts, Kontextverwaltung, Fallback-Mechanismen und Evaluatoren beeinflussen die Ergebnisse erheblich.
Der Bericht enthält mehrere Fallbeispiele, die zeigen sollen, dass K3 für komplexe Ingenieursarbeiten weit über kurze Code-Vervollständigungen hinaus geeignet ist.
Diese Beispiele stammen von den Modellentwicklern und sollten als Fallpräsentationen und nicht als allgemeine Leistungsgarantie betrachtet werden.
Moonshot berichtet, dass Kimi K3 MiniTriton entwickelt hat, ein kompaktes, Triton-ähnliches GPU-Programmiersystem.
Das Projekt umfasst eine Zwischendarstellung, Compiler-Workflows, PTX-Generierung, Frontend-Sprachen, Laufzeitkomponenten, GPU-Kernel-Optimierungen sowie verteilte Trainingsprimitive.
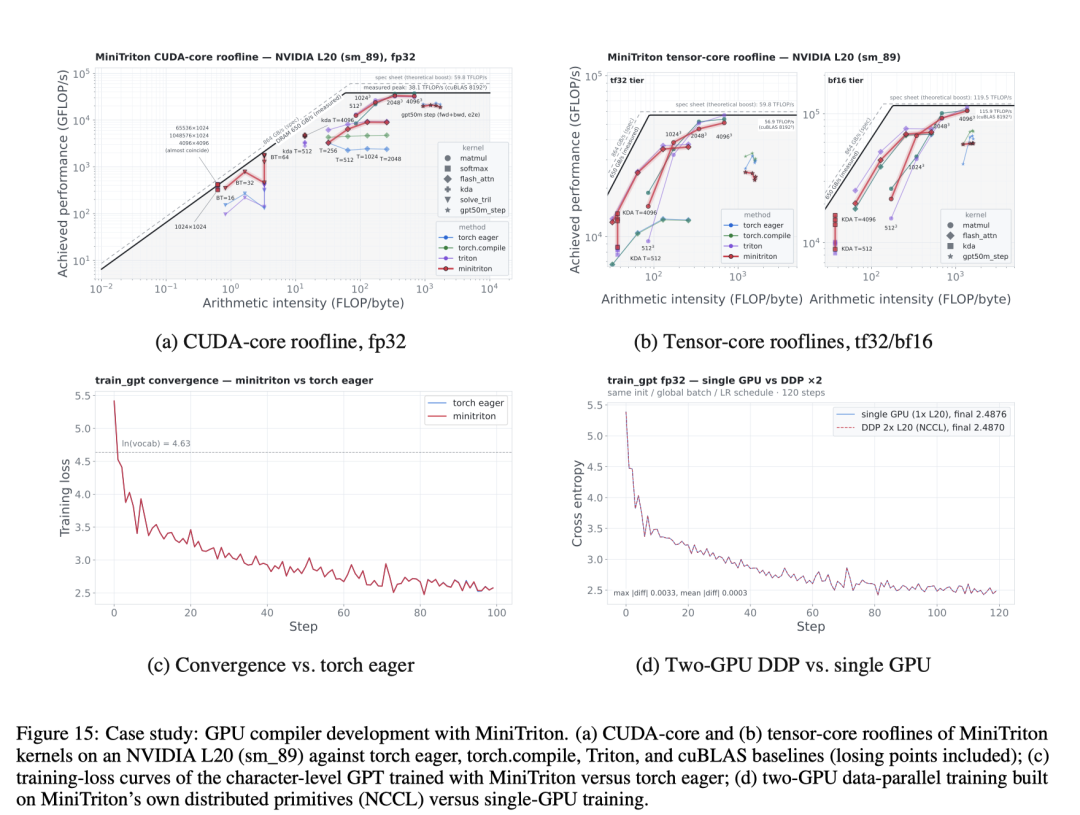
Moonshot gibt an, dass K3 auch komplexe Kernel optimiert hat, die mit seiner eigenen Architektur zusammenhängen, und bei ausgewählten Kernen deutliche Beschleunigungen erzielt hat.
Dies zeigt das erwartete Verhalten des Modells: Überprüfung komplexer Codebasen, Durchführung von Leistungsanalysen, Schreiben von Low-Level-Code, Benchmarking der Ergebnisse und iterative Verbesserung.
Das bedeutet jedoch nicht, dass die von jedem Modell generierten Compiler oder Kernel ohne menschliche Überprüfung und Tests vollständig vertrauenswürdig sind.
In einer weiteren Fallstudie wurde Kimi K3 für 48 Stunden in einer Sandbox-Umgebung ausgeführt und beauftragt, einen Inferenz-Chip-Prototypen für ein kleines Modell zu erstellen, dessen Designkonzept Ähnlichkeiten mit der oben genannten Architektur aufweist.
Das Modell verwendete Open-Source-Tools für das elektronische Design (EDA) sowie die Nangate-45-Nanometer-Standardzellenbibliothek.
Laut Moonshot wurde das endgültige Design im Rahmen eines analysierten Flächenbudgets von 4 Quadratmillimetern abgeschlossen, erreichte Timing-Closure bei einer Taktfrequenz von 100 MHz, umfasste etwa 1,46 Millionen Standardzellen, verwendete 0,277 MiB SRAM und erzielte einen Decodierungsdurchsatz von über 8.700 Tokens pro Sekunde in der RTL-Simulation.
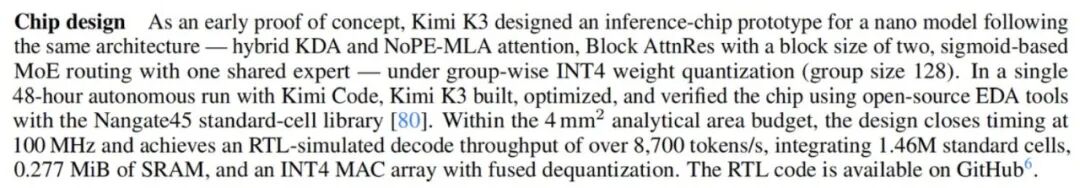
Dies ist ein simulationsbasierter Proof-of-Concept und kein Chip für die Serienproduktion.
K3 wurde auch in einer Replikationsaufgabe aus der computergestützten Astrophysik evaluiert.
Moonshot gab an, dass das Modell über 20 wissenschaftliche Arbeiten las und kreuzvalidierte, eine vollständige numerische Pipeline implementierte, mehr als 300 Zustandsgleichungen bewertete, Inkonsistenzen in veröffentlichten Formeln identifizierte, über 3.000 Zeilen Python-Code schrieb und ein interaktives HTML-Dashboard generierte.
![Das Bild zeigt die Errungenschaften von Kimi K3 im wissenschaftlichen Programmieren. Zur Replikation der I-Love-Q-Universalrelation in der computergestützten Astrophysik überprüfte Kimi K3 über 20 wissenschaftliche Arbeiten, kreuzvalidierte Ergebnisse, implementierte eine vollständige numerische Pipeline, bewertete über 300 Zustandsgleichungen, entdeckte Inkonsistenzen in öffentlichen Formeln, schrieb über 3.000 Zeilen Python-Code und generierte in etwa zwei Stunden ein interaktives HTML-Dashboard, wofür erfahrene Forscher normalerweise 1–2 Wochen benötigen. Das Bild zeigt im Kontext die spezifischen Ergebnisse von Kimi K3 bei dieser wissenschaftlichen Programmieraufgabe.]
Berichten zufolge dauerte diese autonome Arbeit etwa zwei Stunden, während erfahrene Forscher normalerweise ein bis zwei Wochen benötigen.
Für wissenschaftliche Arbeiten bleibt die unabhängige Validierung entscheidend. Das Modell kann einen vollständigen Workflow generieren, kann aber dennoch subtile Fehler bei Annahmen, Einheiten, numerischen Methoden, Zitaten oder Interpretationen machen.
Der technische Bericht behandelt auch Bewertungen im Bereich Cybersicherheit.
Moonshot gab an, dass Kimi K3 in kontrollierten Sicherheitstests zuvor unbekannte Schwachstellen im Linux-Kernel entdeckt hat, die von menschlichen Experten überprüft wurden.
Die Bedeutung liegt nicht darin, dass K3 für unbeaufsichtigte offensive Sicherheitsoperationen eingesetzt werden sollte.
Vielmehr zeigt es, dass langzyklische Codierungsmodelle zunehmend in der Lage sind, große Codebasen zu lesen, Low-Level-Verhalten zu verfolgen, Hypothesen zu bilden, zu validieren und Methoden zu korrigieren sowie nach gescheiterten Versuchen fortzufahren.
Diese Fähigkeiten können defensive Audits und sichere Code-Reviews unterstützen, machen aber auch Autorisierung, Sandboxing, Zugriffskontrollen und menschliche Aufsicht noch wichtiger.
Der Wert eines Modells wird nicht allein durch Benchmark-Ergebnisse bestimmt.
Langzyklische Agentensysteme können bei einer einzigen Aufgabe Millionen von Tokens generieren.
Daher hängen die Kosten von der Eingabelänge, Ausgabelänge, Inferenzkomplexität, Cache-Trefferquote, Anzahl der Tool-Aufrufe, Wiederholungen, Kontextverwaltung und dem Inferenzanbieter ab.
Der technische Bericht von Moonshot enthält Kosten- und Leistungsvergleiche für mehrere Agenten-Benchmarks.
Diese Diagramme zeigen, dass K3 bei einigen Test-Workloads relativ kosteneffizient ist.
Dies sollte nicht als allgemeingültige Schlussfolgerung interpretiert werden, dass K3 in jeder Situation günstiger ist als alle Alternativen.
Bei der Produktionsplanung sollten die Gesamtkosten für den erfolgreichen Abschluss einer Aufgabe gemessen werden, nicht nur der Preis pro Million Tokens.
Die Veröffentlichung von Kimi K3 geht über das Ranking eines einzelnen Modells hinaus.
Es eröffnet mehrere Forschungs- und Ingenieurbereiche, die in rein API-basierten Systemen schwer zu untersuchen sind.
Forscher können Modellgewichte, MoE-Verhalten, KDA-basierte Aufmerksamkeitsmechanismen, Langkontextmechanismen, visuelle Komponenten, Quantisierungsverhalten, Servicesysteme und Post-Training-Strategien für Agenten überprüfen oder modifizieren.
Infrastrukturteams können verschiedene Servicelösungen testen.
Unternehmen können private Bereitstellungen bewerten, wenn die Hardwarewirtschaftlichkeit gegeben ist.
Die Community kann Folgendes aufbauen:
Neue Inferenzschemata.
Quantisierte Varianten.
Feinabgestimmte Derivate.
Domänenspezifische Systeme.
Evaluierungsframeworks
Modell-Routing-Tools
Hardwarespezifische Optimierungen
Ob daraus ein Ökosystem entstehen kann, das mit frühen wichtigen Open-Source-Modellveröffentlichungen vergleichbar ist, hängt von den Inferenzkosten, der verfügbaren Hardware, den Lizenzbedingungen, den Community-Toolchains und der Qualität der abgeleiteten kleineren Modelle ab.
Stellen Sie sicher, dass Ihr Anwendungsfall zu den folgenden Kategorien gehört: interne Forschung, Unternehmensnutzung, Feinabstimmung, eingebettete Anwendungen, öffentliche Inferenz oder Modell-as-a-Service.
Prüfen Sie die Beschleunigerarchitektur, HBM-Kapazität, Verbindungsart, CUDA-Version, Kernel-Anforderungen, Quantisierungsunterstützung, Anzahl der Geräte und Expert-Parallel-Topologie.
Verwenden Sie die aktuellen K3-spezifischen Lösungen für vLLM, SGLang oder andere offiziell unterstützte Service-Pfade.
Messen Sie Prefill-Latenz, Decodierungs-Latenz, Prefix-Cache-Verhalten, Speichernutzung, Parallelfähigkeit, Durchsatz und Fehlerbehebung.
Befolgen Sie bei Agenten-Mehrrunden-Workflows die Richtlinien von Moonshot zur Rückgabe vollständiger Assistentennachrichten (einschließlich Inferenz- und Tool-Aufrufstatus).
Führen Sie Benchmarks mit Ihren eigenen Repositorys, Forschungs-Workflows, Dokumenten, visuellen Aufgaben, Tool-Nutzung und Agentenszenarien durch.
Die alleinige Betrachtung des Token-Preises kann irreführend sein. Berechnen Sie die Kosten für Wiederholungen, Tool-Aufrufe, Ausgabelänge und manuelle Eingriffe.
Die vollständigen Gewichte, das Code-Repository, die Dokumentation und der technische Bericht von Kimi K3 sind öffentlich zugänglich. MoonShot beschreibt es als ein Modell mit offenen Gewichten. Das Modell verwendet eine benutzerdefinierte Kimi K3-Lizenz und nicht Apache 2.0.
Standardprotokolle, gewerbliche Nutzer müssen die spezifischen Bestimmungen sorgfältig prüfen.
Die offiziellen Gewichte sind auf Moonshot AI auf Hugging Face erhältlich. Das Hauptquellcode-Repository und der technische Bericht sind auf GitHub einsehbar.
Die Gesamtparameteranzahl von Kimi K3 beträgt etwa 2,8 Billionen. Aufgrund der spärlichen Experten-Mischarchitektur (Mixture of Experts) werden pro Token etwa 104 Milliarden Parameter aktiviert.
Das offizielle Modell unterstützt einen Kontext von bis zu 1.048.576 Token. Der Einsatz mit langen Kontexten erfordert weiterhin viel Speicher und Inferenzinfrastruktur, insbesondere in parallelen Szenarien.
Das vollständige 2,8-T-Modell kann tatsächlich nicht auf normalen handelsüblichen GPUs ausgeführt werden. Selbst bei spärlicher Aktivierung und niedriger Bitquantisierung erfordern die vollständigen Gewichte und der Service-Stack eine große Multi-Beschleuniger-Infrastruktur.
Das offizielle Moonshot-Repository empfiehlt die Verwendung von vLLM, SGLang und TokenSpeed über den speziellen K3-Bereitstellungsleitfaden. Da das Modell KDA-, MLA-, MoE- und MXFP4-bezogene Optimierungen verwendet, muss vor der Bereitstellung die aktuell unterstützte Version überprüft werden.
MoonEP ist eine von Moonshot als Open Source bereitgestellte Experten-Parallelkommunikationsbibliothek, die zur Lastverteilung von MoE-Token über GPUs verwendet wird. FlashKDA ist ein auf CUTLASS basierender leistungsstarker Kimi Delta Attention-Kernel.
Nicht in jeder Hinsicht. Der technische Bericht von Moonshot weist darauf hin, dass Kimi K3 ein Spitzenniveau erreicht hat und bei bestimmten Aufgaben führend ist, insgesamt aber immer noch hinter den stärksten proprietären Systemen zurückbleibt. Die Benchmark-Ergebnisse hängen auch vom Agenten-Framework, den Werkzeugen, den Inferenz-Einstellungen und den Bewertungsmethoden ab.
kimi-k3-Modell.Moonshot AI hat nun die vollständigen Kimi K3-Gewichte veröffentlicht und damit das 2,8-T-Parameter-Spitzenmodell in ein System verwandelt, das Forscher und Infrastrukturteams unter der Kimi K3-Lizenz überprüfen, bereitstellen, verfeinern und erweitern können.
Das Modell kombiniert 104B aktivierte Parameter, ein 1M-Token-Kontextfenster, native Multimodalität, hybride KDA/Gated-MLA-Aufmerksamkeit, Aufmerksamkeitsresiduen, stabile latente MoE, quantisierungsbewusstes Training und Post-Training mit langer Horizont-Agenten.
Ebenso wichtig ist, dass diese Veröffentlichung durch Projekte wie MoonEP und FlashKDA einen Teil der Systemtechnik hinter dem Modell offenlegt. K3 bleibt ein Modell mit hohen Selbsthosting-Anforderungen, und seine besten Ergebnisse sollten im Kontext von Framework-Auswahl und Entwicklerdurchführung interpretiert werden.
Evaluierung.
Der wahre Meilenstein ist nicht allein die Existenz eines Modells in der Größenordnung von 2,8T – sondern dass ein Modell dieser Größenordnung nun einer breiteren Gemeinschaft zur Überprüfung, zum Betrieb und zur Nutzung als Grundlage zur Verfügung steht.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



