For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/matrix-game-4-0-rtx-5090-neural-rendering-59d3cc6b.md.
Matrix-Game 4.0 von Skywork AI trennt zwei Aufgaben, die in einem KI-generierten Spiel leicht ineinander übergehen können. Eine ausführbare ...
Matrix-Game 4.0 von Skywork AI trennt zwei Aufgaben, die in einem KI-generierten Spiel leicht ineinander übergehen können. Eine ausführbare Engine verwaltet Regeln und physikalischen Zustand; ein kausales Videomodell verwandelt die Low-Poly-Bilder der Engine in detailliertere Frames.
Diese Trennung ist die zentrale Idee des Projekts. Wenn eine Figur einen Schild aufnimmt, Schaden erleidet oder eine Mission abschließt, entscheidet die Engine, was passiert ist. Der neuronale Renderer ist dafür verantwortlich, wie es aussieht, statt die generierten Pixel zur endgültigen Instanz für Punktestand oder Gesundheit der Spielfigur zu machen.
Die Veröffentlichung umfasst außerdem einen Inferenzpfad für eine einzelne RTX 5090 GPU. Die entscheidenden Fragen sind, was die Demonstrationen tatsächlich messen, welche Fähigkeiten im veröffentlichten Code vorhanden sind und wie spezialisiert die herunterladbaren Modelle bleiben.
Ein Videomodell kann überzeugende Bewegungen erzeugen, ohne eine verlässliche Repräsentation jeder Spielregel bereitzustellen. Ein visuell plausibler Frame legt nicht zwangsläufig fest, wo sich ein Gegner befindet, wem ein Gegenstand gehört oder ob eine Kollision das Spiel beenden sollte.
Matrix-Game 4.0 hält diese Fakten im Code fest. Die Engine verarbeitet Eingaben, entwickelt die Spielwelt weiter und erzeugt eine vergleichsweise kostengünstige Low-Poly-RGB-Ansicht. Anschließend generiert das Videomodell aus dieser strukturierten Eingabe die endgültige visuelle Darstellung.
Das offizielle Repository bezeichnet dies als engine-gestütztes Gameplay und Streaming Neural Rendering. Es handelt sich um ein Hybridsystem und nicht um die Behauptung, das Modell habe sämtliche Aspekte einer allgemeinen Spiele-Engine intern erlernt und führe sie zuverlässig aus.
Ein visueller Fehler verändert daher nicht unmittelbar die zugrunde liegende Kollision oder den Gameplay-Zustand. Er kann Spielende dennoch verwirren. Diese Architektur trennt somit zwei Fehlermodi, anstatt alle Fehler zu beseitigen.
Die Projektseite zeigt einen Rahmen, der einen Coding-Agenten und eine Spiele-Engine kombiniert. Nutzeranweisungen können in neue Regeln oder Prompts überführt werden, während die Engine den Zustand liefert, der nötig ist, um die Welt konsistent zu halten.
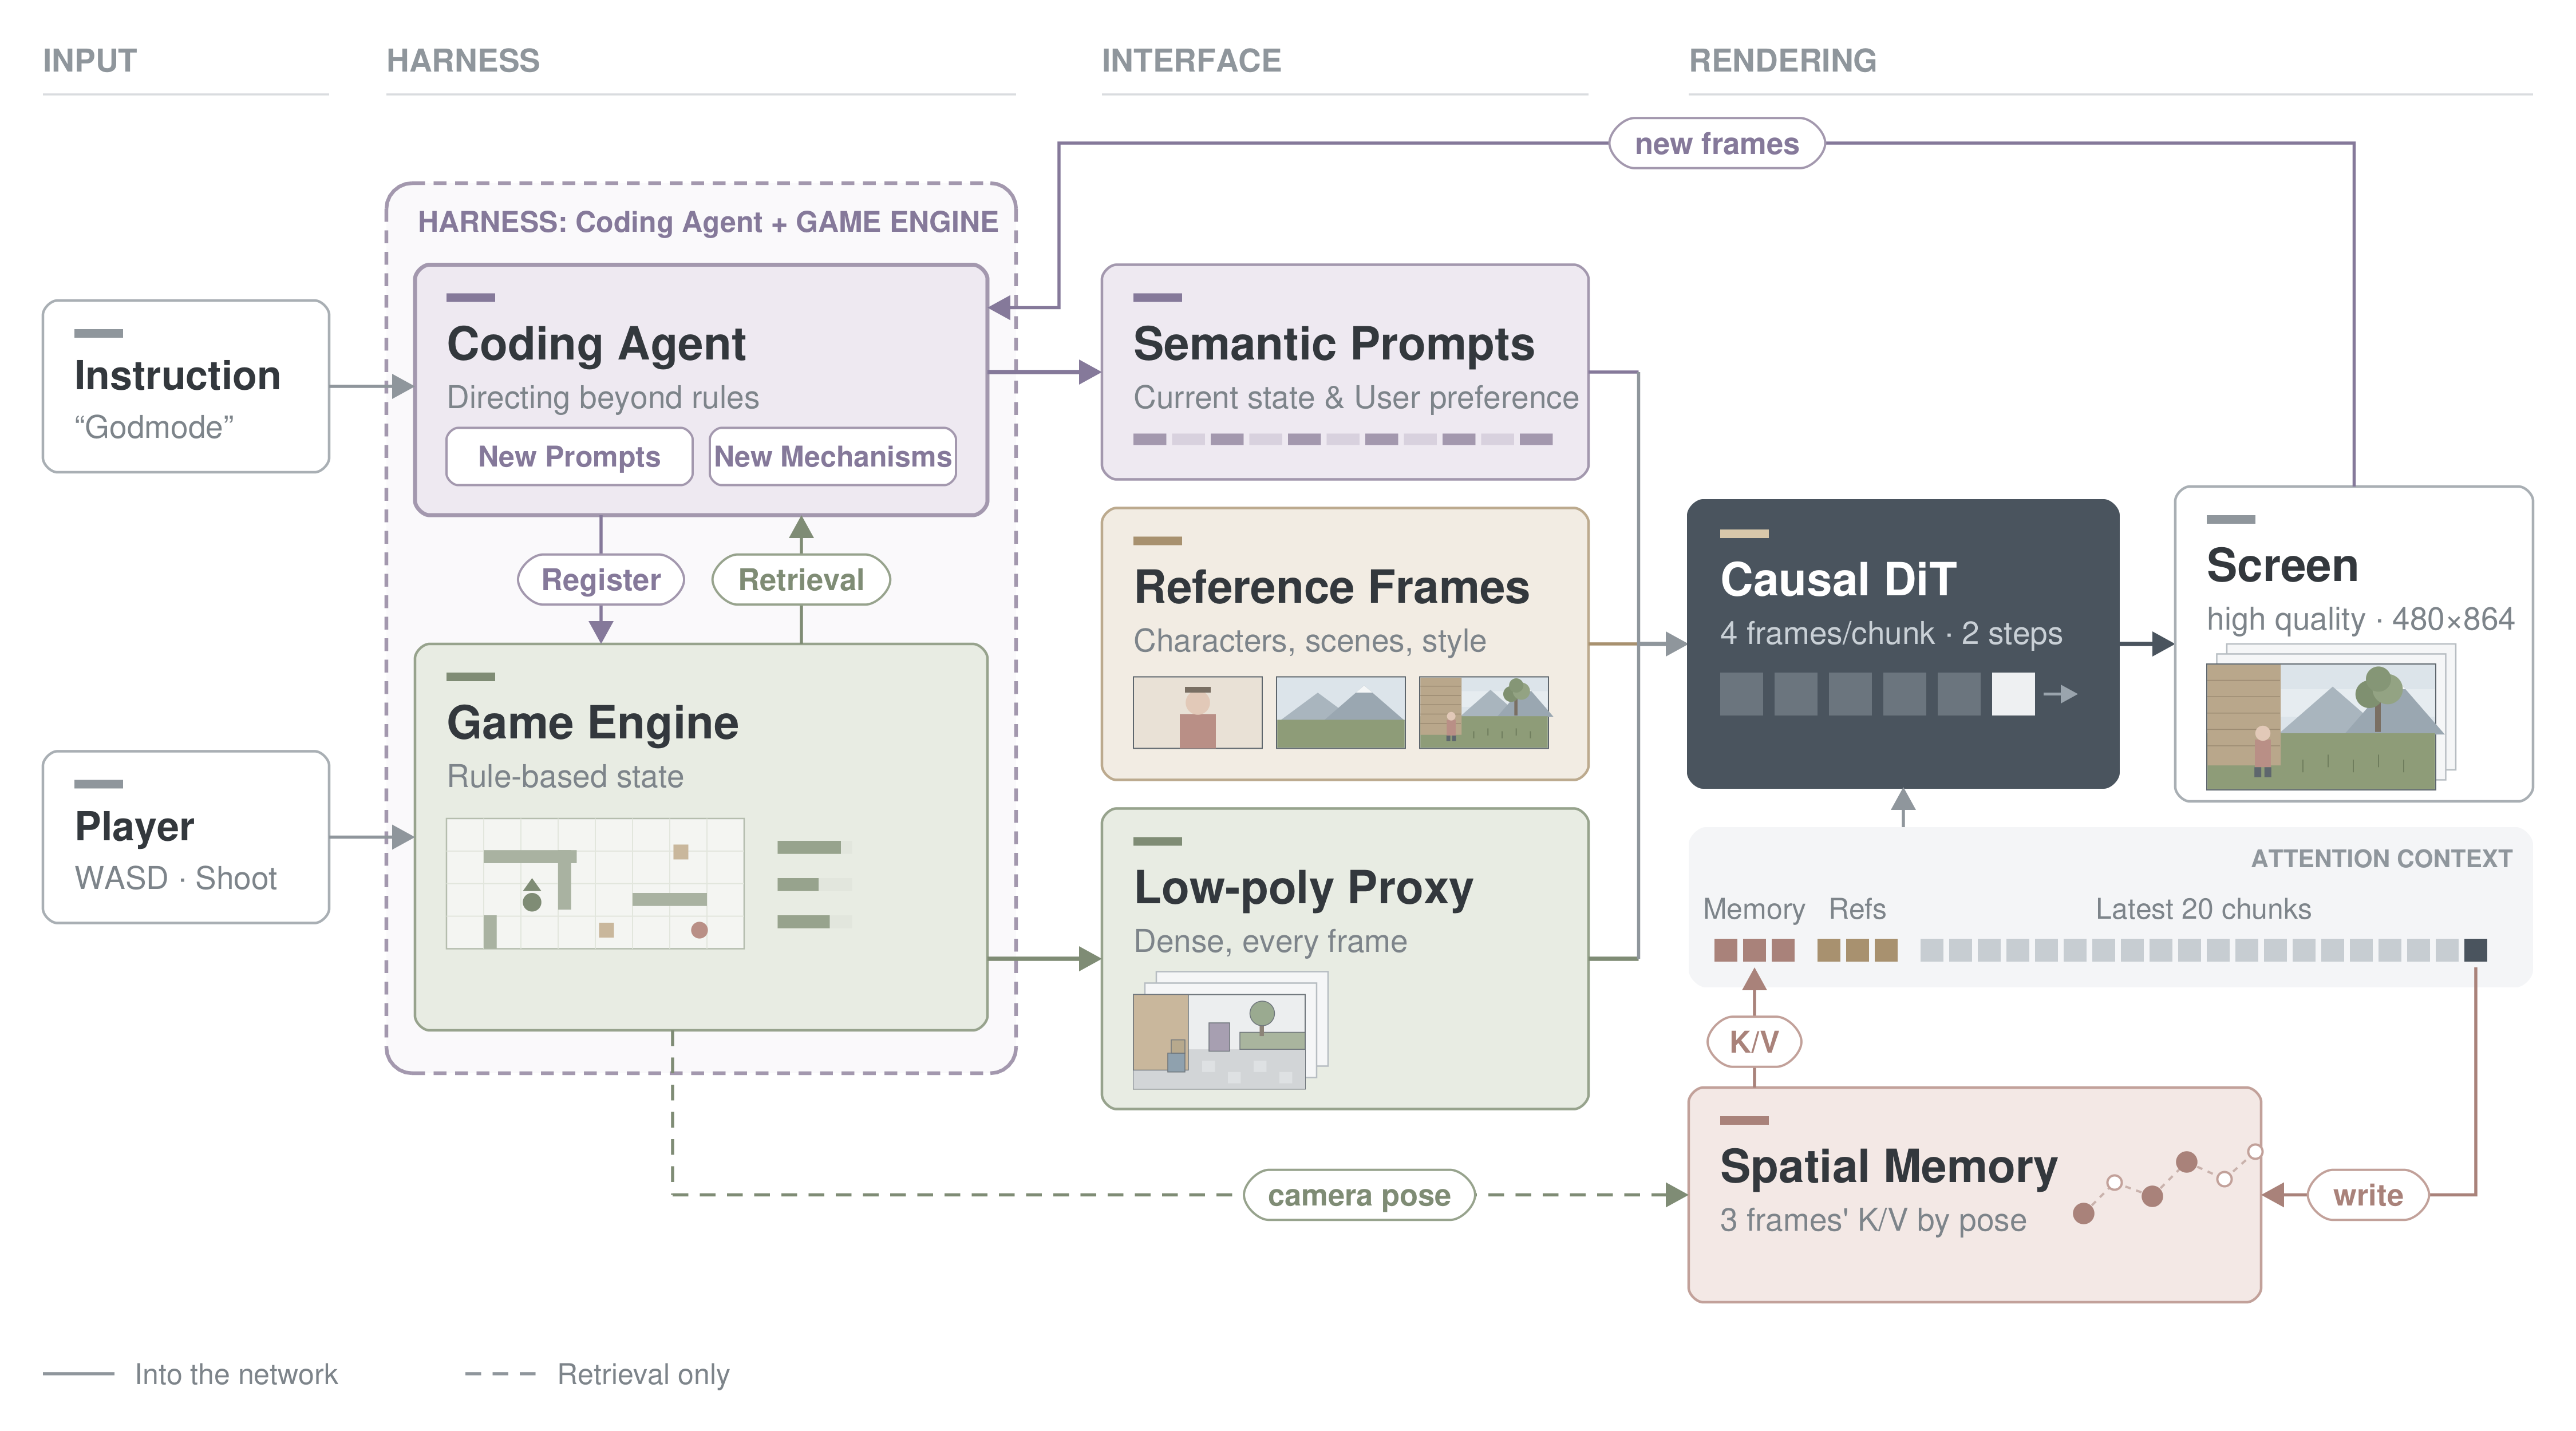
Quelle: Matrix-Game-4.0-Projektseite, Skywork AI. Diese konzeptionelle Abbildung umfasst den Abruf räumlicher Erinnerungen; die veröffentlichte Shooter-Laufzeitumgebung weist ein engeres Verhalten auf, das nachfolgend beschrieben wird.
Auf hoher Ebene sieht der Ablauf so aus:
Die Beispiele von QbitAI umfassen eine Schildhaltbarkeit, die vor Gesundheitsverlust berücksichtigt wird, sowie eine Rennaufgabe, die von einem Zeitfahren in eine Verfolgung geändert wurde. Sie verdeutlichen den Vorteil expliziter Regeln: Gameplay zu verändern bedeutet, den Code zu ändern und zu testen, nicht lediglich das Videomodell zu bitten, ein anderes Ergebnis darzustellen.
Die Hugging-Face-Modellkarte beschreibt drei szenenspezialisierte Renderer: Medieval Castle, Ancient Egypt und City Racing. Jeder Checkpoint umfasst etwa fünf Milliarden BF16-Parameter und erfordert den Inferenzquellcode von Matrix-Game 4.0.
Diese Gewichte sind keine direkt einsetzbaren Diffusers-Pipelines. Die Veröffentlichung stellt Inferenzcode, eine Browser-Demonstration, nativen Spielquellcode, Modelle und Spiel-Assets bereit, während die Modellkarte ausdrücklich darauf hinweist, dass Trainingscode und Trainingsdaten nicht enthalten sind.
Die Ausgabe beträgt 480 mal 864 RGB. Nach dem Start entspricht ein latentes Segment vier RGB-Frames; das Startsegment enthält einen Frame. Die bereitgestellten gemeinsamen Ressourcen und szenenspezifischen Richtlinien sind relevant, sodass beliebige Codecs oder die Referenzkonfiguration einer anderen Szene keine gleichwertigen Ersatzlösungen darstellen.
HUD-Elemente und Audio bleiben getrennte, framegenau ausgerichtete Präsentationsebenen. Das Modell erzeugt nicht automatisch all diese Komponenten, nur weil sie in einer fertigen Demonstration zusammen erscheinen.
Die Projektabbildung enthält einen räumlichen Speicher, der über Kamerapose und dynamische semantische Beschreibungen abgerufen wird. Der aktuelle Laufzeitvertrag ist konkreter: Die veröffentlichte Shooter-Konfiguration verwendet einen festen Szenen-Prompt und einen begrenzten Cache und führt ausdrücklich auf, dass in dieser Konfiguration kein abgerufener Speicher und keine dynamische Prompt-Generierung eingesetzt werden.
Racing unterstützt feste oder segmentausgerichtete dynamische Bildbeschreibungen, die von der Engine bereitgestellt werden. Die dynamische Konditionierung behält den Text-Encoder bei und aktualisiert textbezogene Cache-Einträge, wenn sich die Bildbeschreibung ändert, was die Verarbeitungsgeschwindigkeit beeinträchtigt.
Diese Unterscheidung verhindert, dass aus einem attraktiven Forschungsdiagramm eine unzutreffende Funktionsliste für die herunterladbare Demo wird. Prüfen Sie Szene und verwendetes Preset, bevor Sie annehmen, dass ein dargestellter Mechanismus in diesem Pfad ausgeführt wird.
Der Quellbericht fasst die technische Umsetzung als Verringerung dessen zusammen, was das Modell ableiten, speichern und berechnen muss. Die offiziellen Materialien stützen die wichtigsten Mechanismen: Low-Poly-Visual-Konditionierung, Referenzinformationen, einen begrenzten Cache für die jüngste Historie und kausale Generierung mit wenigen Schritten.
Statt eine Szene allein aus Text zu synthetisieren, erhält das Modell eine von der Engine gerenderte Struktur. Objekte und Kamerabewegungen werden somit als visuelle Einschränkungen bereitgestellt. Die Textkonditionierung ergänzt die Semantik der Szene, wobei der veröffentlichte Modus je nach Szene variiert.
Für die Inferenz verwendet der Echtzeitpfad den TAEHV-Codec, einen Denoising-Schritt, optimierte DiT-Ausführung und CUDA Graphs. Das Qualitäts-Preset verwendet Wan-Encoding und -Decoding, zwei Denoising-Schritte und natives DiT. Die Dokumentation warnt, dass diese Modi unterschiedliche Qualitäts- und Rechenkosten aufweisen.
Auf der RTX 5090 wandeln die dedizierten Presets die linearen Gewichte der DiT-Blöcke beim Laden in FP8 um und quantisieren Aktivierungen während der Inferenz. Embeddings und der Ausgabekopf bleiben BF16. Einfaches rtx5090 verwendet PyTorch SDPA; rtx5090-sage erfordert zusätzlich einen gepatchten SageAttention-Build.
Die Projektseite zeigt eine Ein-Schritt-Demonstration auf einer RTX 5090 mit den folgenden Werten. Sie beschreiben die gezeigte Konfiguration und sind keine Framerate-Garantie für jede Szene oder jeden Computer.
| Angabe auf der Projektseite | Was sie misst oder beschreibt |
|---|---|
| 83 FPS | Ein-Schritt-Denoising-Demonstration auf RTX 5090. |
| 48 ms | Denoising eines Segments, das nach dem Start vier RGB-Frames entspricht. |
| 112 ms | Tastendruck bis zum ersten reagierenden Frame in der berichteten Demonstration. |
| 480p | Kategorie der Streaming-Ausgabeauflösung. |
| Eine GPU | Permanenter Text-Encoder, DiT und VAE im gezeigten Setup. |
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
QbitAI berichtet zusätzlich über etwa 57 FPS mit Zwei-Schritt-Denoising, ungefähr 18,5 GiB maximalen GPU-Speicher und Gameplay, das mit 60 FPS präsentiert wird. Dies sind quellenberichtete Werte; sie sollten nicht so kombiniert werden, als erreiche jeder Modus sie alle gleichzeitig.
Die Browser-Beispiele im aktuellen README verwenden --fps 40, bezeichnen dies jedoch ausdrücklich als Ziel-Taktung für die Spielaufzeichnung und nicht als gemessene Garantie für Rendering-Durchsatz oder Latenz. Start und Aufwärmphase unterscheiden sich außerdem von der Inferenz im stabilen Betrieb.
Videocodierung, Pufferung, Übertragung und Browser-Decodierung verursachen zusätzlichen Aufwand über die Denoising-Zeit des Modells hinaus. Deshalb sind eine Inferenzangabe pro Segment, der Durchsatz der Server-Pipeline und die Latenz von Aktion bis Photon unterschiedliche Metriken.
Die Quelle vergleicht das System zudem mit einem anderen NVIDIA-Forschungssetup. Ohne übereinstimmende Hardware, Auflösung, Qualitäts- und Latenzdefinitionen belegen diese Zahlen keine faire, allgemeingültige Rangfolge.
Das v4 README dokumentiert Linux mit einer NVIDIA-GPU und Python 3.12 für die Inferenz sowie die passende PyTorch-, CUDA- und Treiberumgebung. Eine Browser-Demo benötigt auf dem Host zusätzlich das native Spiel und Medienabhängigkeiten. Der Browser-Client benötigt keine eigene Inferenz-GPU.
Vor dem ersten Start:
Matrix-Game-4/ und nicht aus dem übergeordneten Verzeichnis.Der Downloader ordnet Hub-Szenenordner den Laufzeitpfaden zu. Ein Ordnername auf Hugging Face reicht daher nicht aus, um das lokale Verzeichnislayout abzuleiten. Die offiziellen Manifeste prüfen Dateigröße und SHA256, bevor eine Ressource installiert wird.
Die Veröffentlichung erwartet nur eine aktive Sitzung und ein Szenenmodell pro Serverprozess. Das README beschreibt sie als vertrauenswürdige Einzelbenutzer-Demo mit Loopback-Standardwerten und nicht als authentifizierten Public-Cloud-Gaming-Dienst. Setzen Sie ihre HTTP-, RTSP- und WebRTC-Dienste nicht direkt dem Internet aus.
Der v4-Quellcode steht unter Apache-2.0. Die Modellkarte kennzeichnet außerdem die Projektszenengewichte, Sink-Bilder und Spiel-Assets als Apache-2.0, während gemeinsame Ressourcen und Drittmaterialien ihre eigenen Bedingungen behalten. TAEHV enthält einen MIT-Hinweis, und Racing-Audio umfasst für einige Assets Namensnennungspflichten.
Das ist umfangreiches herunterladbares Material, jedoch keine vollständige Trainingsveröffentlichung. Beachten Sie die geltenden Lizenzen und Audio-Credits, wenn Sie Arbeiten auf Basis des Projekts weiterverbreiten.
Die Modelle sind auf die bereitgestellten Szenen und Kameraprofile spezialisiert. Die Modellkarte nennt Erscheinungsdrift und Geometriefehler bei unbekannter Geometrie, schnellen Bewegungen, Verdeckungen und langen Sitzungen und vermeidet ausdrücklich Garantien für Framerate, ausreichenden Speicher oder exakte Szenenrekonstruktion.
Matrix-Game 4.0 ist daher eine konkrete Plattform zum Testen engine-gestützten neuronalen Renderings. Es sollte nicht als universeller Spielgenerator, bewiesener Multiplayer-Dienst oder System beschrieben werden, das die Notwendigkeit konventioneller Spieleentwicklung beseitigt.
Die offizielle Veröffentlichung enthält einen optimierten RTX-5090-Inferenzpfad und berichtet über Demonstrationen mit einer einzelnen GPU. Leistung und ausreichender Speicher hängen von der dokumentierten Konfiguration ab, und die Modellkarte garantiert sie nicht für jede Arbeitslast.
Nein. Die ausführbare Spiele-Engine verwaltet Gameplay und physikalischen Zustand. Die neuronale Ausgabe kann visuelle Fehler enthalten, ohne die Kollisions- oder Regelberechnungen der Engine unmittelbar zu verändern.
Die Modellkarte sagt ausdrücklich, dass dies nicht der Fall ist. Sie enthält Szenen-Checkpoints und Assets, die mit dem veröffentlichten Inferenz- und Spielquellcode verwendet werden. Das ist ein anderer Umfang als die Reproduktion des Modelltrainings.
--fps 40 40 angezeigte Frames pro Sekunde?Nein. Das README definiert den Wert als Ziel-Taktung für die Aufzeichnung. Kodierung, Übertragung, Pufferung, Browser-Decodierung und Inferenz können die endgültige Darstellung und Latenz beeinflussen.
Das konzeptionelle Projektdiagramm enthält diesen Mechanismus, aber der aktuelle Laufzeitvertrag besagt, dass die veröffentlichte Shooter-Konfiguration keinen abgerufenen Speicher verwendet. Auch der Modus mit dynamischen Bildbeschreibungen von Racing ist vom Shooter-Pfad mit festem Prompt getrennt.
Die Veröffentlichung dokumentiert eine aktive Sitzung pro Serverprozess und beschreibt eine vertrauenswürdige Einzelbenutzer-Demo. Ihre Dienste sollten nicht direkt dem Internet ausgesetzt werden, als wären Authentifizierung und Schutzmechanismen für öffentliche Dienste bereits vorhanden.
Matrix-Game 4.0 verwendet eine ausführbare Engine zur Verwaltung des Spiels, während ein kausales Videomodell dessen Erscheinungsbild rendert. Die Einzel-GPU-Veröffentlichung bietet mit herunterladbaren Szenen, Inferenzcode und Assets eine praktische Möglichkeit, diese Aufgabentrennung zu untersuchen.
Die Demonstrationen sind vielversprechend, doch die veröffentlichte Konfiguration, die Szenenspezialisierung und die getrennten Leistungsmetriken sind ebenso wichtig wie die FPS-Schlagzeile.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.
