For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/meta-muse-image-video-agentic-generation.md.
Die Veröffentlichung von Meta Muse Image ist bemerkenswert, da sie die Bildgenerierung als agentischen Workflow neu definiert. Das Modell ka...
Nach Muse Spark hat Meta Superintelligence Labs ein neues Paar von Mediengenerierungsmodellen vorgestellt: Muse Image, das jetzt ausgerollt wird, und Muse Video, das sich derzeit in der Vorschauphase befindet.
Muse Image ist Metas Bildgenerierungsmodell, das für die Text-zu-Bild-Erstellung, Bildbearbeitung, Multi-Referenz-Komposition und sozialkontextbezogene Generierung innerhalb von Meta-Produkten entwickelt wurde. Muse Video wurde auf dieselbe breite Mediengenerierungsrichtung trainiert und ist für hochauflösende Videoausgabe, Prompt-Treue, zeitliche Konsistenz und native Audio-Unterstützung ausgelegt.
Laut Metas eigener Ankündigung ist Muse Image über die Meta AI App und die Web-Erfahrung verfügbar, mit Ausrollpfaden über Instagram Stories, WhatsApp und Facebook-Oberflächen. Meta gibt an, dass Muse Video später für Entwickler und Meta AI-Nutzer kommen wird.
Die Veröffentlichung wurde auch mit benchmarkartigen Vergleichen von Arena-Bestenlisten begleitet. Im Quellartikel wird Muse Image nahe der Spitze der Rankings für Text-zu-Bild, Einzelbildbearbeitung und Mehrbildbearbeitung gezeigt. Muse Video wird ebenfalls dargestellt, wie es in das Text-zu-Video-Ranking in der Nähe der führenden Gruppe eintritt.
Der wichtige Punkt ist nicht nur das Ranking. Der interessantere Teil ist das Modelldesign: Meta versucht, die Bildgenerierung mehr wie einen mehrstufigen kreativen Workflow zu gestalten, anstatt wie ein einmaliges Prompt-zu-Bild-Werkzeug.
Ein typisches Bildmodell nimmt oft einen Prompt, komprimiert die Absicht und generiert direkt ein Ergebnis. Muse Image folgt einem anderen Muster. Meta beschreibt es als ein agentisches System, das die Anfrage durchdenken, entscheiden kann, ob zusätzliche Informationen benötigt werden, Werkzeuge nutzen und das Ergebnis vor der Auslieferung verbessern kann.
Wenn ein Prompt beispielsweise aktuelle reale Kontextinformationen erfordert, kann Muse Image die Suche nutzen. Wenn die Szene genaue Handlungen, Formeln, Layouts oder QR
Codes können Codierungswerkzeuge nutzen, um zuverlässigere Zwischenassets zu erstellen.
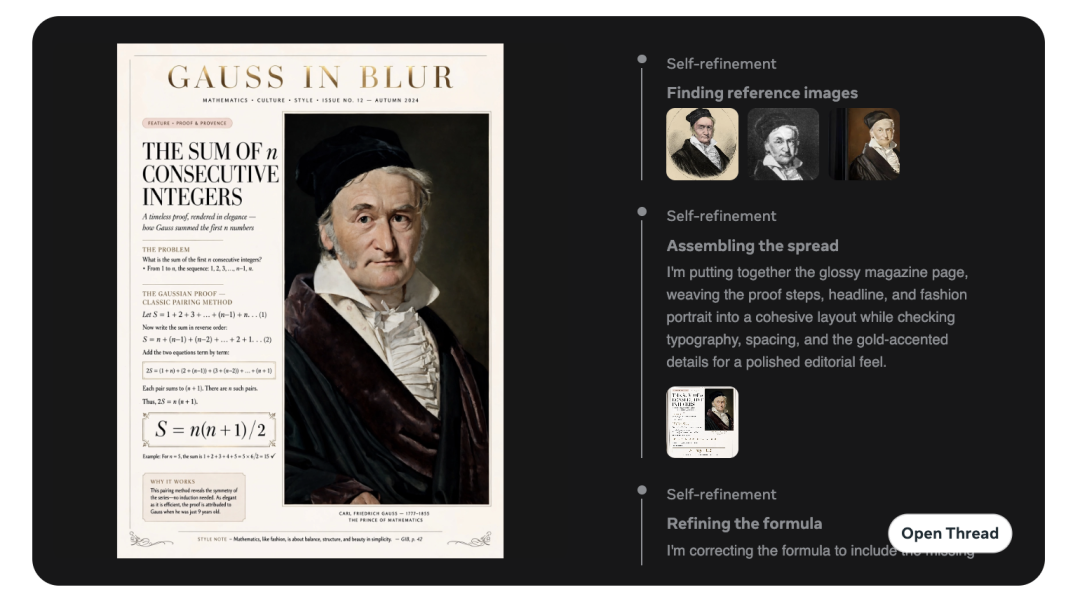
Das ist wichtig, denn viele Fehler bei der Bilderzeugung sind nicht rein ästhetischer Natur. Sie sind oft auf schwache Verankerung zurückzuführen: falsche Fakten, fehlerhafter Text, inkonsistente Platzierung von Objekten, unleserliche Diagramme oder Details, die auf den ersten Blick gut aussehen, aber bei genauerer Betrachtung versagen.
Meta gibt an, dass Muse Image während des Generierungsprozesses Werkzeuge wie Suche und Codeausführung nutzen kann. Die Suche hilft bei Eingabeaufforderungen, die aktuelle Ereignisse, Sehenswürdigkeiten, Marken, Identitäten oder faktische Zusammenhänge betreffen. Codierung hilft, wenn das endgültige Bild mathematisch oder strukturell genauen Inhalt benötigt.
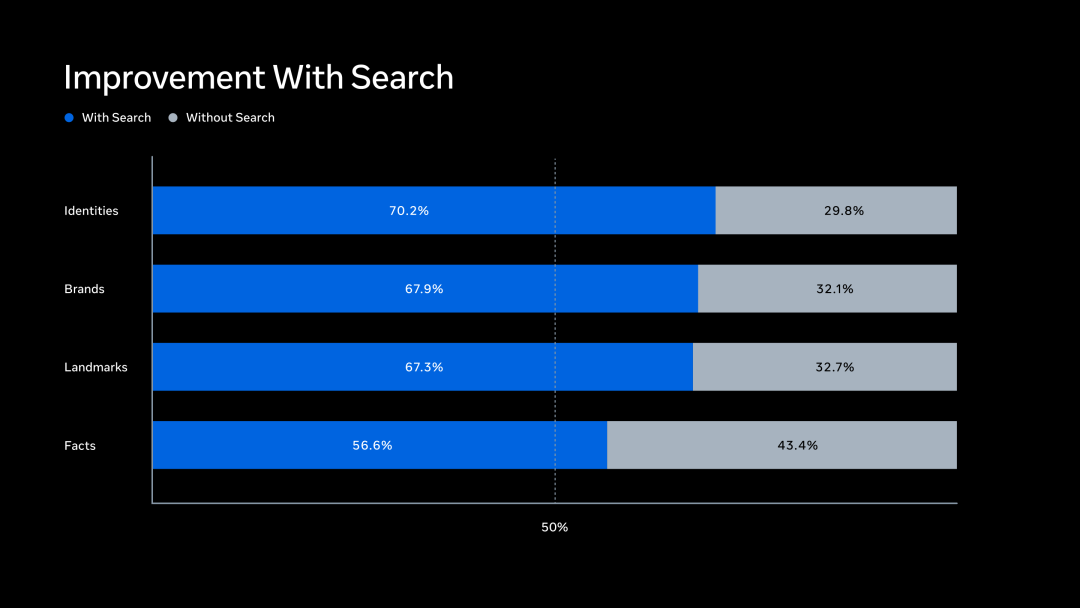
Der Quellartikel bietet eine einfache Möglichkeit, dies zu verstehen: Wenn man das Modell bittet, etwas zu zeichnen, das von der heutigen realen Welt abhängt, sollte es sich nicht nur auf ein eingefrorenes internes Gedächtnis verlassen. Es kann zuerst Referenzen nachschlagen. Wenn man es bittet, ein Diagramm, eine Formelseite oder einen scannbaren QR-Code zu erstellen, kann es Code als Teil des Prozesses verwenden.
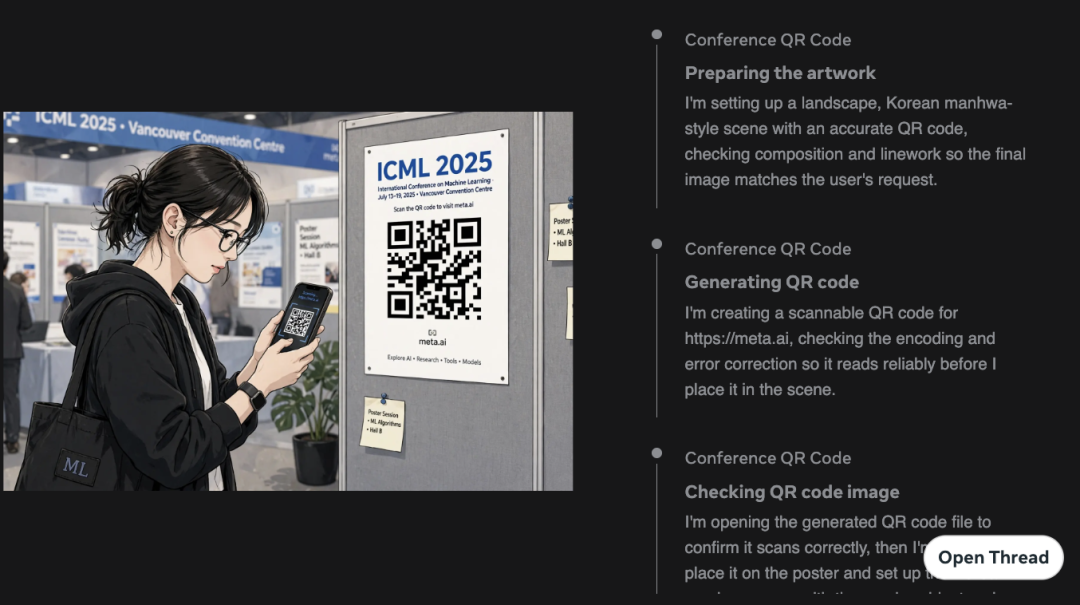
Das bedeutet nicht, dass jedes Ergebnis perfekt sein wird. Aber es verändert den erwarteten Arbeitsablauf. Das Modell „stellt“ sich das Ergebnis nicht mehr nur „vor“; es kann Beweise zusammentragen, Teile der Szene berechnen und Details überprüfen, bevor das Bild fertiggestellt wird.
Eine weitere Schlüsselidee ist die Selbstverfeinerung. Muse Image kann seine eigene Ausgabe überprüfen, Probleme erkennen und entscheiden, ob ein kleiner Bereich überarbeitet, ein größerer Abschnitt neu generiert oder erneut Werkzeuge für ein genaueres Ergebnis verwendet werden sollen.
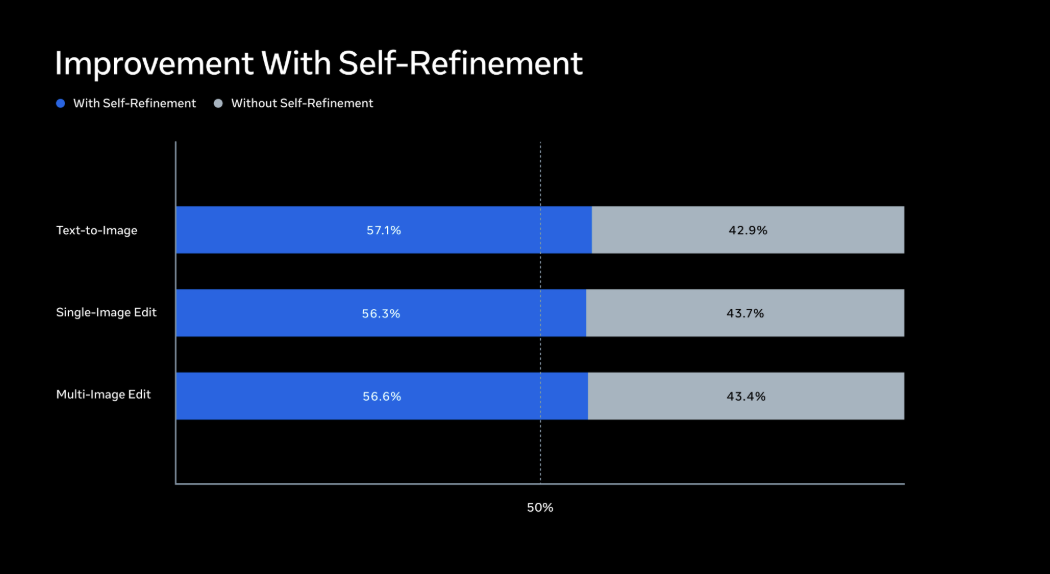
Bei der normalen Bilderzeugung müssen Benutzer oft manuell Eingabeaufforderungen eingeben.
Immer wieder das Modell: die Hand korrigieren, das falsche Logo entfernen, den Text lesbar machen, den Charakter konsistent halten. Muse Image ist darauf ausgelegt, einen Teil dieses Korrekturprozesses in den Modellprozess selbst zu verlagern.
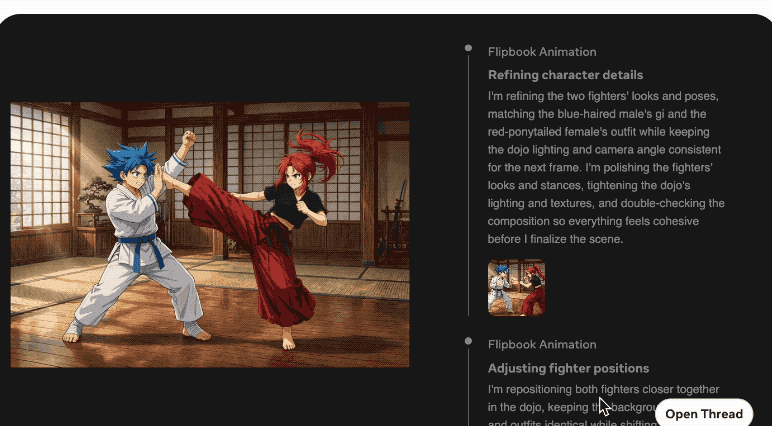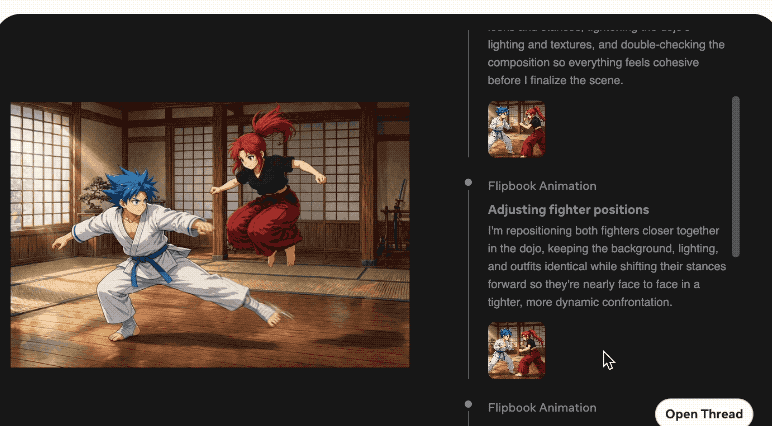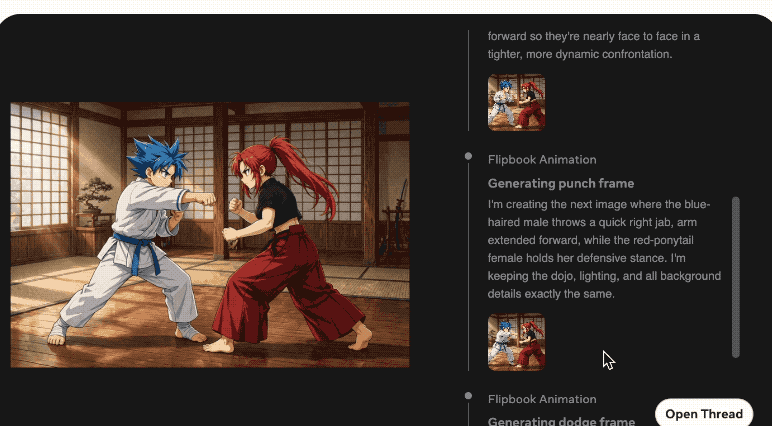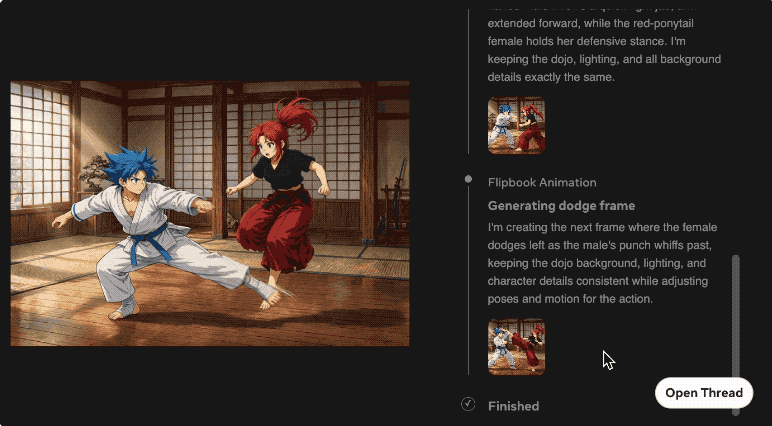
Für Kreativschaffende und Vermarkter macht dies den praktischen Unterschied aus. Ein Modell, das seinen eigenen Entwurf überarbeiten kann, ist für Produktionsabläufe nützlicher, da das erste akzeptable Ergebnis möglicherweise schneller eintrifft und weniger manuelle Bearbeitung erfordert.
Meta berichtet zudem, dass ein stärkeres logisches Denken zum Zeitpunkt der Generierung die Qualität der Ausgabe verbessern kann. Einfach ausgedrückt: Wenn man dem System mehr Zeit und Rechenleistung gibt, um zu denken, zu planen, zu suchen, zu verfeinern oder zwischen Kandidaten auszuwählen, kann dies zu einem besseren Bild führen.
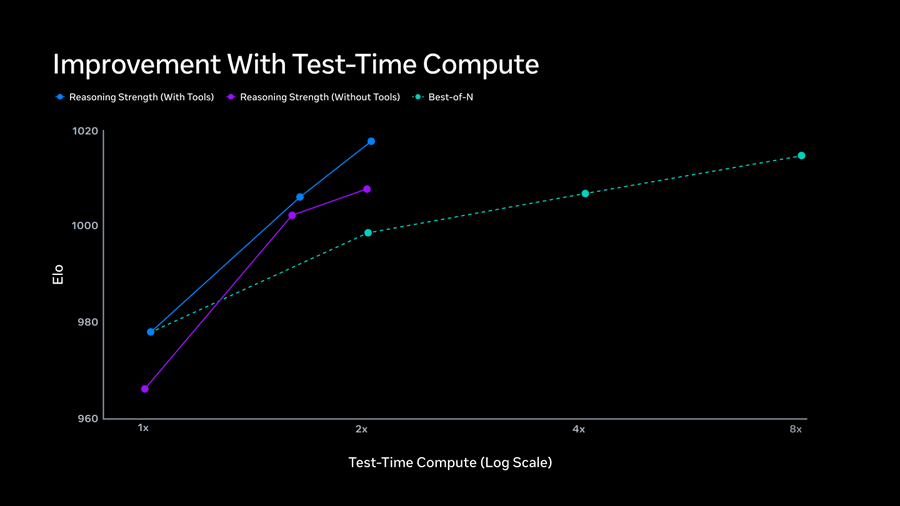
Dies ähnelt dem, was viele bereits bei Sprachmodellen gesehen haben: Die Antwort des Modells kann sich verbessern, wenn es erhält, sorgfältiger zu überlegen. Muse Image wendet eine ähnliche Idee auf die visuelle Erstellung an.
Muse Image ist zudem darauf ausgelegt, mit Muse Spark, dem Sprachmodell von Meta aus der Muse-Familie, zusammenzuarbeiten. Meta gibt an, dass die beiden Modelle Werkzeuge gemeinsam nutzen und die Medienerstellung gemeinsam planen können.
Diese Verbindung eröffnet die Möglichkeit für komplexere Ausgaben als ein einzelnes statisches Bild. Beispielsweise könnte ein Arbeitsablauf Website-Code, eingebettete Bilder, animierte GIFs und interaktive visuelle Elemente kombinieren. In diesem Fall übernimmt das Sprachmodell die Planung und die strukturierte Generierung, während das Bildmodell die visuellen Assets erstellt.
Hier wird der „agentische“ Rahmen bedeutsamer. Das Modell ist nicht nur ein Maler. Es wird Teil eines kreativen Systems, das über mehrere Medienformate hinweg planen, erstellen, prüfen und überarbeiten kann.
Muse Image unterstützt mehrere visuelle Referenzen. Ein Benutzer kann eine Person, ein Outfit, einen Hintergrund, ein Stilbild oder einen anderen visuellen Hinweis angeben und das Modell bitten, diese zu einer neuen Szene zu kombinieren.
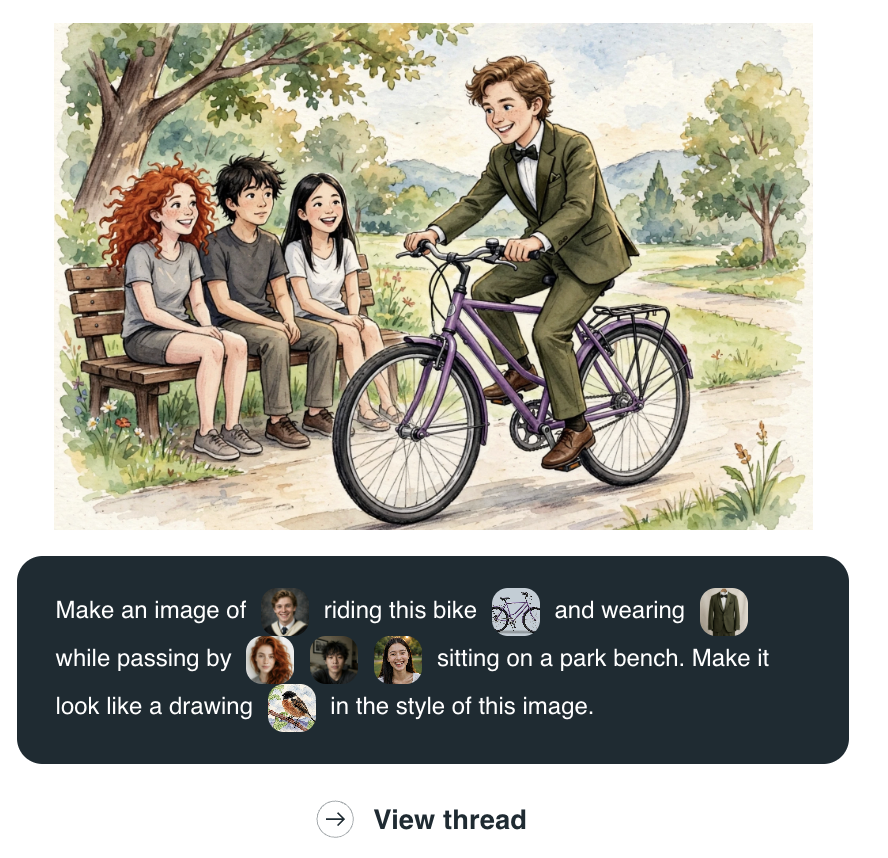
Ein natürlicher Prompt könnte wie folgt aussehen:
Erstelle ein Bild dieser Person in diesem Outfit, sitzend an diesem Ort, und behalte den Stil nahe an diesem Referenzbild.
Diese Art der gemischten Bild- und Textaufforderung ist wichtig, da echte kreative Arbeit selten mit einer einzigen Quelle beginnt.
Arbeit beginnt selten allein mit Text. Designer, Gründer, Kreative und Markenteams denken oft in Referenzen. Sie bringen Moodboards, Screenshots, Produktfotos, Kampagnenbeispiele und Stilmuster in den Prozess ein.
Muse Image unterstützt auch die direkte Bildbearbeitung. Anstatt von vorne zu beginnen, kann ein Nutzer einen Teil des Bildes markieren, die Änderung beschreiben und die gleiche visuelle Richtung weiter verfeinern.
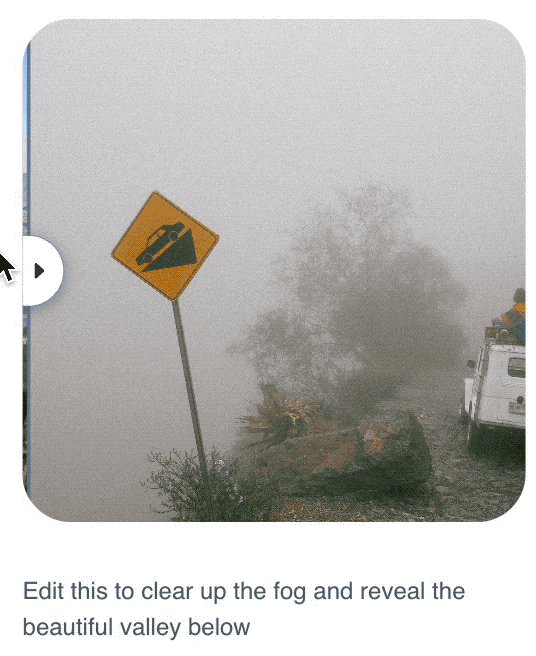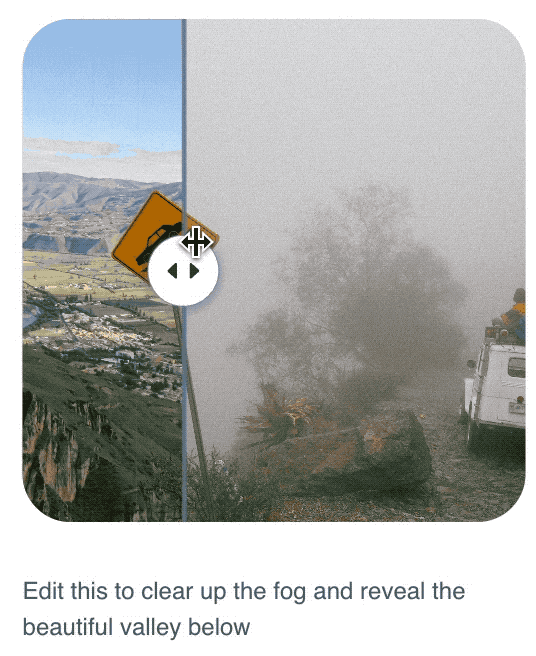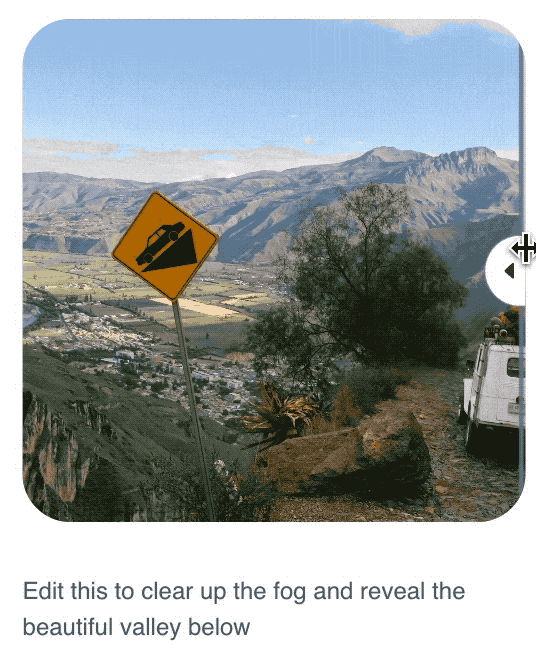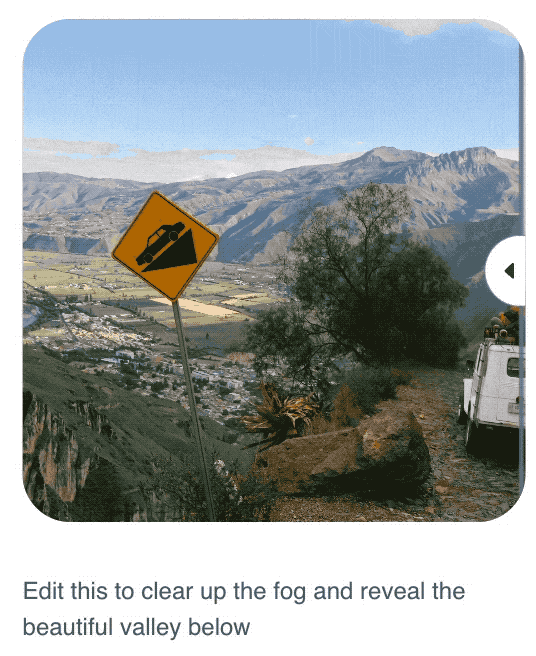
Für soziale Inhalte, E-Commerce-Bilder, visuelle Werbung und leichte Marken-Assets kann dieser Bearbeitungszyklus nützlicher sein als die reine Text-zu-Bild-Generierung. Das Ergebnis muss einem Zweck entsprechen, nicht nur beeindruckend aussehen.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Eine der am meisten diskutierten Funktionen von Muse Image ist seine Verbindung zum sozialen Graphen von Meta. Meta nennt diese Richtung Native Social Context.
In der Praxis kann Muse Image den öffentlichen Instagram-Kontext nutzen, wenn Nutzer in ihren Aufforderungen Konten erwähnen. Das bedeutet, dass ein Nutzer möglicherweise Bilder generieren kann, die auf öffentliche Beiträge oder Profilinhalte verweisen, abhängig von den Plattformeinstellungen und der Verfügbarkeit.
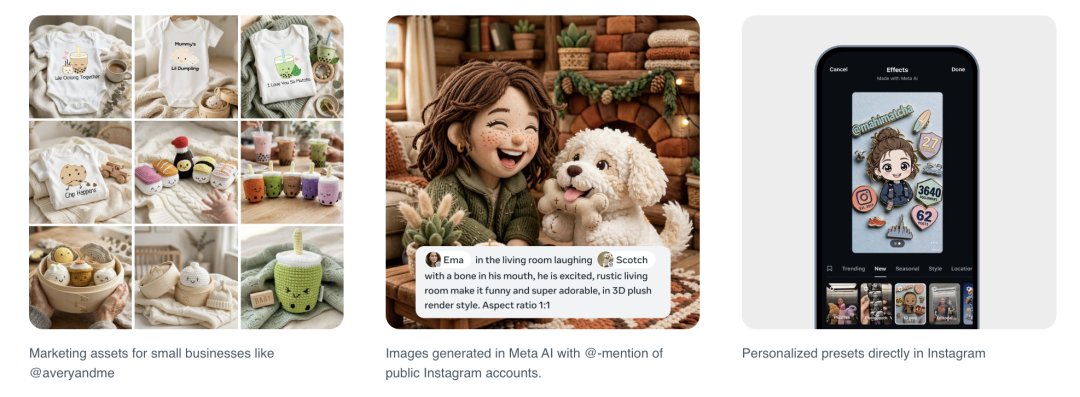
Das ist leistungsstark, wirft aber auch Datenschutzfragen auf. Meta sagt, dass Nutzer Kontrollen haben, mit denen sie verwalten können, ob ihre Instagram-Inhalte für die KI-Erstellung wiederverwendet werden dürfen. Für öffentliche Konten ist dies eine wichtige Einstellung, die es zu überprüfen gilt, insbesondere für Kreative, Influencer, Gründer und alle, deren öffentliche Fotos Teil ihrer persönlichen Marke sind.
Meta sagt auch, dass die Ausgaben von Muse Image ein Content Seal enthalten, ein unsichtbares Wasserzeichensystem, das helfen soll, KI-generierte Bilder zu identifizieren. Laut Meta ist das Signal so konzipiert, dass es gängige Transformationen wie Zuschneiden, Komprimieren, Größenänderung und Screenshots übersteht. Meta stellt zudem ein Erkennungstool vor, mit dem überprüft werden kann, ob ein Bild dieses Wasserzeichen trägt.
Muse Video ist noch nicht vollständig veröffentlicht, daher sind die verfügbaren Informationen begrenzter. Meta beschreibt es als ein Videogenerierungsmodell, das auf derselben Vortrainingsbasis wie Muse Image aufbaut, mit Stärken in visueller Wiedergabetreue, Prompt-Befolgung, zeitlicher Konsistenz und nativer Audiounterstützung.
Der Quellartikel stellt auch fest, dass Meta noch an schwierigen Bereichen wie Audio-Video-Synchronisation und physikalisch genauen schnellen Bewegungen arbeitet. Das ist eine realistische Einschränkung. Videogenerierung ist schwieriger als Bildgenerierung, da das Modell Objekte, Identität, Beleuchtung, Bewegung, Ton und Timing über mehrere Frames hinweg kohärent halten muss.
Dennoch, Muse Video
进入文本转视频排名的领先集团,表明Meta希望直接与其他顶级视频模型竞争,而不仅仅是给其应用添加基本的短视频效果。
消息来源指出,Meta的MSL视觉模型团队包括多位知名研究员,他们来自OpenAI、谷歌、斯坦福大学、UIUC及其他主要AI研究机构。
赵胜佳被公开报道为Meta超级智能实验室的首席科学家。路透社和TechCrunch在2025年报道称,赵胜佳曾是OpenAI研究员,加入Meta以领导新AI部门的科学方向。
消息来源还提到与Muse Image和Muse Video相关的关键多模态负责人余嘉辉。他在计算机视觉、图像生成、图像编辑和多模态系统方面拥有长期的研究记录。
总体要点很简单:Meta不仅在增加一个产品功能。它正在围绕一个全新整合的AI研究和产品团队构建一个媒体生成栈。
Muse Image展示了消费级AI媒体工具的发展方向。下一代图像工具将不仅能通过简短提示生成漂亮图片。它们将更像创意助手,能够:
对创作者来说,这意味着更快的资产制作。对小企业来说,可能减少创建社交视觉内容、产品模型、活动邀请和营销图像所需的工作。对AI产品团队来说,最重要的教训是,生成质量越来越依赖于模型周围的完整工作流程,而不仅仅是模型检查点本身。
Muse Image是Meta超级智能实验室的图像生成模型。它设计用于在Meta AI及相关Meta产品中进行文本到图像生成、图像编辑、多参考合成和社交上下文创建。
Meta将Muse Image描述为具有智能代理特性,因为它能在生成前进行规划,使用搜索和代码等工具,并优化自身输出。这使其更接近创意工作流助手,而非简单的一次性图像生成器。
Muse Video是Meta预览的视频生成模型。Meta表示,它建立在与Muse Image相同的广泛媒体生成方向上,并侧重于提示遵循度、视觉保真度、时间一致性和原生音频支持。
Meta表示,Muse Image可以使用
Instagram sozialer Kontext, wenn Nutzer öffentliche Konten erwähnen, abhängig von Plattformverfügbarkeit und -einstellungen. Inhaber öffentlicher Konten sollten die Instagram-Kontrollen zur KI-Wiederverwendung überprüfen, wenn sie nicht möchten, dass ihre öffentlichen Inhalte auf diese Weise verwendet werden.
Content Seal ist Metas unsichtbares Wasserzeichensystem für KI-generierte Bilder. Meta sagt, dass Bilder, die mit Muse Image in Meta AI und auf meta.ai erstellt wurden, ein verborgenes Herkunftssignal enthalten, das auch nach üblichen Bearbeitungen wie Zuschneiden oder Komprimierung bestehen bleiben kann.
Meta sagt, dass Muse Image über die Meta AI-App und meta.ai verfügbar ist, mit zusätzlicher Verfügbarkeit in Instagram Stories in den USA, WhatsApp in ausgewählten Ländern und zukünftigen Facebook-Oberflächen. Die Einführung kann je nach Region und Produktoberfläche variieren.
Die Suche hilft, die Bildgenerierung in aktuellen oder faktenbasierten Kontext zu stellen, wie Wahrzeichen, Marken oder reale Referenzen. Code hilft bei der Erstellung präziser Diagramme, Formeln, QR-Codes und anderer strukturierter visueller Elemente, die normale Bildmodelle oft nur schwer zuverlässig darstellen können.
Metas Veröffentlichung von Muse Image ist
Bemerkenswert, weil es die Bildgenerierung als agentischen Workflow neu definiert. Das Modell kann Werkzeuge nutzen, seine eigenen Ergebnisse verfeinern, mit mehreren Referenzen arbeiten und sich in Metas breiteres soziales Ökosystem einbinden.
Muse Video befindet sich noch in der Vorschauphase, deutet jedoch darauf hin, dass Meta von der statischen Bildgenerierung hin zu einem breiteren multimodalen Medien-Stack übergeht. Die Kombination aus Muse Spark, Muse Image und Muse Video weist auf eine Zukunft hin, in der KI-generierte Inhalte geplant, geprüft, bearbeitet und über verschiedene Produktoberflächen verteilt werden.
Für Kreative, Vermarkter und KI-Entwickler ist die Kernbotschaft klar: Bessere Mediengenerierung hängt weniger von einem einzelnen Prompt ab, sondern vielmehr vom System rund um das Modell.
Muse Image ist nicht einfach nur ein weiterer KI-Bildgenerator; es ist Metas Versuch, visuelle Erstellung wie einen agentengesteuerten Workflow zu gestalten.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



