For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/meta-muse-wonder-and-full-benchmarks-memo-741b367d.md.
Meta stellte am 12. Oktober 2026 **Muse Wonder** und **Muse Wonder Full** vor. Die Veröffentlichung richtet sich an persönliche und professi...
Meta stellte am 12. Oktober 2026 Muse Wonder und Muse Wonder Full vor. Die Veröffentlichung richtet sich an persönliche und professionelle Agenten: Systeme, die nützlichen Kontext speichern, Hindernisse bewältigen und Projekte abschließen sollen, die mehr als eine einzelne Antwort erfordern.
Die offizielle Ankündigung bestätigt, dass Wonder über die Meta Model API und Muse Code verfügbar ist, während Full für Muse-Code-Abonnenten verfügbar ist. Meta plant außerdem, Wonder zunächst für Abonnenten in seinen Muse-Assistenten zu integrieren.
Die Modellkarte nennt ein Kontextfenster von einer Million Token bei der Inferenz sowie Eingaben in Form von Text, Bildern, Videos und Audio. Als Ausgabemodalität ist Text angegeben. Multimodales Verständnis sollte daher nicht mit dem Versprechen verwechselt werden, dass das Modell selbst jedes Eingabemedium erzeugt.
Meta gibt an, die Modelle in seinem Prometheus-Rechenzentrum im Gigawatt-Maßstab trainiert zu haben, im Zuge eines umfassenderen Neuaufbaus seines KI-Stacks. Die Trainingsinfrastruktur erklärt den Kontext der Veröffentlichung; sie belegt jedoch nicht, dass jede Anwendung genauso gut abschneidet wie eine Benchmark-Demonstration.
Der vorliegende Bericht beschreibt, dass Wonder Full im Artificial Analysis Intelligence Index 56 Punkte erreichte, verglichen mit 52 für Wonder und 48 für Muse Spark 1.3. Die eigene Bewertung von Artificial Analysis bestätigt diese Werte bei maximalem Reasoning-Aufwand. Sie beziehen sich auf den gemeldeten Evaluierungszeitpunkt und nicht auf eine dauerhafte Rangfolge.
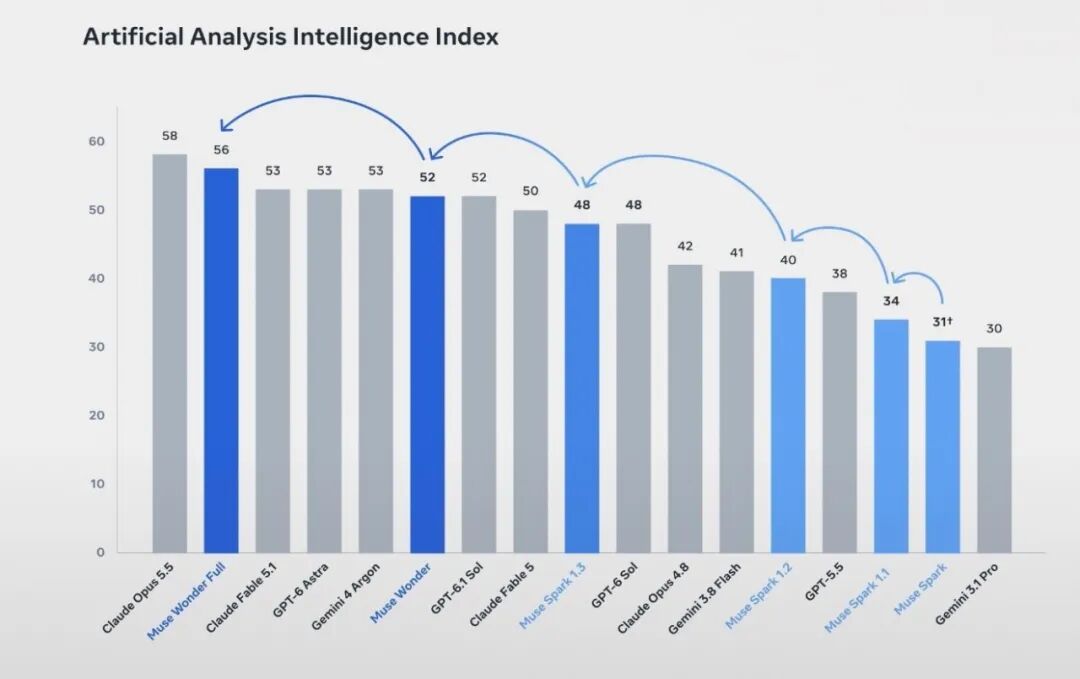
Diagramm, reproduziert im Xinzhiyuan-Bericht auf BAAI; die dortige Bewertung wird Artificial Analysis zugeschrieben.
Für länger laufende Softwarearbeit berichtet die Quelle:
| Bewertung | Wonder Full | Wonder | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| SWE-Marathon | 57,5 % | 53,1 % | 46,3 % | 42,5 % |
| DeepSWE v1.1 | 79,0 % | 78,8 % | 74,2 % | 74,1 % |
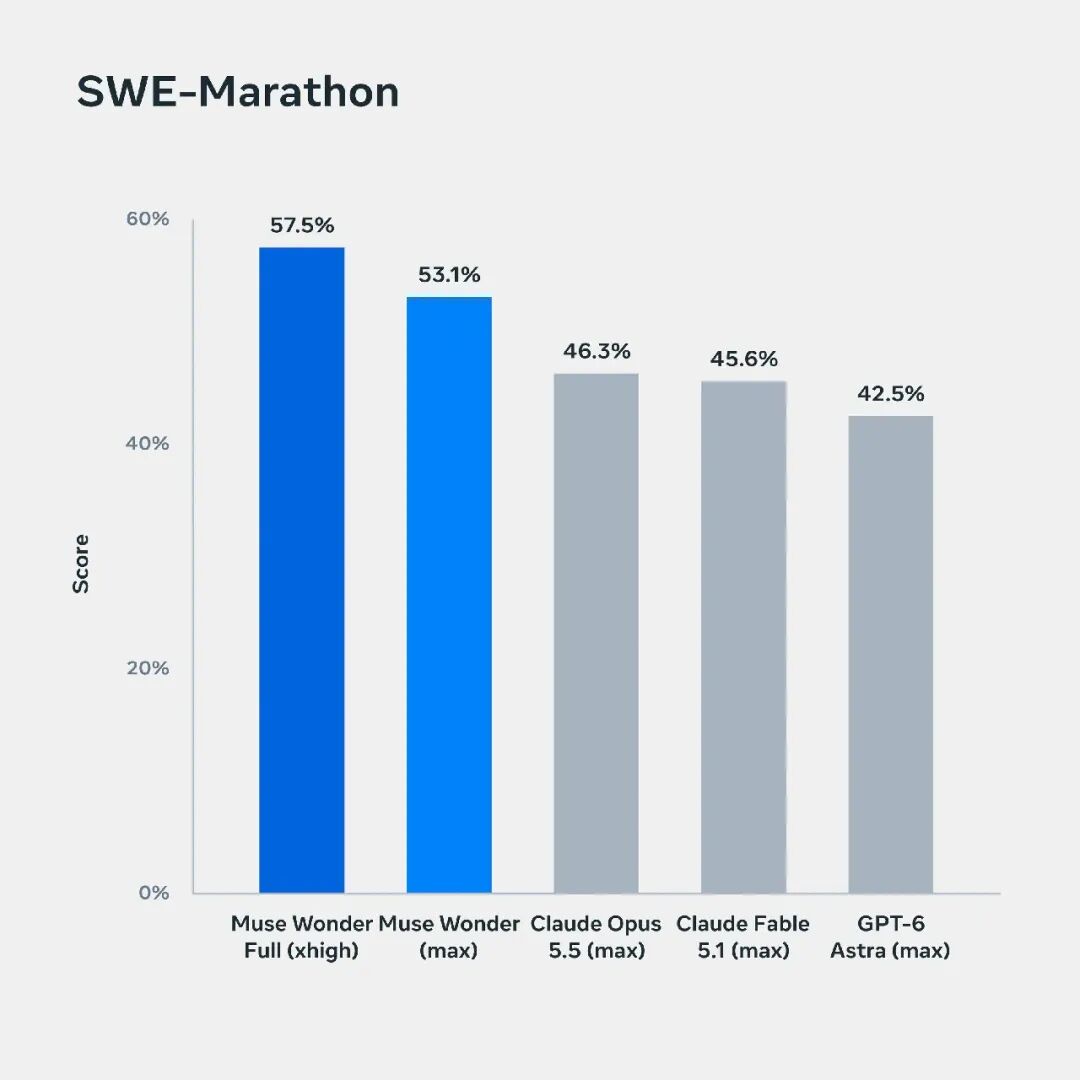
Benchmark-Grafik von Meta, wie von der Quelle reproduziert.
Die Modellkarte enthält eine wichtige Einschränkung: SWE-Marathon ist kein kontrollierter Vergleich mit einem gemeinsamen Test-Harness. Einige Ergebnisse konkurrierender Systeme verwenden Codex oder Claude Code, während das gemeldete Ergebnis von Wonder Full den xhigh-Reasoning-Aufwand nutzt. DeepSWE kombiniert ebenfalls spezifizierte Drittanbieter- und von Anbietern gemeldete Ergebnisse. Leser sollten daher die Methodik jedes Benchmarks prüfen.
Das Gesamtbild ist eher gemischt als ein eindeutiger Durchmarsch. Der Artikel berichtet, dass Full bei ProgramBench vor GPT-6 Astra liegt, jedoch hinter Opus 5.5, und beim aufgeführten Terminal-Coding-Vergleich hinter beiden liegt. Die Modellauswahl hängt weiterhin von der tatsächlichen Arbeit, der Tool-Umgebung, dem Budget und der akzeptablen Fehlerrate ab.
Meta verwendet den Begriff Active Memory dafür, wichtigen Kontext zwischen Gesprächen zu übertragen und relevante Details bei Bedarf abzurufen. Mit Active Focus bezeichnet Meta anhaltende Arbeit: einen anderen Ansatz auszuprobieren, sich an neue Informationen anzupassen und trotz Blockaden weiterzuarbeiten.
Diese Fähigkeiten lösen unterschiedliche Probleme. Das Erinnern an eine Anforderung stellt für sich genommen nicht sicher, dass ein Agent eine schwierige Implementierung abschließen kann; Ausdauer hilft nicht, wenn der Agent eine entscheidende Einschränkung verloren hat.
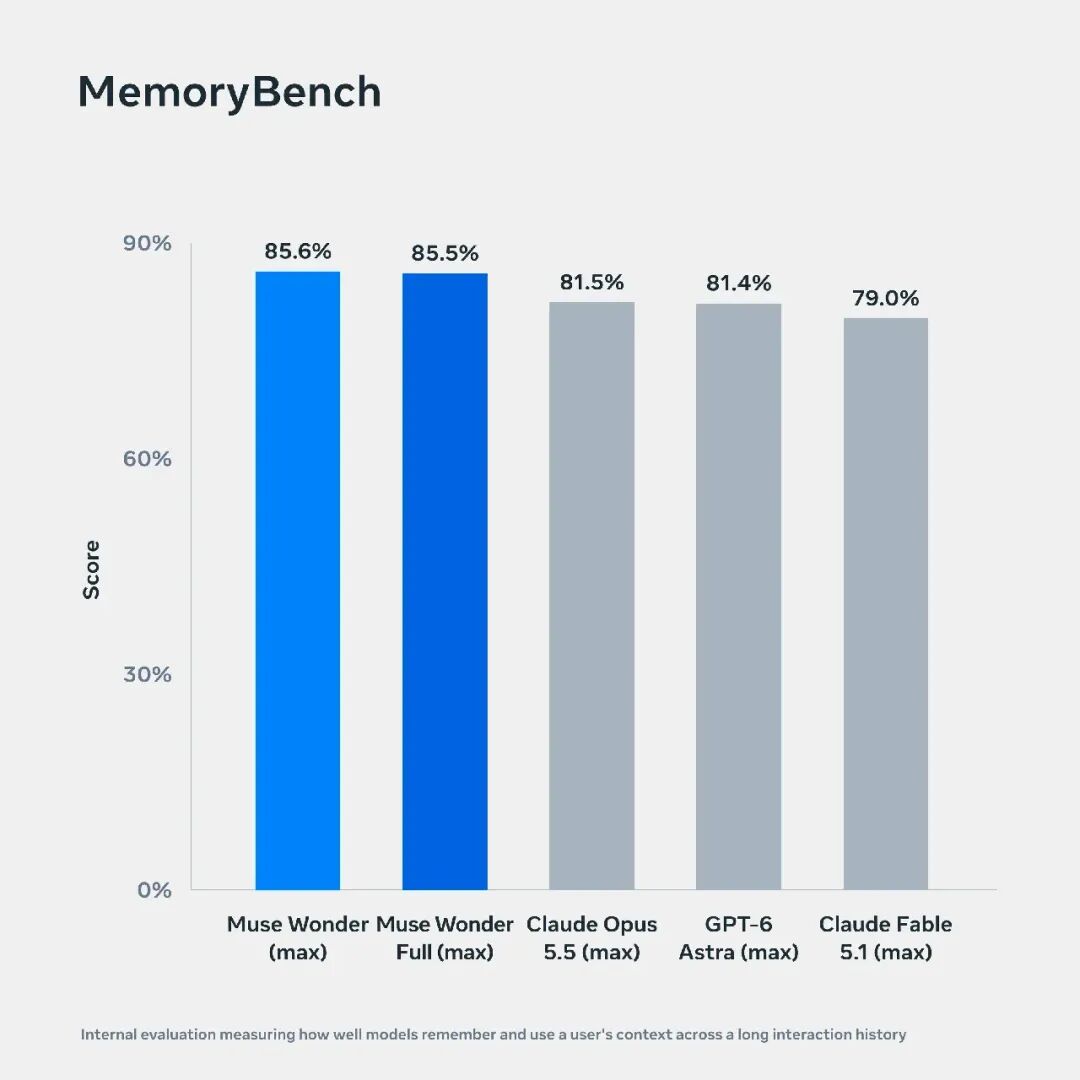
Meta-Evaluierungsgrafik, über den Quellbericht reproduziert.
Die Modellkarte beschreibt MemoryBench als interne Evaluierung mit Gesprächen von 64.000 bis 100.000 Token, einschließlich ablenkender oder widersprüchlicher Informationen. FocusBench ist ebenfalls eine interne Evaluierung. Diese Angaben beschreiben sinnvoll, was getestet wurde, garantieren jedoch weder fehlerfreie Erinnerung noch ununterbrochene Autonomie in einem bereitgestellten Dienst.
Meta bewertet die Modelle neben Programmierung auch bei Aufgaben aus Recht, Finanzen, Gesundheit und professionellen Dokumenten. Diese Tests beziehen sich auf konkrete Arbeitsergebnisse und Bewertungsregeln; ein Ergebnis sollte nicht als berufliche Qualifikation verstanden werden.
Der chinesische Bericht hebt zudem einen Unterschied zwischen selektivem Antworten und größerem Wissen hervor. Er berichtet für Full einen niedrigeren Halluzinationswert bei zugleich niedrigerem Wissensindex als bei den verglichenen Modellen Opus und Astra. In dieser Diskussion ist der Halluzinationsprozentsatz von falschen oder unbeantworteten Wissens-Testaufgaben abhängig; er ist nicht der Anteil aller realen Antworten, die falsch sind.
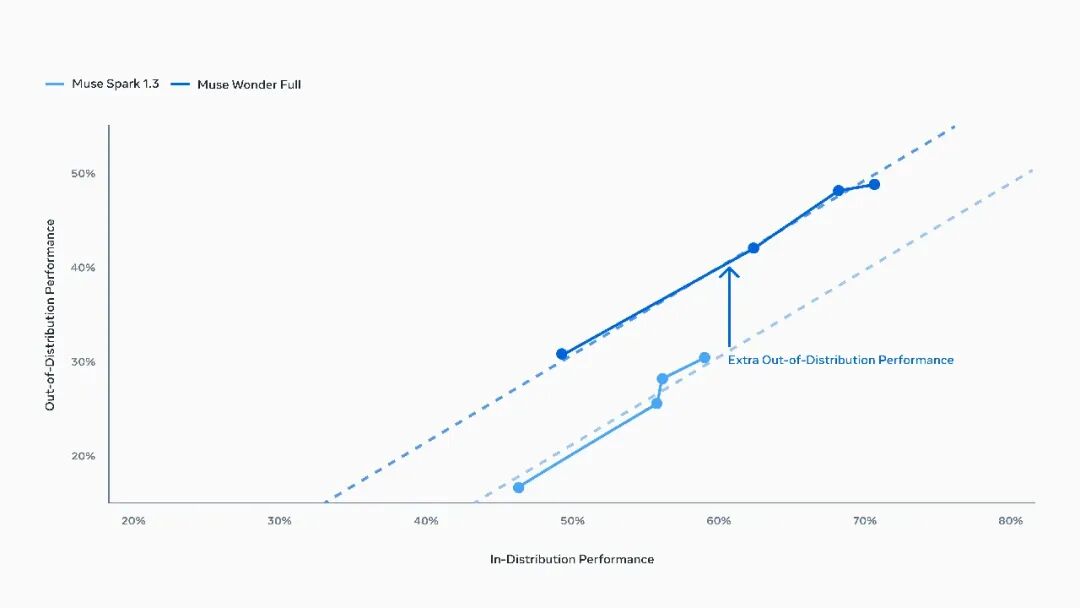
Bei unbekannten Aufgaben präsentiert Meta Hinweise darauf, dass Full bei vergleichbarer Leistung innerhalb der Trainingsverteilung besser als das frühere Spark-Modell generalisiert. Diese Schlussfolgerung bezieht sich auf das gemessene Evaluierungs-Setup und ist kein Beweis für uneingeschränkte Selbstverbesserung.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Generalisierungsdiagramm von Meta, im Quellbericht reproduziert.
Die Quelle nennt zum Zeitpunkt ihres Berichts die folgenden Preise:
| Produkt | Gemeldeter Preis | Gemeldeter Zugang |
|---|---|---|
| Wonder-API-Eingabe | 4 US-Dollar pro Million Token | Nutzungsbasierte API |
| Wonder-API-Ausgabe | 20 US-Dollar pro Million Token | Nutzungsbasierte API |
| Wonder-API-Eingabe aus Cache | 0,20 US-Dollar pro Million Token | Eingabe aus Cache |
| Full: Power Usage | 50 US-Dollar pro Monat | Muse-Code-Abonnement |
| Full: Maximum Usage | 200 US-Dollar pro Monat | Muse-Code-Abonnement |
Der Bericht beschreibt die beiden Full-Abonnements als Angebote mit dem 20- beziehungsweise 80-Fachen der Basiskapazität. Diese Multiplikatoren bedeuten keine unbegrenzte Nutzung, und die Quelle legt keine allgemeingültige Anzahl von Aufgaben pro Monat fest.
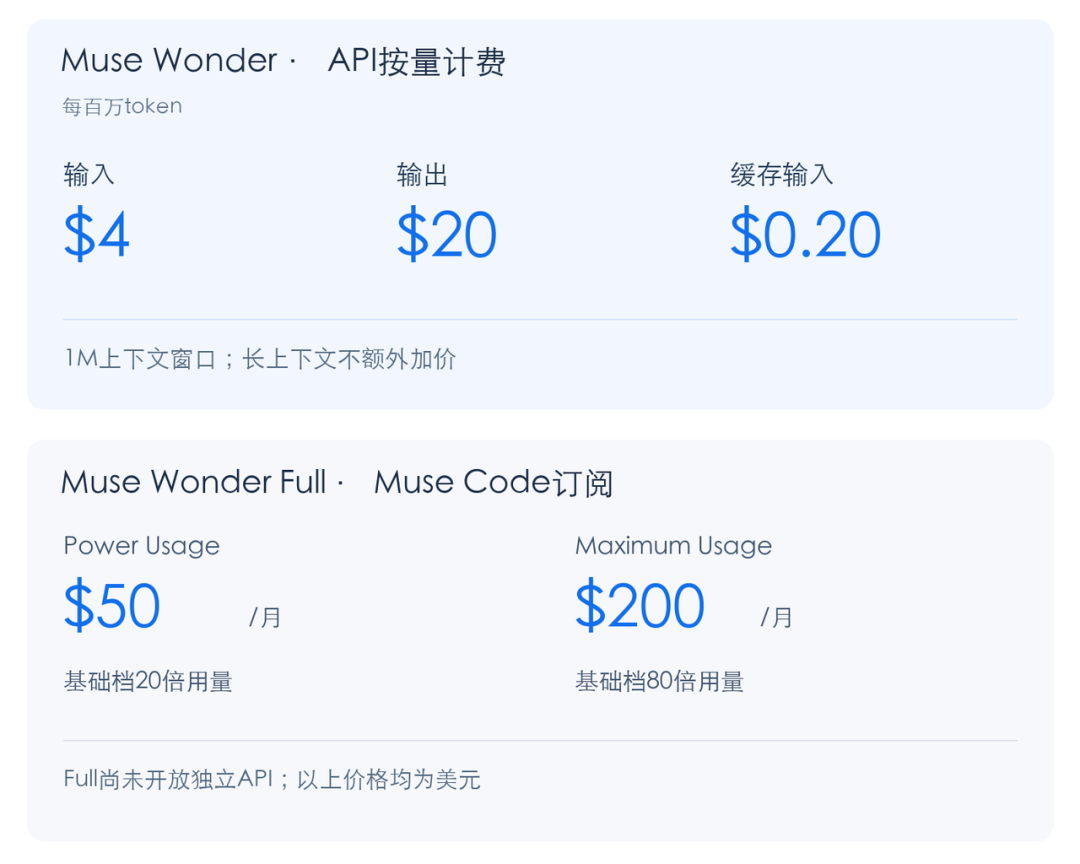
Preisgrafik mit Quellenangabe im Quellbericht; aktuelle Abrechnungsbedingungen waren nicht unabhängig zugänglich.
Zum Zeitpunkt der Ankündigung wurde Full über Muse-Code-Abonnements angeboten, nicht über eine separat angekündigte öffentliche API. Teams, die eines der beiden Produkte in Betracht ziehen, sollten den aktuellen Zugang und die Preise ihres tatsächlichen Kontos prüfen, bevor sie sich auf einen Arbeitsumfang festlegen.
Muse Wonder ist ein Meta-Modell, das am 12. Oktober 2026 für persönliche und professionelle Agentenaufgaben veröffentlicht wurde. Meta beschreibt Stärken bei Speicher, anhaltender Aufgabenausführung, Programmierung und domänenspezifischer Arbeit.
Full ist die leistungsstärkere Variante in vielen der gemeldeten Evaluierungen. Die offizielle Ankündigung bietet Wonder über die API und Muse Code an, während Full für Muse-Code-Abonnenten verfügbar ist.
Metas Modellkarte nennt eine Million Token bei der Inferenz. Kontextkapazität ist von zuverlässigem Erinnern, Ausgabelimits und der Menge nutzbaren Materials zu unterscheiden, die eine bestimmte Anwendung bereitstellen kann.
Die Modellkarte nennt Text-, Bild-, Video- und Audioeingaben. Sie nennt Text als Ausgabe. Die Unterstützung multimodaler Eingaben sollte daher nicht als native Audio- oder Videogenerierung interpretiert werden.
Nein. Die gemeldeten Ergebnisse gelten für bestimmte Aufgaben, Agenten-Setups und Reasoning-Einstellungen. Meta weist ausdrücklich darauf hin, dass die SWE-Marathon-Ergebnisse nicht für alle verglichenen Systeme einen kontrollierten gemeinsamen Test-Harness verwenden.
Active Memory betrifft das Behalten und Abrufen relevanten Kontexts über Gespräche hinweg. Active Focus betrifft das Durchhalten bei Hindernissen und die Anpassung während einer Aufgabe, gegebenenfalls mit Klärung oder Bestätigung.
Die Ankündigung vom 12. Oktober beschreibt Full als für Muse-Code-Abonnenten verfügbar. Sie kündigt keine separate öffentliche Full-API an; die Verfügbarkeit sollte anhand späterer offizieller Hinweise geprüft werden.
Muse Wonder und Full erweitern Metas Agentenangebot um ein Kontextfenster von einer Million Token, multimodale Eingaben, Speicher und Fähigkeiten für anhaltende Programmierarbeit. Die Ankündigung bestätigt getrennte Zugangswege über API und Abonnement, während die Quelle deutliche Verbesserungen gegenüber Muse Spark 1.3 berichtet.
Der nützlichste Vergleich verbindet Benchmark-Ergebnisse mit ihren Test-Harnesses, dem Kontozugang und den Kosten für die Erledigung Ihrer eigenen Aufgaben.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



