Microsoft meldet, dass eine neue Konfiguration seines Multi-Modell- und Multi-Agenten-Systems MDASH bei CyberGym eine Erfolgsquote von 95,95...
Microsoft berichtet, dass eine neue Konfiguration seines Multi-Modell-, Multi-Agenten-Systems MDASH eine Erfolgsquote von 95,95 % auf CyberGym erreicht hat. Das System dient der Identifizierung, Verifizierung, Priorisierung und Behebung von Software-Schwachstellen.
Diese Zahl ist bemerkenswert. Das ursprüngliche CyberGym-Paper berichtete, dass die stärkste getestete Kombination – OpenHands mit Claude 3.7 Sonnet – in der erstveröffentlichten Auswertung nur 11,9 % der Schwachstellen des Benchmarks reproduzieren konnte.
Das neueste Ergebnis von Microsoft liegt deutlich darüber. Der wichtigste Teil dieser Ankündigung ist jedoch nicht nur, dass neue Modelle leistungsfähiger sind.
Die Punktzahl von 95,95 % wurde von einem vollständigen Sicherheitssystem erzielt, das Folgendes kombiniert:
Microsoft fasst diesen Ansatz in drei Worten zusammen:
Modell
Daten
Framework
Das Modell liefert Intelligenz. Die Daten verleihen der Intelligenz Sicherheitskontext. Das Framework verwandelt Modellausgaben in wiederholbare, verifizierbare Arbeitsabläufe.
Diese Unterscheidung ist wichtig, weil Unternehmens-Sicherheitsteams keine Benchmark-Antworten kaufen. Sie benötigen ein System, das kontinuierlich läuft, Fehlalarme kontrolliert, beweist, dass Erkenntnisse real sind, und hilft, Ergebnisse in Sicherheitsfixes umzuwandeln.
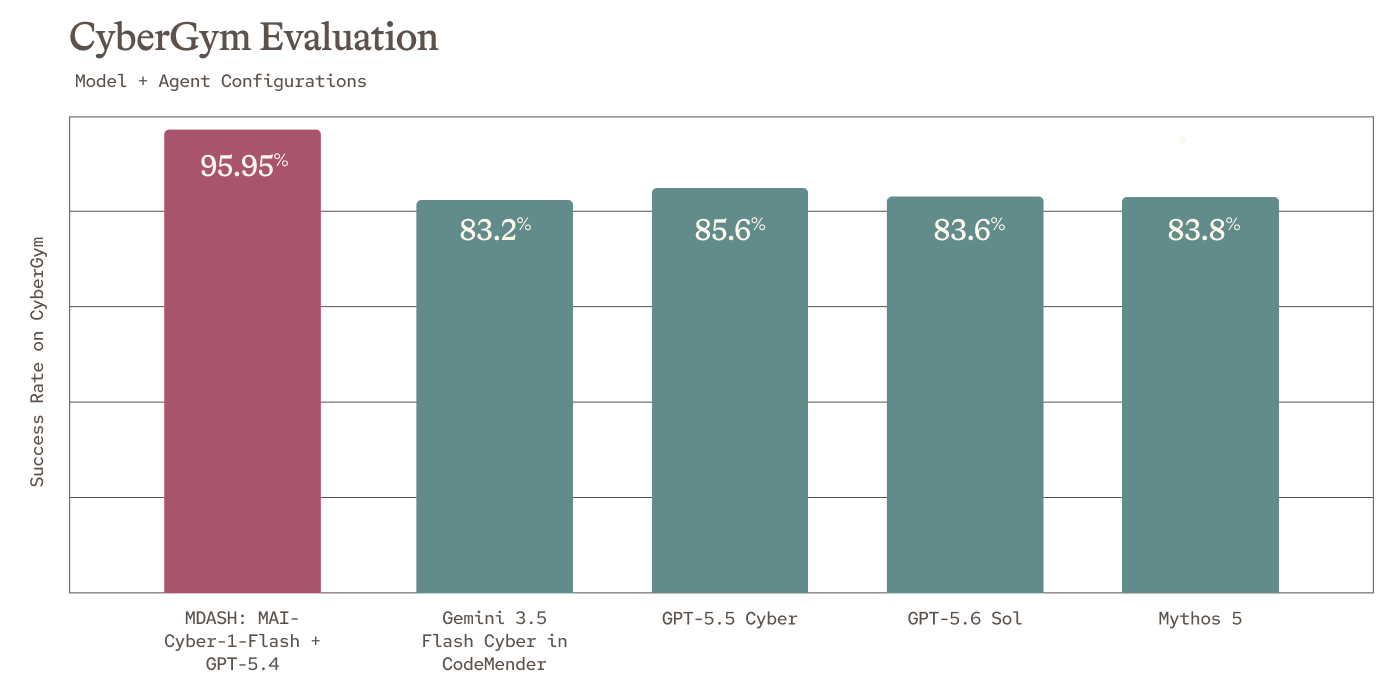
Das von Microsoft veröffentlichte CyberGym-Diagramm vergleicht fünf Modell- und Agentenkonfigurationen:
| System- oder Modellkonfiguration | Von Microsoft berichtete CyberGym-Erfolgsquote |
|---|---|
| MDASH: MAI-Cyber-1-Flash + GPT-5.4 | 95,95 % |
| GPT-5.5 Cyber | 85,6 % |
| Mythos 5 | 83,8 % |
| GPT-5.6 Sol | 83,6 % |
| Gemini 3.5 Flash Cyber in CodeMender | 83,2 % |
Die MDASH-Konfiguration liegt in Microsofts Diagramm mehr als zehn Prozentpunkte vor dem Zweitplatzierten.
Microsoft gibt außerdem an, dass diese Konfiguration etwa 50 % günstiger ist als die bisher stärkste MDASH-Einstellung (mit GPT-5.4, GPT-5.4 mini und GPT-5.3 Codex).
Der Vergleich umfasst also zwei Dimensionen:
Sicherheitsscans sind keine einmalige Aufgabe. Große Organisationen müssen möglicherweise Millionen von Codezeilen prüfen, nach jeder Änderung erneut scannen, mutmaßliche Schwachstellen verifizieren, Patches erneut testen und sich ständig ändernde Software-Assets überwachen.
Eine Konfiguration, die äußerst leistungsfähig, aber bei häufiger Ausführung zu teuer ist, könnte weniger praktischen Schutz bieten als ein etwas kleineres Modell, das in ein besseres Routing- und Verifizierungssystem eingebettet ist.
Microsoft gibt an, dass MAI-Cyber-1-Flash dafür entwickelt wurde, bis zu 90 % der Aufgaben im MDASH-Workflow zu übernehmen.
Die schwierigsten 10 % der Aufgaben können an ein größeres Modell weitergeleitet werden, das Microsoft in der veröffentlichten Konfiguration als GPT-5.4 identifiziert.

Diese Strategie lässt sich wie folgt darstellen:
Häufige und regelmäßige Sicherheitsaufgaben
→ MAI-Cyber-1-Flash

Außergewöhnlich schwierige Aufgaben
→ GPT-5.4
Das bedeutet nicht, dass MAI-Cyber-1-Flash allein 90 % der Schwachstellen behebt.
Die Zahl 90 % bezieht sich auf den Aufgabenanteil, den das kleine Modell im Routing-Workflow abdecken soll. Das vollständige MDASH-Ergebnis hängt weiterhin vom Aufgaben-Router, größeren Modellen, spezialisierten Agenten, Verifizierung, Beweisgenerierung, Deduplizierung, Sicherheitswerkzeugen, Ausführungsumgebungen und Systemsteuerung auf Systemebene ab.
Das kleine Modell senkt die durchschnittlichen Kosten des Workflows, beseitigt jedoch nicht die Notwendigkeit stärkerer Modelle für die schwierigsten Fälle.
Microsoft beschreibt MAI-Cyber-1-Flash als sein erstes auf Cybersicherheit spezialisiertes Modell.
Die offizielle Modellkarte listet:
| Spezifikation | MAI-Cyber-1-Flash |
|---|---|
| Architektur | Sparse Mixture-of-Experts Transformer |
| Gesamtparameter | 137B |
| Aktivierte Parameter | 5B |
| Kontextlänge | 256K |
| Eingabe | Text |
| Ausgabe | Text |
| Basismodell | MAI-Code-1-Flash |
| Primäre Umgebung | Microsoft Codename MDASH |
| Veröffentlichungsdatum | 27. Juli 2026 |
| Verfügbarkeit | Private Vorschau in Azure AI Foundry für genehmigte MDASH-Kunden |
Das Modell ist eine auf Cybersicherheit spezialisierte Feinabstimmung von MAI-Code-1-Flash.
Es wurde für Arbeitsabläufe wie Schwachstellenidentifizierung, Verifizierung, Priorisierung, Klassifizierung, Behebungsunterstützung und Unternehmenscode-Scanning entwickelt.
Es handelt sich nicht um ein öffentliches Allzweck-Cybermodell.
Die Modellkarte von Microsoft weist darauf hin, dass der Zugriff auf ausgewählte MDASH-Kunden beschränkt ist und einer zusätzlichen Prüfung bedarf, da fortgeschrittene Cybersicherheitsfähigkeiten unter Dual-Use-Technologien fallen.
Das Modell ist außerdem speziell für die Integration in MDASH konzipiert und nicht als eigenständig herunterladbares Modell oder uneingeschränkte öffentliche API.
MAI-Cyber-1-Flash hat insgesamt 137 Milliarden Parameter, aktiviert jedoch nur etwa 5 Milliarden Parameter pro Token.
Dieses Sparse-Mixture-of-Experts-Design ermöglicht es dem Modell, auf eine größere Gesamtkapazität zuzugreifen und gleichzeitig einen relativ geringen Inferenz-Overhead durch Aktivierung aufrechtzuerhalten.
Die wichtigere Optimierung liegt jedoch in der Spezialisierung.
Allzweck-Frontier-Modelle müssen Schreiben, Mathematik, Recherche, Programmierung, Konversation, Planung, multimodale Arbeit und Werkzeugnutzung unterstützen. Ein spezialisiertes Modell kann hingegen mehr Training und Post-Training auf einen einzigen operativen Bereich konzentrieren.
Für MAI-Cyber-1-Flash umfasst dieser Bereich ausführbare Sicherheitsumgebungen und Schwachstellenmanagement-Workflows.
Wenn ein Modell wiederholt auf Aufgaben trifft, die seiner Trainings- und Bewertungsumgebung ähneln, kann Spezialisierung das Preis-Leistungs-Verhältnis verbessern.
Das System benötigt dennoch einen Reserveplan, da schwierige oder spezielle Fälle die Fähigkeiten des spezialisierten Modells übersteigen können.
Dies führt zu einer praktischen Multi-Modell-Architektur:
Kostengünstiges Spezialmodell für die Breite
+
Frontier-Modell für Ausnahmefälle
+
Verifizierungssystem für Vertrauen
Die Modellkarte bietet einen besonders nützlichen Systemvergleich.
Microsoft gibt an, dass die bisherige MDASH-Konfiguration auf CyberGym 88,4 % erreichte.
Nachdem 80 % der bestehenden Modellaufrufe im Workflow durch MAI-Cyber-1-Flash ersetzt wurden, stieg das Ergebnis auf 95,95 %.
Auch die Kosten sanken im Vergleich zur bisher stärksten Konfiguration um etwa die Hälfte.
Dieses Ergebnis stellt eine gängige Annahme in Frage:
Günstigere Modelle bedeuten zwangsläufig geringere Qualität.
Das mag gelten, wenn Modelle allein und mit derselben Aufgabe verglichen werden. Innerhalb eines Routing-Systems ist dies jedoch nicht immer der Fall.
Ein spezialisiertes Modell kann bei häufigen Aufgaben stabilere Ergebnisse liefern, weil es gezielt für diese Aufgaben trainiert wurde. Der Router kann teure Frontier-Modelle für Szenarien reservieren, in denen sie den größten Mehrwert schaffen.
Das Endergebnis hängt davon ab, drei Fragen richtig zu beantworten:
Modell-Routing wird Teil der Produktqualität.
Die Modellkarte von Microsoft berichtet außerdem
MAI-Cyber-1-Flash eigenständige Ergebnisse in anderen Cybersicherheitsbewertungen.
Diese rein modellbezogenen Ergebnisse entsprechen nicht der MDASH-Punktzahl auf CyberGym.
Die Modellkarte listet Folgendes auf:
| Benchmark | MAI-Cyber-1-Flash eigenständiges Ergebnis |
|---|---|
| CVEBench | 0.314 |
| CyberSecEval4 Threat Intelligence | 0.553 |
| CyberSecEval4 Malware-Analyse | 0.33 |
| CRSBench | 0.651 (POV=1200) |
| ExploitGym Kernel | 0 |
| ExploitGym User-Mode | 0 |
| ExploitGym Browser | 0 |
Diese Daten verdeutlichen die Bedeutung der Unterscheidung auf Systemebene.
Das kleine Modell ist nicht auf allen Cyber-Benchmarks durchgängig führend. Seine stärksten veröffentlichten Ergebnisse erzielt es in Zusammenarbeit mit anderen Modellen, Agenten, Tools, Daten und Validierungsphasen innerhalb von MDASH.
Dies bestätigt die zentrale Botschaft von Microsoft:
Modelle sind Komponenten.
Systeme sind das Produkt.
MDASH ist Microsofts Multi-Modell-, Multi-Agenten-Framework zur Schwachstellenerkennung und -behebung.
Microsoft gibt an, dass seine Sicherheitsexperten mehr als 100 spezialisierte Agenten im System erstellt haben.
Verschiedene Agenten übernehmen unterschiedliche Abschnitte des Workflows, darunter Code-Lokalisierung, Kandidatenfindung, Schwachstellenanalyse, Validierung, Beweisaufbau, Klassifizierung, Deduplizierung, Behebung, Patch-bezogene Arbeiten sowie den Abgleich zwischen Erkenntnissen.
Der vereinfachte Systemablauf sieht grob wie folgt aus:
Code- und Sicherheitskontext
        ↓
Kandidatenfindungs-Agenten
        ↓
Validierungs-Agenten
        ↓
Debatte und Abgleich
        ↓
Deduplizierung
        ↓
Proof-of-Concept-Erzeugung
        ↓
Patch- oder Behebungsunterstützung
Menschliche Prüfung und kontrollierter Betrieb
Die konkrete interne Implementierung ist proprietär, aber Microsoft hat mehrere wichtige Designprinzipien dargelegt.
Microsoft gibt an, dass MDASH die verschiedenen Teile der Pipeline (wie Zielausrichtung, Validierung, Deduplizierung und Beweisführung) von jedem einzelnen Modell entkoppelt.
Dies erleichtert das Austauschen oder Vergleichen von Modellen.
Wenn neue Modelle verfügbar werden, kann das System diese per A/B-Test gegen die aktuelle Modellgruppe testen.
Bisherige Investitionen der Organisation bleiben wirksam:
Dies reduziert die Abhängigkeit von einem einzelnen Modellanbieter oder Checkpoint.
Es ermöglicht auch kontinuierliche Verbesserungen. Das beste Modell für eine Phase ist nicht unbedingt das beste für eine andere Phase.
Das Auffinden bestimmter Schwachstellen erfordert mehr als nur das Lesen von Quellcode.
Das System muss möglicherweise Projekte erstellen, Trigger-Eingaben erzeugen, verwundbare Versionen ausführen, gepatchte Versionen ausführen, Abstürze untersuchen, Code-Analyse-Datenbanken abfragen, Kontrollflüsse vergleichen und verifizieren, ob das Verhalten reproduzierbar ist.
Microsoft gibt an, dass MDASH spezialisierte Domain-Plugins und Code-Analyse-Systeme verwenden kann.
Die Ankündigung vom Mai diskutierte Validierungs-Plugins für Schwachstellen im allgemeinen Log-Dateisystem und wies darauf hin, dass auch CodeQL-Datenbanken verwendet werden können.
Das Modell muss nicht alles über Freitext ausführen.
Für Aufgaben, die besser für Software geeignet sind, können Tools deterministische Fähigkeiten bereitstellen.
Sicherheitsmodelle können plausible, aber tatsächlich falsche Schwachstellenbeschreibungen erzeugen.
Wenn das System jedes spekulative Ergebnis an Entwickler weiterleitet, erzeugt dies Alarmmüdigkeit.
Der operative Wert liegt darin, zu beweisen, dass ein Fund echt ist.
Nützliche Beweise können umfassen:
Deshalb sind Benchmarks wie CyberGym relevant.
Er bewertet nicht nur die Überzeugungskraft schriftlicher Erklärungen.
Er prüft, ob der erzeugte Beweis tatsächlich das Zielverhalten reproduzieren kann.
CyberGym ist ein groß angelegter Benchmark, der von Forschern im Umfeld der University of California, Berkeley, erstellt wurde.
Das derzeit öffentliche Projekt enthält 1.507 reale Schwachstelleninstanzen aus 188 Softwareprojekten.
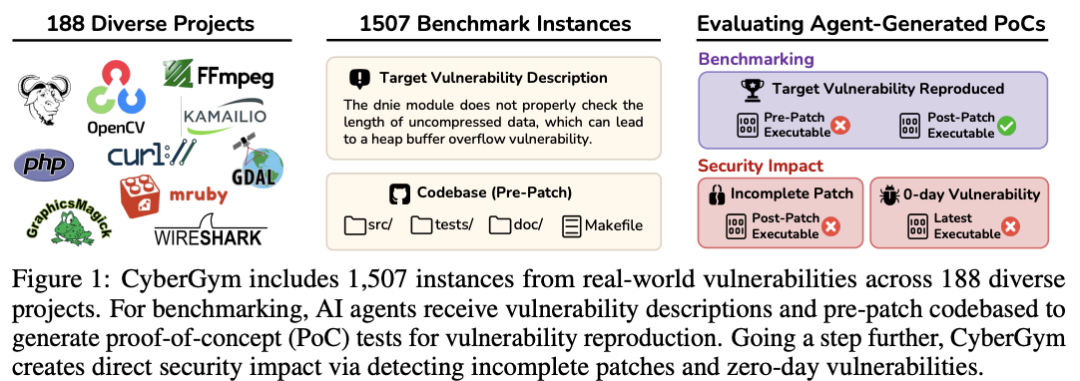
In seiner primären PoC-Generierungskonfiguration erhält der Agent:
Der Agent muss einen Proof-of-Concept generieren, der die Schwachstelle auslöst.
Der Benchmark bewertet dann das Verhalten
gegenüber der verwundbaren Version und der gepatchten Version.
Eine erfolgreiche Reproduktion sollte in der Regel den erwarteten Kontrast erfüllen:
Vor dem Patch:
PoC löst die Zielschwachstelle aus.

Nach dem Patch:
Das gleiche PoC löst die Schwachstelle nicht mehr aus.
CyberGym verwendet reale Schwachstellen aus wichtigen Open-Source-Projekten, einschließlich solcher aus dem OSS-Fuzz-Ökosystem.
Seine ausführungsbasierte Architektur macht ihn strenger als Benchmarks, die lediglich verlangen, dass das Modell Code klassifiziert oder Erklärungen verfasst.
Die Zahl 95,95 % muss sorgfältig interpretiert werden.
Die primäre Konfiguration von CyberGym versorgt den Agenten mit der Schwachstellenbeschreibung.
Der Agent startet nicht unbedingt mit einer völlig unbekannten Codebasis und ohne Hinweis auf die Existenz der Schwachstelle.
Daher misst der Benchmark eine Form der Reproduktion bekannter Schwachstellen.
Er bedeutet nicht direkt:
Der Benchmark erfordert dennoch anspruchsvolle Arbeit. Der Agent muss in echten Codebasen navigieren, relevantes Verhalten lokalisieren, gültige Trigger konstruieren, Software bauen oder ausführen und Ergebnisse validieren.
Die korrekte Beschreibung lautet:
Die berichtete Punktzahl ist die Schwachstellen-Reproduktionsrate unter der CyberGym-Bewertungskonfiguration, die Microsoft verwendet.
Die erste Version des ursprünglichen CyberGym-Papiers berichtete, dass die stärkste getestete Kombination – OpenHands mit Claude 3.7 Sonnet – eine Reproduktionsrate von 11,9 % erreichte.
Spätere Benchmark-Revisionen, Agenten-Frameworks, Modellgenerationen und Systemdesigns verbesserten die Ergebnisse erheblich.
Die von Microsoft berichteten 95,95 % zeigen, wie schnell sich die Kombination aus Modellen und Tool-Frameworks verbessert.
Dieser Vergleich sollte jedoch nicht als reine Modell-zu-Modell-Verbesserung interpretiert werden.
Diese Systeme unterscheiden sich in Modellgenerationen, Agenten-Frameworks, Prompts, Tools, Validierung, Rechenbudgets, Kosten, Aufgabenrouting, Benchmark-Versionen, Infrastruktur und Wiederholungsstrategien.
Der Fortschritt ist real, aber es ist Fortschritt auf Systemebene.
Der Quellartikel stellte fest, dass die 95,95-%-Ergebnisse von Microsoft zum Zeitpunkt der Veröffentlichung noch nicht in der öffentlichen CyberGym-Rangliste erschienen waren.
Die frühere Microsoft-Konfiguration vom Mai, berichtet mit etwa 88,4 %–88,45 %, wurde zuvor öffentlich als Benchmark-Führender veröffentlicht.
Die neuen 95,95 %-Daten wurden von Microsoft in der MAI-Cyber-1-Flash-Ankündigung, der Modellkarte sowie in der Project-Perception-Ankündigung von Microsoft veröffentlicht.
Bis ein externer Ranglisteneintrag oder eine unabhängige Reproduktion verfügbar ist, sollte es als von Microsoft berichtetes Ergebnis bezeichnet werden.
Das macht das Ergebnis nicht bedeutungslos. Es bedeutet, dass die Leser unterscheiden sollten zwischen:
Vom Anbieter berichteten Bewertungen
und
unabhängig reproduzierten öffentlichen Ergebnissen
Diese Unterscheidung ist bei sich schnell ändernden Benchmark-Vergleichen besonders wichtig.
Microsoft
betrachtet seine historischen Sicherheitsdaten als seinen tiefsten Vorteil.
Das Unternehmen gibt an, täglich über 100 Billionen Sicherheitssignale zu verarbeiten und über operative Einblicke von 1,6 Millionen Kunden zu verfügen.
Seine Sicherheitsabdeckung umfasst Identitäten, Endpunkte, Cloud, Netzwerk, Daten, Browser und Anwendungen.
Der Wert liegt nicht nur in der Anzahl der Ereignisse.
Das Unternehmen kann Sicherheitsmaßnahmen mit Ergebnissen verknüpfen:
Welche Patches das Problem behoben haben.
Das bildet eine Rückkopplungsschleife.
Sicherheitsvorfall
→ Untersuchung
→ Verifikation
→ Behebung
→ Beobachtete Ergebnisse
→ Bessere Daten und Erkenntnisse
→ Verbesserte Modelle und Agenten
Wettbewerber können Zugang zu ähnlichen Basismodellen erhalten.
Aber sie können nicht über Nacht eine jahrzehntelang validierte Betriebshistorie nachbilden.
Nur wenn große Datenmengen in Trainings-, Bewertungs- und Betriebskontext umgewandelt werden, sind sie wertvoll.
Rohe Sicherheitssignale können repetitiv, verrauscht, unvollständig, kundenspezifisch, sensibel, falsch beschriftet, auf sichtbare Angriffe ausgerichtet sein oder es fehlen Endresultate.
Datenpipelines müssen Ereignisse mit vertrauenswürdigen Beschriftungen und Ergebnissen verknüpfen.
Zum Beispiel:
Alarm ausgelöst
→ Analystenuntersuchung
→ Schwachstelle bestätigt
→ Patch bereitgestellt
→ Exploit funktioniert nicht mehr
Diese Sequenz ist wertvoller als ein einzelner Alarm.
Der Burggraben entsteht aus Daten plus Datenaufbereitung, Feedback, Bewertung und Sicherheitsbetriebszugang.
Das Drei-Teile-Framework von Microsoft bietet eine nützliche Methode zur Bewertung jedes unternehmensweiten KI-Sicherheitssystems.
Fragen umfassen:
Fragen umfassen:
Fragen umfassen:
Ein System mit starkem Modell, aber schwachen Daten und mangelnder Validierung kann beeindruckende, aber unzuverlässige Berichte erzeugen.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Ein gut gestaltetes System kann durch die Zuweisung passender Aufgaben an kleinere Modelle und die Prüfung ihrer Arbeit nützlicher werden.
Microsoft sieht die Token-Kosten als zentrale Einschränkung, wenn Sicherheitsprüfungen kontinuierlich laufen.
Betrachten wir eine vereinfachte Arbeitslast:
10 Millionen Code-Analyse-Aufgaben pro Monat
Wenn jede Aufgabe das teuerste Spitzenmodell verwendet, könnte das System bei vollständiger Abdeckung ins Schwanken geraten.
Ein Routing-Design verändert die durchschnittlichen Kosten:
90% kostengünstige spezialisierte Modelle
+
10% teure Spitzenmodelle
Die tatsächliche
Wirtschaftlichkeit hängt auch von Eingabelänge, Ausgabelänge, Tool-Aufrufen, Wiederholungen, Sandbox-Ausführung, Code-Indexierung, Validierung, manueller Überprüfung, Infrastruktur und Datenspeicherung ab.
Modell-Token-Gebühren sind nur eine Komponente.
Dennoch bietet die Routing-Mechanik eine starke Optimierungsmöglichkeit, da teure Modelle selektiv eingesetzt werden.
Benchmark-Tests können einzelne Modelle unter einem einheitlichen Testrahmen vergleichen.
Produkte müssen den vollständigen Workflow optimieren.
Das beste System könnte Modelle verwenden, die in Einzelrankings nicht an erster Stelle stehen, wenn das Modell bessere Geschwindigkeit, Kosten, Spezialisierung, Vorhersagbarkeit, Tool-Nutzung, Kontexteffizienz, Sicherheitskalibrierung und Kompatibilität mit dem Testrahmen bietet.
Das ähnelt anderen Produktionssystemen.
Datenbanken wählen nicht für jede Abfrage denselben Algorithmus. Cloud-Scheduler legen nicht jede Arbeitslast auf die größte Maschine. Sicherheitssysteme sollten nicht jede Aufgabe an das teuerste Modell senden.
Cybersicherheitsmodelle bringen besondere Sicherheitsrisiken mit sich.
Dieselbe Fähigkeit, die Verteidigern hilft, Schwachstellen zu validieren, könnte auch Angreifern helfen, Schwachstellen auszunutzen.
Daher beschränkt Microsoft den Zugriff auf MAI-Cyber-1-Flash.
Das Modellkarten-Dokument besagt:
Microsoft gibt an, dass das Modell mit einem sicherheitsorientierten Ansatz kalibriert, vom Microsoft AI Red Team bewertet, durch automatisierte adversariale Übungen getestet, von Sicherheitsexperten geprüft und von unabhängigen Dritten evaluiert wurde.
Angeblich ergab die unabhängige Bewertung keine Probleme mit schwerwiegendem Schweregrad.
Das beweist nicht, dass das Modell risikofrei ist. Es erklärt, warum das Unternehmen mit einer eingeschränkten Bereitstellung beginnt und nicht mit einer uneingeschränkten öffentlichen Veröffentlichung.
Microsofts Modellkarte listet mehrere Einschränkungen auf.
Das Modell wurde hauptsächlich auf Englisch trainiert und evaluiert. In anderen Sprachen kann die Leistung niedriger sein.
Wie andere Sprachmodelle kann es ungenaue, unvollständige oder fehlerhafte Code- und Textausgaben erzeugen. Ausgaben müssen überprüft und validiert werden.
Das Modell ist bewusst darauf kalibriert, vorsichtig zu handeln. Wenn legitime defensive Anfragen mehrdeutig sind oder schädlichen Aktivitäten ähneln, können Sicherheitsmechanismen ausgelöst werden.
Das Modell ist speziell für MDASH entwickelt. Einzelne Ergebnisse repräsentieren nicht die Fähigkeiten des vollständigen Systems.
Die Verwendung außerhalb genehmigter defensiver Sicherheitsoperationen wird nicht unterstützt.
Die MDASH-Ankündigung von Microsoft im Mai enthielt Beispiele aus realer Sicherheitsforschung.
Das Unternehmen berichtete, das Testframework an einem unveröffentlichten Beispieltreiber mit 21 absichtlich eingefügten Schwachstellen getestet zu haben. Es gab an, dass MDASH unter kontrollierten Tests alle 21 Schwachstellen mit null Fehlalarmen identifiziert habe.
Microsoft berichtete außerdem, dass MDASH dabei half, 16 CVEs zu identifizieren, die im Mai veröffentlicht wurden.
Patch-Dienstag für Windows 2026.
Dies sind eigene Produkt- und Forschungsaussagen von Microsoft.
Sie sind für die Bereitstellung relevanter als Benchmark-Ergebnisse, da sie private Codebasen, reale Engineering-Workflows, Schwachstellenvalidierung, Patch-Prozesse und Überprüfung durch Sicherheitsteams betreffen.
Gleichzeitig können ausgewählte Fallstudien keine universelle Fehlalarm- oder Erfolgsrate über alle Codebasen hinweg begründen.
Microsoft hat Project Perception als größeres agentenbasiertes Sicherheitssystem vorgestellt.
Das Ziel ist der Übergang von KI, die Verteidiger unterstützt, zu KI, die mehr Sicherheitsworkflows übernimmt, während kritische Entscheidungen der menschlichen Kontrolle überlassen bleiben.
Project Perception koordiniert drei Kategorien von Agenten:
| Agentenkategorie | Hauptaufgaben |
|---|---|
| Rote Agenten | Simulieren die Denkweise von Angreifern und identifizieren mögliche Einbruchspfade |
| Blaue Agenten | Führen Untersuchungen durch, schlussfolgern kontextbasiert, erkennen und priorisieren sinnvolle Risiken |
| Grüne Agenten | Beheben, härten Systeme ab und reduzieren die Angriffsfläche |
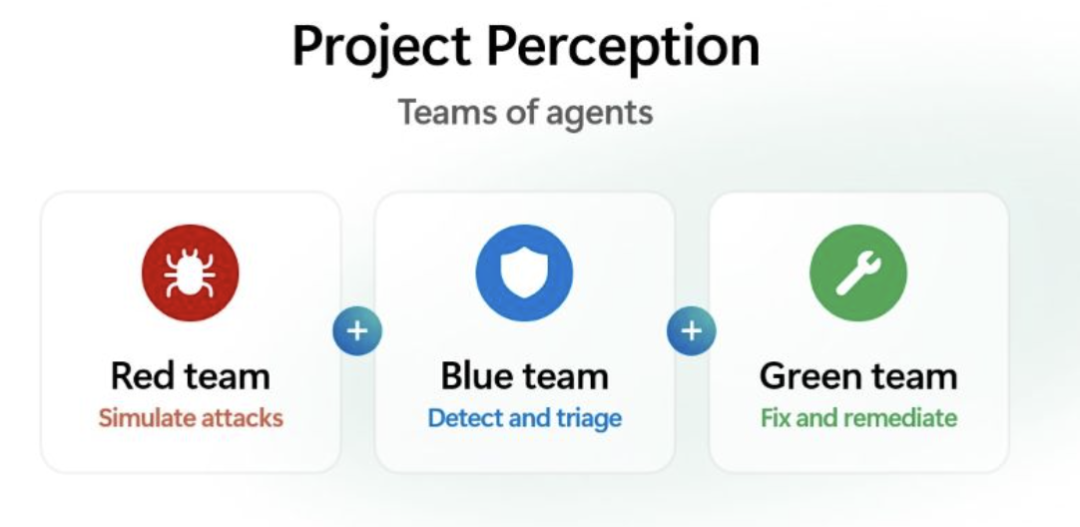
Diese drei Rollen bilden einen Kreislauf:
Rote Agenten entdecken Pfade
→ Blaue Agenten validieren und priorisieren
→ Grüne Agenten beheben
→ Das System beobachtet Ergebnisse
→ Zukünftige Verteidigungsfähigkeiten werden verbessert
Microsoft gibt an, dass Project Perception am 3. August 2026 in die öffentliche Vorschauphase eingetreten ist.
Microsoft beschreibt das System als mehrere miteinander verbundene Ebenen.
Das System beobachtet Endpunkte, Identitäten, Cloud, Anwendungen und andere Teile digitaler Vermögenswerte.
Rohsignale werden in verknüpfte Darstellungen von Vermögenswerten, Identitäten, Beziehungen, Richtlinien, Risiken, Aktivitäten und historischen Ereignissen umgewandelt.
Die Plattform verfolgt eine Multimodell-Strategie, einschließlich spezialisierter Cyber-Modelle wie MAI-Cyber-1-Flash.
Der Koordinierungsrahmen koordiniert Modelle, Agenten, Tools, Workflows, Tests, Berechtigungen und Kontrollmaßnahmen.
Rote, blaue und grüne Agenten führen spezialisierte Sicherheitsarbeit aus.
Ausführungsaktoren setzen Entscheidungen in tatsächliche Aktionen in integrierten Sicherheitsprodukten um.
Diese Architektur geht weit über einen Chatbot hinaus. Sie zielt darauf ab, ein kontinuierlich laufendes Sicherheitsbetriebssystem zu bilden.
Menschen bleiben für kritische Entscheidungen verantwortlich
Microsoft stellt klar, dass Menschen weiterhin die Kontrolle über weitreichende Aktionen behalten.
Die Projekt-Perception-Seite beschreibt die Arbeitsteilung wie folgt:
Agenten übernehmen die Arbeit.
Menschen übernehmen das Urteilen.
Verteidiger legen Ziele, Strategien, Schutzgrenzen, Genehmigungsanforderungen, Umfang und Reaktionsprioritäten fest.
Weitreichende Aktionen erfordern weiterhin menschliche Genehmigung.
Dies ist notwendig, da Sicherheitskorrekturen selbst Schaden anrichten können.
Automatisierte Systeme könnten legitime Konten deaktivieren, Produktionsdatenverkehr blockieren, kritische Dateien löschen,
ein Geschäftssystem isolieren, fehlerhafte Patches bereitstellen oder den Betrieb unterbrechen.
Die Kosten einer falschen Aktion können höher sein als die Kosten einer übersehenen Meldung.
Microsoft beschreibt Security Copilot als eine KI-gestützte, dialogorientierte Oberfläche.
Projekt Perception wird als ein breiteres Agentensystem positioniert.
| Produktkonzept | Rolle |
|---|---|
| Security Copilot | Unterstützende KI über eine generative Oberfläche |
| Projekt Perception | KI-Agenten, die in Sicherheitsworkflows kontinuierlich denken und handeln |
Die beiden Produkte sind für die Zusammenarbeit konzipiert.
Menschen können Copilot nutzen, um Arbeit zu verstehen und zu steuern, während Perception-Agenten mehr kontinuierliche Betriebsprozesse übernehmen.
Microsoft gibt an, dass Projekt Perception eine verbrauchsbasierte Preisgestaltung verwendet, gemessen in Security Compute Units (SCUs).
Verschiedene Agenten verbrauchen je nach Aufgabenintensität unterschiedliche Ressourcen.
Dadurch wird die Effizienz von Modellen und Workflows wirtschaftlich entscheidend.
Red-Team-Simulationen, schnelle Klassifizierungsaufgaben und langfristige Korrektur-Workflows können unterschiedliche Ressourcen verbrauchen.
Die in MDASH verwendete Multi-Modell-Routing-Strategie entspricht diesem breiteren Preismodell.
Wenn Routinearbeit von kleineren spezialisierten Modellen übernommen werden kann, könnte dasselbe Budget mehr Sicherheitsabdeckung ermöglichen.
Der Zugang zu Spitzenmodellen wird zunehmend weniger knapp.
Organisationen können zunehmend leistungsstarke öffentliche Modelle per API aufrufen.
Der knappe Teil könnten Systeme sein, die feststellen können, ob die Sicherheitsbehauptungen eines Modells zutreffen.
Dieses System benötigt ausführbare Umgebungen, Build-Infrastruktur, Versionskontrolle, Beweisgenerierung, Patch-Vergleich, Sicherheitswissen, Sandboxing, Deduplizierung, menschliche Überprüfung und Nachweisverfolgung.
Im Sicherheitsbereich sind schöne Erklärungen ohne Beweise oft unzureichend.
Der Burggraben verschiebt sich von:
Zugang zu leistungsstarken Modellen
hin zu:
Vertrauenswürdige Prozesse zur Verifizierung und Umsetzung von Modellarbeit
Nicht automatisch das teuerste Modell für jeden Vorgang verwenden.
Bewertungssets aufbauen, um zu bestimmen, welche Aufgaben zuverlässig von kleineren spezialisierten Modellen bewältigt werden können.
Ein Agent oder Modell kann Kandidaten generieren. Ein anderer Agent, ein Tool oder ein deterministischer Test sollte diese verifizieren.
Wo möglich reproduzierbare Tests verlangen, anstatt textliche Behauptungen zu akzeptieren.
Automatisierung von Sammlung, Analyse und Verifikation priorisieren. Destruktive oder produktionsbeeinflussende Aktionen hinter Genehmigungs-Gates belassen.
Der reine Token-Preis ist nicht die richtige Kennzahl.
Ein günstiges Modell, das viele Fehlalarme erzeugt, kann auf Betriebsebene teurer sein.
Nützliche Kennzahlen umfassen Kosten pro bestätigter Schwachstelle, Verifikationszeit, Fehlalarmrate, menschliche Überprüfungszeit, Patch-Akzeptanzrate und Regressionsrate.
Modellgenerationen wechseln schnell.
Aufgabendefinitionen, Tools, Verifikation und Sicherheitskontrollen sollten wiederverwendbar bleiben, wenn das zugrunde liegende Modell ausgetauscht wird.
Ergebnisse protokollieren, nicht nur Warnungen.
Das System sollte lernen, welche Befunde echt sind und welche Korrekturen wirksam sind.
Das CyberGym-Repository warnt davor, seine Dienste dem öffentlichen Internet auszusetzen.
Microsoft beschreibt ebenfalls sandboxartige, netzwerkisolierte Umgebungen für Tests.
Die Reproduktion von Schwachstellen sollte in kontrollierter Infrastruktur erfolgen.
Eine ernsthafte Bewertung sollte nicht nur aus einer Headline-Zahl bestehen.
Die 95,95 %-Punktzahl ist wichtig, sollte aber nicht über den Evidenzrahmen hinaus verallgemeinert werden.
Das Ergebnis entsteht durch MDASH, mehrere Agenten, zwei Modellstufen, Tools und Daten.
Das Ergebnis wurde von Microsoft veröffentlicht. Unabhängige Replikationsverifikation ist weiterhin wertvoll.
CyberGym misst eine klar definierte Schwachstellenreproduktionsaufgabe.
Das Fehlalarmverhalten in der Produktion muss separat gemessen werden.
Microsoft behält sich die menschliche Freigabe für kritische Aktionen vor.
MAI-Cyber-1-Flash ist nur für genehmigte MDASH-Kunden in der privaten Vorschau verfügbar.
Die Ergebnisse können je nach Sprache, Schwachstellenkategorie, Codebasis, Tools und Benchmark-Framework variieren.
MDASH ist das Multi-Modell-, Multi-Agenten-System von Microsoft zur Identifizierung, Verifizierung, Priorisierung und Behebung von Software-Schwachstellen. Es kombiniert spezialisierte Agenten, mehrere Modelle, Code-Analysewerkzeuge, Generierung von Verifikationsbeweisen, Verifikation und Unternehmenssicherheitskontrollen.
MAI-Cyber-1-Flash ist das auf Cybersicherheit spezialisierte spärliche MoE-Modell von Microsoft. Die offizielle Modellkarte zeigt 137 Milliarden Gesamtparameter, 5 Milliarden aktive Parameter, einen Kontextfenster von 256K und kontrollierten Zugriff.
Es wird über MDASH in der privaten Vorschau von Azure AI Foundry bereitgestellt.
Nein. Die 95,95 %-Punktzahl gehört zur vollständigen MDASH-Konfiguration unter Verwendung von MAI-Cyber-1-Flash, GPT-5.4, Agenten, Tools, Daten und Verifikationsprozessen. Die unabhängige Modellkarte von Microsoft zeigt auf mehreren anderen Netzwerk-Benchmarks andere und niedrigere Ergebnisse.
Microsoft gibt an, dass MAI-Cyber-1-Flash dafür ausgelegt ist, bis zu 90 % der Aufgaben in gerouteten MDASH-Workflows zu übernehmen. Dies bedeutet nicht, dass das Modell unabhängig 90 % aller Schwachstellen findet oder behebt.
CyberGym bewertet hauptsächlich, ob ein Agent basierend auf einer Schwachstellenbeschreibung und einer Codebasis vor dem Patch einen Proof-of-Concept (PoC) generieren kann, der eine bekannte reale Schwachstelle reproduziert. Dieser PoC wird gegen die verwundbare und die gepatchte Version getestet.
Die Punktzahl wurde von Microsoft in seiner Ankündigung und Modellkarte veröffentlicht. Zum Zeitpunkt der Beschreibung im Quellartikel war das Ergebnis noch nicht als aktualisiertes Ergebnis auf öffentlichen Benchmark-Ranglisten erschienen und sollte daher als von Microsoft selbst berichtete Daten bezeichnet werden.
Es gibt keine öffentlichen Aufzeichnungen über einen Modelldownload. Microsoft gibt an, dass das Modell nur über die private Vorschau von Azure AI Foundry für ausgewählte MDASH-Kunden verfügbar ist.
Vom Kunden bereitgestellt und muss geprüft und freigegeben werden.
Project Perception ist das breiter angelegte agentische Sicherheitssystem von Microsoft. Es orchestriert Red-Team-, Blue-Team- und Green-Team-Agenten über die Workflows Erkennung, Untersuchung, Behebung und Härtung, während kritische Entscheidungen weiterhin beim Menschen liegen.
com/en-us/security/blog/2026/05/12/defense-at-ai-speed-microsofts-new-multi-model-agentic-security-system-tops-leading-industry-benchmark/: Technischer Überblick von Microsoft über das Framework, die Validierungsarchitektur, Sicherheitsforschung und die ersten CyberGym-Ergebnisse.
Microsoft berichtet, dass MDASH nach der Integration von MAI-Cyber-1-Flash und dem Routing der schwierigsten Fälle an GPT-5.4 eine Erfolgsquote von 95,95 % auf CyberGym erreicht hat. Das Unternehmen berichtet außerdem von einer Kostensenkung um 50 % gegenüber der bisher stärksten Modellkonfiguration.
Dieses Ergebnis stammt nicht von einem einzelnen Modell. Es stammt von einem multimodalen Sicherheitssystem mit über 100 Agenten, historischen Sicherheitsdaten, spezialisierten Tools, Beweiserzeugung, Validierung, Deduplizierung, Sandboxing und menschlich gestalteter Orchestrierung.
CyberGym testet hauptsächlich die Fähigkeit, bekannte Schwachstellen aus Beschreibungen und Code vor dem Patch zu reproduzieren. Die Punktzahl belegt daher eine starke Schwachstellenreproduktionsleistung auf diesem Benchmark – nicht allgemeine Zero-Day-Erkennung oder autonome Behebungsraten.
Project Perception überträgt dieselbe Systemphilosophie über die Codescanning hinaus: Rote Agenten decken Risiken auf, blaue Agenten untersuchen Risiken, grüne Agenten beheben Risiken, während kritische Entscheidungen weiterhin beim Menschen liegen.
Die zentrale Erkenntnis ist, dass sich der Vorsprung im Bereich Cybersicherheit von der Beschaffung eines einzelnen leistungsstarken Modells hin zur Fähigkeit verschiebt, mehrere Modelle innerhalb eines vertrauenswürdigen Sicherheitssystems zu routen, zu validieren und zu betreiben.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



