For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/minicpm-v-4-7-35b-moe-on-iphone-les-and-l-9db57311.md.
MiniCPM-V 4.7 bringt ein Mixture-of-Experts-Modell mit 35 Milliarden Parametern auf lokale Geräte, einschließlich Smartphones. ModelBest und...

MiniCPM-V 4.7 bringt ein Mixture-of-Experts-Modell mit 35 Milliarden Parametern auf lokale Geräte, einschließlich Smartphones. ModelBest und OpenBMB berichten bei Verwendung eines optimierten Bereitstellungs-Stacks von mehr als 13 generierten Tokens pro Sekunde bei rund 3 GB Arbeitsspeicher auf einem iPhone 17 Pro Max.
Diese Zahl benötigt Kontext. Sie bedeutet weder, dass das vollständige 35B-Modell in einen 3-GB-Download passt, noch dass jedes Smartphone mit 3 GB RAM es mit der angegebenen Geschwindigkeit ausführen kann. Das Modell streamt Expertengewichte aus dem Speicher und nutzt Scheduling, Quantisierung und Inferenzoptimierungen, um den aktiven Arbeitssatz klein zu halten.
Die Veröffentlichung umfasst zwei Hauptvarianten:
| Variante | Aufbau | Vorgesehener Einsatz |
|---|---|---|
| MiniCPM-V 4.7 35B-A3B | MoE mit insgesamt 35B Parametern und etwa 3B aktiven Parametern pro Token | Stärkeres lokales Verständnis von Bildern, Dokumenten, mehreren Bildern und Videos |
| MiniCPM-V 4.7 1B | Kleines dichtes Modell; QbitAI beschreibt ungefähr 1,3B Parameter | Visuelle Aufgaben mit geringerem Ressourcenbedarf, OCR und Dokumentenextraktion |
Das 35B-A3B-Modell ist das erste MoE der MiniCPM-V-Reihe. Das Projekt kündigte Version 4.7 am 12. Oktober 2026 an, gefolgt von DSpark-Entwürfen für spekulatives Decoding für beide Varianten am 15. Oktober.
Das Repository führt Unterstützung für die Bereitstellung auf iOS, Android und HarmonyOS auf. Es beschreibt außerdem Unterstützung für Plattformen von Intel, AMD, Arm, Rockchip und Houmo. Die tatsächliche Leistung hängt vom Gerät, Modellformat, Inferenz-Backend und den Einstellungen ab. Plattformunterstützung sollte daher nicht als identische Geschwindigkeit auf jeder Hardware verstanden werden.
Die offizielle Bewertungstabelle für 35B-A3B berichtet im Instruct-Modus die folgenden Ergebnisse:
| Benchmark | 4× visuelle Komprimierung | 16× visuelle Komprimierung |
|---|---|---|
| MMBench | 91,72 | 90,87 |
| MMStar | 80,67 | 80,13 |
| MMMU | 80,22 | 80,00 |
| MathVista | 88,00 | 87,30 |
| OCRBench | 91,20 | 90,40 |
| OmniDocBench v1.6 | 94,24 | 93,25 |
| Video-MME, ohne Untertitel | 76,40 | 74,70 |
| LongVideoBench | 68,90 | 67,60 |

Quelle: OpenBMB, MiniCPM-V-Repository. Die Tabelle kombiniert öffentliche Berichte mit lokalen Bewertungen des Teams unter Verwendung offizieller Checkpoints im Instruct-Modus.
Die Tabelle zeigt bei mehreren Aufgaben relativ kleine Rückgänge beim Wechsel zu stärkerer visueller Komprimierung. MMBench sinkt beispielsweise um 0,85 Punkte, während OCRBench um 0,80 Punkte sinkt. Bei anderen Aufgaben sind die Verluste größer. Entwickler müssen daher weiterhin prüfen, ob kleiner Text, Diagramme oder visuelle Details für ihren jeweiligen Anwendungsfall entscheidend sind.
Dies sind Modellergebnisse aus Bewertungen, kein Nachweis dafür, dass die mobile Konfiguration jeden Wert reproduziert oder dass jedes Nutzerbild korrekt interpretiert wird. Sie sind nützliche Referenzpunkte für die Auswahl der zu testenden Fälle.
MoE reduziert die Rechenlast, indem für ein Token nur ausgewählte Experten aktiviert werden. Es beseitigt jedoch nicht die Notwendigkeit, die übrigen Experten zu speichern, da spätere Tokens und Schichten andere Experten auswählen können.
Auf einem Smartphone mit begrenztem Arbeitsspeicher werden diese Gewichte im Flash-Speicher verfügbar gehalten. Wiederholtes Warten auf den Speicherzugriff kann das Decoding jedoch verlangsamen. Eine Beschränkung des Routings auf eine feste Teilmenge von Experten reduziert zwar das Laden, verändert aber auch, welche Experten das Modell verwenden kann. MiniCPM-V 4.7 versucht stattdessen, das Laden mit der Berechnung zu überlappen und zugleich die tatsächlichen Entscheidungen des Routers beizubehalten.
Lookahead Expert Scheduling oder LES prognostiziert, welche Experten die nächste Schicht voraussichtlich benötigt, und lädt deren Gewichte vorab. Wenn der tatsächliche Router Experten auswählt, berechnet die Engine zunächst die ausgewählten Experten, die bereits verfügbar sind, während sie die verbleibenden erforderlichen Experten lädt.
Die Vorhersage verändert die Vorbereitungs- und Ausführungsreihenfolge. Sie ersetzt nicht die Routing-Entscheidung des Modells: Experten, die durch die Vorhersage nicht erfasst wurden, werden weiterhin geladen und ausgewertet. Diese Unterscheidung erklärt, warum die Technik die Geschwindigkeit verbessern kann, ohne auf einen dauerhaft reduzierten Expertenpool angewiesen zu sein.
Der offizielle Leitfaden kombiniert LES mit feingranularer schichtweiser Quantisierung. Kleinere Expertengewichte reduzieren den Datenverkehr zwischen Speicher und Arbeitsspeicher, während ein optimiertes Layout das Laden effizienter macht. Das Team berichtet für seine On-Device-Optimierungsarbeit eine fünffache Verbesserung beim Decoding auf realen Geräten; dies ist ein Ergebnis der getesteten Konfiguration und kein universeller Multiplikator.
DSpark fügt ein Entwurfsmodell hinzu, das Tokens vorschlägt, welche das Hauptmodell überprüft. Die Veröffentlichung stellt dedizierte Entwurfs-Head-Modelle für beide Größen bereit. Dies ist ein weiterer Bestandteil des optimierten Stacks. Daher sollte nicht angenommen werden, dass ein Standard-Checkpoint in einem generischen Backend dieselbe Geschwindigkeit erreicht.
Auf der visuellen Seite nutzt das Modell eine frühe Komprimierung innerhalb des Vision Encoders auf Basis von LLaVA-UHD v4. Das frühe Zusammenführen visueller Tokens reduziert den Aufwand in späteren Encoder-Schichten. Die wählbaren Einstellungen 4× und 16× machen den Zielkonflikt zwischen visuellen Details und Inferenzkosten sichtbar.
Die offizielle Dokumentation der mobilen App vermittelt ein deutlich klareres Bild der vollständigen Bereitstellung:
| Element der mobilen Bereitstellung | Dokumentierte Anforderung oder Größe |
|---|---|
| Validiertes Smartphone für 35B-A3B | iPhone 17 Pro Max mit 12 GB RAM |
| Empfohlener Geräte-RAM für die 35B-A3B-Demo | Mindestens 12 GB |
| Gesamter Modelldownload für 35B-A3B | Ungefähr 16,6 GB |
| Empfohlener freier Speicher | Ungefähr 17 GB für die Modelldateien |
| Expertenspeicher | Separates Verzeichnis experts/ mit 40 Shards und einem Manifest |
| Standard-Kontextfenster der Demo | 4K Tokens |
Das aufgeteilte mobile Paket unterscheidet sich von einem standardmäßigen vollständigen GGUF-Modell. Seine Hauptdatei mit dem Suffix -les ist auf das passende Expertenverzeichnis angewiesen, und die App prüft, ob die Dateien konsistent sind. Größere Kontextfenster erhöhen den Speicherbedarf des KV-Cache, während ein kleinerer Expertencache auf Geräten mit weniger RAM die Generierung erheblich verlangsamen kann.
Eine geringe Zahl für den Arbeitsspeicher beseitigt nicht den Bedarf an umfangreichem und schnellem lokalem Speicher.
Der Artikel von QbitAI zeigt lokale Beispiele auf Smartphones und Tablets und anschließend separate API-Tests. Diese Unterscheidung ist wichtig: Ein API-Ergebnis ist kein Beleg dafür, dass dieselbe Aufgabe offline auf dem Smartphone ausgeführt wurde.
In der einleitenden iPhone-Demonstration analysiert das Modell Minards Diagramm zu Napoleons Russlandfeldzug. Auf die Frage nach der niedrigsten Temperatur und ihrem Datum identifiziert es −30° Réaumur am 6. Dezember 1812 und rechnet dies mit °C = °Ré × 1.25 in −37,5 °C um.
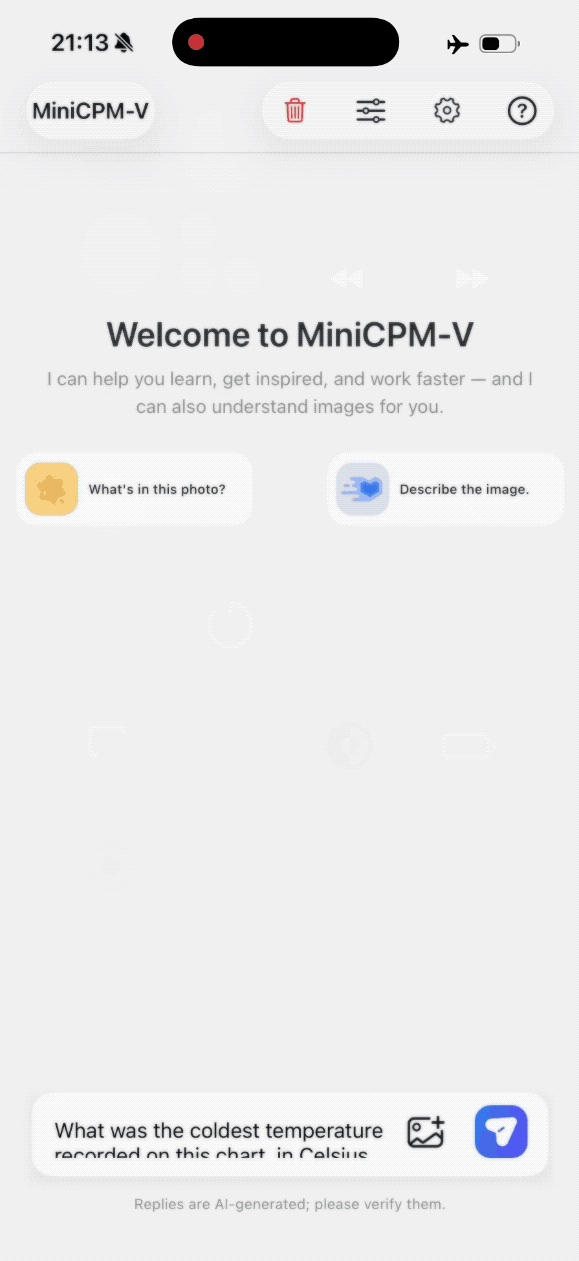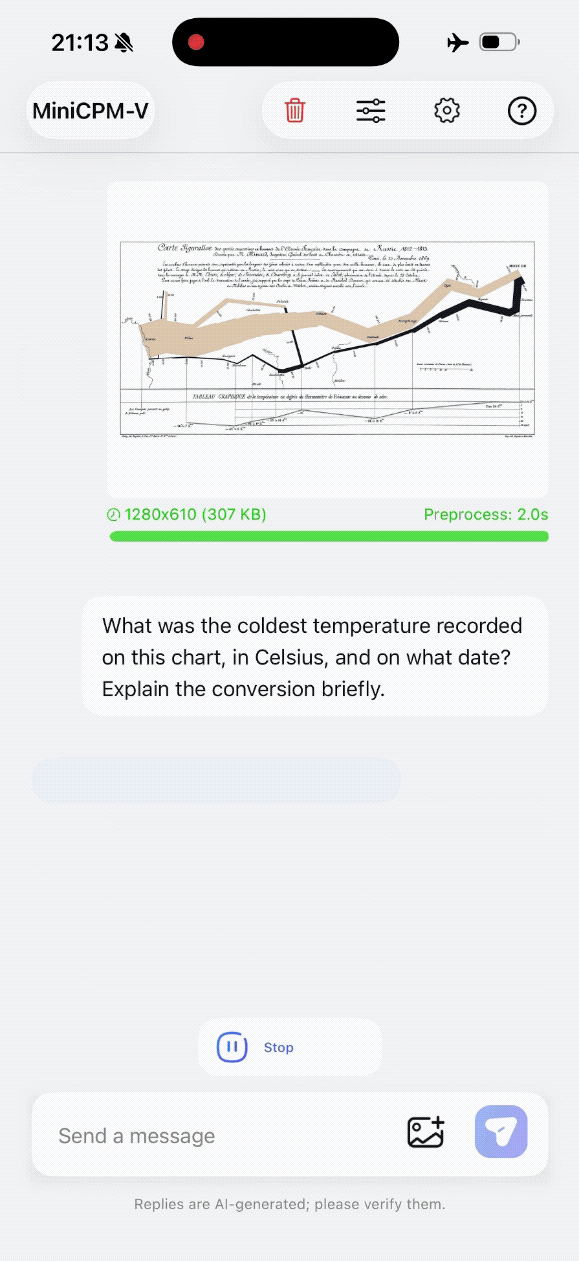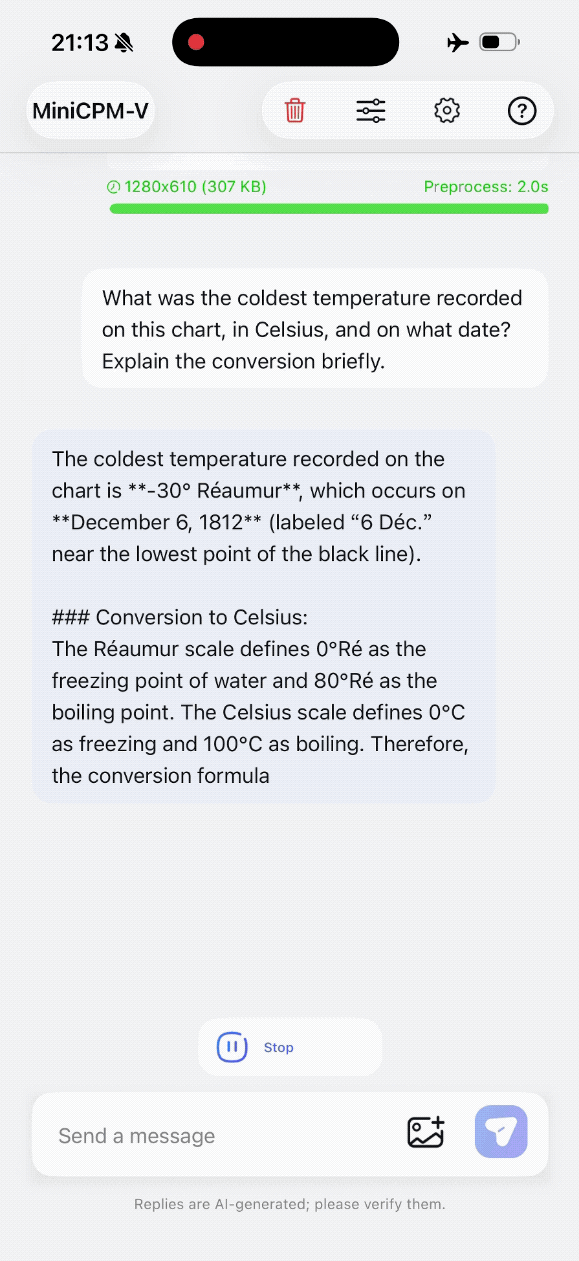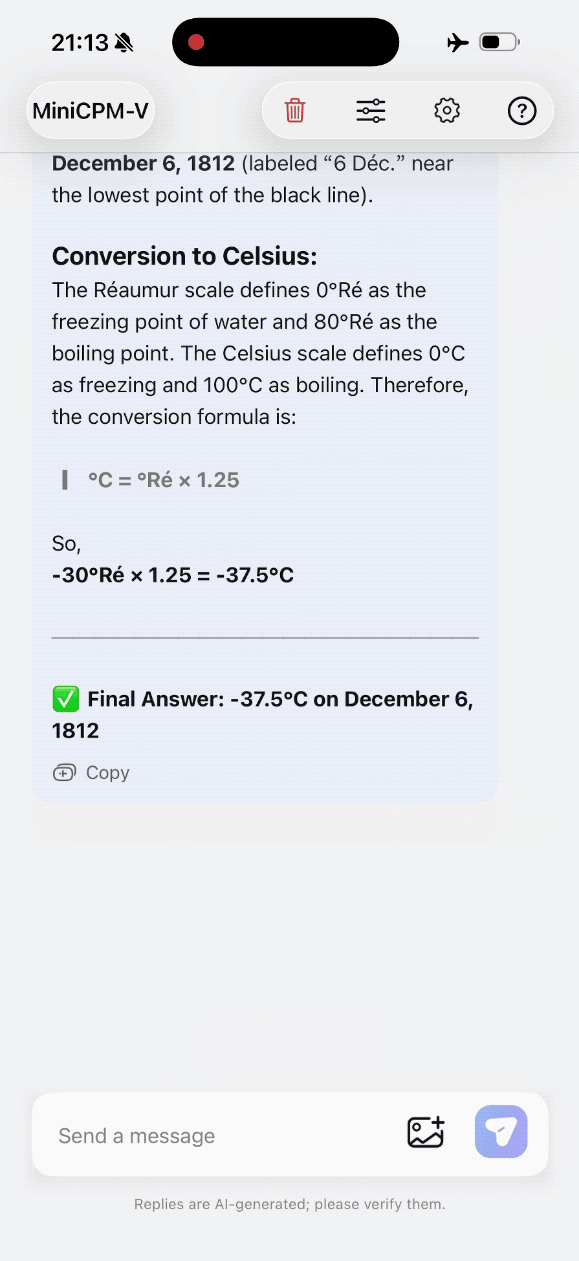
Quelle: QbitAI über BAAI; animierte Bildschirmaufzeichnung eines Smartphones. Die Quelle berichtet außerdem über dieselbe Antwort auf einem M4-iPad.
Dieses Beispiel prüft mehr als Texterkennung. Das Modell muss das Diagramm lesen, einem relevanten Punkt ein Datum zuordnen, die Temperaturskala erkennen und eine Umrechnung durchführen.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Ein weiteres Beispiel kombiniert Leistungsaufnahmen und Nutzungszeiten von Haushaltsgeräten mit einer Monatsrechnung über 420 kWh zu Kosten von ¥126. Die ausgegebene Antwort schätzt für die aufgeführten Geräte 213,63 kWh oder etwa 50,9 % der Rechnung und identifiziert eine verringerte Nutzung der Klimaanlage als besten der drei vorgeschlagenen Sparpläne.
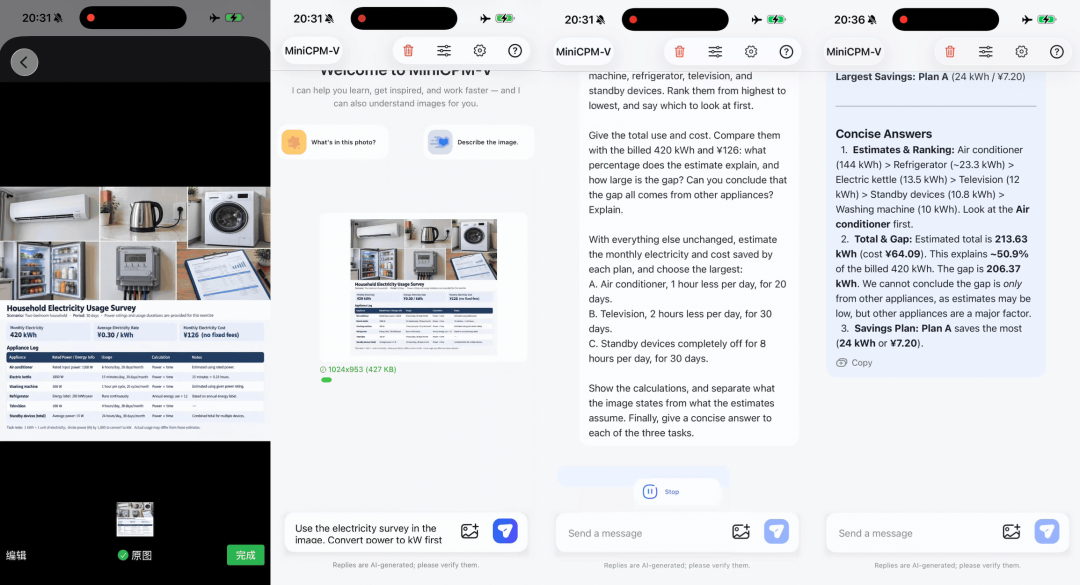
Quelle: QbitAI über BAAI. Die angezeigte Antwort behandelt den nicht erklärten Verbrauch als unsicher, anstatt ihn automatisch anderen Geräten zuzuordnen.
Diese Einschränkung ist nützlich: Geschätzte Nutzungsstunden, die tatsächliche Leistungsaufnahme und nicht berücksichtigte Geräte können den Rechnungsvergleich beeinflussen. Eine korrekte arithmetische Summe allein belegt nicht, warum der verbleibende Verbrauch entstanden ist.
Das kleinere Modell wird dabei gezeigt, wie es eine Paper-Seite in Markdown umwandelt, einschließlich Überschriften, einer Tabelle und mathematischer Notation. QbitAI berichtet, dass die Demonstration weniger als eine halbe Minute dauerte.
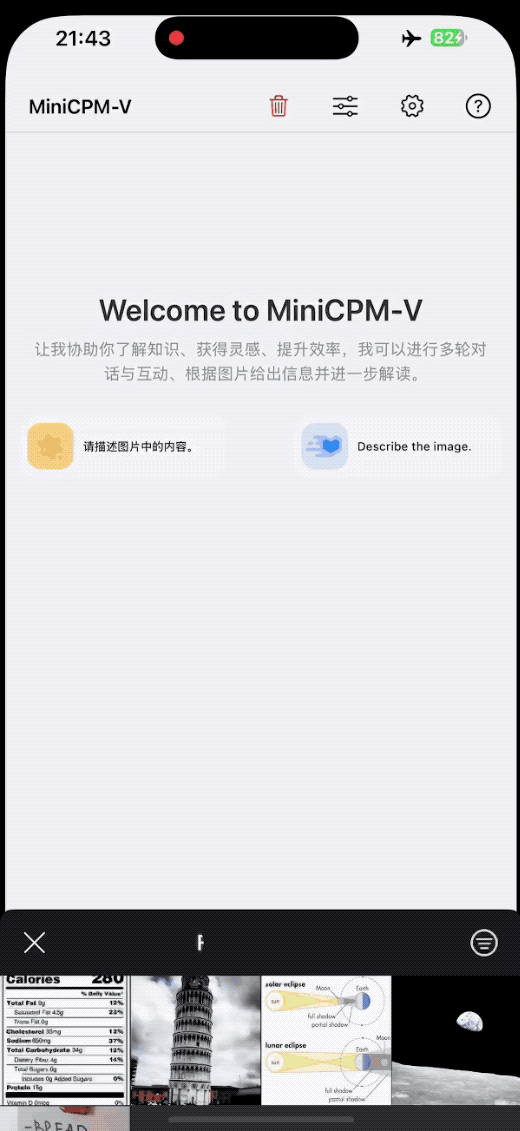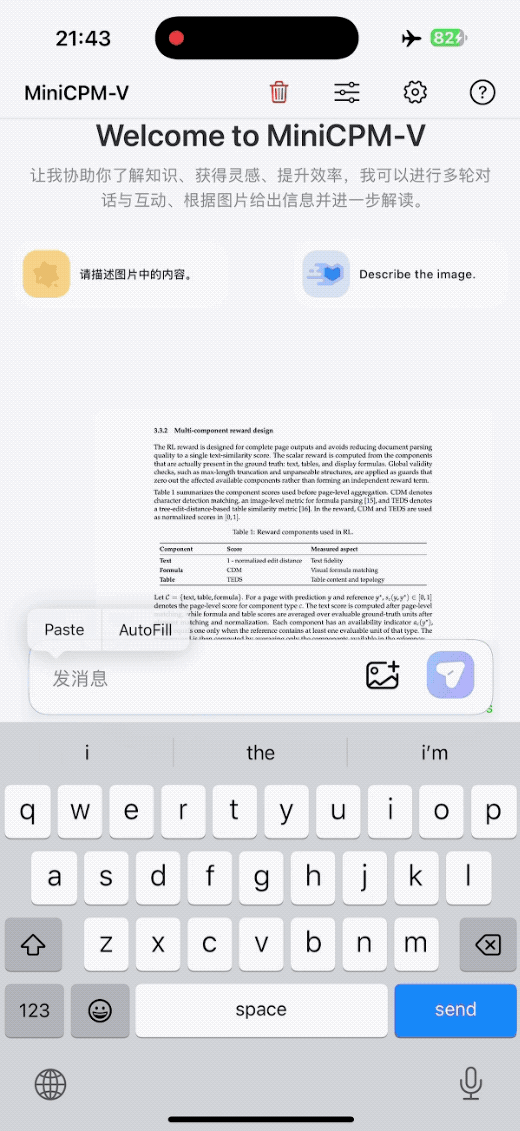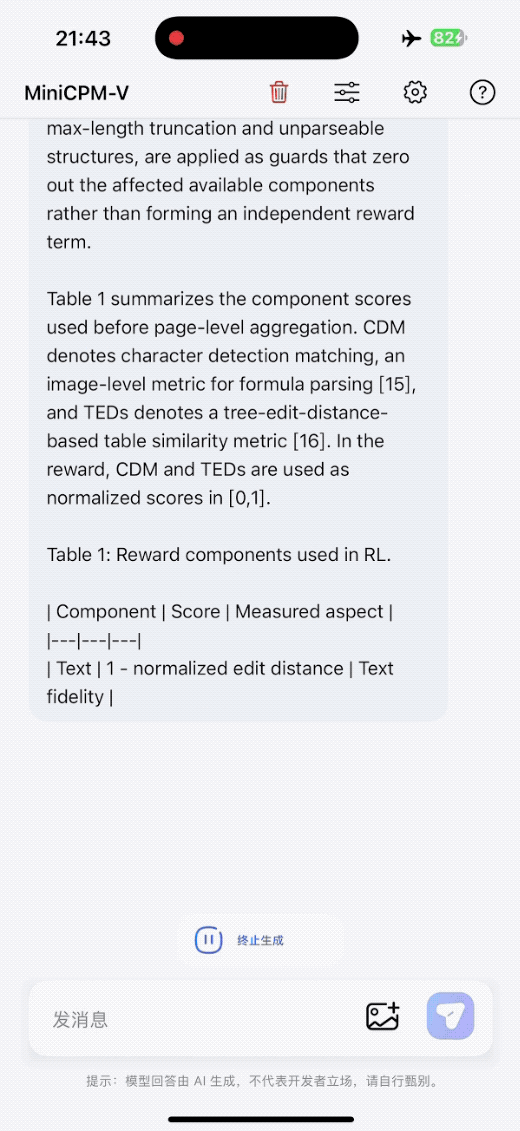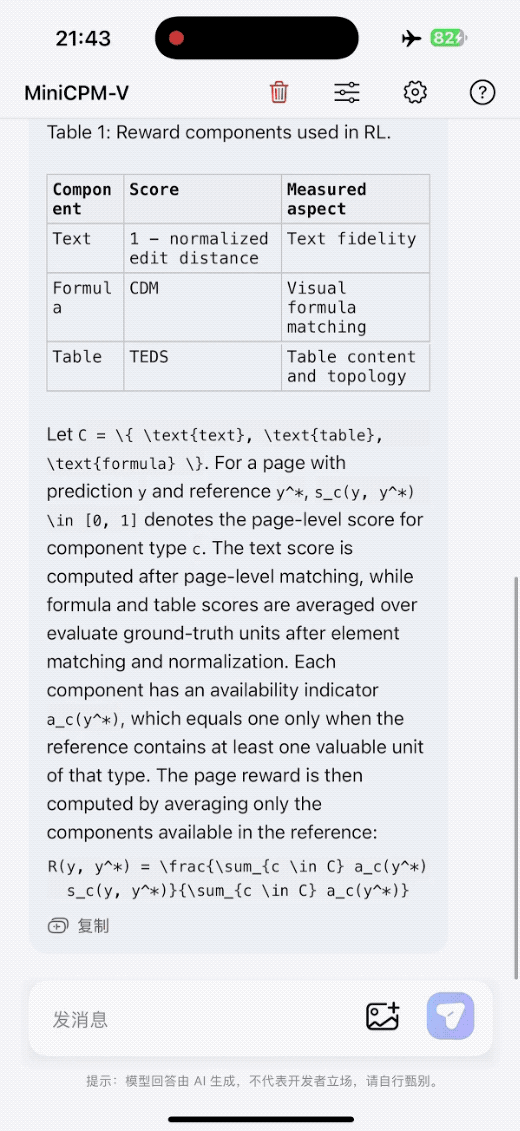
Quelle: QbitAI über BAAI; animierte Demonstration eines lokalen Dokuments.
In separaten API-Tests berichtet der Artikel über eine Belegberechnung von ¥86,40 abzüglich ¥8 Rabatt, entsprechend einer Zahlung von ¥78,40. Außerdem beschreibt er eine Aufgabe zu Parkregeln, bei der ein Aufenthalt von 90 Minuten gegen Reinigungseinschränkungen, ein Zwei-Stunden-Limit, Ausnahmen für Anwohner und Bedingungen für die erneute Einfahrt geprüft wird. Dies sind anschauliche Tests, keine systematische Genauigkeitsstudie.
Eine verwandte Veröffentlichung befasst sich mit Vergessen bei der Anpassung. Self-Replay Fine-Tuning erzeugt allgemeindomänige Antworten aus dem ursprünglichen Modell, filtert sie nach Qualität und mischt die beibehaltenen Beispiele während des standardmäßigen überwachten Fine-Tunings mit den Daten der neuen Aufgabe.
Die Methode verändert die Trainingsdaten und nicht die Modellarchitektur oder Verlustfunktion. Replay-Beispiele können vor dem Training erzeugt und wiederverwendet werden, wodurch der Bedarf an neuen Online-Rollouts in jedem Durchlauf sinkt.
Der Beitrag von OpenBMB berichtet über ermutigende Ergebnisse bei der Beibehaltung von Fähigkeiten in Experimenten zum Zählen und zur Dokumenten-OCR, einschließlich Tests mit früheren MiniCPM-Modellen und anderen Modellfamilien. Diese Ergebnisse sollten nicht als pauschale Garantie für jedes Fine-Tuning von Version 4.7 dargestellt werden. Prompt-Abdeckung, Filterqualität und das Verhältnis von Aufgabendaten zu Replay-Daten bleiben experimentelle Entscheidungen.
Das Repository für mobile Apps stellt Demos für iOS, Android und HarmonyOS bereit. Für den MoE-Pfad auf Smartphones lädt der In-App-Modellmanager die passende Hauptdatei, den Visual Projector und die Experten-Shards herunter. Das Repository warnt, dass gewöhnliche, nicht aufgeteilte Desktop-GGUF-Dateien nicht mit diesem mobilen Paket austauschbar sind.
Für andere Bereitstellungen führt der 4.7-Leitfaden SGLang, vLLM, llama.cpp und Ollama sowie SWIFT und LLaMA-Factory für Fine-Tuning auf. Er verweist auf Quantisierungsoptionen, einschließlich GGUF, BNB, AWQ, GPTQ und FP8. Wählen Sie das Artefakt für die vorgesehene Laufzeitumgebung aus, anstatt jedes unterstützte Format als direkt einsetzbares mobiles Modell zu behandeln.
Die Offline-Inferenz beginnt, nachdem die erforderliche App und die Modelldateien lokal vorhanden sind. Dadurch entfällt die Notwendigkeit, jede Inferenzanfrage an ein Cloud-Modell zu senden, während App-Berechtigungen, der Umgang mit lokalen Daten, Speicher und Hardwareleistung praktische Aspekte der Bereitstellung bleiben.
Es handelt sich um eine multimodale Modellveröffentlichung von ModelBest und OpenBMB mit den Varianten 35B-A3B MoE und 1B. Sie unterstützt Aufgaben mit Bildern, Dokumenten, mehreren Bildern und Videos.
Das Projekt demonstriert eine optimierte 35B-A3B-Bereitstellung auf einem iPhone 17 Pro Max. Es hält einen kleineren Arbeitssatz im Speicher und streamt Experten aus dem lokalen Speicher, statt alle 35B Parameter gleichzeitig in den RAM zu laden.
Nein. Die offizielle mobile Demo nennt für das 35B-A3B-Paket einen Gesamtdownload von ungefähr 16,6 GB und empfiehlt etwa 17 GB freien Speicher. Das validierte iPhone verfügt über 12 GB Geräte-RAM.
Nein. LES prognostiziert Experten zum Vorladen und priorisiert zuerst diejenigen, die bereits verfügbar sind. Der tatsächliche Router des Modells wählt weiterhin die zu berechnenden Experten aus, einschließlich aller Experten, die von der Vorhersage nicht erfasst wurden.
Ja. Die lokalen Demos führen die Inferenz auf dem Gerät aus, sobald die erforderlichen Dateien heruntergeladen oder installiert sind. Die API-Beispiele in der Quelle sind separate Tests und sollten nicht mit dem Offline-Betrieb verwechselt werden.
Nein. Die Demo benötigt ein passendes aufgeteiltes Paket mit seiner Hauptdatei -les, dem Visual Projector und den Experten-Shards. Die App-Dokumentation erläutert, warum standardmäßige vollständige GGUF-Dateien nicht dasselbe Bereitstellungsverhalten auf Smartphones bieten.
MiniCPM-V 4.7 kombiniert spärliche Berechnung mit Experten-Streaming, Lookahead-Scheduling, Quantisierung und visueller Komprimierung, um ein größeres multimodales Modell auf ausgewählten lokalen Geräten praktikabel zu machen. Die Demonstrationen umfassen die Interpretation von Diagrammen, die Dokumentenumwandlung und alltägliche Berechnungen, während die veröffentlichten Benchmarks Ausgangspunkte für Bewertungen bieten.
Die zentrale Einschränkung bei der Bereitstellung ist der Unterschied zwischen Arbeitsspeicher, gesamtem Geräte-RAM und gespeicherten Gewichten. Das Smartphone-Ergebnis ist als spezifische optimierte Konfiguration glaubwürdig, nicht als Versprechen, dass ein vollständiges 35B-Modell in 3 GB passt oder auf jedem Gerät gleich gut läuft.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.